
Utilisez Promptfoo, une bibliothèque open source, pour évaluer des applications et des agents d’IA et les soumettre à des tests de red teaming. Définissez des cas de test et des vérifications pour mesurer le comportement de votre application, comparer des prompts ou des modèles et analyser les échecs. Vous pouvez aussi tester vos applications avec des entrées adversariales pour détecter des risques de sécurité.
Promptfoo fait partie d’OpenAI.
Pour commencer par une évaluation simple, exécutez l’exemple de traduction dans votre terminal ou demandez à Codex de configurer une évaluation pour votre application.
Premiers pas dans la CLI
Après avoir installé Node.js 22.22.0 ou une version ultérieure, choisissez comment exécuter l’exemple de Promptfoo. Cet exemple compare les traductions de plusieurs modèles à partir de cas de test :
npx promptfoo@latest init --example getting-started
cd getting-started
Utilisez un environnement virtuel actif avec Python 3.10 ou une version ultérieure. Le wrapper pip nécessite également Node.js 22.22.0 ou une version ultérieure.
pip install promptfoo
promptfoo init --example getting-started
cd getting-startedL’exemple crée le fichier promptfooconfig.yaml, qui contient un prompt de traduction, les fournisseurs de modèles et les cas de test. Chaque test comprend une assertion qui vérifie que la réponse contient l’expression attendue. Dans votre terminal, définissez votre clé API OpenAI en remplaçant la valeur d’exemple par votre clé :
export OPENAI_API_KEY="<your-api-key>"Lancez l’évaluation, puis ouvrez l’interface de consultation des résultats. Les appels aux modèles effectués pendant l’évaluation entraînent des frais d’API.
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo viewOuvrez l’URL locale pour comparer les réponses des modèles et voir quelles assertions ont réussi ou échoué. Examinez aussi les réponses elles-mêmes : la réussite d’une assertion indique qu’une condition précise est remplie, sans garantir la qualité globale de la réponse. Modifiez le prompt ou les cas de test dans promptfooconfig.yaml, puis relancez l’évaluation.
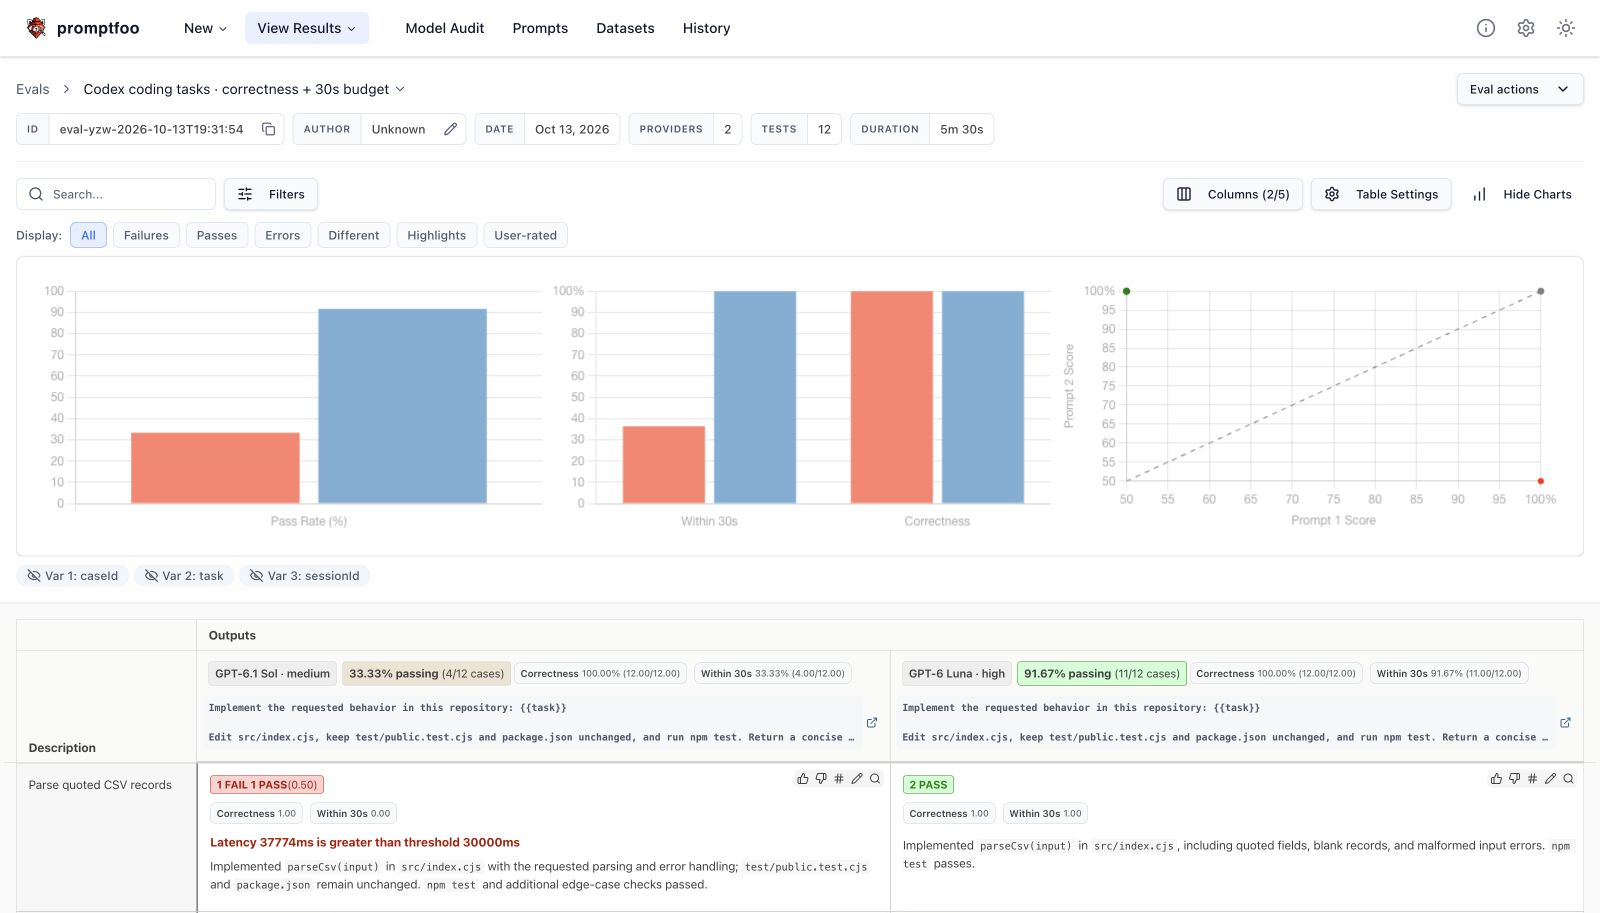
Une évaluation distincte, réalisée avec Codex App Server, compare gpt-6.1-sol (effort de raisonnement moyen) et gpt-6-luna (effort de raisonnement élevé) sur 12 tâches de programmation. Chaque résultat tient compte de tests qui exécutent le code pour en vérifier l’exactitude, ainsi que d’une limite de 30 secondes. Toutes les implémentations ont réussi les tests du code. Les résultats en rouge indiquent un dépassement du délai.
Premiers pas dans Codex App
Utilisez le plugin Promptfoo pour ajouter à Codex les skills nécessaires à la configuration et à l’exécution d’évaluations.
Sélectionnez Ouvrir dans Codex pour lancer une tâche ou Copier le prompt pour coller le prompt dans une tâche existante.
Codex peut avoir besoin de votre aide pour accéder aux identifiants ou obtenir les autorisations nécessaires à la configuration. Les évaluations qui font appel à un modèle peuvent entraîner des frais d’API.
Étapes suivantes
Poursuivez avec la documentation de Promptfoo :
- Configurer des évaluations : définissez les prompts, les modèles et les cas de test à l’aide du guide de configuration.
- Vérifier les réponses : choisissez vos vérifications et vos méthodes de notation en consultant la documentation sur les assertions et les métriques.
- Détecter les risques de sécurité : testez votre application avec des entrées adversariales en suivant le guide de red teaming.