
Avec GPT-Live, les utilisateurs donnent leur rythme à la conversation : ils peuvent intervenir, changer de sujet ou préciser une idée à mesure qu’ils parlent. Les systèmes vocaux en cascade font passer la parole par des modèles distincts de transcription, de traitement du langage et de synthèse vocale. GPT-Live, lui, écoute et parle simultanément. Les échanges gagnent en naturel, car le moment où l’on prend la parole ou interrompt son interlocuteur compte autant que les mots eux-mêmes.
Dans cet article, Juno, Picsart, Treater et Weekend racontent avec leurs propres mots comment ces équipes développent leurs produits avec GPT-Live et ce qu’elles ont appris sur quatre sujets :
- Améliorer les appels à partir des données recueillies en production
- Trouver des voix qui inspirent confiance
- Se coordonner avec des agents en arrière-plan
- Orchestrer plusieurs agents vocaux qui collaborent
Nous examinerons les prompts, les processus et les retours qui façonnent leurs produits, avec des pistes concrètes à tester dans vos propres applications.
Témoignages de startups
Juno : rendre les échanges avec son assistant vocal plus naturels pour les patients grâce à GPT-Live
Par Marshall Gould, cofondateur et directeur général, et Isaac Tolley, cofondateur et directeur technique
Nous développons Juno, un assistant de santé personnel destiné aux personnes atteintes de maladies chroniques comme le Covid long, le syndrome de tachycardie orthostatique posturale (POTS) ou les syndromes d’Ehlers-Danlos (EDS).
Ce que nous voulions créer
Il faut vivre avec une maladie chronique pour vraiment comprendre le poids qu’elle représente. Aux symptômes intenses, à la fatigue, aux rendez-vous et à l’angoisse de ne pas savoir ce qui ne va pas s’ajoutent toutes les démarches du quotidien. Il faut penser à renouveler son traitement, lire les dernières études, suivre ses symptômes et faire le lien avec les centaines de variables qui changent chaque jour, tout en essayant de mener une vie normale.
Pour les personnes atteintes d’une maladie chronique, surtout quand celle-ci limite leur énergie, les outils de suivi représentent une charge de plus. Tout consigner à la main devient épuisant. Beaucoup finissent par abandonner ces applications, même si elles les aident.
C’est là que la voix a tout changé. Il suffit de prononcer une phrase pour que Juno consigne plusieurs éléments à la fois à votre place.
Les difficultés qui subsistent à l’oral
Dès les premiers essais, la voix impressionne. C’est pour nous la façon la plus naturelle de communiquer, mais nous apprenons encore à bien nous en servir. Quelques difficultés demeurent :
- Consigner un symptôme ou récupérer du contexte sans interrompre l’échange.
- Retrouver à l’oral ce que l’agent a mémorisé à l’écrit sans bloquer la conversation.
- Soutenir de longues conversations.
Les modèles vocaux me font penser à des méduses. Ils sont rapides et réactifs, mais savent rarement quelle direction prendre d’eux-mêmes. Ils se laissent porter par les derniers mots de l’utilisateur et s’arrêtent souvent pour demander confirmation. Les modèles de texte prennent davantage les devants, car ils disposent d’un contexte bien plus large et n’ont pas besoin que l’utilisateur leur explique sa situation à chaque fois. Avec la voix, c’est à vous de donner le cap.
Comment nous améliorons nos agents vocaux
Consigner et mémoriser sans interrompre l’échange
Demandez à la plupart des agents vocaux de faire quelque chose : ils transmettent la demande à un outil, puis attendent la réponse. Pendant ce temps, c’est le silence. GPT-Live peut déléguer une tâche à un autre agent, mais la conversation reste bloquée jusqu’au retour de la réponse. Dans notre première version, quatre appels sur cinq comportaient au moins une pause de ce type : « Un instant », puis une dizaine de secondes de silence.
Notre solution est simple. Après chaque tour de parole, un petit modèle rapide (l’API Decisions d’OpenAI) répond à deux questions en arrière-plan :
- Y a-t-il quelque chose à consigner et, si oui, de quel type ?
- Quels éléments de votre historique sont pertinents à cet instant ?
Dites « Note que j’ai mal à la tête ». Juno reçoit aussitôt la confirmation que c’est noté, pendant que la sauvegarde s’effectue discrètement en arrière-plan. C’est suffisamment rapide pour que, si vous posez une question sur ce mal de tête au tour suivant, il soit déjà enregistré.
La réponse à la seconde question sert à gérer la mémoire. Seuls les éléments pertinents de votre historique entrent dans le contexte du tour suivant. Ce tri compte, car un modèle vocal dispose de beaucoup moins de contexte qu’un modèle de texte. Il faut donc choisir avec soin ce qu’on y inclut.
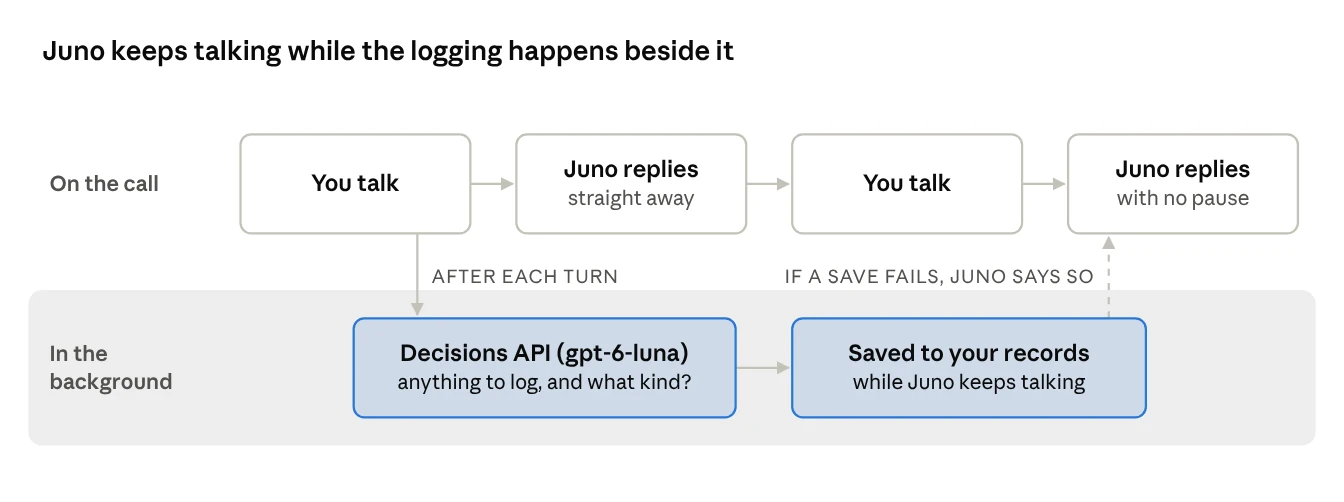
Nous avons ainsi réduit de 40 % les délégations à l’agent de texte. Lors d’un appel de test, le plus long silence est passé de 9,3 à 3,2 secondes. C’est ce qui fait la différence entre une attente gênante et une pause naturelle.
Les longues conversations
Les longues conversations demandent la même attention. Repensez à la méduse : le modèle sait rarement où aller de lui-même, il faut donc le guider. Un agent de pilotage actualise le contexte de l’appel. Ainsi, au centième tour de parole, Juno sait encore ce qui s’est dit au premier et quel sujet aborder si l’échange s’essouffle. Pour permettre de longues conversations, vous devez mettre en place ce mécanisme vous-même. Ces échanges ont de la valeur : c’est là qu’apparaissent les régularités et les tendances qui aident les gens à mieux comprendre leur santé.
Trouver la voix de Juno en la faisant écouter aux utilisateurs
Créer une voix qui sonne juste est une autre difficulté, et c’est plus facile à dire qu’à faire. Les voix que propose GPT-Live dès le départ marquent un grand progrès par rapport aux modèles précédents. Pourtant, on nous dit encore qu’une voix « fait IA ». Peut-on en créer une qui convienne à neuf personnes sur dix ?
Lors d’un entretien de groupe, des personnes atteintes de maladies chroniques nous ont dit que notre voix était un peu trop lente et légèrement condescendante. Nous avons pris ce retour au sérieux et lancé une étude pour l’améliorer.
Avec la fonction de création de voix à partir d’un prompt de GPT-Live, nous avons conçu de nouvelles voix à partir de courtes descriptions écrites. Nous les avons comparées à la voix actuelle auprès de 290 adultes vivant aux États-Unis et atteints de maladies chroniques. Chaque personne a écouté les trois mêmes phrases, noté chaque voix, puis choisi sa préférée, celle qu’elle aimait le moins et celle qu’elle voudrait entendre un jour d’épuisement.
Au fil de cinq courtes séries de tests, nous avons conservé les meilleures voix et réécrit les descriptions des autres. Ensuite, 171 nouvelles personnes ont comparé la voix actuelle aux deux meilleures nouvelles voix.
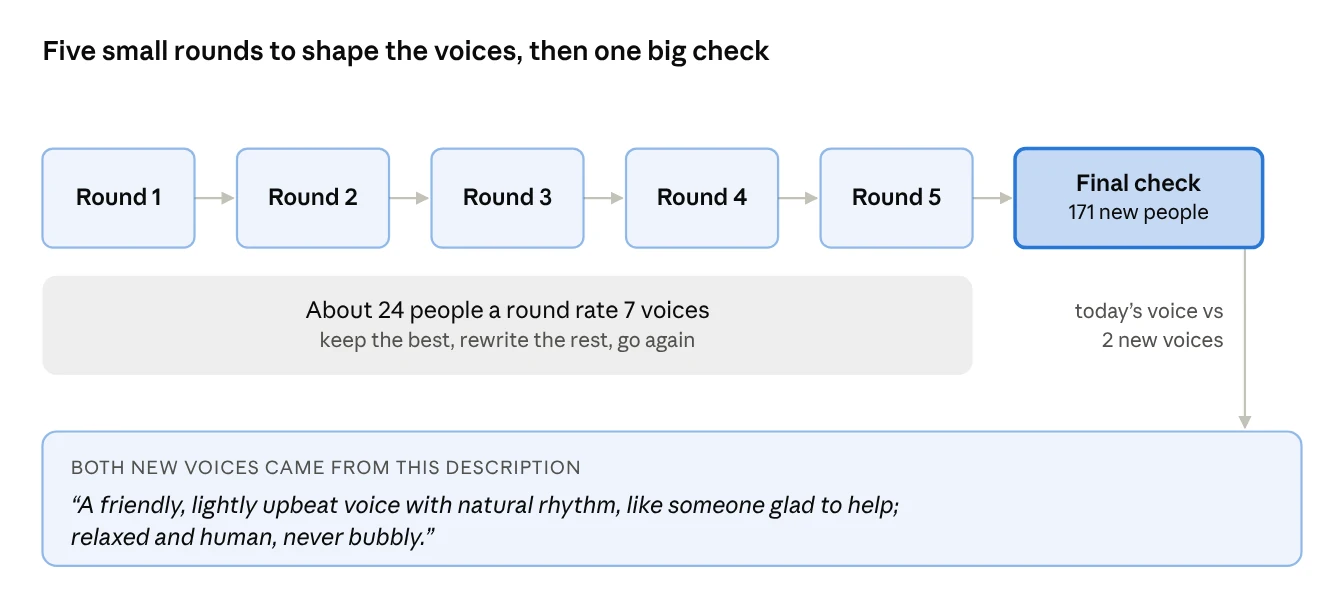
La voix gagnante a été créée à partir de la description qui figure dans le schéma ci-dessus. Lors de la dernière évaluation, les participants ont été plus nombreux à la désigner comme leur préférée que la voix actuelle. Moins de participants l’ont classée en dernière position, et ils ont été nettement moins nombreux à lui reprocher un manque de chaleur.
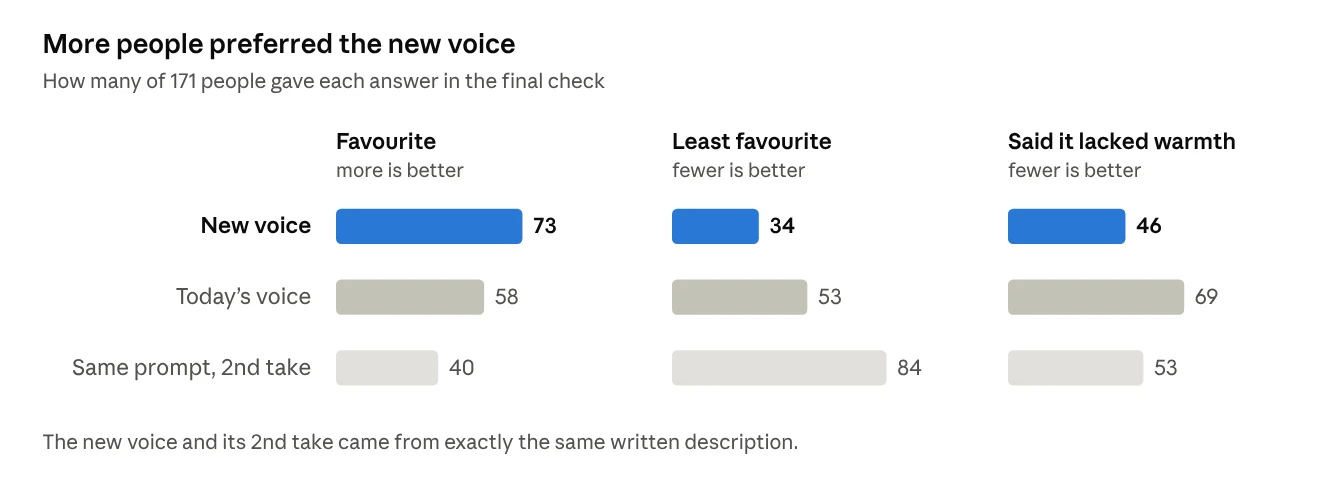
Cette étude a ses limites. Les participants n’ont entendu que trois phrases, les notes étaient proches et une étude ne reproduit pas un véritable appel. Nous allons maintenant tester la nouvelle voix en conditions réelles auprès de personnes qui appellent pour la première fois, puis vérifier si elles sont plus nombreuses à revenir le lendemain.
Quelle voix pour les jours d’épuisement ?
Nous avons aussi demandé aux participants quelle voix ils aimeraient entendre un jour où ils se sentent épuisés. Cette fois, la voix actuelle a devancé la nouvelle de peu. L’écart est faible, mais il soulève une question plus large : pourquoi tenons-nous tellement à trouver une seule voix parfaite ?

Nos propres voix varient. Nous changeons de ton, de débit et de volume selon la situation. Et si la voix de Juno s’adaptait à ce que vous ressentez ? Les gens font davantage confiance à une voix dont le débit et le volume s’accordent aux leurs (Levitan et al., 2016). Or, GPT-Live nous permet déjà de modifier la façon dont Juno parle en cours d’appel. C’est ce que nous testerons dans notre prochaine étude. Vous pouvez écouter toutes les voix et consulter les résultats complets sur junocompanion.com/voice-study.
C’est impressionnant de voir ce que la voix a rendu possible pour les personnes atteintes de maladies chroniques et à quel point elle leur simplifie la vie. GPT-Live est un excellent modèle de base, et de petits ajustements font une réelle différence au quotidien.
À propos de l’auteur et de l’entreprise
Je suis Marshall Gould, fondateur de Juno. J’ai développé la voix de Juno avec trois chercheurs : Isaac Tolley, Sean Lees et Dawid Wraga. Notre entreprise d’IA a pour mission d’aider les personnes atteintes de maladies chroniques à mieux vivre avec leur maladie et à la gérer au quotidien. Nous sommes fiers de compter dans notre équipe une majorité de personnes qui vivent elles-mêmes avec une maladie chronique. Des centaines de milliers de personnes utilisent aujourd’hui Juno, et nous serions heureux de poursuivre cette mission avec votre aide. Pour en savoir plus, rendez-vous sur junocompanion.com.
Picsart : synchroniser la conversation vocale et les tâches de l’agent
Par Dmitry Ivanov, Senior Staff Engineer chez Picsart
Ce que nous voulions créer
Un travail de création peut durer plus longtemps qu’un appel. Nous voulions que les utilisateurs puissent parler naturellement aux agents IA de Picsart pendant l’exécution d’une tâche, ou quitter l’appel et revenir une fois les résultats prêts. Une idée créative ne prend pas toujours forme d’un seul coup. Il est parfois plus facile de discuter d’une ambiance ou d’une première piste que de formuler une demande précise par écrit.
GPT-Live a été la première technologie qui nous a permis de concrétiser cette idée. Grâce au naturel des échanges en direct, on pouvait aller au-delà de la simple dictée de commandes et développer des idées ensemble à l’oral. Nous avions les bases pour proposer cette expérience de conversation avec les agents IA de Picsart.
Nous avons donc fait de la voix une interface indépendante pour communiquer avec l’agent, tout en conservant le même fil de discussion qu’à l’écrit. Nous avons confié la conversation en direct à GPT-Live. Notre couche d’intelligence gère le raisonnement, les outils, les plans et le contexte enregistré.
Notre solution : dissocier la conversation de l’exécution des tâches

Comme le montre le schéma, l’application transmet les tâches à la couche d’intelligence et renvoie le contexte et les réponses à GPT-Live. Elle utilise une connexion WebSocket partagée pour envoyer les tâches, suivre leur avancement et recevoir les résultats. Les interfaces vocale et textuelle utilisent le même agent, le même processus d’exécution et les mêmes règles d’approbation.
Notre passerelle vocale initialise la session avec les instructions de l’agent sélectionné. L’audio en direct circule directement entre le navigateur et OpenAI via WebRTC. Une tâche soumise peut se poursuivre après la fin de l’appel.
Envoyer une demande à l’agent
Lorsque GPT-Live sollicite l’agent principal, nous envoyons la demande orale, les messages récents et les pièces jointes à l’agent actif, dans le fil en cours, en indiquant que la demande provient du mode vocal. Nous enregistrons ce contexte dès l’envoi pour que la suite de la conversation ne puisse pas écraser une demande en attente.
Nous demandons à l’agent principal d’écrire pour l’oral : formuler des réponses courtes sur le ton de la conversation, poser une question à la fois et éviter de répéter ce que l’interface vocale a déjà confirmé. Il doit préciser le travail proposé, son coût et les éléments à approuver.
Ce que l’interface vocale sait et ce qu’elle dit
Nous transmettons trois types d’informations à l’interface vocale :
| Canal | Informations transmises et utilisation par l’interface vocale |
|---|---|
| instructions | Identité de l’agent, règles qui déterminent quand lui confier du travail et règles de conversation |
| thinking | Messages récents, état des tâches, sélection de données issues des outils et actions de l’utilisateur, à utiliser comme contexte silencieux |
| commentary | Réponses, questions et étapes importantes à annoncer à voix haute |
Le canal thinking transmet le contexte fourni par l’application. Le raisonnement privé de l’agent principal reste interne. Avant de transmettre les résultats d’outils sélectionnés, nous supprimons les champs courants contenant des identifiants d’accès ainsi que les données binaires, limitons la taille des résultats et signalons ceux qui sont incomplets.
Lorsqu’une action à l’écran envoie une demande à l’agent, nous en informons l’interface vocale via le canal thinking. Elle peut alors confirmer la prise en compte de l’action sans poser à nouveau la question ni renvoyer la demande.
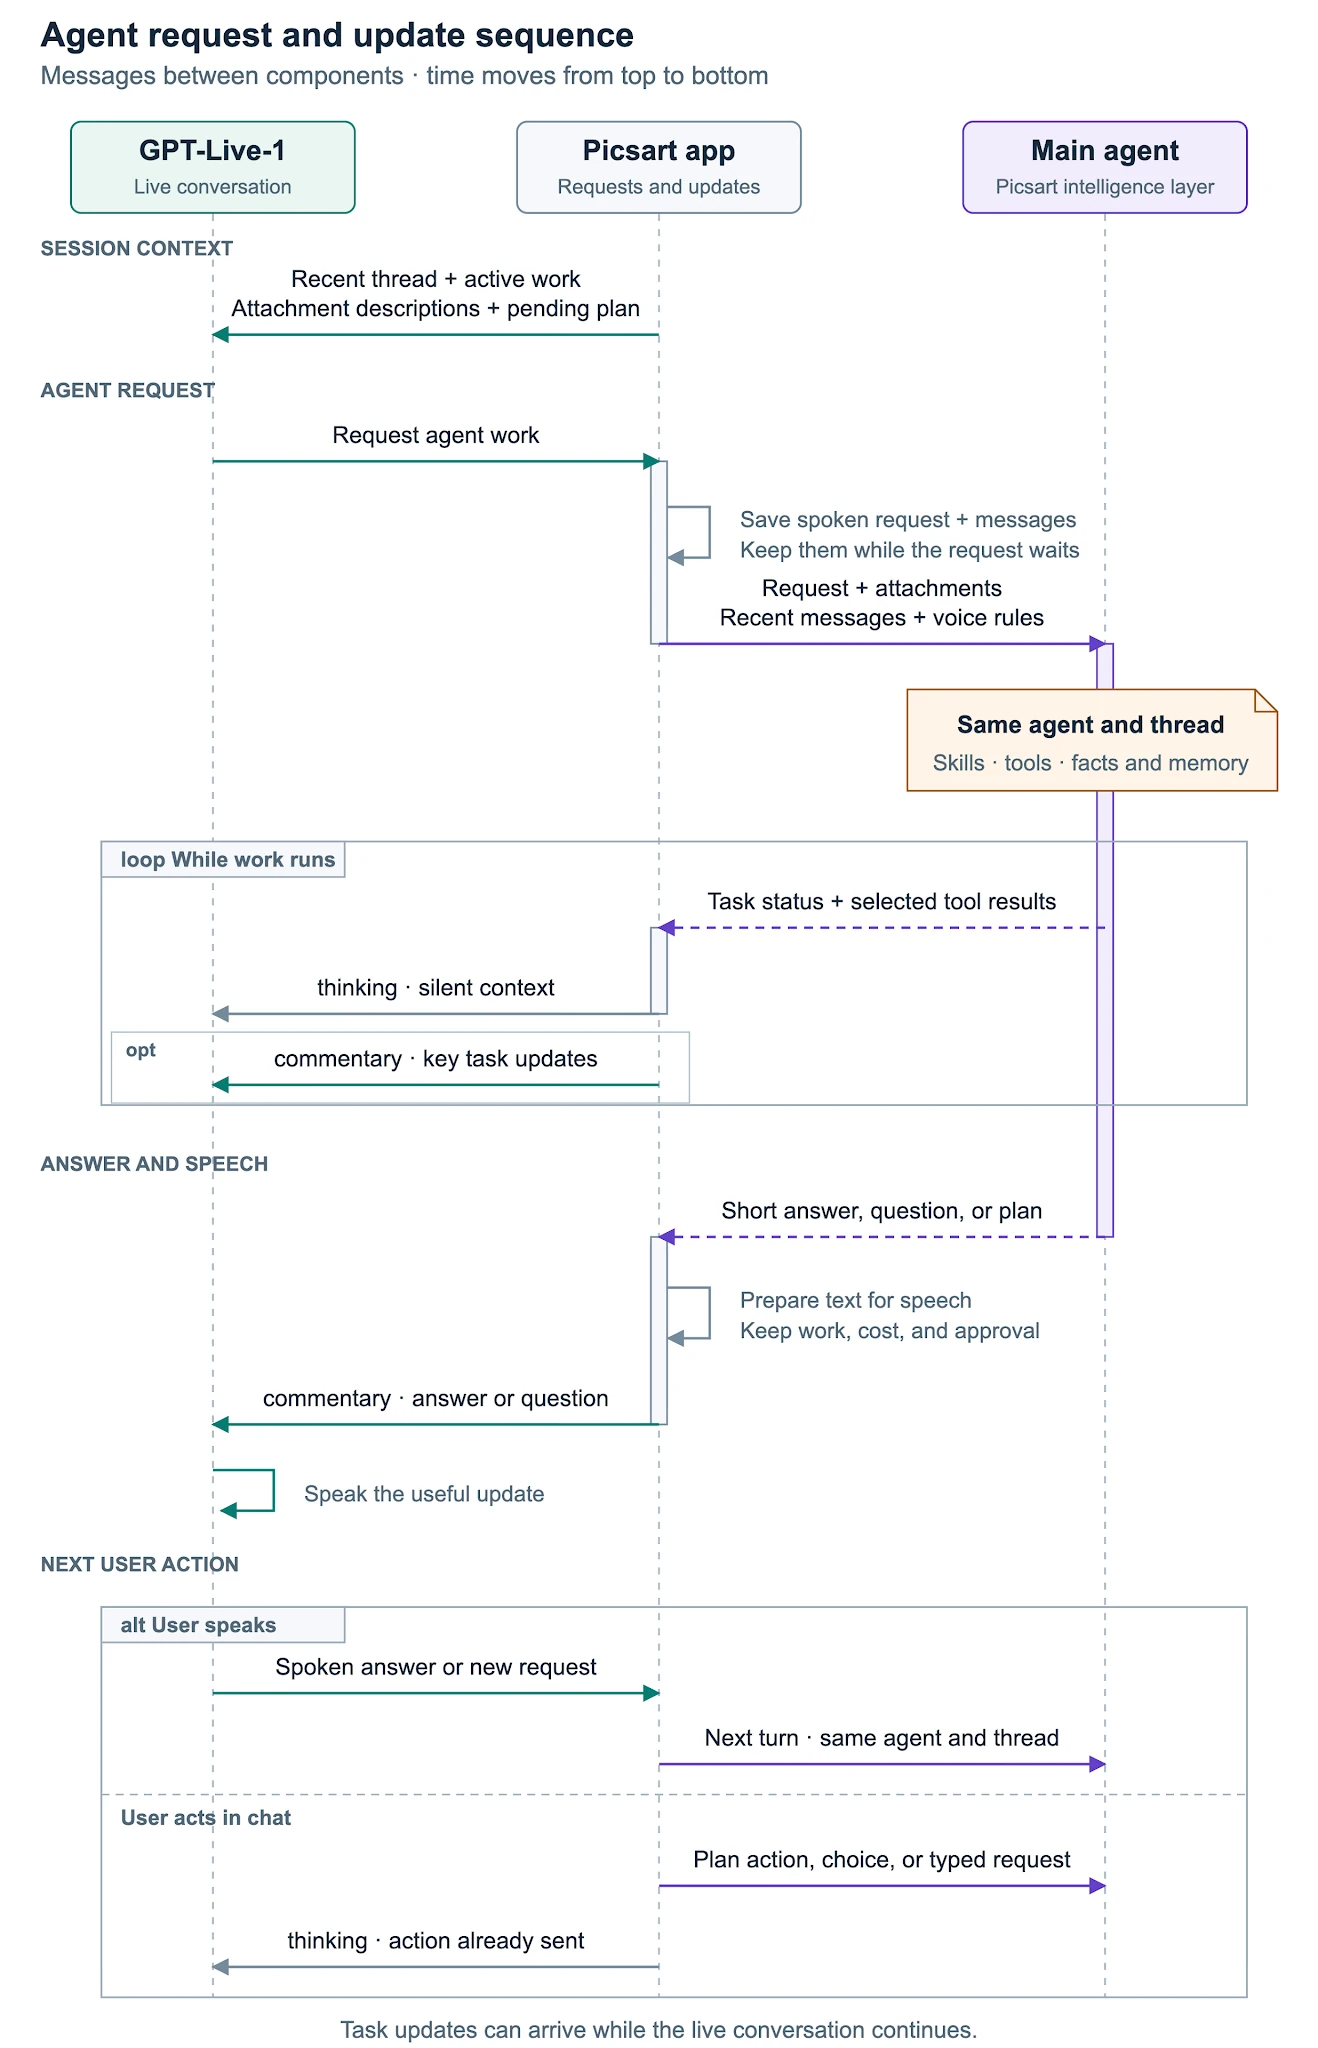
Les opérations courantes des outils restent silencieuses. Le début de l’exécution d’un plan et la fin d’une tâche sont annoncés à voix haute. Nous regroupons en phrases les fragments de réponse reçus en continu, puis attendons une pause pour les transmettre à l’interface vocale. À l’arrivée de la réponse finale, nous évitons de répéter le texte déjà transmis, tout en communiquant les corrections et les demandes d’approbation.
Ce que l’on retrouve au début d’un appel et ce qui est enregistré
Les instructions de session définissent le rôle de l’agent. Sa mémoire de l’utilisateur est gérée séparément. Au début d’un appel, nous chargeons les messages récents, les descriptions des pièces jointes, les tâches actives et les approbations en attente. L’interface vocale peut ainsi reprendre là où l’utilisateur s’était arrêté.
L’agent principal conserve la mémoire à long terme. Lorsque la mémoire est activée, il peut utiliser l’historique du fil, des résumés, des faits enregistrés et les préférences de l’utilisateur ou du projet.
Si l’utilisateur dit « Utilise le style que nous avons enregistré », l’agent principal peut rechercher ce style ou demander une précision, puis renvoyer sa réponse à l’interface vocale. Si la mémoire est indisponible, l’appel peut se poursuivre avec moins de contexte.
Le fil conserve les demandes adressées à l’agent et les messages qui y sont joints. Il ne conserve pas tous les échanges oraux. Une préférence évoquée au détour d’une conversation n’est enregistrée que si l’agent principal la reçoit et la sauvegarde.
Démarrage, poursuite et arrêt des tâches
Nous présentons un plan à voix haute après que l’agent l’a expliqué. Nous annonçons que le travail est en cours uniquement lorsque l’agent en a confirmé le démarrage. Nous présentons ensemble le travail proposé, son coût et la demande d’approbation. Un complément de contexte n’autorise ni travail ni dépense supplémentaires.
Si une mise à jour nous échappe, nous récupérons l’état de la tâche en cours. Cela évite de la relancer, de répéter les résultats ou de redemander une approbation.
Interrompre la voix ou quitter l’appel n’annule pas le travail. L’arrêt d’une tâche nécessite une demande distincte et les actions déjà en cours peuvent se poursuivre. Les nouvelles demandes conservent leur contexte d’origine et attendent la fin du tour en cours, sans modifier le travail déjà engagé.
Ce que nous en retenons : l’interface vocale doit en savoir plus qu’elle n’en dit
De cette intégration, nous retenons quatre enseignements pratiques :
- Préparez les réponses destinées à l’oral dans l’agent principal.
- Enregistrez le contexte de chaque demande au moment de son envoi.
- Utilisez le même fil et les mêmes règles pour les échanges vocaux, le texte et les actions à l’écran.
- Gérez séparément la conversation et la tâche.
À propos de Picsart
Picsart est une plateforme de production et de diffusion de médias assistée par l’IA. Plus de 100 millions de créateurs et d’entreprises dans le monde y créent, y promeuvent et y monétisent leurs contenus.
Depuis plus de 14 ans, Picsart aide une nouvelle génération à raconter des histoires en vidéo, à produire ces contenus à grande échelle et désormais à en tirer des revenus. Grâce à ses outils de conception intuitifs, à la création d’images et de vidéos par IA et à ses fonctions MCP et CLI, Picsart accompagne les créateurs dans leurs environnements de travail. Avec plus de 100 millions d’utilisateurs actifs par mois et plus de 2,5 milliards de téléchargements à ce jour, Picsart permet de créer à grande échelle et en toute autonomie. Les créateurs peuvent ainsi affirmer leur identité, développer leur influence et entreprendre grâce à leurs contenus.
Treater : ajuster les agents vocaux pour améliorer les résultats des appels
Par Britt O’Daly, cofondateur et directeur général, Ayaz Hafiz, cofondateur et directeur technique, et Sayd Agzamkhodjaev, développeur logiciel
Atteindre un objectif par la conversation
Lors d’un appel avec une agence de recrutement, notre agent vocal a discuté avec la personne qui dirigeait l’agence des difficultés que rencontrait son équipe avec un logiciel de planification.
À mesure que son interlocuteur expliquait pourquoi la solution précédente n’avait pas fonctionné, l’agent intervenait sans cesse avec des « Hum hum » et des « Oui, oui ». La personne a fini par écourter l’échange :
Bon, envoyez-moi juste un e-mail.
L’agent comprenait ce qu’on lui disait, mais ses interventions rendaient l’échange désagréable. Un commercial tirerait des leçons de cet appel et adapterait sa façon de mener les suivants. Nous voulions que nos agents en fassent autant.
Chez Treater, nous développons des agents IA qui aident les entreprises à contacter leurs partenaires et à travailler avec eux par téléphone, par e-mail et par SMS. Nous voulons que nos agents atteignent les objectifs de nos clients grâce à des conversations de grande qualité. Nous avons créé un système d’apprentissage qui évalue de vraies conversations, repère des pistes d’amélioration et teste de nouvelles configurations d’agents en mesurant les résultats pour nos clients.
Dans cette démonstration, notre agent se coordonne avec plusieurs interlocuteurs pour réapprovisionner un magasin alimentaire après une rupture de stock.
Des agents qui apprennent sur le terrain
Avant GPT-Live, nous passions une grande partie de notre temps à développer et à maintenir une pile logicielle vocale sur mesure. Après son adoption, nous avons pu remplacer presque tout cet ensemble par de simples prompts et obtenir de meilleures performances. Les conversations plus longues sont corrélées à de meilleurs résultats pour nos clients. Depuis l’adoption de GPT-Live, nous avons vu leur durée médiane augmenter de 26 à 30 %, avec des hausses allant jusqu’à 40 % au 90e percentile.
Le taux de réalisation des objectifs qui comptent pour nos clients a augmenté de 6 points de pourcentage en moyenne.
Cela nous laisse davantage de temps à consacrer à « ce qui donne un meilleur goût à notre bière » : apprendre et nous adapter dans un environnement qui évolue constamment. Tout comme les personnes progressent dans leur métier, nous voulons que nos agents apprennent sur le terrain ce que signifie bien faire leur travail.
Pour améliorer nos agents, nous testons différentes combinaisons de paramètres pour chacun d’eux (voix, prompt, cadence, outils disponibles). Nous notons chaque conversation selon nos propres critères (tonalité de l’échange, étapes accomplies) et ceux du client (respect des préférences, degré de réalisation de l’objectif). Un algorithme de bandit à plusieurs bras oriente progressivement les appels vers les configurations les mieux notées. Les moins performantes sont rapidement écartées.
Hors ligne, un système d’évaluation analyse les appels passés et propose de nouvelles configurations. Nous rejouons chaque proposition sur des conversations passées et prédisons sa récompense en production pour écarter les modifications qui n’apporteraient pas de gain tangible. Nos clients examinent les modifications, ou choisissent de les déployer automatiquement.
Avec GPT-Live, nombre de ces réglages sont devenus très simples. Le ton, la cadence, le choix de s’accorder ou non à l’énergie de l’interlocuteur, le registre de langue, la fréquence des petits signes d’écoute : chacun de ces paramètres exigeait auparavant de coordonner plusieurs composants de notre pile vocale. Aujourd’hui, une ligne dans un prompt suffit pour la plupart d’entre eux, ce qui facilite la comparaison entre versions.
Démonstration : qu’a donc appris notre agent de son appel avec la personne qui dirige l’agence de recrutement ?
Ouvrir la simulation en pleine page.
Cette démonstration présente une version anonymisée et simplifiée de la campagne évoquée en introduction : une entreprise cherche à obtenir des rendez-vous de démonstration auprès d’agences de recrutement, en partant d’une configuration de base de l’agent.
- Notre système a repéré une piste d’amélioration. En analysant hors ligne les appels à faible récompense, il a relevé plusieurs comportements récurrents. Dans 20 % des appels, par exemple, l’agent coupait la parole aux responsables d’agence en voulant leur montrer qu’il les écoutait. Le système a proposé quatre nouvelles configurations.
- Il a proposé des améliorations. Chaque proposition a été simulée sur des appels passés et a reçu une récompense calculée comme en production. La variante au débit plus lent a obtenu un mauvais score et a été immédiatement écartée. Les autres ont été examinées et approuvées.
- L’évaluation s’est poursuivie en production. Les appels sont répartis entre les nouvelles versions selon la récompense attendue. En une journée, la version B reçoit la majorité des appels. La version C ne rattrape jamais son retard et est désactivée le troisième jour. La version D, ajoutée le deuxième jour, prend la tête dès le début du troisième et finit par recevoir environ 90 % des appels. Les versions A et B en conservent une petite part au cas où les conditions changeraient. Le nombre de démonstrations obtenues pour 100 appels passe de 3,0 à 4,3.
Ce système fonctionne à plusieurs niveaux. Les améliorations apportées à nos harnais communs bénéficient à tous les cas d’usage, et les enseignements tirés d’un processus servent de point de départ aux processus similaires.
Les enseignements qui nous guident
- Tout est une hypothèse à tester ! L’une de nos réussites les plus nettes concernait un client qui souhaitait que l’agent commence par annoncer sa prochaine promotion. Les appels qui commençaient par évoquer la hausse récente du taux d’écoulement des produits ont donné de bien meilleurs résultats.
- Fondez la récompense sur des résultats à la fois révélateurs et importants pour votre activité. Si ces résultats tardent à se concrétiser (par exemple, conclure une vente), cherchez aussi des résultats plus rapides à mesurer (par exemple, fixer un prochain rendez-vous), puis vérifiez que les deux sont effectivement liés.
- Donnez-vous les moyens d’observer et de mesurer l’environnement dans lequel vos agents travaillent. Les simulations et les tests de référence n’ont de sens que s’ils reproduisent fidèlement la répartition des situations réelles.
- Avec GPT-Live, essayez de décrire le comportement recherché plutôt que de prescrire chaque réplique. Les agents GPT-Live savent s’adapter au contexte et suivre des consignes générales sans qu’il soit nécessaire de tout scénariser.
Avec GPT-Live, nous continuons à franchir des paliers dans la qualité des conversations, et nous avons hâte de découvrir les dix prochains !
À propos de Treater
Treater dialogue avec vos interlocuteurs pour concrétiser vos objectifs commerciaux et accorde à chaque occasion autant d’attention qu’à la plus importante. Notre plateforme gère des centaines de milliers d’appels avec des milliers d’agents distincts. Au cours de l’année écoulée, le volume d’appels a augmenté de 25 % par mois. Nos clients vont de sociétés cotées en bourse à de jeunes entreprises en forte croissance. Pour en savoir plus, consultez trytreater.com.
Weekend : comment deux personnages de Wit’s End se partagent une scène avec GPT-Live
Par Kevin Shen, ingénieur logiciel senior, et James Wilsterman, cofondateur et directeur technique de Weekend
Ce que nous voulions créer
Notre jeu, Wit’s End, est un jeu de rôle sur table dans un univers de fantasy, conçu pour se jouer à la voix. Sir Bart, le maître du jeu incarné par une IA, raconte l’histoire et fait appliquer les règles. Les joueurs, eux, n’ont qu’à parler. Grâce à l’audio en duplex intégral de GPT-Live, on se croirait vraiment autour d’une table : les joueurs se coupent la parole, plaisantent, se disputent, et Sir Bart réagit alors même qu’ils parlent encore.
Le point faible, c’étaient les personnages. Une session GPT-Live n’a qu’une voix. Le capitaine bourru à la porte de la ville et la vieille dame effrayée dans la taverne avaient donc tous deux la voix du narrateur. Nous voulions que le personnage principal de chaque scène puisse s’exprimer avec sa propre voix et sa propre personnalité, tout en préservant ce qui fait fonctionner le jeu : les joueurs peuvent dire ce qu’ils veulent et l’histoire arrive quand même à son dénouement.
Voici comment se déroule une scène aujourd’hui. Le groupe arrive à la porte de Timberfall. Sir Bart plante le décor et s’arrête : « Des gardes impassibles montent la garde. Leur capitaine s’avance, la main sur son épée, et vous toise. » Le capitaine Dmitri prend la parole d’une voix grave et rocailleuse. Il traque une traîtresse nommée Jade, et le groupe correspond au signalement de ses complices. Un joueur le conteste et Dmitri lui rend la pareille. Un autre lui glisse une pièce d’or. Sir Bart intervient pour annoncer le jet de dés, raconte l’effet du pot-de-vin, puis rend la parole à Dmitri, qui réagit.
Notre solution : deux voix et un seul metteur en scène
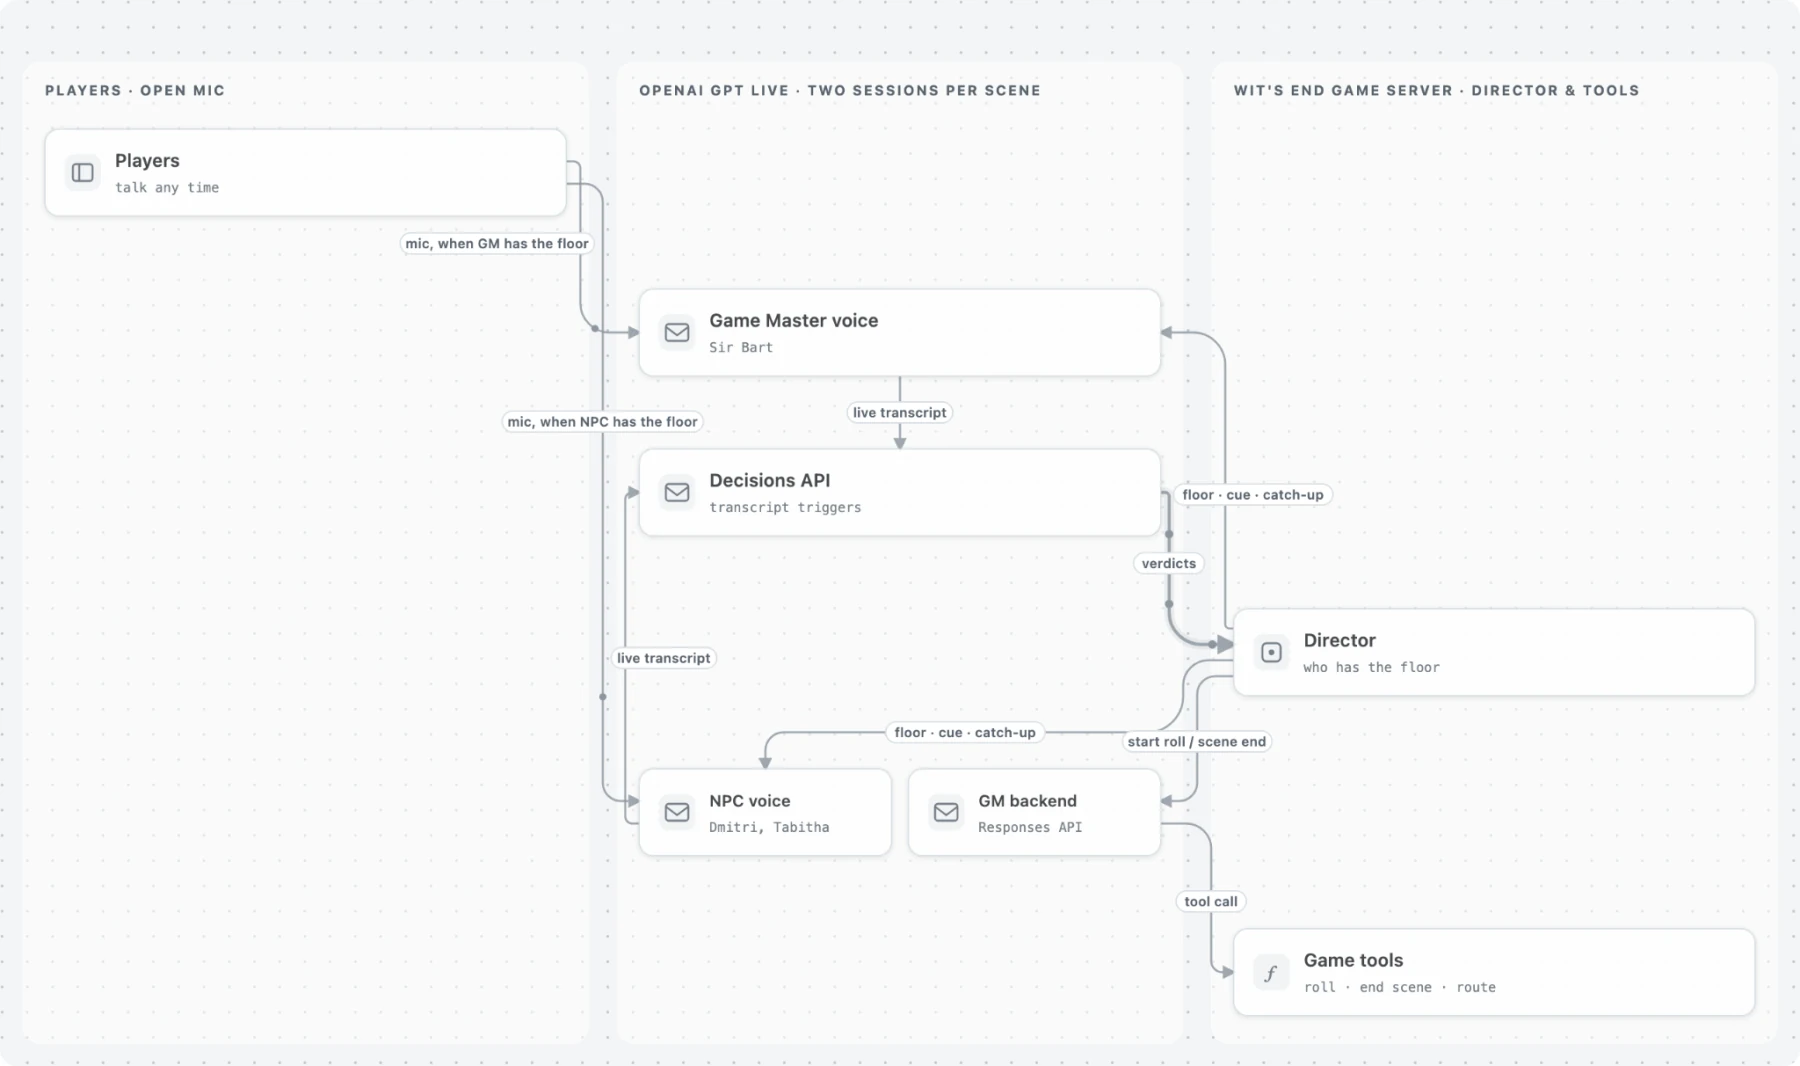
À qui la parole ? Les verdicts de l’API Decisions sur les transcriptions des deux sessions indiquent au metteur en scène qui doit parler ensuite. Il passe la parole d’une voix à l’autre et déclenche les jets de dés et les fins de scène sur le backend du maître du jeu.
Dans chaque scène, deux sessions GPT-Live fonctionnent en parallèle : celle de Sir Bart et celle du personnage de la scène (Dmitri à la porte, Tabitha à la taverne). Chacune dispose de son propre prompt et d’une voix personnalisée. Un metteur en scène, sur notre serveur de jeu, décide qui a la parole. Seule la session qui a la parole entend les joueurs. Dans les deux sessions, des déclencheurs qui analysent les transcriptions avec l’API Decisions indiquent au metteur en scène ce qui se passe dans la conversation. Le backend du maître du jeu, un modèle de l’API Responses, est le seul composant qui appelle les outils du jeu pour les jets de dés, les fins de scène et les choix d’itinéraire.
Deux personnalités, une seule histoire
Pour chaque personnage, nous distinguons les éléments qui lui sont propres de ceux qu’il partage avec les autres.
Sa personnalité est définie dans son propre prompt.
Chaque prompt décrit également la voix du personnage, dans les termes mêmes qui nous ont servi à la créer.
Exemple de scène partagée
La scène est commune aux deux sessions. Sir Bart et le personnage reçoivent le même conflit, le même dénouement et les mêmes étapes narratives. Chaque étape précise qui doit prendre la parole. Dmitri se présente et dit qui il traque. Tabitha indique au groupe où Jade leur donne rendez-vous. Le jeu attend que chaque étape ait été exprimée par la voix désignée avant de clore la scène.
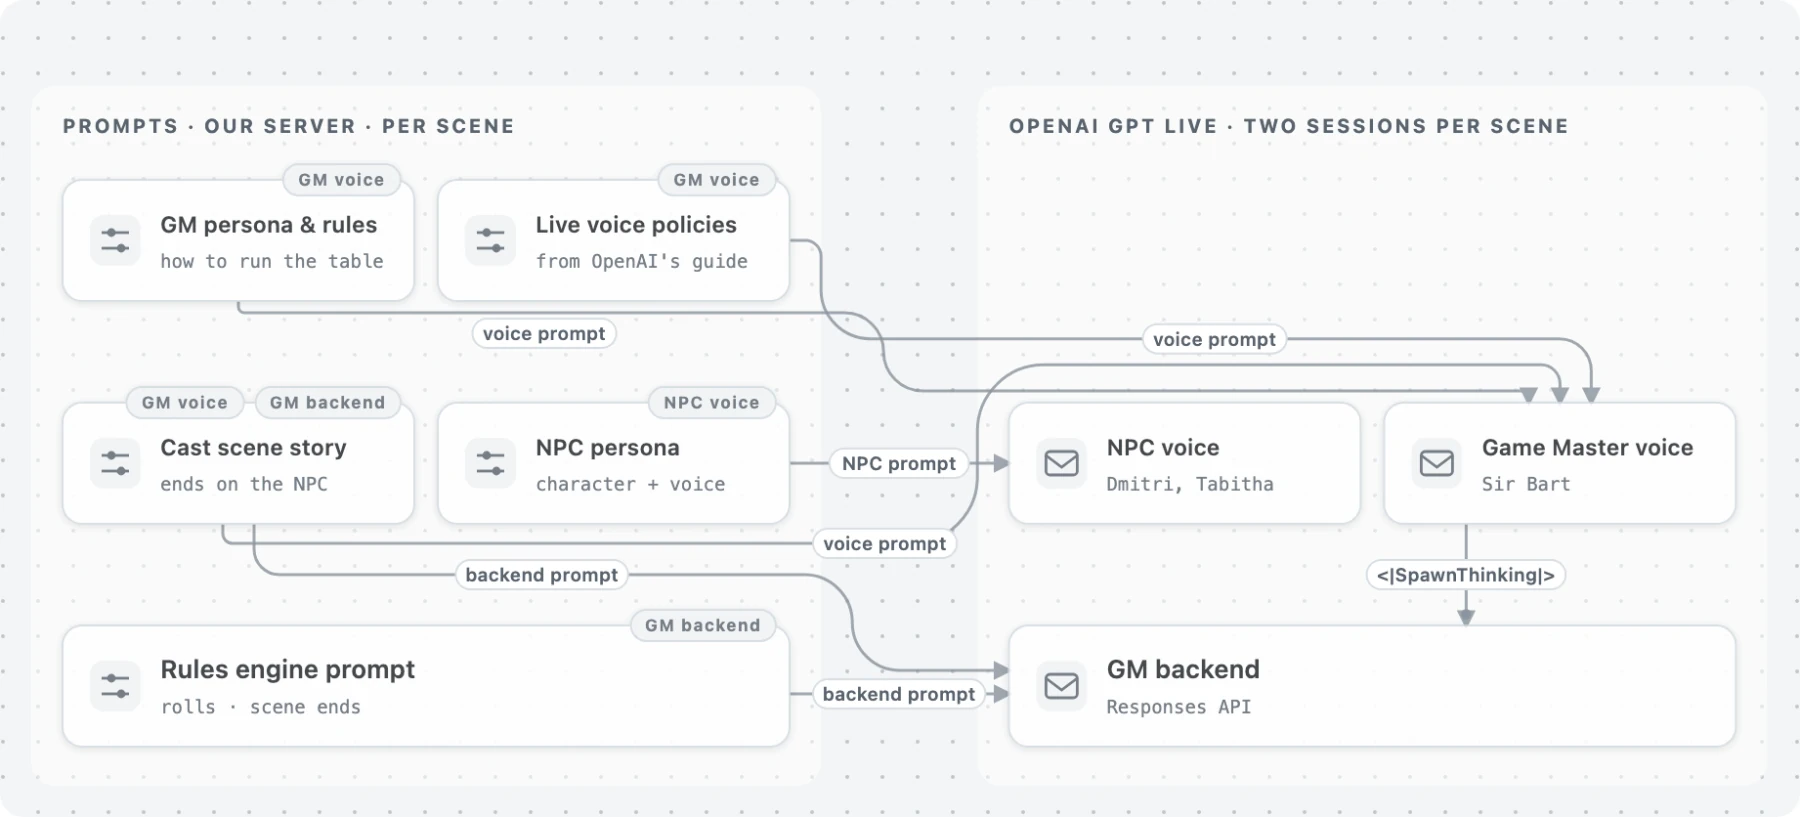
Structure des prompts. La voix de Sir Bart et son backend partagent la trame de la scène. Le personnage reçoit un prompt qui définit sa propre personnalité.
Extrait du prompt du personnage
Vous interprétez un rôle dans une scène qui se joue en direct, à l’oral.
Un narrateur décrit le monde. Vous parlez toujours à voix haute,
en votre seul nom et à la première personne.
- Ne racontez jamais la scène, ne décrivez jamais vos propres gestes
  ni votre voix et ne parlez jamais à la place des voyageurs
  ou du narrateur.
- Ne décidez jamais si une tentative risquée réussit.
  Réagissez en une courte réplique, puis arrêtez-vous.
  C’est le narrateur qui en détermine l’issue.
- Parlez uniquement lorsqu’un voyageur s’adresse à vous
  ou qu’on vous donne la parole.
Comment le metteur en scène choisit qui va parler
Sans produire lui-même de parole, le metteur en scène s’appuie sur les verdicts de l’API Decisions à mesure qu’arrivent les fragments de transcription. Il détermine ainsi à qui un joueur s’adresse, si une action nécessite un jet de dés et à quel moment la narration ou la dernière réplique d’un personnage invite à passer la parole.

Les verdicts évoluent pendant que le joueur parle. Pour identifier le destinataire, le metteur en scène attend que le verdict se stabilise à la fin du tour. En revanche, il transmet les actions risquées au maître du jeu dès qu’il les reconnaît.
Qui prend la parole ?
| Situation | Qui prend la parole ensuite ? |
|---|---|
| Sir Bart termine sa narration et le score du signal de passage de parole atteint au moins 0,6, ou sa réplique s’achève sur un verbe de parole (« Tabitha calls after you ») | Le personnage |
| Un joueur s’adresse au personnage alors que Sir Bart a la parole | Le personnage, qui reçoit la phrase à laquelle répondre |
| Un joueur tente une action risquée : soudoyer quelqu’un, mentir, passer en douce ou se battre | Sir Bart, immédiatement, même en milieu de phrase si nécessaire. Le metteur en scène déclenche le jet sur le backend de Sir Bart, qui en raconte l’issue puis rend la parole au personnage |
| Un joueur pose une question au narrateur ou décrit ce que fait son personnage | Sir Bart |
| Les joueurs discutent entre eux | Personne. La session qui a la parole reçoit une instruction ponctuelle lui indiquant de les laisser discuter |
| Le personnage prononce des mots qui concluent son intervention (« Allez-y, alors. Faites profil bas. ») | Sir Bart, une fois la réplique terminée. Le metteur en scène déclenche la fin de la scène sur le backend de Sir Bart |
| La session qui vient de recevoir la parole garde le silence pendant 2,5 s | La même session, que le metteur en scène sollicite à nouveau |
Passer la parole
Le passage de parole se déroule en quatre étapes :
- Le metteur en scène coupe le son de la session qui cède la parole, lui demande de s’arrêter et supprime l’audio qu’elle avait mis en file d’attente.
- Il transmet à la session qui prend la parole ce qu’elle a manqué, sous forme de contexte silencieux, avec
session.thinking.append. Il ajoute les mêmes répliques à son contexte Decisions pour que ses déclencheurs s’appuient sur le même historique. - Il réactive le son de la session qui prend la parole et lui donne le signal de commencer.
- Il maintient les micros des joueurs coupés jusqu’à ce que le nouvel intervenant ait prononcé sa première phrase, pendant 8 s au maximum, pour éviter que quelqu’un ne parle par-dessus lui au moment du relais.
Comme la session du personnage est déjà active, le premier son se fait entendre en moyenne 0,84 s après le passage de parole, contre 1,54 s lorsqu’il faut démarrer une nouvelle session.
Faire avancer la partie jusqu’à son dénouement
Les voix improvisent. L’application décide quand les événements se produisent.
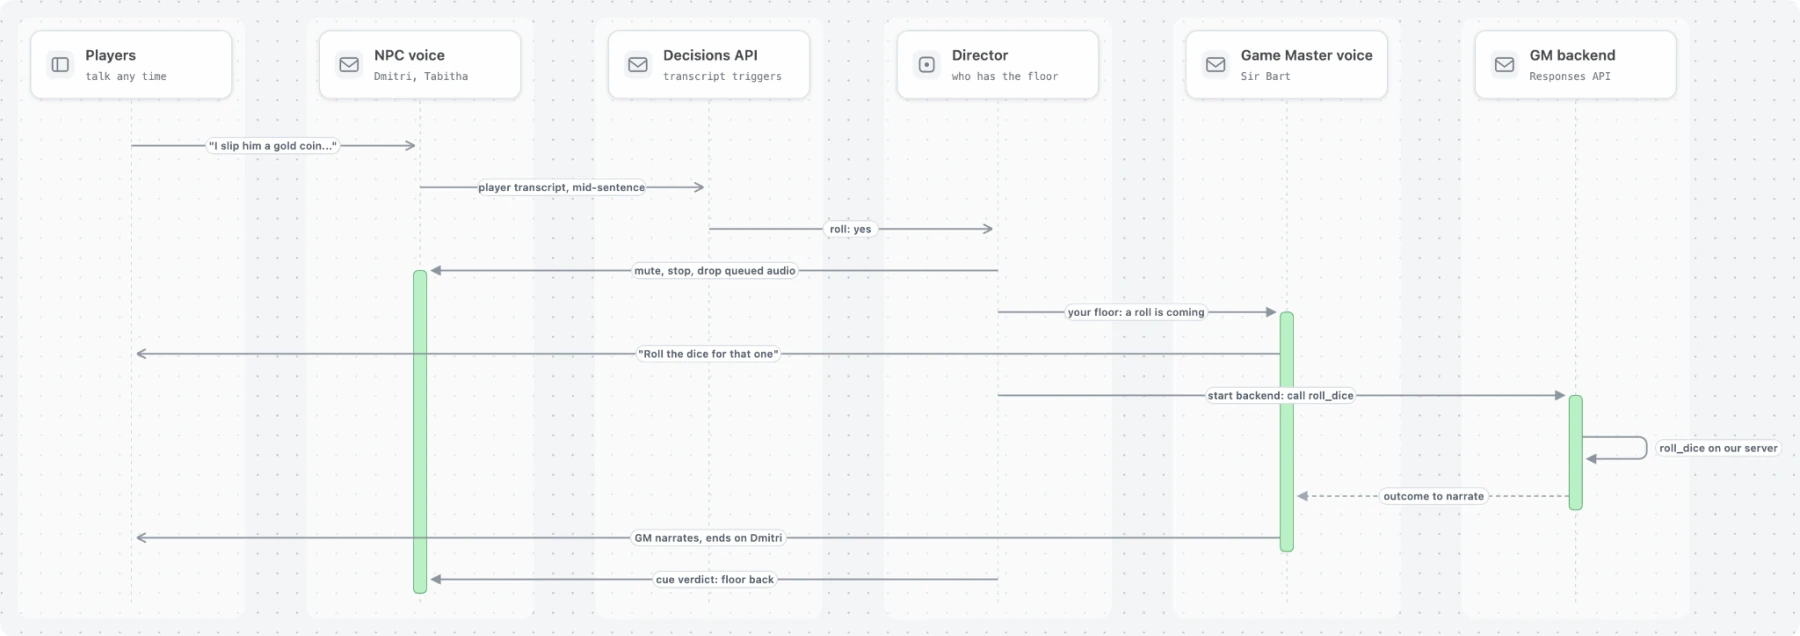
Un joueur tente de soudoyer Dmitri alors que celui-ci a la parole. Le verdict qui demande un jet de dés arrive en milieu de phrase. Le metteur en scène donne la parole à Sir Bart et déclenche le jet sur son backend. Une fois que Sir Bart en a raconté l’issue, un verdict de passage de parole rend la main à Dmitri.
- Le metteur en scène déclenche lui-même les jets et les fins de scène. Lors d’une partie de test, Sir Bart a dit « You’re going to have to roll the dice for that one », mais il n’a jamais passé la main à son backend. Aucun dé n’a été lancé, et Sir Bart a inventé le résultat. Désormais, le metteur en scène déclenche directement une réponse sur le backend de Sir Bart. La voix prononce une courte réplique pendant l’exécution, puis raconte le résultat.
- Les dés décident de l’issue de chaque scène. La scène 1 se termine sur un jet réussi. Si Dmitri cède avant le moindre jet, le metteur en scène soumet la tentative des joueurs aux dés au lieu de clore la scène.
- Un personnage peut terminer son intervention, et le maître du jeu clôt la scène. Quand Tabitha dit au groupe que Jade les retrouvera au Sprite Altar, le metteur en scène donne la parole à Sir Bart. Son backend marque la scène comme terminée et Sir Bart propose les deux chemins possibles pour poursuivre l’aventure.
Ce que nous en retenons
- Une seule session doit entendre les joueurs. Lorsque nos deux systèmes écoutaient, tous deux répondaient à chaque phrase de test, souvent en se contredisant. Dmitri refusait un pot-de-vin alors que le maître du jeu racontait qu’il le mettait dans sa poche.
- Couper le son d’une session ne suffit pas à la faire taire. Demandez-lui de s’arrêter et supprimez l’audio en attente. Quand elle reprend la parole, levez explicitement la consigne « Gardez le silence ». Encore soumis à cette règle, notre maître du jeu n’a répondu à personne pendant toute une scène.
- Gardez chaque session vocale active. La voix d’une session est fixée à son démarrage. Il faut donc une session par voix. Démarrer la session du personnage en début de scène permet de gagner environ 0,7 s à chaque passage de parole. C’est ce qui évite un silence gênant au moment du relais.
- Agissez au bon moment pour chaque verdict. Les verdicts arrivent pendant que le joueur parle encore. Le délai médian entre la fin de sa prise de parole et l’arrivée du dernier verdict est de 0,19 s. Transmettez une action risquée au maître du jeu dès qu’elle est reconnue. Pour déterminer à qui s’adressait une réplique, attendez la fin du tour de parole et la stabilisation du verdict.
- Formulez vos questions oui/non comme des prédicats, calibrez les seuils sur de vraies répliques et prévoyez une règle simple en secours. La question « Should Dmitri speak next? » a donné 11 bonnes réponses sur 12 sous forme de prédicat, contre 8 sur 12 sous forme de choix entre deux options. Avec un seuil de 0,4, la phrase « You’re going to have to roll the dice for that one » a été interprétée comme un signal de passage de parole. Dmitri a donc repris la main en plein jet de dés. Les vrais signaux obtenaient un score d’au moins 0,94, et nous avons retenu un seuil de 0,6. Comme « Tabitha calls after you » n’a obtenu que 0,04, nous vérifions aussi la présence d’un verbe de parole pour repérer les passages où la narration s’arrête précisément au moment où le personnage doit s’exprimer.
- Confiez chaque résultat à un seul responsable. Seul le backend du maître du jeu appelle des outils, et c’est l’application qui déclenche les jets et les fins de scène. Chaque personnage peut ainsi improviser librement tout en respectant les règles du jeu.
À propos des auteurs et de l’entreprise
L’équipe de Weekend développe Wit’s End, un jeu de rôle sur table dans un univers de fantasy, conçu pour se jouer à la voix. Un maître du jeu incarné par une IA mène l’histoire et les joueurs n’ont qu’à parler, depuis leur navigateur ou leur téléviseur. Vous pouvez y jouer sur witsend.ai.
Weekend, anciennement Volley, crée des jeux à commande vocale pour la télévision, pour que les familles puissent jouer ensemble à voix haute devant leur écran. Son catalogue de plus de 25 jeux, dont Jeopardy!, Wheel of Fortune, Song Quiz et Wit’s End, est disponible sur Roku, Fire TV et les téléviseurs Samsung et LG. Plus de 30 millions de foyers y ont déjà joué. Weekend bénéficie du soutien de M12, le fonds de Microsoft, de Lightspeed Venture Partners et de Y Combinator.
Quelles perspectives pour les agents vocaux ?
La prochaine étape va au-delà de la qualité de la conversation. Il s’agit de créer des logiciels qui continuent d’écouter pendant l’exécution d’une tâche, conservent le contexte d’une interface à l’autre et coordonnent plusieurs voix sans perdre le fil. Parce que GPT-Live peut écouter et parler simultanément, les développeurs peuvent concevoir des expériences qui suivent le rythme de la conversation, sans obliger les utilisateurs à attendre leur tour.
Ces quatre témoignages montrent ce que cela demande en pratique. Juno teste ses voix auprès des personnes qui les utilisent. Picsart synchronise la conversation avec le travail en arrière-plan. Treater tire des enseignements d’appels réels. Weekend donne une voix à chaque personnage tout en gardant la maîtrise du jeu.
GPT-Live offre un moyen intuitif d’interagir avec les logiciels et élargit les possibilités des agents. On peut préciser une idée créative en parlant, orienter un travail en cours ou entrer dans une histoire et en influencer la suite. Ces projets donnent un premier aperçu de ce que les développeurs peuvent créer lorsque la conversation fait partie du fonctionnement même d’un logiciel.
Pour commencer à créer votre propre expérience, consultez le guide de démarrage de GPT-Live et la documentation sur la délégation et les outils.