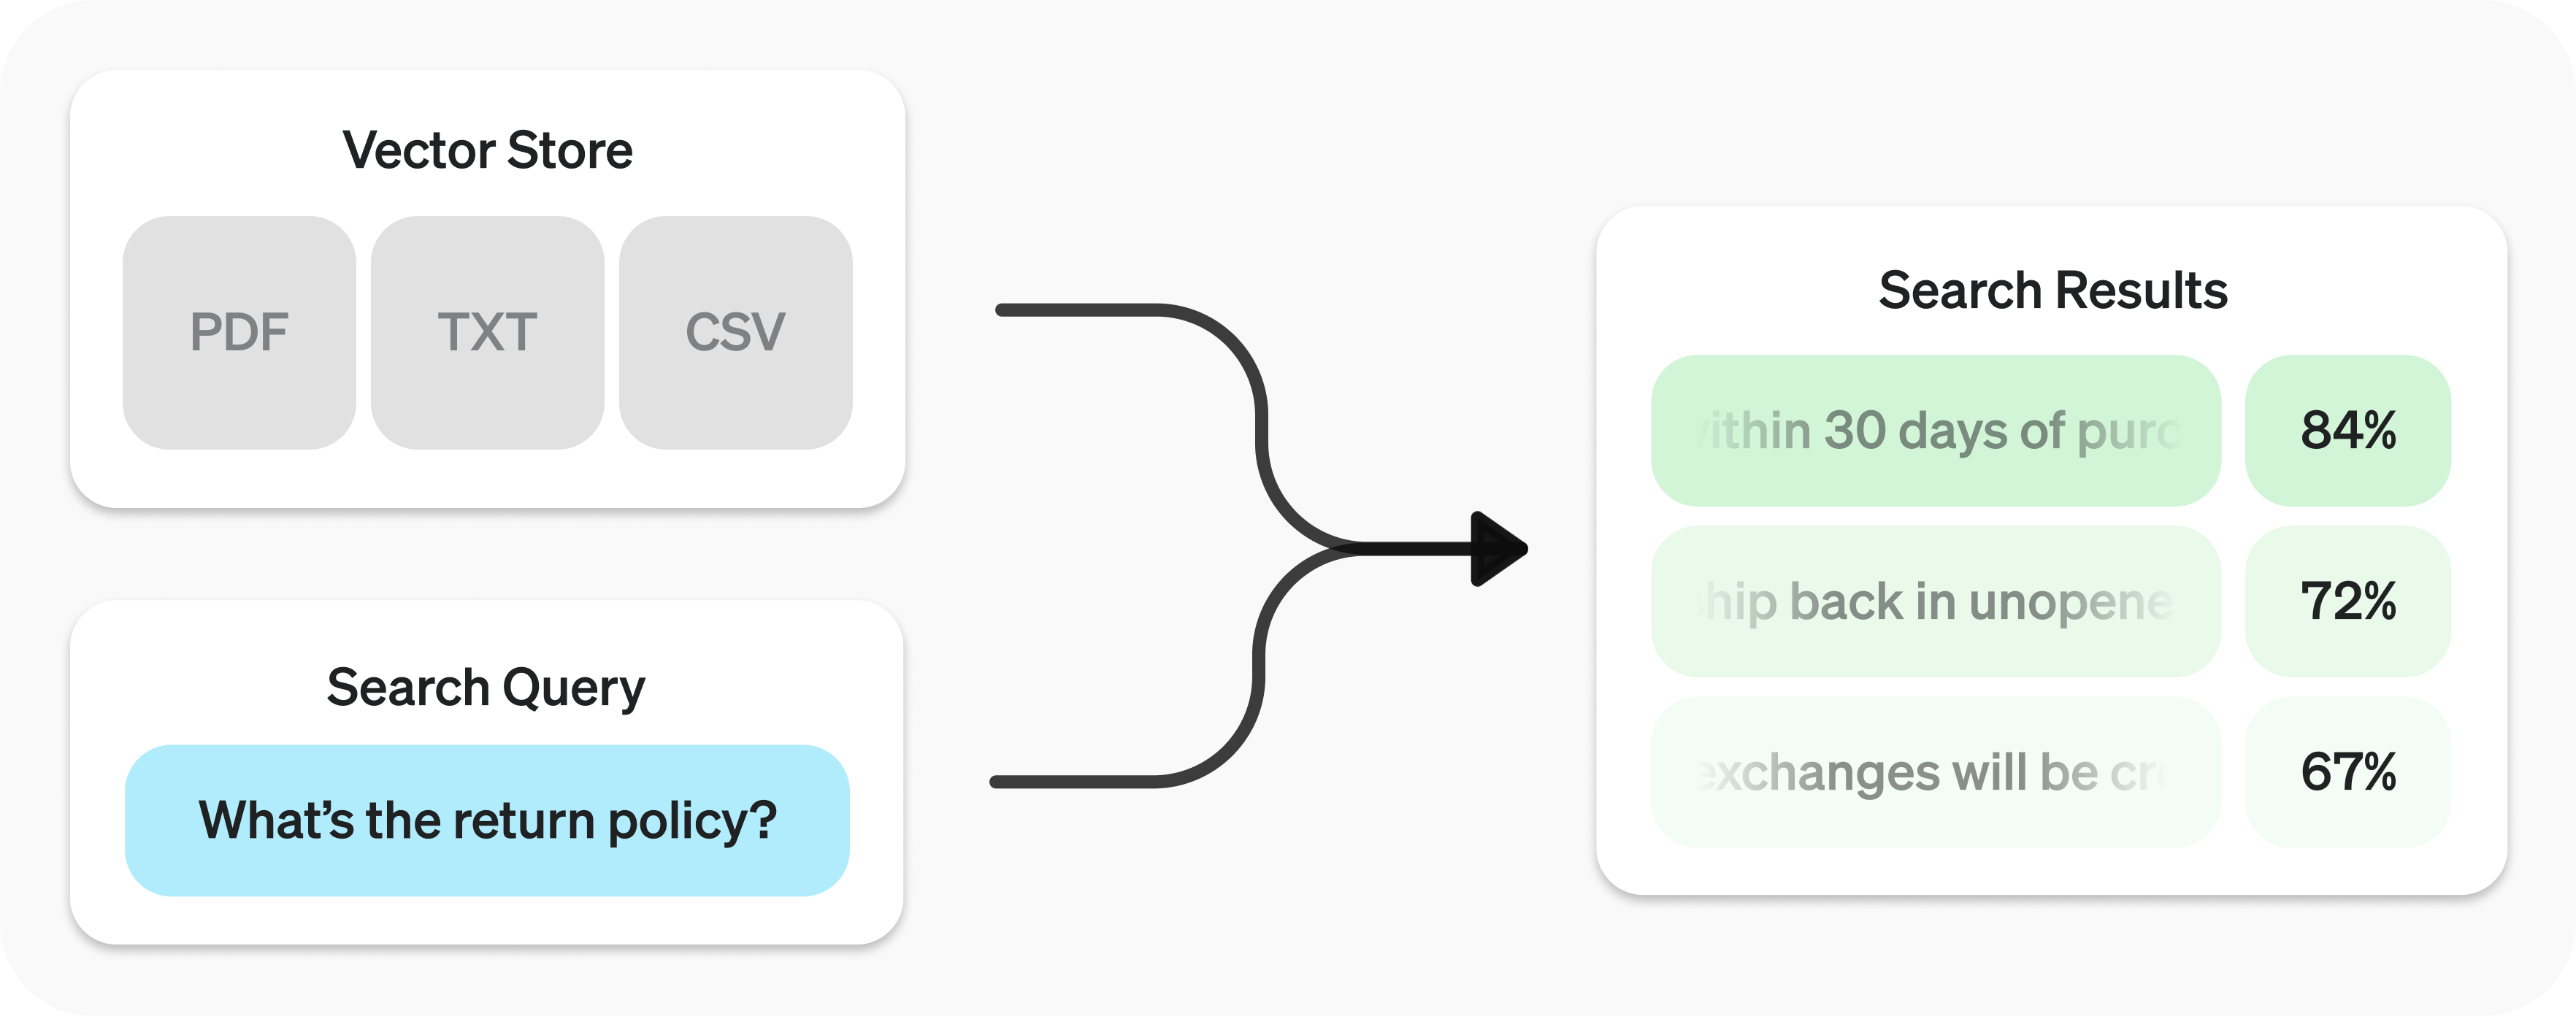
Recherchez des informations dans vos données par similarité sémantique.
L’API Retrieval permet d’effectuer une recherche sémantique dans vos données. Cette technique trouve des résultats proches de la requête par leur sens, même s’ils n’ont que peu de mots-clés en commun avec elle, voire aucun. La recherche d’informations est utile en elle-même, mais elle est particulièrement efficace lorsque nos modèles s’appuient sur les résultats pour formuler une réponse.
L’API Retrieval s’appuie sur des bases vectorielles qui servent d’index pour vos données. Ce guide explique comment effectuer une recherche sémantique, puis présente en détail le fonctionnement des bases vectorielles.
Démarrage rapide
Créez une base vectorielle et importez-y des fichiers.
1
2
3
4
5require "openai"client = OpenAI::Client.newresults = client.vector_stores.search("vs_123", query: "What is the return policy?")puts(results.data&.first&.content)
Pour savoir comment utiliser les résultats avec nos modèles, consultez la section Synthèse des réponses.
Recherche sémantique
La recherche sémantique utilise des représentations vectorielles pour trouver des résultats pertinents en fonction de leur sens. Elle peut ainsi trouver des résultats qui ont peu ou pas de mots-clés en commun avec la requête et qui pourraient échapper aux méthodes de recherche classiques.
Voici quelques résultats possibles pour la requête "When did we go to the moon?" (« Quand sommes-nous allés sur la Lune ? »). Les scores correspondent aux textes en anglais.
Texte
Similarité des mots-clés
Similarité sémantique
Le premier alunissage a eu lieu en juillet 1969.
0 %
65 %
Le premier homme à avoir marché sur la Lune était Neil Armstrong.
27 %
43 %
Quand j’ai mangé le gâteau de lune, je l’ai trouvé délicieux.
Dans cet exemple en anglais, le résultat le plus pertinent ne contient aucun des mots de la requête. Cette souplesse rend la recherche sémantique particulièrement efficace pour interroger des bases de connaissances de toute taille.
La recherche sémantique s’appuie sur des bases vectorielles, décrites en détail plus loin dans ce guide. Cette section explique comment fonctionne la recherche sémantique.
Effectuer une recherche sémantique
Pour interroger une base vectorielle, appelez la fonction search en lui passant une requête query en langage naturel. La fonction renvoie une liste de résultats. Chacun indique les segments pertinents, leurs scores de similarité et leur fichier d’origine.
Requête de recherche
Python
1
2
3const results = await client.vectorStores.search(vector_store.id, { query: "How many woodchucks are allowed per passenger?",});
1
2
3
4results = client.vector_stores.search(vector_store_id=vector_store.id,query="How many woodchucks are allowed per passenger?",)
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "How many woodchucks are allowed per passenger?")puts(results.data&.first&.content)
Résultats
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42{"object": "vector_store.search_results.page","search_query": "How many woodchucks are allowed per passenger?","data": [ {"file_id": "file-12345","filename": "woodchuck_policy.txt","score": 0.85,"attributes": {"region": "North America","author": "Wildlife Department" },"content": [ {"type": "text","text": "According to the latest regulations, each passenger is allowed to carry up to two woodchucks." }, {"type": "text","text": "Ensure that the woodchucks are properly contained during transport." } ] }, {"file_id": "file-67890","filename": "transport_guidelines.txt","score": 0.75,"attributes": {"region": "North America","author": "Transport Authority" },"content": [ {"type": "text","text": "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks." } ] } ],"has_more": false,"next_page": null}
Par défaut, une réponse contient au maximum 10 résultats. Vous pouvez porter cette limite à 50 avec le paramètre max_num_results.
Reformulation des requêtes
Certaines formulations donnent de meilleurs résultats. Pour optimiser la recherche, activez la reformulation automatique de vos requêtes en définissant rewrite_query=true lors d’un appel à search.
Vous trouverez la requête reformulée dans le champ search_query du résultat.
Requête initiale
Requête reformulée
J’aimerais connaître la hauteur du bâtiment principal des bureaux.
hauteur bâtiment principal bureaux
Quelles règles de sécurité s’appliquent au transport de matières dangereuses ?
règles de sécurité matières dangereuses
Comment déposer une réclamation pour un problème de service ?
procédure de réclamation service
Filtrage par attributs
Le filtrage par attributs permet de cibler les résultats en appliquant des critères, par exemple en limitant la recherche à une période donnée. Dans filters, vous pouvez définir et combiner des critères pour sélectionner les fichiers selon leurs attributs avant d’effectuer la recherche sémantique.
Utilisez des filtres de comparaison pour comparer la valeur d’une clé key dans les attributes d’un fichier à une valeur value donnée. Utilisez des filtres composés pour combiner plusieurs filtres avec and et or.
Filtre de comparaison
1
2
3
4
5{"type": "eq"|"ne"|"gt"|"gte"|"lt"|"lte"|"in"|"nin", // comparison operators"key": "attributes_key", // attributes key"value": "target_value"// value to compare against}
Les exemples de filtrage par nom de fichier utilisent un attribut personnalisé filename que vous devez définir explicitement pour chaque fichier de la base vectorielle, par exemple {"filename": "example.txt"}. Ces filtres ne prennent pas automatiquement en compte le nom du fichier importé.
Si les résultats de la recherche dans vos fichiers manquent de pertinence, ajustez les options ranking_options pour améliorer la qualité des réponses. Vous pouvez notamment choisir un ranker, par exemple auto ou default-2024-08-21, et définir un score_threshold entre 0,0 et 1,0. Un score_threshold plus élevé ne retient que les segments les plus pertinents, au risque d’écarter des segments potentiellement utiles. Si vous spécifiez ranking_options.hybrid_search, vous pouvez également ajuster hybrid_search.embedding_weight (rrf_embedding_weight) et hybrid_search.text_weight (rrf_text_weight). Ces poids déterminent comment la fusion des classements par rang réciproque combine les correspondances sémantiques issues des représentations vectorielles et les correspondances de mots-clés issues des représentations creuses. Augmentez le premier poids pour privilégier la similarité sémantique ou le second pour privilégier les termes communs. Vérifiez qu’au moins l’un des deux poids est strictement positif.
Bases vectorielles
Les bases vectorielles sont les conteneurs sur lesquels s’appuient l’API Retrieval et l’outil de recherche dans les fichiers pour effectuer des recherches sémantiques. Lorsque vous ajoutez un fichier à une base vectorielle, son contenu est automatiquement découpé en segments, puis chaque segment est converti en représentation vectorielle et indexé.
Les bases vectorielles contiennent des objets vector_store_file, chacun associé à un objet file sous-jacent.
Type d’objet
Description
file
Représente le contenu importé via l’API Files. Cet objet sert souvent dans les bases vectorielles, mais aussi pour le fine-tuning et d’autres usages.
vector_store
Conteneur de fichiers dans lesquels vous pouvez effectuer des recherches.
vector_store.file
Type qui encapsule un objet file dont le contenu a été découpé en segments et converti en représentations vectorielles, et qui a été associé à un objet vector_store. Contient le dictionnaire attributes utilisé pour le filtrage.
Tarification
La facturation dépend du stockage total utilisé par l’ensemble de vos bases vectorielles. Ce volume correspond à la taille des segments obtenus après analyse des fichiers et de leurs représentations vectorielles.
Opérations sur les fichiers d’une base vectorielle
Certaines opérations, comme create pour vector_store.file, sont asynchrones et peuvent prendre du temps. Pour attendre la fin d’une opération avant de poursuivre l’exécution, utilisez une fonction utilitaire comme create_and_poll. Vous pouvez aussi vérifier l’état de l’opération. La suppression d’un fichier dans une base vectorielle se propage progressivement. Les résultats de recherche peuvent donc encore inclure du contenu du fichier pendant un court moment après sa suppression.
Pour créer un lot, vous pouvez fournir file_ids et, si nécessaire, attributes, chunking_strategy ou les deux. Vous pouvez aussi utiliser le tableau files pour transmettre un objet par fichier. Chaque objet contient un file_id et peut inclure attributes et chunking_strategy. Ces deux méthodes s’excluent mutuellement. La première applique les mêmes paramètres à tous les fichiers, tandis que la seconde permet de les personnaliser pour chaque fichier.
Pour augmenter le débit d’importation dans une même base vectorielle, nous recommandons de créer des lots chaque fois que possible. Un lot peut contenir jusqu’à 500 fichiers dans une seule requête. Cela réduit généralement la contention et la latence de bout en bout par rapport à l’envoi de nombreuses requêtes de création portant chacune sur un seul fichier.
Attributs
Chaque objet vector_store.file peut être associé à un dictionnaire attributes dont les valeurs peuvent servir lors d’une recherche sémantique avec filtrage par attributs. Ce dictionnaire accepte jusqu’à 16 clés, chacune limitée à 256 caractères.
Créer un fichier avec des attributs dans une base vectorielle
Vous pouvez définir une politique d’expiration pour les objets vector_store avec expires_after. À l’expiration d’une base vectorielle, tous les objets vector_store.file associés sont supprimés et leur facturation prend fin.
Définir une politique d’expiration pour une base vectorielle
La taille maximale d’un fichier est de 512 Mo. Chaque fichier doit contenir au maximum 5 000 000 de tokens. Ce nombre est calculé automatiquement lorsque vous joignez le fichier.
Découpage en segments
Par défaut, max_chunk_size_tokens vaut 800 et chunk_overlap_tokens vaut 400. Pour l’indexation, chaque fichier est donc découpé en segments de 800 tokens, avec un chevauchement de 400 tokens entre deux segments consécutifs.
Vous pouvez modifier ce découpage en définissant chunking_strategy lors de l’ajout de fichiers à la base vectorielle. Les limites suivantes s’appliquent :
max_chunk_size_tokens doit être compris entre 100 et 4 096 inclus.
chunk_overlap_tokens doit être supérieur ou égal à zéro et ne devrait pas dépasser max_chunk_size_tokens / 2.
Pour les types MIME text/, l’encodage doit être utf-8, utf-16 ou ascii.
Après une recherche, vous pouvez utiliser nos modèles pour formuler une réponse à partir des résultats. Transmettez au modèle les résultats et la requête initiale pour obtenir une réponse fondée sur les informations trouvées.
Exécuter la requête de recherche pour obtenir les résultats
Python
1
2
3
4
5
6
7
8
9import OpenAI from "openai";const client = new OpenAI();const userQuery = "What is the return policy?";const results = await client.vectorStores.search(vector_store.id, { query: userQuery,});
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "What is the return policy?")puts(results.data)
Formuler une réponse à partir des résultats
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22const formattedResults = formatResults(results.data);// Join the text content of all resultsconst textSources = results.data .map((result) => result.content.map((c) => c.text).join("\n")) .join("\n");const completion = await client.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "developer", content: "Produce a concise answer to the query based on the provided sources.", }, { role: "user", content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`, }, ],});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20# Use results and user_query from the preceding search step.formatted_results = format_results(results.data)"\n".join("\n".join(c.text for c in result.content) for result in results.data)completion = client.chat.completions.create(model="gpt-6-astra",messages=[ {"role": "developer","content": "Produce a concise answer to the query based on the provided sources.", }, {"role": "user","content": f"Sources: {formatted_results}\n\nQuery: '{user_query}'", }, ],)print(completion.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46package mainimport ( "context" "fmt" "strings" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() userQuery := "What is the return policy?" results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{ Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)}, }) if err != nil { panic(err) } completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."), openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}func formatResults(results []openai.VectorStoreSearchResponse) string { var sources strings.Builder sources.WriteString("<sources>") for _, result := range results { fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename) for _, content := range result.Content { fmt.Fprintf(&sources, "<content>%s</content>", content.Text) } sources.WriteString("</result>") } sources.WriteString("</sources>") return sources.String()}