
Comment obtenir des réponses plus exactes et un comportement plus constant avec les LLM
Optimiser un LLM est difficile.
Nous avons travaillé avec de nombreux développeurs, aussi bien en start-up que dans de grandes entreprises. Trois questions reviennent régulièrement :
- Par où commencer pour améliorer la précision ?
- Quelle méthode d’optimisation choisir, et quand ?
- Quel niveau de précision est suffisant pour la production ?
Ce guide propose un cadre de réflexion pour améliorer la précision des LLM et ajuster leur comportement. Nous examinerons l’ingénierie de prompts, la génération augmentée par récupération (RAG) et le fine-tuning. Nous verrons comment et quand utiliser chaque technique, ainsi que quelques pièges à éviter.
Au fil de votre lecture, gardez à l’esprit ce que signifie la précision dans votre cas d’usage. Cela peut sembler évident, mais un texte mal rédigé qu’une personne doit corriger n’a pas les mêmes conséquences qu’un remboursement de 1 000 $ au lieu de 100 $. Avant toute discussion sur la précision d’un LLM, estimez ce que vous coûte un échec et ce qu’une réussite vous fait économiser ou gagner. Nous y reviendrons à la fin du guide pour déterminer quel niveau de précision est « suffisant » en production.
Comment aborder l’optimisation des LLM
De nombreux guides pratiques présentent l’optimisation comme une simple succession d’étapes : d’abord l’ingénierie de prompts, puis la génération augmentée par récupération, et enfin le fine-tuning. Dans la pratique, ces techniques répondent à des problèmes différents. Pour progresser, il faut choisir celle qui répond au problème rencontré.
Il est utile de représenter l’optimisation des LLM sous la forme d’une matrice :

Pour une tâche typique, on commence en bas à gauche par l’ingénierie de prompts. On fait des essais, on en tire des enseignements et on évalue les résultats pour établir un point de référence. Une fois les exemples examinés et les causes des erreurs identifiées, on peut agir sur l’un des deux axes :
- Optimisation du contexte : travaillez sur le contexte lorsque 1) le modèle ne dispose pas des connaissances nécessaires parce qu’elles ne figuraient pas dans ses données d’entraînement, 2) ses connaissances sont obsolètes ou 3) la tâche exige des informations propriétaires. Cet axe vise à maximiser l’exactitude des réponses.
- Optimisation du LLM : travaillez sur le modèle lorsque 1) ses résultats varient et leur format est incorrect, 2) le ton ou le style employé ne convient pas ou 3) le modèle ne suit pas systématiquement le raisonnement attendu. Cet axe vise à maximiser la constance du comportement.
En pratique, l’optimisation se déroule en plusieurs étapes. On évalue les résultats, on formule une hypothèse sur la manière de les améliorer, on la met à l’épreuve, puis on réévalue les résultats pour choisir la prochaine étape. Voici un parcours assez courant :
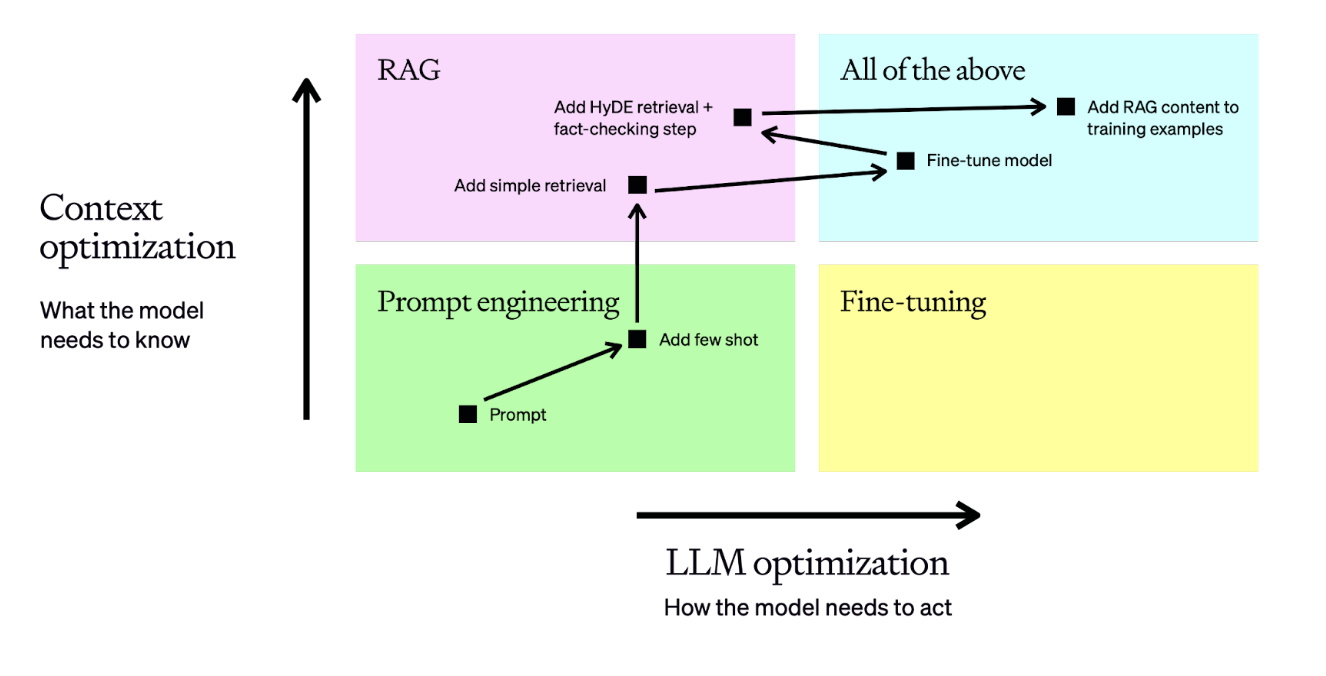
Dans cet exemple, nous procédons ainsi :
- Nous commençons par un prompt et évaluons ses performances.
- Nous ajoutons des exemples few-shot fixes pour obtenir des résultats plus constants.
- Nous ajoutons une étape de récupération pour sélectionner dynamiquement les exemples few-shot en fonction de la question. Le modèle dispose ainsi d’un contexte pertinent pour chaque entrée, ce qui améliore ses performances.
- Nous préparons un jeu de données d’au moins 50 exemples et effectuons le fine-tuning d’un modèle pour obtenir un comportement plus constant.
- Nous ajustons la récupération et ajoutons une étape de vérification des faits pour détecter les hallucinations et gagner en précision.
- Nous reprenons l’entraînement du modèle issu du fine-tuning avec les nouveaux exemples, qui intègrent désormais les données fournies par notre système RAG amélioré.
Ce processus d’optimisation est assez courant face à un problème métier difficile. Il nous aide à déterminer si le modèle a besoin d’un contexte plus pertinent ou si son comportement doit gagner en constance. Une fois ce diagnostic posé, nous savons sur quoi agir en premier.
Voyons maintenant comment intervenir sur chacun de ces axes. Commençons en bas à gauche de la matrice, par l’ingénierie de prompts.
Ingénierie de prompts
L’ingénierie de prompts est généralement le meilleur point de départ**. Elle suffit souvent pour des tâches comme la synthèse de texte, la traduction ou la génération de code, pour lesquelles une approche zero-shot peut atteindre le niveau de précision et de constance requis en production.
Cette démarche vous oblige à définir ce qu’est une réponse exacte dans votre cas d’usage. Au départ, vous fournissez simplement une entrée et devez pouvoir juger si la sortie correspond à vos attentes. Si elle ne vous convient pas, cherchez pourquoi : la réponse vous indiquera comment poursuivre l’optimisation.
Commencez toujours par un prompt simple, avec une idée du résultat attendu. Enrichissez ensuite le prompt en ajoutant du contexte, des instructions ou des exemples jusqu’à obtenir le résultat souhaité.
Optimisation
Pour optimiser les prompts, je m’appuierai principalement sur les stratégies du guide d’ingénierie de prompts de la documentation de l’API OpenAI. Chacune permet d’agir sur le contexte, sur le LLM ou sur les deux :
| Stratégie | Optimisation du contexte | Optimisation du LLM |
|---|---|---|
| Rédigez des instructions claires | X | |
| Divisez les tâches complexes en sous-tâches plus simples | X | X |
| Laissez aux modèles GPT le temps de « réfléchir » | X | |
| Testez systématiquement les modifications | X | X |
| Fournissez un texte de référence | X | |
| Utilisez des outils externes | X |
Pour voir comment ces stratégies fonctionnent en pratique, essayons-les sur un cas concret : la correction de phrases en islandais avec gpt-4-turbo.
L’ingénierie de prompts constitue donc un bon point de départ. Avec des ajustements appropriés, elle permet déjà d’améliorer sensiblement les performances.
Sa principale limite apparaît quand on cherche à l’appliquer à plus grande échelle. Pour traiter une plus grande diversité de problèmes, il faut parfois fournir un contexte dynamique, car ajouter du contenu fixe au prompt ne suffit plus. Dans d’autres cas, il faut obtenir un comportement plus constant que ne le permettent les exemples few-shot.
Les modèles à contexte long permettent d’aller plus loin dans l’ingénierie de prompts. Attention toutefois : face à un très long prompt contenant des instructions complexes, un modèle peut avoir du mal à maintenir son attention. Évaluez toujours ces modèles avec différentes tailles de contexte pour vérifier qu’ils ne perdent pas de vue les informations situées au milieu. Ce phénomène tient au fait qu’un LLM ne peut pas accorder simultanément la même attention à tous les tokens qui lui sont fournis. Il peut ainsi manquer certaines informations de façon apparemment aléatoire. Vous pouvez utiliser un contexte long, à condition de l’évaluer soigneusement. Greg Kamradt, contributeur open source, a conçu un test appelé Needle in A Haystack (NITA). Il a placé une information à différentes profondeurs dans de longs documents, puis évalué la capacité du modèle à la retrouver. Ce test illustre la difficulté : placer toutes les informations dans le contexte simplifie considérablement la récupération, mais peut faire perdre en précision.
Jusqu’où pouvez-vous aller avec l’ingénierie de prompts ? Cela dépend de votre cas d’usage. Les évaluations vous permettront d’en juger.
Évaluation
À ce stade, le meilleur résultat est donc un bon prompt accompagné d’un jeu de questions d’évaluation et de leurs réponses de référence. Avec au moins 20 paires question-réponse, une analyse détaillée des échecs et une hypothèse sur leurs causes, vous disposez d’un point de référence solide pour essayer des méthodes d’optimisation plus avancées.
Avant de passer à ces méthodes, cherchez aussi comment automatiser l’évaluation pour accélérer les itérations. Voici deux pratiques courantes qui ont fait leurs preuves :
- Utilisez des méthodes comme ROUGE ou BERTScore pour obtenir une première estimation. Ces scores sont assez peu corrélés au jugement humain, mais ils permettent de mesurer rapidement à quel point une modification a changé les sorties du modèle.
- Utilisez GPT-4 comme évaluateur selon la méthode décrite dans l’article G-Eval. Fournissez au LLM une grille de notation pour qu’il évalue la sortie aussi objectivement que possible.
Pour approfondir ces méthodes, consultez cet exemple du Cookbook, qui les met toutes en pratique.
Comprendre les outils
Vous avez travaillé sur vos prompts et constitué un jeu d’évaluation, mais votre modèle n’accomplit toujours pas la tâche comme prévu. Il faut maintenant déterminer où il échoue et quel outil convient le mieux pour y remédier.
Voici une façon simple de poser ce diagnostic :
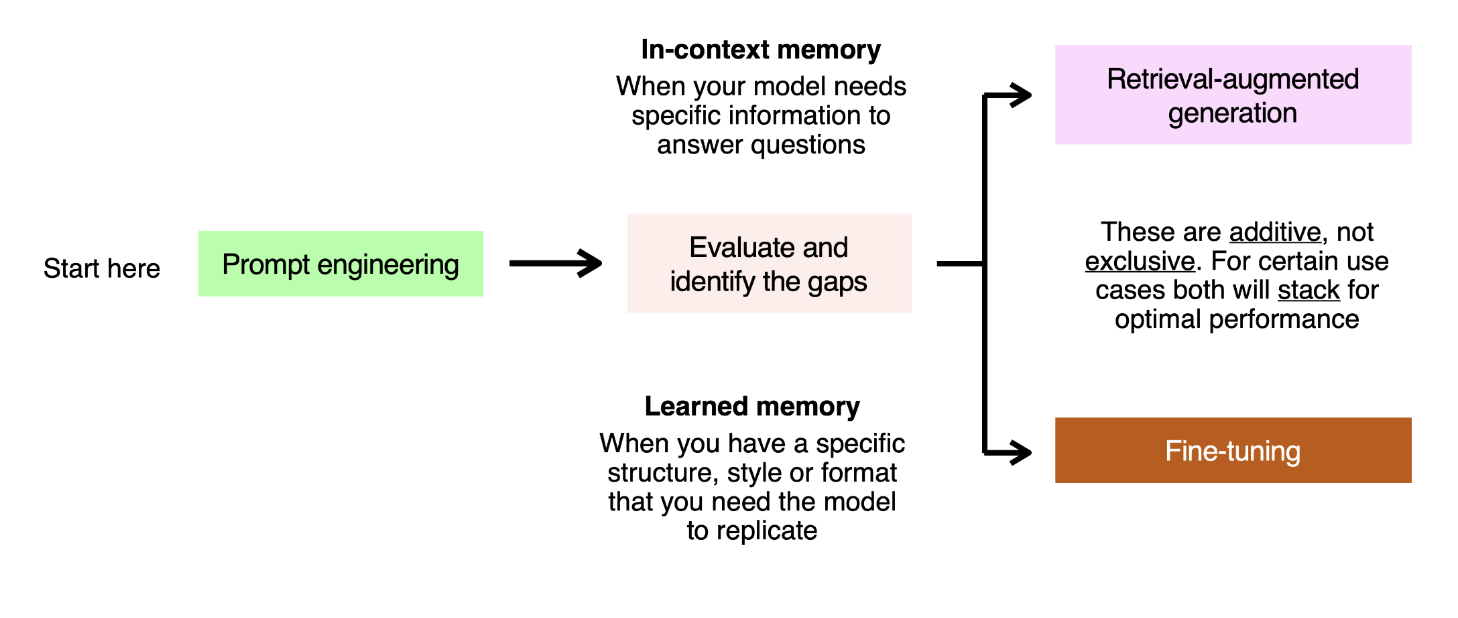
Pour chaque question à laquelle le modèle a mal répondu, demandez-vous si le problème vient de la mémoire en contexte ou de la mémoire acquise. Imaginez que vous passiez un examen. Vous avez deux moyens de trouver la bonne réponse :
- Vous avez suivi les cours pendant six mois et étudié de nombreux exemples illustrant le même concept. C’est la mémoire acquise. Pour qu’un LLM apprenne de cette manière, montrez-lui des exemples de prompts accompagnés des réponses attendues.
- Vous avez le manuel avec vous et pouvez y chercher les informations nécessaires pour répondre à la question. C’est la mémoire en contexte. Avec un LLM, on fournit les informations pertinentes dans la fenêtre de contexte, soit de manière statique grâce à l’ingénierie de prompts, soit à grande échelle grâce au RAG.
Ces deux méthodes d’optimisation se complètent et peuvent se combiner. Dans certains cas, il faudra les utiliser ensemble pour obtenir les meilleures performances.
Supposons que le problème relève de la mémoire à court terme. Nous utiliserons le RAG pour le résoudre.
Génération augmentée par récupération (RAG)
Le RAG consiste à récupérer du contenu pour enrichir le prompt du LLM avant de générer une réponse. Il donne au modèle accès à un contexte propre au domaine pour accomplir sa tâche.
Le RAG est particulièrement utile pour améliorer la précision et la constance d’un LLM. Chez OpenAI, bon nombre des déploiements les plus importants chez nos clients reposent uniquement sur l’ingénierie de prompts et le RAG.
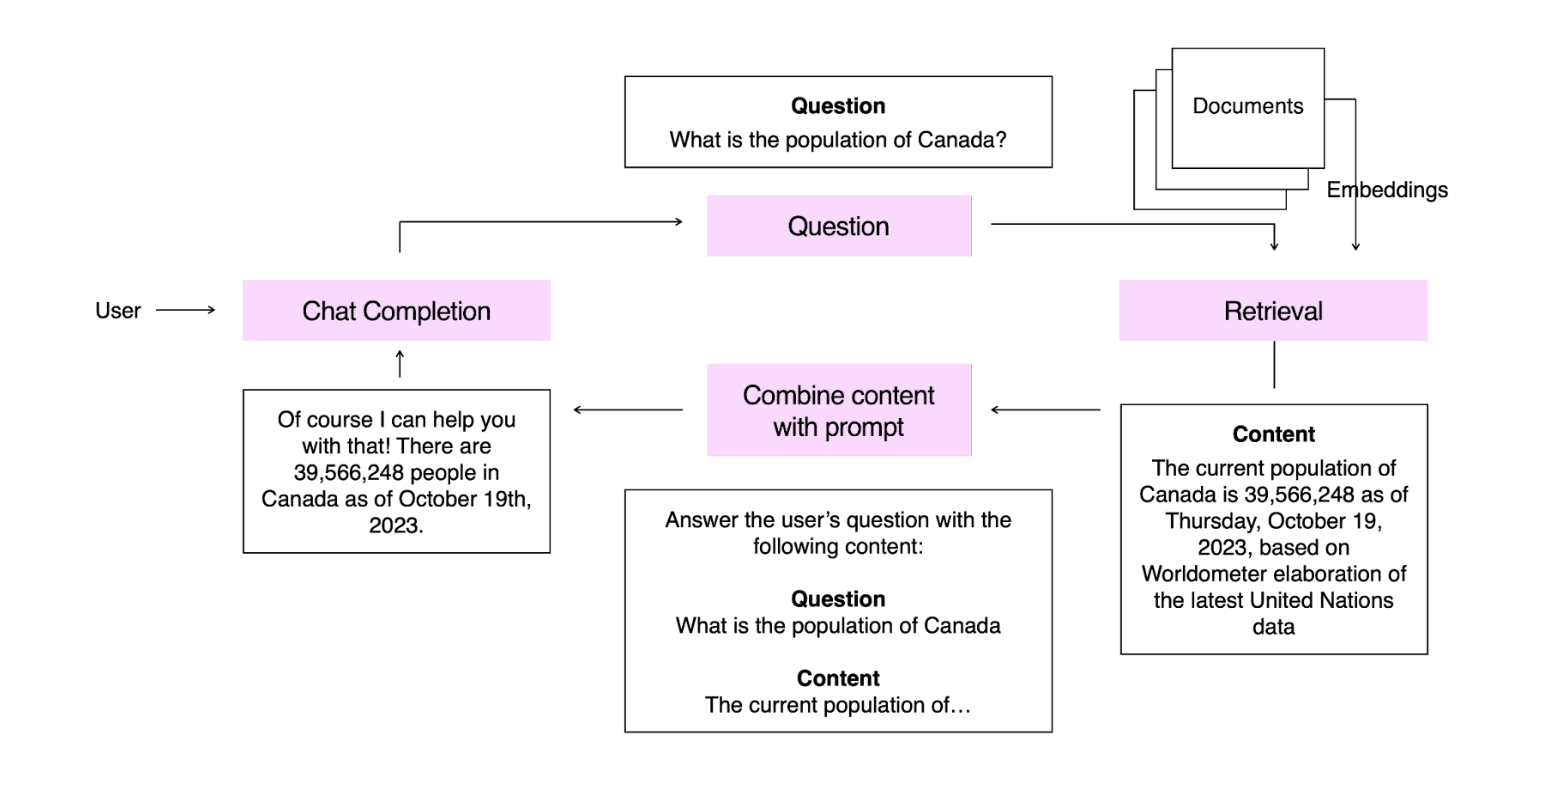
Dans cet exemple, nous avons converti le contenu d’une base de connaissances statistiques en vecteurs. Lorsqu’un utilisateur pose une question, nous la convertissons également en vecteur et récupérons les éléments les plus pertinents dans la base. Nous les transmettons au modèle, qui répond à la question.
Les applications RAG introduisent un nouvel axe d’optimisation : la récupération. Pour que le RAG fonctionne, nous devons fournir le bon contexte au modèle, puis vérifier si celui-ci répond correctement. La grille suivante permet d’aborder simplement l’évaluation d’un système RAG :
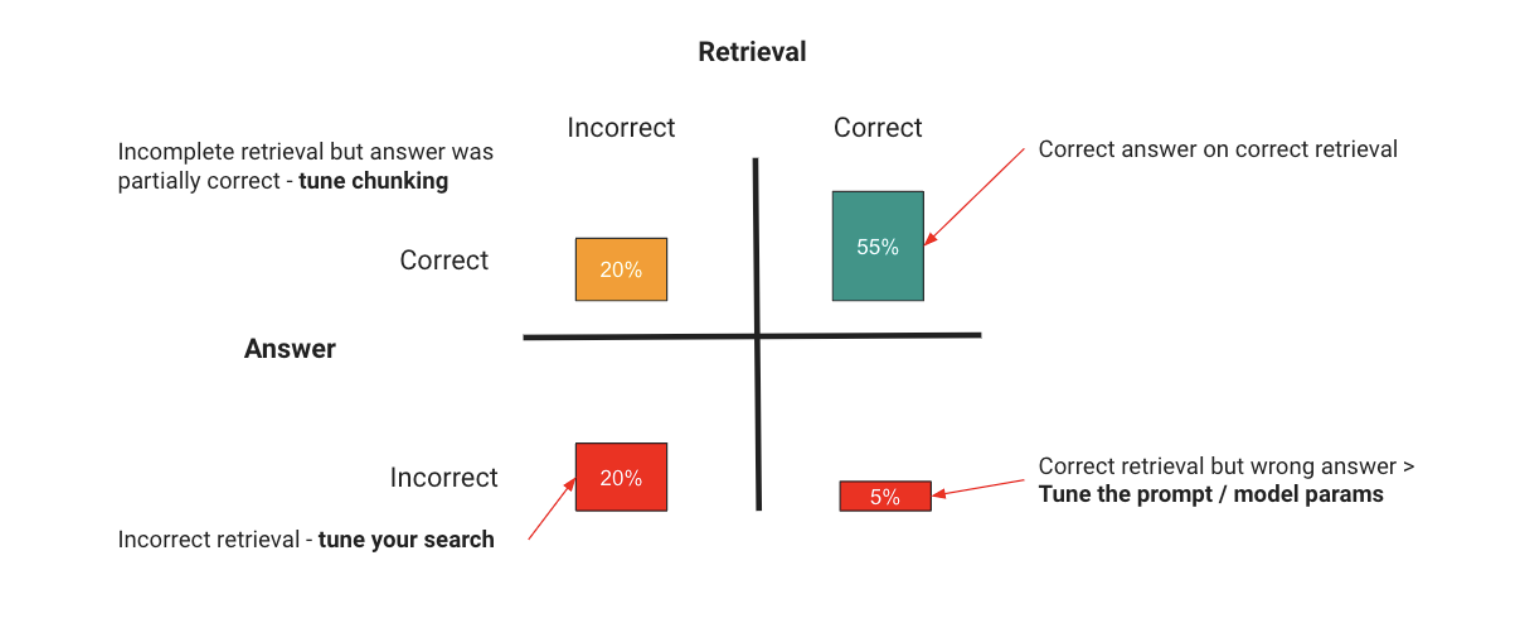
Votre application RAG peut échouer à deux niveaux :
| Niveau | Problème | Solution |
|---|---|---|
| Récupération | Si le contexte fourni est incorrect, le modèle ne peut pas répondre. Si le contexte contient trop d’éléments sans rapport avec la question, les informations utiles sont noyées dans le bruit, ce qui provoque des hallucinations. | Optimisez la récupération. Vous pouvez notamment : - Ajuster la recherche pour obtenir les bons résultats. - Ajuster la recherche pour réduire le bruit. - Fournir davantage d’informations dans chaque résultat récupéré. Ce ne sont que quelques exemples. L’optimisation des performances du RAG est une spécialité à part entière. Des bibliothèques comme LlamaIndex et LangChain proposent de nombreuses méthodes pour y parvenir. |
| LLM | Le modèle peut recevoir le bon contexte et mal l’exploiter. | Utilisez l’ingénierie de prompts pour améliorer les instructions et la méthode suivie par le modèle. Si lui montrer des exemples améliore la précision, ajoutez une étape de fine-tuning. |
Le principe reste celui de la matrice présentée au début du guide : évaluez les résultats pour identifier la cause de l’erreur, puis intervenez pour la corriger. Avec le RAG, la seule différence est qu’il faut aussi examiner la récupération.
Le RAG ne résout que les problèmes d’apprentissage en contexte. Dans de nombreux cas, il faut que le LLM apprenne à réaliser une tâche pour pouvoir l’exécuter de manière constante et fiable. C’est là qu’intervient le fine-tuning.
Fine-tuning
Pour résoudre un problème de mémoire acquise, de nombreux développeurs poursuivent l’entraînement du LLM sur un jeu de données plus restreint, propre à leur domaine, afin de l’optimiser pour une tâche précise. C’est ce qu’on appelle le fine-tuning.
On recourt généralement au fine-tuning pour l’une des deux raisons suivantes :
- Améliorer la précision du modèle sur une tâche donnée : entraînez le modèle sur des données propres à la tâche en lui montrant de nombreux exemples d’exécution correcte pour résoudre un problème de mémoire acquise.
- Améliorer l’efficacité du modèle : obtenez la même précision avec moins de tokens ou avec un modèle plus petit.
Le fine-tuning commence par la préparation d’un jeu d’exemples d’entraînement. C’est l’étape la plus importante : ces exemples doivent représenter fidèlement les entrées que le modèle recevra en conditions réelles.
De nombreux clients pratiquent le prompt baking : pendant une phase pilote, ils consignent en détail les prompts et les sorties correspondantes. Ils trient ensuite ces enregistrements pour constituer un jeu d’entraînement efficace à partir d’exemples réalistes.
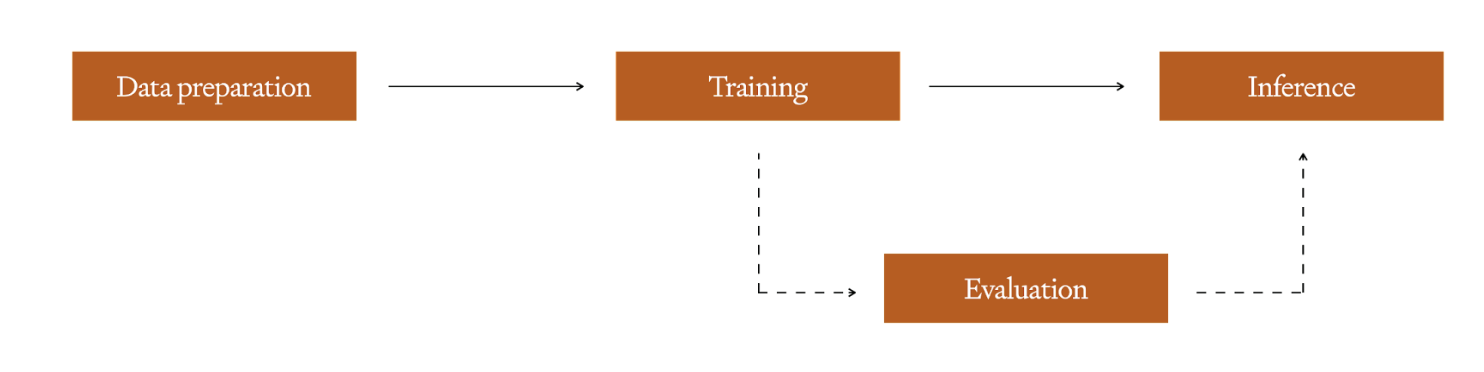
Une fois le jeu de données nettoyé, lancez un entraînement pour obtenir un modèle adapté à votre tâche. Selon la plateforme ou le framework utilisé, vous pourrez régler certains hyperparamètres, comme pour tout autre modèle d’apprentissage automatique. Nous recommandons de toujours réserver un jeu de données distinct à l’évaluation après l’entraînement pour détecter un éventuel surapprentissage. Pour constituer un bon jeu d’entraînement, consultez les conseils de notre documentation sur le fine-tuning. Une fois l’entraînement terminé, le nouveau modèle est disponible pour l’inférence.
Pour optimiser le fine-tuning, nous nous appuierons sur les bonnes pratiques observées avec les outils de personnalisation de modèles d’OpenAI. Ces principes devraient aussi s’appliquer aux solutions d’autres fournisseurs et aux outils open source :
- Commencez par l’ingénierie de prompts : constituez à cette étape un jeu d’évaluation solide qui vous servira de référence. Vous limiterez ainsi l’investissement initial jusqu’à ce que vous ayez confiance dans votre prompt de départ.
- Commencez à petite échelle et privilégiez la qualité : pour le fine-tuning d’un modèle de fondation, la qualité des données d’entraînement compte davantage que leur quantité. Commencez par au moins 50 exemples et évaluez les résultats. Augmentez ensuite la taille du jeu d’entraînement si la précision reste insuffisante et si les erreurs tiennent à la constance ou au comportement du modèle plutôt qu’au contexte.
- Vérifiez que vos exemples sont représentatifs : l’un des pièges les plus courants tient à de légères différences de format ou de présentation entre les exemples de fine-tuning et les entrées que reçoit le LLM en production. Pour une application RAG, par exemple, utilisez des exemples incluant le contexte récupéré afin que le modèle n’ait pas à apprendre à l’exploiter en zero-shot.
Combiner les techniques
Ces techniques peuvent se combiner. Si vos premières évaluations révèlent à la fois des problèmes de contexte et de comportement, votre solution de production utilisera probablement le fine-tuning et le RAG. Cette combinaison permet de compenser les limites de chaque approche. Voici quelques-uns de ses principaux avantages :
- Utilisez le fine-tuning pour réduire au minimum le nombre de tokens nécessaires à l’ingénierie de prompts. De nombreux exemples d’entraînement remplacent les instructions et les exemples few-shot et permettent au modèle d’acquérir un comportement constant.
- Enseignez des comportements complexes grâce à un fine-tuning approfondi.
- Utilisez le RAG pour ajouter du contexte, qu’il s’agisse de contenu plus récent ou d’informations spécialisées nécessaires à votre cas d’usage.
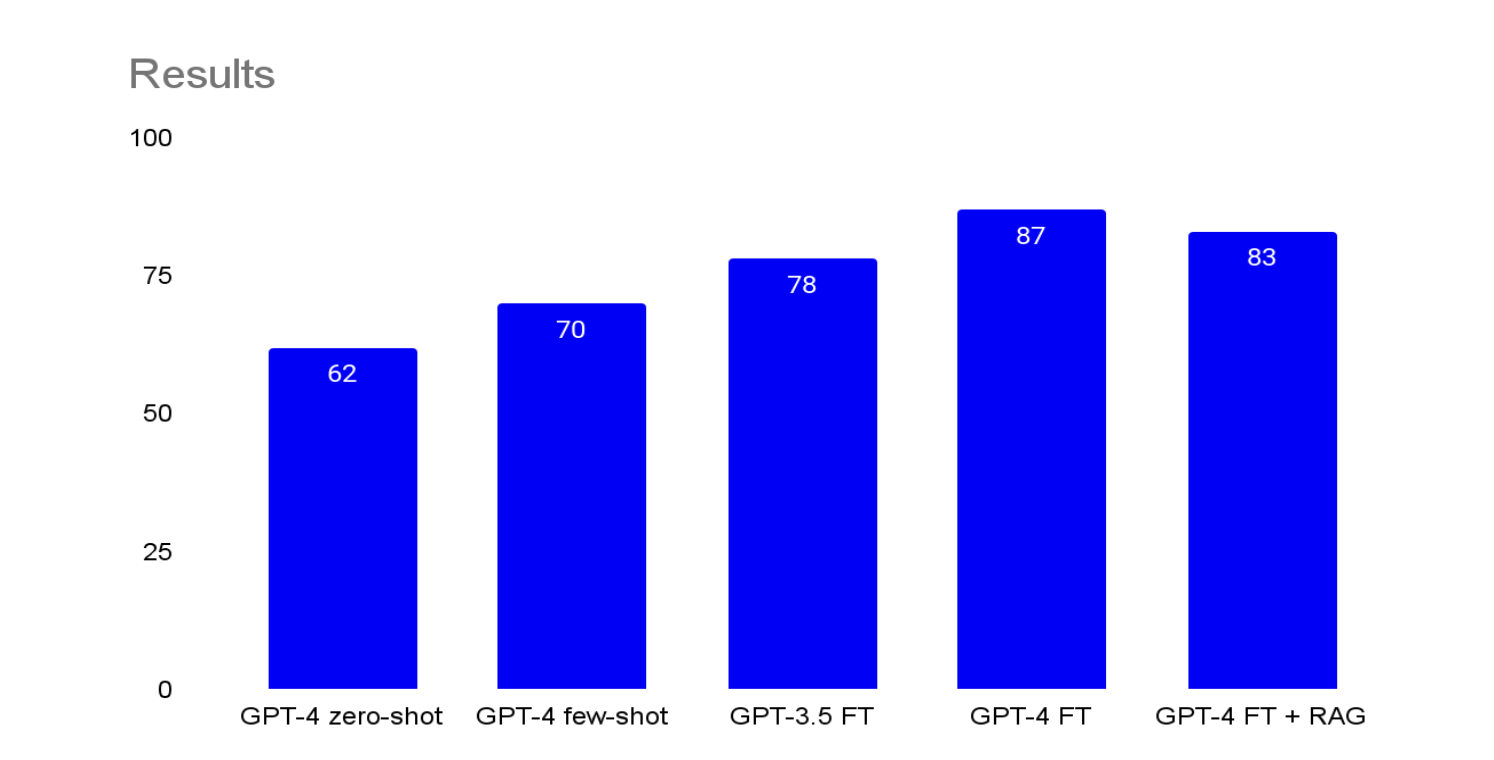 Score BLEU par méthode d’optimisation (sur 100)
Vous savez maintenant à quoi servent le RAG et le fine-tuning, et dans quels cas les utiliser. Tenez aussi compte de leur effet sur la vitesse des itérations :
- Avec le RAG, vous devez ajuster à la fois la récupération et le comportement du LLM.
- Avec le fine-tuning, chaque nouvel ajustement demande de relancer l’entraînement et de gérer les jeux d’entraînement et de validation.
Ces deux processus peuvent être longs et complexes. À mesure que votre application LLM se complexifie, des régressions peuvent apparaître. Avant de recourir au RAG ou au fine-tuning, tirez le meilleur parti des méthodes simples. C’est votre objectif de précision qui doit guider le choix des techniques. La sophistication du RAG et du fine-tuning ne justifie pas à elle seule leur emploi conjoint.
Quel niveau de précision est « suffisant » pour la production ?
On pourrait chercher indéfiniment à améliorer la précision d’un LLM. Avec des méthodes prêtes à l’emploi, il est peu probable d’atteindre 99,999 % de précision. Comment savoir quand s’arrêter ? Il s’agit de déterminer à partir de quel niveau vous pouvez déployer le modèle en toute confiance et comment gérer les risques liés à son utilisation en production.
Je trouve utile d’aborder la question sous deux angles : économique et technique. Je présenterai les grandes lignes de chaque démarche en prenant l’exemple d’un service d’assistance client pour illustrer la gestion des risques dans les deux cas.
Enjeux économiques
Pour une entreprise habituée à la relative prévisibilité des systèmes à base de règles, des modèles d’apprentissage automatique classiques ou même du travail humain, il peut être difficile de faire confiance aux LLM. Comment prendre en compte les défaillances d’un système lorsqu’il est difficile d’en prévoir la nature ou les conséquences ?
Voici une démarche qui a fait ses preuves dans un service d’assistance client.
Nous avons d’abord recensé les principaux scénarios de réussite et d’échec et estimé le coût ou le gain associé à chacun. À partir des résultats du pilote, nous pouvions ainsi chiffrer ce que la solution allait probablement nous faire économiser ou nous coûter.
- Par exemple, si l’IA résout une demande auparavant traitée par une personne, nous pouvons économiser 20 $.
- Un transfert injustifié à un conseiller peut coûter 40 $.
- Dans le pire des cas, un client quitte l’entreprise tant l’interaction avec l’IA l’a frustré, ce qui nous coûte 1 000 $. Nous supposons que cela se produit dans 5 % des cas d’échec.
| Événement | Valeur | Nombre de cas | Valeur totale |
|---|---|---|---|
| Réussite de l’IA | +20 | 815 | 16 300 $ |
| Échec de l’IA (transfert à un conseiller) | -40 | 175,75 | 7 030 $ |
| Échec de l’IA (perte du client) | -1000 | 9,25 | 9 250 $ |
| Résultat | +20 | ||
| Précision au seuil de rentabilité | 81,5 % |
Nous avons aussi recueilli des données sur le fonctionnement du service pour mesurer l’effet global de la solution. Pour un service d’assistance client, on peut par exemple comparer :
- Le score de satisfaction client (CSAT) des interactions entièrement prises en charge par des conseillers et celui des interactions avec l’IA.
- L’exactitude des décisions prises par les conseillers et par l’IA, en réexaminant les dossiers a posteriori.
- Le délai de résolution des demandes par les conseillers et par l’IA.
Dans notre exemple, les données recueillies au cours de plusieurs pilotes nous ont permis de prendre deux décisions importantes :
- Même si notre LLM transférait plus de demandes que prévu aux conseillers, il réduisait considérablement les coûts de fonctionnement par rapport à la solution existante. Une précision de 85 % pouvait donc suffire si les 15 % d’erreurs correspondaient principalement à des transferts prématurés.
- Lorsque le coût d’une erreur était très élevé, par exemple en cas de traitement incorrect d’un dossier de fraude, nous avons décidé de confier la décision au conseiller, avec l’IA en appui. La mesure de l’exactitude des décisions nous a permis de conclure que le niveau atteint ne justifiait pas une autonomie complète.
Enjeux techniques
Sur le plan technique, la démarche est plus directe. Une fois que l’entreprise a précisé les gains attendus et le coût des erreurs possibles, votre rôle consiste à concevoir une solution qui gère les échecs sans perturber l’expérience utilisateur.
Reprenons l’exemple de l’assistance client et supposons que notre modèle identifie correctement l’intention du client dans 85 % des cas. L’équipe technique peut limiter les conséquences des 15 % d’erreurs de plusieurs façons :
- Nous pouvons ajuster le prompt pour que le modèle demande des précisions au client en cas de doute. La précision à la première tentative peut diminuer, mais le modèle peut mieux cerner l’intention du client s’il dispose de deux tentatives.
- Nous pouvons permettre à l’assistant de deuxième niveau de renvoyer la demande à l’étape d’identification de l’intention. Le système peut ainsi corriger lui-même une erreur, au prix d’un délai supplémentaire pour l’utilisateur.
- Nous pouvons ajuster le prompt pour que le modèle passe la main à un conseiller lorsque l’intention reste floue. Les économies de fonctionnement seront moindres à court terme, mais le risque de perdre des clients pourrait diminuer à long terme.
Ces choix se répercutent sur l’expérience utilisateur : gagner en précision peut allonger le délai de traitement ou nécessiter davantage d’interventions humaines. Il faut alors en tenir compte dans le modèle de coûts présenté plus haut.
Vous disposez ainsi d’une démarche pour examiner séparément les décisions économiques et techniques et fixer un objectif de précision adapté aux réalités de votre activité.
Passer à la pratique
Ce cadre de réflexion vous aide à améliorer la précision d’un LLM, à choisir les outils appropriés et à déterminer quand le niveau atteint suffit pour la production. Vous pouvez vous en servir pour préparer vos déploiements de manière méthodique. Pour découvrir ce que d’autres ont réalisé avec ces techniques, consultez nos témoignages clients, notamment ceux de Morgan Stanley et de Klarna.
Bonne continuation ! Nous avons hâte de découvrir ce que vous allez créer avec ces techniques.