
OpenAI propose deux types de modèles : les modèles de raisonnement (o3 et o4-mini, par exemple) et les modèles GPT (comme GPT-4.1). Ces deux familles de modèles se comportent différemment.
Ce guide aborde trois questions :
- En quoi nos modèles de raisonnement diffèrent-ils de nos modèles GPT sans raisonnement ?
- Quand utiliser nos modèles de raisonnement ?
- Comment rédiger des prompts efficaces pour les modèles de raisonnement ?
En savoir plus sur les modèles de raisonnement et leur fonctionnement.
Modèles de raisonnement et modèles GPT
Nos modèles de la série o et nos modèles GPT excellent dans des tâches différentes et nécessitent des prompts différents. Chaque famille a ses points forts.
Nous avons entraîné nos modèles de la série o, les « planificateurs », à consacrer plus de temps à l’analyse approfondie des tâches complexes. Ils savent élaborer des stratégies, planifier la résolution de problèmes complexes et prendre des décisions à partir de grandes quantités d’informations ambiguës. Ils peuvent aussi exécuter des tâches avec une grande exactitude et beaucoup de précision. Ils sont donc particulièrement adaptés aux domaines qui exigeraient autrement l’intervention d’un spécialiste, comme les mathématiques, les sciences, l’ingénierie, les services financiers et les services juridiques.
Nos modèles GPT, les « exécutants », sont quant à eux conçus pour exécuter des tâches simples avec une latence et un coût moindres. Une application peut utiliser les modèles de la série o pour définir la stratégie de résolution d’un problème, puis confier des tâches précises aux modèles GPT, en particulier lorsque la rapidité et le coût priment sur l’exactitude absolue.
Comment choisir
Quels critères comptent le plus dans votre cas d’usage ?
- Rapidité et coût → Les modèles GPT sont plus rapides et généralement moins coûteux.
- Exécution de tâches bien définies → Les modèles GPT s’en sortent bien lorsque les tâches sont définies explicitement.
- Exactitude et fiabilité → Les modèles de la série o prennent des décisions fiables.
- Résolution de problèmes complexes → Les modèles de la série o savent traiter des problèmes à la fois ambigus et complexes.
Si la rapidité et le coût sont vos critères prioritaires et que votre cas d’usage se compose de tâches simples et bien définies, nos modèles GPT sont les mieux adaptés. Si l’exactitude et la fiabilité priment et que vous devez résoudre un problème très complexe en plusieurs étapes, nos modèles de la série o vous conviendront probablement mieux.
La plupart des workflows d’IA combinent les deux familles de modèles : la série o pour la planification et la prise de décision par les agents, et les modèles GPT pour l’exécution des tâches.
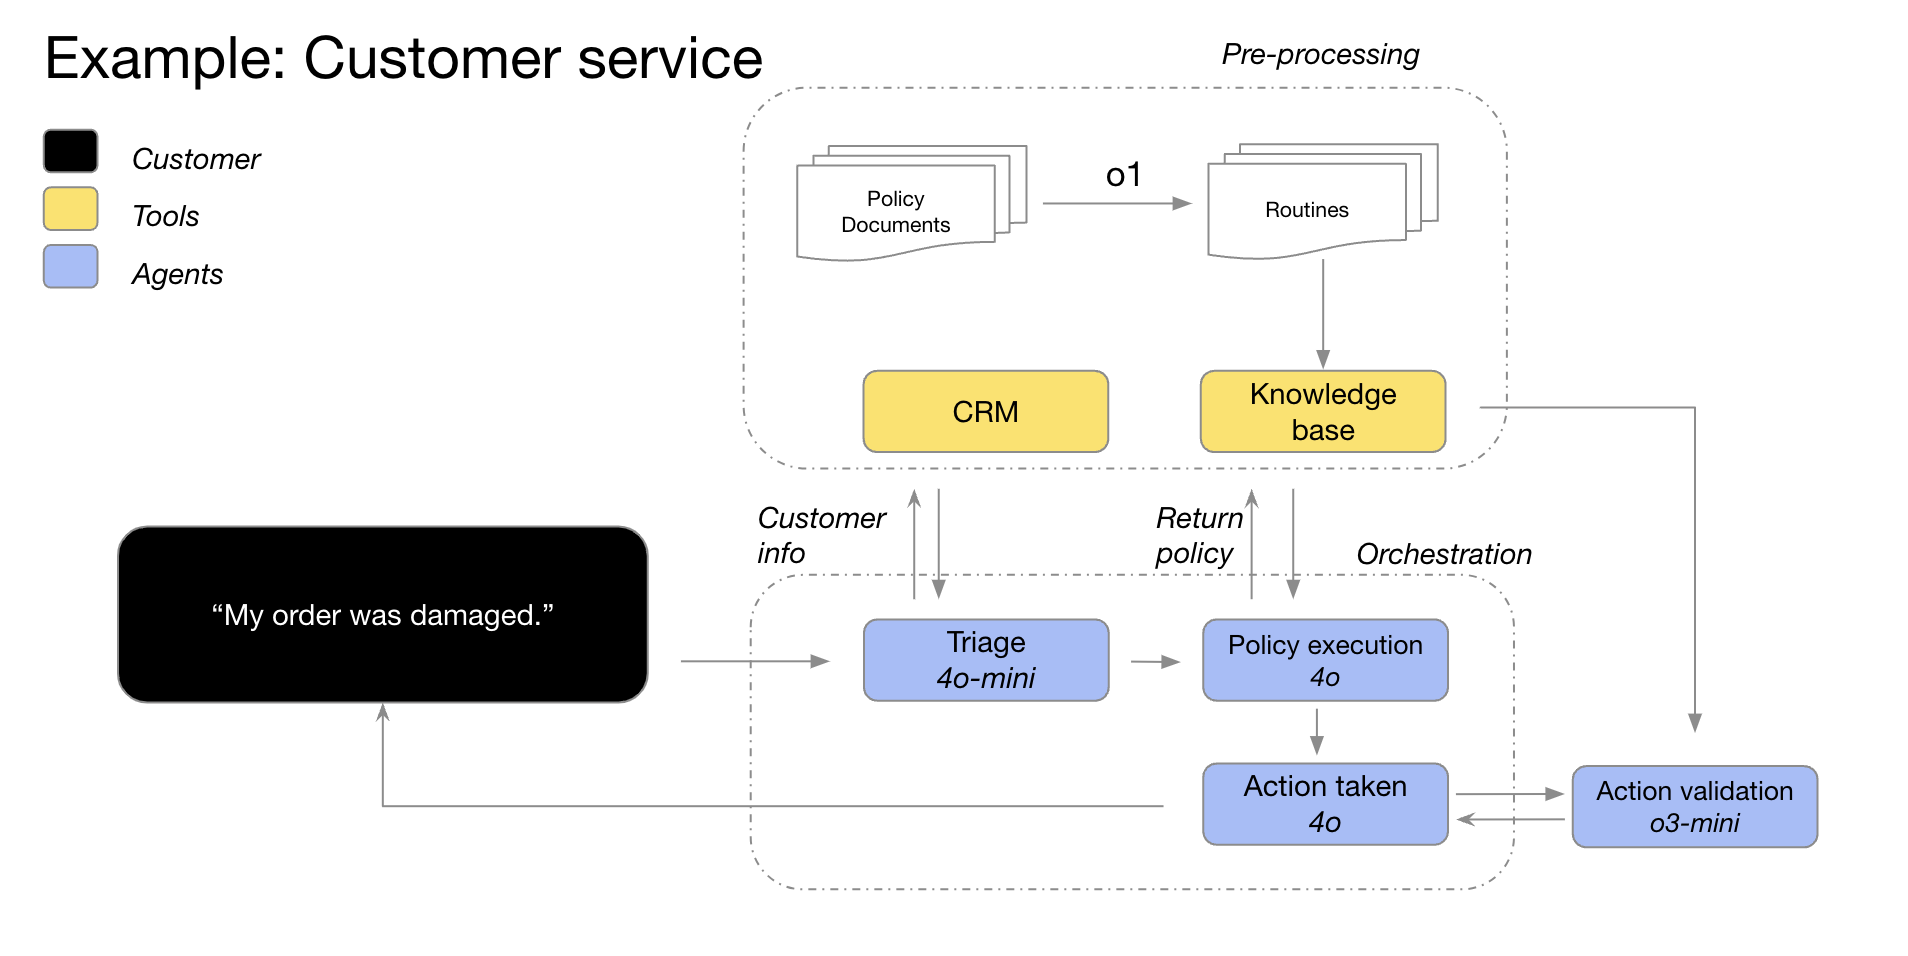
Nos modèles GPT-4o et GPT-4o mini trient les détails de la commande en tenant compte des informations sur le client, repèrent les problèmes liés à la commande et identifient la politique de retour applicable. Ils transmettent ensuite ces éléments à o3-mini, qui décide si cette politique autorise le retour.
Quand utiliser nos modèles de raisonnement
Voici quelques exemples d’utilisation qui ont fait leurs preuves chez nos clients et en interne chez OpenAI. Ces exemples vous donnent des pistes concrètes pour tester nos modèles de la série o, sans prétendre couvrir tous les cas d’usage.
Prêt à utiliser un modèle de raisonnement ? Accédez au guide de démarrage rapide →
1. Traiter des tâches ambiguës
Avec un simple prompt, les modèles de raisonnement savent interpréter des informations limitées ou disparates, comprendre l’intention de l’utilisateur et tenir compte des lacunes dans les instructions. Ils demandent souvent des précisions avant de se risquer à une supposition ou de tenter de combler un manque d’information.
« Grâce aux capacités de raisonnement d’o1, notre plateforme multi-agents Matrix produit des réponses exhaustives, bien structurées et détaillées lorsqu’elle traite des documents complexes. Avec un simple prompt, Matrix a par exemple pu repérer facilement les enveloppes disponibles au titre des clauses encadrant les paiements restreints dans un contrat de crédit. Aucun modèle antérieur n’atteint ce niveau de performance. Sur 52 % des prompts complexes portant sur des contrats de crédit denses, o1 a obtenu de meilleurs résultats que les autres modèles. »
— Hebbia, entreprise qui développe une plateforme de gestion des connaissances par l’IA pour le droit et la finance
2. Trouver une aiguille dans une botte de foin
Lorsque vous leur transmettez un grand volume d’informations non structurées, les modèles de raisonnement savent les interpréter et en extraire uniquement les éléments les plus pertinents pour répondre à une question.
« Pour analyser l’acquisition d’une entreprise, o1 a examiné des dizaines de documents, dont des contrats et des baux, à la recherche de conditions susceptibles de compliquer l’opération. Nous lui avions demandé de signaler les clauses importantes. Il a ainsi repéré dans les notes de bas de page une clause déterminante de « changement de contrôle » : en cas de vente, l’entreprise devait immédiatement rembourser un prêt de 75 millions de dollars. Grâce à l’attention qu’o1 porte aux moindres détails, nos agents d’IA aident les professionnels de la finance à repérer les informations cruciales. »
— Endex, plateforme d’analyse financière fondée sur l’IA
3. Repérer les liens et les nuances dans un vaste jeu de données
Nous avons constaté que les modèles de raisonnement analysent particulièrement bien les documents complexes qui contiennent des centaines de pages d’informations denses et non structurées, comme les contrats juridiques, les états financiers et les déclarations de sinistre. Ils savent notamment établir des liens entre les documents et fonder leurs décisions sur ce que les données révèlent implicitement.
« En recherche fiscale, il faut faire la synthèse de plusieurs documents pour aboutir à une réponse convaincante. Nous avons remplacé GPT-4o par o1 et constaté qu’o1 analysait bien mieux les liens entre les documents. Il en tirait des conclusions logiques qui ne ressortaient d’aucun document pris isolément. En passant à o1, nous avons multiplié par quatre les performances de bout en bout. Incroyable ! »
— Blue J, plateforme d’IA pour la recherche fiscale
Les modèles de raisonnement savent également interpréter des politiques et des règles qui comportent des subtilités, puis les appliquer au cas qui leur est soumis pour parvenir à une conclusion raisonnable.
« En analyse financière, les analystes étudient souvent des scénarios complexes touchant aux participations des actionnaires et doivent en comprendre les subtilités juridiques. Nous avons testé une dizaine de modèles de différents fournisseurs sur une question difficile mais courante : quelle est l’incidence d’une levée de fonds sur les actionnaires existants, en particulier lorsqu’ils exercent leurs droits anti-dilution ? Pour répondre, il fallait raisonner sur les valorisations avant et après la levée de fonds et résoudre des calculs de dilution circulaires. Même un excellent analyste financier y consacrerait 20 à 30 minutes. Nous avons constaté qu’o1 et o3-mini y parviennent sans erreur ! Les modèles ont même produit un tableau de calcul clair montrant l’incidence de l’opération pour un actionnaire détenant une participation de 100 000 dollars. »
– BlueFlame AI, plateforme d’IA pour la gestion des investissements
4. Planification en plusieurs étapes par des agents
Les modèles de raisonnement jouent un rôle essentiel dans la planification par les agents et l’élaboration de stratégies. Nous avons obtenu de bons résultats en confiant à un modèle de raisonnement le rôle de « planificateur ». Il élabore une solution détaillée en plusieurs étapes, puis confie chaque étape au modèle GPT « exécutant » le mieux adapté, selon que la priorité est la capacité d’analyse ou la faible latence.
« Dans notre infrastructure d’agents, o1 joue le rôle de planificateur : il coordonne les autres modèles du workflow pour accomplir une tâche en plusieurs étapes. Il choisit très bien les types de données et sait décomposer une question de grande ampleur en questions plus simples. Les autres modèles peuvent ainsi se concentrer sur l’exécution. »
— Argon AI, plateforme de gestion des connaissances par l’IA pour l’industrie pharmaceutique
« Chez Lindy, notre assistant d’IA pour le travail, o1 prend en charge de nombreux workflows agentiques. Le modèle utilise l’appel de fonction pour récupérer des informations dans votre agenda ou vos e-mails. Il peut ensuite vous aider automatiquement à planifier des réunions, à envoyer des e-mails et à gérer d’autres tâches du quotidien. Nous avons confié à o1 toutes les étapes qui posaient problème à nos agents. Du jour au lendemain, ils ne faisaient pratiquement plus d’erreurs ! »
— Lindy.AI, assistant d’IA pour le travail
5. Raisonnement visuel
À ce jour, o1 est le seul modèle de raisonnement doté de capacités de vision. Il se distingue de GPT-4o par sa capacité à interpréter même les images les plus difficiles à lire, comme des graphiques ou des tableaux à la structure ambiguë, ou encore des photos de mauvaise qualité.
« Nous automatisons les contrôles de risque et de conformité pour des millions de produits proposés en ligne, notamment des imitations de bijoux de luxe, des espèces menacées et des substances réglementées. GPT-4o classait correctement 50 % des images dans nos tâches de classification les plus difficiles. Avec o1, cette proportion a atteint le chiffre remarquable de 88 %, sans aucune modification de notre pipeline. »
— SafetyKit, plateforme de gestion des risques et de la conformité fondée sur l’IA
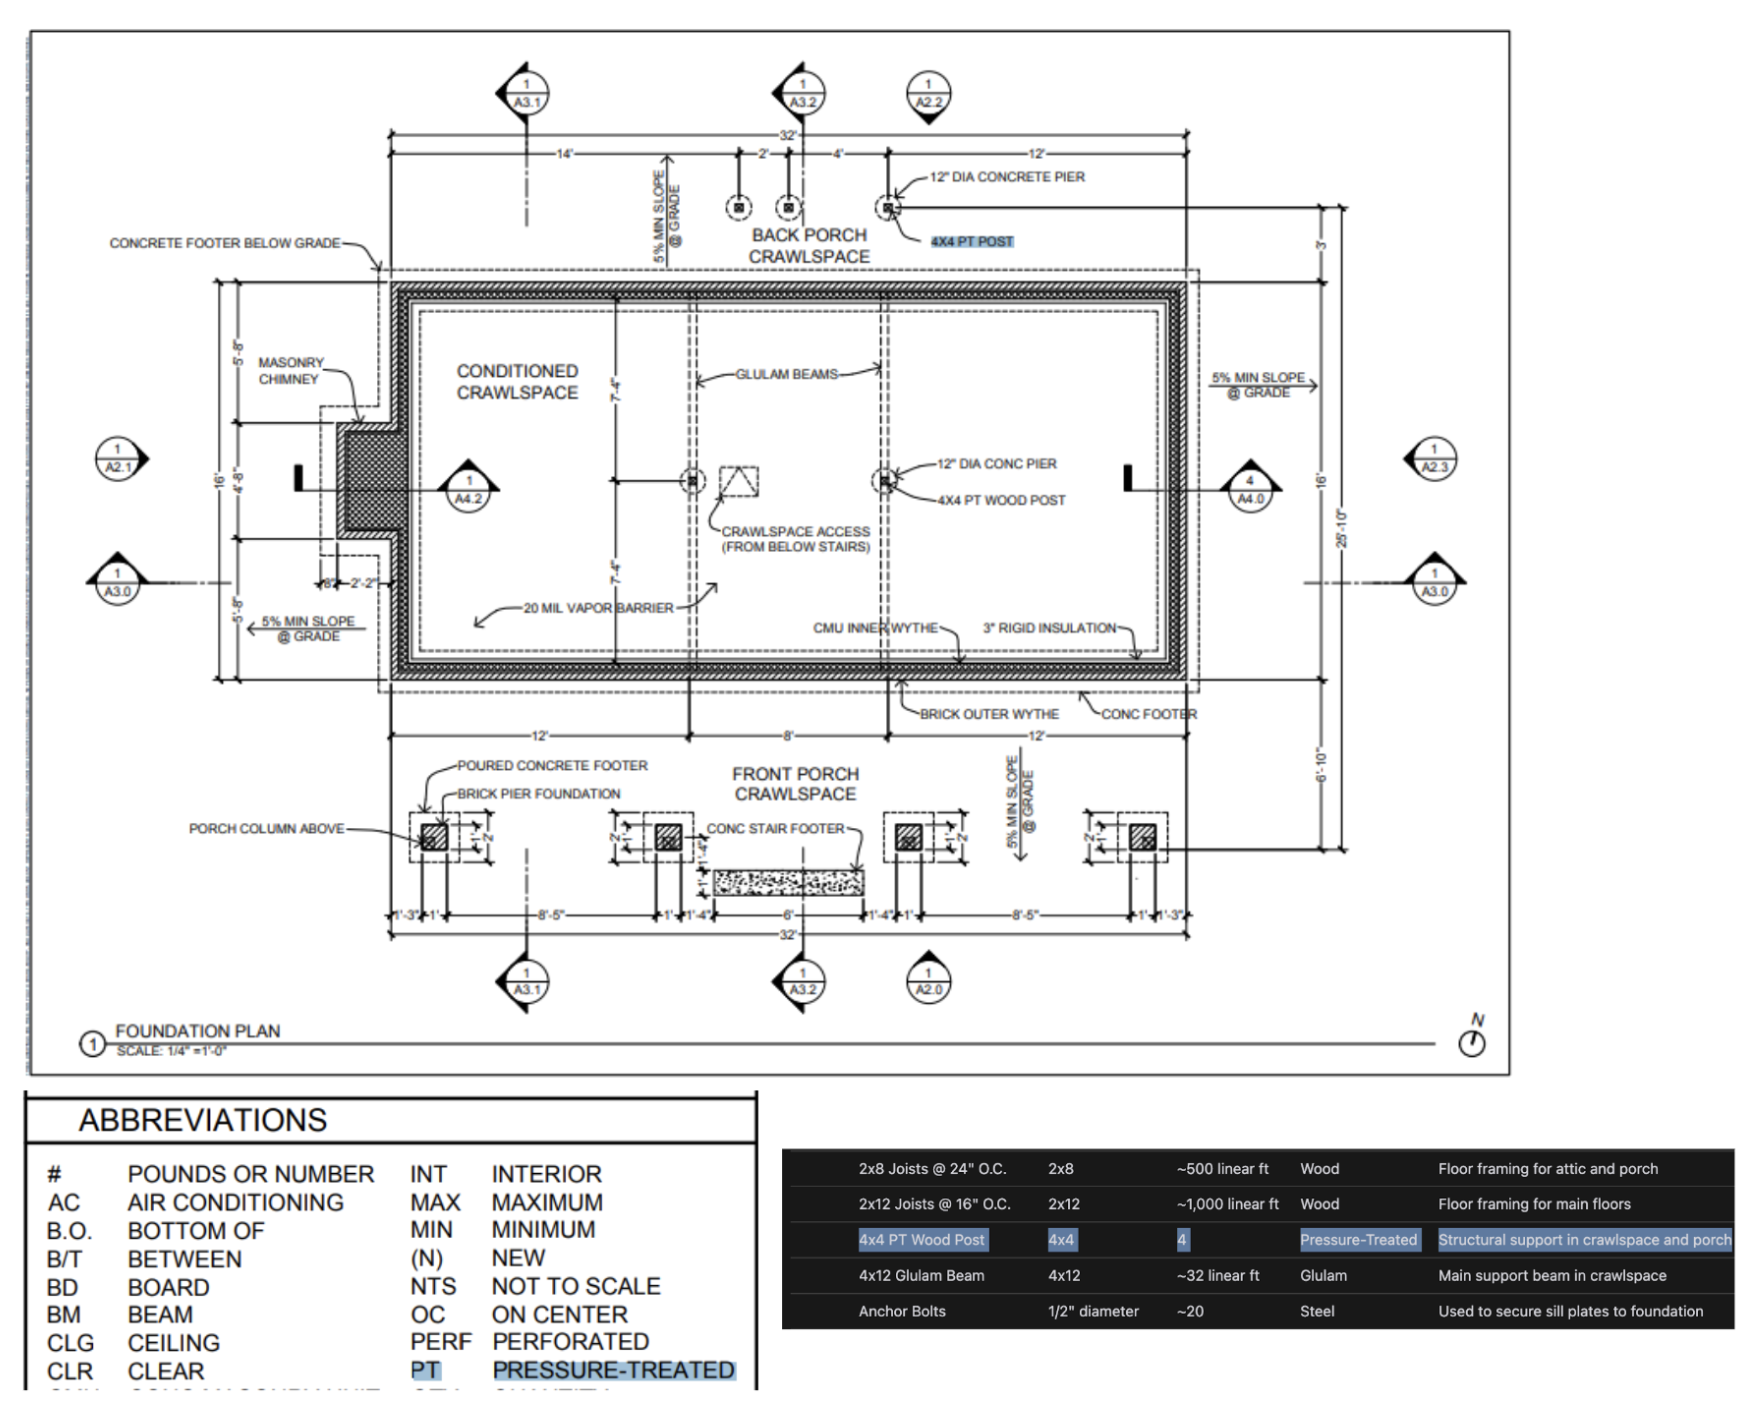
Lors de nos tests internes, o1 a su identifier les équipements et les matériaux sur des plans d’architecte très détaillés pour en dresser une nomenclature complète. À notre surprise, o1 a même su faire le lien entre plusieurs images : il a correctement appliqué la légende d’une page de plans à une autre page, sans instruction explicite. Dans l’exemple ci-dessous, o1 s’est appuyé sur la légende pour comprendre que, dans la désignation des poteaux en bois 4x4 PT, « PT » signifie que le bois a été traité sous pression.
6. Revue de code, débogage et amélioration de la qualité du code
Les modèles de raisonnement sont particulièrement efficaces pour examiner et améliorer de grandes quantités de code. Compte tenu de leur latence plus élevée, les revues de code s’effectuent souvent en arrière-plan.
« Nous proposons des revues de code automatisées par l’IA sur des plateformes comme GitHub et GitLab. La revue de code est peu sensible à la latence en soi, mais elle exige de comprendre les modifications apportées à plusieurs fichiers. C’est là qu’o1 excelle : il repère de manière fiable de petites modifications du code source qui pourraient échapper à la personne chargée de la revue. En passant aux modèles de la série o, nous avons triplé les taux de conversion de notre produit. »
— CodeRabbit, start-up spécialisée dans la revue de code par l’IA
La latence plus faible de GPT-4o et GPT-4o mini peut les rendre plus adaptés à l’écriture de code. Nous avons aussi constaté qu’o3-mini obtenait d’excellents résultats en génération de code lorsque la latence comptait un peu moins.
« o3-mini produit systématiquement du code de qualité qui répond au problème posé. Lorsque le problème est bien défini, il trouve très souvent la bonne solution, même pour des tâches de programmation très difficiles. D’autres modèles ne sont parfois utiles que pour apporter rapidement de petites modifications au code. o3-mini, lui, excelle lorsqu’il faut planifier la conception de systèmes logiciels complexes et la mener à bien. »
— Windsurf, IDE collaboratif doté d’une IA agentique, développé par Codeium
7. Évaluer et comparer les réponses d’autres modèles
Nous avons également obtenu de bons résultats en utilisant des modèles de raisonnement pour comparer et évaluer les réponses d’autres modèles. La validation des données est importante pour garantir la qualité et la fiabilité des jeux de données, en particulier dans des domaines sensibles comme la santé. Les méthodes de validation classiques s’appuient sur des règles et des schémas prédéfinis. Des modèles avancés comme o1 et o3-mini peuvent comprendre le contexte et raisonner sur les données, ce qui permet une validation plus souple et plus éclairée.
« De nombreux clients utilisent un LLM comme juge dans leurs évaluations sur Braintrust. Une entreprise du secteur de la santé peut, par exemple, utiliser un modèle exécutant comme gpt-4o pour résumer les questions des patients, puis confier à o1 l’évaluation de la qualité du résumé. Chez l’un de nos clients, le score F1 du juge est passé de 0,12 avec 4o à 0,74 avec o1 ! Pour les tâches de notation les plus difficiles et les plus complexes, ces clients ont constaté que les capacités de raisonnement d’o1 changeaient la donne : le modèle parvient à distinguer des nuances entre les réponses générées. »
— Braintrust, plateforme d’évaluation de l’IA
Comment rédiger des prompts efficaces pour les modèles de raisonnement
Ces modèles donnent leurs meilleurs résultats avec des prompts simples et directs. Certaines techniques d’ingénierie de prompts, comme demander au modèle de « réfléchir étape par étape », n’améliorent pas nécessairement ses performances et peuvent parfois les dégrader. Consultez les bonnes pratiques ci-dessous ou commencez par des exemples de prompts.
- Les messages développeur remplacent les messages système : à partir de
o1-2024-12-17, les modèles de raisonnement prennent en charge les messages développeur à la place des messages système, conformément à la hiérarchie des instructions décrite dans la spécification du modèle. - Rédigez des prompts simples et directs : les modèles comprennent très bien les instructions brèves et claires et savent y répondre.
- Évitez les prompts qui demandent un raisonnement détaillé (« chain-of-thought ») : ces modèles raisonnent déjà en interne. Il est donc inutile de leur demander de « réfléchir étape par étape » ou d’« expliquer leur raisonnement ».
- Utilisez des délimiteurs pour gagner en clarté : distinguez les parties de votre entrée à l’aide du Markdown, de balises XML ou de titres de section. Le modèle pourra ainsi interpréter correctement chaque partie.
- Essayez d’abord le zero-shot, puis passez au few-shot si nécessaire : les modèles de raisonnement donnent souvent de bons résultats sans exemples few-shot. Commencez donc par rédiger un prompt sans exemple. Si le résultat attendu doit satisfaire à des exigences plus complexes, il peut être utile de fournir dans le prompt quelques exemples d’entrées et de sorties attendues. Veillez à ce que ces exemples correspondent précisément à vos instructions : tout écart risque de dégrader les résultats.
- Donnez des consignes précises : si la réponse doit respecter certaines contraintes, indiquez-les explicitement dans le prompt, par exemple « proposez une solution dont le budget est inférieur à 500 dollars ».
- Définissez précisément votre objectif final : indiquez dans vos instructions les critères précis auxquels une bonne réponse doit satisfaire. Invitez le modèle à poursuivre son raisonnement et à affiner sa réponse jusqu’à ce qu’elle remplisse ces critères.
- Mise en forme Markdown : à partir de
o1-2024-12-17, les modèles de raisonnement utilisés via l’API évitent de mettre leurs réponses en forme en Markdown. Pour demander une réponse en Markdown, incluez la chaîneFormatting re-enabledsur la première ligne de votre message développeur.
Comment limiter les coûts tout en préservant l’exactitude
Depuis l’arrivée des modèles o3 et o4-mini, l’API Responses traite différemment les éléments de raisonnement enregistrés. Auparavant, avec o1, o3-mini, o1-mini et o1-preview, l’API ignorait systématiquement les éléments de raisonnement lors des requêtes suivantes, même s’ils figuraient parmi les éléments d’entrée de ces requêtes. Avec o3 et o4-mini, l’API inclut dans le contexte du modèle certains éléments de raisonnement adjacents aux appels de fonction. Le modèle peut ainsi améliorer ses performances tout en utilisant le moins de tokens de raisonnement possible.
Pour tirer le meilleur parti de ce changement, nous vous recommandons d’utiliser l’API Responses, de définir le paramètre store sur true et de transmettre tous les éléments de raisonnement des requêtes précédentes. Pour cela, utilisez previous_response_id ou transmettez tous les éléments de sortie d’une requête antérieure comme éléments d’entrée de la nouvelle requête. OpenAI inclut automatiquement les éléments de raisonnement pertinents dans le contexte du modèle et ignore les autres. Pour les cas d’usage avancés où vous souhaitez maîtriser plus précisément le contenu du contexte, nous vous recommandons d’inclure au minimum tous les éléments de raisonnement situés entre le dernier appel de fonction et le message utilisateur qui le précède. Ainsi, lorsque vous répondez à un appel de fonction, le modèle peut poursuivre son raisonnement sans le reprendre depuis le début. Les appels de fonction sont alors plus performants et la consommation totale de tokens diminue.
Si vous utilisez l’API Chat Completions, les éléments de raisonnement ne figurent jamais dans le contexte du modèle, car Chat Completions est une API sans état. Dans les cas d’usage agentiques complexes qui nécessitent de nombreux appels de fonction, les performances du modèle seront donc légèrement inférieures et sa consommation de tokens de raisonnement plus élevée. Si votre cas d’usage ne fait pas intervenir d’enchaînement complexe d’appels de fonction, les performances devraient rester les mêmes quelle que soit l’API utilisée.
Autres ressources
Pour trouver d’autres idées, consultez l’OpenAI Cookbook, qui propose des exemples de code et des liens vers des ressources tierces, ou explorez les ressources suivantes sur nos modèles et leurs capacités de raisonnement :