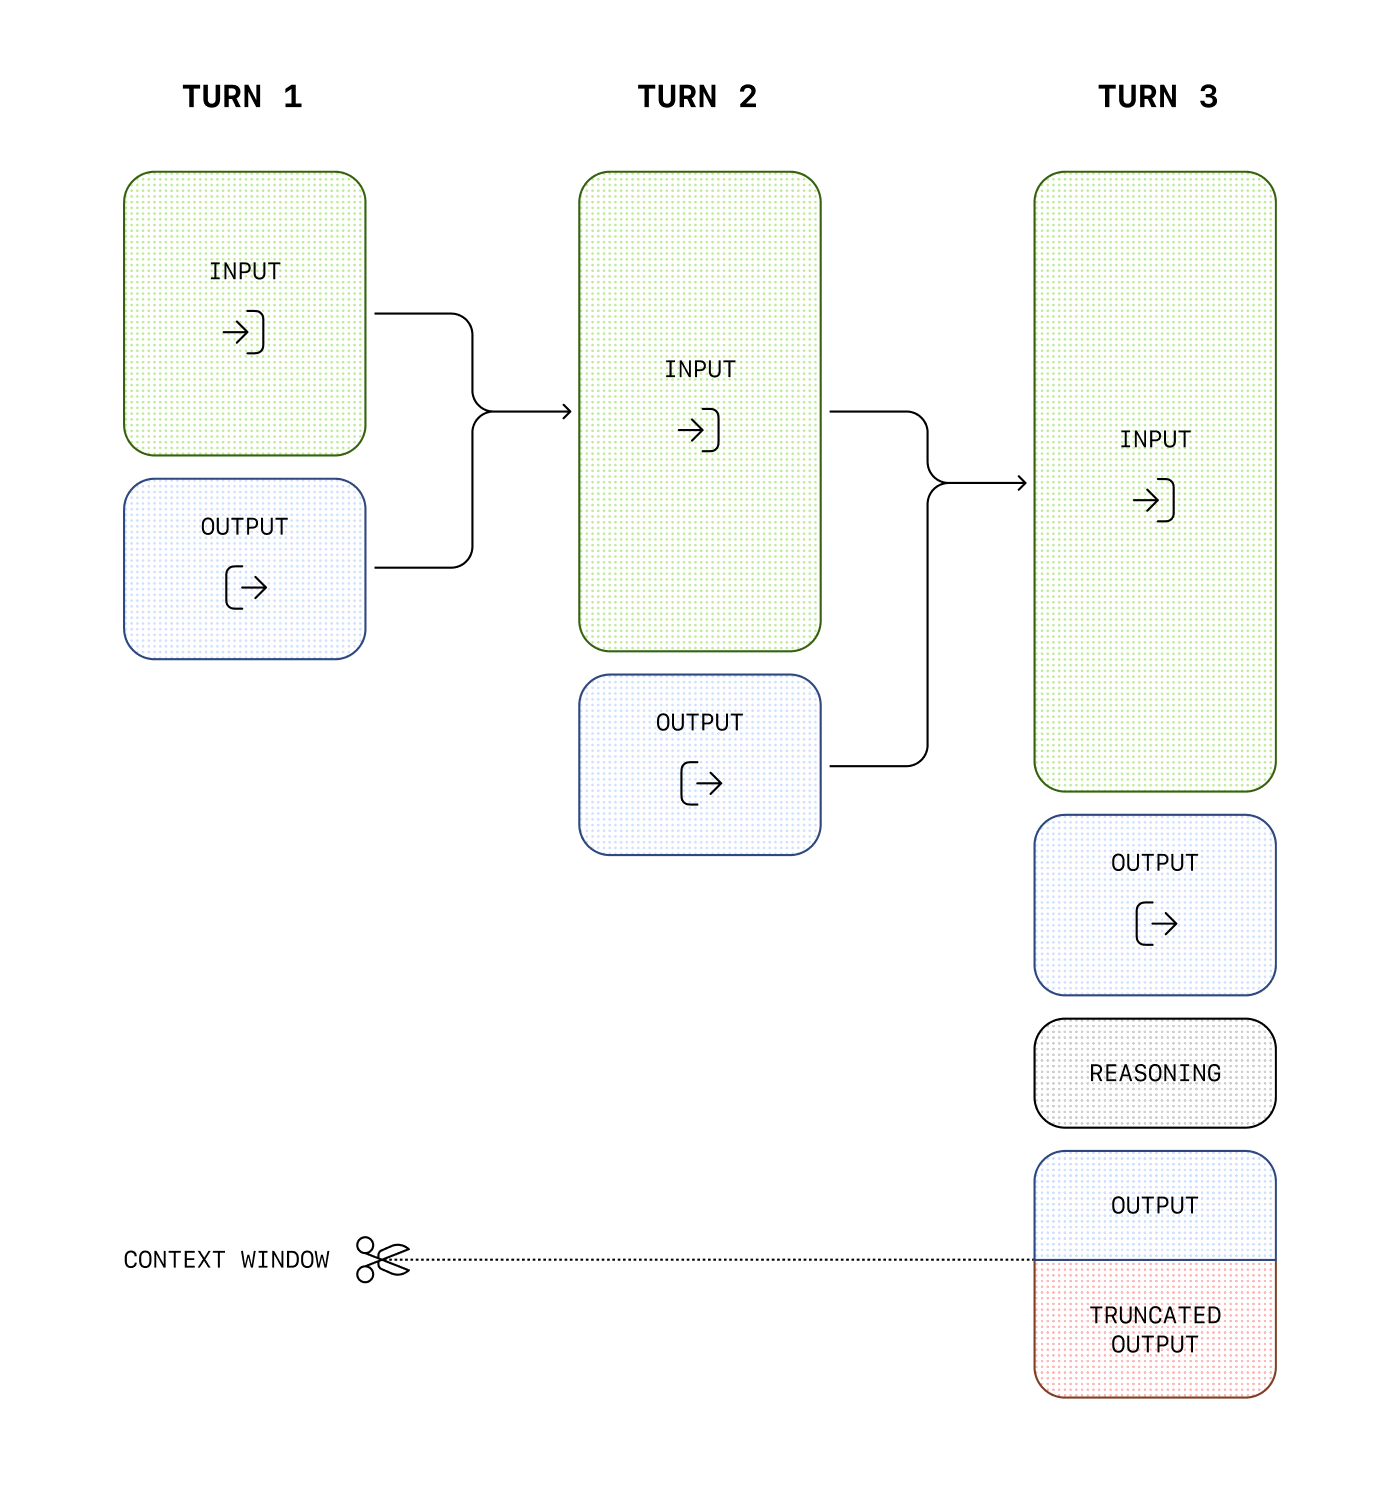
Découvrez comment fonctionnent les modèles de raisonnement et comment les utiliser efficacement.
Responses
Les modèles de raisonnement utilisent des tokens de raisonnement internes avant de produire une réponse. Ces tokens aident le modèle à planifier son travail, à utiliser efficacement les outils, à examiner différentes approches, à lever les ambiguïtés et à accomplir des tâches plus difficiles en plusieurs étapes. Les modèles de raisonnement sont particulièrement efficaces pour résoudre des problèmes complexes, programmer, mener un raisonnement scientifique et exécuter des workflows agentiques en plusieurs étapes. Ce sont aussi les meilleurs modèles pour Codex CLI, notre agent de programmation léger.
Pour la plupart des tâches de raisonnement, commencez par gpt-6-astra. Pour réduire les coûts, envisagez gpt-5.6-terra, ou choisissez gpt-5.6-luna pour obtenir le coût et la latence les plus faibles. Si vous utilisez un modèle GPT-5.6 ou GPT-6, consultez la section sur le mode de raisonnement pour découvrir l’option pro.
Les modèles de raisonnement fonctionnent mieux avec l’API Responses. L’API Chat Completions reste prise en charge, mais avec Responses, le modèle raisonne mieux et offre de meilleures performances.
Premier appel à un modèle de raisonnement
Appelez l’API Responses en précisant le modèle et l’effort de raisonnement souhaités :
Utilisation d’un modèle de raisonnement avec l’API Responses
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
Effort de raisonnement
Le paramètre reasoning.effort indique au modèle l’effort de raisonnement à consacrer à une tâche.
Les valeurs prises en charge dépendent du modèle et peuvent inclure none, minimal, low, medium, high, xhigh et max. Un effort faible privilégie la rapidité et réduit la consommation de tokens. Avec un effort plus élevé, le modèle approfondit son raisonnement pour fournir des réponses de meilleure qualité. Quel que soit le niveau d’effort, le modèle adapte aussi son raisonnement à la tâche : il utilise moins de tokens pour les tâches simples et réfléchit davantage pour les tâches complexes.
GPT-6 Astra ne prend pas en charge le niveau d’effort none. Si vous définissez reasoning.effort (Responses) ou reasoning_effort (Chat Completions) sur none, l’API renvoie une erreur HTTP 400. GPT-6.1 Sol ne prend en charge ni none ni minimal et utilise medium par défaut.
Utilisez l’API Responses pour les appels de fonction. Chat Completions ne prend pas en charge les appels de fonction avec GPT-6 Astra ou GPT-6.1 Sol.
Les valeurs par défaut dépendent elles aussi du modèle. gpt-5.5 utilise par défaut le niveau d’effort medium. C’est le meilleur point de départ pour tirer parti de l’équilibre qu’offre gpt-5.5 entre qualité, fiabilité et performances.
Effort
Cas d’usage privilégiés
none
Tâches pour lesquelles la latence est critique et qui ne tirent aucun bénéfice du raisonnement ni d’une succession d’appels d’outils. Si la latence est importante pour votre application avec gpt-5.5, nous vous recommandons de commencer par low, puis de passer à none si nécessaire.
Exemples courants : applications vocales, recherche rapide d’informations et classification.
low
Raisonnement efficace avec une légère augmentation de la latence. Idéal pour les tâches qui nécessitent des outils, de la planification, des recherches ou des décisions en plusieurs étapes, tout en privilégiant la rapidité et la maîtrise des coûts.
Exemples courants : analyse de données, rédaction, programmation axée sur la mise en œuvre et workflows d’assistance client ou d’assistants conversationnels.
medium
Tâches où la qualité et la fiabilité comptent et qui font appel à la planification, à un raisonnement complexe et au discernement. C’est le réglage par défaut pour la plupart des tâches. Il offre un bon compromis sur la courbe de Pareto entre latence, performances et coût.
Exemples courants : programmation agentique, recherche, travail sur des feuilles de calcul et des présentations, et délégation de tâches de longue durée.
high
Raisonnements difficiles, débogage complexe, planification approfondie et tâches à forte valeur ajoutée pour lesquelles la qualité et les capacités du modèle priment sur la latence. Ce niveau est recommandé pour les workflows complexes et les tâches agentiques.
Exemples courants : programmation agentique, recherches de longue durée et travail intellectuel. Selon la complexité de la tâche, évaluez à la fois medium et high.
xhigh
Recherche approfondie, workflows asynchrones et tâches agentiques de longue durée. Utilisez ce niveau uniquement si vos évaluations montrent un gain clair qui justifie la latence et le coût supplémentaires.
Exemples courants : audits de sécurité et revues de code, tâches de productivité en entreprise, recherches plus poussées et workflows de programmation exigeants.
max
Effort de raisonnement maximal pour vos tâches les plus complexes. Si vous utilisez actuellement xhigh, vérifiez si max améliore les performances.
Pour afficher le premier token plus rapidement dans les applications sensibles à la latence, demandez au modèle de générer un court préambule avant d’approfondir son raisonnement.
Certains modèles ne prennent en charge qu’une partie de ces valeurs. Consultez la page du modèle concerné avant de choisir un réglage.
Mode de raisonnement
Les modèles GPT-5.6 et GPT-6 prennent en charge les modes de raisonnement standard et pro dans l’API Responses. Le mode standard est activé par défaut. Définissez reasoning.mode sur pro pour les tâches difficiles qui demandent davantage de travail au modèle et pour lesquelles une latence et une consommation de tokens plus élevées sont acceptables.
Le mode et l’effort de raisonnement sont indépendants. Le mode détermine si l’exécution se fait en mode standard ou Pro, tandis que reasoning.effort règle l’effort de raisonnement du modèle dans le mode choisi. Si vous omettez reasoning.effort, GPT-5.6 utilise medium par défaut dans les deux modes. GPT-6.1 Sol, GPT-6 Sol et GPT-6 Luna utilisent également medium par défaut.
Le mode Pro comptabilise l’ensemble du travail effectué par le modèle pour produire la réponse finale et facture les tokens correspondants aux tarifs standard par token du modèle sélectionné. En mode Pro, le modèle effectue davantage de travail qu’en mode standard, ce qui augmente la consommation de tokens et le coût. Les identifiants de modèles Pro existants conservent leur comportement et leur tarification actuels.
Fonctionnement du raisonnement
En plus des tokens d’entrée et de sortie, les modèles de raisonnement utilisent des tokens de raisonnement. Ils s’en servent pour « réfléchir » : ils décomposent le prompt et envisagent plusieurs façons d’y répondre. Nos modèles de raisonnement, comme gpt-5.5 et gpt-5.4, peuvent alterner raisonnement et génération de contenu. Ils peuvent ainsi produire des tokens de sortie visibles avant de commencer à réfléchir et entre deux étapes de raisonnement, mais aussi réfléchir entre deux appels d’outils.
Dans une conversation en plusieurs étapes, les modèles sortis avant GPT-5.6 reprennent par défaut les tokens d’entrée et de sortie de chaque étape sans intégrer le raisonnement des tours précédents au contexte de la génération suivante. Les modèles GPT-5.6 y intègrent par défaut le raisonnement disponible des tours précédents. Utilisez reasoning.context pour choisir l’un ou l’autre comportement sur les modèles qui le permettent.
Les tokens de raisonnement ne sont pas visibles via l’API, mais ils occupent de la place dans la fenêtre de contexte du modèle et sont facturés comme des tokens de sortie.
Maîtrise des coûts
Pour maîtriser les coûts des modèles de raisonnement, vous pouvez limiter le nombre total de tokens générés par le modèle à l’aide du paramètre max_output_tokens. Cette limite couvre les tokens de raisonnement, les tokens de sortie visibles et les tokens de mise en forme invisibles. Consultez la section sur le décompte des tokens de sortie pour savoir comment les tokens générés sont pris en compte dans la consommation et les limites de sortie.
Gestion de la fenêtre de contexte
Lors de la création d’une réponse, prévoyez suffisamment d’espace dans la fenêtre de contexte pour les tokens de raisonnement. Selon la complexité du problème, le modèle peut en générer de quelques centaines à plusieurs dizaines de milliers. Le nombre exact de tokens de raisonnement utilisés figure dans l’objet de suivi de la consommation de la réponse, sous output_tokens_details :
La page de référence des modèles indique la taille des fenêtres de contexte. Cette taille varie selon la version du modèle.
Espace à réserver au raisonnement
Si les tokens générés atteignent la limite de la fenêtre de contexte ou la valeur de max_output_tokens que vous avez définie, vous recevez une réponse dont le champ status vaut incomplete. Dans incomplete_details, le champ reason vaut alors max_output_tokens. La limite peut être atteinte avant même la production du premier token de sortie visible. Des tokens d’entrée et de raisonnement peuvent donc vous être facturés sans que vous receviez de réponse visible.
Pour éviter cette situation, vérifiez que la fenêtre de contexte offre suffisamment d’espace ou augmentez la valeur de max_output_tokens. OpenAI recommande de réserver au moins 25 000 tokens au raisonnement et à la sortie lors de vos premiers essais avec ces modèles. Une fois que vous connaissez le nombre de tokens de raisonnement nécessaire pour vos prompts, vous pouvez ajuster cette marge.
Gestion des réponses incomplètes
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
Conservation du raisonnement entre les appels
L’état de la conversation et l’état du raisonnement remplissent deux fonctions distinctes. En transmettant les messages d’un appel à l’autre, vous donnez au modèle accès à l’historique visible de la conversation. Sur les modèles compatibles, la conservation du raisonnement permet également d’intégrer au contexte suivant les éléments de raisonnement compatibles des tours précédents.
La conservation du raisonnement assure la continuité entre les tours sans exposer le raisonnement brut du modèle. Les éléments de raisonnement restent opaques et l’API ne renvoie pas le texte qu’ils contiennent. Définissez reasoning.context pour choisir les éléments de raisonnement disponibles que le modèle peut utiliser :
La famille de modèles GPT-5.6 prend en charge all_turns et l’utilise par défaut. Les modèles antérieurs utilisent current_turn par défaut. GPT-6.1 Sol prend également en charge all_turns. Omettez reasoning.context ou définissez-le sur auto pour utiliser le réglage par défaut du modèle sélectionné.
Valeur
Comportement
auto
Utilise le réglage par défaut du modèle sélectionné. Omettre reasoning.context revient à choisir auto.
current_turn
Rend disponible le raisonnement du tour en cours sans intégrer celui des tours précédents au contexte de la génération suivante.
all_turns
Intègre au contexte de la génération suivante les éléments de raisonnement disponibles et compatibles des tours précédents. Les modèles GPT-5.6 et GPT-6.1 Sol prennent en charge cette valeur.
Le champ reasoning.context de la réponse indique le mode effectivement utilisé : current_turn ou all_turns. Vérifiez ce champ dans chaque réponse pour confirmer le mode utilisé par le modèle. Ce réglage ne crée aucun élément de raisonnement supplémentaire.
all_turns n’a d’effet que si la requête a accès aux éléments des réponses précédentes. Utilisez previous_response_id, associez la réponse à une conversation ou retransmettez manuellement l’historique complet des réponses. Lors de la première requête, current_turn et all_turns ont le même effet puisqu’il n’existe aucun raisonnement antérieur.
Seuls les modèles d’une même famille peuvent réutiliser le raisonnement conservé. Par exemple, gpt-5.6-sol, gpt-5.6-terra et gpt-5.6-luna peuvent chacun réutiliser le raisonnement des deux autres, mais le raisonnement ne se transmet pas entre les familles GPT-5.6 et GPT-5.5.
Lorsque vous changez de famille de modèles, l’API exclut du contexte du modèle les éléments de raisonnement incompatibles, même si reasoning.context vaut all_turns.
Poursuite du raisonnement à partir des réponses stockées
Pour l’intégration avec état la plus simple, utilisez previous_response_id :
Conservation du raisonnement à partir d’une réponse précédente
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";const client = new OpenAI();const first = await client.responses.create({ model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: "current_turn" },});const second = await client.responses.create({ model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"first = client.responses.create(model=model,input="Inspect this repository and identify the likely bug.",reasoning={"context": "current_turn"},)second = client.responses.create(model=model,previous_response_id=first.id,input="Now patch the bug and explain the change.",reasoning={"context": "all_turns"},)print(second.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
Utilisez current_turn lorsque vous retransmettez des éléments de réponses antérieures dont le modèle n’a plus besoin. Les éléments de raisonnement correspondants peuvent rester dans le corps de la requête API pour assurer la continuité, mais le service ne les intègre pas au contexte de la nouvelle génération. Vous pouvez ainsi réduire la taille du contexte utilisé dans les workflows de longue durée.
Conservation du raisonnement sans stockage des réponses
Lorsque vous créez une réponse en mode sans état, les éléments de raisonnement du tableau output de la réponse contiennent par défaut une propriété encrypted_content. Le mode sans état s’applique lorsque store vaut false ou que votre organisation applique une politique de non-conservation des données (ZDR). Pour des raisons de compatibilité, l’API accepte toujours l’ancienne valeur reasoning.encrypted_content dans include, mais elle ne l’exige plus.
La requête suivante renvoie le contenu chiffré du raisonnement sans que vous ayez à préciser include :
1
2
3
4
5
6
7
8
9
10curlhttps://api.openai.com/v1/responses\-H"Content-Type: application/json"\-H"Authorization: Bearer $OPENAI_API_KEY"\-d'{ "model": "gpt-6-astra", "store": false, "reasoning": {"effort": "medium"}, "input": "What is the weather like today?", "tools": [ ... function config here ... ] }'
Les éléments de raisonnement du tableau output contiennent une propriété encrypted_content qui regroupe les tokens de raisonnement chiffrés. Vous pouvez les transmettre lors d’appels ultérieurs.
Pour utiliser all_turns avec store: false, conservez chaque élément de sortie, ajoutez le message utilisateur suivant et retransmettez l’historique complet :
Conservation du raisonnement sans stockage des réponses
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const client = new OpenAI();const history = [ { role: "user", content: "Inspect this repository and identify the likely bug.", },];const first = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "current_turn" },});// Keep replayable output, including encrypted reasoning and assistant phase.history.push(...toResponseInputItems(first.output));history.push({ role: "user", content: "Now patch the bug and explain the change.",});const second = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"history = [ {"role": "user","content": "Inspect this repository and identify the likely bug.", }]first = client.responses.create(model=model,store=False,input=history,reasoning={"context": "current_turn"},)# Keep every output item, including encrypted reasoning and assistant phase.history.extend(item.to_dict() for item in first.output)history.append( {"role": "user","content": "Now patch the bug and explain the change.", })second = client.responses.create(model=model,store=False,input=history,reasoning={"context": "all_turns"},)print(second.output_text)
Maintien des éléments de raisonnement dans le contexte
Lorsque vous utilisez l’appel de fonction avec un modèle de raisonnement dans l’API Responses, renvoyez les éléments de raisonnement reçus avec les appels de fonction en même temps que les sorties des outils. Le modèle peut ainsi poursuivre son raisonnement après un appel d’outil.
Pour transmettre les éléments de raisonnement d’un appel à l’autre, utilisez previous_response_id. Si vous gérez vous-même l’historique de la conversation, incluez l’entrée initiale et tous les éléments de sortie de chaque réponse dans l’entrée de la requête suivante. Conservez ces éléments dans leur ordre d’origine et ajoutez les nouveaux éléments à la fin.
Avec les modèles de pointe récents, si vous modifiez l’historique qui précède un élément de raisonnement, l’API peut exclure le raisonnement correspondant du contexte. Consultez le guide Conservez le préfixe intact pour savoir comment modifier les instructions et les sorties des outils et comment gérer les longues conversations.
Modification du raisonnement en cours de conversation
Utilisez configuration_update pour augmenter l’effort de raisonnement lors des tâches difficiles ou le réduire pour les demandes de suivi courantes. Insérez la mise à jour entre deux réponses en conservant la valeur de reasoning.effort définie au niveau de la requête. Vous préservez ainsi le préfixe du prompt initial pour la mise en cache des prompts.
Avec les modèles compatibles de la génération GPT-6 ou d’une génération ultérieure, vous pouvez modifier l’effort de raisonnement et le format de réponse en mode standard avec un seul agent.
Ajoutez l’élément suivant avant le prochain message utilisateur dans le tableau input d’une requête HTTP à l’API Responses ou d’une requête WebSocket response.create :
Par exemple, si la conversation commence avec un effort réglé sur low au niveau de la requête, cette mise à jour sélectionne high pour la réponse suivante et toutes les réponses ultérieures, jusqu’à ce qu’une autre mise à jour remplace ce réglage.
Augmentation de l’effort de raisonnement pour une demande de suivi
Conservez les mises à jour avec previous_response_id ou retransmettez-les à leur position d’origine si vous gérez manuellement l’historique de la conversation. Le champ reasoning.effort de la réponse continue d’indiquer le réglage défini au niveau de la requête, même si la mise à jour a sélectionné un autre niveau d’effort.
Vous pouvez définir reasoning.effort et text.format dans le même élément configuration_update. Si vous modifiez un seul de ces paramètres, l’autre conserve sa valeur.
Ne combinez pas les mises à jour de configuration avec le compactage automatique ou la troncature automatique. Le point de terminaison autonome /responses/compact rejette également les historiques qui contiennent ces mises à jour.
Vous pouvez néanmoins déclencher explicitement le compactage de l’historique en incluant un élément compaction_trigger dans une requête /responses. Après le compactage, ajoutez un nouvel élément configuration_update avant le prochain message utilisateur. Indiquez-y de nouveau la valeur de chaque paramètre que vous avez modifié, y compris le format de réponse si vous l’avez modifié.
Les conditions habituelles de mise en cache des prompts continuent de s’appliquer. Pour envoyer des instructions utilisateur pendant la génération d’une réponse, consultez le guide sur le guidage en cours de tour.
Résumés du raisonnement
Les tokens de raisonnement bruts produits par le modèle ne sont pas accessibles, mais le paramètre summary permet de consulter un résumé de son raisonnement. Consultez la documentation des modèles pour vérifier quels modèles de raisonnement prennent en charge les résumés.
Les réglages disponibles pour les résumés du raisonnement varient selon le modèle. Par exemple, notre modèle d’utilisation de l’ordinateur prend en charge le réglage concise, tandis qu’o4-mini prend en charge detailed. Pour obtenir le résumé le plus détaillé disponible pour un modèle, définissez ce paramètre sur auto. Pour la plupart des modèles de raisonnement actuels, auto équivaut à detailed, mais des réglages plus fins pourraient être proposés à l’avenir.
Le résumé du raisonnement figure dans le tableau summary associé au type reasoning dans l’élément de sortie. L’API ne l’inclut que si vous demandez explicitement un résumé du raisonnement.
L’exemple ci-dessous montre comment demander un résumé du raisonnement dans une requête API.
Inclusion d’un résumé du raisonnement dans la réponse de l’API
Python
1
2
3
4
5
6
7
8
9
10
11
12
13import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "What is the capital of France?", reasoning: { effort: "low", summary: "auto", },});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="What is the capital of France?",reasoning={"effort": "low", "summary": "auto"},)print(response.output)
Cette requête API renvoie un tableau de sortie qui contient à la fois un message de l’assistant et un résumé du raisonnement suivi par le modèle pour produire cette réponse.
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
Pour les workflows de longue durée ou qui font de nombreux appels d’outils avec GPT-5.5 et GPT-5.4 dans l’API Responses, utilisez le champ phase des messages de l’assistant afin d’éviter les arrêts prématurés et d’autres comportements indésirables.
L’API n’exige pas phase, mais OpenAI recommande de l’utiliser. Utilisez phase: "commentary" pour les messages intermédiaires de l’assistant, par exemple les préambules aux appels d’outils, et phase: "final_answer" pour la réponse finale. N’ajoutez pas phase aux messages utilisateur.
Le plus simple est généralement d’utiliser previous_response_id, qui préserve l’état antérieur de l’assistant. Si vous retransmettez manuellement l’historique de l’assistant, conservez chaque valeur d’origine de phase.
Si le champ phase est absent ou supprimé, les préambules risquent d’être traités comme des réponses finales dans ces workflows. Pour des conseils de rédaction des prompts propres au modèle, consultez le guide Rédaction de prompts pour GPT-5.5.
Retransmission des valeurs de phase de l’assistant
Retransmission des valeurs de phase de l’assistant
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: [ { role: "assistant", phase: "commentary", content: "I’ll inspect the logs and then summarize root cause and remediation.", }, { role: "assistant", phase: "final_answer", content: "Root cause: cache invalidation race.", }, { role: "user", content: "Great—now give me a rollout-safe fix plan.", }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input=[ {"role": "assistant","phase": "commentary","content": "I’ll inspect the logs and then summarize root cause and remediation.", }, {"role": "assistant","phase": "final_answer","content": "Root cause: cache invalidation race.", }, {"role": "user","content": "Great—now give me a rollout-safe fix plan.", }, ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: [ { role: :assistant, phase: :commentary, content: "I'll inspect the logs and then summarize root cause and remediation." }, { role: :assistant, phase: :final_answer, content: "Root cause: cache invalidation race." }, { role: :user, content: "Great—now give me a rollout-safe fix plan." } ])puts(response.output_text)
Conseils de rédaction des prompts
Tenez compte des particularités des modèles de raisonnement lorsque vous rédigez vos prompts. Les modèles GPT-5 capables de raisonner donnent généralement de meilleurs résultats si vous leur fixez un objectif clair, des contraintes précises et des exigences explicites pour la sortie, sans leur dicter chaque étape intermédiaire.
Indiquez au modèle la tâche à accomplir, les contraintes à respecter et le format de sortie souhaité.
Utilisez reasoning.effort pour affiner le réglage du modèle. Si la qualité est insuffisante, ce paramètre ne doit pas être votre principal levier d’amélioration.
Pour les workflows agentiques ou qui nécessitent beaucoup de recherches, définissez les critères d’achèvement et précisez comment le modèle doit vérifier son travail.
Pour en savoir plus sur les bonnes pratiques d’utilisation des modèles de raisonnement, consultez ce guide.
Exemples de prompts
Programmation (refactorisation)
Les modèles de raisonnement peuvent implémenter des algorithmes complexes et générer du code. Ce prompt demande au modèle de refactoriser un composant React selon des critères précis.
Refactorisation de code
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Refactorisation de code
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Programmation (planification)
Les modèles de raisonnement peuvent aussi élaborer des plans en plusieurs étapes. Dans cet exemple, le prompt demande au modèle de créer l’arborescence des fichiers d’une solution complète et d’écrire le code Python qui répond au cas d’usage visé.
Planifier et créer un projet Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Planifier et créer un projet Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Recherche en sciences, technologies, ingénierie et mathématiques
Les modèles de la série o d’OpenAI ont obtenu d’excellents résultats en recherche dans les domaines des sciences, des technologies, de l’ingénierie et des mathématiques. Vous devriez obtenir de bons résultats en leur demandant de vous aider dans vos travaux de recherche fondamentale.
Posez des questions sur la recherche fondamentale
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Posez des questions sur la recherche fondamentale
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Exemples de cas d’usage
Vous trouverez dans le Cookbook des exemples concrets d’utilisation des modèles de raisonnement.