
L’API Decisions est désormais disponible pour tous. Découvrez les nouveautés depuis la bêta publique.
L’API Decisions évalue du texte, des images et des données JSON et renvoie des réponses typées environ dix fois plus vite que l’API Responses. Vous pouvez obtenir la probabilité qu’une condition soit vraie, un choix parmi des options prédéfinies ou un score selon un barème. Utilisez ces réponses pour classer du contenu, orienter les demandes et hiérarchiser les tâches dans votre application.
Essayez l’API Decisions dans le Playground pour tester différentes questions et données d’entrée avant d’écrire du code.
Envoyez vos requêtes à POST /v1/decisions avec gpt-6-luna, le seul modèle actuellement pris en charge.
Nouveautés
Depuis le lancement de la bêta publique, l’API Decisions propose les fonctionnalités suivantes :
- Mise en cache des prompts. Réutilisez les mêmes données d’entrée dans plusieurs requêtes et bénéficiez du tarif réduit de lecture du cache.
- Images dans les instructions des questions. Fournissez à chaque question ses propres images à comparer aux données communes.
- Entrée JSON. Transmettez directement des données structurées dans un élément de contenu
input_json. - Davantage de questions par requête. Posez jusqu’à 400 questions par requête, contre 200 pendant la bêta publique.
- Images hébergées en entrée. Transmettez des URL d’images HTTP ou HTTPS accessibles publiquement ou des URL de données intégrant les images en base64.
- Historique de conversation. Évaluez les messages avec les appels de fonction, les appels d’outils personnalisés et leurs sorties.
- Rapports d’utilisation par organisation. Suivez la consommation de tokens et le nombre de requêtes.
- Intégration native à GPT-Live. Laissez Live appeler directement Decisions ou déclenchez des décisions à mesure que vous recevez les transcriptions en entrée ou en sortie.
- Private Link. Envoyez vos requêtes à Decisions via une connexion privée.
Fonctionnement de Decisions
Une requête comprend trois champs :
| Champ | Rôle |
|---|---|
model |
Modèle qui évalue la requête. Actuellement, seul gpt-6-luna est pris en charge. |
input |
Données communes aux questions : une chaîne de texte ou un tableau ordonné de messages, d’appels d’outils et de sorties d’outils. |
questions |
Éléments à évaluer, avec le type et les instructions de chaque question ainsi que les choix ou niveaux de score autorisés, le cas échéant. |
La réponse contient un tableau answers. Attribuez à chaque question un name unique pour identifier sa réponse. L’API reprend ce nom dans la réponse.
Choisissez un type de question
| Type | Utilisation | Résultat principal |
|---|---|---|
predicate |
Vérifier une condition, comme la présence de dommages visibles ou la pertinence d’un passage. | probability : estimation, entre 0 et 1, de la probabilité que la condition soit vraie. |
choice |
Choisir une option, par exemple un service ou une catégorie de contenu. | choice : l’une des valeurs fournies. |
score |
Évaluer une entrée sur une échelle ordonnée, par exemple pour déterminer la gravité d’un problème. | score : moyenne des indices des niveaux, pondérée par leurs probabilités. |
Les types choice et score renvoient tous deux les probabilités associées à des options discrètes. Utilisez choice pour des catégories sans ordre particulier, comme des services. Utilisez score pour des niveaux ordonnés, par exemple des degrés de gravité. Le score correspond à la moyenne des indices numériques des niveaux, pondérée par leurs probabilités, et peut donc se situer entre deux niveaux.
Utilisez Decisions lorsque votre application a besoin de l’un de ces types de réponses. Utilisez les sorties structurées avec l’API Responses pour générer un objet conforme à votre propre schéma JSON, par exemple un objet contenant des champs extraits ou une explication rédigée. Utilisez l’appel de fonction si le modèle doit demander l’exécution d’un outil avec des arguments.
Évaluez une conversation
Transmettez l’historique de la conversation dans input pour évaluer une demande dans son contexte. Incluez dans l’ordre les messages ainsi que les éventuels appels de fonction ou d’outils personnalisés et leurs sorties. Associez chaque sortie d’outil à l’appel correspondant avec call_id.
Le contenu pris en charge dépend du rôle du message ou du type d’élément :
| Élément d’entrée | Contenu pris en charge |
|---|---|
| Message utilisateur | Texte, images et données JSON |
| Message développeur ou système | Texte d’entrée uniquement. Les messages système sont traités comme des messages développeur. |
| Message de l’assistant | Texte de sortie ou refus |
| Sortie de fonction ou d’outil personnalisé | Texte et images associés à l’appel d’outil correspondant |
Les appels d’outils et leurs sorties servent de base à l’évaluation des questions. Decisions renvoie des réponses typées. Votre application exécute les actions sélectionnées à partir de ces réponses. Les fichiers, les données audio et les références à des éléments ne sont pas pris en charge. Consultez la référence sur la création de décisions pour connaître les champs d’entrée acceptés.
Évaluez des données JSON
Utilisez un élément de contenu input_json pour transmettre des données structurées sans devoir les convertir en chaîne de caractères. Placez l’objet ou le tableau JSON dans data, aux côtés des éventuels éléments de texte ou d’image du message utilisateur. Dans le contenu d’un message, input_json est pris en charge uniquement pour le rôle user.
Par exemple, envoyez ce corps de requête JSON à POST /v1/decisions pour évaluer un ticket d’assistance à partir des données d’une commande :
{
"model": "gpt-6-luna",
"input": [
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "Evaluate the ticket using the order evidence."
},
{
"type": "input_json",
"data": {
"ticket": { "body": "Please refund the duplicate charge." },
"order": { "charges": [49, 49] }
}
}
]
}
],
"questions": [
{
"type": "predicate",
"name": "duplicate_charge",
"instructions": "Does the ticket describe a duplicate charge supported by the order?"
}
]
}Les clés JSON telles que role ou image_url dans data sont de simples données. Elles ne créent pas de messages et ne déclenchent pas le téléchargement d’images. Le format de la réponse dépend toujours du type de question choisi, même avec une entrée JSON.
Repérez les dommages visibles sur une image
Utilisez une question de type predicate pour vérifier si un produit présente des dommages visibles sur une photo. Cette requête associe l’image à des instructions demandant de rechercher une fissure, une déchirure ou un enfoncement.
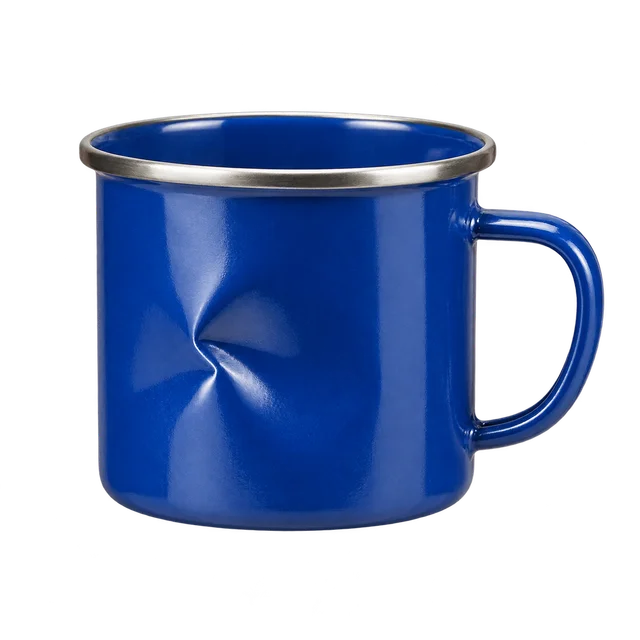
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
--data-binary @- <<JSON
{
"model": "gpt-6-luna",
"input": [{
"role": "user",
"content": [
{"type": "input_text", "text": "Inspect the product in this photo."},
{"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
]
}],
"questions": [{
"type": "predicate",
"name": "visible_damage",
"instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
}]
}
JSONExtrait d’une réponse possible :
{
"answers": [
{
"type": "predicate",
"name": "visible_damage",
"probability": 0.92
}
]
}Le champ probability indique la probabilité, estimée par le modèle, que la condition soit vraie. Utilisez cette valeur pour signaler les photos à examiner selon le seuil de votre choix.
Fournissez les images sous forme d’URL de données intégrant l’image en base64 ou d’URL HTTP ou HTTPS accessibles publiquement. Ce point de terminaison ne prend pas en charge les entrées file_id. Combinez des éléments input_text et input_image dans un message utilisateur pour évaluer les images avec des instructions ou d’autres éléments de contexte.
Incluez des images dans les instructions des questions
Placez les données communes à toutes les questions dans input. Pour attribuer une image différente à chaque question, définissez son champ instructions comme un tableau non vide d’éléments input_text et input_image. Cette possibilité s’applique aux questions de type prédicat, choix ou score. Les instructions exclusivement textuelles peuvent rester sous forme de chaîne.
Par exemple, envoyez ce corps de requête JSON à POST /v1/decisions pour comparer une image candidate à une référence commune. Remplacez les deux URL d’exemple par celles d’images accessibles publiquement ou utilisez des URL de données intégrant les images en base64 :
{
"model": "gpt-6-luna",
"input": [
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "The shared image is reference image A."
},
{
"type": "input_image",
"image_url": "https://example.com/reference.jpg"
}
]
}
],
"questions": [
{
"type": "predicate",
"name": "candidate_matches_reference",
"instructions": [
{
"type": "input_text",
"text": "Is candidate image B a derivative or variant of reference image A, including recompression or resizing?"
},
{
"type": "input_image",
"image_url": "https://example.com/candidate.jpg"
}
]
}
]
}Lorsque vous ajoutez des images aux instructions des questions :
- Ajoutez une question pour chaque image candidate. Chaque question compare sa propre image candidate à la même image de référence.
- Fournissez les éléments de contenu directement dans
instructions, sans les encapsuler dans un message ni préciser derole. - Les limites d’images par requête s’appliquent au total des images des questions et des images dans
input.
Choisissez parmi des options prédéfinies
Une question de type choice sélectionne une valeur parmi les options que vous fournissez. Utilisez des valeurs distinctes et expliquez dans chaque description quand l’option s’applique.
Cette requête détermine à quel service transmettre une réclamation client :
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-6-luna",
"input": "I was charged twice for my order.",
"questions": [{
"type": "choice",
"name": "department",
"instructions": "Which department should handle this complaint?",
"choices": [
{"value": "billing", "description": "Payments, invoices, and refunds."},
{"value": "technical", "description": "Problems using the product."},
{"value": "shipping", "description": "Delivery and tracking."},
{"value": "other", "description": "Requests outside these categories."}
]
}]
}'Extrait d’une réponse possible :
{
"answers": [
{
"type": "choice",
"name": "department",
"choice": "billing",
"probabilities": [
{ "value": "billing", "probability": 0.95 },
{ "value": "technical", "probability": 0.02 },
{ "value": "shipping", "probability": 0.01 },
{ "value": "other", "probability": 0.02 }
],
"confidence": 0.93
}
]
}Le champ choice de la réponse contient l’une des valeurs fournies, ici "billing". La réponse comprend aussi un tableau probabilities pour les différentes options et un champ confidence. Consultez la section Interprétez les réponses pour savoir comment définir des seuils.
Prévoyez une option par défaut, par exemple "other", si vos catégories ne couvrent pas toutes les entrées possibles. Votre application peut alors envoyer la demande dans une file d’attente générale pour examen.
Attribuez un score selon un barème
Une question de type score évalue une entrée sur une échelle de 2 à 10 niveaux ordonnés définis dans levels. Précisez les critères de chaque niveau et classez les niveaux du plus faible au plus élevé.
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-6-luna",
"input": "Export fails in Safari but works in Chrome.",
"questions": [{
"type": "score",
"name": "severity",
"instructions": "How severe is this issue?",
"levels": [
{"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
{"label": "Workaround available", "description": "A task fails, but another way works."},
{"label": "Fully blocked", "description": "A task fails with no workaround."}
]
}]
}'Extrait d’une réponse possible :
{
"answers": [
{
"type": "score",
"name": "severity",
"score": 1.1,
"probabilities": [
{ "value": 0, "label": "Cosmetic", "probability": 0.1 },
{ "value": 1, "label": "Workaround available", "probability": 0.7 },
{ "value": 2, "label": "Fully blocked", "probability": 0.2 }
],
"confidence": 0.55
}
]
}Les indices des niveaux commencent à 0. Ici, 0 correspond à un problème purement esthétique, 1 à un problème pour lequel il existe une solution de contournement et 2 à un blocage complet. La valeur score renvoyée est une moyenne pondérée par les probabilités et peut donc se situer entre deux niveaux. Dans cet exemple, les probabilités de 0,1, 0,7 et 0,2 donnent un score de 1,1.
La réponse comprend également le champ confidence et les probabilités de chaque niveau dans probabilities. Le score résume la distribution des probabilités entre les niveaux. Utilisez choice pour sélectionner une seule catégorie.
Posez plusieurs questions
Incluez entre 1 et 400 questions par requête. Regroupez les questions indépendantes dans le même tableau questions pour évaluer des données d’entrée communes. Pour une photo de produit, une seule requête peut à la fois détecter des dommages et déterminer la catégorie du produit. Chaque question peut être d’un type différent.
Si une décision dépend d’une réponse précédente, envoyez des requêtes distinctes. Par exemple, vérifiez d’abord si le produit est endommagé, puis utilisez le résultat pour décider s’il faut demander quelle catégorie de réparation convient.
Formulez vos questions à partir de critères observables. Consacrez une question à chaque aspect à évaluer, donnez à chaque choix une signification distincte et définissez des critères qui permettent de distinguer deux niveaux de score consécutifs.
Interprétez les réponses
Les prédicats renvoient une estimation de la probabilité qu’une condition soit vraie. Les réponses aux questions de type choix ou score contiennent une distribution des probabilités et un champ confidence distinct.
Utilisez des exemples annotés issus de votre application pour définir les seuils d’orientation, de filtrage ou d’examen. Choisissez ces seuils en fonction du coût des faux positifs et des faux négatifs.
Réutilisez les entrées communes grâce à la mise en cache des prompts
La mise en cache des prompts permet à plusieurs requêtes de réutiliser un préfixe identique dans les données communes du champ input et de bénéficier du tarif réduit de lecture du cache. Par exemple, conservez un document ou une image de référence dans input et modifiez les questions à chaque requête. Le contenu de questions, y compris les images propres à chaque question, ne fait pas partie du préfixe réutilisable.
Par défaut, Decisions place une limite de cache implicite à la fin des données communes dans input. Les requêtes existantes peuvent ainsi bénéficier du cache sans modification de leur corps. Le préfixe réutilisable doit contenir au moins 1 024 tokens. Le contenu des questions ne compte pas dans ce seuil. Conservez un préfixe identique d’une requête à l’autre pour permettre sa réutilisation.
Utilisez prompt_cache_key pour répartir les requêtes qui réutilisent le cache selon une clé fournie par l’appelant. Pour choisir où se termine le préfixe, ajoutez prompt_cache_breakpoint: {"mode": "explicit"} aux éléments de texte ou d’image des données communes dans input. Définissez prompt_cache_options.mode sur "explicit" pour utiliser uniquement les limites indiquées. En mode explicite, une requête sans limite indiquée n’utilise pas la mise en cache des prompts. Les instructions des questions ne prennent pas en charge les limites de cache.
Consultez usage.input_tokens_details.cached_tokens pour connaître le nombre de tokens lus dans le cache et usage.input_tokens_details.cache_write_tokens pour celui des tokens écrits. Ces deux nombres sont déjà inclus dans usage.input_tokens. Ne les ajoutez pas au total. Consultez le guide de mise en cache des prompts pour comprendre le fonctionnement du cache et la référence de Decisions pour connaître les paramètres de requête pris en charge.
Suivez l’utilisation
Utilisez GET /v1/organization/usage/decisions pour récupérer le nombre de tokens consommés et le nombre de requêtes envoyées à Decisions par votre organisation. Authentifiez-vous avec une clé API d’administration disposant de l’autorisation api.usage.read.
Choisissez une période et une durée d’intervalle, puis filtrez ou regroupez les résultats par projet, clé API ou modèle. Le champ num_model_requests comptabilise les requêtes : une requête contenant plusieurs questions ne compte qu’une fois. Consultez la référence sur l’utilisation de Decisions pour en savoir plus sur les filtres et la pagination.
Tarifs et disponibilité
Avec gpt-6-luna, les entrées hors cache coûtent 0,10 $ par million de tokens. Les entrées trouvées dans le cache bénéficient d’un tarif réduit. Les écritures dans le cache sont facturées. Les tarifs de lecture et d’écriture correspondent aux tarifs standard de mise en cache des prompts pour gpt-6-luna. Les tokens de sortie ne sont pas facturés.
Les majorations pour le traitement régional et les coefficients tarifaires pour les entrées à contexte long s’appliquent. Ces tarifs concernent /v1/decisions. Les autres requêtes utilisant gpt-6-luna suivent la tarification applicable au modèle et au niveau de traitement.
Pour les clients éligibles, l’API Decisions prend en charge la politique de non-conservation des données (ZDR) et les usages conformes à la loi HIPAA. La résidence des données est disponible dans toutes les régions prises en charge par l’API. Le traitement régional est disponible aux États-Unis et en Europe (EEE et Suisse). Consultez la documentation sur les contrôles des données pour connaître les conditions d’éligibilité, les accords requis et les limites applicables.
Ajoutez la commande vocale
Connectez la voix à Decisions pour choisir une action à partir d’une demande orale ou réagir pendant que votre utilisateur ou GPT-Live parle.