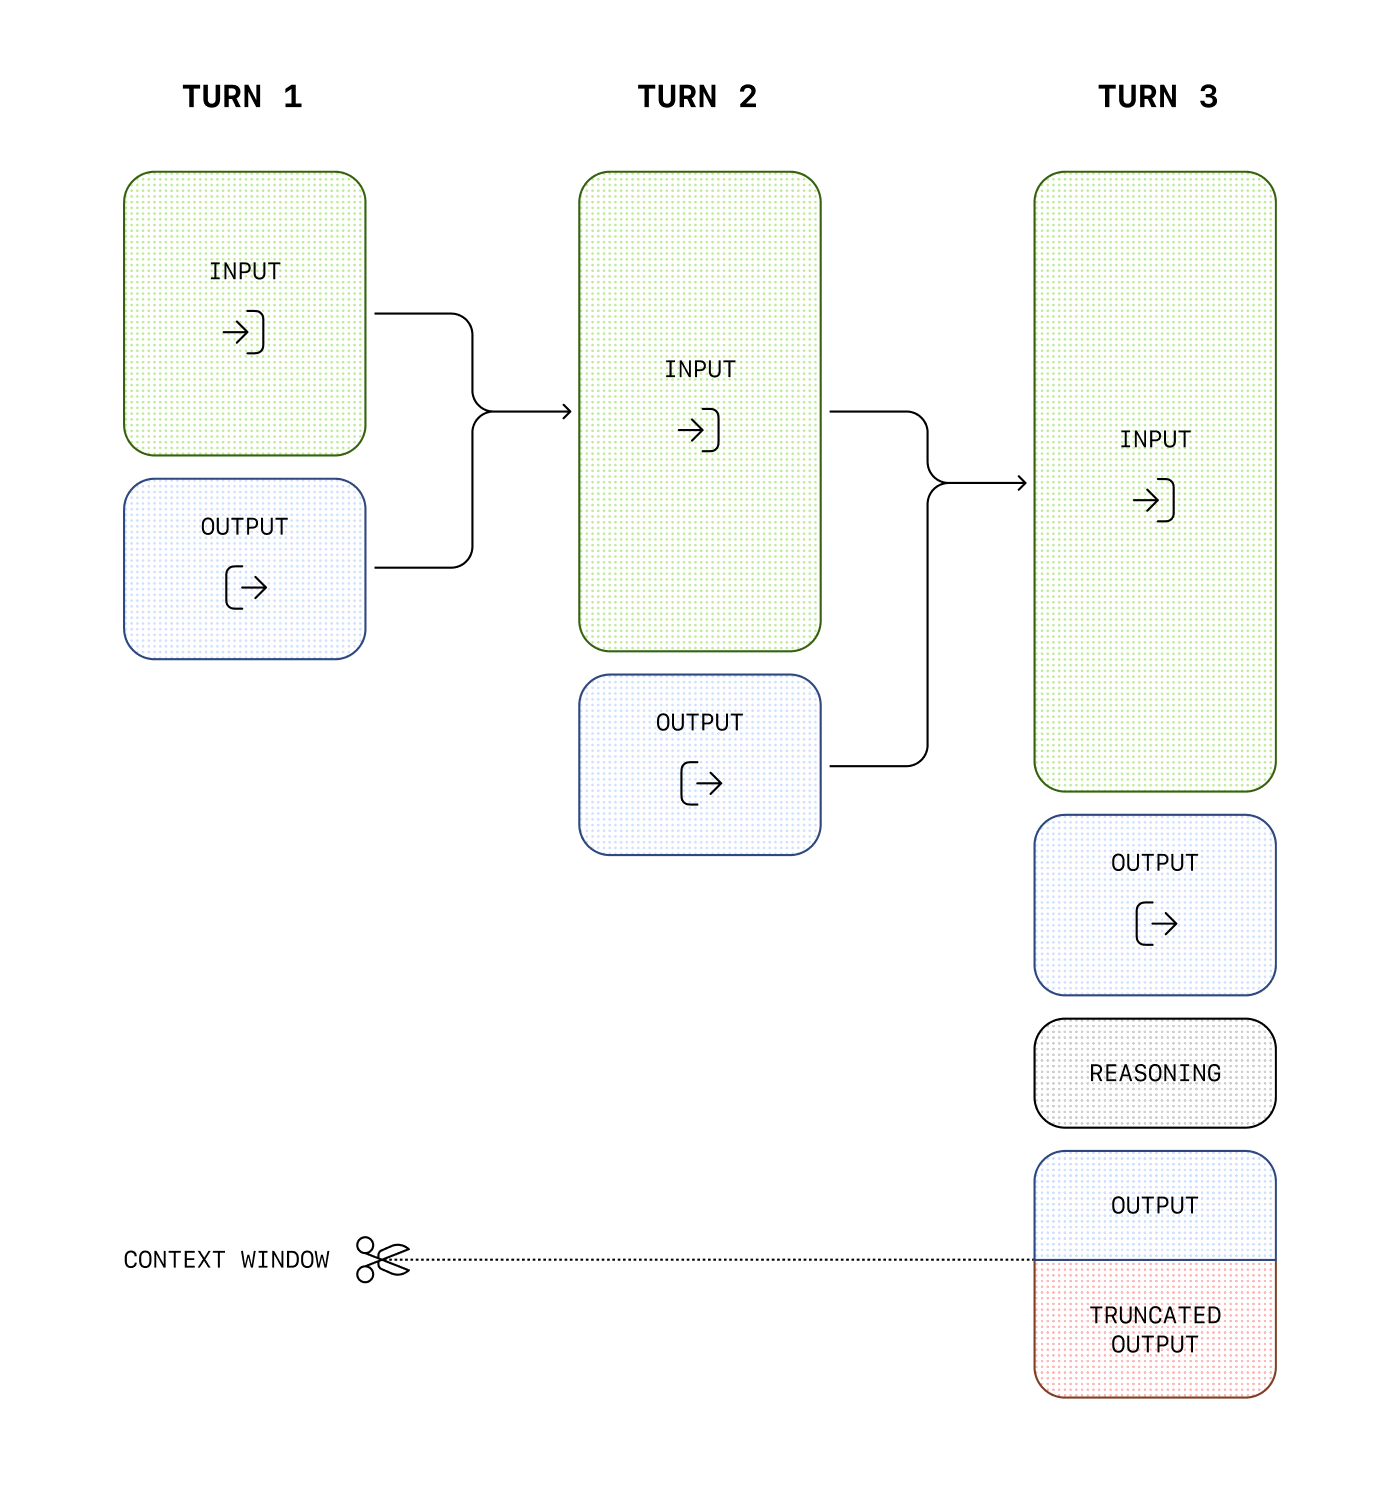
Découvrez comment fonctionnent les modèles de raisonnement et comment bien les utiliser.
Responses
Les modèles de raisonnement utilisent des tokens de raisonnement internes avant de produire une réponse. Cela aide le modèle à planifier, à utiliser efficacement les outils, à examiner différentes approches, à lever les ambiguïtés et à résoudre des tâches plus difficiles en plusieurs étapes. Les modèles de raisonnement sont particulièrement adaptés à la résolution de problèmes complexes, à la programmation, au raisonnement scientifique et aux workflows agentiques en plusieurs étapes. Ce sont aussi les meilleurs modèles pour Codex CLI, notre agent de programmation léger.
Commencez par gpt-6-astra pour la plupart des tâches de raisonnement. Pour réduire les coûts, envisagez gpt-5.6-terra, ou gpt-5.6-luna pour minimiser les coûts et la latence. Si vous utilisez un modèle GPT-5.6, consultez la section Mode de raisonnement pour en savoir plus sur son option pro.
Les modèles de raisonnement fonctionnent mieux avec l’API
Responses. L’API Chat Completions
reste prise en charge, mais vous bénéficierez d’une intelligence et de performances accrues du modèle en
utilisant Responses.
Premiers pas avec le raisonnement
Appelez l’API Responses et précisez votre modèle de raisonnement ainsi que l’effort de raisonnement souhaité :
Utilisation d’un modèle de raisonnement dans l’API Responses
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
Effort de raisonnement
Le paramètre reasoning.effort indique au modèle l’effort de réflexion à consacrer à une tâche.
Les valeurs prises en charge dépendent du modèle et peuvent inclure none, minimal, low, medium, high, xhigh et max. Un effort plus faible privilégie la rapidité et réduit la consommation de tokens, tandis qu’un effort plus élevé permet au modèle de réfléchir plus en profondeur pour fournir des réponses de meilleure qualité. À chaque niveau d’effort, les modèles adaptent aussi leur raisonnement : ils utilisent moins de tokens pour les tâches simples et réfléchissent davantage pour les tâches complexes.
GPT-6 Astra ne prend pas en charge l’effort de
raisonnement none. Définir reasoning.effort (Responses) ou reasoning_effort (Chat
Completions) sur none renvoie une erreur HTTP 400.
Utilisez l’API Responses pour l’appel de
fonction. Chat Completions ne prend pas en charge l’appel de fonction avec GPT-6 Astra.
Les valeurs par défaut dépendent elles aussi du modèle et ne sont pas universelles. gpt-5.5 utilise par défaut l’effort de raisonnement medium. C’est le meilleur point de départ pour profiter pleinement de l’équilibre entre qualité, fiabilité et performances de gpt-5.5.
Effort
Idéal pour
none
Les tâches où la latence est critique et qui ne tirent aucun bénéfice du raisonnement ni de l’enchaînement de plusieurs appels d’outils. Pour les cas d’utilisation sensibles à la latence avec gpt-5.5, nous recommandons de commencer par essayer low, puis de passer à none si nécessaire.
Les cas d’utilisation courants incluent la voix, la récupération rapide d’informations et la classification.
low
Un raisonnement efficace avec une légère hausse de la latence. Idéal pour les cas d’utilisation nécessitant des outils, de la planification, de la recherche ou des décisions en plusieurs étapes, tout en optimisant la rapidité et les coûts.
Les cas d’utilisation courants incluent l’analyse de données, la rédaction, la programmation axée sur l’exécution et les workflows de support client ou d’assistant conversationnel.
medium
Lorsque la qualité et la fiabilité comptent, et que la tâche demande de la planification, un raisonnement complexe et du discernement. Configuration par défaut pour la plupart des tâches, qui offre un bon équilibre sur la courbe de Pareto entre latence, performances et coûts.
Les cas d’utilisation courants incluent la programmation agentique, la recherche, le travail sur des feuilles de calcul et des présentations, ainsi que la délégation de tâches de longue durée.
high
Les raisonnements exigeants, le débogage complexe, la planification approfondie et les tâches à forte valeur ajoutée où la qualité et l’intelligence priment sur la latence. Recommandé pour les workflows complexes et les tâches agentiques.
Les cas d’utilisation courants incluent la programmation agentique, la recherche de longue durée et le travail intellectuel. Selon la complexité de la tâche, évaluez à la fois medium et high.
xhigh
La recherche approfondie, les workflows asynchrones et les tâches agentiques nécessitant une exécution de longue durée. Utilisez ce niveau uniquement si vos évaluations montrent un bénéfice clair qui justifie la latence et les coûts supplémentaires.
Les cas d’utilisation courants incluent la sécurité et la revue de code, la productivité en entreprise, les tâches de recherche plus approfondies et les workflows de programmation exigeants.
max
Un raisonnement maximal pour vos tâches les plus complexes. Si vous utilisez actuellement xhigh, évaluez si max offre de meilleures performances
Pour réduire le délai avant le premier token visible dans les applications sensibles à la latence, demandez au modèle de générer un court préambule avant de poursuivre avec un raisonnement plus approfondi.
Certains modèles ne prennent en charge qu’une partie de ces valeurs. Consultez donc la page du modèle concerné avant de choisir un réglage.
Mode de raisonnement
Les modèles GPT-5.6 prennent en charge les modes de raisonnement standard et pro dans l’API Responses. standard est le mode par défaut. Définissez reasoning.mode sur pro pour les tâches difficiles qui demandent davantage de travail au modèle et peuvent tolérer une latence et une consommation de tokens plus élevées.
Le mode de raisonnement et l’effort de raisonnement sont indépendants. Le mode sélectionne une exécution standard ou pro, tandis que reasoning.effort contrôle l’effort de raisonnement du modèle dans ce mode. Si vous omettez reasoning.effort, GPT-5.6 utilise medium par défaut dans les deux modes.
Le mode Pro comptabilise l’ensemble du travail effectué par le modèle pour produire la réponse finale et facture les tokens correspondants aux tarifs par token standard du modèle sélectionné. Le mode Pro sollicite davantage le modèle que le mode standard, ce qui augmente la consommation de tokens et les coûts. Les identifiants de modèles Pro existants conservent leur comportement et leur tarification actuels.
Fonctionnement du raisonnement
Les modèles de raisonnement introduisent des tokens de raisonnement en plus des tokens d’entrée et de sortie. Ils utilisent ces tokens de raisonnement pour « réfléchir », en décomposant le prompt et en examinant plusieurs approches pour générer une réponse. Nos modèles de raisonnement comme gpt-5.5 et gpt-5.4 prennent en charge le raisonnement entrelacé : le modèle peut générer des tokens de sortie visibles avant et entre ses phases de réflexion, et réfléchir entre les appels d’outils.
Pour les modèles sortis avant GPT-5.6, le comportement par défaut dans une conversation en plusieurs étapes consiste à reprendre les tokens d’entrée et de sortie de chaque étape sans intégrer le raisonnement des tours précédents au contexte de la génération suivante. Les modèles GPT-5.6 intègrent quant à eux par défaut le raisonnement disponible des tours précédents. Utilisez reasoning.context pour choisir l’un ou l’autre de ces comportements sur les modèles compatibles.
Bien que les tokens de raisonnement ne soient pas visibles via l’API, ils occupent de l’espace dans
la fenêtre de contexte du modèle et sont facturés comme des tokens de
sortie.
Maîtrise des coûts
Pour maîtriser les coûts des modèles de raisonnement, vous pouvez limiter le nombre total de tokens
générés par le modèle, y compris les tokens de raisonnement, les tokens de sortie visibles et les tokens
de mise en forme non visibles, à l’aide du paramètre
max_output_tokens.
Consultez la section sur le décompte des tokens de sortie pour savoir comment les tokens générés sont comptabilisés dans l’utilisation et les limites de sortie.
Gestion de la fenêtre de contexte
Veillez à laisser suffisamment d’espace dans la fenêtre de contexte pour les tokens de raisonnement lors de la création de réponses. Selon la complexité du problème, les modèles peuvent générer de quelques centaines à plusieurs dizaines de milliers de tokens de raisonnement. Le nombre exact de tokens de raisonnement utilisés est visible dans l’objet usage de l’objet de réponse, sous output_tokens_details :
Les tailles des fenêtres de contexte sont indiquées sur la page de référence des modèles et varient selon les versions figées des modèles.
Réservation d’espace pour le raisonnement
Si les tokens générés atteignent la limite de la fenêtre de contexte ou la valeur de max_output_tokens que vous avez définie, vous recevrez une réponse dont le champ status vaut incomplete et dont l’objet incomplete_details contient un champ reason défini sur max_output_tokens. Cela peut se produire avant la génération du moindre token de sortie visible : des tokens d’entrée et de raisonnement peuvent donc vous être facturés sans que vous receviez de réponse visible.
Pour éviter cela, assurez-vous de laisser suffisamment d’espace dans la fenêtre de contexte ou augmentez la valeur de max_output_tokens. OpenAI recommande de réserver au moins 25 000 tokens pour le raisonnement et les sorties lorsque vous commencez à expérimenter avec ces modèles. À mesure que vous cernez le nombre de tokens de raisonnement requis par vos prompts, vous pouvez ajuster cette réserve en conséquence.
Gestion des réponses incomplètes
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
Conservez le raisonnement d’un appel à l’autre
L’état de la conversation et l’état du raisonnement remplissent des fonctions différentes. Transmettre les messages d’un appel à l’autre donne au modèle accès à l’historique visible de la conversation. Sur les modèles compatibles, la persistance du raisonnement permet aussi au modèle d’intégrer les éléments de raisonnement compatibles des tours précédents à son prochain contexte.
La persistance du raisonnement assure la continuité sans exposer le raisonnement brut du modèle. Les éléments de raisonnement restent opaques et l’API ne renvoie pas le texte qu’ils contiennent. Définissez reasoning.context pour contrôler quels éléments de raisonnement disponibles le modèle peut utiliser :
La famille de modèles GPT-5.6
prend en charge
all_turns et l’utilise par défaut. Les modèles antérieurs utilisent par défaut
current_turn. Omettez reasoning.context ou définissez-le sur
auto pour utiliser la valeur par défaut du modèle sélectionné.
Valeur
Comportement
auto
Utilise la valeur par défaut du modèle sélectionné. Omettre reasoning.context a le même effet que auto.
current_turn
Rend disponible le raisonnement du tour en cours, mais n’intègre pas le raisonnement des tours précédents au contexte de la génération suivante.
all_turns
Intègre les éléments de raisonnement disponibles et compatibles des tours précédents au contexte de la génération suivante. Les modèles GPT-5.6 prennent en charge cette valeur.
Le champ reasoning.context de la réponse contient le mode effectivement utilisé, soit current_turn, soit all_turns. Vérifiez ce champ dans chaque réponse pour confirmer le mode utilisé par le modèle. Ce réglage ne crée aucun élément de raisonnement qui ne soit déjà disponible.
all_turns n’a d’effet que si la requête a accès aux éléments des réponses précédentes. Utilisez previous_response_id, associez la réponse à une conversation ou retransmettez manuellement l’historique complet des réponses. Lors de la première requête, current_turn et all_turns se comportent de la même manière, car aucun raisonnement antérieur n’existe.
Le raisonnement conservé ne peut être réutilisé qu’au sein d’une même famille de modèles. Par exemple, gpt-5.6-sol, gpt-5.6-terra et gpt-5.6-luna peuvent réutiliser le raisonnement les uns des autres, mais le raisonnement ne se transmet pas entre les familles GPT-5.6 et GPT-5.5.
Lorsque vous changez de famille de modèles, l’API exclut le raisonnement incompatible du contexte du modèle, même lorsque reasoning.context est défini sur all_turns.
Poursuivez le raisonnement avec des réponses stockées
Utilisez previous_response_id pour une intégration avec état aussi simple que possible :
Conservez le raisonnement à l’aide d’une réponse précédente
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";const client = new OpenAI();const first = await client.responses.create({ model: "gpt-5.6", input: "Inspect this repository and identify the likely bug.", reasoning: { context: "current_turn" },});const second = await client.responses.create({ model: "gpt-5.6", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIclient = OpenAI()model ="gpt-5.6"first = client.responses.create(model=model,input="Inspect this repository and identify the likely bug.",reasoning={"context": "current_turn"},)second = client.responses.create(model=model,previous_response_id=first.id,input="Now patch the bug and explain the change.",reasoning={"context": "all_turns"},)print(second.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-5.6", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-5.6", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
Utilisez current_turn lorsque vous retransmettez d’anciens éléments de réponse dont le modèle n’a plus besoin. Ces éléments de raisonnement peuvent rester dans les données transmises à l’API pour assurer la continuité, mais le service ne les intègre pas au contexte de la nouvelle génération. Cela peut réduire le contexte fourni au modèle pour les workflows de longue durée.
Conservez le raisonnement sans réponses stockées
Lorsque vous créez une réponse en mode sans état, les éléments de raisonnement du tableau output de la réponse incluent par défaut une propriété encrypted_content. Le mode sans état s’applique lorsque store vaut false ou lorsque votre organisation utilise la politique de non-conservation des données (ZDR). L’API accepte toujours l’ancienne valeur reasoning.encrypted_content dans include pour assurer la compatibilité, mais ne l’exige pas.
La requête suivante renvoie le contenu chiffré du raisonnement sans spécifier include :
1
2
3
4
5
6
7
8
9
10curlhttps://api.openai.com/v1/responses\-H"Content-Type: application/json"\-H"Authorization: Bearer $OPENAI_API_KEY"\-d'{ "model": "gpt-6-astra", "store": false, "reasoning": {"effort": "medium"}, "input": "What is the weather like today?", "tools": [ ... function config here ... ] }'
Les éléments de raisonnement du tableau output incluront une propriété encrypted_content contenant des tokens de raisonnement chiffrés que vous pourrez transmettre aux appels suivants.
Pour utiliser all_turns avec store: false, conservez chaque élément de sortie, ajoutez le message utilisateur suivant à la fin, puis retransmettez l’historique complet :
Conservez le raisonnement sans stocker les réponses
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const client = new OpenAI();const history = [ { role: "user", content: "Inspect this repository and identify the likely bug.", },];const first = await client.responses.create({ model: "gpt-5.6", store: false, input: history, reasoning: { context: "current_turn" },});// Keep replayable output, including encrypted reasoning and assistant phase.history.push(...toResponseInputItems(first.output));history.push({ role: "user", content: "Now patch the bug and explain the change.",});const second = await client.responses.create({ model: "gpt-5.6", store: false, input: history, reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()model ="gpt-5.6"history = [ {"role": "user","content": "Inspect this repository and identify the likely bug.", }]first = client.responses.create(model=model,store=False,input=history,reasoning={"context": "current_turn"},)# Keep every output item, including encrypted reasoning and assistant phase.history.extend(item.model_dump() for item in first.output)history.append( {"role": "user","content": "Now patch the bug and explain the change.", })second = client.responses.create(model=model,store=False,input=history,reasoning={"context": "all_turns"},)print(second.output_text)
Conservez les éléments de raisonnement dans le contexte
Lorsque vous utilisez l’appel de fonction avec un modèle de raisonnement dans l’API Responses, nous vous recommandons vivement de retransmettre tous les éléments de raisonnement renvoyés avec le dernier appel de fonction, en plus de la sortie de votre fonction. Si le modèle appelle plusieurs fonctions consécutivement, nous vous recommandons de retransmettre tous les éléments de raisonnement, d’appel de fonction et de sortie d’appel de fonction depuis le dernier message user. Le modèle peut ainsi poursuivre son raisonnement pour produire de meilleurs résultats tout en utilisant les tokens le plus efficacement possible.
Le plus simple consiste à transmettre tous les éléments de raisonnement d’une réponse précédente à la suivante. Nos systèmes ignorent intelligemment les éléments de raisonnement qui ne sont pas pertinents pour vos fonctions et ne conservent dans le contexte que ceux qui le sont. Vous pouvez transmettre les éléments de raisonnement des réponses précédentes à l’aide du paramètre previous_response_id, ou en transmettant manuellement tous les éléments de sortie d’une réponse précédente en entrée d’une nouvelle réponse.
Pour les cas d’utilisation avancés où vous tronquez et optimisez certaines parties de la fenêtre de contexte avant de les transmettre à la réponse suivante, veillez simplement à transmettre sans modification tous les éléments compris entre le dernier message utilisateur et la sortie de votre appel de fonction. Le modèle disposera ainsi de tout le contexte nécessaire.
Consultez ce guide pour en savoir plus sur la gestion manuelle du contexte.
Modifiez le raisonnement en cours de conversation
Utilisez configuration_update pour augmenter l’effort de raisonnement lors de tâches difficiles ou le réduire pour des demandes de suivi courantes. Ajoutez la mise à jour entre les réponses en laissant inchangé le paramètre reasoning.effort défini au niveau de la requête. Cela préserve le préfixe initial du prompt pour la mise en cache des prompts.
Les mises à jour de configuration sont prises en charge uniquement par GPT-6 Astra (gpt-6-astra) en
mode standard à agent unique. Elles modifient uniquement l’effort de raisonnement.
Ajoutez l’élément suivant avant le prochain message utilisateur dans le tableau input d’une requête HTTP à l’API Responses ou d’une requête WebSocket response.create :
Par exemple, si la conversation commence avec un effort défini sur low au niveau de la requête, cette mise à jour sélectionne high pour la réponse suivante et les réponses ultérieures, jusqu’à ce qu’une autre mise à jour le remplace.
Augmentez l’effort de raisonnement pour une demande de suivi
Conservez les mises à jour à l’aide de previous_response_id, ou retransmettez-les à leur position d’origine lorsque vous gérez manuellement l’historique de la conversation. Le champ reasoning.effort de la réponse continue d’indiquer le réglage défini au niveau de la requête, et non l’effort sélectionné par la mise à jour.
Ne placez pas deux éléments configuration_update directement l’un à la suite de l’autre dans l’historique de la conversation ; l’API rejette les mises à jour adjacentes.
Ne combinez pas les mises à jour de configuration avec le compactage automatique ou la troncature automatique. Le point de terminaison autonome /responses/compact rejette également les historiques contenant ces mises à jour.
Vous pouvez toujours compacter explicitement l’historique en incluant un élément compaction_trigger dans une requête /responses. Après le compactage, ajoutez un nouvel élément configuration_update avec l’effort souhaité avant le prochain message utilisateur.
Les exigences habituelles de mise en cache des prompts continuent de s’appliquer. Pour envoyer des instructions utilisateur pendant la génération d’une réponse, utilisez la réorientation en cours de tour.
Résumés du raisonnement
Nous ne rendons pas accessibles les tokens de raisonnement bruts émis par le modèle, mais vous pouvez consulter un résumé de son raisonnement à l’aide du paramètre summary. Consultez notre documentation sur les modèles pour vérifier quels modèles de raisonnement prennent en charge les résumés.
Les réglages de résumé du raisonnement pris en charge varient selon les modèles. Par exemple, notre modèle d’utilisation de l’ordinateur prend en charge le mode de résumé concise, tandis qu’o4-mini prend en charge detailed. Pour obtenir le résumé le plus détaillé disponible pour un modèle, définissez ce paramètre sur auto. Pour la plupart des modèles de raisonnement actuels, auto équivaut à detailed, mais des réglages plus fins pourraient être proposés à l’avenir.
Le résumé du raisonnement figure dans le tableau summary de l’élément de sortiereasoning. Il n’est inclus que si vous demandez explicitement l’inclusion des résumés du raisonnement.
L’exemple ci-dessous montre comment effectuer une requête API qui inclut un résumé du raisonnement.
Incluez un résumé du raisonnement dans la réponse de l’API
Python
1
2
3
4
5
6
7
8
9
10
11
12
13import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "What is the capital of France?", reasoning: { effort: "low", summary: "auto", },});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="What is the capital of France?",reasoning={"effort": "low", "summary": "auto"},)print(response.output)
Cette requête API renverra un tableau de sortie contenant à la fois un message de l’assistant et un résumé du raisonnement suivi par le modèle pour générer cette réponse.
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
Pour les workflows de longue durée ou faisant largement appel aux outils avec GPT-5.5 et GPT-5.4 dans l’API Responses, utilisez le champ phase des messages de l’assistant afin d’éviter les arrêts prématurés et autres comportements indésirables.
phase est facultatif au niveau de l’API, mais OpenAI recommande de l’utiliser. Utilisez phase: "commentary" pour les messages intermédiaires de l’assistant, comme les préambules avant les appels d’outils, et phase: "final_answer" pour la réponse finale. N’ajoutez pas phase aux messages utilisateur.
L’utilisation de previous_response_id est généralement la solution la plus simple, car elle préserve l’état antérieur de l’assistant. Si vous retransmettez manuellement l’historique de l’assistant, conservez chaque valeur d’origine de phase.
L’absence ou la suppression de phase peut conduire à traiter les préambules comme des réponses finales dans ces workflows. Pour des conseils de conception de prompts propres au modèle, consultez Conception de prompts pour GPT-5.5.
Retransmettez les valeurs de phase de l’assistant
Retransmettez les valeurs de phase de l’assistant
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: [ { role: "assistant", phase: "commentary", content: "I’ll inspect the logs and then summarize root cause and remediation.", }, { role: "assistant", phase: "final_answer", content: "Root cause: cache invalidation race.", }, { role: "user", content: "Great—now give me a rollout-safe fix plan.", }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input=[ {"role": "assistant","phase": "commentary","content": "I’ll inspect the logs and then summarize root cause and remediation.", }, {"role": "assistant","phase": "final_answer","content": "Root cause: cache invalidation race.", }, {"role": "user","content": "Great—now give me a rollout-safe fix plan.", }, ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: [ { role: :assistant, phase: :commentary, content: "I'll inspect the logs and then summarize root cause and remediation." }, { role: :assistant, phase: :final_answer, content: "Root cause: cache invalidation race." }, { role: :user, content: "Great—now give me a rollout-safe fix plan." } ])puts(response.output_text)
Conseils de conception de prompts
Tenez compte de ces différences lorsque vous rédigez un prompt pour un modèle de raisonnement. Les modèles GPT-5 capables de raisonner donnent généralement les meilleurs résultats lorsque vous leur fournissez un objectif clair, des contraintes strictes et des exigences explicites pour la sortie, sans imposer chaque étape intermédiaire.
Indiquez au modèle la tâche, les contraintes et le format de sortie souhaité.
Utilisez reasoning.effort pour affiner les réglages, et non comme principal moyen de corriger un problème de qualité.
Pour les workflows agentiques ou nécessitant beaucoup de recherche, définissez les critères d’achèvement de la tâche et la manière dont le modèle doit vérifier son travail.
Pour en savoir plus sur les bonnes pratiques d’utilisation des modèles de raisonnement, consultez ce guide.
Exemples de prompts
Programmation (refactorisation)
Les modèles de la série o d’OpenAI peuvent implémenter des algorithmes complexes et produire du code. Ce prompt demande à o1 de refactoriser un composant React selon des critères précis.
Refactorisation du code
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Refactorisation du code
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Programmation (planification)
Les modèles de la série o d’OpenAI savent également élaborer des plans en plusieurs étapes. Cet exemple de prompt demande à o1 de créer une arborescence de fichiers pour une solution complète, ainsi que le code Python qui met en œuvre le cas d’usage souhaité.
Planifiez et créez un projet Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Planifiez et créez un projet Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Recherche en sciences, technologies, ingénierie et mathématiques
Les modèles de la série o d’OpenAI ont démontré d’excellentes performances en recherche dans les domaines STEM. Les prompts demandant de l’aide pour des tâches de recherche fondamentale devraient donner de très bons résultats.
Posez des questions sur la recherche scientifique fondamentale
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Posez des questions sur la recherche scientifique fondamentale
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Exemples de cas d’utilisation
Vous trouverez des exemples concrets d’utilisation des modèles de raisonnement dans le Cookbook.