Dê aos modelos acesso a novos recursos e dados para que possam seguir instruções e responder a prompts.
Responses
A chamada de função (também conhecida como chamada de ferramenta) oferece aos modelos da OpenAI uma maneira poderosa e flexível de interagir com sistemas externos e acessar dados que não fizeram parte do treinamento. Este guia mostra como conectar um modelo aos dados e às ações que seu aplicativo oferece. Você verá como usar ferramentas do tipo função (definidas por um schema JSON) e ferramentas personalizadas que recebem e retornam texto livre.
Em sessões da Agents API, use Funções para registrar funções e processar solicitações de ação da sessão. Os exemplos deste guia mostram integrações com a Responses API e com a API chat completions.
Se seu aplicativo tiver muitas funções ou schemas grandes, você pode combinar a chamada de função com a pesquisa de ferramentas para adiar o carregamento de ferramentas pouco usadas até que o modelo precise delas. Somente o gpt-5.4 e modelos posteriores oferecem suporte a tool_search.
O GPT-6 Astra e o GPT-6.1 Sol exigem a Responses API para chamadas de ferramenta. Os exemplos da API chat completions usam o GPT-5.6 Terra com o raciocínio desativado. Consulte o guia de migração para atualizar uma integração existente.
Como funciona
Antes de passar aos exemplos práticos, vamos conhecer alguns termos fundamentais para entender como funciona a chamada de ferramenta.
Uma função ou ferramenta é um recurso que apresentamos ao modelo como disponível para uso. Ao gerar uma resposta a um prompt, o modelo pode determinar que precisa dos dados ou recursos de uma ferramenta para seguir as instruções recebidas.
Você pode dar ao modelo acesso a ferramentas que permitem:
Consultar as condições do tempo de hoje em determinado local
Acessar os detalhes de uma conta a partir do ID do usuário
Emitir reembolsos por um pedido extraviado
Você também pode disponibilizar outras informações que o modelo precise consultar ou ações que ele possa executar ao responder a um prompt.
Ao enviar uma solicitação à API com um prompt para o modelo, podemos incluir uma lista de ferramentas que ele pode escolher usar. Por exemplo, para que o modelo responda a perguntas sobre as condições atuais do tempo em algum lugar do mundo, podemos dar a ele acesso a uma ferramenta get_weather que recebe location como argumento.
Uma chamada de função ou chamada de ferramenta é um tipo especial de resposta que o modelo pode retornar quando analisa um prompt e determina que precisa chamar uma das ferramentas disponíveis para seguir as instruções.
Se o modelo receber um prompt como “Como está o tempo em Paris?” em uma solicitação à API, ele poderá responder com uma chamada à ferramenta get_weather, passando Paris como valor do argumento location.
A saída de uma chamada de função ou saída de uma chamada de ferramenta é a resposta que a ferramenta gera a partir da entrada fornecida pelo modelo na chamada. Essa saída pode ser um JSON estruturado ou texto simples e deve incluir uma referência à chamada específica feita pelo modelo (identificada por call_id nos próximos exemplos).
Para completar o exemplo do tempo:
O modelo tem acesso a get_weather, uma ferramenta que recebe location como argumento.
Em resposta a um prompt como “Como está o tempo em Paris?”, o modelo retorna uma chamada de ferramenta com o argumento location definido como Paris.
A saída da chamada de ferramenta pode conter um objeto JSON (por exemplo, {"temperature": "25", "unit": "C"}, que indica uma temperatura atual de 25 graus), o conteúdo de uma imagem ou o conteúdo de um arquivo.
Em seguida, enviamos ao modelo a definição da ferramenta, o prompt original, a chamada de ferramenta feita pelo modelo e a saída da chamada. Assim, recebemos uma resposta em texto como esta:
The weather in Paris today is 25C.
Uma função é um tipo específico de ferramenta, definido por um schema JSON. A definição da função permite que o modelo passe dados ao seu aplicativo, onde seu código pode acessar dados ou executar ações sugeridas pelo modelo.
Além das ferramentas do tipo função, há ferramentas personalizadas (descritas neste guia) que recebem e retornam texto livre.
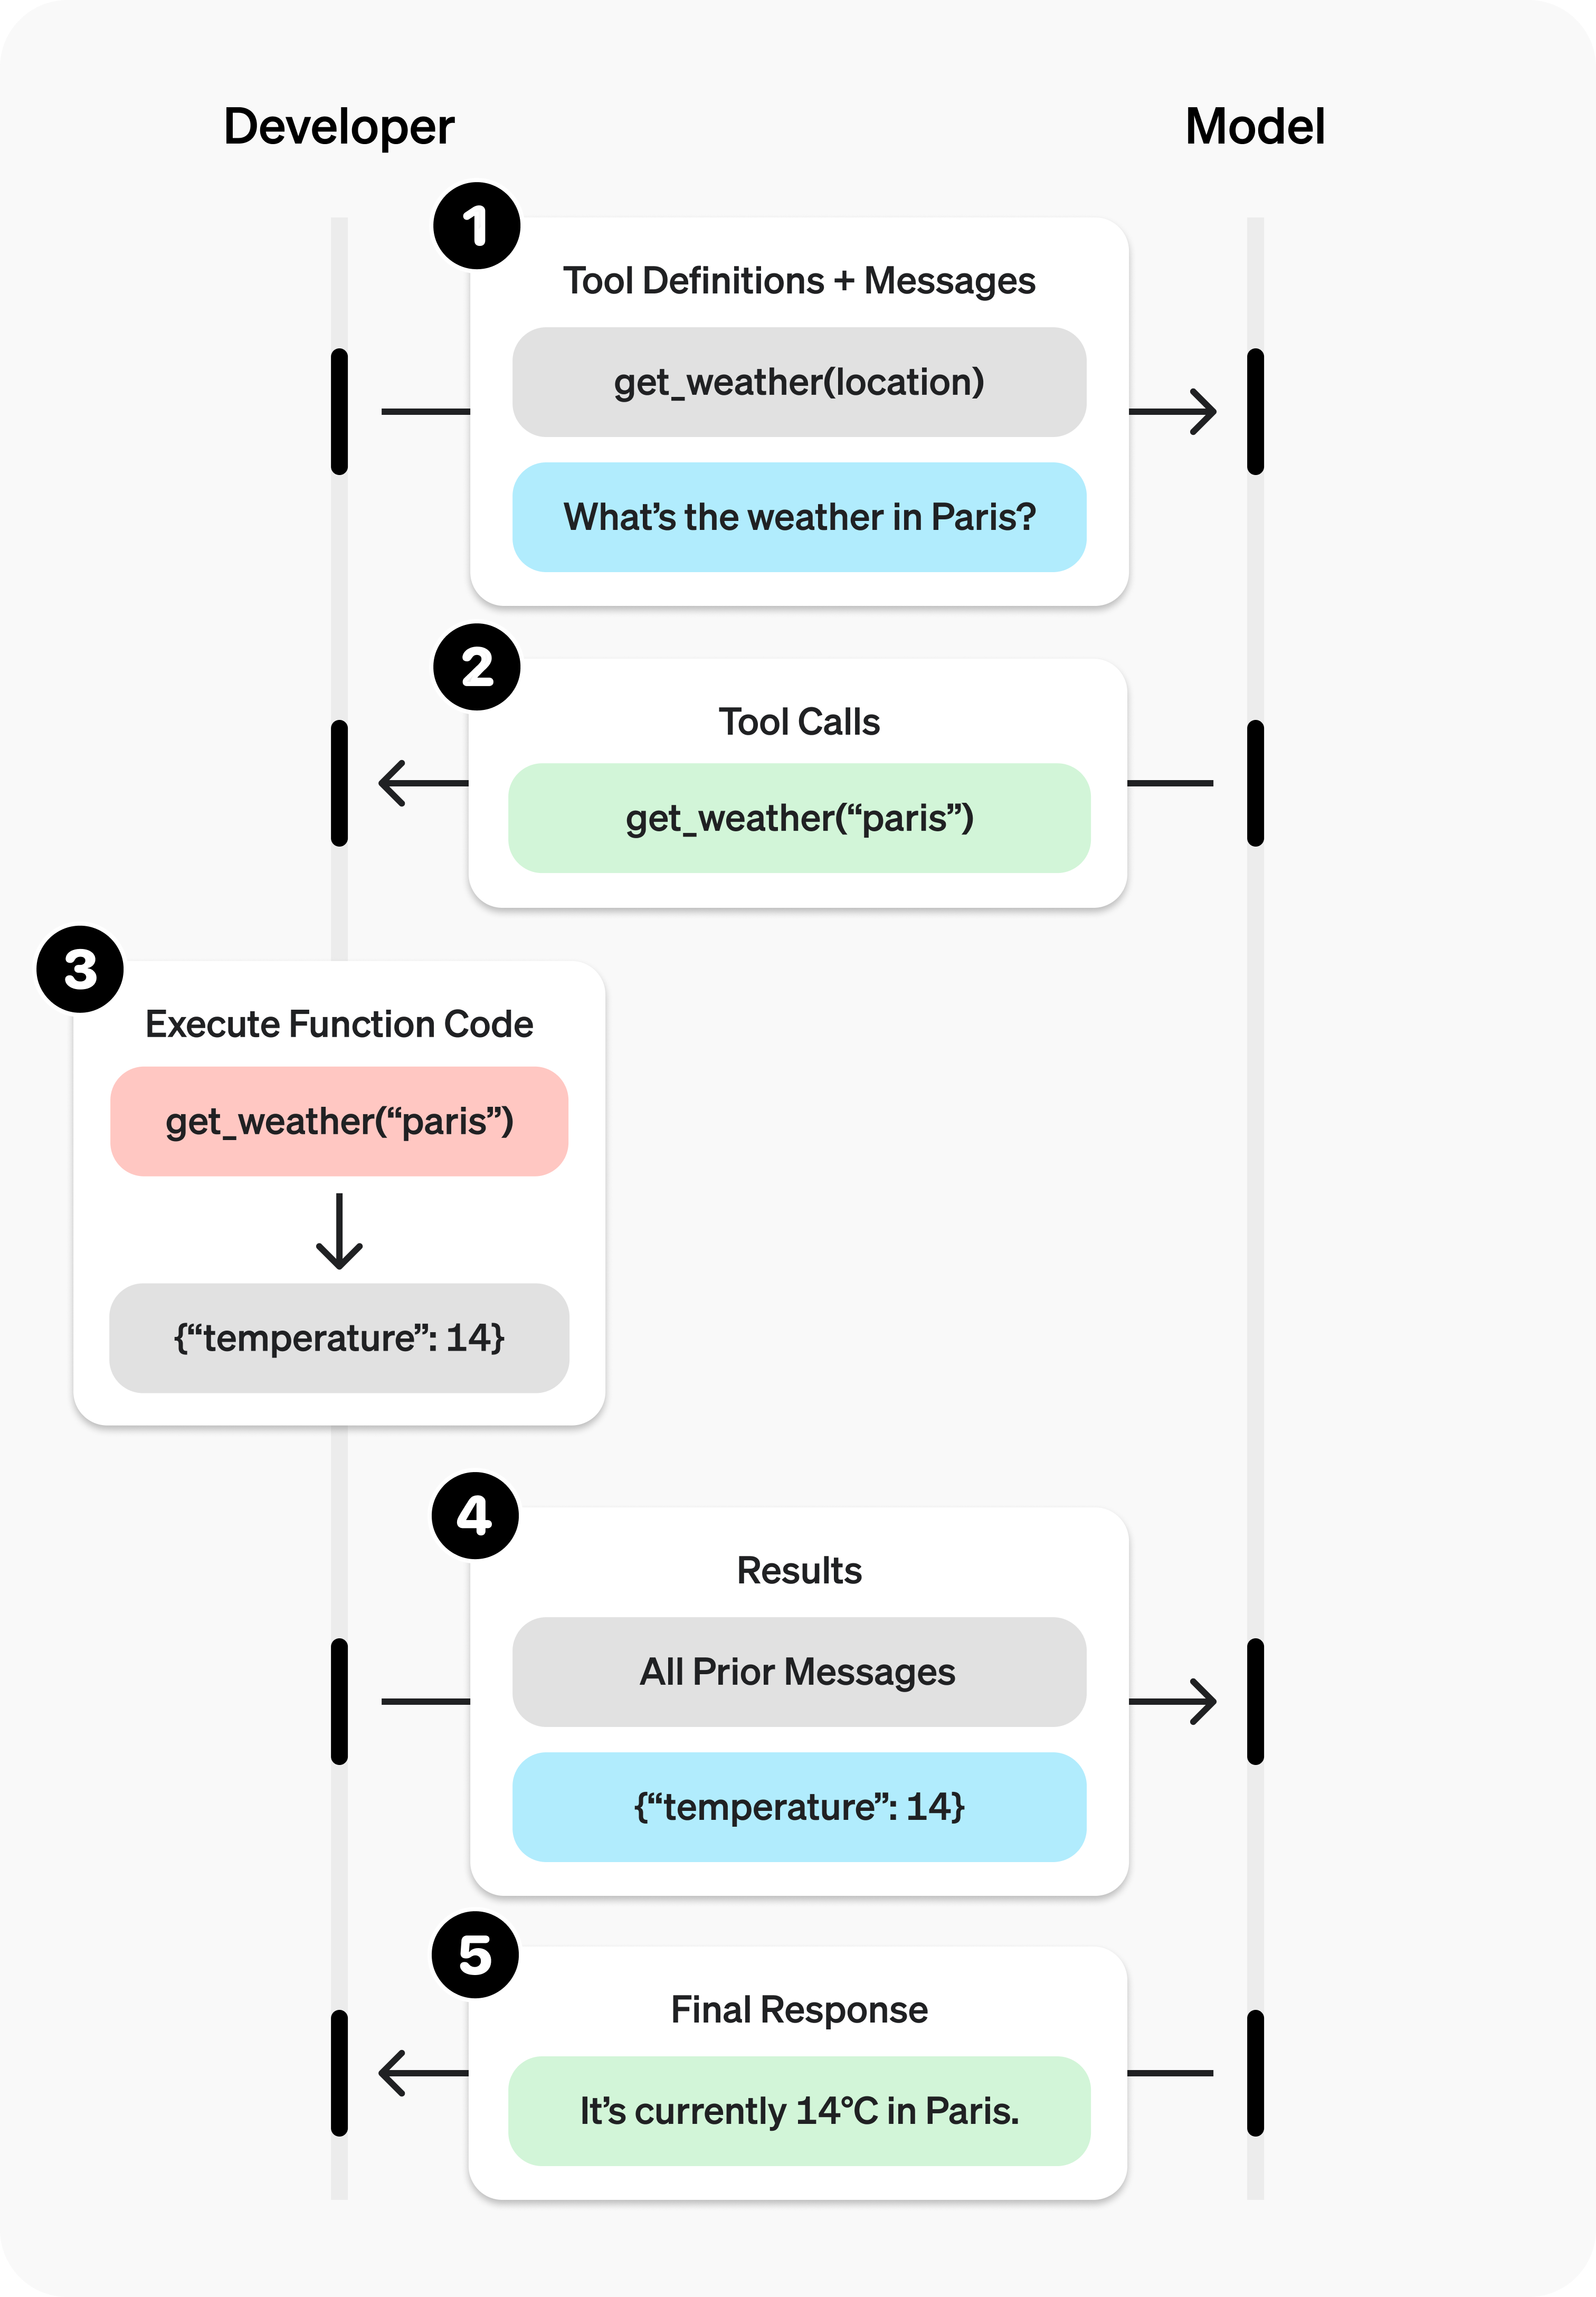
A chamada de ferramenta envolve uma conversa em várias etapas entre seu aplicativo e um modelo por meio da API da OpenAI. O fluxo tem cinco etapas principais:
Envie uma solicitação ao modelo com as ferramentas que ele pode chamar.
Receba uma chamada de ferramenta do modelo.
Execute o código no aplicativo com a entrada fornecida na chamada.
Envie uma segunda solicitação ao modelo com a saída da ferramenta.
Receba a resposta final do modelo (ou outras chamadas de ferramenta).
Com a Responses API, seu aplicativo pode continuar esse fluxo por quantas chamadas de ferramenta a tarefa exigir. Se quiser usar um framework que cuide das etapas recorrentes de orquestração desse ciclo, veja a comparação entre a Responses API e o Agents SDK.
Exemplo de ferramenta do tipo função
Veja o fluxo completo de chamada de ferramenta com uma função get_horoscope que consulta o horóscopo do dia para um signo.
Exemplo completo de chamada de ferramenta
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72import OpenAI from "openai";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", function: { name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, }, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}const messages = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});messages.push(response.choices[0].message);for (const toolCall of response.choices[0].message.tool_calls ?? []) { if (toolCall.type !== "function") continue; if (toolCall.function.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const args = JSON.parse(toolCall.function.arguments); const horoscope = getHoroscope(args.sign); // 4. Provide function call results to the model messages.push({ role: "tool", tool_call_id: toolCall.id, content: JSON.stringify({ horoscope }), }); }}response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});// 5. The model should be able to give a response!console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","function": {"name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, },"strict": True, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."messages = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)messages.append(response.choices[0].message)for tool_call in response.choices[0].message.tool_calls or []:if tool_call.function.name =="get_horoscope":# 3. Execute the function logic for get_horoscope args = json.loads(tool_call.function.arguments) horoscope = get_horoscope(args["sign"])# 4. Provide function call results to the model messages.append( {"role": "tool","tool_call_id": tool_call.id,"content": json.dumps({"horoscope": horoscope}), } )response = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)# 5. The model should be able to give a response!print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}// Create a running input list we will add to over timelet input = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.responses.create({ model: "gpt-6-astra", tools, input,});// Preserve model output for the next turninput.push(...toResponseInputItems(response.output));for (const item of response.output) { if (item.type !== "function_call") continue; if (item.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const { sign } = JSON.parse(item.arguments); const horoscope = getHoroscope(sign); // 4. Provide function call results to the model input.push({ type: "function_call_output", call_id: item.call_id, output: horoscope, }); }}console.log("Final input:");console.log(JSON.stringify(input, null, 2));response = await openai.responses.create({ model: "gpt-6-astra", instructions: "Respond only with a horoscope generated by a tool.", tools, input,});// 5. The model should be able to give a response!console.log("Final output:");console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","name": "get_horoscope","strict": True,"description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."# Create a running input list we will add to over timeinput_list = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.responses.create(model="gpt-6-astra",tools=tools,input=input_list,)# Save function call outputs for subsequent requestsinput_list += response.outputfor item in response.output:if item.type =="function_call":if item.name =="get_horoscope":# 3. Execute the function logic for get_horoscope sign = json.loads(item.arguments)["sign"] horoscope = get_horoscope(sign)# 4. Provide function call results to the model input_list.append( {"type": "function_call_output","call_id": item.call_id,"output": horoscope, } )response = client.responses.create(model="gpt-6-astra",instructions="Respond only with a horoscope generated by a tool.",tools=tools,input=input_list,)# 5. The model should be able to give a response!print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75package mainimport ( "context" "encoding/json" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() tool := horoscopeResponseTool() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("What is my horoscope? I am an Aquarius.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } var functionOutput responses.ResponseInputItemUnionParam for _, output := range response.Output { if output.Type != "function_call" { continue } call := output.AsFunctionCall() if call.Name != "get_horoscope" { continue } var arguments struct { Sign string `json:"sign"` } if err := json.Unmarshal([]byte(call.Arguments), &arguments); err != nil { panic(err) } functionOutput = responses.ResponseInputItemParamOfFunctionCallOutput(getHoroscope(arguments.Sign)) functionOutput.OfFunctionCallOutput.CallID = openai.String(call.CallID) } if functionOutput.OfFunctionCallOutput == nil { panic("the model did not call get_horoscope") } response, err = client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", PreviousResponseID: openai.String(response.ID), Instructions: openai.String("Respond only with a horoscope generated by a tool."), Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{functionOutput}}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}func horoscopeResponseTool() responses.ToolUnionParam { parameters := map[string]any{ "type": "object", "properties": map[string]any{ "sign": map[string]any{"type": "string", "description": "An astrological sign like Taurus or Aquarius"}, }, "required": []string{"sign"}, "additionalProperties": false, } tool := responses.ToolParamOfFunction("get_horoscope", parameters, true) tool.OfFunction.Description = openai.String("Get today's horoscope for an astrological sign.") return tool}func getHoroscope(sign string) string { return fmt.Sprintf("%s: Next Tuesday you will befriend a baby otter.", sign)}
Ao usar modelos de raciocínio como o GPT-5 ou o o4-mini, envie de volta, junto com as saídas das chamadas de ferramenta, todos os itens de raciocínio que o modelo retornou nas respostas que continham essas chamadas. Para saber como preservar o histórico que deu origem a esses itens, consulte as boas práticas para alterar o prefixo.
Como definir funções
Normalmente, você declara as funções no parâmetro tools de cada solicitação à API. Com a pesquisa de ferramentas, seu aplicativo também pode adiar o carregamento de funções para um momento posterior da interação. Em ambos os casos, o schema de cada função que pode ser chamada segue a mesma estrutura. A definição de uma função tem as seguintes propriedades:
Campo
Descrição
type
Deve ser sempre function
name
Nome da função (por exemplo, get_weather)
description
Detalhes sobre quando e como usar a função
parameters
Schema JSON que define os argumentos de entrada da função
strict
Indica se o modo estrito deve ser aplicado à chamada de função
Veja um exemplo de definição da função get_weather:
12345678910111213141516171819202122{ "type": "function", "name": "get_weather", "description": "Retrieves current weather for the given location.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "City and country e.g. Bogotá, Colombia" }, "units": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "Units the temperature will be returned in." } }, "required": ["location", "units"], "additionalProperties": false }, "strict": true}
Como parameters é definido por um schema JSON, você pode aproveitar recursos como tipos de propriedades, enumerações, descrições, objetos aninhados e objetos recursivos.
Como definir namespaces
Use namespaces para agrupar ferramentas relacionadas por domínio, como crm, billing ou shipping. Os namespaces ajudam a organizar ferramentas semelhantes e são especialmente úteis quando o modelo precisa escolher entre ferramentas destinadas a sistemas ou finalidades diferentes, como uma ferramenta de pesquisa para o CRM e outra para o sistema de chamados de suporte.
Se precisar dar ao modelo acesso a muitas ferramentas, você pode adiar o carregamento de algumas ou de todas elas com tool_search. A ferramenta tool_search permite que o modelo procure ferramentas relevantes, adicione-as ao contexto e passe a usá-las. Somente o gpt-5.4 e modelos posteriores oferecem suporte a esse recurso. Saiba mais no guia de pesquisa de ferramentas.
Sempre que possível, defina os schemas das funções diretamente. As bibliotecas cliente para Python e JavaScript também oferecem utilitários para converter objetos pydantic e zod em schemas, mas esses utilitários não oferecem suporte a todos os recursos.
Definição de objetos para representar o schema da função
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import OpenAI from "openai";import { z } from "zod";import { zodFunction } from "openai/helpers/zod";const openai = new OpenAI();const GetWeatherParameters = z.object({ location: z.string().describe("City and country e.g. Bogotá, Colombia"),});const tools = [ zodFunction({ name: "getWeather", parameters: GetWeatherParameters }),];const messages = [ { role: "user", content: "What's the weather like in Paris today?" },];const response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools, store: true,});console.log(response.choices[0].message.tool_calls);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20from openai import OpenAI, pydantic_function_toolfrom pydantic import BaseModel, Fieldclient = OpenAI()classGetWeather(BaseModel): location: str= Field(..., description="City and country e.g. Bogotá, Colombia")tools = [pydantic_function_tool(GetWeather)]completion = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,)print(completion.choices[0].message.tool_calls)
Boas práticas para definir funções
Escolha nomes claros e descritivos para as funções e escreva descrições de parâmetros e instruções detalhadas.
Descreva explicitamente a finalidade da função e de cada parâmetro (incluindo seu formato), além do significado da saída.
Use o prompt do sistema para descrever quando usar cada função e quando evitar seu uso. Em geral, diga ao modelo exatamente o que fazer.
Inclua exemplos e casos extremos, especialmente para corrigir falhas recorrentes. (Observação: adicionar exemplos pode prejudicar o desempenho dos modelos de raciocínio.)
Para ferramentas com carregamento adiado, inclua orientações detalhadas na descrição da função e mantenha a descrição do namespace concisa. O namespace ajuda o modelo a escolher o que carregar. A descrição da função o ajuda a usar a ferramenta corretamente após o carregamento.
Use enumerações e a estrutura dos objetos para evitar estados inválidos. Por exemplo, toggle_light(on: bool, off: bool) permite chamadas inválidas.
Faça o teste do estagiário. Uma pessoa em início de carreira conseguiria usar a função corretamente só com as informações que você deu ao modelo? (Se não conseguir, que perguntas ela faria? Inclua as respostas no prompt.)
Reduza o trabalho do modelo e use código sempre que possível.
Evite pedir ao modelo que preencha argumentos cujos valores você já conhece. Por exemplo, se você já obteve um order_id em um menu anterior, não inclua um parâmetro order_id. Defina submit_refund() sem parâmetros e passe o order_id no seu código.
Combine funções que são sempre chamadas em sequência. Por exemplo, se você sempre chama mark_location() depois de query_location(), incorpore a lógica de marcação à função de consulta.
Disponibilize poucas funções inicialmente para aumentar a precisão.
Avalie o desempenho com diferentes quantidades de funções.
Procure disponibilizar menos de 20 funções no início de cada turno, mas considere esse número apenas uma referência.
Use a pesquisa de ferramentas para adiar o carregamento de grupos grandes de ferramentas ou de ferramentas pouco usadas, em vez de disponibilizar tudo de início.
Considere usar o ajuste fino para aumentar a precisão da chamada de função quando houver muitas funções ou tarefas difíceis. (Exemplo no Cookbook)
Uso de tokens
Internamente, as funções são inseridas na mensagem do sistema com uma sintaxe que o modelo aprendeu durante o treinamento. Assim, as definições das funções disponíveis contam para o limite de contexto do modelo e são cobradas como tokens de entrada. Se atingir o limite de tokens, sugerimos reduzir o número de funções carregadas inicialmente, encurtar as descrições quando possível ou usar a pesquisa de ferramentas para carregar as ferramentas adiadas somente quando necessárias.
Se a especificação das ferramentas definir muitas funções, você também pode usar o ajuste fino para reduzir o número de tokens usados.
Como processar chamadas de função
Quando o modelo chama uma função, você precisa executá-la e retornar o resultado. Como as respostas do modelo podem incluir zero, uma ou várias chamadas, é uma boa prática preparar seu código para processar várias.
A resposta contém o array tool_calls. Cada chamada tem um id (usado posteriormente para enviar o resultado da função) e um objeto function que contém um name e os arguments codificados em JSON.
O array output da resposta contém uma entrada cujo type tem o valor function_call. Cada entrada desse tipo contém um call_id (usado posteriormente para enviar o resultado da função), um name e os arguments codificados em JSON.
Se estiver usando a pesquisa de ferramentas, você também poderá ver itens tool_search_call e tool_search_output antes de um function_call. Após o carregamento da função, processe a chamada como neste exemplo.
Execução das chamadas de função e inclusão dos resultados
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31import com.fasterxml.jackson.databind.JsonNode;import com.fasterxml.jackson.databind.ObjectMapper;import java.util.Map;var argsJson = new ObjectMapper().readTree("{\"location\":\"Paris, France\"}");System.out.println(callFunction("get_weather", argsJson));// These local fixtures demonstrate dispatch; replace them with your application services.// The email fixture prints its inputs and does not send a message.static Map<String, Object> callFunction(String name, JsonNode arguments) { return switch (name) { case "get_weather" -> getWeather(arguments.get("location").asText()); case "send_email" -> sendEmail(arguments.get("to").asText(), arguments.get("body").asText()); default -> throw new IllegalArgumentException("Unknown function: " + name); };}private static Map<String, Object> getWeather(String location) { int temperature = switch (location) { case "Bogotá, Colombia" -> 18; case "Paris, France" -> 15; default -> 20; }; return Map.of("location", location, "temperature_celsius", temperature);}private static Map<String, Object> sendEmail(String to, String body) { System.out.println("Sending email to " + to + ": " + body); return Map.of("status", "sent");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22using System.Text.Json;using JsonDocument arguments = JsonDocument.Parse("{\"location\":\"Paris, France\"}");Console.WriteLine(FunctionDispatcher.CallFunction("get_weather", arguments.RootElement));internal static class FunctionDispatcher{ // These local fixtures demonstrate dispatch; replace them with your application services. // The email fixture prints its inputs and does not send a message. internal static string CallFunction(string name, JsonElement arguments) => name switch { "get_weather" => GetWeather(arguments.GetProperty("location").GetString()!), "send_email" => SendEmail(arguments.GetProperty("to").GetString()!, arguments.GetProperty("body").GetString()!), _ => throw new ArgumentException($"Unknown function: {name}", nameof(name)) }; private static string GetWeather(string location) => JsonSerializer.Serialize(new { location, temperature_celsius = location switch { "Bogotá, Colombia" => 18, "Paris, France" => 15, _ => 20 } }); private static string SendEmail(string to, string body) { Console.WriteLine($"Sending email to {to}: {body}"); return "{\"status\":\"sent\"}"; }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def call_function(name, arguments) case name when "get_weather" FunctionCallingExample.get_weather( arguments.fetch("latitude"), arguments.fetch("longitude") ) when "send_email" FunctionCallingExample.send_email( arguments.fetch("to"), arguments.fetch("body") ) else raise ArgumentError, "Unknown function: #{name}" endend
Formatação dos resultados
Em geral, o resultado que você passa na mensagem function_call_output deve ser uma string. Você escolhe o formato (JSON, códigos de erro, texto simples etc.). O modelo interpreta a string conforme necessário.
"It's about 15°C in Paris, 18°C in Bogotá, and I've sent that email to Bob."
Configurações adicionais
Escolha de ferramentas
Por padrão, o modelo decide quando usar ferramentas e quantas usar. Você pode impor um comportamento específico com o parâmetro tool_choice.
Automática: (Padrão) O modelo pode chamar zero, uma ou várias funções. tool_choice: "auto"
Obrigatória: O modelo deve chamar uma ou mais funções.
tool_choice: "required"
Função imposta: O modelo deve chamar exatamente uma função específica.
tool_choice: {"type": "function", "name": "get_weather"}
Ferramentas permitidas: Limite as chamadas do modelo a um subconjunto das ferramentas disponíveis.
Quando usar allowed_tools
Configure uma lista allowed_tools se quiser disponibilizar apenas um subconjunto de ferramentas nas solicitações ao modelo e manter a lista completa que você envia. Assim, você pode maximizar a economia com o cache de prompts.
Você também pode definir tool_choice como "none" para obter o mesmo comportamento que teria se não passasse nenhuma função.
Ao usar a pesquisa de ferramentas, tool_choice continua se aplicando às ferramentas que podem ser chamadas naquele momento do turno. Isso é especialmente útil depois de carregar um subconjunto de ferramentas, quando você quer limitar o modelo a esse subconjunto.
Chamada de função em paralelo
Nos modelos compatíveis a partir do GPT-5, as funções podem ser chamadas em paralelo mesmo quando há ferramentas integradas disponíveis. Ferramentas integradas não podem fazer parte de um lote de chamadas de função em paralelo.
O modelo pode optar por chamar várias funções em um único turno. Para impedir isso, defina parallel_tool_calls como false. Assim, o modelo fará no máximo uma chamada de ferramenta.
Observação: Atualmente, se um modelo com ajuste fino chamar várias funções no mesmo turno, o modo estrito será desativado para essas chamadas.
Observação sobre gpt-4.1-nano-2025-04-14: Essa versão do gpt-4.1-nano às vezes gera várias chamadas à mesma ferramenta quando as chamadas em paralelo estão ativadas. Recomendamos desativar esse recurso ao usar essa versão.
Modo estrito
Defina strict como true para garantir que as chamadas de função sigam o schema da função de forma confiável. Sem essa garantia, o modelo apenas tenta seguir o schema. Recomendamos sempre ativar o modo estrito.
Internamente, o modo estrito usa o recurso de saídas estruturadas, o que impõe dois requisitos:
additionalProperties deve ter o valor false em cada objeto de parameters.
Todos os campos de properties devem ser marcados como required.
Para indicar campos opcionais, adicione null como uma opção de type (veja o exemplo abaixo).
Se você enviar strict: true e o schema não atender aos requisitos acima, a API rejeitará a solicitação e indicará quais restrições faltam. Se você omitir strict, o comportamento padrão dependerá da API. A Responses API tenta normalizar o schema para o modo estrito. Se não for possível torná-lo compatível, a chamada de função passa a operar sem a garantia de conformidade do modo estrito. Nesse caso, a ferramenta na resposta exibirá strict: false. As solicitações à API chat completions usam o modo não estrito por padrão. Para desativar o modo estrito na Responses API e manter a chamada de função sem garantia de conformidade, defina explicitamente strict: false.
Modo estrito ativado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false } }}
Modo estrito desativado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], } }}
Modo estrito ativado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false }}
Modo estrito desativado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], }}
Todos os schemas gerados no Playground têm o modo estrito ativado.
Embora recomendemos ativar o modo estrito, ele tem algumas limitações:
O modo estrito não oferece suporte a todos os recursos de schema JSON. (Consulte os schemas compatíveis.)
Para modelos com ajuste fino, há limitações específicas:
Os schemas passam por processamento adicional na primeira solicitação e depois ficam em cache. Se os schemas variarem de uma solicitação para outra, a latência poderá aumentar.
Os schemas ficam em cache para melhorar o desempenho e não são elegíveis para zero retenção de dados.
Streaming
Com o streaming, você pode mostrar o progresso da chamada, indicando qual função o modelo está chamando enquanto ele preenche os argumentos. Também é possível exibir os argumentos em tempo real.
O streaming de chamadas de função funciona como o de respostas comuns: você define stream como true e recebe fragmentos com objetos delta.
Streaming de chamadas de função
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42import { OpenAI } from "openai";const openai = new OpenAI();const tools = [ { type: "function", function: { name: "get_weather", description: "Get current temperature for a given location.", parameters: { type: "object", properties: { location: { type: "string", description: "City and country e.g. Bogotá, Colombia", }, }, required: ["location"], additionalProperties: false, }, strict: true, }, },];const stream = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages: [ { role: "user", content: "What's the weather like in Paris today?" }, ], tools, tool_choice: "required", stream: true, store: true,});for await (const chunk of stream) { const delta = chunk.choices[0].delta; console.log(delta.tool_calls);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37from openai import OpenAIclient = OpenAI()tools = [ {"type": "function","function": {"name": "get_weather","description": "Get current temperature for a given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia", } },"required": ["location"],"additionalProperties": False, },"strict": True, }, }]stream = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,stream=True,)for chunk in stream: delta = chunk.choices[0].deltaprint(delta.tool_calls)
Com o streaming, você pode mostrar o progresso da chamada, indicando qual função o modelo está chamando enquanto ele preenche os argumentos. Também é possível exibir os argumentos em tempo real.
O streaming de chamadas de função funciona como o de respostas comuns: você define stream como true e recebe diferentes objetos event.
Nesse caso, em vez de reunir os fragmentos em uma única string content, você os reúne para formar o objeto JSON codificado em arguments.
Quando o modelo chama uma ou mais funções, a API emite um evento do tipo response.output_item.added para cada chamada de função. O evento contém os seguintes campos:
Campo
Descrição
response_id
ID da resposta à qual pertence a chamada de função
output_index
Índice do item de saída na resposta. Identifica cada chamada de função na resposta.
item
Item da chamada de função em andamento, com os campos name, arguments e id
Em seguida, você recebe uma série de eventos do tipo response.function_call_arguments.delta com o delta do campo arguments. Esses eventos contêm os seguintes campos:
Campo
Descrição
response_id
ID da resposta à qual pertence a chamada de função
item_id
ID do item da chamada de função ao qual pertence o delta
output_index
Índice do item de saída na resposta. Identifica cada chamada de função na resposta.
delta
Delta do campo arguments.
O trecho de código abaixo mostra como reunir os objetos delta em um objeto tool_call final.
Quando o modelo termina de chamar as funções, a API emite um evento do tipo response.function_call_arguments.done. Esse evento contém a chamada de função completa, incluindo os seguintes campos:
Campo
Descrição
response_id
ID da resposta à qual pertence a chamada de função
output_index
Índice do item de saída na resposta. Identifica cada chamada de função na resposta.
item
Item da chamada de função, com os campos name, arguments e id.
Ferramentas personalizadas
As ferramentas personalizadas funcionam de maneira semelhante às ferramentas do tipo função definidas por schema JSON. A diferença é que, em vez de receber instruções explícitas sobre a entrada exigida pela ferramenta, o modelo pode passar uma string arbitrária como entrada. Isso permite evitar o uso desnecessário de JSON para encapsular uma resposta ou aplicar uma gramática personalizada à resposta (veja a seguir).
O exemplo de código a seguir cria uma ferramenta personalizada que espera receber como resposta uma string de texto com código Python.
Exemplo de chamada de ferramenta personalizada
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the code_exec tool to print hello world to the console.", tools: [ { type: "custom", name: "code_exec", description: "Executes arbitrary Python code.", }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Use the code_exec tool to print hello world to the console.",tools=[ {"type": "custom","name": "code_exec","description": "Executes arbitrary Python code.", } ],)print(response.output)
Como nos exemplos anteriores, o array output contém uma chamada de ferramenta gerada pelo modelo. Desta vez, a entrada da chamada é fornecida em texto simples.
Uma gramática livre de contexto (CFG) é um conjunto de regras que definem como produzir texto válido em determinado formato. Para ferramentas personalizadas, você pode fornecer uma CFG que restrinja o texto que o modelo envia como entrada à ferramenta.
Use o parâmetro grammar ao configurar uma ferramenta personalizada para fornecer sua própria CFG. Atualmente, há suporte a duas sintaxes para definir gramáticas: lark e regex.
As gramáticas são especificadas com uma variante de Lark. A LLGuidance restringe a amostragem do modelo. A API não oferece suporte aos seguintes recursos de Lark:
Asserções de contexto (lookarounds) nas expressões regulares do analisador léxico
Modificadores não gulosos (*?, +?, ??) nas expressões regulares do analisador léxico
Prioridades de terminais
Templates
Importações (exceto a importação integrada %import common)
Diretivas %declare
Recomendamos usar o IDE do Lark para experimentar gramáticas personalizadas.
Limite a complexidade da gramática
Restrinja a gramática às regras e aos padrões de que a ferramenta precisa. A API da OpenAI pode retornar um erro se a gramática for complexa demais. Verifique se a gramática é compatível antes de usá-la na API.
Pode ser difícil acertar todos os detalhes de uma gramática Lark. Gramáticas mais simples funcionam de forma mais confiável. Com gramáticas complexas, muitas vezes é preciso refinar a própria definição da gramática, o prompt e a descrição da ferramenta para evitar que o modelo gere saídas fora da distribuição esperada.
NÃO divida o padrão entre regras e terminais como no exemplo abaixo. Essa abordagem tenta usar regras para distribuir o texto livre entre os terminais. O analisador léxico consome os trechos de texto livre de forma gulosa, e você perde o controle sobre a divisão:
As regras em minúsculas não influenciam a divisão da entrada em terminais. Somente as definições dos terminais determinam essa divisão. Quando precisar de “texto livre entre âncoras”, represente todo o padrão em um único terminal de expressão regular para que o analisador léxico faça uma única correspondência com a estrutura pretendida.
Terminais e regras
O Lark usa terminais para representar os tokens do analisador léxico (por convenção, em UPPERCASE) e regras para as produções do analisador sintático (por convenção, em lowercase). Para usar apenas os recursos compatíveis e evitar surpresas, mantenha a gramática explícita, evite complexidade desnecessária e separe claramente as responsabilidades dos terminais e das regras.
O analisador léxico é executado antes do analisador sintático
Antes da aplicação de qualquer regra da CFG, o analisador léxico identifica os terminais de forma gulosa: prevalece a correspondência mais longa. Se você tentar delimitar um terminal dividindo-o entre várias regras, essas regras não orientarão o analisador léxico. Ele segue apenas as expressões regulares dos terminais.
Prefira um único terminal para extrair trechos de texto livre
Se precisar reconhecer um padrão em meio a texto arbitrário (por exemplo, linguagem natural com “qualquer conteúdo” entre âncoras), represente-o como um único terminal. Evite intercalar terminais de texto livre com regras do analisador sintático. A análise léxica gulosa não respeitará os limites pretendidos, e é muito provável que o modelo gere saídas fora da distribuição esperada.
Use regras para combinar tokens distintos
As regras são ideais para combinar terminais com limites explícitos (números, palavras-chave, pontuação) em estruturas maiores. Elas não são adequadas para restringir “o conteúdo entre” dois terminais.
Defina terminais específicos, delimitados e independentes
Prefira classes de caracteres explícitas e quantificadores limitados ({0,10}, em vez de usar * sem limite em toda parte). Se precisar de “qualquer texto até um ponto final”, prefira algo como /[^.\n]{0,10}*\./ a /.+\./ para evitar que o trecho capturado cresça sem controle.
Use regras para combinar tokens e deixe a correspondência interna a cargo das expressões regulares
Exemplo de uso adequado de regras:
start: exprNUMBER: /[0-9]+/PLUS: "+"MINUS: "-"expr: term (("+"|"-") term)*term: NUMBER
Trate os espaços em branco de forma explícita
Evite depender de diretivas %ignore sem limites. Elas podem tornar a gramática complexa demais, levar o modelo a gerar saídas fora da distribuição esperada ou causar ambos os problemas. Prefira inserir terminais explícitos em cada ponto em que espaços em branco são permitidos.
Solução de problemas
Se a API rejeitar a gramática por excesso de complexidade, simplifique as regras e os terminais e remova as diretivas %ignore sem limites.
Se as ferramentas personalizadas receberem chamadas com tokens inesperados, verifique se há sobreposição entre os terminais e como o analisador léxico faz a correspondência gulosa.
Quando o modelo gerar saídas “fora da distribuição esperada” (excessivamente longas ou repetitivas, com sintaxe válida, mas significado incorreto):
Torne a gramática mais restritiva.
Refine o prompt (adicione exemplos few-shot) e a descrição da ferramenta (explique a gramática e instrua o modelo a raciocinar e a seguir suas regras).
Experimente um esforço de raciocínio maior (por exemplo, passe de médio para alto).
CFG com expressão regular
Exemplo de gramática livre de contexto com expressão regular
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const grammar = "^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\\s+(?P<day>\\d{1,2})(?:st|nd|rd|th)?\\s+(?P<year>\\d{4})\\s+at\\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$";const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.", tools: [ { type: "custom", name: "timestamp", description: "Saves a timestamp in date + time in 24-hr format.", format: { type: "grammar", syntax: "regex", definition: grammar, }, }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23from openai import OpenAIclient = OpenAI()grammar =r"^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$"response = client.responses.create(model="gpt-6-astra",input="Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.",tools=[ {"type": "custom","name": "timestamp","description": "Saves a timestamp in date + time in 24-hr format.","format": {"type": "grammar","syntax": "regex","definition": grammar, }, } ],)print(response.output)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses" "github.com/openai/openai-go/v3/shared")func main() { client := openai.NewClient() grammar := `^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$` tool := responses.ToolParamOfCustom("timestamp") tool.OfCustom.Description = openai.String("Saves a timestamp in date and time format.") tool.OfCustom.Format = shared.CustomToolInputFormatParamOfGrammar(grammar, "regex") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.Output)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.CustomToolInputFormat;import com.openai.models.responses.CustomTool;import com.openai.models.responses.ResponseCreateParams;String grammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) " + "\\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$";ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input("Use timestamp to save August 7th 2025 at 10AM.") .addTool( CustomTool.builder() .name("timestamp") .description("Saves a timestamp in date and time format.") .format( CustomToolInputFormat.Grammar.builder() .syntax(CustomToolInputFormat.Grammar.Syntax.REGEX) .definition(grammar) .build()) .build()) .build();client.responses().create(params).output().forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newgrammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) \\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$"response = client.responses.create( model: "gpt-6-astra", input: "Use timestamp to save August 7th 2025 at 10AM.", tools: [ { type: :custom, name: "timestamp", description: "Saves a timestamp in date and time format.", format: { type: :grammar, syntax: :regex, definition: grammar } } ])puts(response.output)
A saída da ferramenta deve então seguir a CFG que você definiu com a expressão regular:
A API não oferece suporte aos seguintes recursos de expressões regulares:
Asserções de contexto (lookarounds)
Modificadores não gulosos (*?, +?, ??)
Conceitos e boas práticas
O padrão deve ocupar uma única linha
Se precisar reconhecer uma quebra de linha na entrada, use a sequência de escape \n. Não use o modo detalhado ou estendido, que permite escrever padrões em várias linhas.
Forneça a expressão regular como uma string que contenha apenas o padrão