
Como maximizar a taxa de acertos e a consistência do comportamento ao trabalhar com LLMs
Otimizar LLMs é difícil.
Ao trabalhar com desenvolvedores de startups e de grandes empresas, vimos que as dificuldades de otimização quase sempre se resumem a três questões:
- Saber por onde começar a melhorar a acurácia
- Decidir qual método usar e quando
- Definir qual nível de acurácia é suficiente para produção
Este artigo apresenta um modelo mental para otimizar a acurácia e o comportamento dos LLMs. Vamos explorar métodos como engenharia de prompt, geração aumentada por recuperação (RAG) e ajuste fino. Também vamos mostrar como e quando usar cada técnica e apontar algumas armadilhas.
Durante a leitura, relacione esses princípios ao que significa acertar no seu caso de uso. Pode parecer óbvio, mas há uma diferença entre gerar um texto ruim que alguém precisa corrigir e reembolsar um cliente em US$ 1.000 quando o valor correto era US$ 100. Ao discutir a acurácia de um LLM, tenha uma estimativa de quanto custa cada erro e de quanto você economiza ou ganha a cada acerto. Retomaremos essa questão no final, quando discutirmos qual nível de acurácia é “suficiente” para produção.
Como pensar na otimização de LLMs
Muitos guias práticos descrevem a otimização como uma sequência simples: você começa pela engenharia de prompt, passa para a geração aumentada por recuperação e termina com o ajuste fino. Na prática, muitas vezes o processo é diferente. Cada método resolve um tipo de problema, e a escolha depende do que você precisa melhorar.
Uma forma útil de visualizar a otimização de LLMs é organizá-la em uma matriz:

Uma tarefa típica com LLMs começa no canto inferior esquerdo, com a engenharia de prompt. Nessa etapa, testamos, aprendemos e avaliamos para estabelecer uma referência inicial. Depois de revisar os exemplos dessa primeira avaliação e identificar as causas dos erros, podemos atuar em um dos eixos:
- Otimização do contexto: Você precisa otimizar o contexto quando 1) o modelo desconhece informações relevantes porque elas não faziam parte do conjunto de treinamento, 2) o conhecimento do modelo está desatualizado ou 3) a tarefa exige acesso a informações proprietárias. Esse eixo maximiza a acurácia das respostas.
- Otimização do LLM: Você precisa otimizar o LLM quando 1) o modelo gera resultados inconsistentes, com formatação incorreta, 2) o tom ou o estilo de linguagem é inadequado ou 3) o modelo não segue o raciocínio esperado de forma consistente. Esse eixo maximiza a consistência do comportamento.
Na prática, a otimização envolve várias etapas. Avaliamos o resultado, formulamos uma hipótese de melhoria, aplicamos a mudança e avaliamos novamente para decidir o próximo passo. Veja um exemplo de sequência bastante comum:
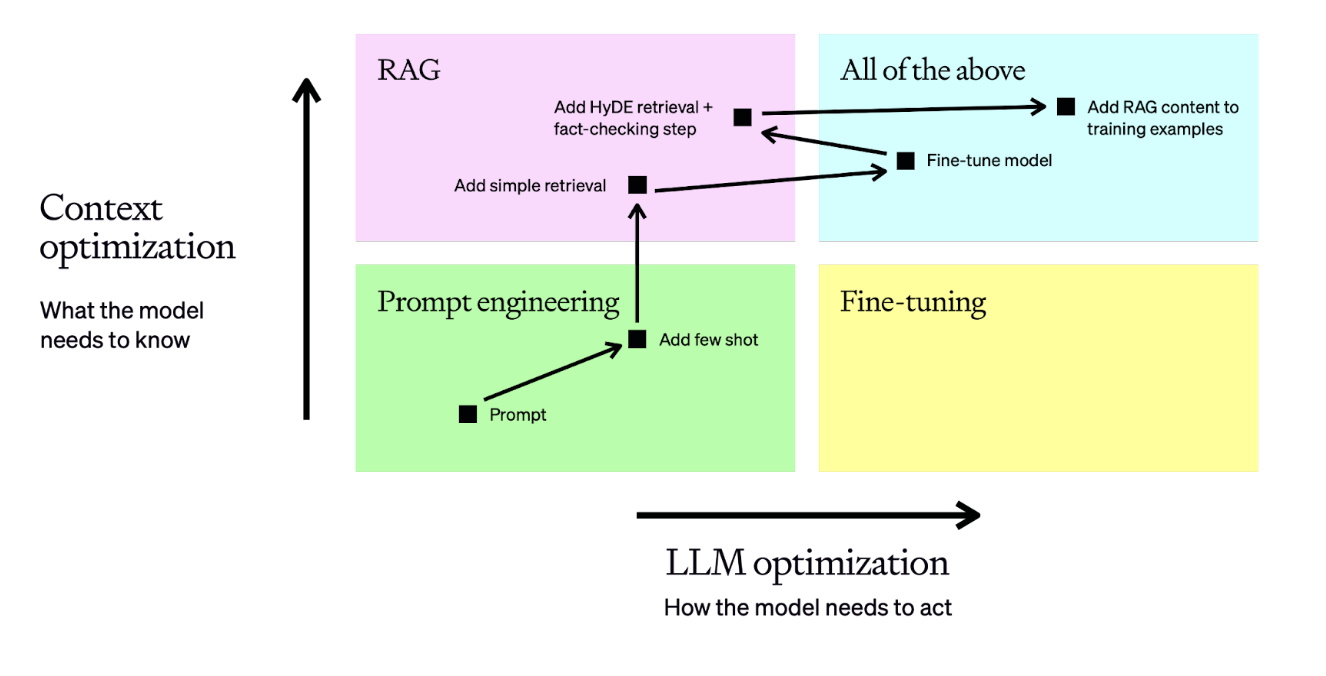
Neste exemplo, seguimos estas etapas:
- Começamos com um prompt e avaliamos seu desempenho.
- Adicionamos exemplos few-shot fixos, o que deve tornar os resultados mais consistentes.
- Adicionamos uma etapa de recuperação para selecionar os exemplos few-shot dinamicamente, de acordo com a pergunta. Isso melhora o desempenho ao fornecer contexto relevante para cada entrada.
- Preparamos um conjunto de dados com pelo menos 50 exemplos e fazemos o ajuste fino de um modelo para aumentar a consistência.
- Refinamos a recuperação e adicionamos uma etapa de verificação de fatos para identificar alucinações e aumentar a acurácia.
- Treinamos novamente o modelo que passou pelo ajuste fino, desta vez com novos exemplos de treinamento que incluem as entradas aprimoradas com RAG.
Esse processo de otimização é bastante comum em problemas de negócio difíceis. Ele nos ajuda a decidir se precisamos fornecer um contexto mais relevante ou obter um comportamento mais consistente do modelo. Com essa decisão, sabemos por onde começar a otimização.
Agora que temos um modelo mental, vamos examinar os métodos que podemos aplicar em cada área. Começaremos no canto inferior esquerdo, com a engenharia de prompt.
Engenharia de prompt
A engenharia de prompt costuma ser o melhor ponto de partida**. Muitas vezes, é o único método necessário em tarefas como resumo de textos, tradução e geração de código, nas quais uma abordagem zero-shot pode atingir a acurácia e a consistência necessárias para produção.
Isso acontece porque a engenharia de prompt exige que você defina o que significa acertar no seu caso de uso. Você começa pelo mais simples: fornece uma entrada e precisa saber avaliar se a saída corresponde às suas expectativas. Se o resultado não for o esperado, entender por que ele ficou aquém mostrará quais recursos usar nas próximas etapas de otimização.
Comece sempre com um prompt simples e uma ideia clara da saída esperada. Depois, refine o prompt adicionando contexto, instruções ou exemplos até obter o resultado desejado.
Otimização
Para otimizar os prompts, vou me basear principalmente nas estratégias do guia de engenharia de prompt da documentação da API da OpenAI. Cada estratégia ajuda a ajustar o contexto, o LLM ou ambos:
| Estratégia | Otimização do contexto | Otimização do LLM |
|---|---|---|
| Escreva instruções claras | X | |
| Divida tarefas complexas em subtarefas mais simples | X | X |
| Dê aos GPTs tempo para “pensar” | X | |
| Teste as mudanças de forma sistemática | X | X |
| Forneça um texto de referência | X | |
| Use ferramentas externas | X |
Pode ser difícil visualizar essas estratégias. Vamos testá-las em um caso prático, usando o gpt-4-turbo para corrigir frases em islandês.
Vimos que a engenharia de prompt é um ótimo ponto de partida e que, com os ajustes adequados, é possível melhorar bastante o desempenho.
A principal dificuldade é aplicar a engenharia de prompt em escala. Às vezes, acrescentar conteúdo fixo ao prompt não basta para cobrir a variedade de problemas que o modelo precisa resolver, e temos de fornecer contexto dinamicamente. Em outros casos, precisamos de um comportamento mais consistente do que conseguimos obter com exemplos few-shot.
Modelos com janelas de contexto longas ampliam o alcance da engenharia de prompt. Mas atenção: os modelos podem ter dificuldade para manter a atenção ao longo de prompts muito extensos com instruções complexas. Por isso, avalie sempre o desempenho com contextos de tamanhos diferentes para verificar se alguma informação fica perdida no meio. A expressão “perdida no meio” descreve a dificuldade de um LLM em dar a mesma atenção a todos os tokens que recebe de uma vez. Por causa disso, o modelo pode deixar passar informações de forma aparentemente aleatória. Você pode usar contextos longos, desde que avalie os resultados com cuidado. Greg Kamradt, colaborador de projetos de código aberto, criou uma avaliação chamada Agulha no palheiro (NITA). Ele inseriu uma informação em diferentes posições de documentos longos e avaliou a qualidade da recuperação. O teste ilustra o desafio dos contextos longos: incluir tudo no contexto pode simplificar muito a recuperação, mas tem um custo em acurácia.
Até onde dá para chegar com a engenharia de prompt? Depende do caso, e são as avaliações que permitem tomar essa decisão.
Avaliação
Por isso, o melhor resultado desta etapa é um bom prompt acompanhado de um conjunto de avaliação com perguntas e respostas de referência. Se você tem pelo menos 20 pares de perguntas e respostas, examinou os erros em detalhe e formulou uma hipótese sobre suas causas, já tem uma base adequada para testar métodos de otimização mais avançados.
Antes de passar a métodos mais sofisticados, vale pensar em como automatizar a avaliação para acelerar cada rodada de testes. Algumas práticas que têm funcionado bem são:
- Usar métricas como ROUGE ou BERTScore para obter uma estimativa inicial. A correlação com as avaliações humanas não é tão alta, mas essas métricas permitem medir de forma rápida e eficaz o quanto as saídas do modelo mudaram de uma rodada para outra.
- Usar o GPT-4 como avaliador, conforme o método descrito no artigo sobre o G-Eval. Você fornece ao LLM uma ficha com critérios de pontuação para que ele avalie a saída com a maior objetividade possível.
Para se aprofundar, consulte este exemplo do Cookbook, que mostra como aplicar cada uma dessas abordagens.
Como escolher as ferramentas
Você já trabalhou no prompt, montou um conjunto de avaliação e o modelo ainda não faz o que você precisa. O próximo passo mais importante é identificar onde ele falha e qual ferramenta é mais adequada para corrigir o problema.
Veja uma forma simples de fazer esse diagnóstico:
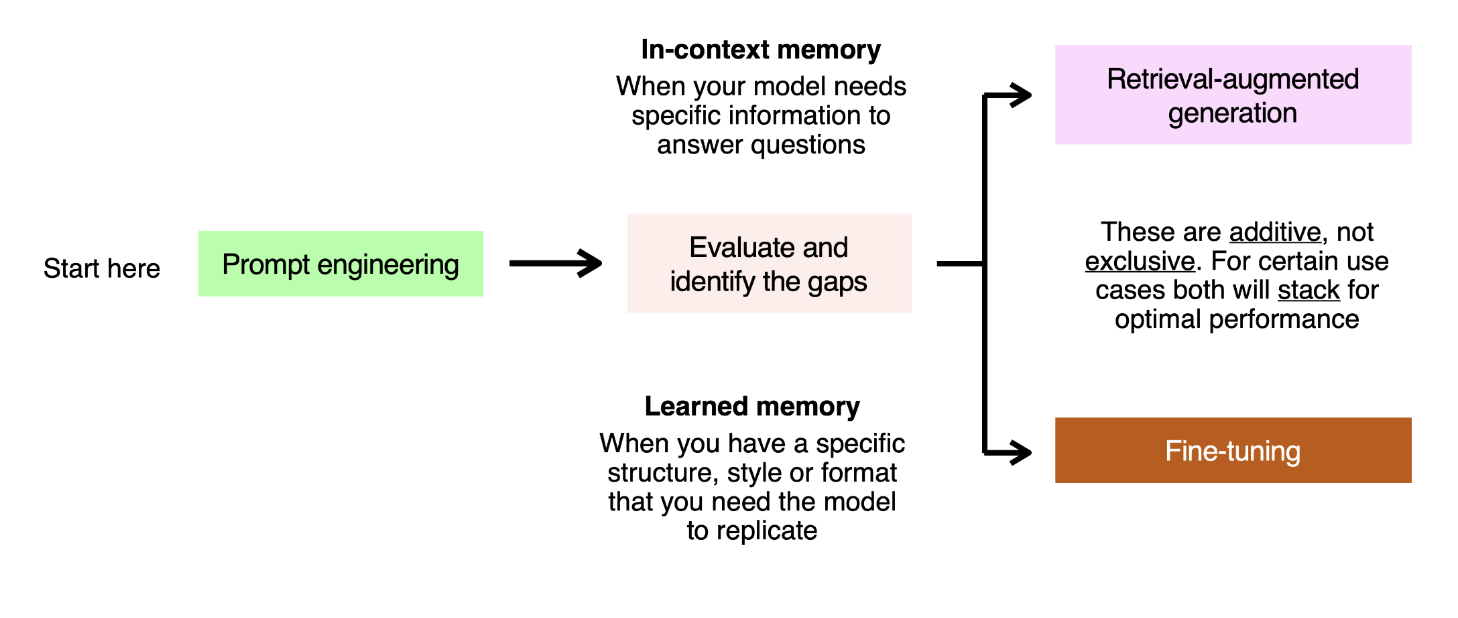
Para cada pergunta que o modelo errou na avaliação, considere se o problema está na memória fornecida pelo contexto ou na memória adquirida pelo aprendizado. Imagine que você esteja fazendo uma prova. Há duas formas de chegar à resposta correta:
- Você frequentou as aulas nos últimos seis meses e viu, repetidas vezes, exemplos de como determinado conceito funciona. Essa é a memória adquirida pelo aprendizado. No caso dos LLMs, você fornece exemplos de prompts e das respostas esperadas para que o modelo aprenda com eles.
- Você tem o livro didático em mãos e pode consultar as informações necessárias para responder à pergunta. Essa é a memória fornecida pelo contexto. No caso dos LLMs, incluímos informações relevantes na janela de contexto, seja de forma estática, com engenharia de prompt, seja em escala, com RAG.
Esses dois métodos de otimização se complementam e podem ser combinados. Em alguns casos, você precisará usar ambos para obter o melhor desempenho.
Vamos supor que o problema seja de memória de curto prazo. Nesse caso, usaremos RAG para resolvê-lo.
Geração aumentada por recuperação (RAG)
A técnica de RAG consiste em recuperar conteúdo para ampliar o prompt do LLM antes de gerar uma resposta. Ela dá ao modelo acesso a contexto específico do domínio para realizar uma tarefa.
RAG é uma ferramenta muito útil para aumentar a acurácia e a consistência de um LLM. Na OpenAI, muitas das nossas maiores implantações para clientes usaram apenas engenharia de prompt e RAG.
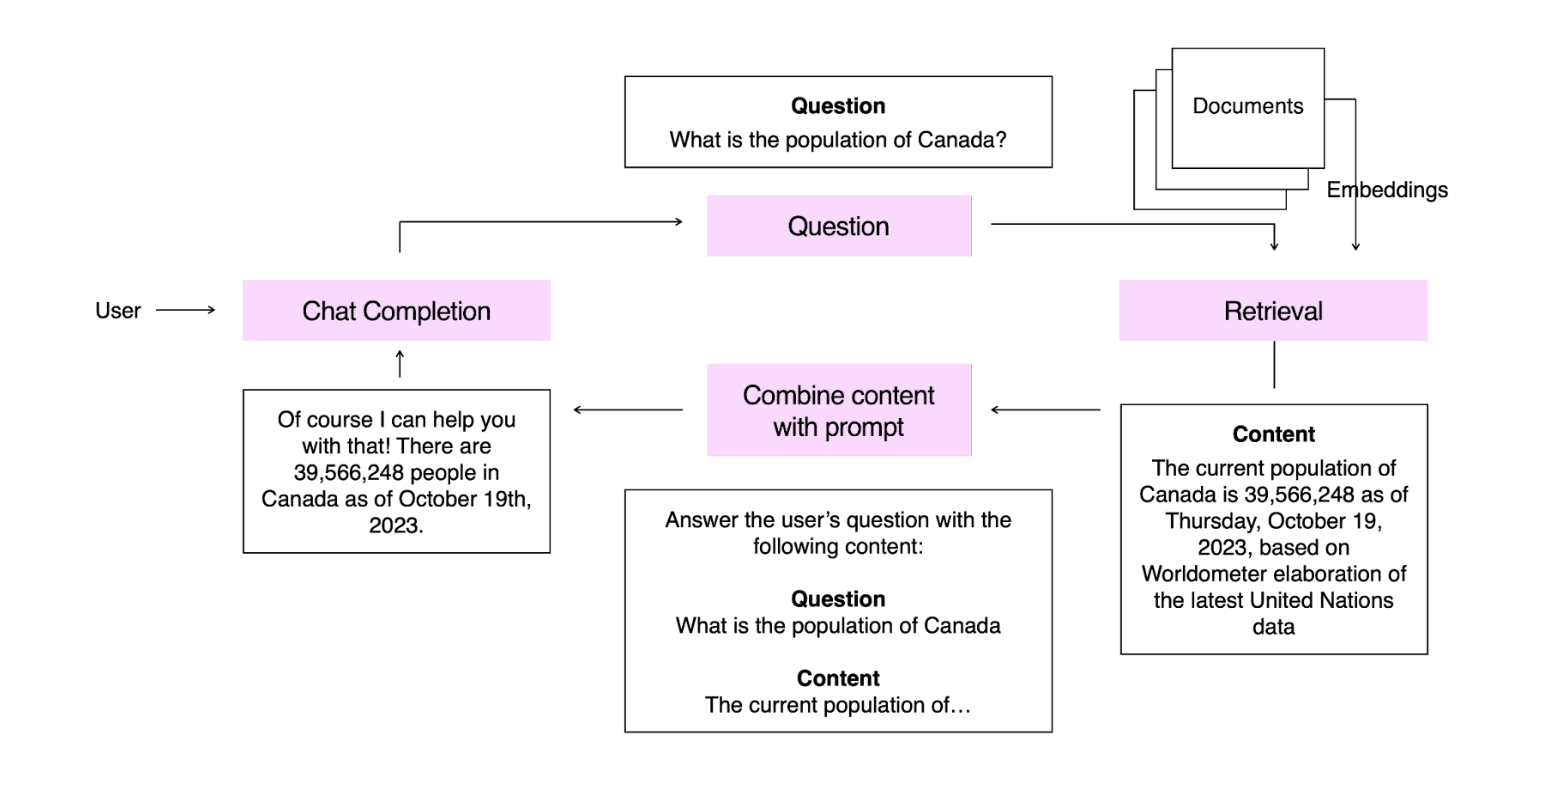
Neste exemplo, criamos representações vetoriais de uma base de conhecimento com dados estatísticos. Quando o usuário faz uma pergunta, também a convertemos em um vetor e recuperamos o conteúdo mais relevante da base. Apresentamos esse conteúdo ao modelo, que então responde à pergunta.
Aplicações com RAG introduzem mais um eixo de otimização: a recuperação. Para que a RAG funcione, precisamos fornecer o contexto certo ao modelo e depois verificar se ele responde corretamente. A matriz a seguir mostra uma forma simples de avaliar esses dois aspectos:
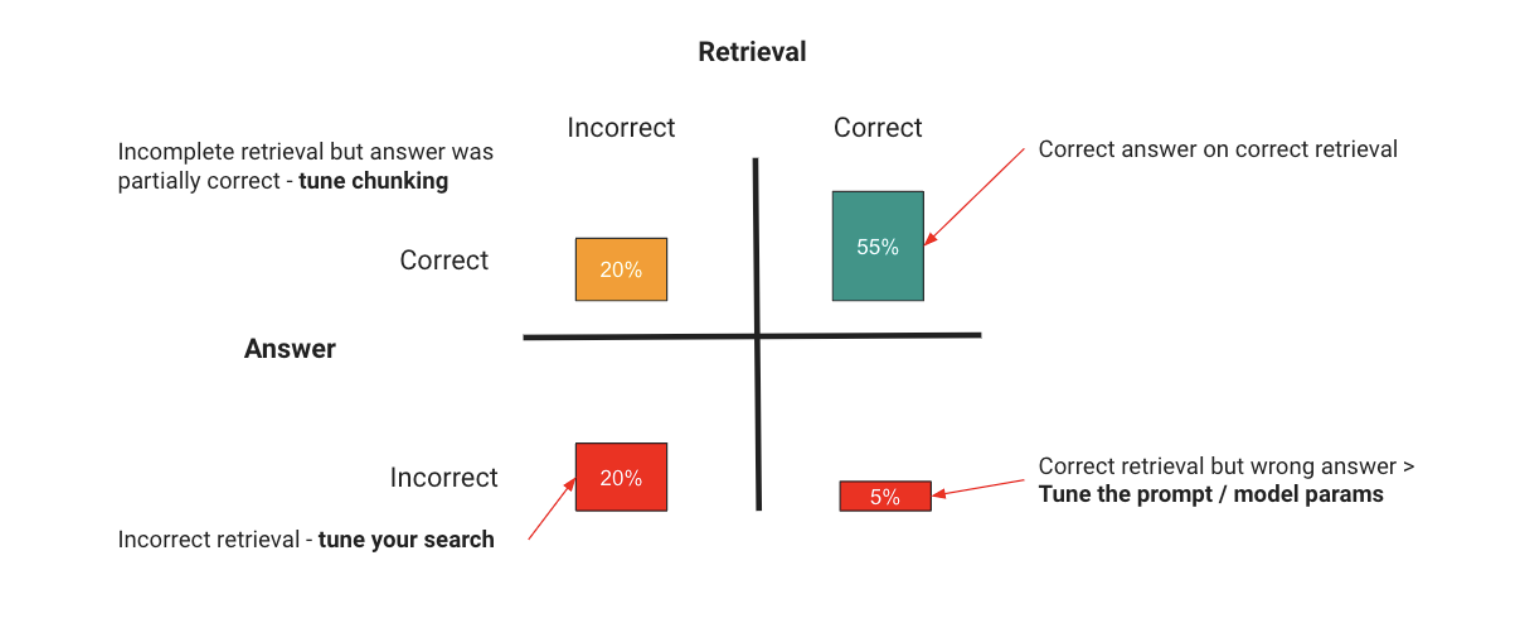
Uma aplicação com RAG pode falhar em duas áreas:
| Área | Problema | Solução |
|---|---|---|
| Recuperação | Se você fornecer o contexto errado, o modelo não terá como responder. Se fornecer contexto irrelevante em excesso, as informações importantes podem se perder em meio ao ruído, o que causa alucinações. | Otimize a recuperação. Você pode: - Ajustar a busca para retornar os resultados corretos. - Ajustar a busca para reduzir o ruído. - Fornecer mais informações em cada resultado recuperado. Esses são apenas alguns exemplos. A otimização de desempenho da RAG é uma área por si só, e bibliotecas como LlamaIndex e LangChain oferecem diversas abordagens. |
| LLM | O modelo também pode receber o contexto certo e usá-lo de forma incorreta. | Use engenharia de prompt para melhorar as instruções e o método que o modelo segue. Se fornecer exemplos aumentar a acurácia, incorpore o ajuste fino. |
O princípio é o mesmo do modelo mental apresentado no início: avalie o resultado para identificar o que deu errado e faça um ajuste para corrigir o problema. A diferença é que, com RAG, você também precisa considerar a recuperação.
Por mais útil que seja, a RAG só resolve problemas de aprendizado em contexto. Em muitos casos, o desafio é garantir que o LLM aprenda a tarefa para executá-la de forma consistente e confiável. Para isso, recorremos ao ajuste fino.
Ajuste fino
Para resolver um problema de memória adquirida pelo aprendizado, muitos desenvolvedores dão continuidade ao treinamento do LLM com um conjunto de dados menor, específico do domínio, para otimizar o modelo para determinada tarefa. Esse processo se chama ajuste fino.
O ajuste fino costuma ter um de dois objetivos:
- Melhorar a acurácia do modelo em uma tarefa específica: Treinar o modelo com dados da própria tarefa para resolver um problema de memória adquirida pelo aprendizado, mostrando vários exemplos de execução correta.
- Melhorar a eficiência do modelo: Obter a mesma acurácia com menos tokens ou com um modelo menor.
O ajuste fino começa pela preparação de um conjunto de exemplos de treinamento. Essa é a etapa mais importante, pois os exemplos precisam representar fielmente o que o modelo encontrará no uso real.
Muitos clientes usam um processo conhecido como prompt baking: durante um piloto, registram em detalhe as entradas e saídas dos prompts. Depois, selecionam os registros que formarão um conjunto de treinamento eficaz, com exemplos realistas.
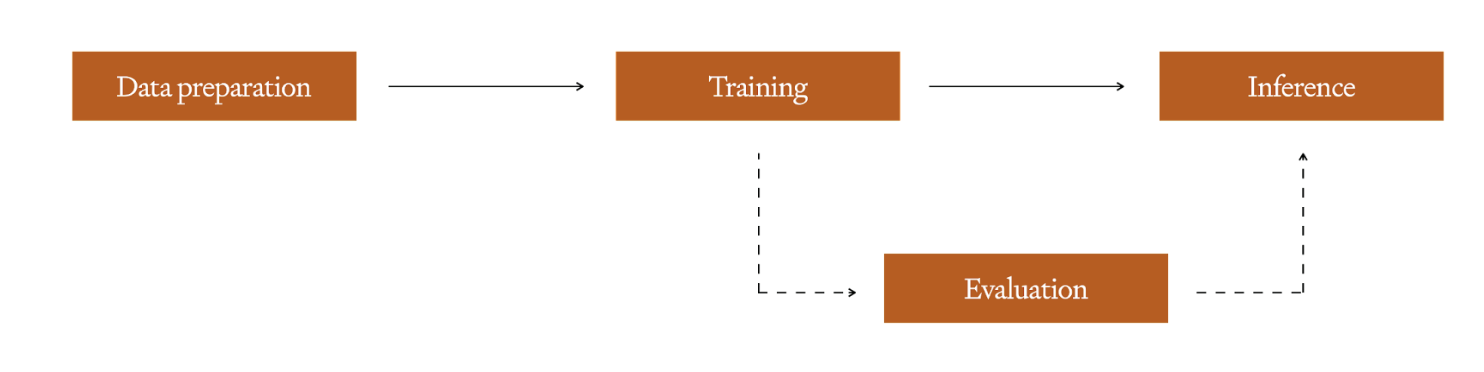
Com o conjunto de dados preparado, você pode fazer o ajuste fino do modelo executando uma rodada de treinamento. Dependendo da plataforma ou do framework, você poderá ajustar hiperparâmetros, como faria com outros modelos de aprendizado de máquina. Recomendamos sempre reservar um conjunto de dados para avaliação após o treinamento, a fim de detectar sobreajuste. Para saber como montar um bom conjunto de treinamento, consulte as orientações na documentação sobre ajuste fino. Quando o treinamento termina, o novo modelo fica disponível para inferência.
Para otimizar o ajuste fino, vamos nos concentrar nas boas práticas que observamos com as ferramentas de personalização de modelos da OpenAI. Esses princípios também devem valer para outros provedores e soluções de código aberto. As principais práticas são:
- Comece pela engenharia de prompt: Monte nessa etapa um conjunto de avaliação confiável que sirva de referência. Assim, você pode manter o investimento baixo até ganhar confiança no prompt inicial.
- Comece com poucos exemplos e priorize a qualidade: Ao fazer o ajuste fino de um modelo de base, a qualidade dos dados de treinamento importa mais do que a quantidade. Comece com pelo menos 50 exemplos e avalie os resultados. Aumente o conjunto se ainda não tiver atingido a acurácia necessária e se os erros decorrerem do comportamento ou da falta de consistência do modelo, e não do contexto.
- Use exemplos representativos: Um dos problemas mais comuns que observamos é o uso de dados de treinamento pouco representativos. Às vezes, há diferenças sutis de formato ou estrutura entre os exemplos de ajuste fino e as entradas que o LLM recebe em produção. Se a sua aplicação usa RAG, por exemplo, inclua exemplos com RAG no ajuste fino para que o modelo aprenda a usar o contexto sem depender de uma abordagem zero-shot.
Como combinar as técnicas
Você pode combinar essas técnicas. Se as primeiras avaliações revelarem problemas tanto de contexto quanto de comportamento, é bem possível que sua solução em produção use ajuste fino e RAG. Essa combinação ajuda a compensar as limitações de cada abordagem. Entre os principais benefícios estão:
- Usar o ajuste fino para reduzir ao mínimo o número de tokens usados na engenharia de prompt, substituindo instruções e exemplos few-shot por muitos exemplos de treinamento que ensinam ao modelo um comportamento consistente.
- Ensinar comportamentos complexos com um ajuste fino mais extenso.
- Usar RAG para inserir contexto, como conteúdo mais recente ou outras informações especializadas exigidas pelos seus casos de uso.
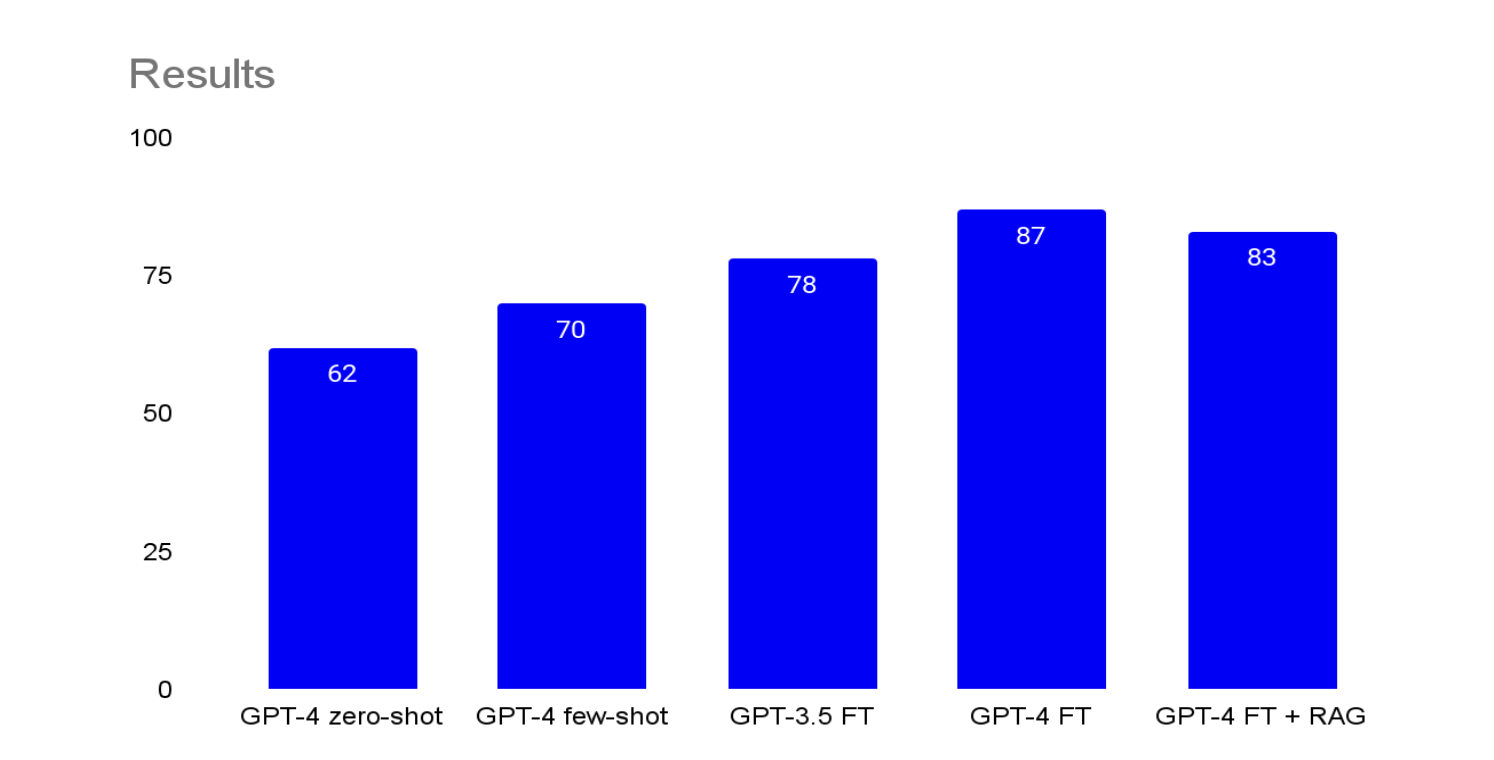 Pontuação BLEU por método de ajuste (de 0 a 100)
Agora você já sabe quando usar RAG e quando recorrer ao ajuste fino. Ainda há um fator a considerar: introduzir essas ferramentas afeta a velocidade com que você consegue testar mudanças.
- Com RAG, você precisa ajustar tanto a recuperação quanto o comportamento do LLM.
- Com o ajuste fino, cada nova rodada de ajustes exige repetir o treinamento e gerenciar os conjuntos de treinamento e validação.
Os dois processos podem ser demorados e complexos. À medida que a aplicação com LLM ganha complexidade, as mudanças podem introduzir regressões. Se houver uma lição a levar deste artigo, é esta: procure obter a maior acurácia possível com os métodos básicos antes de recorrer a abordagens mais complexas, como RAG ou ajuste fino. Deixe que a meta de acurácia oriente a escolha. A sofisticação atribuída à combinação de RAG e ajuste fino, por si só, não justifica seu uso.
Qual nível de acurácia é “suficiente” para produção?
Melhorar a acurácia de um LLM pode ser um trabalho sem fim. Com métodos prontos para uso, é improvável que o modelo atinja 99,999% de acurácia. Nesta seção, vamos discutir como decidir quando a acurácia é suficiente para colocar um LLM em produção com confiança e como gerenciar os riscos da solução depois do lançamento.
Acho útil considerar a questão tanto do ponto de vista do negócio quanto do ponto de vista técnico. Vou descrever as abordagens gerais para lidar com os dois aspectos e usar um exemplo de central de atendimento ao cliente para mostrar como administramos o risco em cada um deles.
Aspectos de negócio
Para uma empresa acostumada à previsibilidade relativamente maior de sistemas baseados em regras, de modelos tradicionais de aprendizado de máquina ou até mesmo de pessoas, pode ser difícil confiar em LLMs. É um desafio lidar com um sistema que pode falhar de maneiras variadas e imprevisíveis.
Uma abordagem que vi funcionar em um caso de atendimento ao cliente foi a seguinte:
Primeiro, identificamos os principais cenários de sucesso e falha e estimamos o custo de cada um. Com isso, podemos usar o desempenho no piloto para estimar quanto a solução tende a economizar ou custar.
- Por exemplo, quando a IA resolve um caso que antes precisava de um atendente, podemos economizar US$ 20.
- Encaminhar um cliente a um atendente sem necessidade pode custar US$ 40.
- No pior cenário, o cliente fica tão frustrado com a IA que deixa de usar o serviço, o que nos custa US$ 1.000. Supomos que isso aconteça em 5% dos casos.
| Evento | Valor | Número de casos | Valor total |
|---|---|---|---|
| Acerto da IA | +20 | 815 | US$ 16.300 |
| Falha da IA (encaminhamento a um atendente) | -40 | 175,75 | US$ 7.030 |
| Falha da IA (perda do cliente) | -1000 | 9,25 | US$ 9.250 |
| Resultado | +20 | ||
| Acurácia no ponto de equilíbrio | 81,5% |
Também coletamos dados do processo para medir o impacto geral da solução. No exemplo de atendimento ao cliente, poderíamos comparar:
- A pontuação de satisfação do cliente (CSAT) nas interações conduzidas inteiramente por pessoas e nas conduzidas pela IA.
- A taxa de acerto das decisões de atendentes e da IA, calculada a partir de uma revisão posterior dos casos.
- O tempo que atendentes e IA levam para resolver os casos.
No exemplo de atendimento ao cliente, realizamos alguns pilotos para obter dados claros. Os resultados nos ajudaram a tomar duas decisões importantes:
- Embora a solução com LLM encaminhasse mais casos a atendentes do que gostaríamos, a economia operacional em relação à solução existente ainda era enorme. Assim, até uma acurácia de 85% poderia ser aceitável se os 15% restantes fossem, em sua maioria, encaminhamentos prematuros.
- Quando o custo de um erro era muito alto, como no caso de uma fraude tratada incorretamente, decidimos que uma pessoa conduziria o atendimento e a IA atuaria como assistente. Nesse caso, a taxa de acerto das decisões nos ajudou a concluir que não tínhamos confiança suficiente para dar autonomia total à IA.
Aspectos técnicos
Do ponto de vista técnico, a tarefa é mais clara. Quando a empresa já sabe que valor espera obter e quanto as falhas podem custar, cabe a você criar uma solução capaz de lidar com erros sem comprometer a experiência do usuário.
Vamos retomar o exemplo de atendimento ao cliente e supor que o modelo identifique corretamente a intenção do cliente em 85% dos casos. A equipe técnica tem algumas opções para reduzir o impacto dos erros nos 15% restantes:
- Podemos ajustar o prompt para que o modelo peça mais informações ao cliente quando houver dúvida. A taxa de acertos na primeira tentativa pode cair, mas, com duas oportunidades para identificar a intenção, podemos obter uma acurácia maior.
- Podemos permitir que o assistente de segundo nível devolva o caso à etapa de identificação da intenção. Assim, o fluxo de atendimento tem mais uma oportunidade de corrigir o erro, embora isso aumente um pouco o tempo de espera do usuário.
- Podemos ajustar o prompt para que o modelo encaminhe o caso a um atendente se a intenção não estiver clara. Isso reduz parte da economia operacional no curto prazo, mas pode reduzir o risco de perder clientes no longo prazo.
Essas decisões afetam a experiência do usuário: o atendimento pode levar mais tempo para alcançar uma acurácia maior ou exigir mais intervenções humanas. Esses efeitos entram no cálculo de custos descrito na seção sobre aspectos de negócio.
Com essa abordagem, você pode analisar separadamente as decisões de negócio e as decisões técnicas envolvidas na definição de uma meta de acurácia compatível com a realidade da empresa.
Próximos passos
Este modelo mental oferece uma visão geral de como maximizar a acurácia dos LLMs, quais ferramentas usar e como decidir quando a acurácia é suficiente para produção. Agora você tem um método e as ferramentas necessárias para levar soluções à produção de forma consistente. Para conhecer resultados obtidos com essas técnicas, explore nossas Histórias de clientes. Os casos do Morgan Stanley e da Klarna mostram o que é possível alcançar na prática.
Boa sorte! Estamos ansiosos para ver o que você vai criar com essas técnicas.