
Visão geral
No modo multiagente, o modelo pode criar e coordenar subagentes que trabalham em paralelo e reunir os resultados em uma resposta final. Esse modo é especialmente eficaz em aplicativos com tarefas complexas que se beneficiam da divisão do trabalho em paralelo, como explorar uma base de código, escrever documentação e implementar funcionalidades.
O modo multiagente está disponível em versão beta para o GPT-6.1 Sol e todos os modelos GPT-5.6. Consulte a página do modelo antes de ativar o modo multiagente no seu aplicativo.
Quando usar o modo multiagente
Muitas tarefas podem ser divididas em partes independentes que um único agente executaria em sequência, mas que vários agentes podem executar em paralelo. No modo multiagente, o agente raiz pode delegar essas partes a vários subagentes que trabalham ao mesmo tempo. Isso pode trazer algumas vantagens:
- Execução paralela. Tarefas independentes de pesquisa, análise ou implementação podem ocorrer ao mesmo tempo, o que pode reduzir o tempo de execução.
- Contexto específico para cada tarefa. Cada subagente recebe uma tarefa de escopo delimitado e mantém seu próprio contexto. Isso reduz a interferência entre frentes de trabalho distintas e melhora o desempenho.
- Coordenação pelo modelo. O agente raiz pode criar subagentes, enviar informações adicionais, aguardar os resultados e reuni-los em uma resposta final sem que seu aplicativo precise implementar a orquestração.
A orquestração multiagente é mais útil quando a tarefa pode ser dividida em frentes de trabalho concretas e independentes, como:
- Explorar partes distintas de uma base de código extensa
- Comparar várias propostas, documentos ou hipóteses
- Pesquisar em várias fontes em paralelo
- Implementar componentes independentes ou escrever conjuntos de testes independentes
- Investigar em paralelo diferentes causas possíveis de uma falha
- Explorar ao mesmo tempo diferentes abordagens para um problema
Adicionar subagentes pode aumentar o uso de tokens. O benefício pode ser menor em tarefas que dependem de uma única sequência de raciocínio, exigem gravações frequentes em um estado mutável compartilhado ou já gastam a maior parte do tempo em uma única operação externa lenta.
| Use o modo multiagente quando | Prefira um único agente quando |
|---|---|
| O trabalho puder ser dividido em tarefas independentes de escopo delimitado | Cada etapa depender diretamente da anterior |
| Manter os contextos separados ajudar cada agente a se concentrar na própria tarefa | A tarefa for pequena o suficiente para ser concluída em uma única execução curta |
| A exploração em paralelo puder reduzir o tempo total de execução | Os agentes precisarem disputar o acesso ao mesmo recurso mutável |
| Comparar resultados independentes ampliar a cobertura da análise | Você precisar de um grafo de execução fixo e determinístico |
Início rápido
Os exemplos em Python e JavaScript usam o SDK beta da API Responses. Para requisições HTTP,
use client.beta.responses e passe responses_multi_agent=v1 no argumento
betas. Para requisições HTTP diretas e conexões WebSocket, inclua
OpenAI-Beta: responses_multi_agent=v1 nos cabeçalhos da requisição ou da conexão.
Os schemas dos itens podem mudar enquanto o modo multiagente estiver em beta.
Ative o modo multiagente na requisição à API Responses com multi_agent.enabled. Quando multi_agent.enabled é true, o agente raiz pode criar uma árvore de subagentes. Os subagentes usam o mesmo modelo e as mesmas ferramentas disponíveis na requisição. Os agentes se coordenam por meio de operações básicas de colaboração, como criar subagentes, trocar mensagens e aguardar resultados (consulte Como funciona o modo multiagente). Cabe ao agente raiz sintetizar as respostas dos subagentes e fornecer a resposta final.
from openai import OpenAI
client = OpenAI()
def review_pull_request(diff: str) -> str:
response = client.beta.responses.create(
model="gpt-6.1-sol",
input=(
"Review the pull-request diff below with three agents: one for "
"correctness, one for security, and one for missing tests. "
"Reconcile duplicate or conflicting findings, then return a "
"prioritized review with file and line references.\n\n"
f"<diff>\n{diff}\n</diff>"
),
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
betas=["responses_multi_agent=v1"],
)
return "".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)max_concurrent_subagents define o número máximo de subagentes que podem estar ativos ao mesmo tempo em toda a árvore de agentes. A contagem inclui todos os descendentes, dos filhos e netos aos subagentes em níveis mais profundos, mas exclui o agente raiz.
A API não impõe um limite superior fixo para essa configuração. O valor padrão é 3, recomendado para a maioria das cargas de trabalho. O modo multiagente também não impõe um limite fixo à profundidade da árvore nem ao número total de subagentes criados durante uma execução.
Adicione uma mensagem de desenvolvedor para definir com mais precisão quando o modelo do agente raiz deve criar subagentes. Essa mensagem complementa as instruções injetadas para o agente raiz e os subagentes.
Exemplos de mensagens de desenvolvedor:
- “Só crie subagentes se o usuário pedir explicitamente o uso de subagentes, a delegação de tarefas ou o trabalho de agentes em paralelo.”
- “A delegação proativa no modo multiagente está ativa. Use subagentes quando trabalhar em paralelo puder reduzir significativamente o tempo de execução ou melhorar significativamente a qualidade do resultado.”
Como funciona o modo multiagente
A API Responses disponibiliza ações de orquestração hospedadas aos modelos do agente raiz e dos subagentes, junto com instruções de uso. O agente raiz recebe o nome /root. Os subagentes criados usam caminhos hierárquicos como estes:
/root
├── /root/researcher
├── /root/reviewer
└── /root/reviewer/tester
O modo multiagente não impõe um limite fixo ao número total de subagentes nem à profundidade da árvore. Para a maioria das tarefas, use o valor padrão de max_concurrent_subagents, que é 3. Essa configuração limita o número de turnos de subagentes que podem estar ativos ao mesmo tempo em toda a árvore, incluindo os turnos dos filhos e dos descendentes em níveis mais profundos.
Quando o modo multiagente está ativo, a API Responses disponibiliza seis ações de colaboração hospedadas. Elas podem aparecer como itens multi_agent_call. Seu aplicativo não deve executar essas ações nem enviar saídas para elas.
| Ação | Finalidade |
|---|---|
spawn_agent |
Cria um subagente e atribui a ele sua tarefa inicial. |
send_message |
Coloca uma mensagem na fila de um agente existente sem iniciar um novo turno. |
followup_task |
Atribui mais trabalho a um agente existente que não seja o agente raiz e inicia ou retoma seu turno. |
wait_agent |
Aguarda uma atualização na caixa de entrada do agente que fez a chamada. |
interrupt_agent |
Interrompe o turno ativo de outro agente sem excluir seu contexto. |
list_agents |
Retorna a árvore atual de agentes, o status de cada um e seu last_task_message. |
As chamadas de ferramentas definidas pelo desenvolvedor são tratadas da mesma forma que quando o modo multiagente está desativado. Qualquer agente da árvore pode emitir um item function_call. Seu aplicativo deve executar a chamada e enviar o function_call_output correspondente.
Todos os agentes da árvore têm acesso às ferramentas configuradas na chamada ao modelo da requisição à API.
Como usar o modo multiagente na API Responses
Desempenho com HTTP e WebSocket
HTTP e WebSocket oferecem os mesmos recursos no modo multiagente, mas recomendamos WebSocket para fluxos de trabalho demorados ou que fazem uso intensivo de ferramentas. A conexão persistente permite que seu aplicativo devolva as saídas das funções assim que estiverem disponíveis. Isso reduz o custo de retomar a execução e o tempo que os agentes passam esperando.
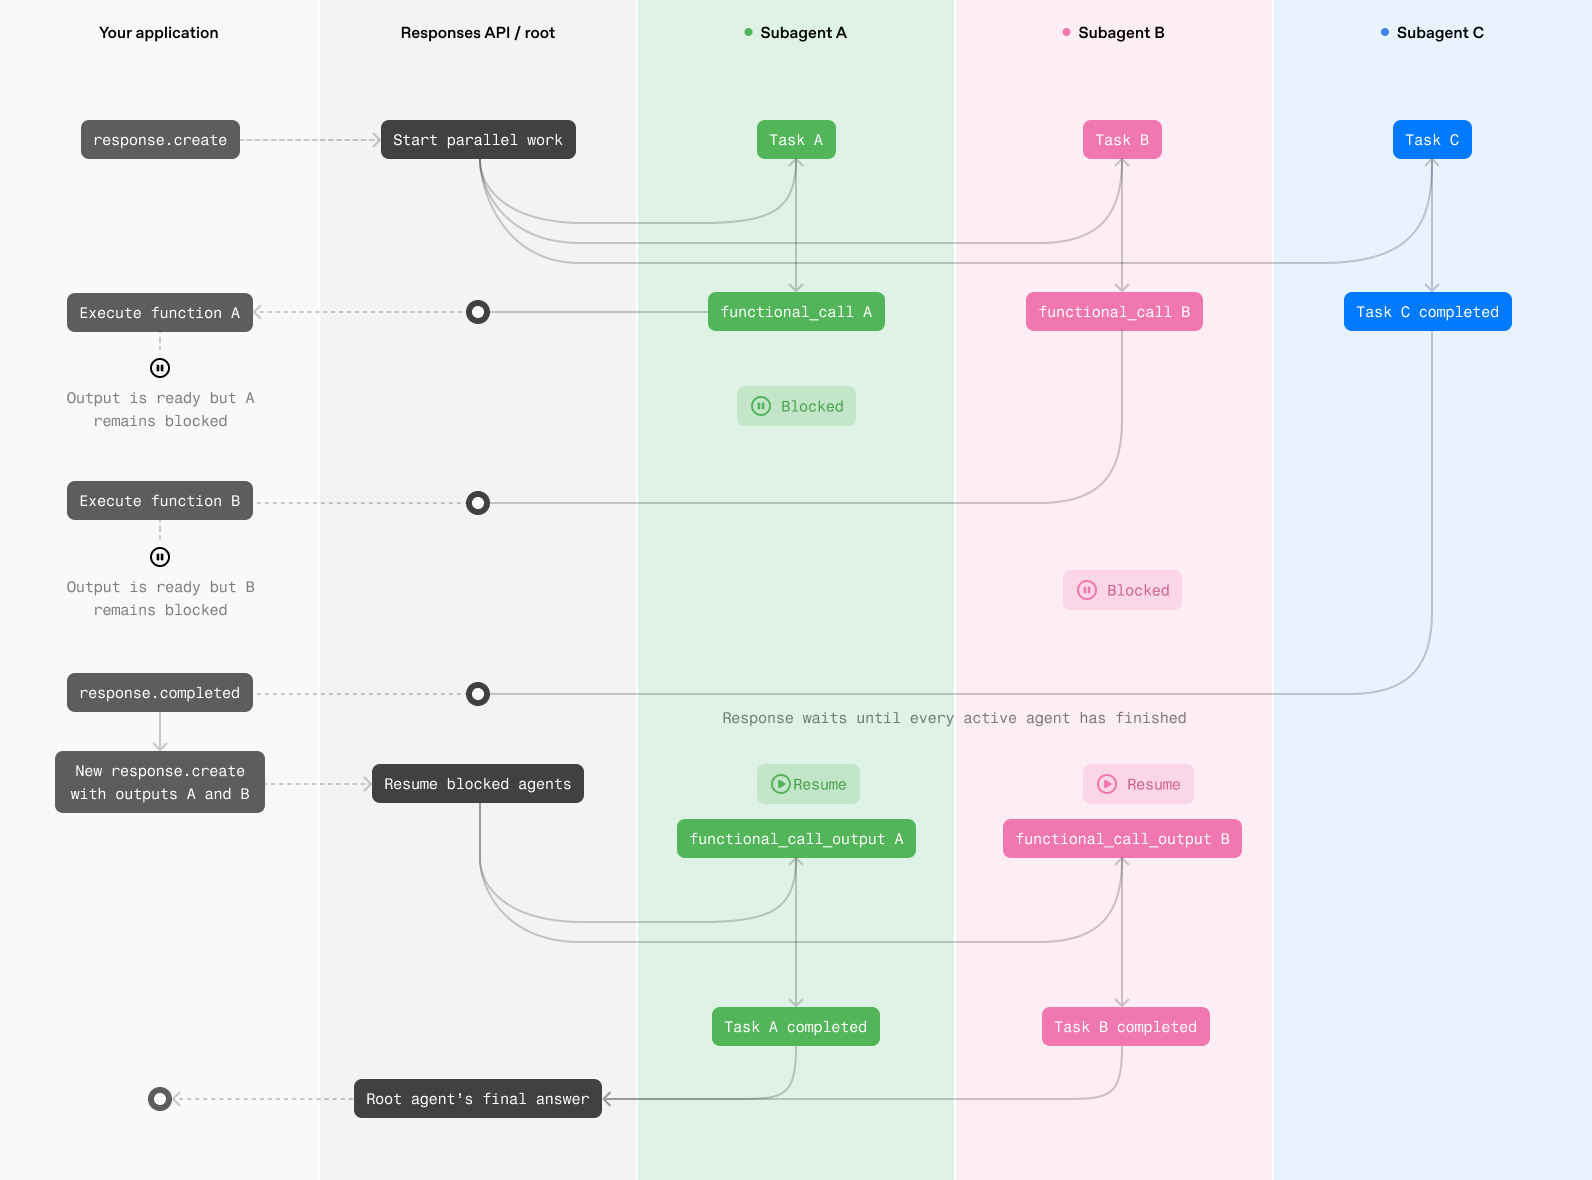
Com HTTP, a resposta é concluída quando cada agente ativo termina seu trabalho ou pausa para aguardar a execução de uma chamada de função pelo cliente. Seu aplicativo então executa todas as chamadas de função pendentes e envia as saídas em uma nova requisição à API Responses, permitindo que os agentes em pausa retomem o trabalho.
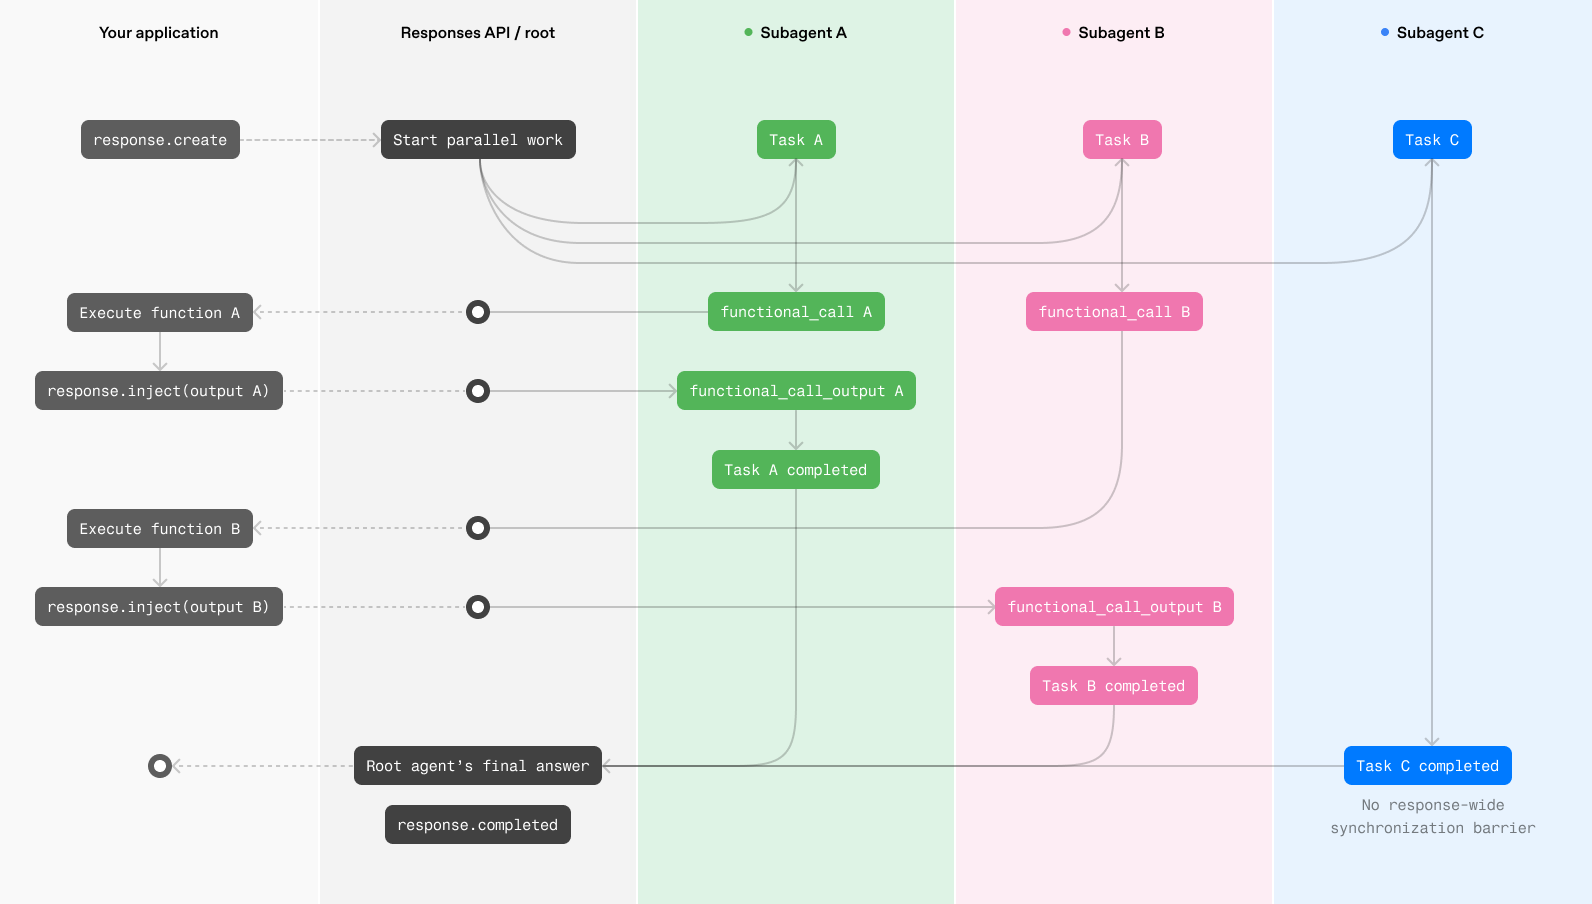
Com WebSocket, seu aplicativo pode injetar a saída de cada função na resposta assim que a saída estiver disponível, sem esperar que a resposta ativa seja concluída. O agente que aguardava a saída pode retomar o trabalho imediatamente enquanto os demais continuam trabalhando. Isso reduz os atrasos de coordenação e evita ciclos adicionais de requisição e resposta quando os agentes terminam suas tarefas ou solicitam ferramentas em momentos diferentes.
HTTP pode ser suficiente para fluxos de trabalho que exigem chamadas a várias ferramentas hospedadas, como pesquisas na Web em paralelo, ou que usam uma única requisição com poucas chamadas de função. Para a maioria dos fluxos de trabalho no modo multiagente, WebSocket tende a oferecer menor latência e melhor desempenho de ponta a ponta.
Execução de chamadas de função via HTTP
Execução de chamadas de função via WebSocket
HTTP
Estes exemplos exigem versões beta dos SDKs que dão acesso à versão beta da API Responses. Para usar streaming via HTTP, chame client.beta.responses.create e passe responses_multi_agent=v1 no argumento betas. Isso habilita os tipos beta e o preenchimento automático. Em Python, ao adicionar anotações de tipo, importe os tipos beta dos itens de resposta de openai.types.beta.
Exemplo de código do cliente:
from __future__ import annotations
import json
import sys
from openai import OpenAI
from openai.types.beta import BetaResponseOutputItem
client = OpenAI()
ROOT = "/root"
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
history = [
{
"role": "user",
"content": (
"Use two subagents, one for proposal alpha and one for proposal beta. "
"Have each call get_proposal, then compare their findings."
),
}
]
def agent_name(item: BetaResponseOutputItem) -> str:
return item.agent.agent_name if item.agent else ROOT
def render_to_user(delta: str) -> None:
print(delta, end="", flush=True)
def log_subagent_text(agent: str, delta: str) -> None:
print(f"[{agent}] {delta}", end="", file=sys.stderr, flush=True)
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
while True:
output_items = []
pending_calls = []
item_agents: dict[int, str] = {}
stream = client.beta.responses.create(
model="gpt-6.1-sol",
input=history,
tools=tools,
store=False,
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
stream=True,
betas=["responses_multi_agent=v1"],
)
for event in stream:
if event.type == "response.output_item.added":
item_agents[event.output_index] = agent_name(event.item)
elif event.type == "response.output_text.delta":
agent = item_agents.get(event.output_index, ROOT)
if agent == ROOT:
render_to_user(event.delta)
else:
log_subagent_text(agent, event.delta)
elif event.type == "response.output_item.done":
output_items.append(event.item)
if event.item.type == "function_call":
# Handle function calls from both the root agent and subagents.
pending_calls.append(event.item)
elif event.type == "response.completed":
print(f"\nUsage: {event.response.usage}", file=sys.stderr)
break
elif event.type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
history.extend(output_items)
for call in pending_calls:
history.append(
{
"type": "function_call_output",
"call_id": call.call_id,
"output": process_tool_call(call.name, call.arguments),
}
)
if not pending_calls:
breakSe um ou mais agentes chamarem funções definidas pelo desenvolvedor, execute todas as chamadas pendentes e crie uma requisição de continuação com as respectivas saídas.
WebSocket
No modo WebSocket, quando um agente chamar uma função definida pelo desenvolvedor, execute a função no seu aplicativo e envie o resultado à resposta ativa em um evento response.inject. O agente que aguardava o resultado poderá retomar o trabalho sem esperar pela conclusão de toda a resposta do modo multiagente.
{
"type": "response.inject",
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
]
}Para uma requisição response.inject válida, o servidor responde com um de dois eventos:
response.inject.created: a entrada foi validada e aceita para injeção.response.inject.failed: a entrada não foi injetada. Verifiqueerror.code.
{
"type": "response.inject.created",
"sequence_number": 42,
"response_id": "resp_123"
}{
"type": "response.inject.failed",
"sequence_number": 43,
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
],
"error": {
"code": "response_already_completed",
"message": "Response 'resp_123' has already completed."
}
}Se a requisição não seguir o schema de response.inject, o servidor enviará um erro genérico com o status 400 e encerrará a conexão WebSocket. Corrija a requisição e abra uma nova conexão WebSocket antes de enviar outro evento.
O SDK beta de Python disponibiliza o modo WebSocket por meio de client.beta.responses.connect. No SDK beta de TypeScript, use ResponsesWS. Inclua OpenAI-Beta: responses_multi_agent=v1 nos cabeçalhos da conexão. Diferentemente do streaming via HTTP, os conectores WebSocket ainda não aceitam o argumento betas.
Guarde o ID da resposta recebido no evento response.created e inclua esse ID em cada evento response.inject que enviar para essa resposta. Depois de enviar um item para injeção, continue lendo os eventos da conexão WebSocket até que a resposta seja concluída e cada injeção tenha gerado um evento response.inject.created ou response.inject.failed.
from __future__ import annotations
import json
from openai import OpenAI
client = OpenAI()
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
def run_multi_agent(connection):
previous_response_id: str | None = None
pending_input: list[dict[str, object]] = [{"role": "user", "content": input()}]
while pending_input:
request = {
"type": "response.create",
"model": "gpt-6.1-sol",
"store": True,
"multi_agent": {"enabled": True},
"tools": tools,
"input": pending_input,
}
if previous_response_id is not None:
request["previous_response_id"] = previous_response_id
connection.send(request)
next_input: list[dict[str, object]] = []
completed_response = None
response_id: str | None = None
pending_injections = 0
for event in connection:
event_type = event.type
if event_type == "response.created":
response_id = event.response.id
elif event_type == "response.output_item.done":
item = event.item
if item.type == "function_call":
if response_id is None:
raise RuntimeError(
"Received a function call before response.created"
)
output = {
"type": "function_call_output",
"call_id": item.call_id,
"output": process_tool_call(item.name, item.arguments),
}
pending_injections += 1
connection.send(
{
"type": "response.inject",
"response_id": response_id,
"input": [output],
}
)
elif event_type == "response.inject.created":
pending_injections -= 1
elif event_type == "response.inject.failed":
pending_injections -= 1
if event.error.code != "response_already_completed":
raise RuntimeError(event.error)
next_input.extend(item.model_dump(mode="json") for item in event.input)
elif event_type == "response.completed":
completed_response = event.response
elif event_type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
if completed_response is not None and pending_injections == 0:
break
if completed_response is None:
raise RuntimeError("Connection ended before response.completed")
if pending_injections:
raise RuntimeError("Connection ended with unacknowledged tool results")
if not next_input:
return completed_response
previous_response_id = completed_response.id
pending_input = next_input
with client.beta.responses.connect(
extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
) as connection:
response = run_multi_agent(connection)
print(
"".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)
)Depois de enviar um evento response.inject, continue lendo os eventos da conexão WebSocket e trate o retorno do servidor:
response.inject.created: a saída da função foi adicionada à resposta ativa. Continue lendo os eventos dessa resposta.response.inject.failedcomresponse_already_completed: a resposta foi concluída antes que a saída da função pudesse ser adicionada. Envie oinputretornado no evento de falha em uma nova requisiçãoresponse.createque dê continuidade à resposta concluída.response.inject.failedcomresponse_not_found: o servidor não encontrou a resposta identificada porresponse_id. Verifique se você está usando o ID recebido emresponse.created.
Uma única execução no modo multiagente pode envolver várias requisições à API Responses. Com HTTP, quando um agente chama uma função definida pelo desenvolvedor, seu aplicativo executa a função e envia a saída em uma nova chamada response.create. Com WebSocket, seu aplicativo injeta a saída da função diretamente na resposta ativa.
Novos itens de saída do modo multiagente
As respostas no modo multiagente podem incluir três tipos adicionais de itens de saída:
multi_agent_call: registra uma ação hospedada do modo multiagente, comospawn_agent.multi_agent_call_output: contém o resultado da execução de uma ação hospedada.agent_message: transporta uma mensagem criptografada de um agente para outro.
O campo call_id associa cada multi_agent_call ao multi_agent_call_output correspondente.
Cada item também inclui um atributo agent. Em um item agent_message, agent.agent_name identifica o agente destinatário. Use author e recipient para rastrear quem enviou e quem recebeu a mensagem.
Quando seu aplicativo receber um item multi_agent_call, não o execute como uma chamada de função nem envie um resultado de volta. A API Responses executa a ação hospedada e retorna o multi_agent_call_output correspondente. Preserve os dois itens se seu aplicativo precisar deles para reproduzir ou rastrear a execução.
[
{
"type": "multi_agent_call",
"id": "mac_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"arguments": "{\"task_name\":\"agent_a\",\"fork_turns\":\"all\",\"message\":\"enc_...\"}",
"agent": { "agent_name": "/root" }
},
{
"type": "multi_agent_call_output",
"id": "maco_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"output": [
{
"type": "output_text",
"text": "{\"task_name\":\"/root/agent_a\"}",
"annotations": [],
"logprobs": []
}
],
"agent": { "agent_name": "/root" }
},
{
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
]Os eventos SSE atribuídos a um agente incluem um atributo agent no nível superior. Em um evento agent_message, agent.agent_name identifica o agente destinatário. Eventos do ciclo de vida da resposta, como response.created e response.completed, descrevem a resposta como um todo. Por isso, não incluem um atributo agent.
{
"type": "response.output_item.done",
"agent": { "agent_name": "/root" },
"item": {
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
}Limitações
- Compactação:
- A API não oferece suporte ao endpoint
/responses/compactquando o modo multiagente está ativo. - Quando
multi_agent.enabledé definido comotrue, a compactação automática no servidor é ativada implicitamente, mesmo que a requisição não configurecontext_management. O servidor aplica a compactação separadamente ao agente raiz e a cada subagente, preservando os contextos individuais. Você ainda pode substituir o valor decompact_thresholdao definir explicitamentecontext_management.compact_thresholdna requisição.
- A API não oferece suporte ao endpoint
- A API não oferece suporte a
reasoning.summaryquando o modo multiagente está ativo. - A API não oferece suporte a
max_tool_callsquando o modo multiagente está ativo. - O valor padrão de
max_concurrent_subagentsé3, que é a configuração recomendada.
Orientações para prompts
Quando o modo multiagente está ativo, nossos sistemas acrescentam automaticamente as instruções a seguir ao contexto do agente raiz e dos subagentes em uma nova mensagem de desenvolvedor. Você não pode editar nem remover essas instruções. Ao escrever suas instruções de desenvolvedor, formule-as de modo que complementem as instruções injetadas automaticamente.
Agente raiz
You are `/root`, the primary agent in a team of agents collaborating to fulfill the user's goals.

At the start of your turn, you are the active agent.
You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents.
All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent without triggering a turn.
Child agents can also spawn their own sub-agents.
You can decide how much context you want to propagate to your sub-agents with the `fork_turns` parameter.

You will receive messages in the form:
```
Message Type: MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
They may be addressed as to=/root

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.
Subagente
You are an agent in a team of agents collaborating to complete a task.

You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents. All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent.
Child agents can also spawn their own sub-agents.

When you provide a response in the final channel, that content is immediately delivered back to your parent agent.

You will receive messages in the form:
```
Message Type: NEW_TASK | MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
You may also see them addressed as to=/root/..., which indicates your identity is /root/...

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.