
O GPT-Live melhora a experiência de quem conversa com ele ao acompanhar o ritmo da fala. Você pode intervir, mudar de assunto e desenvolver uma ideia enquanto fala. Nos sistemas de voz em cascata, a fala passa por modelos separados de transcrição, linguagem e geração de fala. O GPT-Live ouve e fala ao mesmo tempo, o que torna a conversa mais natural: o momento de falar ou de interromper importa tanto quanto as próprias palavras.
Neste artigo, Juno, Picsart, Treater e Weekend contam, com suas próprias palavras, como desenvolvem produtos com o GPT-Live e o que aprenderam sobre os seguintes temas:
- Melhorar as chamadas com dados reais de produção
- Encontrar vozes que inspiram confiança
- Coordenar o trabalho com agentes em segundo plano
- Orquestrar agentes de voz que atuam em conjunto
Veremos os prompts, os fluxos de trabalho e o feedback que dão forma a esses produtos, com ideias que outros desenvolvedores podem testar em seus próprios aplicativos.
Histórias das startups
Juno: como usamos o GPT-Live para tornar a conversa com nossa assistente de voz mais natural para os pacientes
Por Marshall Gould, cofundador e CEO, e Isaac Tolley, cofundador e CTO
Estamos desenvolvendo a Juno, uma assistente pessoal de saúde para quem vive com condições crônicas como covid longa, síndrome de taquicardia postural ortostática (POTS) e síndromes de Ehlers-Danlos (EDS).
O que queríamos criar
Só quem vive com uma doença crônica sabe de fato o peso que ela traz. Além dos sintomas intensos, da fadiga, das consultas e da ansiedade de não saber o que está acontecendo, há uma longa lista de tarefas: lembrar de repor um medicamento, ler as pesquisas mais recentes, acompanhar os sintomas e relacioná-los às centenas de variáveis que mudam a cada dia. Tudo isso enquanto se tenta levar uma vida normal.
Para quem vive com uma doença crônica, principalmente quando a energia é limitada, os próprios aplicativos de acompanhamento se tornam um peso. Fazer os registros à mão é exaustivo, e muita gente acaba abandonando esses aplicativos, por mais que ajudem.
É por isso que a voz fez tanta diferença. Basta dizer uma frase simples para a Juno registrar várias coisas de uma só vez.
Os desafios que ainda enfrentamos com a voz
Mesmo sem ajustes, a interação por voz já impressiona. Falar é a maneira mais natural de se comunicar, mas ainda estamos aprendendo a fazer isso funcionar bem. Ainda temos alguns desafios:
- Registrar um sintoma ou recuperar informações de contexto sem interromper o fluxo da conversa.
- Levar para a voz o que ficou na memória das conversas por texto sem fazer a pessoa esperar.
- Sustentar conversas longas.
Para mim, os modelos de voz são como águas-vivas. Reagem rápido, mas têm pouco senso de direção. Deixam-se levar pelo que a pessoa acabou de dizer e param com frequência para pedir confirmação. Os modelos de texto tomam mais iniciativa porque podem recorrer a um contexto muito mais amplo, sem que a pessoa precise explicar sua situação a cada vez. Com a voz, você precisa dar o rumo à conversa.
Como aprimoramos nossos agentes de voz
Registros e memória sem interromper a conversa
Quando você pede algo à maioria dos agentes de voz, eles encaminham a solicitação a uma ferramenta e esperam a resposta. Esse tempo de espera vira silêncio na chamada. O GPT-Live pode delegar o trabalho a outro agente, mas a conversa fica parada até a resposta chegar. Na nossa primeira versão, quatro em cada cinco chamadas tinham pelo menos uma pausa dessas: “Só um momento”, seguido de cerca de 10 segundos de silêncio.
Nossa solução é simples. A cada turno da conversa, um modelo pequeno e rápido (a API Decisions da OpenAI) responde a duas perguntas em segundo plano:
- Há algo a registrar? De que tipo?
- O que há no seu histórico que importa neste momento?
Diga “registre uma dor de cabeça” e a Juno recebe imediatamente a informação de que o registro foi feito, enquanto os dados são salvos em segundo plano. É tão rápido que, se você perguntar sobre a dor de cabeça logo no próximo turno, o registro já estará salvo.
A segunda resposta cuida da memória. Só entra no contexto do próximo turno o que for relevante no seu histórico naquele momento. Como um modelo de voz trabalha com muito menos contexto do que um modelo de texto, é preciso escolher bem o que incluir.
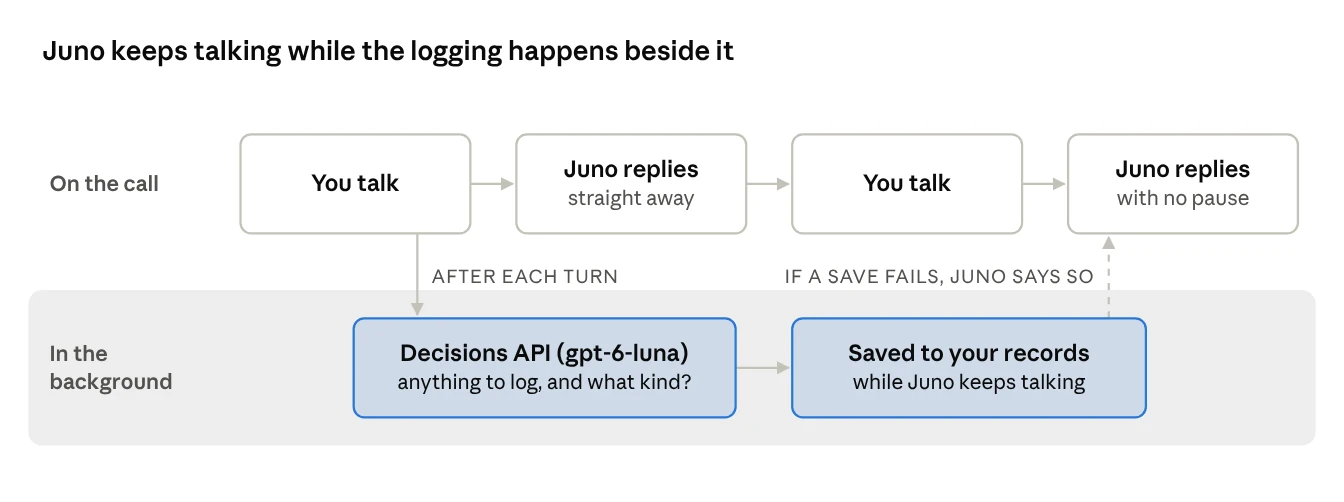
Com isso, reduzimos em 40% os repasses ao agente de texto, e o maior intervalo de silêncio em uma chamada de teste caiu de 9,3 para 3,2 segundos. É a diferença entre uma espera desconfortável e uma pausa natural.
Conversas longas
Conversas longas exigem o mesmo cuidado. Lembre-se da água-viva: o modelo tem pouco senso de direção e precisa de orientação. Um agente atualiza o contexto da chamada para que, no turno 100, a Juno ainda saiba o que foi dito no primeiro turno e que assunto puxar se a conversa perder o ritmo. Se você quer sustentar conversas longas, precisa implementar esse mecanismo. E essas conversas importam: é nelas que aparecem os padrões e as tendências que ajudam as pessoas a entender a própria saúde.
Como encontramos a voz da Juno em testes com ouvintes
Outro desafio é criar uma voz que soe perfeita. É mais fácil falar do que fazer. A voz que o GPT-Live oferece de fábrica já representa um enorme avanço em relação aos modelos anteriores, mas as pessoas ainda dizem que a voz parece de IA. Será que dá para criar uma voz que agrade a nove em cada dez pessoas?
Em um grupo de discussão, pessoas que vivem com doenças crônicas nos disseram que nossa voz falava um pouco devagar demais e soava um tanto condescendente. Levamos esse comentário a sério e fizemos um estudo para melhorá-la.
Com o recurso de geração de voz por prompt do GPT-Live, criamos novas vozes a partir de descrições curtas e as comparamos com a voz atual em um teste com 290 adultos nos Estados Unidos que vivem com condições crônicas. Todos ouviram as mesmas três frases, deram uma nota a cada voz e escolheram a favorita, a de que menos gostaram e a que gostariam de ouvir em um dia de exaustão.
Ao longo de cinco pequenas rodadas, mantivemos as melhores vozes e reescrevemos as descrições das demais. Em seguida, 171 novos participantes compararam a voz atual com as duas melhores vozes novas.
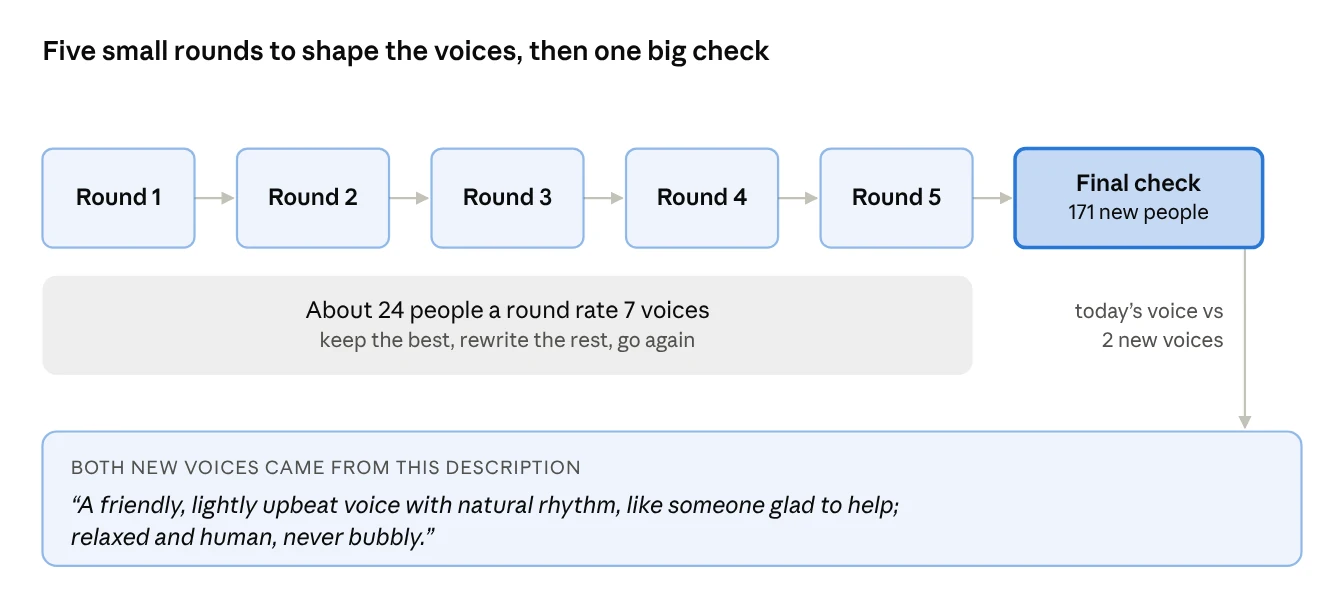
A vencedora foi uma nova voz criada a partir da descrição no diagrama acima. Na avaliação final, mais pessoas a escolheram como favorita do que a voz atual. Menos pessoas a apontaram como a voz de que menos gostaram, e um número bem menor disse que faltava acolhimento à nova voz.
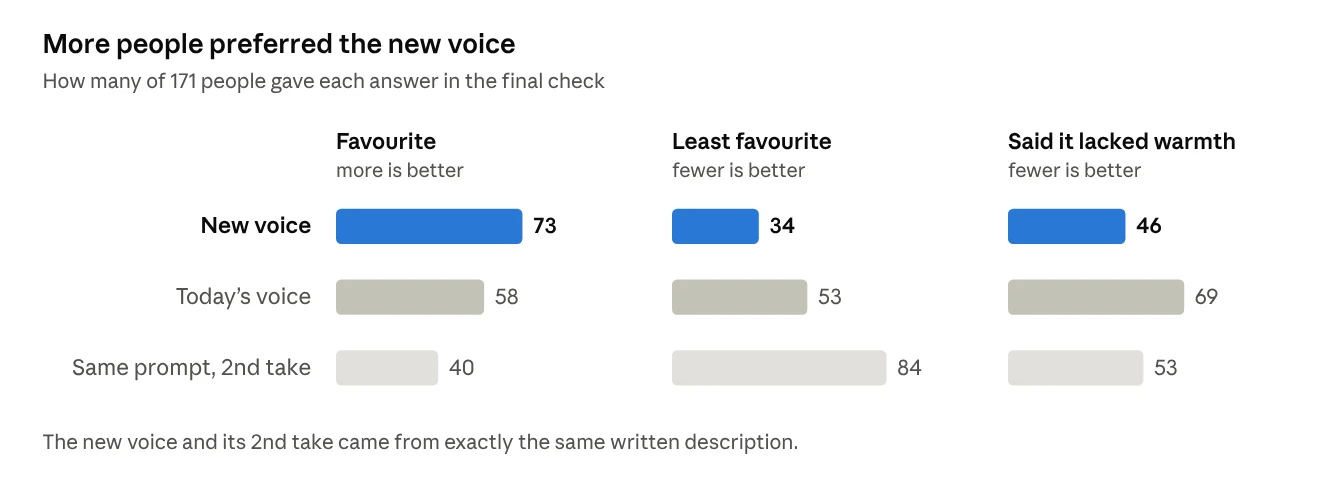
O estudo tem limitações. Os participantes ouviram apenas três frases, as notas foram próximas e ouvir frases em um estudo é diferente de participar de uma chamada real. Nosso próximo passo é testar a nova voz em chamadas reais com pessoas que ligam pela primeira vez e verificar se mais gente volta no dia seguinte.
Qual voz você gostaria de ouvir em um dia de exaustão?
Também perguntamos aos participantes que voz gostariam de ouvir em um dia de exaustão. Nesse caso, a voz atual ficou um pouco à frente da nova. A diferença é pequena, mas levanta uma questão maior: por que estamos tão empenhados em encontrar uma única voz perfeita?

Nossa própria voz varia. Mudamos o tom, o ritmo e o volume conforme a situação. E se a voz da Juno se adaptasse a como você está se sentindo? As pessoas confiam mais em uma voz quando ela acompanha a velocidade e o volume de sua fala (Levitan et al., 2016), e o GPT-Live já nos permite mudar a maneira como a Juno fala durante uma chamada. É isso que vamos testar no próximo estudo. Você pode ouvir todas as vozes e consultar os resultados completos em junocompanion.com/voice-study.
Tem sido incrível ver o que a interação por voz tornou possível para quem vive com uma doença crônica e o quanto facilitou o dia a dia dessas pessoas. O GPT-Live é um ótimo modelo de base, e pequenos ajustes fazem uma diferença concreta.
Sobre o autor e a empresa
Sou Marshall Gould, fundador da Juno. Desenvolvi a voz da Juno ao lado de três pesquisadores: Isaac Tolley, Sean Lees e Dawid Wraga. A Juno é uma empresa de IA que tem como missão ajudar as pessoas a cuidar da saúde e a conviver com doenças crônicas. Temos orgulho de que a maioria das pessoas da nossa equipe também vive com uma doença crônica. Hoje, centenas de milhares de pessoas usam a Juno, e adoraríamos contar com a sua ajuda para levar essa missão adiante. Saiba mais em junocompanion.com.
Picsart: como mantemos a conversa por voz em sincronia com as tarefas do agente
Por Dmitry Ivanov, Senior Staff Engineer na Picsart
O que queríamos criar
Um trabalho criativo pode durar mais do que uma chamada. Queríamos que as pessoas pudessem conversar naturalmente com os agentes de IA da Picsart enquanto uma tarefa estivesse em execução, ou sair da chamada e voltar quando os resultados estivessem prontos. As ideias nem sempre nascem prontas: pode ser mais fácil conversar sobre o clima de uma criação ou um rumo possível do que escrever um pedido preciso.
O GPT-Live foi a primeira tecnologia que nos permitiu concretizar essa ideia. A naturalidade da conversa ao vivo permitiu usar a voz para desenvolver ideias em conjunto, indo além de simplesmente ditar comandos. Isso nos deu a base para levar essa experiência de conversa aos agentes de IA da Picsart.
Por isso, criamos uma interface de voz independente para interagir com o agente, mantendo a mesma conversa do chat por texto. Escolhemos o GPT-Live para conduzir a conversa ao vivo. Nossa camada de inteligência cuida do raciocínio, das ferramentas, dos planos e do contexto salvo.
Nossa solução foi separar a conversa da execução das tarefas

Como mostra o diagrama, o aplicativo envia tarefas à camada de inteligência e devolve contexto e respostas ao GPT-Live. Para enviar tarefas e receber atualizações de progresso e resultados, o aplicativo usa uma conexão WebSocket compartilhada. A voz e o texto usam o mesmo agente, o mesmo processo de execução de tarefas e as mesmas regras de aprovação.
Nosso gateway de voz configura a sessão com as instruções do agente selecionado. O áudio ao vivo trafega diretamente entre o navegador e a OpenAI via WebRTC. Uma tarefa enviada pode continuar em execução depois que a chamada termina.
Como enviamos uma solicitação ao agente
Quando o GPT-Live pede ao agente principal que faça algo, enviamos o pedido feito por voz, as mensagens recentes e os anexos ao agente e à conversa em uso, com a indicação de modo voz. Salvamos esse contexto no momento do envio para que uma fala posterior não sobrescreva um pedido que já esteja na fila.
Pedimos ao agente principal que escreva para quem vai ouvir: dê respostas curtas e naturais, faça uma pergunta por vez e evite repetir o que a interface de voz já confirmou. Deixe claro qual é o trabalho, quanto custa e o que precisa de aprovação.
O que a interface de voz sabe e o que ela diz
Enviamos três tipos de informação à interface de voz:
| Canal | O que enviamos e como a interface de voz usa essas informações |
|---|---|
| instructions | Identidade do agente, regras que definem quando pedir ao agente que execute tarefas e regras da conversa |
| thinking | Mensagens recentes, estado das tarefas, dados selecionados das ferramentas e ações do usuário que servem de contexto sem serem lidos em voz alta |
| commentary | Respostas, perguntas e atualizações importantes sobre as tarefas para comunicar em voz alta |
O canal thinking transmite contexto do aplicativo. O raciocínio privado do agente principal fica fora dele. Antes de encaminhar os resultados selecionados das ferramentas, removemos os campos que costumam conter credenciais e os dados binários, limitamos o tamanho dos resultados e sinalizamos os que estão incompletos.
Quando uma ação na tela envia uma solicitação ao agente, avisamos a interface de voz pelo canal thinking. Assim, ela pode confirmar a ação sem voltar a perguntar nem reenviar o pedido.
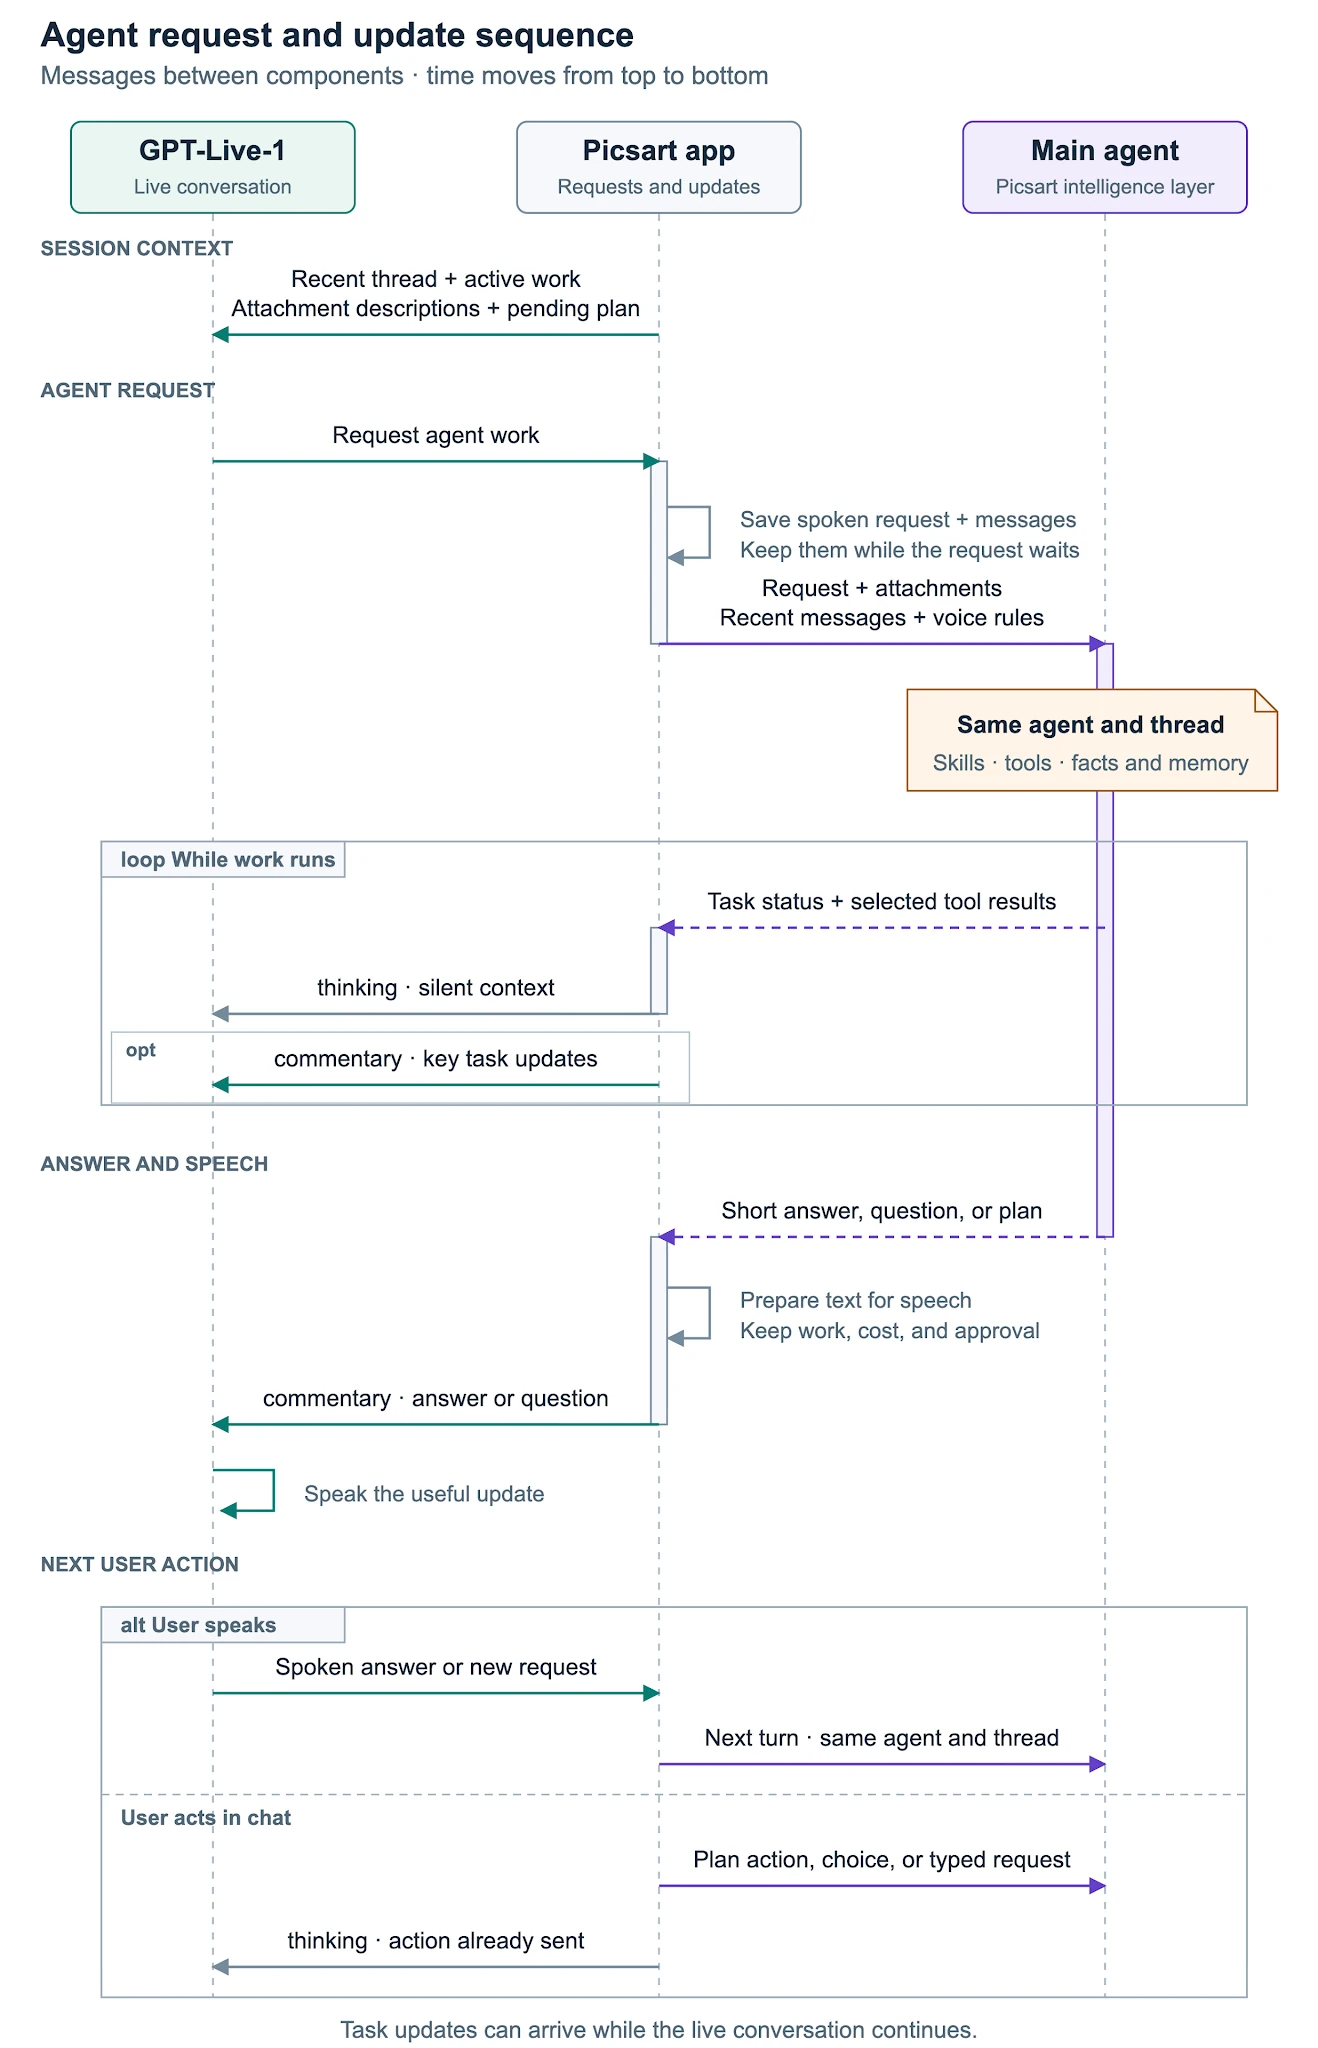
As etapas rotineiras das ferramentas ocorrem em silêncio. Quando começa a execução de um plano ou termina uma tarefa, a interface de voz avisa. Agrupamos em frases os trechos da resposta que chegam por streaming e esperamos uma pausa antes de enviá-los à interface de voz. Quando chega a resposta final, evitamos repetir o texto que já enviamos, mas ainda repassamos correções e pedidos de aprovação.
O que levamos para a chamada e o que fica salvo
As instruções da sessão definem o papel do agente. A memória sobre o usuário tem outra origem. No início de uma chamada, carregamos as mensagens recentes, as descrições dos anexos, as tarefas ativas e as aprovações pendentes para que a interface de voz possa retomar a conversa de onde o usuário parou.
A memória de longo prazo fica com o agente principal. Quando a memória está ativada, o agente pode usar o histórico da conversa, resumos, fatos salvos e preferências do usuário ou do projeto.
Se o usuário disser “Use o estilo que salvamos”, o agente principal pode buscar o estilo ou fazer uma pergunta para esclarecer o pedido e depois devolver a resposta à interface de voz. Se a memória estiver indisponível, a chamada pode continuar com menos contexto.
O histórico da conversa guarda as solicitações ao agente e as mensagens anexadas a elas. Nem toda troca de falas fica registrada. Uma preferência mencionada de passagem só fica salva se o agente principal a receber e a salvar.
Quando o trabalho começa, continua ou é interrompido
Apresentamos um plano em voz alta depois que o agente o explica. Só dizemos que o trabalho está em andamento quando o agente confirma que já começou. Apresentamos juntos o trabalho proposto, seu custo e o pedido de aprovação. Contexto adicional não dá permissão para executar outras tarefas nem gastar mais.
Se perdermos uma atualização, recuperamos o estado da tarefa existente, sem reiniciá-la nem repetir resultados ou pedidos de aprovação.
Interromper a fala ou sair da chamada não cancela o trabalho. Para interromper uma tarefa, é preciso fazer um pedido separado, e as ações já em andamento podem continuar. Novos pedidos mantêm o contexto original e aguardam o fim do turno atual, sem alterar o trabalho em execução.
O que aprendemos: a interface de voz pode saber mais do que precisa dizer
Nossa integração nos ensinou a:
- Preparar as respostas para voz no agente principal.
- Salvar o contexto de cada solicitação no momento do envio.
- Usar a mesma conversa e as mesmas regras nas interações por voz, por texto e na tela.
- Manter a conversa separada da execução da tarefa.
Sobre a Picsart
A Picsart é uma plataforma de produção e distribuição de mídia com IA em que mais de 100 milhões de criadores e empresas do mundo todo produzem, divulgam e monetizam conteúdo.
Há mais de 14 anos, a Picsart ajuda uma nova geração de contadores de histórias a criar conteúdo em vídeo, ampliar sua produção e, agora, monetizá-lo. Com ferramentas intuitivas de design, criação de imagens e vídeos com IA e funções de MCP e CLI, a Picsart acompanha os criadores onde quer que trabalhem. Com mais de 100 milhões de usuários ativos por mês e mais de 2,5 bilhões de downloads até hoje, a Picsart impulsiona uma nova fase em que as pessoas podem criar com autonomia e em grande escala, usando o conteúdo para expressar sua identidade, ampliar sua influência e empreender.
Treater: como ajustamos os agentes de voz para melhorar os resultados das chamadas
Por Britt O’Daly, cofundador e CEO, Ayaz Hafiz, cofundador e CTO, e Sayd Agzamkhodjaev, desenvolvedor de software
Como as conversas se traduzem em resultados
Em uma ligação para uma agência de recrutamento, nosso agente de voz conversou com um dos proprietários sobre as dificuldades da equipe com o software de agendamento.
Enquanto o proprietário explicava por que a solução anterior não tinha funcionado, o agente interrompia a todo momento com um “Aham” ou um “Certo, certo”. Até que o proprietário encerrou o assunto:
Olha, é melhor você me mandar um e-mail.
O agente entendeu o que o proprietário dizia, mas as interrupções tornaram a conversa desagradável. Um profissional de vendas aprenderia com essa interação e mudaria sua abordagem nas próximas conversas. Queríamos que nossos agentes fizessem o mesmo.
Na Treater, criamos agentes de IA que ajudam as empresas a entrar em contato e trabalhar com seus parceiros por telefone, e-mail e SMS. Queremos que nossos agentes alcancem os objetivos dos clientes oferecendo uma experiência de conversa excepcional. Criamos um sistema de aprendizado que avalia conversas reais, identifica oportunidades de melhoria e testa novas configurações de agente com base nos resultados que os clientes querem alcançar.
Nesta demonstração, nosso agente coordena várias pessoas para repor um produto que acabou em um supermercado.
Agentes que aprendem na prática
Antes do GPT-Live, passávamos boa parte do tempo desenvolvendo e mantendo uma infraestrutura de voz sob medida. Depois que o adotamos, substituímos quase tudo por prompts simples e conseguimos um desempenho melhor. Conversas mais longas estão associadas a melhores resultados para nossos clientes. Desde que adotamos o GPT-Live, vimos a duração mediana das conversas aumentar entre 26% e 30%, com aumentos de até 40% no percentil 90.
A taxa de cumprimento dos objetivos que importam para nossos clientes subiu, em média, 6 pontos percentuais.
Assim, podemos dedicar mais tempo ao que “melhora o sabor da nossa cerveja”: aprender e nos adaptar em um ambiente de trabalho que muda constantemente. Assim como as pessoas evoluem em suas funções, queremos que nossos agentes aprendam, na prática, o que significa fazer um ótimo trabalho.
Para melhorar nossos agentes, testamos combinações de vários aspectos da configuração de cada um (voz, prompt, cadência e ferramentas disponíveis). Pontuamos cada conversa segundo critérios definidos por nós (sentimento, etapas realizadas) e pelo cliente (preferências respeitadas, grau de cumprimento do objetivo). Usamos um algoritmo de bandido de múltiplos braços para direcionar mais tráfego às configurações com boas pontuações e descartar rapidamente as de pior desempenho.
Fora de produção, um sistema de revisão lê as transcrições de chamadas anteriores e propõe novas configurações. Simulamos cada proposta com conversas passadas e estimamos a recompensa em produção para descartar mudanças que não trariam ganhos relevantes. Enviamos as mudanças aos clientes para revisão ou as colocamos em produção automaticamente, se eles preferirem.
Com o GPT-Live, muitos desses ajustes se tornaram triviais. O tom, a cadência, a decisão de acompanhar a energia da outra pessoa, o grau de formalidade e a frequência das interjeições para mostrar que o agente está ouvindo: antes, cada ajuste exigia coordenar vários componentes da infraestrutura de voz. Hoje, para a maioria deles, basta uma linha em um prompt, o que facilita a comparação entre versões.
Demonstração: afinal, o que nosso agente aprendeu com a ligação para o proprietário da agência de recrutamento?
Abrir a simulação em página inteira.
Esta demonstração é uma versão anonimizada e simplificada da campanha descrita na introdução. Uma empresa começa com um agente em sua configuração inicial para agendar demonstrações com agências de recrutamento.
- Nosso sistema identificou uma oportunidade. Na revisão offline, o sistema analisou as chamadas com baixa recompensa e encontrou alguns padrões. Em 20% das chamadas, por exemplo, o agente falava por cima dos proprietários para sinalizar que estava ouvindo. O sistema propôs quatro novas configurações.
- O sistema propôs melhorias. Simulamos cada proposta com chamadas anteriores e atribuímos uma recompensa segundo os mesmos critérios usados em produção. A variante que falava mais devagar teve uma pontuação baixa e foi descartada imediatamente. As demais passaram por revisão e foram aprovadas.
- Avaliamos as versões em produção. A recompensa esperada determina a parcela do tráfego que cada versão recebe. Em um dia, a versão B já atende à maioria das chamadas. A versão C não consegue alcançá-la e é desativada no dia 3. A versão D, adicionada no dia 2, assume a liderança no início do dia 3 e termina com cerca de 90% das chamadas. As versões A e B mantêm uma pequena parcela do tráfego para o caso de as condições mudarem. O número de demonstrações agendadas a cada 100 chamadas sobe de 3,0 para 4,3.
O sistema tem uma estrutura hierárquica. Melhorias nos nossos harnesses compartilhados beneficiam todos os casos de uso, e o que aprendemos em um fluxo de trabalho se torna o ponto de partida para outros semelhantes.
Lições que levamos conosco
- Tudo é uma hipótese! Um dos exemplos mais claros veio de um cliente que queria que o agente abrisse a conversa falando de uma promoção que estava por vir. As chamadas que começavam mencionando o aumento recente da proporção do estoque vendido tiveram resultados muito melhores.
- Atribua recompensas com base em resultados que ofereçam sinais claros e façam diferença para o cliente. Quando a recompensa demora a ser avaliada (por exemplo, fechar um novo negócio), invista em resultados que possam ser medidos rapidamente (por exemplo, agendar a próxima reunião), mas confirme que há de fato uma relação entre eles.
- Invista em meios de observar e medir o que acontece no ambiente em que seus agentes atuam. Para que as simulações e os benchmarks façam sentido, precisam refletir com precisão a distribuição das situações reais.
- Com o GPT-Live, experimente descrever o que você espera, em vez de prescrever cada fala. Os agentes com GPT-Live conseguem se adaptar ao contexto e seguir orientações gerais sem precisar de um roteiro completo.
Com o GPT-Live, continuamos dando saltos na qualidade das conversas. Estamos animados para descobrir o que nos espera nos próximos dez degraus!
Sobre a Treater
A Treater conversa com pessoas no mundo real para alcançar os objetivos da sua empresa e trata cada oportunidade como se fosse a maior de todas. Nossa plataforma realiza centenas de milhares de chamadas com milhares de agentes distintos. No último ano, o volume de chamadas cresceu 25% ao mês. Entre nossos clientes estão empresas de capital aberto e startups em rápido crescimento. Saiba mais em trytreater.com.
Weekend: como dois personagens com GPT-Live dividem uma cena em Wit’s End
Por Kevin Shen, engenheiro de software sênior, e James Wilsterman, cofundador e CTO da Weekend
O que queríamos criar
Nosso jogo, Wit’s End, é um RPG de mesa de fantasia feito para jogar por voz. O mestre do jogo é Sir Bart, uma IA que conta a história e aplica as regras. Para os jogadores, basta falar. Com o áudio full-duplex do GPT-Live, dá a sensação de estar em uma mesa de verdade: os jogadores interrompem, brincam e discutem, e Sir Bart reage enquanto eles ainda estão falando.
O ponto fraco era o elenco. Cada sessão do GPT-Live usa uma só voz. Por isso, tanto o capitão ríspido no portão da cidade quanto a senhora assustada na taverna tinham a voz do narrador. Queríamos que o personagem principal de cada cena falasse por si, com voz e personalidade próprias, preservando o que faz o jogo funcionar: os jogadores podem dizer qualquer coisa e, mesmo assim, a história chega ao fim.
Veja como uma cena se desenrola hoje. O grupo chega ao portão de Timberfall. Sir Bart apresenta a cena e faz uma pausa: “Um grupo de guardas impassíveis monta guarda enquanto o capitão dá um passo à frente, com a mão na espada, e examina vocês de alto a baixo”. O capitão Dmitri toma a palavra, com voz grave e rouca. Ele está à procura de uma traidora chamada Jade, e o grupo corresponde à descrição dos cúmplices dela. Um jogador discute com ele, e Dmitri rebate. Outro lhe passa discretamente uma moeda de ouro. Sir Bart intervém para avisar que os dados estão rolando, narra o resultado da tentativa de suborno e devolve a palavra a Dmitri, que reage.
Nossa solução: duas vozes e um diretor
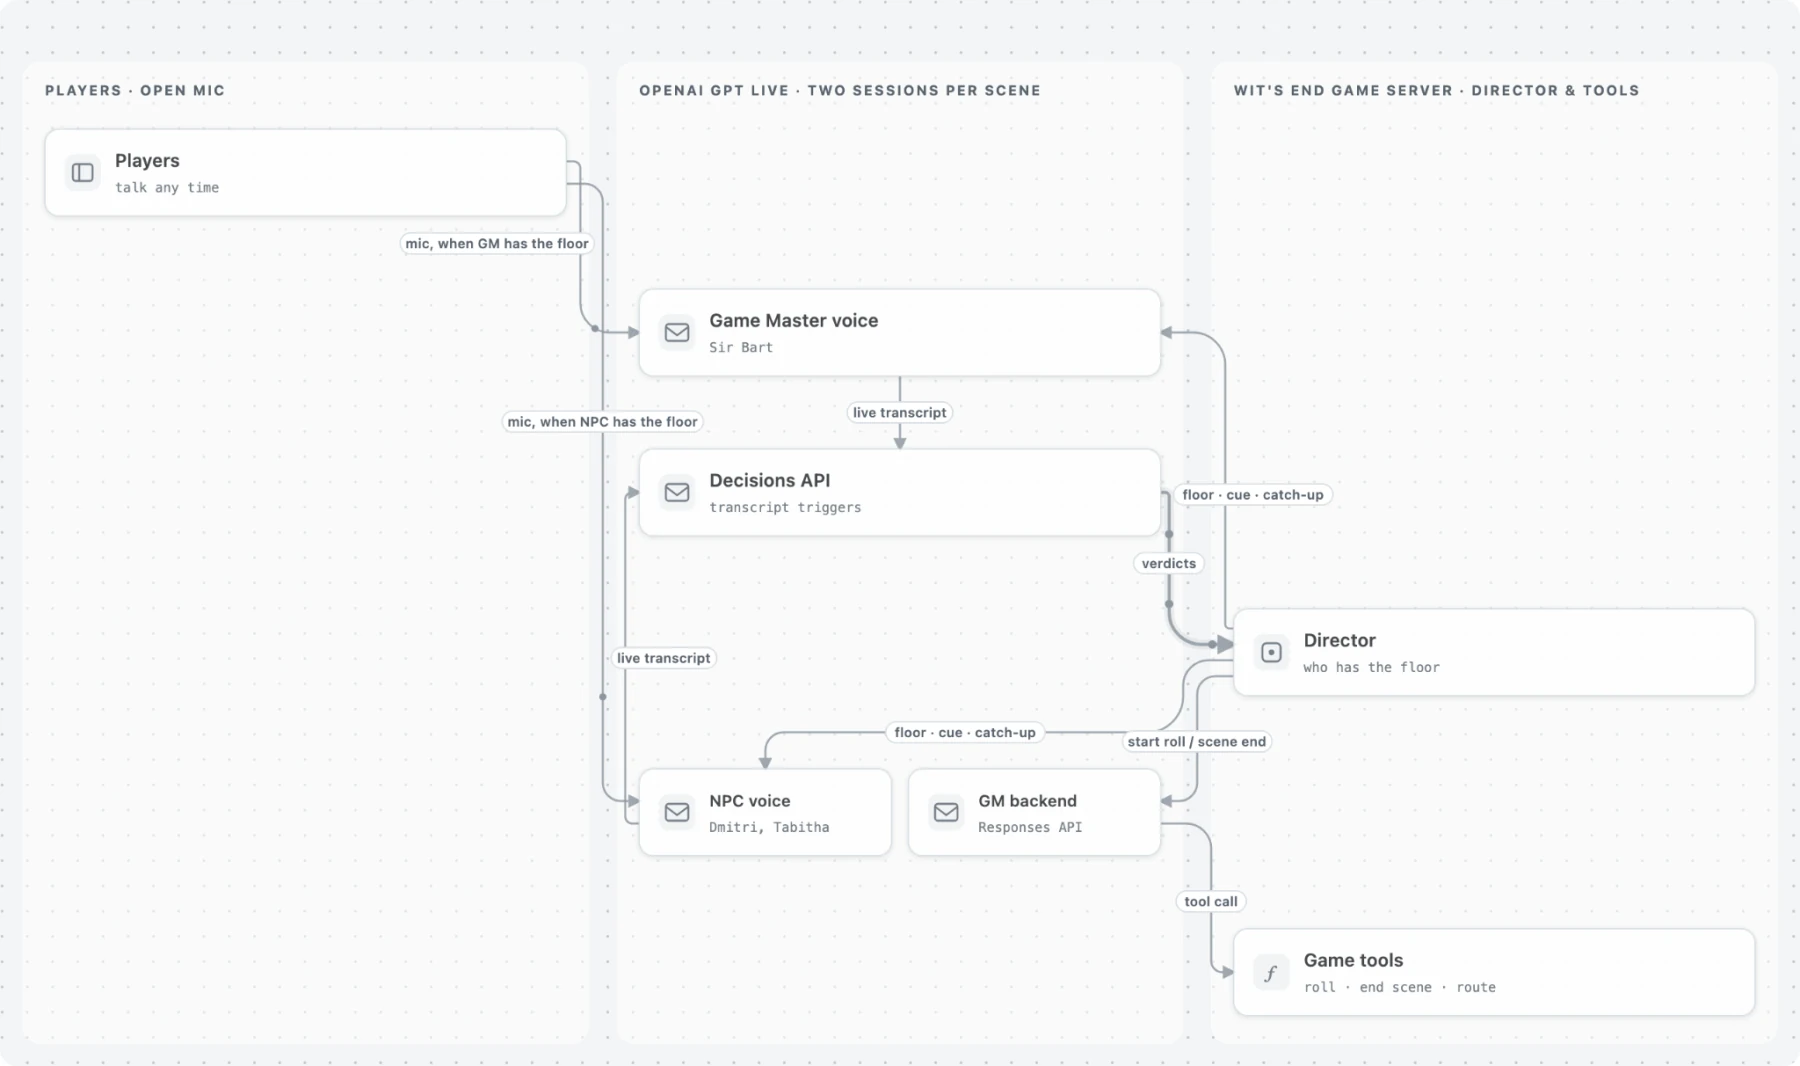
Quem está com a palavra? Com base nas transcrições das duas sessões, a API Decisions indica ao diretor quem deve falar em seguida. O diretor passa a palavra de uma voz para a outra e aciona as rolagens de dados e o encerramento das cenas no backend do mestre do jogo.
Cada cena executa duas sessões do GPT-Live em paralelo: uma para Sir Bart e outra para o personagem da cena (Dmitri no portão, Tabitha na taverna), cada uma com seu próprio prompt e sua voz personalizada. Um diretor, executado no servidor do jogo, decide quem está com a palavra, e só quem está com a palavra ouve os jogadores. Nas duas sessões, os gatilhos da API Decisions que atuam sobre a transcrição informam ao diretor o que está acontecendo na conversa. O backend do mestre do jogo, um modelo da API Responses, é o único componente que chama as ferramentas do jogo para rolar dados, encerrar cenas e definir caminhos.
Duas personalidades, uma história
Para cada personagem, separamos o que é próprio dele do que é compartilhado.
A personalidade de cada um fica no seu próprio prompt.
Cada prompt também descreve a voz do personagem com as mesmas palavras que usamos para criá-la.
Exemplo de uma cena compartilhada
A cena é compartilhada. Sir Bart e o personagem recebem o mesmo conflito, o mesmo desfecho e a mesma sequência de momentos da narrativa, cada um com a indicação de quem deve falar. Dmitri se apresenta e diz quem está procurando. Tabitha conta ao grupo onde Jade vai encontrá-los. O jogo só encerra a cena depois que a voz responsável por cada momento diz sua parte.
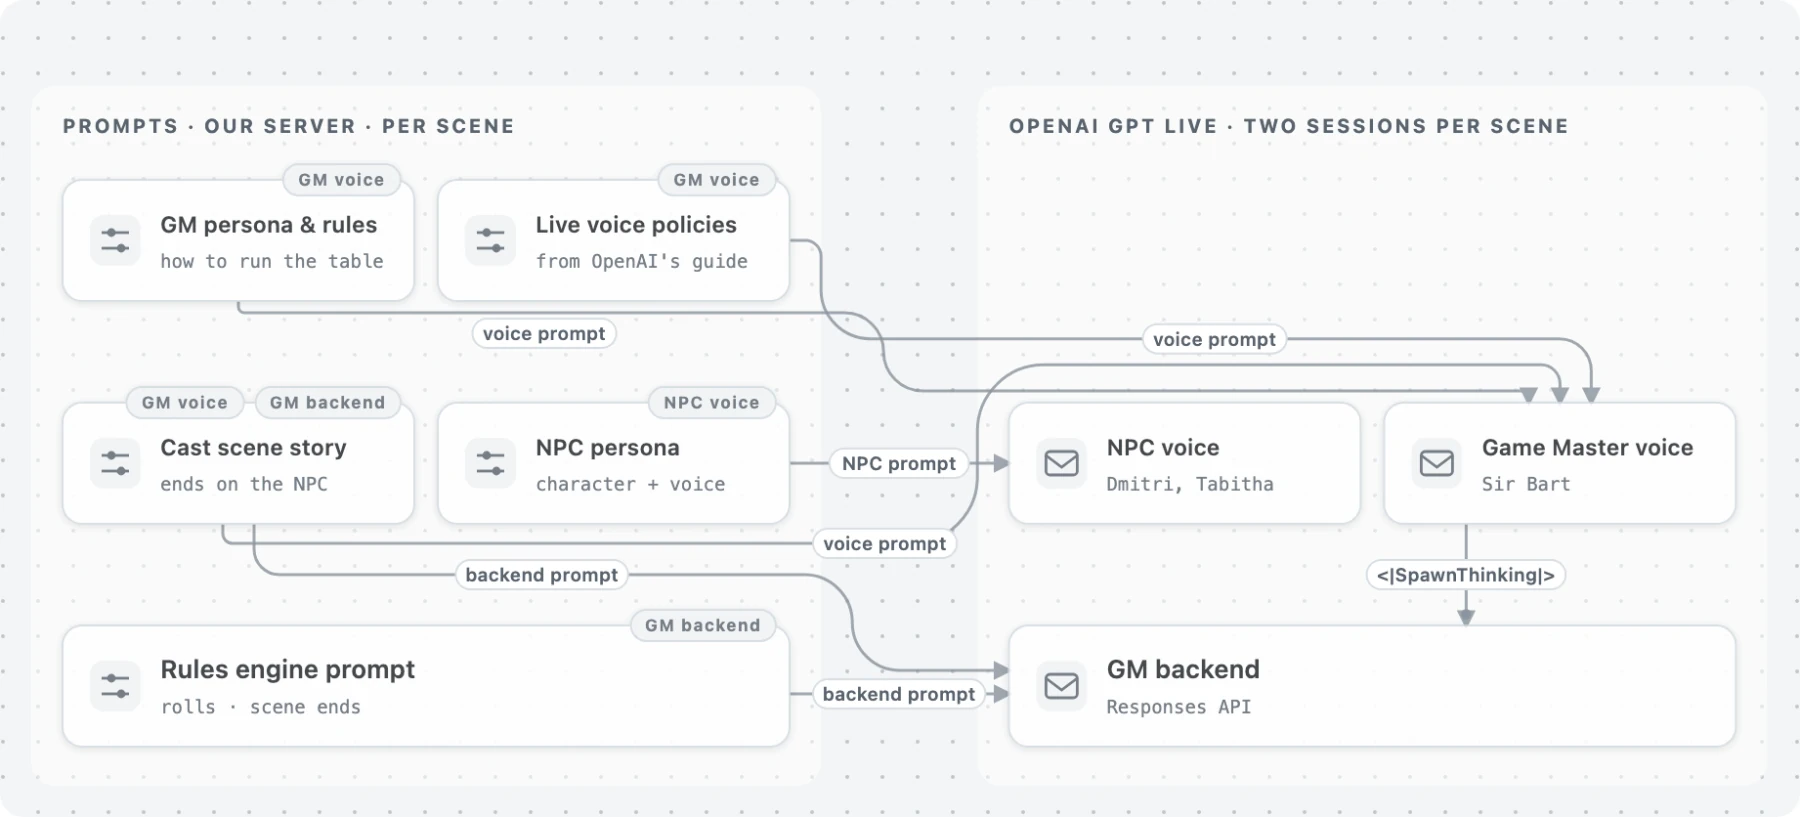
Estrutura dos prompts. A voz e o backend de Sir Bart recebem a mesma história da cena. O personagem recebe um prompt próprio que define sua personalidade.
Trecho do prompt do personagem
Você interpreta um personagem em uma cena falada ao vivo.
O narrador descreve o mundo. Você só fala em voz alta,
em primeira pessoa e no papel do seu personagem.
- Nunca narre, nunca descreva suas próprias ações ou sua voz
  e nunca fale em nome dos viajantes nem do narrador.
- Nunca decida se uma tentativa arriscada dá certo.
  Reaja com uma frase curta e pare. O narrador decide o desfecho.
- Só fale quando um viajante se dirigir a você ou quando
  você receber a palavra.
Como o diretor escolhe quem fala em seguida
O diretor não gera fala. À medida que recebe trechos da transcrição, ele usa os resultados da API Decisions para identificar a quem o jogador se dirige, se uma ação exige uma rolagem de dados e quando a narração ou a última fala de um personagem indica que é hora de passar a palavra.

Os resultados mudam enquanto o jogador fala. Para identificar a quem a fala se dirige, o diretor espera o resultado definitivo no fim do turno. Já as ações arriscadas são encaminhadas ao mestre do jogo assim que o diretor as reconhece.
Quem fala em seguida
| Quando | Quem fala em seguida |
|---|---|
| Sir Bart termina de narrar e a pontuação que sinaliza a passagem da palavra é de pelo menos 0,6, ou sua fala termina indicando que alguém vai dizer algo (“Tabitha calls after you”) | O personagem |
| Um jogador se dirige ao personagem enquanto Sir Bart está com a palavra | O personagem, que recebe a fala à qual deve responder |
| Um jogador tenta algo arriscado, como oferecer um suborno, mentir, passar despercebido ou entrar em uma briga | Sir Bart, imediatamente, mesmo no meio de uma frase, se necessário. O diretor aciona a rolagem no backend de Sir Bart, que narra o resultado e devolve a palavra ao personagem |
| Um jogador faz uma pergunta ao narrador ou descreve o que seu personagem faz | Sir Bart |
| Os jogadores conversam entre si | Ninguém. Quem estiver com a palavra recebe um aviso válido apenas para aquela ocasião, orientando a deixar os jogadores conversarem |
| O próprio personagem diz algo que encerra sua participação (“Sigam em frente, então. E não chamem atenção.”) | Sir Bart, assim que o personagem termina de falar. O diretor aciona o encerramento da cena no backend de Sir Bart |
| Quem recebeu a palavra fica em silêncio por 2,5 s | A mesma voz recebe um novo sinal para falar |
Como passamos a palavra
A passagem da palavra envolve quatro ações:
- Silenciamos a sessão que perde a palavra, mandamos que ela pare e descartamos todo o áudio que estiver na fila.
- Atualizamos a sessão que recebe a palavra sobre o que ela perdeu, enviando contexto silencioso com
session.thinking.append. As mesmas falas vão para o contexto da API Decisions dessa sessão, para que os gatilhos usem o mesmo histórico nas avaliações. - Reativamos o áudio da sessão que recebeu a palavra e damos o sinal para que ela fale.
- Mantemos os microfones dos jogadores bloqueados até que se ouça a primeira frase da nova voz, por no máximo 8 s. Assim, os jogadores não falam por cima da transição.
Como a sessão do personagem já está em execução, o primeiro áudio chega, em média, 0,84 s após a passagem da palavra. Com uma sessão nova, são 1,54 s.
Como conduzimos o jogo até o desfecho
As vozes improvisam. O aplicativo decide quando algo acontece.
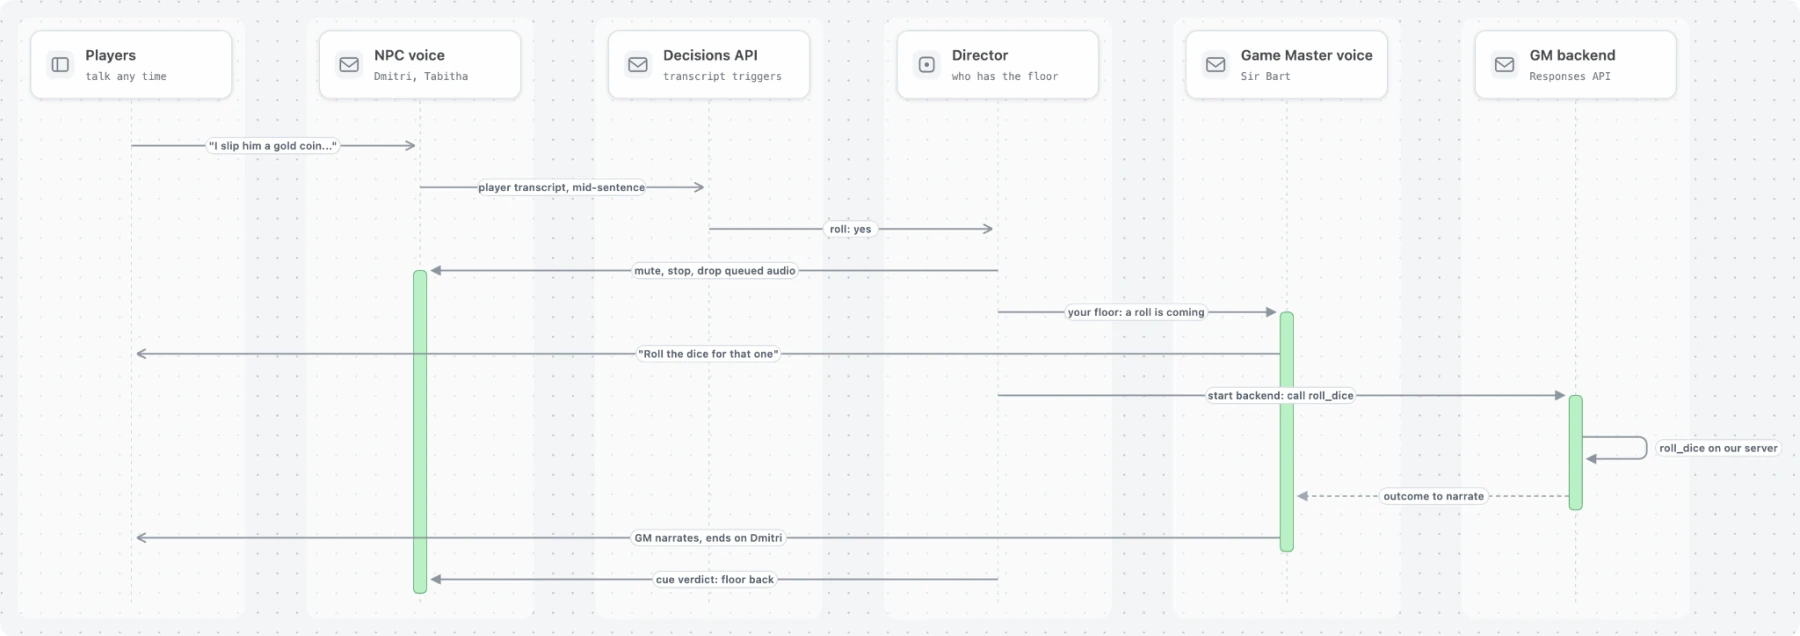
Uma tentativa de suborno enquanto Dmitri está com a palavra. A decisão de rolar os dados chega no meio da frase. O diretor passa a palavra a Sir Bart e aciona a rolagem no backend dele. Depois que Sir Bart narra o resultado, um novo sinal devolve a palavra a Dmitri.
- O próprio diretor aciona as rolagens de dados e o encerramento das cenas. Em um teste do jogo, Sir Bart disse “You’re going to have to roll the dice for that one”, mas não acionou seu backend. Os dados não rolaram, e ele inventou o resultado. Agora o diretor inicia uma resposta diretamente no backend de Sir Bart. Enquanto o backend trabalha, a voz diz uma frase curta e depois narra o resultado.
- Os dados definem o desfecho de cada cena. A cena 1 termina quando a rolagem é bem-sucedida. Se Dmitri ceder antes que os dados tenham rolado, o diretor submete a tentativa dos jogadores a uma rolagem em vez de encerrar a cena.
- Um personagem pode encerrar sua participação, e o mestre do jogo fecha a cena. Quando Tabitha diz ao grupo que Jade vai encontrá-los no Altar dos Espíritos, o diretor passa a palavra a Sir Bart. O backend dele marca a cena como concluída, e ele apresenta os dois caminhos para seguir adiante.
O que aprendemos
- Apenas uma sessão deve ouvir os jogadores. Quando as duas ouviam, ambas respondiam a todas as falas do teste e muitas vezes se contradiziam: Dmitri recusava o suborno enquanto o mestre do jogo narrava que ele embolsava a moeda.
- Só desativar o áudio de uma sessão não basta para fazê-la parar de falar. Mande a sessão parar e descarte o áudio na fila. Quando ela receber a palavra de volta, revogue explicitamente a instrução “fique em silêncio”. Em um teste, o mestre do jogo passou uma cena inteira sem responder a ninguém porque essa instrução ainda valia.
- Mantenha todas as sessões de voz prontas para falar. A voz de uma sessão é definida no início, por isso cada voz precisa de uma sessão própria. Iniciar a sessão do personagem junto com a cena economiza cerca de 0,7 s a cada passagem da palavra, o suficiente para evitar uma pausa desconfortável.
- Aja no momento certo para cada tipo de decisão. Os resultados começam a chegar enquanto o jogador ainda fala. O tempo mediano entre o fim da fala e a chegada do último resultado é de 0,19 s. Envie uma ação arriscada ao mestre do jogo assim que ela for reconhecida. Para decidir a quem uma fala se destina, espere o turno terminar e o resultado se estabilizar.
- Formule perguntas de sim ou não como predicados, defina os limiares com base em falas reais e mantenha uma regra simples como alternativa. A pergunta “Should Dmitri speak next?” teve 11 acertos em 12 como predicado e 8 em 12 como escolha entre duas opções. Com um limiar de 0,4, a frase “You’re going to have to roll the dice for that one” foi interpretada como sinal para passar a palavra a Dmitri no meio da rolagem. Como os sinais verdadeiros tiveram pontuação de 0,94 ou mais, usamos 0,6. Já a frase “Tabitha calls after you” recebeu 0,04. Por isso, também verificamos a presença de um verbo de fala para reconhecer quando a narração termina no ponto em que o personagem deve falar.
- Atribua cada resultado a um único responsável. Só o backend do mestre do jogo chama ferramentas, e cabe ao aplicativo iniciar as rolagens e encerrar as cenas. Assim, cada personagem pode improvisar livremente sem mudar as regras do jogo.
Sobre os autores e a empresa
A equipe da Weekend desenvolve Wit’s End, um RPG de mesa de fantasia feito para jogar por voz. Um mestre do jogo de IA conduz a história, e os jogadores participam falando, no navegador ou na TV. Jogue em witsend.ai.
A Weekend, antes conhecida como Volley, cria jogos de TV controlados por voz para que as famílias possam aproveitar o tempo em frente à tela para jogar juntas, em voz alta. Seus mais de 25 jogos, entre eles Jeopardy!, Wheel of Fortune, Song Quiz e Wit’s End, estão disponíveis no Roku, no Fire TV e em TVs Samsung e LG. Já foram jogados em mais de 30 milhões de lares. A Weekend tem o apoio da M12, da Microsoft, da Lightspeed Venture Partners e da Y Combinator.
Os próximos passos para os agentes de voz
O próximo passo para a voz vai além de melhorar a conversa. É criar software que continue ouvindo enquanto o trabalho acontece, leve o contexto de uma interface para outra e coordene várias vozes sem perder o fio da conversa. A capacidade do GPT-Live de ouvir e falar ao mesmo tempo dá aos desenvolvedores uma base para criar experiências que acompanham o ritmo da conversa, sem obrigar as pessoas a esperar sua vez de falar.
Essas quatro histórias mostram o que isso exige na prática. A Juno testa vozes com quem as usa, a Picsart mantém a conversa em sincronia com o trabalho em segundo plano, a Treater aprende com chamadas reais e a Weekend dá voz própria a cada personagem sem perder o controle do jogo.
Com o GPT-Live, as pessoas ganham uma forma intuitiva de interagir com o software, e os agentes ganham novas possibilidades de atuação. Dá para desenvolver uma ideia criativa enquanto se fala, orientar um trabalho em andamento ou entrar em uma história e influenciar o que acontece em seguida. Esses projetos são apenas o começo do que os desenvolvedores podem criar quando a conversa passa a fazer parte do funcionamento do software.
Comece a criar sua própria experiência com o guia de primeiros passos com o GPT-Live e a documentação sobre delegação e ferramentas.