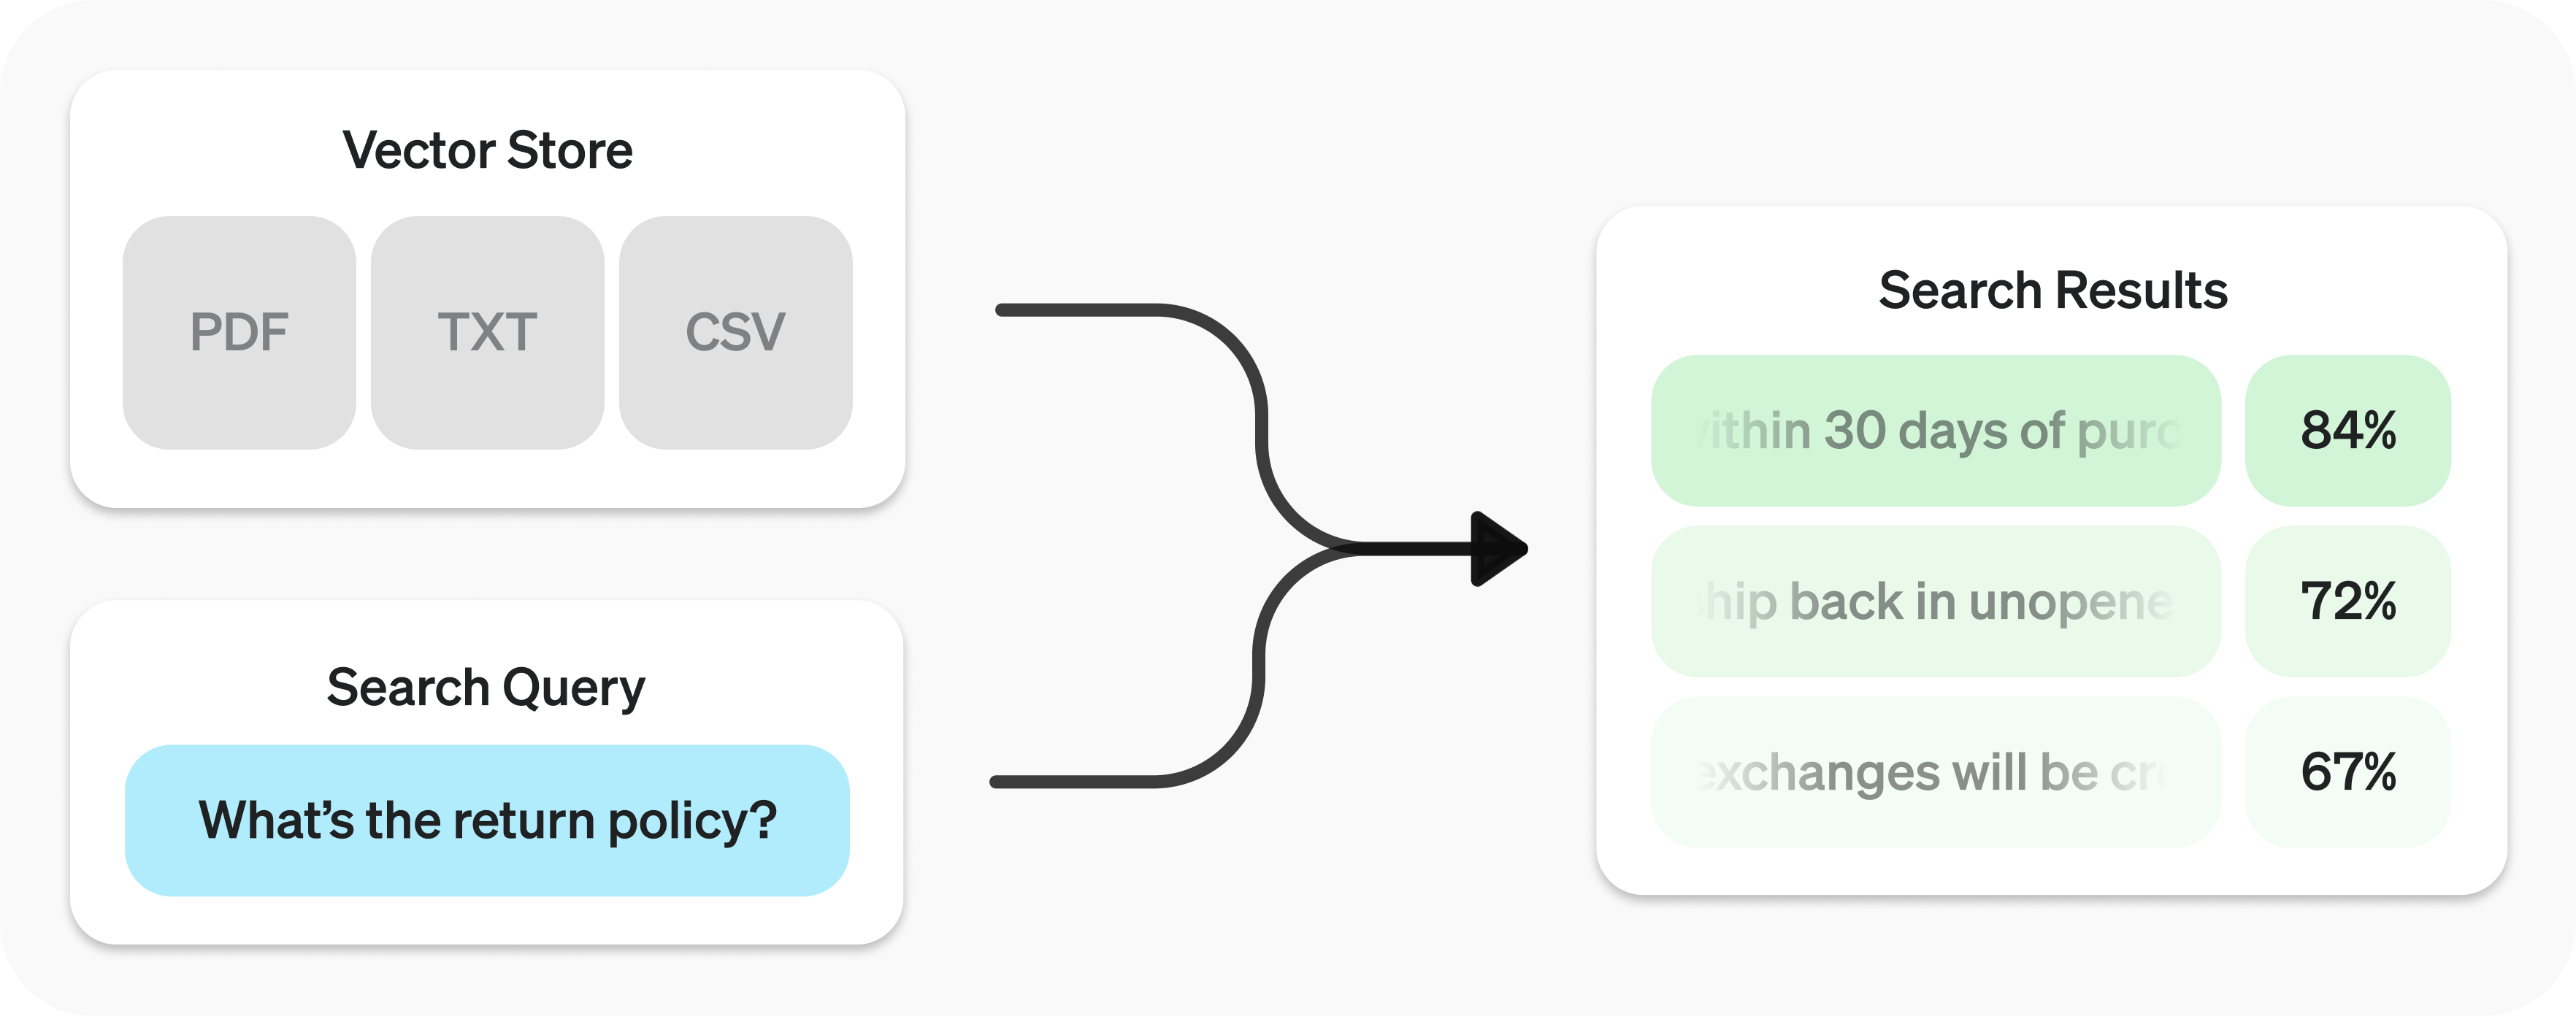
Com a API de recuperação de informações, você pode usar a busca semântica para pesquisar seus dados. Essa técnica encontra resultados com significado semelhante ao da consulta, mesmo quando há poucas ou nenhuma palavra-chave em comum. A recuperação de informações já é útil por si só e se torna especialmente eficaz quando você usa nossos modelos para sintetizar respostas.
A API de recuperação de informações usa repositórios vetoriais como índices para seus dados. Neste guia, você verá como fazer uma busca semântica e conhecerá em detalhe o funcionamento dos repositórios vetoriais.
1
2
3
4
5require "openai"client = OpenAI::Client.newresults = client.vector_stores.search("vs_123", query: "What is the return policy?")puts(results.data&.first&.content)
Para saber como usar os resultados com nossos modelos, consulte a seção Síntese de respostas.
Busca semântica
A busca semântica usa representações vetoriais (embeddings) para encontrar resultados relevantes pelo significado. Assim, ela consegue encontrar resultados que as técnicas tradicionais de busca podem deixar passar, mesmo que compartilhem poucas palavras-chave com a consulta ou não compartilhem nenhuma.
Veja alguns resultados possíveis para a consulta "When did we go to the moon?".
Observe que o resultado mais relevante não contém nenhuma das palavras da consulta. Essa flexibilidade torna a busca semântica uma técnica eficaz para consultar bases de conhecimento de qualquer tamanho.
A busca semântica usa repositórios vetoriais, que veremos em detalhe mais adiante. Nesta seção, veremos como a busca semântica funciona.
Como fazer uma busca semântica
Para consultar um repositório vetorial, use a função search e forneça uma consulta em linguagem natural no parâmetro query. A função retorna uma lista de resultados. Cada resultado inclui os trechos relevantes, as pontuações de similaridade e o arquivo de origem.
Consulta de busca
Python
1
2
3const results = await client.vectorStores.search(vector_store.id, { query: "How many woodchucks are allowed per passenger?",});
1
2
3
4results = client.vector_stores.search(vector_store_id=vector_store.id,query="How many woodchucks are allowed per passenger?",)
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "How many woodchucks are allowed per passenger?")puts(results.data&.first&.content)
Resultados
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42{"object": "vector_store.search_results.page","search_query": "How many woodchucks are allowed per passenger?","data": [ {"file_id": "file-12345","filename": "woodchuck_policy.txt","score": 0.85,"attributes": {"region": "North America","author": "Wildlife Department" },"content": [ {"type": "text","text": "According to the latest regulations, each passenger is allowed to carry up to two woodchucks." }, {"type": "text","text": "Ensure that the woodchucks are properly contained during transport." } ] }, {"file_id": "file-67890","filename": "transport_guidelines.txt","score": 0.75,"attributes": {"region": "North America","author": "Transport Authority" },"content": [ {"type": "text","text": "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks." } ] } ],"has_more": false,"next_page": null}
Por padrão, cada resposta contém no máximo 10 resultados. Você pode definir um limite de até 50 resultados com o parâmetro max_num_results.
Reescrita de consultas
Algumas formas de redigir uma consulta produzem resultados melhores. Por isso, oferecemos uma opção que reescreve suas consultas automaticamente para otimizar a busca. Para ativá-la, defina rewrite_query=true ao chamar search.
A consulta reescrita fica disponível no campo search_query do resultado.
Consulta original
Consulta reescrita
Gostaria de saber a altura do prédio principal de escritórios.
altura do prédio principal de escritórios
Quais são as normas de segurança para o transporte de materiais perigosos?
normas de segurança para materiais perigosos
Como faço para registrar uma reclamação sobre um problema com um serviço?
procedimento para registrar reclamação sobre serviço
Filtragem por atributos
A filtragem por atributos permite restringir os resultados com base em critérios como um intervalo de datas. Você pode definir e combinar critérios em filters para selecionar arquivos pelos atributos antes de fazer a busca semântica.
Use filtros de comparação para comparar o valor da chave indicada por key nos attributes de um arquivo com o valor fornecido em value. Use filtros compostos para combinar vários filtros com and e or.
Filtro de comparação
1
2
3
4
5{"type": "eq"|"ne"|"gt"|"gte"|"lt"|"lte"|"in"|"nin", // comparison operators"key": "attributes_key", // attributes key"value": "target_value"// value to compare against}
Os exemplos de filtragem por nome de arquivo usam um atributo personalizado, filename, que você precisa definir explicitamente em cada arquivo do repositório vetorial, por exemplo, {"filename": "example.txt"}. Esses filtros não usam automaticamente o nome do arquivo enviado.
Se os resultados da busca em arquivos não forem relevantes o suficiente, você pode ajustar ranking_options para melhorar a qualidade das respostas. Você pode especificar um ranker, como auto ou default-2024-08-21, e definir score_threshold entre 0,0 e 1,0. Quanto maior o score_threshold, mais relevantes precisam ser os trechos para aparecer nos resultados, embora isso possa excluir alguns trechos potencialmente úteis. Ao fornecer ranking_options.hybrid_search, você também pode ajustar hybrid_search.embedding_weight (rrf_embedding_weight) e hybrid_search.text_weight (rrf_text_weight). Esses pesos controlam como a fusão por classificação recíproca combina as correspondências semânticas entre embeddings com as correspondências por palavras-chave obtidas na busca esparsa. Aumente o primeiro peso para priorizar a similaridade semântica ou o segundo para priorizar os termos em comum. Pelo menos um dos pesos deve ser maior que zero.
Repositórios vetoriais
Os repositórios vetoriais armazenam os arquivos usados na busca semântica pela API de recuperação de informações e pela ferramenta de busca em arquivos. Quando você adiciona um arquivo a um repositório vetorial, o sistema o divide em trechos, gera os embeddings e indexa os trechos automaticamente.
Os repositórios vetoriais contêm objetos vector_store_file, cada um vinculado a um objeto file.
Tipo de objeto
Descrição
file
Representa o conteúdo enviado pela API de arquivos. É usado com frequência em repositórios vetoriais, mas também em ajustes finos de modelos e em outros casos de uso.
vector_store
Repositório de arquivos que podem ser pesquisados.
vector_store.file
Tipo que encapsula um file já dividido em trechos, com embeddings gerados e associado a um vector_store. Contém o mapa attributes usado na filtragem.
Preços
A cobrança considera o armazenamento total usado por todos os seus repositórios vetoriais. Esse total é calculado a partir do tamanho dos trechos extraídos dos arquivos e dos respectivos embeddings.
Algumas operações, como create para vector_store.file, são assíncronas e podem levar algum tempo. Use funções auxiliares como create_and_poll para que a execução aguarde a conclusão da operação. Outra opção é consultar o status. A remoção de arquivos de um repositório vetorial segue o modelo de consistência eventual. Por um breve período após a remoção, os resultados da busca ainda podem incluir conteúdo do arquivo removido.
Ao criar um lote, você pode fornecer file_ids e, opcionalmente, attributes, chunking_strategy ou ambos. Outra opção é usar o array files para passar um objeto por arquivo, com um file_id e os campos opcionais attributes e chunking_strategy. As duas opções são mutuamente exclusivas. Use a primeira para aplicar as mesmas configurações a todos os arquivos e a segunda para personalizar as configurações de cada arquivo.
Para obter uma taxa de processamento maior ao adicionar arquivos a um único repositório vetorial, recomendamos a criação em lote sempre que possível. Um lote pode incluir até 500 arquivos em uma única requisição. Em comparação com várias requisições de criação de arquivos individuais, isso costuma reduzir a disputa por recursos e a latência de ponta a ponta.
Atributos
Cada vector_store.file pode ter um dicionário attributes associado. Os valores desse dicionário podem ser usados em uma busca semântica com filtragem por atributos. O dicionário aceita no máximo 16 chaves, com até 256 caracteres cada.
Criar um arquivo com atributos no repositório vetorial
Você pode definir uma política de expiração para objetos vector_store com expires_after. Quando um repositório vetorial expira, todos os objetos vector_store.file associados são excluídos, e a cobrança por eles termina.
Definir a política de expiração de um repositório vetorial
O tamanho máximo de cada arquivo é de 512 MB. Cada arquivo deve conter no máximo 5.000.000 de tokens. A contagem é feita automaticamente quando você anexa o arquivo.
Divisão em trechos
Por padrão, max_chunk_size_tokens tem o valor 800 e chunk_overlap_tokens tem o valor 400. Assim, para a indexação, cada arquivo é dividido em trechos de 800 tokens, com uma sobreposição de 400 tokens entre trechos consecutivos.
Você pode ajustar essa divisão definindo chunking_strategy ao adicionar arquivos ao repositório vetorial. A estratégia tem os seguintes limites.
max_chunk_size_tokens deve estar entre 100 e 4096, inclusive.
chunk_overlap_tokens deve ser maior ou igual a zero e não deve exceder max_chunk_size_tokens / 2.
Para os tipos MIME text/, a codificação deve ser utf-8, utf-16 ou ascii.
Depois de fazer uma consulta, você pode sintetizar uma resposta com base nos resultados. Para isso, forneça os resultados e a consulta original a um dos nossos modelos. O modelo usará essas informações para fundamentar a resposta.
Fazer uma consulta para obter resultados
Python
1
2
3
4
5
6
7
8
9import OpenAI from "openai";const client = new OpenAI();const userQuery = "What is the return policy?";const results = await client.vectorStores.search(vector_store.id, { query: userQuery,});
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "What is the return policy?")puts(results.data)
Sintetizar uma resposta com base nos resultados
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22const formattedResults = formatResults(results.data);// Join the text content of all resultsconst textSources = results.data .map((result) => result.content.map((c) => c.text).join("\n")) .join("\n");const completion = await client.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "developer", content: "Produce a concise answer to the query based on the provided sources.", }, { role: "user", content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`, }, ],});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20# Use results and user_query from the preceding search step.formatted_results = format_results(results.data)"\n".join("\n".join(c.text for c in result.content) for result in results.data)completion = client.chat.completions.create(model="gpt-6-astra",messages=[ {"role": "developer","content": "Produce a concise answer to the query based on the provided sources.", }, {"role": "user","content": f"Sources: {formatted_results}\n\nQuery: '{user_query}'", }, ],)print(completion.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46package mainimport ( "context" "fmt" "strings" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() userQuery := "What is the return policy?" results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{ Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)}, }) if err != nil { panic(err) } completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."), openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}func formatResults(results []openai.VectorStoreSearchResponse) string { var sources strings.Builder sources.WriteString("<sources>") for _, result := range results { fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename) for _, content := range result.Content { fmt.Fprintf(&sources, "<content>%s</content>", content.Text) } sources.WriteString("</result>") } sources.WriteString("</sources>") return sources.String()}