
Este guia apresenta os princípios fundamentais para reduzir a latência em diversos casos de uso de LLMs. Essas técnicas vêm do trabalho com clientes e desenvolvedores em uma ampla variedade de aplicativos em produção. Por isso, devem ser aplicáveis tanto a um fluxo de trabalho com etapas bem específicas quanto a um aplicativo de chat completo.
O guia agrupa as várias técnicas em sete princípios, cada um deles correspondente a uma abordagem para reduzir a latência.
No fim, veremos como aplicar esses princípios em um exemplo.
Sete princípios
- Processe tokens mais rápido.
- Gere menos tokens.
- Use menos tokens de entrada.
- Faça menos requisições.
- Execute etapas em paralelo.
- Reduza o tempo de espera dos usuários.
- Evite usar um LLM por padrão.
Processe tokens mais rápido
A velocidade de inferência provavelmente é a primeira coisa que vem à mente quando se pensa em reduzir a latência. Como veremos, há vários outros fatores. Essa velocidade é a taxa com que o LLM processa tokens, geralmente medida em TPM (tokens por minuto) ou TPS (tokens por segundo).
O principal fator que influencia a velocidade de inferência é o tamanho do modelo. Modelos menores geralmente são mais rápidos, custam menos e, quando bem utilizados, podem até superar modelos maiores. Para manter a qualidade dos resultados com modelos menores, você pode experimentar as seguintes técnicas:
- usar um prompt mais detalhado e mais longo,
- incluir exemplos few-shot ou aumentar o número desses exemplos, ou
- usar ajuste fino ou destilação.
Você também pode otimizar a inferência com recursos como o de saídas previstas. Quando você já conhece a maior parte da saída, como acontece em tarefas de edição de código, esse recurso permite reduzir consideravelmente a latência da geração. Ao receber uma previsão, o LLM pode se concentrar mais nas alterações e menos no conteúdo que será mantido.
Outros fatores que afetam a velocidade de inferência são a quantidade de recursos de
computação disponíveis e as demais
otimizações de inferência que você utiliza.
A maioria das pessoas tem pouca influência direta sobre esses fatores. Se você quiser experimentar e tiver algum controle sobre a infraestrutura, usar hardware mais rápido ou
operar os mecanismos de inferência com menor saturação pode aumentar um pouco a taxa de tokens por minuto. Para quem trabalha diretamente com a infraestrutura, há muitas outras
otimizações de inferência
que vão além do escopo deste guia.
Gere menos tokens
Ao usar um LLM, gerar tokens quase sempre é a etapa de maior latência. Como regra prática, reduzir o número de tokens de saída pela metade pode reduzir a latência em cerca de 50%. A forma de reduzir o tamanho da saída depende do que você está gerando.
Para gerar texto em linguagem natural, pode ajudar pedir ao modelo que seja mais conciso (“use menos de 20 palavras” ou “seja breve”). Você também pode usar exemplos few-shot, ajuste fino ou ambos para ensinar o modelo a dar respostas mais curtas.
Para gerar saída estruturada, procure simplificar a sintaxe da saída sempre que possível. Encurte nomes de funções, omita argumentos nomeados, agrupe parâmetros etc.
Por fim, embora seja pouco comum, você também pode usar max_tokens ou stop_tokens para encerrar a geração mais cedo.
Cada token de saída a menos é um (mili)segundo economizado!
Use menos tokens de entrada
Reduzir a quantidade de tokens de entrada diminui a latência, mas o efeito costuma ser pequeno. Cortar o prompt pela metade pode reduzir a latência em apenas 1% a 5%. A menos que você trabalhe com contextos muito grandes (documentos, imagens), talvez valha mais a pena concentrar seus esforços em outras técnicas.
Se você de fato trabalha com contextos muito grandes (ou quer extrair o máximo de desempenho e já esgotou as outras opções), pode usar as seguintes técnicas para reduzir a quantidade de tokens de entrada:
- Faça o ajuste fino do modelo para dispensar instruções ou exemplos extensos.
- Filtre o contexto de entrada, por exemplo, removendo resultados de RAG irrelevantes ou limpando o HTML.
- Maximize o prefixo comum dos prompts colocando as partes dinâmicas (por exemplo, resultados de RAG e histórico) mais para o fim do prompt. Assim, a requisição aproveita melhor o cache KV, usado pela maioria dos provedores de LLMs, e o modelo processa menos tokens de entrada a cada requisição.
Consulte a documentação para saber como funciona o cache de prompts.
Faça menos requisições
Cada requisição acrescenta o tempo de ida e volta até o servidor. Essa latência se acumula.
Se o LLM precisa executar várias etapas em sequência, considere reuni-las em um único prompt e obter todos os resultados em uma só resposta, em vez de enviar uma requisição por etapa. Assim, você evita a latência das idas e voltas adicionais e ainda pode simplificar o processamento das respostas.
Uma forma de fazer isso é colocar as etapas em uma lista numerada no prompt e pedir ao modelo que retorne os resultados em campos nomeados de um objeto JSON. Assim, você pode extrair e acessar cada resultado individualmente.
Execute etapas em paralelo
O processamento paralelo pode ser bastante eficaz quando um LLM precisa executar várias etapas.
Se as etapas não precisam seguir uma sequência estrita, você pode distribuí-las entre chamadas paralelas. Duas camisas no varal levam o mesmo tempo para secar que uma só.
Mesmo que as etapas precisem seguir uma sequência estrita, talvez seja possível usar execução especulativa. Essa técnica é particularmente eficaz em etapas de classificação nas quais um resultado é mais provável que os demais, como na moderação.
- Inicie as etapas 1 e 2 ao mesmo tempo (por exemplo, a moderação da entrada e a geração de uma história).
- Verifique o resultado da etapa 1.
- Se o resultado for diferente do esperado, cancele a etapa 2 e, se necessário, tente novamente.
Se a previsão para a etapa 1 estiver correta, na prática você terá executado essa etapa sem acrescentar latência!
Reduza o tempo de espera dos usuários
Há uma grande diferença entre esperar e acompanhar o progresso. Dê aos usuários a oportunidade de acompanhar o que está acontecendo. Veja algumas técnicas:
- Streaming: É a abordagem mais eficaz, pois reduz o tempo de espera para um segundo ou menos. (Imagine como seria usar o ChatGPT se cada resposta só aparecesse quando estivesse pronta.)
- Processamento em blocos: Se a saída precisar passar por etapas como moderação ou tradução antes de aparecer para o usuário, considere processá-la em blocos. Envie a saída por streaming ao back-end e, à medida que cada bloco for processado, envie-o ao front-end.
- Exibição das etapas: Se o aplicativo executa várias etapas ou usa ferramentas, mostre isso ao usuário. Quanto mais ele puder acompanhar o progresso real, melhor.
- Estados de carregamento: Indicadores de carregamento e barras de progresso ajudam bastante.
Embora exibir as etapas e os estados de carregamento tenha um efeito principalmente psicológico, o streaming e o processamento em blocos reduzem de fato a latência total quando se considera a interação entre o aplicativo e o usuário. O usuário termina de ler a resposta mais cedo.
Evite usar um LLM por padrão
Os modelos de linguagem são poderosos e versáteis. Por isso, às vezes são usados em situações nas quais um método tradicional mais rápido seria mais adequado. Identificar esses casos pode reduzir consideravelmente a latência. Veja alguns exemplos:
- Respostas definidas no código: Se a saída tem poucas variações possíveis, talvez você possa gerá-la sem um LLM. Confirmações de ações, mensagens de recusa e solicitações de dados padronizados são bons exemplos de mensagens que você pode definir diretamente no código. (Também vale o recurso clássico de escrever algumas versões de cada mensagem.)
- Cálculo antecipado: Se a entrada se limita a algumas opções (por exemplo, a seleção de uma categoria), você pode gerar várias respostas com antecedência. Basta garantir que o mesmo usuário nunca veja a mesma resposta duas vezes.
- Uso da interface: Às vezes, componentes de interface tradicionais, criados para uma finalidade específica, apresentam métricas resumidas, relatórios ou resultados de busca com mais clareza do que um texto gerado por um LLM.
- Técnicas tradicionais de otimização: Um aplicativo com LLM continua sendo um aplicativo. Busca binária, cache, tabelas hash e análise da complexidade de tempo continuam sendo úteis mesmo com modelos de linguagem.
Exemplo
Vamos examinar um aplicativo de exemplo, identificar oportunidades de reduzir a latência e propor algumas soluções.
Analisaremos a arquitetura e os prompts de um bot de atendimento ao cliente fictício, inspirado em aplicativos reais em produção. A seção sobre arquitetura e prompts apresenta o funcionamento do bot. Na seção de análise e otimizações, veremos como reduzir a latência passo a passo.
O exemplo aplica apenas alguns dos princípios. Da mesma forma, casos de uso reais nem sempre exigem todas as técnicas.
Arquitetura e prompts
O diagrama mostra a arquitetura inicial de um bot de atendimento ao cliente fictício. É essa arquitetura que vamos modificar.
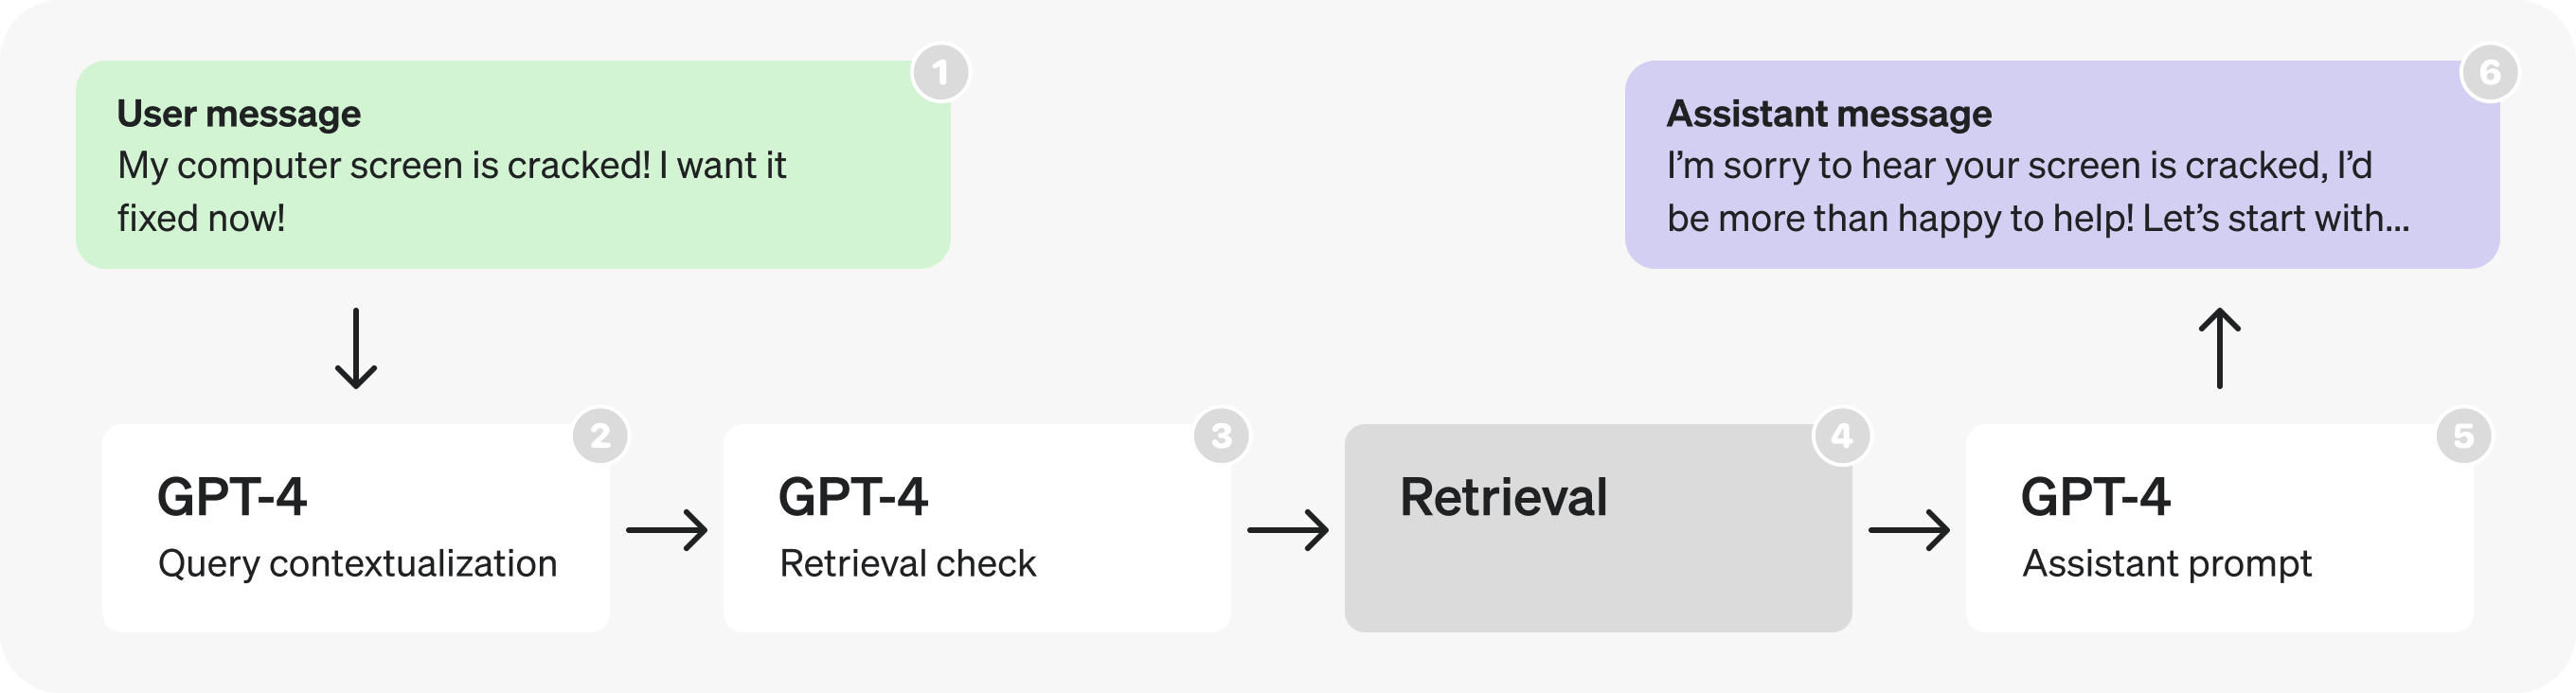
Em linhas gerais, o fluxo do diagrama funciona assim:
- O usuário envia uma mensagem em uma conversa em andamento.
- O sistema transforma a última mensagem em uma consulta que contém todo o contexto necessário (veja os exemplos no prompt).
- O sistema verifica se é preciso buscar informações adicionais para responder à consulta.
- A recuperação de informações retorna os resultados da busca.
- O assistente usa seu raciocínio para analisar a consulta do usuário e os resultados da busca e produz uma resposta.
- O sistema envia a resposta ao usuário.
A seguir estão os prompts usados em cada parte do diagrama. Embora sejam fictícios e simplificados, eles seguem a estrutura e o estilo de redação que você encontraria em um aplicativo em produção.
Marcadores como “[user input here]” indicam partes dinâmicas que o aplicativo substitui por dados reais em tempo de execução.
Análise e otimizações
Parte 1: análise dos prompts de busca
O primeiro detalhe que chama a atenção na arquitetura são as chamadas consecutivas ao GPT-4. Elas sugerem uma possível ineficiência. Em muitos casos, é possível substituí-las por uma única chamada ou por chamadas paralelas.
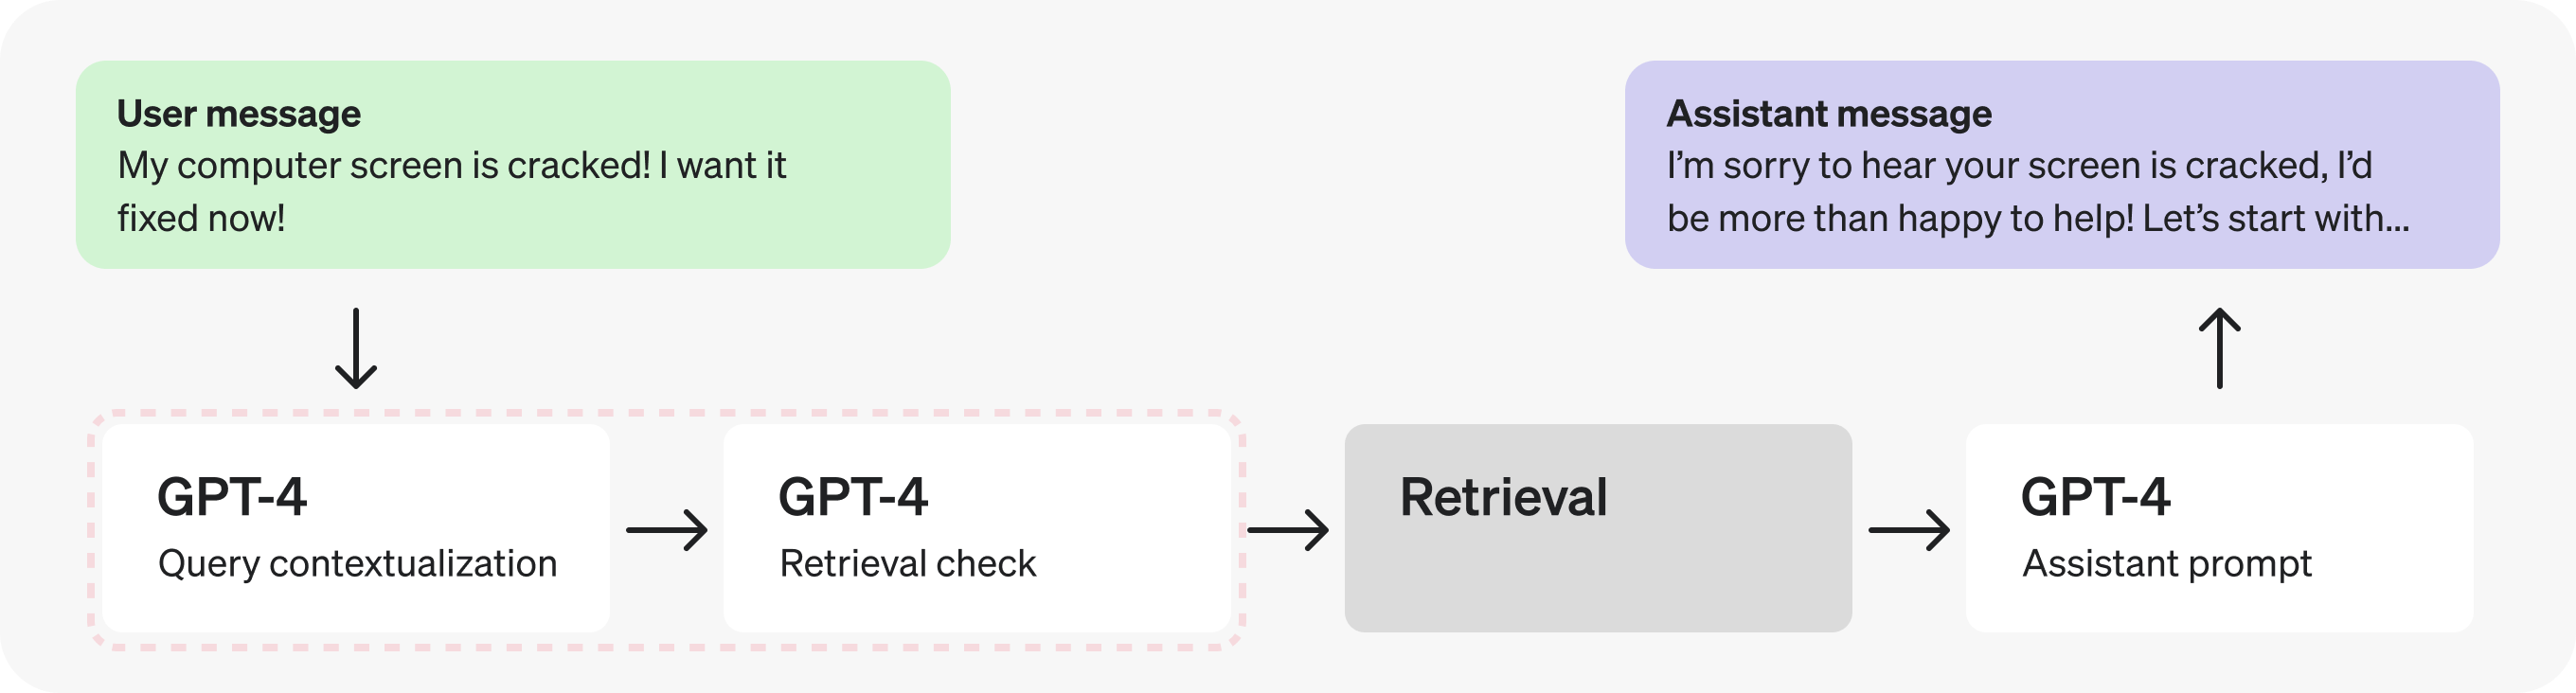
Neste caso, como a verificação da necessidade de busca depende da consulta contextualizada, vamos combinar as duas etapas em um único prompt para fazer menos requisições.
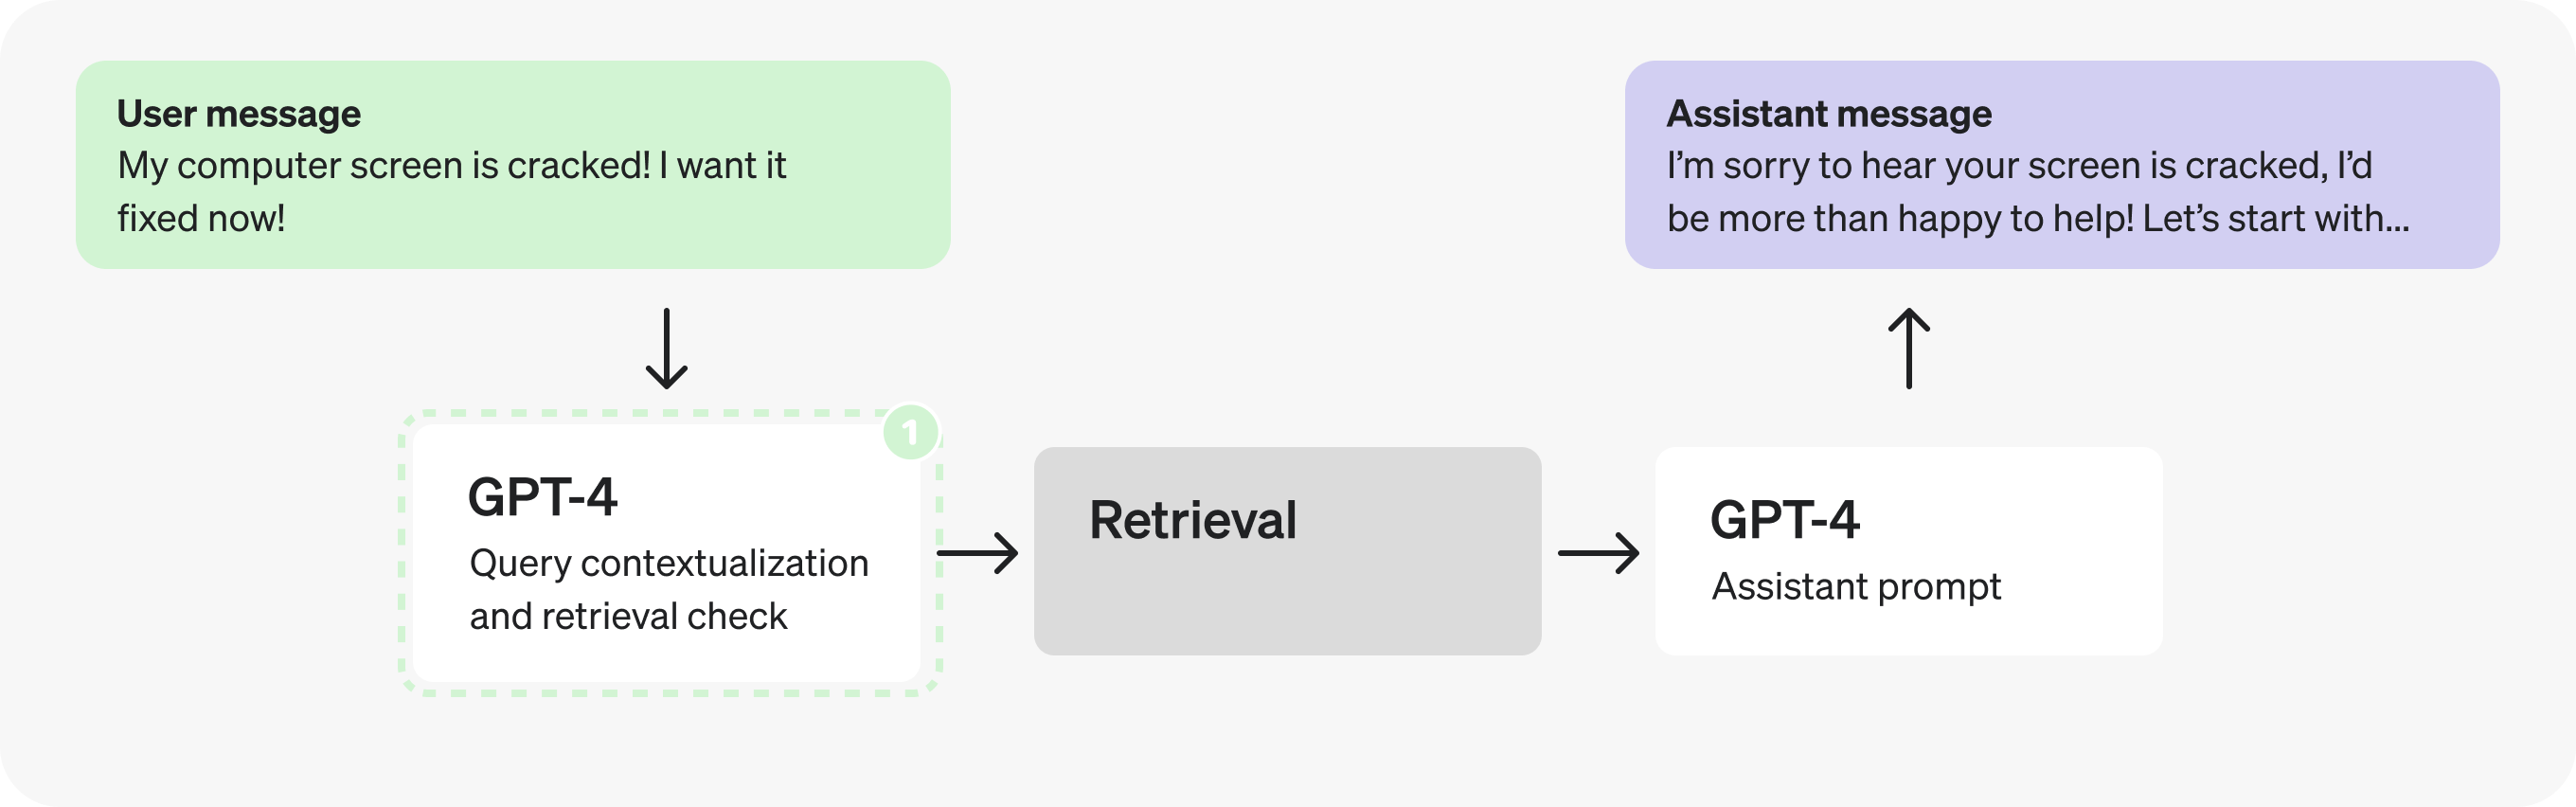
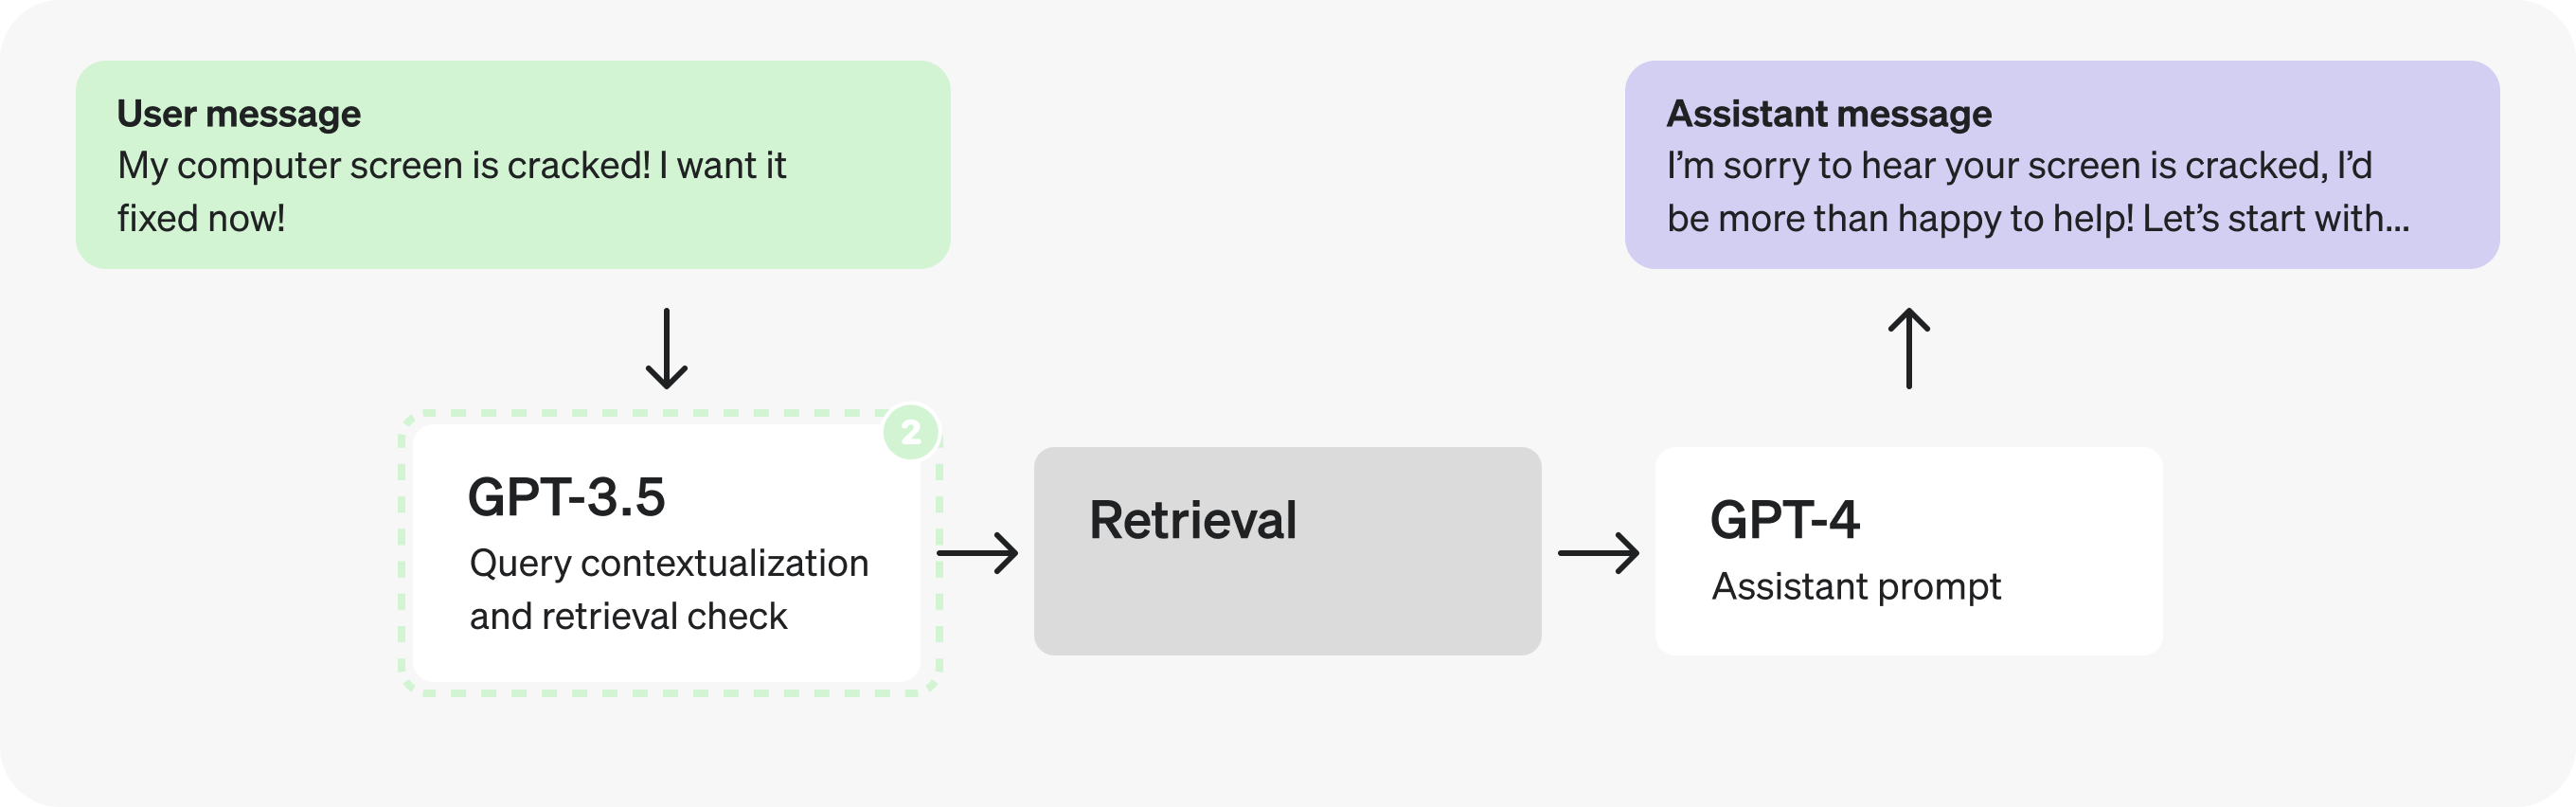
Acrescentar contexto e decidir se uma busca é necessária são tarefas simples e bem definidas. Por isso, provavelmente podemos usar um modelo menor com ajuste fino. A troca pelo GPT-3.5 permitirá processar tokens mais rápido.
Parte 2: análise do prompt do assistente
Vamos examinar o prompt do assistente. Ao preencher os campos do JSON, o assistente parece executar várias etapas distintas. Isso sugere a possibilidade de executar etapas em paralelo.
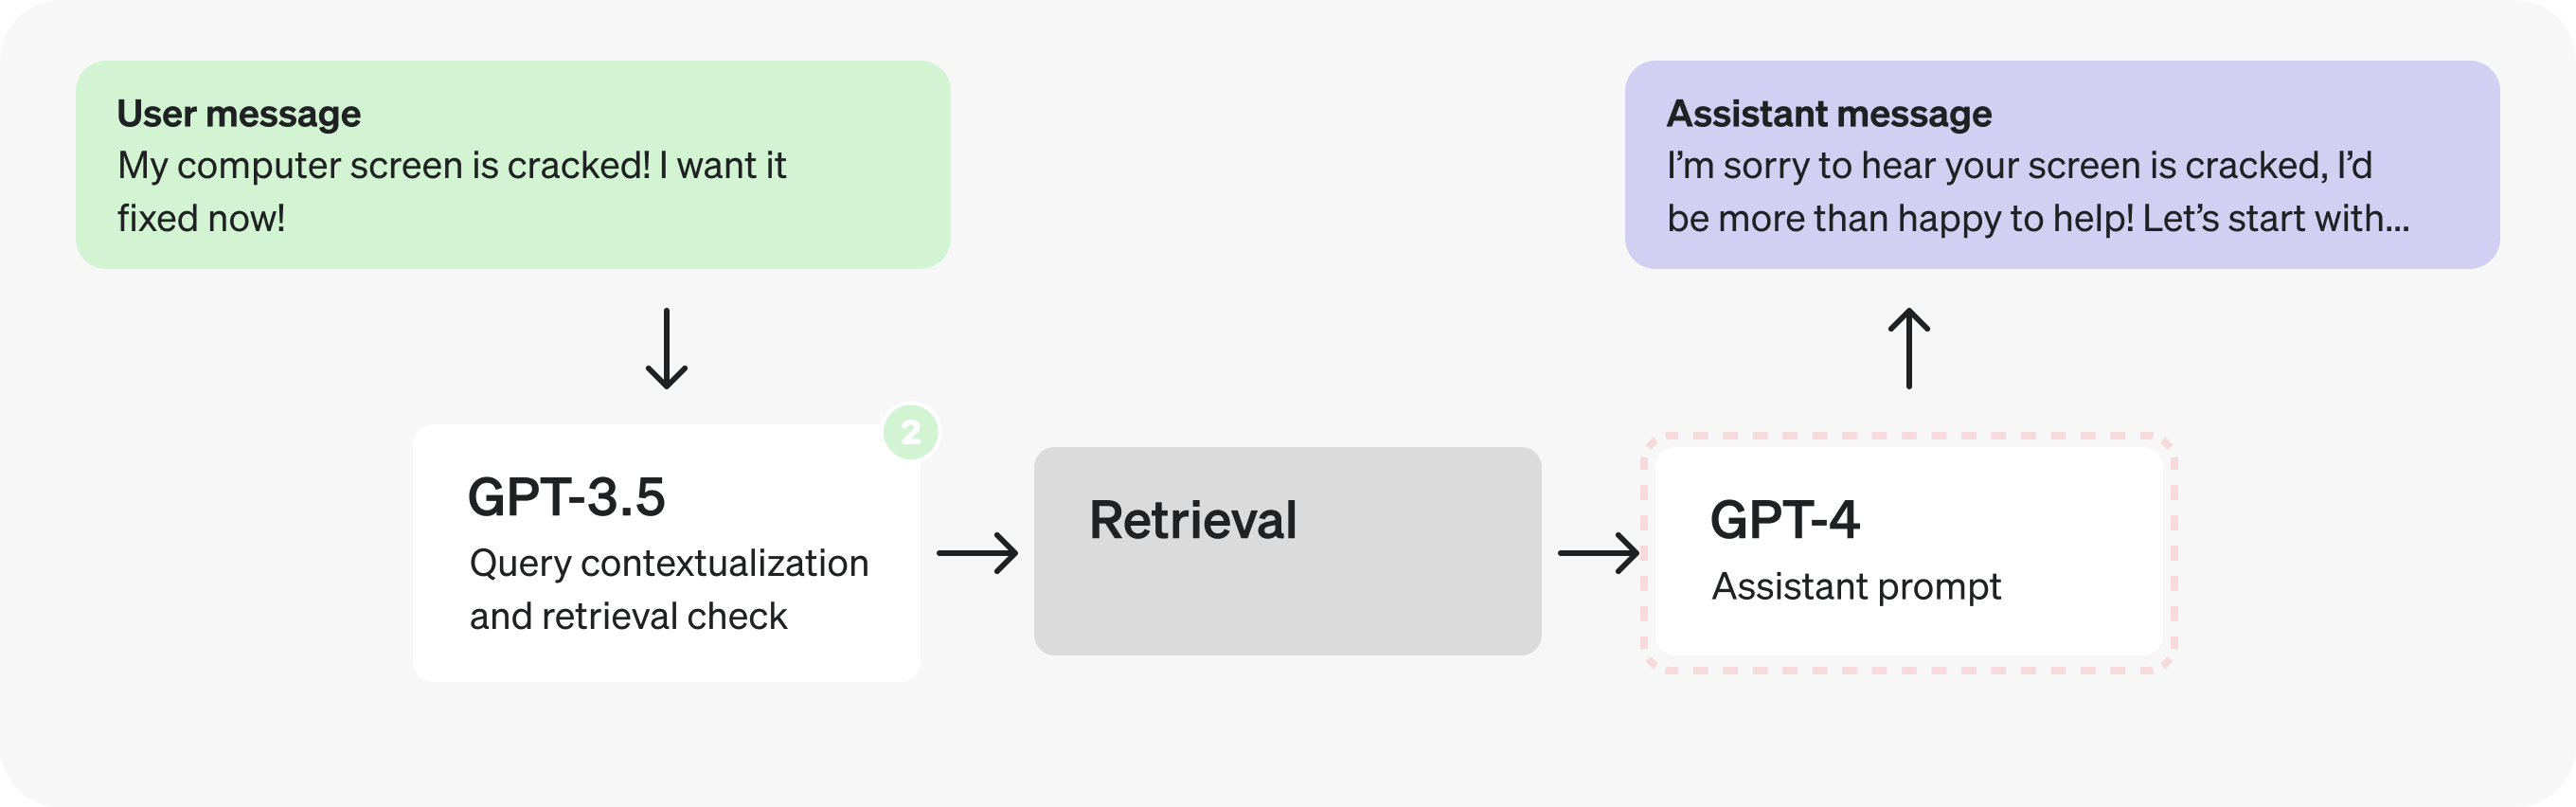
Suponha, porém, que os testes tenham mostrado que separar as etapas de raciocínio do JSON piora as respostas. Nesse caso, precisamos explorar outras soluções.
Poderíamos usar o GPT-3.5 com ajuste fino no lugar do GPT-4? Talvez. Em geral, é melhor deixar as respostas abertas do assistente a cargo do GPT-4, que lida melhor com uma variedade maior de casos. Entretanto, ao analisar as etapas de raciocínio individualmente, vemos que talvez nem todas exijam a capacidade de raciocínio do GPT-4. Como têm um escopo limitado e bem definido, vale considerar o ajuste fino para essas etapas.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
};Temos duas opções, cada uma com uma vantagem. Mantemos uma única requisição cuja saída é gerada inteiramente pelo GPT-4 ou dividimos o processo em duas requisições sequenciais e usamos o GPT-3.5 para tudo, exceto a resposta final? Aqui, dois princípios entram em conflito. A primeira opção permite fazer menos requisições, mas a segunda pode permitir processar tokens mais rápido.
Como em muitas decisões de otimização, a resposta depende de detalhes como estes:
- A proporção de tokens no campo
responseem relação aos demais campos. - A redução média da latência ao processar a maioria dos campos mais rápido.
- O aumento médio da latência ao fazer duas requisições em vez de uma.
A conclusão varia de caso para caso. A melhor forma de decidir é testar as opções com exemplos de produção. Neste caso, vamos supor que os testes tenham indicado que vale a pena dividir o prompt em dois para processar tokens mais rápido.
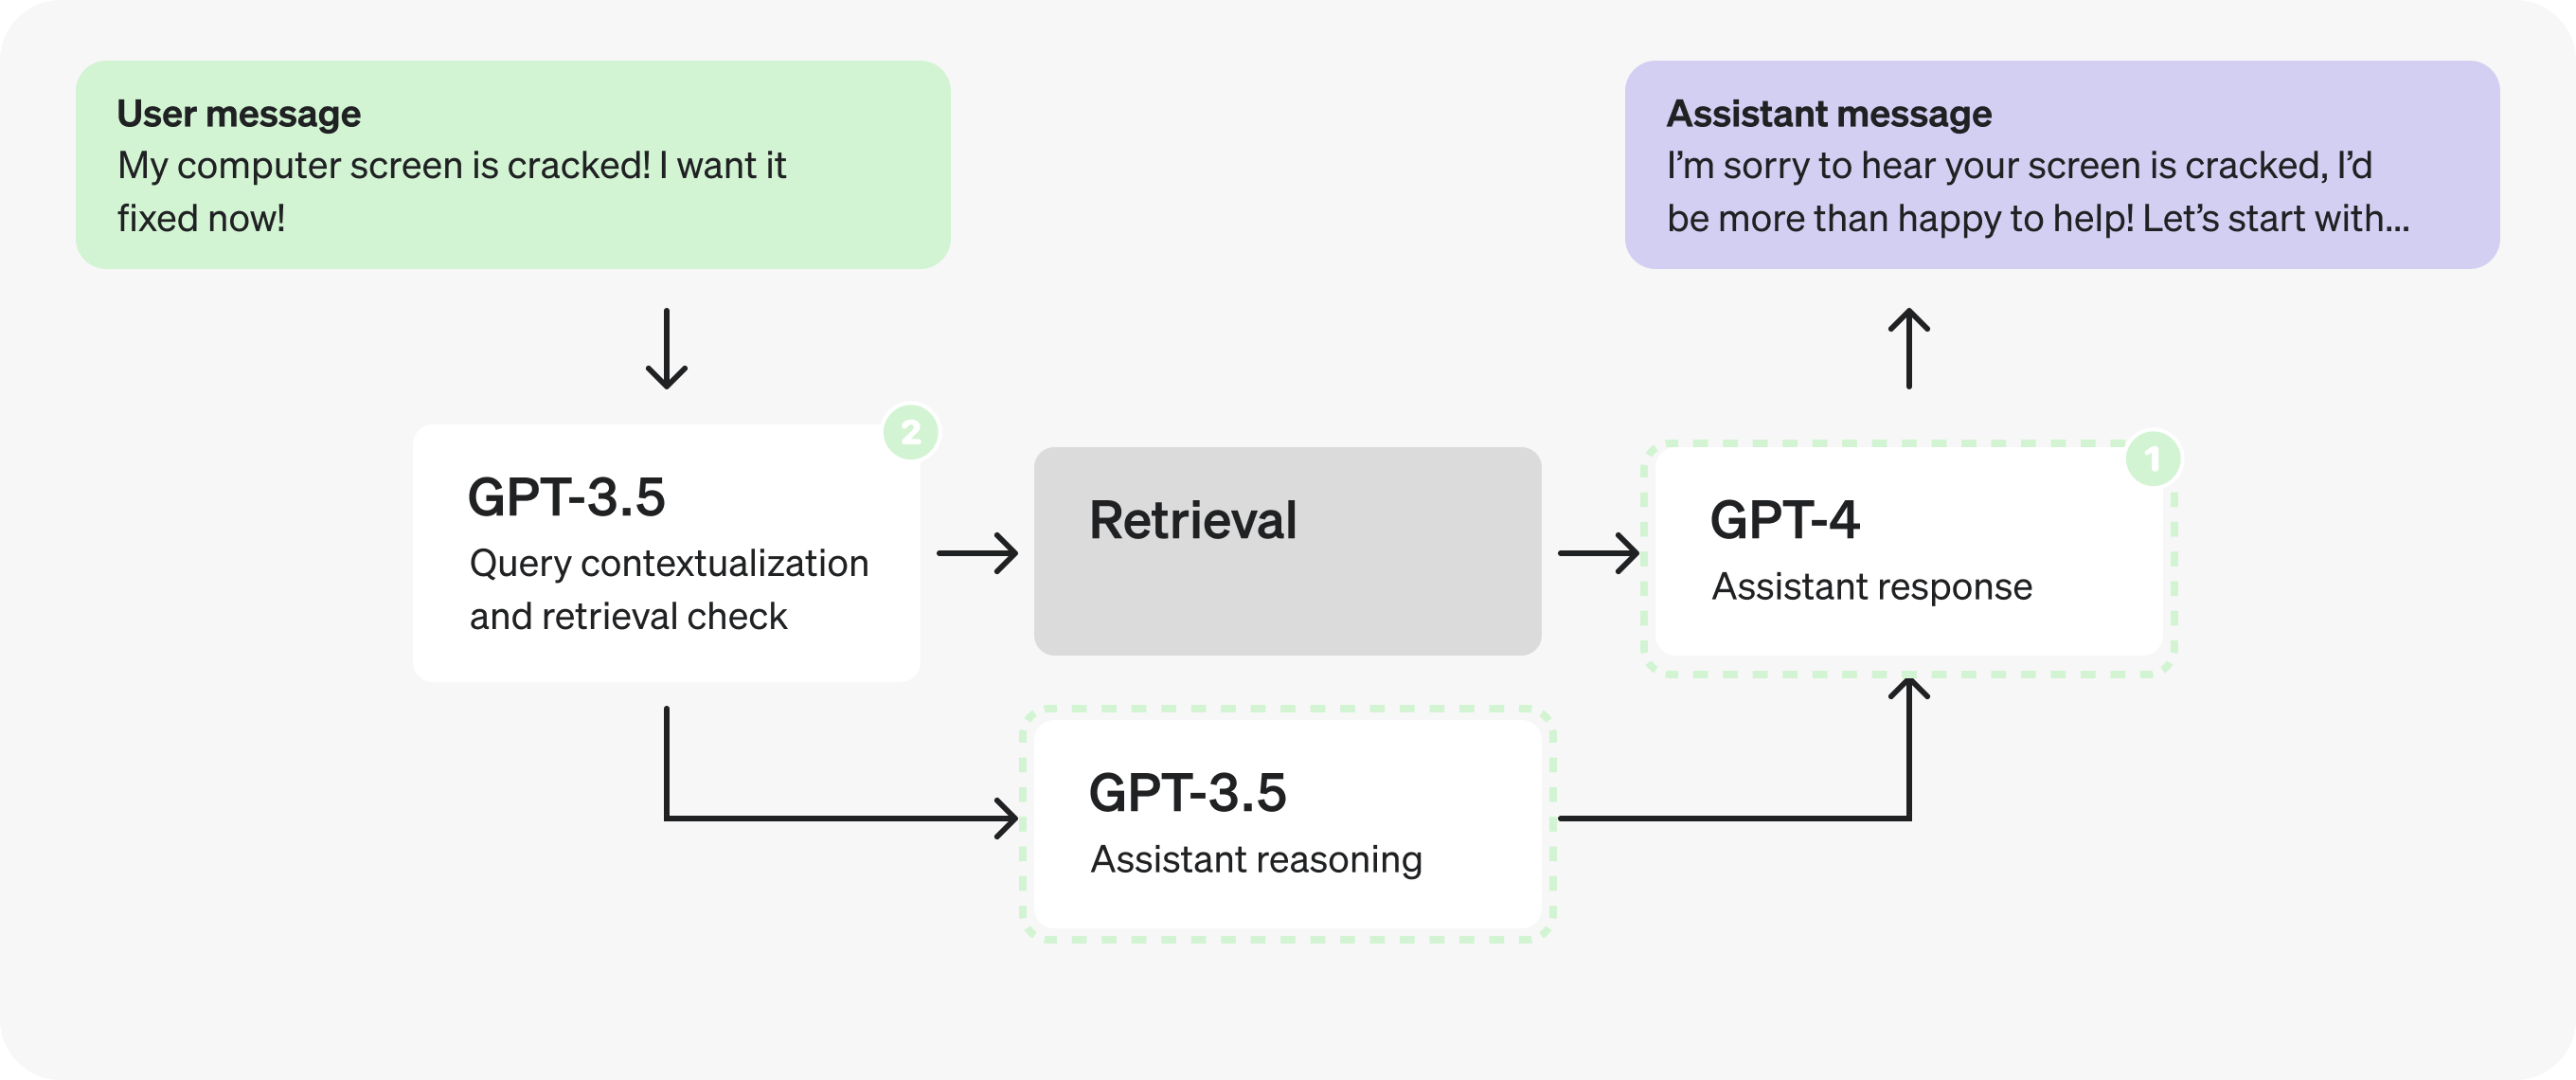
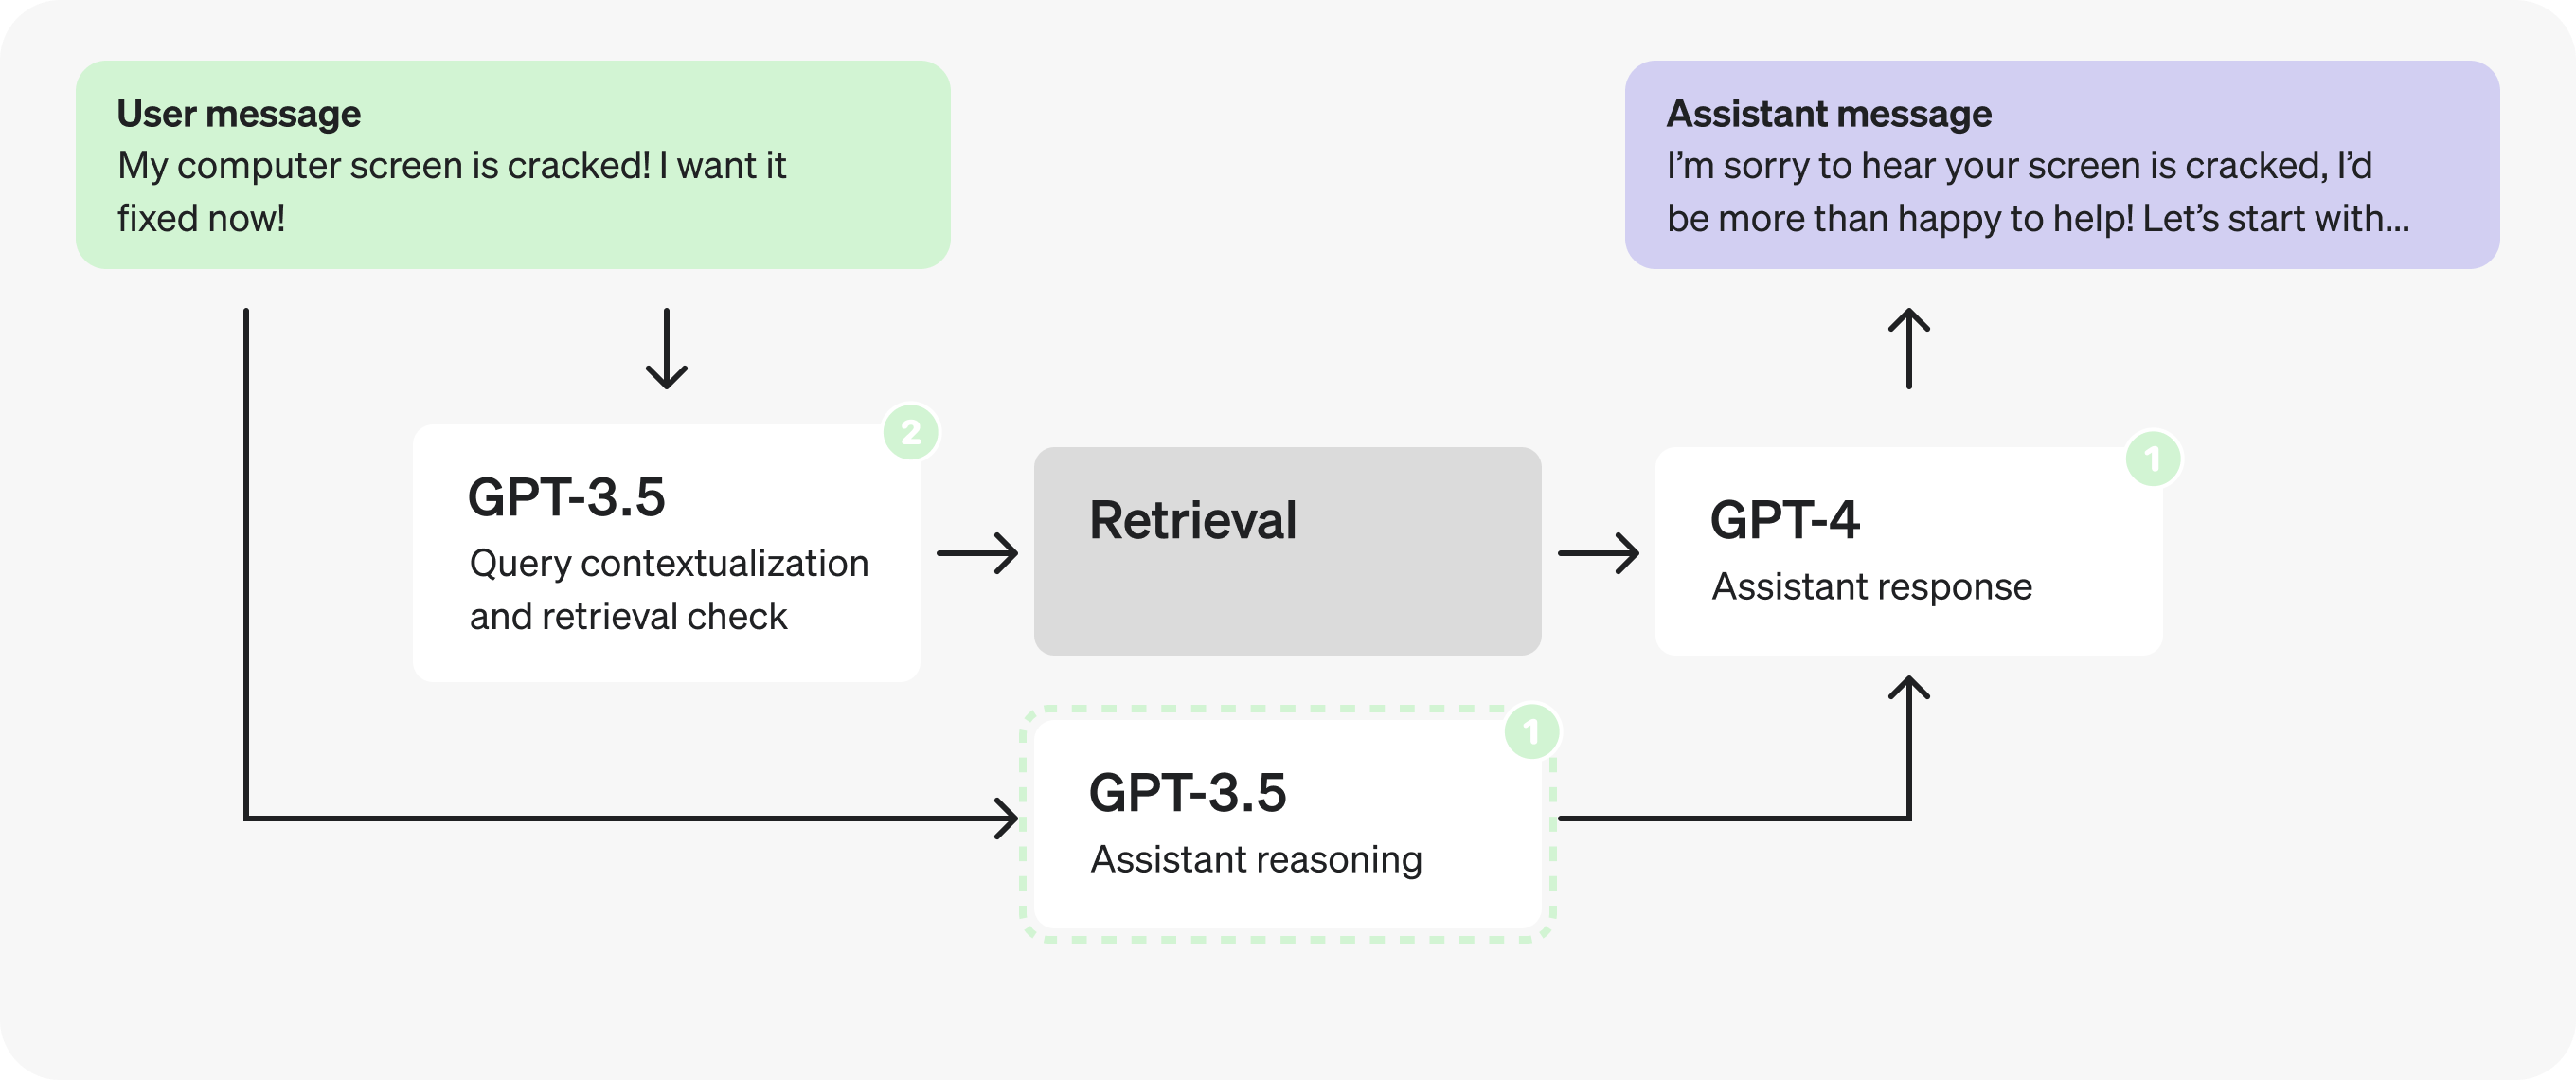
Observação: Vamos agrupar response e enough_information_in_context no segundo prompt para evitar o envio do contexto recuperado aos dois novos prompts.
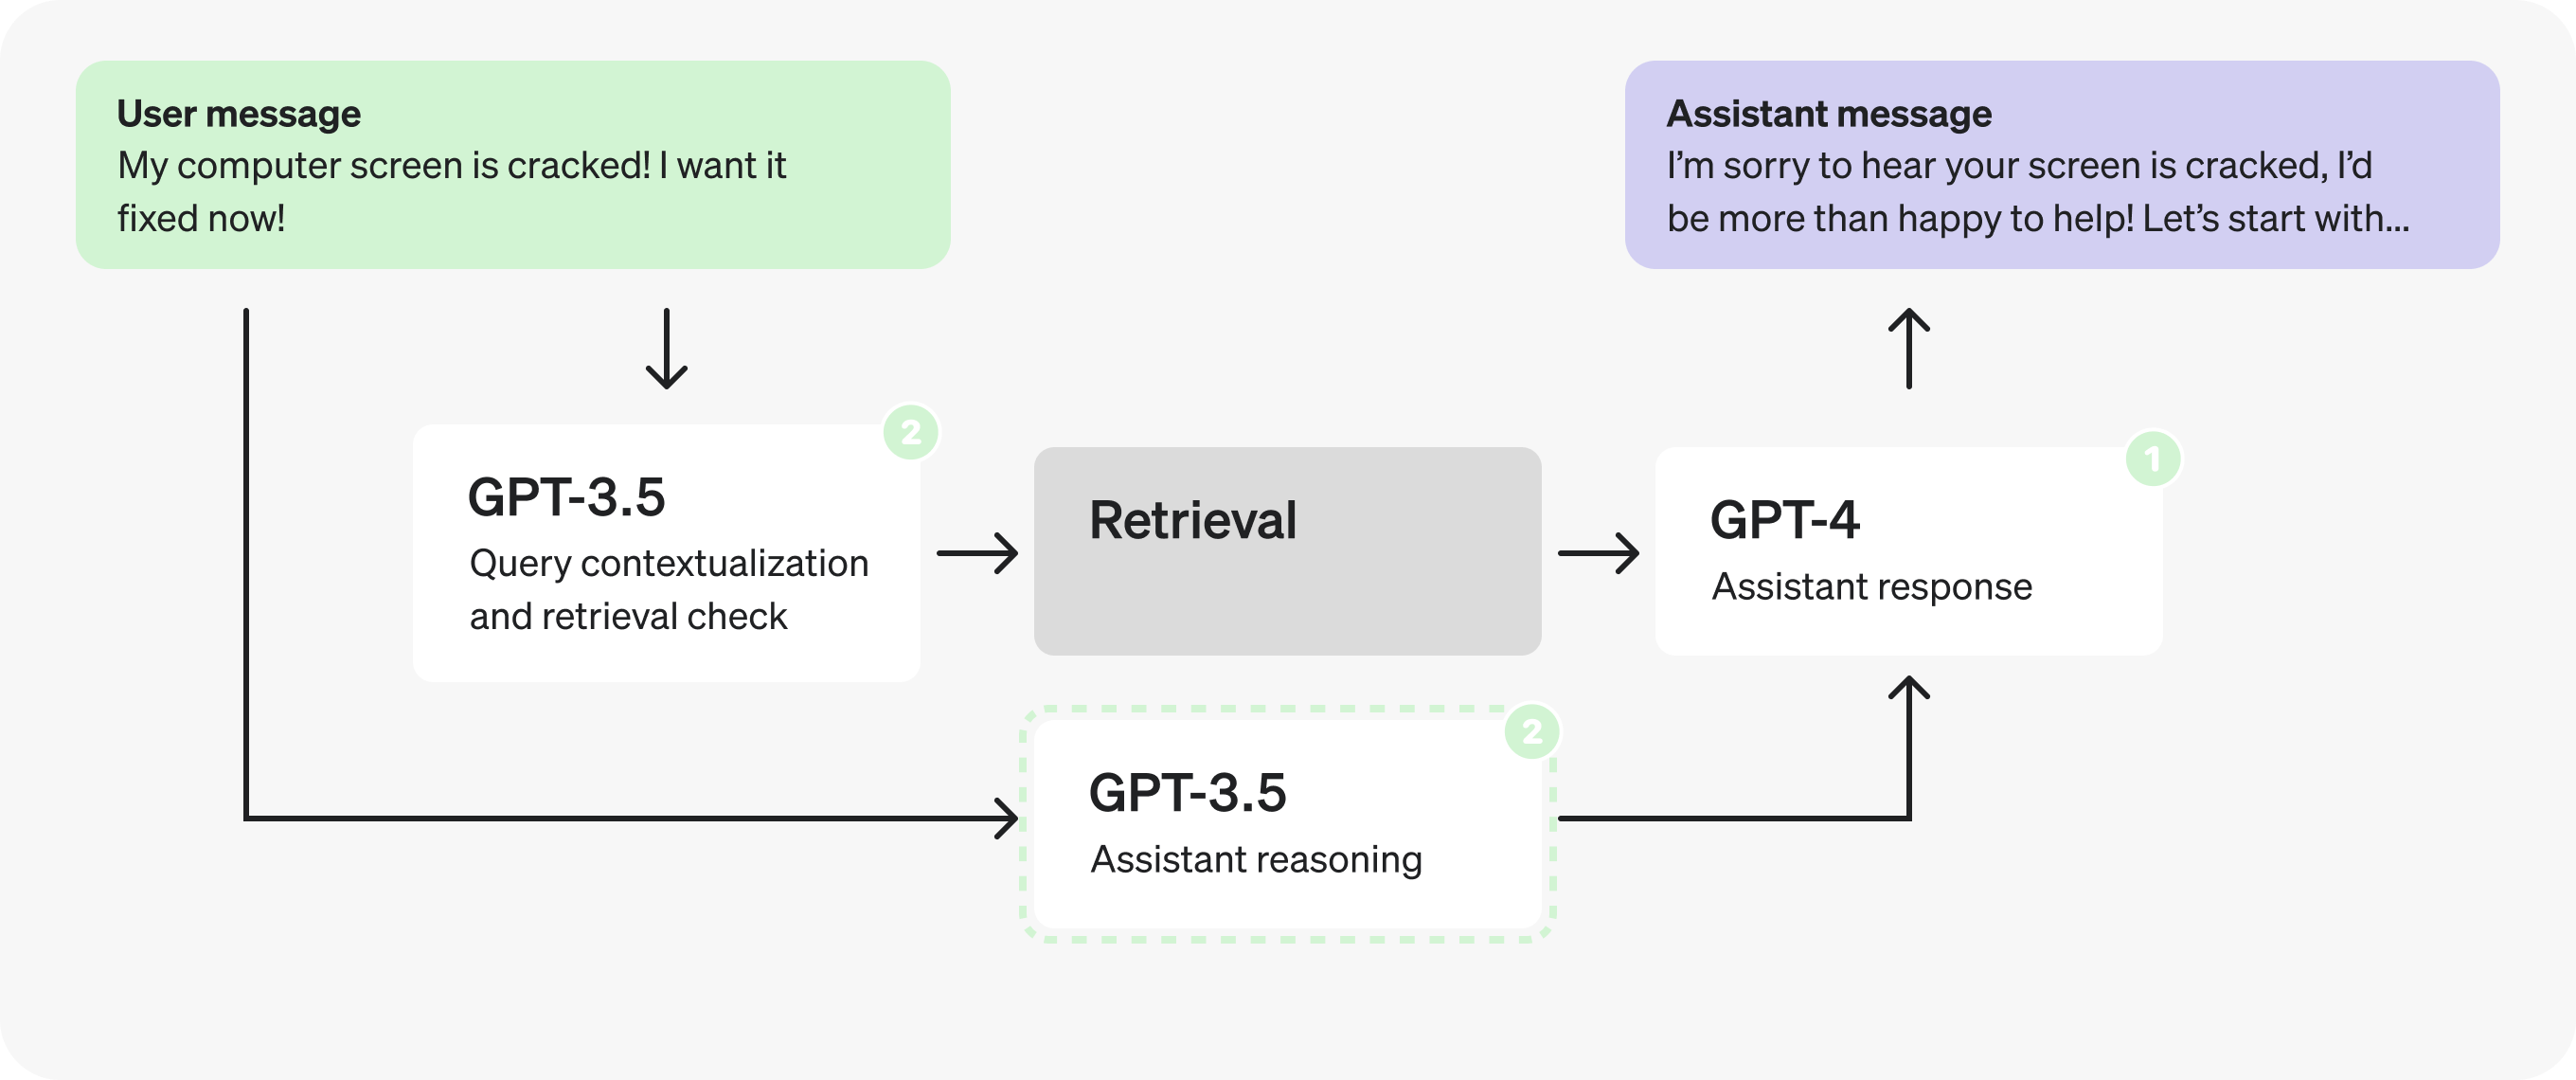
Agora que o prompt de raciocínio independe do contexto recuperado, podemos executar as etapas em paralelo e enviá-lo ao mesmo tempo que os prompts de busca.
Parte 3: otimização da saída estruturada
Vamos examinar novamente o prompt de raciocínio.
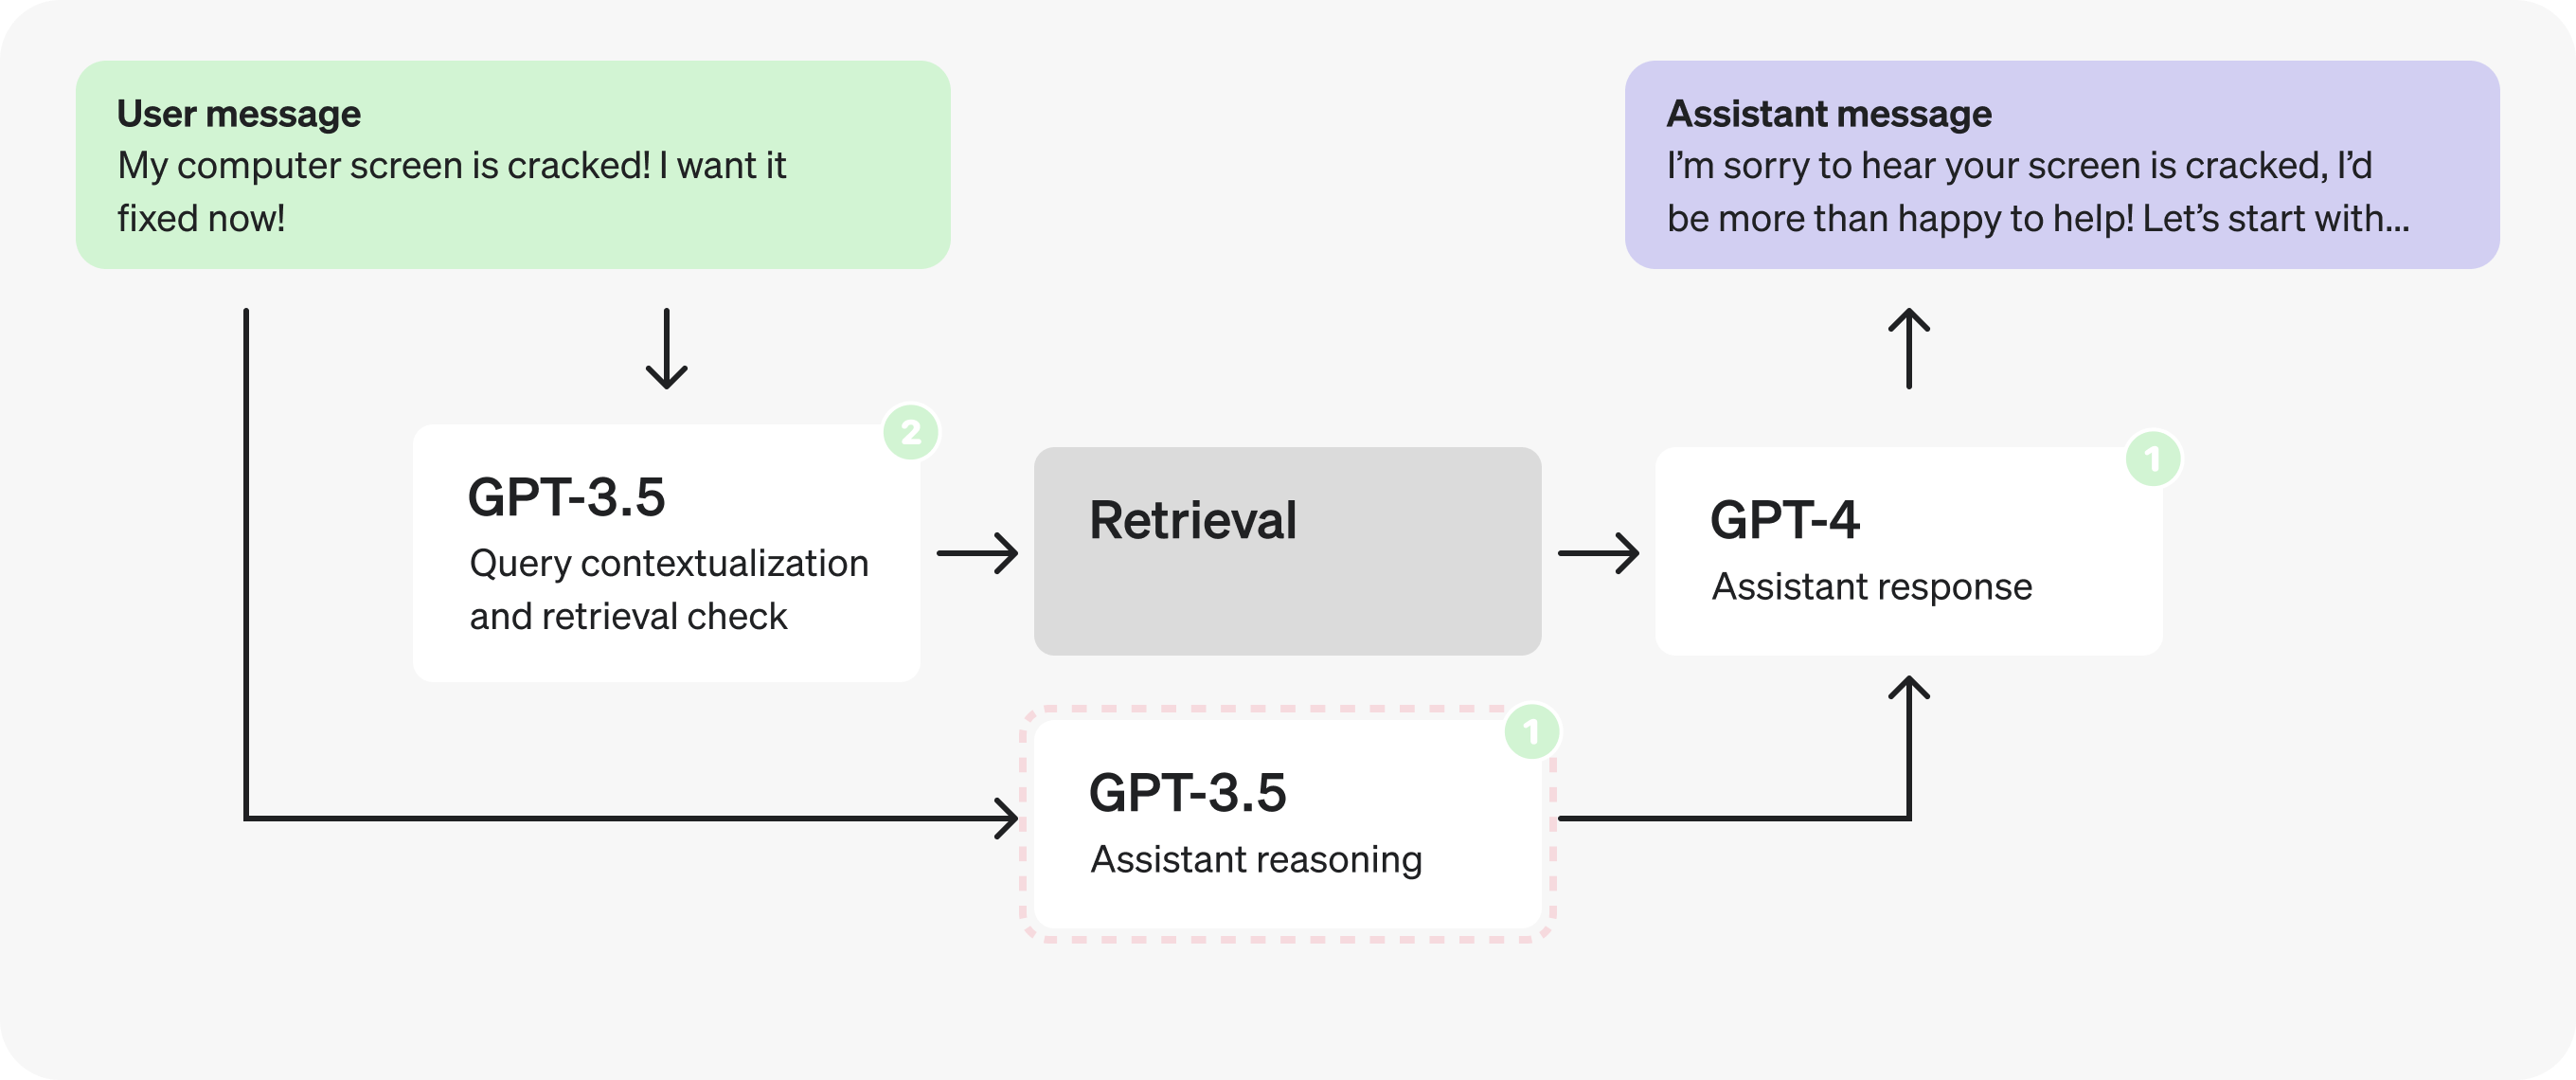
Observe no JSON de raciocínio que os próprios nomes dos campos são bastante longos.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
};Se encurtarmos esses nomes e movermos as explicações para os comentários, podemos gerar menos tokens.
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
};
Essa pequena mudança eliminou 19 tokens de saída. Com o GPT-3.5, isso talvez reduza a latência em apenas alguns milissegundos. Com o GPT-4, a redução pode chegar a um segundo.
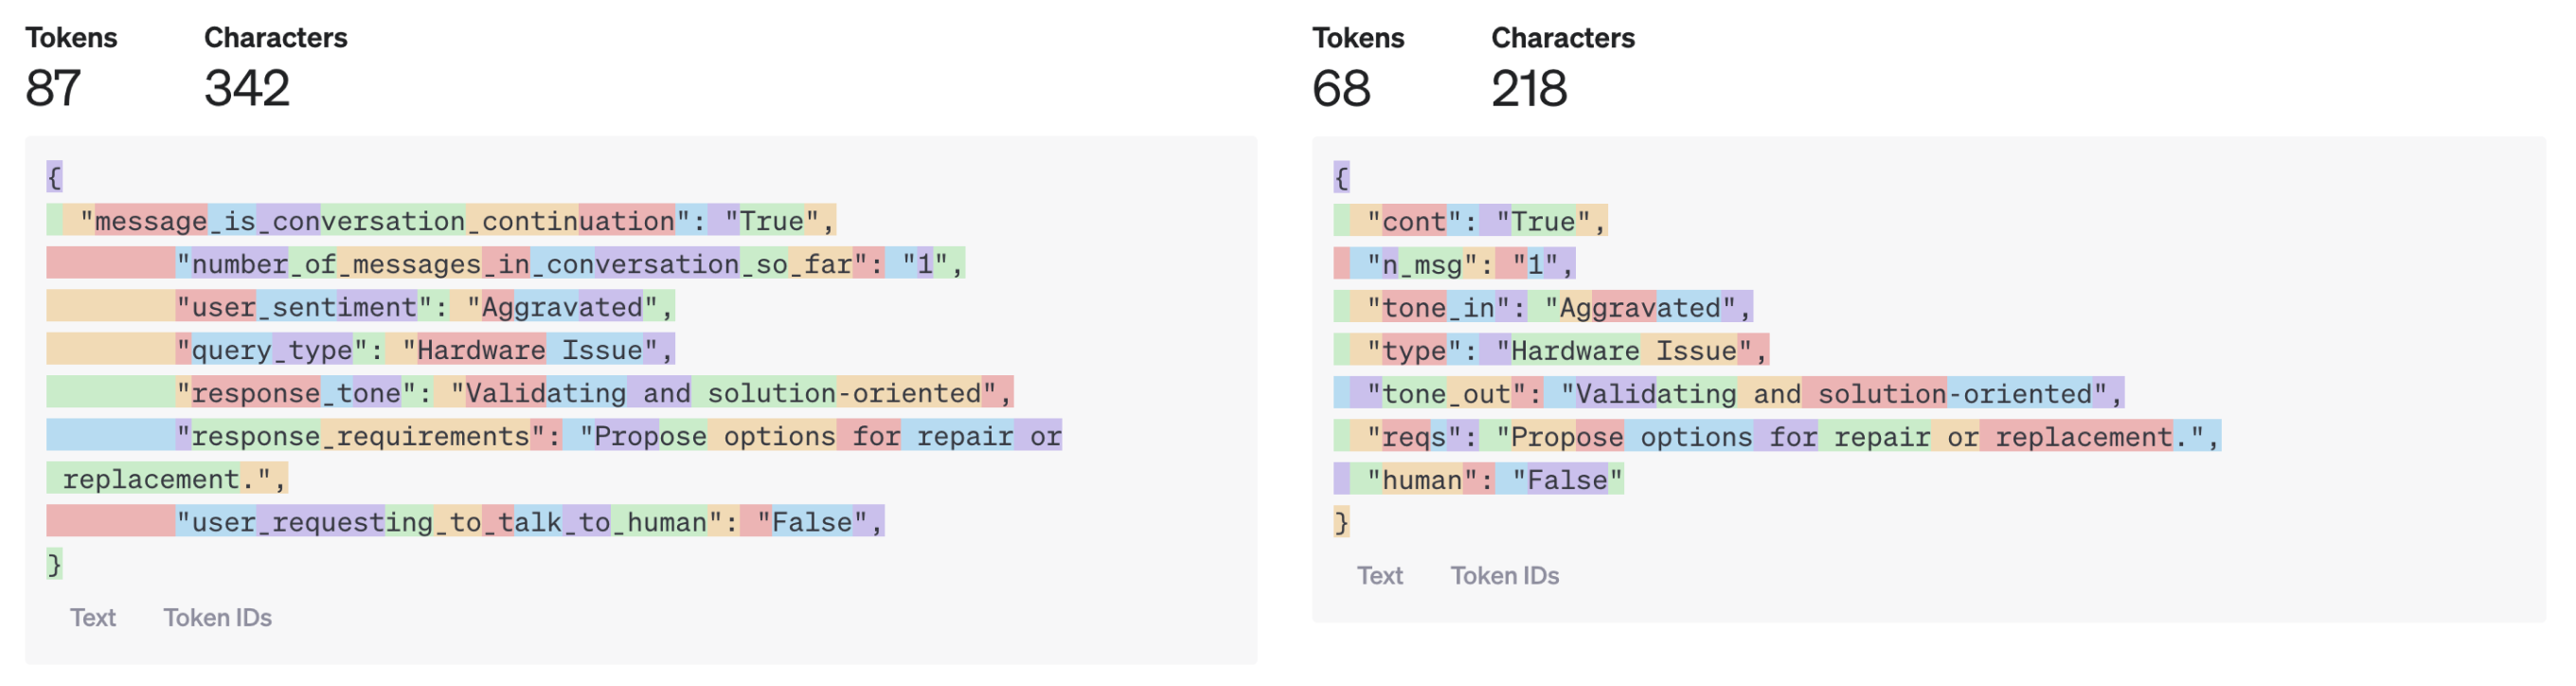
Quando o modelo gera saídas maiores, o impacto dessa técnica pode ser considerável.
Poderíamos ir além e usar apenas um caractere como nome de cada campo do JSON ou colocar tudo em um array. Porém, essas mudanças podem começar a prejudicar a qualidade das respostas. Mais uma vez, a melhor forma de saber é testar.
Resumo do exemplo
Vamos recapitular as otimizações que aplicamos ao bot de atendimento ao cliente:
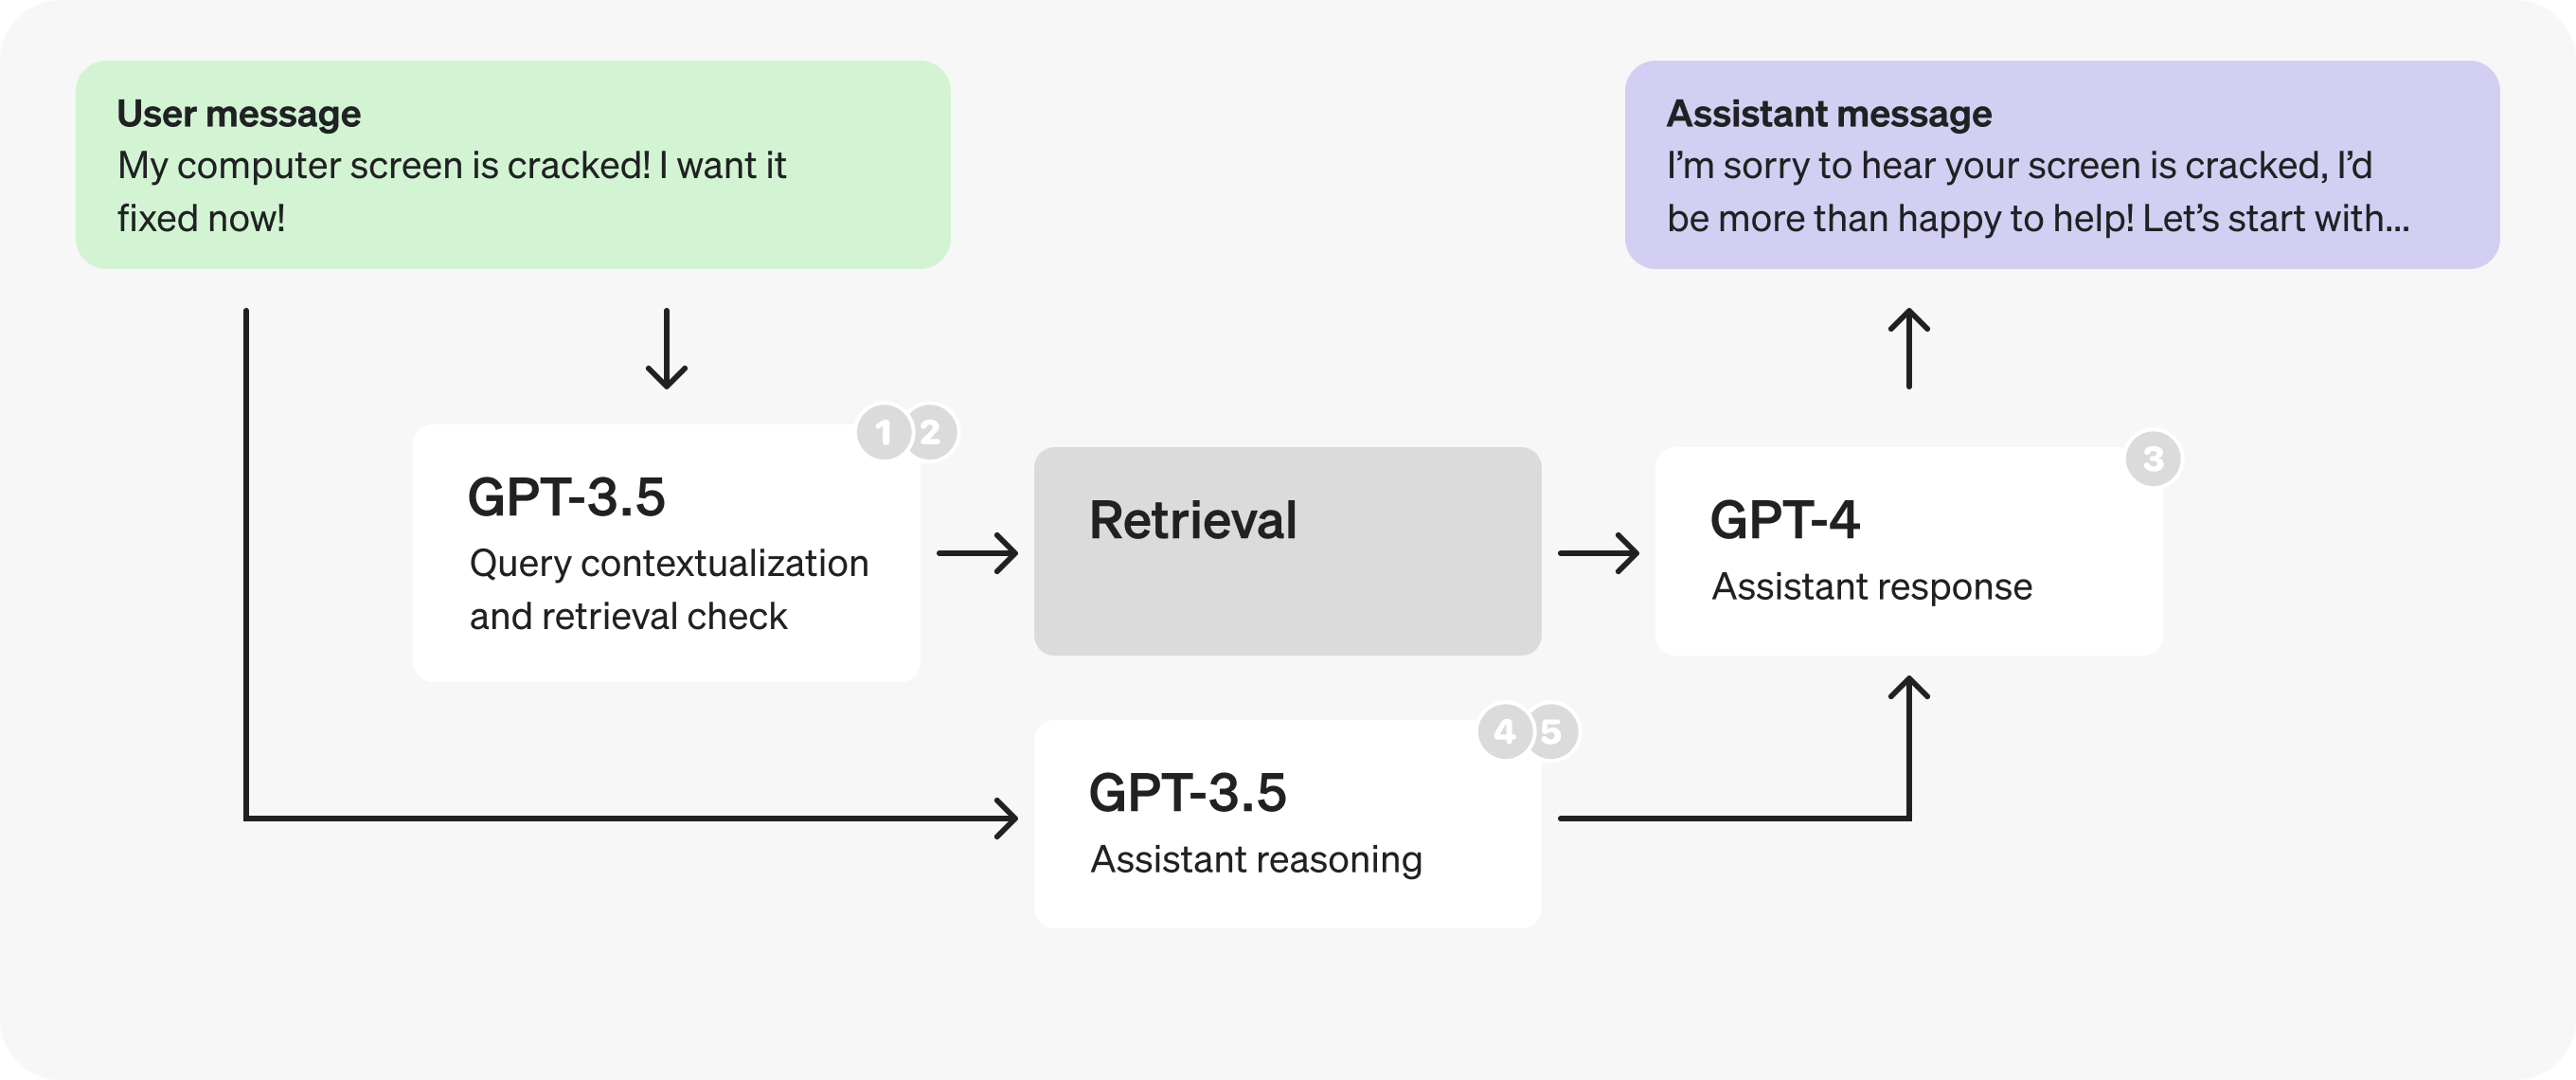
- Combinamos a contextualização da consulta e a verificação da necessidade de busca para fazer menos requisições.
- Para o novo prompt, passamos a usar o GPT-3.5 com ajuste fino, um modelo menor, para processar tokens mais rápido.
- Dividimos o prompt do assistente em dois e passamos a usar o GPT-3.5 com ajuste fino, um modelo menor, para o raciocínio, também com o objetivo de processar tokens mais rápido.
- Executamos em paralelo as verificações da necessidade de busca e as etapas de raciocínio.
- Encurtamos os nomes dos campos de raciocínio e movemos os comentários para o prompt para gerar menos tokens.