Aprenda a gerenciar o estado da conversa durante uma interação com o modelo.
Responses
A OpenAI oferece algumas formas de gerenciar o estado da conversa, o que é importante para preservar informações ao longo de várias mensagens ou turnos de uma conversa.
Ao investigar casos em que o GPT-5.5 trata uma atualização intermediária como
a resposta final, verifique se sua integração preserva corretamente o campo
phase da mensagem do assistente. Consulte Parâmetro
de fase para mais detalhes.
Gerenciar manualmente o estado da conversa
Embora cada requisição de geração de texto seja independente e não mantenha estado, você ainda pode implementar conversas com vários turnos fornecendo mensagens adicionais como parâmetros da requisição de geração de texto. Considere uma piada de “toc-toc”:
Ao alternar mensagens user e assistant, você registra o estado anterior de uma conversa em uma única requisição ao modelo.
Para compartilhar manualmente o contexto entre as respostas geradas, inclua a saída da resposta anterior do modelo como entrada e acrescente essa entrada à próxima requisição.
Em requisições sem estado a modelos de raciocínio, preserve todos os itens do array output da resposta. A Responses API retorna itens de raciocínio criptografados por padrão. Reenviar a saída completa mantém intactos os itens de raciocínio e os valores de phase do assistente. Modelos que oferecem suporte à persistência de raciocínio podem usar reasoning.context: "all_turns" para incluir o raciocínio disponível de turnos anteriores na próxima amostra. Consulte Preservar o raciocínio entre chamadas.
No exemplo a seguir, pedimos ao modelo que conte uma piada e depois solicitamos outra. Acrescentar respostas anteriores a novas requisições dessa forma ajuda a manter a naturalidade das conversas e a preservar o contexto das interações anteriores.
Gerenciar manualmente o estado da conversa com a API chat completions.
Nossas APIs facilitam o gerenciamento automático do estado da conversa, para que você não precise passar as entradas manualmente a cada turno.
Recomendamos usar a Responses API como alternativa. Como ela mantém estado, basta um parâmetro para gerenciar o contexto entre conversas.
Se você estiver usando o endpoint Chat Completions, precisará gerenciar o estado manualmente, conforme documentado acima.
Usar a Conversations API
A Conversations API funciona em conjunto com a Responses API para persistir o estado da conversa como um objeto de longa duração com seu próprio identificador durável. Depois de criar um objeto de conversa, você pode continuar usando-o em diferentes sessões, dispositivos ou tarefas.
As conversas armazenam itens, que podem ser mensagens, chamadas de ferramentas, saídas de ferramentas e outros dados.
Em uma interação com vários turnos, você pode passar conversation nas respostas seguintes para persistir o estado e compartilhar o contexto entre elas, em vez de precisar encadear vários itens de resposta.
Gerenciar o estado da conversa com as APIs Conversations e Responses
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Passar o contexto da resposta anterior
Outra forma de gerenciar o estado da conversa é compartilhar o contexto entre as respostas geradas usando o parâmetro previous_response_id. Esse parâmetro permite encadear respostas e criar uma conversa com mensagens interligadas.
Encadear respostas entre turnos passando o ID da resposta anterior
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
No exemplo a seguir, pedimos ao modelo que conte uma piada. Em uma requisição separada, pedimos que explique por que ela é engraçada, e o modelo tem todo o contexto necessário para dar uma boa resposta.
Gerenciar manualmente o estado da conversa com a Responses API
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id no modo WebSocket
Se você estiver usando o modo WebSocket da Responses API, a continuação usa a mesma semântica de previous_response_id do modo HTTP, mas por meio de um socket persistente com eventos response.create repetidos.
O cache local da conexão mantém as respostas anteriores recentes na memória para permitir a continuação com baixa latência. Ao usar stream_id, cada canal pode reter sua resposta mais recente; previous_response_id continua controlando a linhagem, de modo que um novo canal pode se ramificar a partir de uma resposta de outro canal enquanto ela permanecer disponível. Se não for possível resolver um ID ausente do cache, envie um novo turno com previous_response_id definido como null e passe todo o contexto de entrada.
Os objetos de resposta são salvos por 30 dias por padrão. Eles podem ser visualizados na página de
logs do painel ou
recuperados pela API.
Você pode desativar esse comportamento definindo store como false
ao criar uma Response.
Os objetos de conversa e os itens contidos neles não estão sujeitos ao TTL de 30 dias. Os itens de qualquer resposta vinculada a uma conversa serão persistidos sem o TTL de 30 dias.
A OpenAI não usa dados enviados pela API para treinar nossos modelos sem seu consentimento explícito. Saiba mais.
Mesmo ao usar previous_response_id, todos os tokens de entrada anteriores das respostas na cadeia são cobrados como tokens de entrada na API.
Gerenciar a janela de contexto
Entender as janelas de contexto ajudará você a criar conversas com mensagens interligadas e a gerenciar o estado entre interações com o modelo.
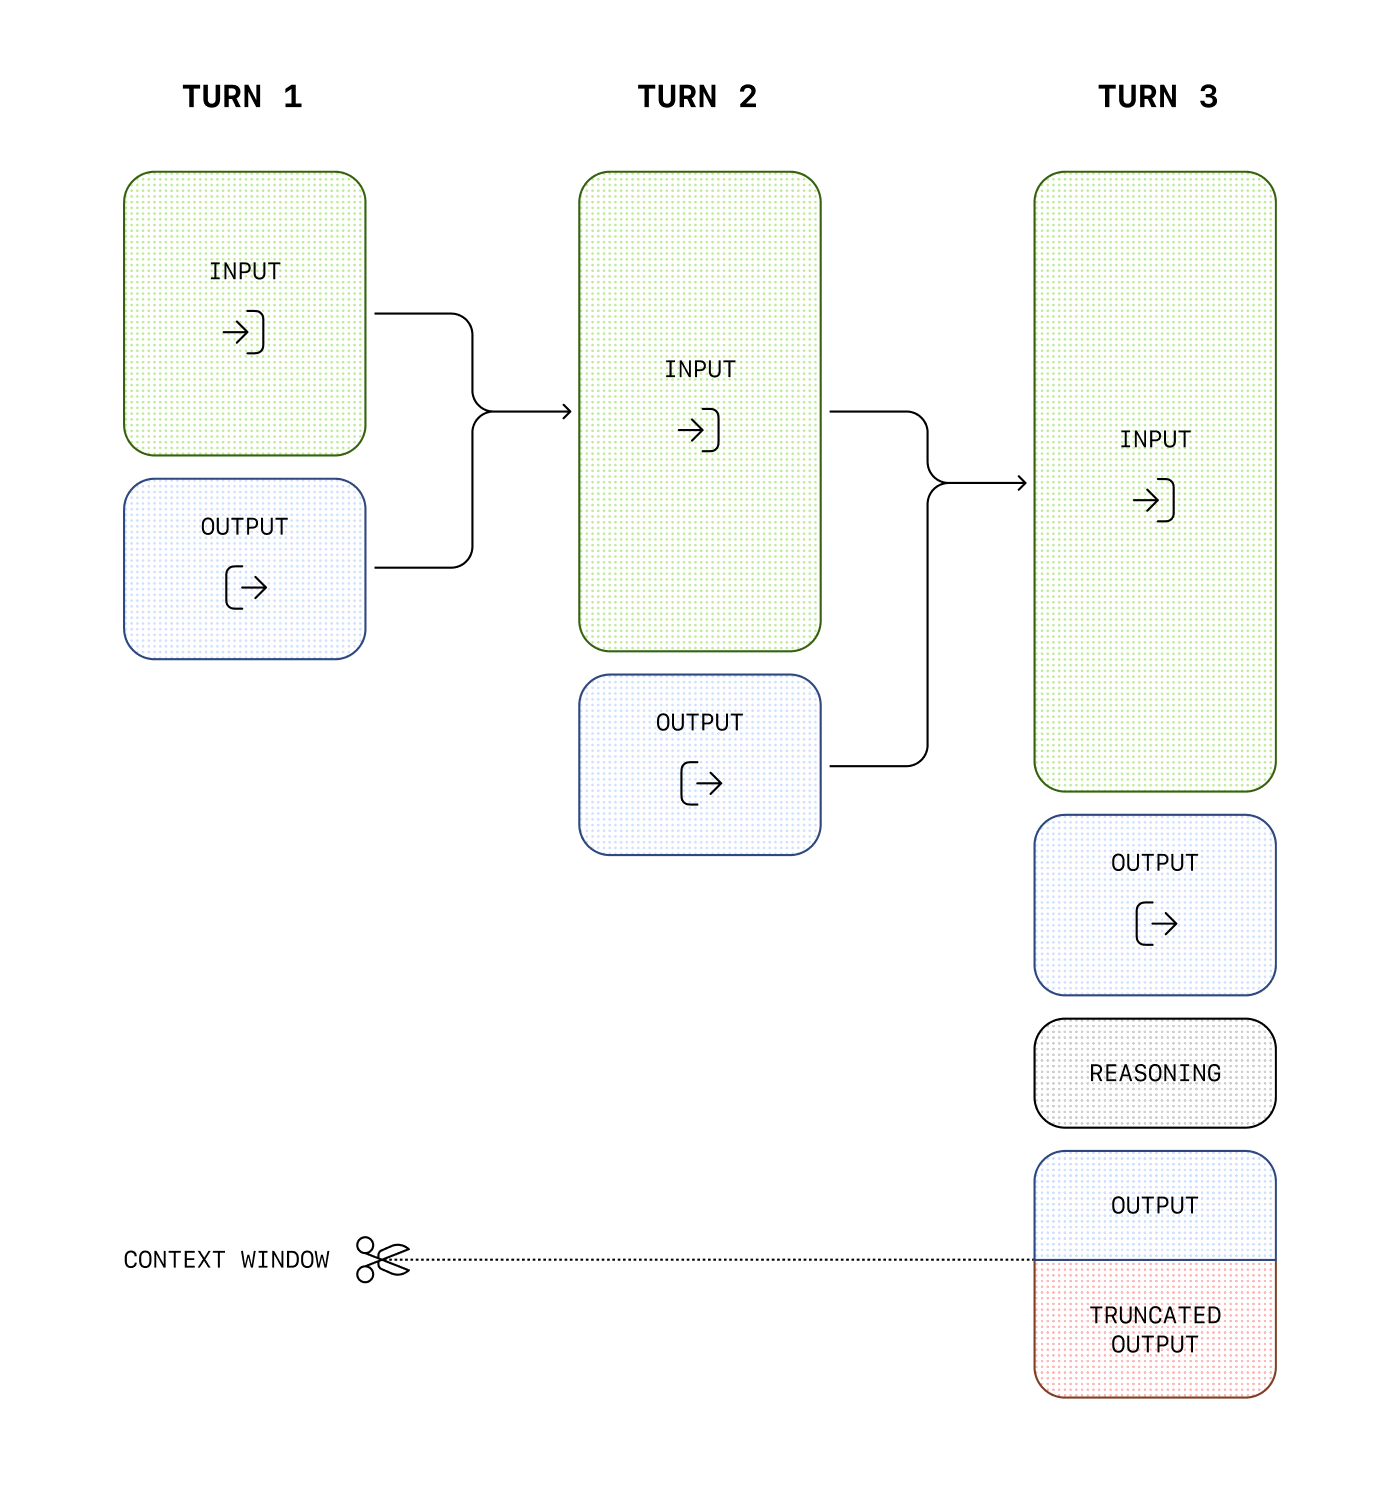
A janela de contexto é o número máximo de tokens que podem ser usados em uma única requisição. Esse limite inclui tokens de entrada, de saída e de raciocínio. Para saber qual é a janela de contexto do seu modelo, consulte os detalhes do modelo.
Gerenciar o contexto para geração de texto
À medida que suas entradas se tornam mais complexas ou você inclui mais turnos em uma conversa, é preciso considerar tanto os limites de tokens de saída quanto os da janela de contexto . As entradas e saídas do modelo são medidas em tokens, extraídos das entradas para analisar seu conteúdo e sua intenção e combinados para produzir saídas lógicas. Os modelos têm limites de uso de tokens durante o ciclo de vida de uma requisição de geração de texto.
Tokens de saída são os tokens gerados por um modelo em resposta a um prompt. Cada modelo tem limites diferentes para tokens de saída. Por exemplo, gpt-4o-2024-08-06 pode gerar no máximo 16.384 tokens de saída.
Uma janela de contexto descreve o total de tokens que podem ser usados para entrada e saída (e, em alguns modelos, para tokens de raciocínio). Compare os limites da janela de contexto dos nossos modelos. Por exemplo, gpt-4o-2024-08-06 tem uma janela de contexto total de 128 mil tokens.
Se você criar um prompt extenso, muitas vezes por incluir contexto, dados ou exemplos adicionais para o modelo, corre o risco de ultrapassar a janela de contexto disponível para ele, o que pode resultar em saídas truncadas.
Por exemplo, ao fazer uma requisição de API ao Chat Completions com o modelo o1, as seguintes contagens de tokens serão consideradas no total da janela de contexto:
Tokens de entrada (entradas que você inclui no array messages com Chat Completions)
Tokens de saída (tokens gerados em resposta ao seu prompt)
Tokens de raciocínio (usados pelo modelo para planejar uma resposta)
Por exemplo, ao fazer uma solicitação à Responses API com um modelo com raciocínio habilitado, como o modelo o1, as seguintes contagens de tokens serão consideradas no total da janela de contexto:
Tokens de entrada (entradas que você inclui no array input para a Responses API)
Tokens de saída (tokens gerados em resposta ao seu prompt)
Tokens de raciocínio (usados pelo modelo para planejar uma resposta)
Os tokens gerados que excederem o limite da janela de contexto poderão ser truncados nas respostas da API.
Para ver exemplos e casos de uso mais específicos, acesse o OpenAI Cookbook ou saiba mais sobre como usar as APIs para ampliar as capacidades dos modelos: