
A OpenAI oferece dois tipos de modelos: modelos de raciocínio (como o3 e o4-mini) e modelos GPT (como GPT-4.1). Essas famílias de modelos se comportam de maneiras diferentes.
Neste guia, você vai aprender:
- Qual é a diferença entre nossos modelos de raciocínio e os modelos GPT sem raciocínio
- Quando usar nossos modelos de raciocínio
- Como escrever prompts eficazes para modelos de raciocínio
Saiba mais sobre os modelos de raciocínio e como eles funcionam.
Modelos de raciocínio e modelos GPT
Os modelos da série o se destacam em tarefas diferentes das que os modelos GPT executam melhor e exigem prompts diferentes. Cada família tem suas características, e nenhuma é superior à outra em tudo.
Treinamos os modelos da série o (os “planejadores”) para dedicar mais tempo e esforço de raciocínio a tarefas complexas. Por isso, eles são eficazes na hora de traçar estratégias, planejar soluções para problemas complexos e tomar decisões com base em grandes volumes de informações ambíguas. Esses modelos também conseguem executar tarefas com alto grau de exatidão e precisão, o que os torna ideais para áreas que, de outra forma, exigiriam um especialista humano, como matemática, ciências, engenharia e serviços financeiros e jurídicos.
Já os modelos GPT (os “executores”) têm menor latência e melhor relação custo-benefício e foram projetados para executar tarefas de forma direta. Um aplicativo pode usar modelos da série o para definir a estratégia de solução de um problema e modelos GPT para executar tarefas específicas, principalmente quando a velocidade e o custo importam mais do que a exatidão absoluta.
Como escolher
O que mais importa para o seu caso de uso?
- Velocidade e custo → Os modelos GPT são mais rápidos e tendem a custar menos
- Execução de tarefas bem definidas → Os modelos GPT executam bem tarefas definidas de forma explícita
- Exatidão e confiabilidade → Os modelos da série o tomam decisões confiáveis
- Resolução de problemas complexos → Os modelos da série o conseguem lidar com ambiguidades e situações complexas
Se a velocidade e o custo são os fatores mais importantes na execução das suas tarefas e seu caso de uso consiste em tarefas simples e bem definidas, os modelos GPT são a melhor escolha. Se a exatidão e a confiabilidade são os fatores mais importantes e você precisa resolver um problema muito complexo, com várias etapas, os modelos da série o provavelmente são os mais adequados.
A maioria dos fluxos de trabalho de IA usará as duas famílias de modelos em conjunto: a série o para planejamento e tomada de decisões com agentes de IA e a série GPT para execução de tarefas.
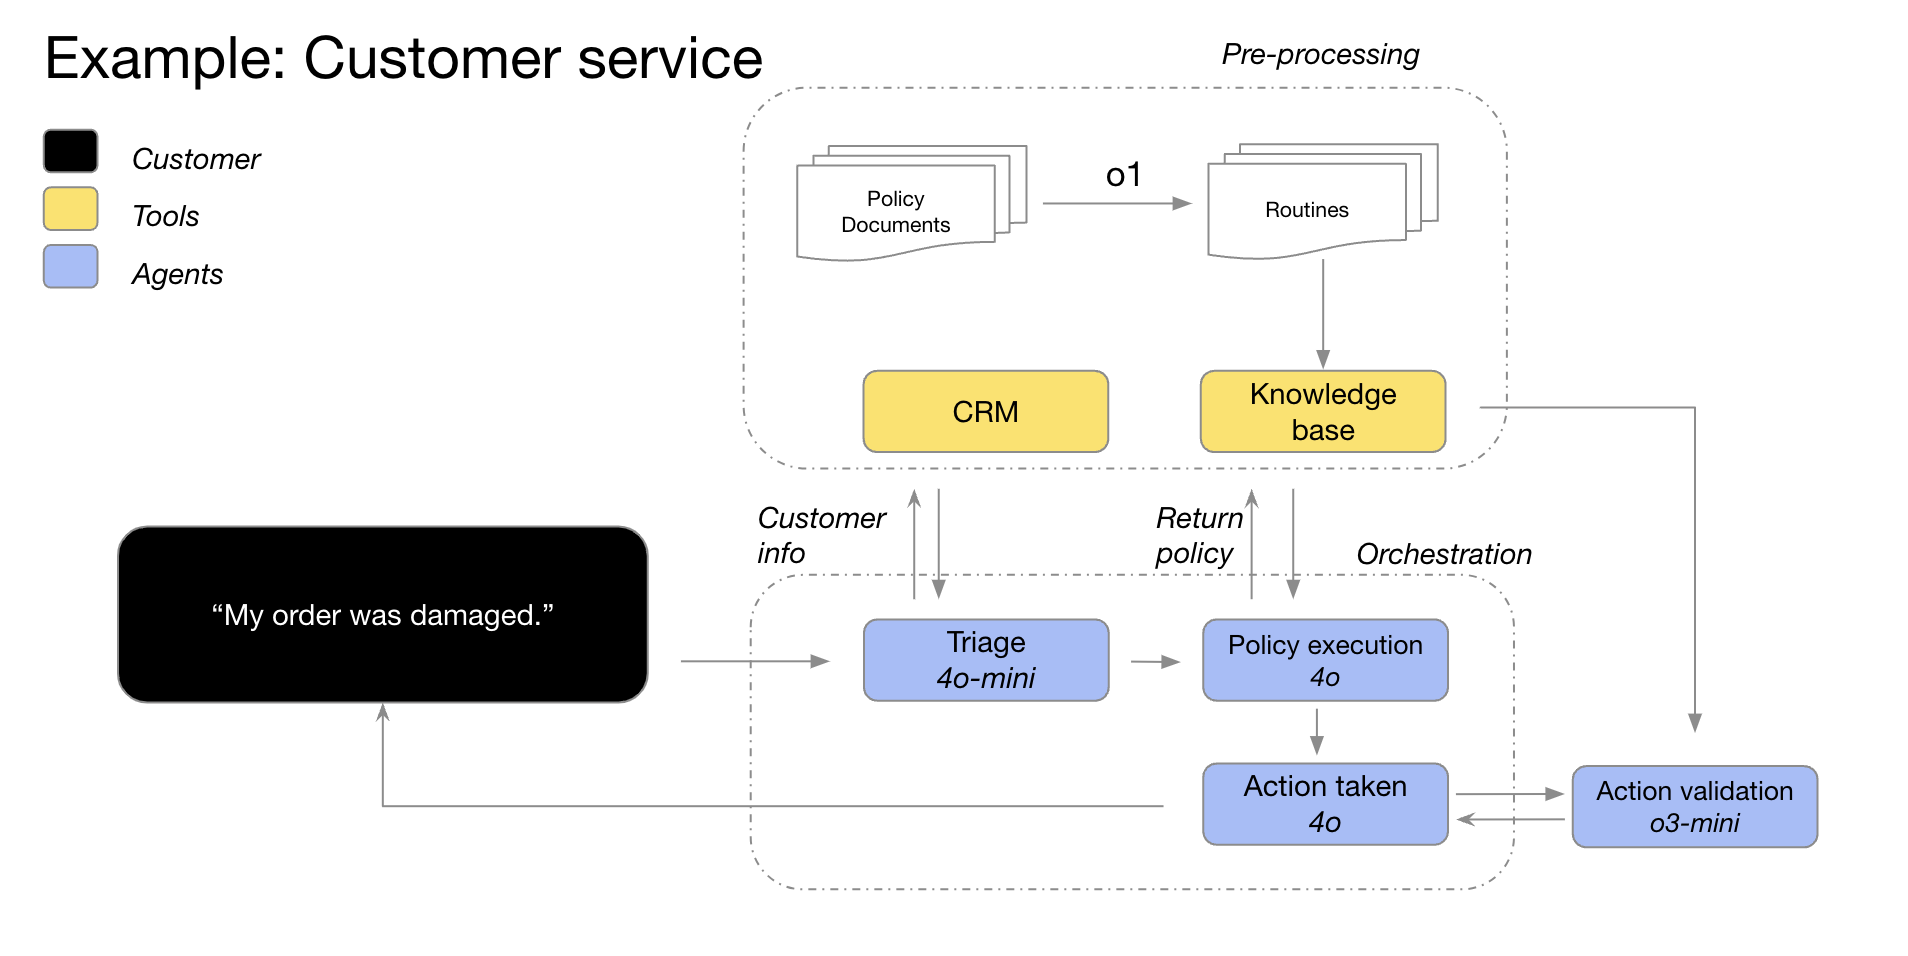
Nossos modelos GPT-4o e GPT-4o mini fazem a triagem dos detalhes do pedido usando as informações do cliente, identificam os problemas com o pedido e a política de devolução aplicável e enviam todos esses dados ao o3-mini. Com base na política, o o3-mini decide se a devolução pode ser aceita.
Quando usar nossos modelos de raciocínio
A seguir, apresentamos algumas formas de usar esses modelos que deram bons resultados entre nossos clientes e na própria OpenAI. São orientações práticas para testar os modelos da série o, sem a pretensão de cobrir todos os casos de uso possíveis.
Quer usar um modelo de raciocínio? Vá para o guia de início rápido →
1. Lidar com tarefas ambíguas
Mesmo quando há poucas informações ou os dados estão dispersos, os modelos de raciocínio conseguem, com um prompt simples, entender a intenção do usuário e lidar com lacunas nas instruções. Muitas vezes, esses modelos fazem perguntas para esclarecer dúvidas antes de arriscar um palpite sem fundamento ou tentar preencher as lacunas por conta própria.
“Com os recursos de raciocínio do o1, nossa plataforma multiagente Matrix produz respostas abrangentes, bem formatadas e detalhadas ao processar documentos complexos. Por exemplo, com um prompt básico, o o1 permitiu que a Matrix identificasse facilmente, em um contrato de crédito, quais limites estavam disponíveis para as diferentes categorias de pagamentos restritos. Nenhum dos modelos anteriores teve um desempenho tão bom. Em comparação com outros modelos, o o1 apresentou resultados melhores em 52% dos prompts complexos sobre contratos de crédito densos.”
—Hebbia, empresa que oferece uma plataforma de conhecimento com IA para os setores jurídico e financeiro
2. Encontrar uma agulha no palheiro
Quando você fornece um grande volume de informações não estruturadas, os modelos de raciocínio conseguem interpretar esse material e extrair apenas as informações mais relevantes para responder a uma pergunta.
“Para analisar a aquisição de uma empresa, o o1 examinou dezenas de documentos, incluindo contratos comerciais e de locação, em busca de condições que pudessem complicar a negociação. Pedimos ao modelo que destacasse as cláusulas mais importantes. Ele identificou nas notas de rodapé uma cláusula decisiva de ‘mudança de controle’: se a empresa fosse vendida, teria de quitar imediatamente um empréstimo de US$ 75 milhões. Com a atenção do o1 aos detalhes, nossos agentes de IA conseguem identificar informações cruciais para os profissionais do setor financeiro.”
—Endex, plataforma de inteligência financeira com IA
3. Identificar relações e nuances em um grande conjunto de dados
Observamos que os modelos de raciocínio são especialmente bons em analisar documentos complexos com centenas de páginas de informações densas e não estruturadas, como contratos jurídicos, demonstrações financeiras e pedidos de indenização de seguros. Eles se destacam ao traçar paralelos entre documentos e tomar decisões com base em fatos implícitos nos dados.
“A pesquisa tributária exige reunir informações de vários documentos para chegar a uma resposta final bem fundamentada. Substituímos o GPT-4o pelo o1 e vimos que o o1 analisava muito melhor as relações entre os documentos e chegava a conclusões lógicas que não eram evidentes em nenhum deles isoladamente. Com a mudança para o o1, o desempenho do processo como um todo quadruplicou. Incrível.”
—Blue J, plataforma de IA para pesquisa tributária
Os modelos de raciocínio também sabem interpretar as nuances de políticas e regras e aplicá-las à tarefa em questão para chegar a uma conclusão razoável.
“Em análises financeiras, os analistas frequentemente lidam com cenários complexos que envolvem a participação dos acionistas e precisam entender os detalhes jurídicos relevantes. Testamos cerca de dez modelos de diferentes fornecedores com uma pergunta difícil, mas comum: como uma captação de recursos afeta os acionistas atuais, especialmente quando eles exercem seus direitos de proteção contra diluição? Para responder, era preciso analisar o valor da empresa antes e depois do aporte e resolver cálculos de diluição com dependências circulares. Mesmo os melhores analistas financeiros levariam de 20 a 30 minutos para resolver isso. Descobrimos que o o1 e o o3-mini conseguem fazer tudo isso sem erros! Os modelos chegaram a montar uma tabela de cálculos que mostrava claramente o impacto para um acionista com participação de US$ 100 mil.”
–BlueFlame AI, plataforma de IA para gestão de investimentos
4. Planejar várias etapas com agentes de IA
Os modelos de raciocínio são essenciais para o planejamento com agentes de IA e para a elaboração de estratégias. Tivemos bons resultados ao usar um modelo de raciocínio como “planejador”. Ele elabora uma solução detalhada em várias etapas e atribui cada etapa ao modelo GPT (o “executor”) mais adequado, conforme o que importa mais naquele momento: maior capacidade de análise ou menor latência.
“Usamos o o1 como planejador na infraestrutura dos nossos agentes. Ele coordena os outros modelos no fluxo de trabalho para concluir tarefas com várias etapas. O o1 é muito bom em selecionar tipos de dados e dividir questões amplas em perguntas menores, o que permite aos outros modelos se concentrarem na execução.”
—Argon AI, plataforma de conhecimento com IA para a indústria farmacêutica
“O o1 está por trás de muitos dos fluxos de trabalho com agentes de IA da Lindy, nossa assistente de IA para o trabalho. O modelo usa a chamada de função para buscar informações na sua agenda ou no seu e-mail. Com elas, pode ajudar você automaticamente a agendar reuniões, enviar e-mails e gerenciar outras tarefas do dia a dia. Passamos a usar o o1 em todas as etapas com agentes de IA que costumavam dar problema e vimos nossos agentes passarem a funcionar praticamente sem falhas de um dia para o outro!”
—Lindy.AI, assistente de IA para o trabalho
5. Raciocínio visual
Atualmente, o o1 é o único modelo de raciocínio com recursos de visão. O que o diferencia do GPT-4o é a capacidade de interpretar até mesmo imagens difíceis de analisar, como gráficos e tabelas com estrutura ambígua ou fotos de baixa qualidade.
“Automatizamos as análises de risco e conformidade de milhões de produtos vendidos online, incluindo imitações de joias de luxo, espécies ameaçadas de extinção e substâncias controladas. O GPT-4o alcançou 50% de acurácia nas nossas tarefas mais difíceis de classificação de imagens. O o1 atingiu impressionantes 88% de acurácia sem que precisássemos modificar nenhuma etapa do processamento.”
—SafetyKit, plataforma de risco e conformidade baseada em IA
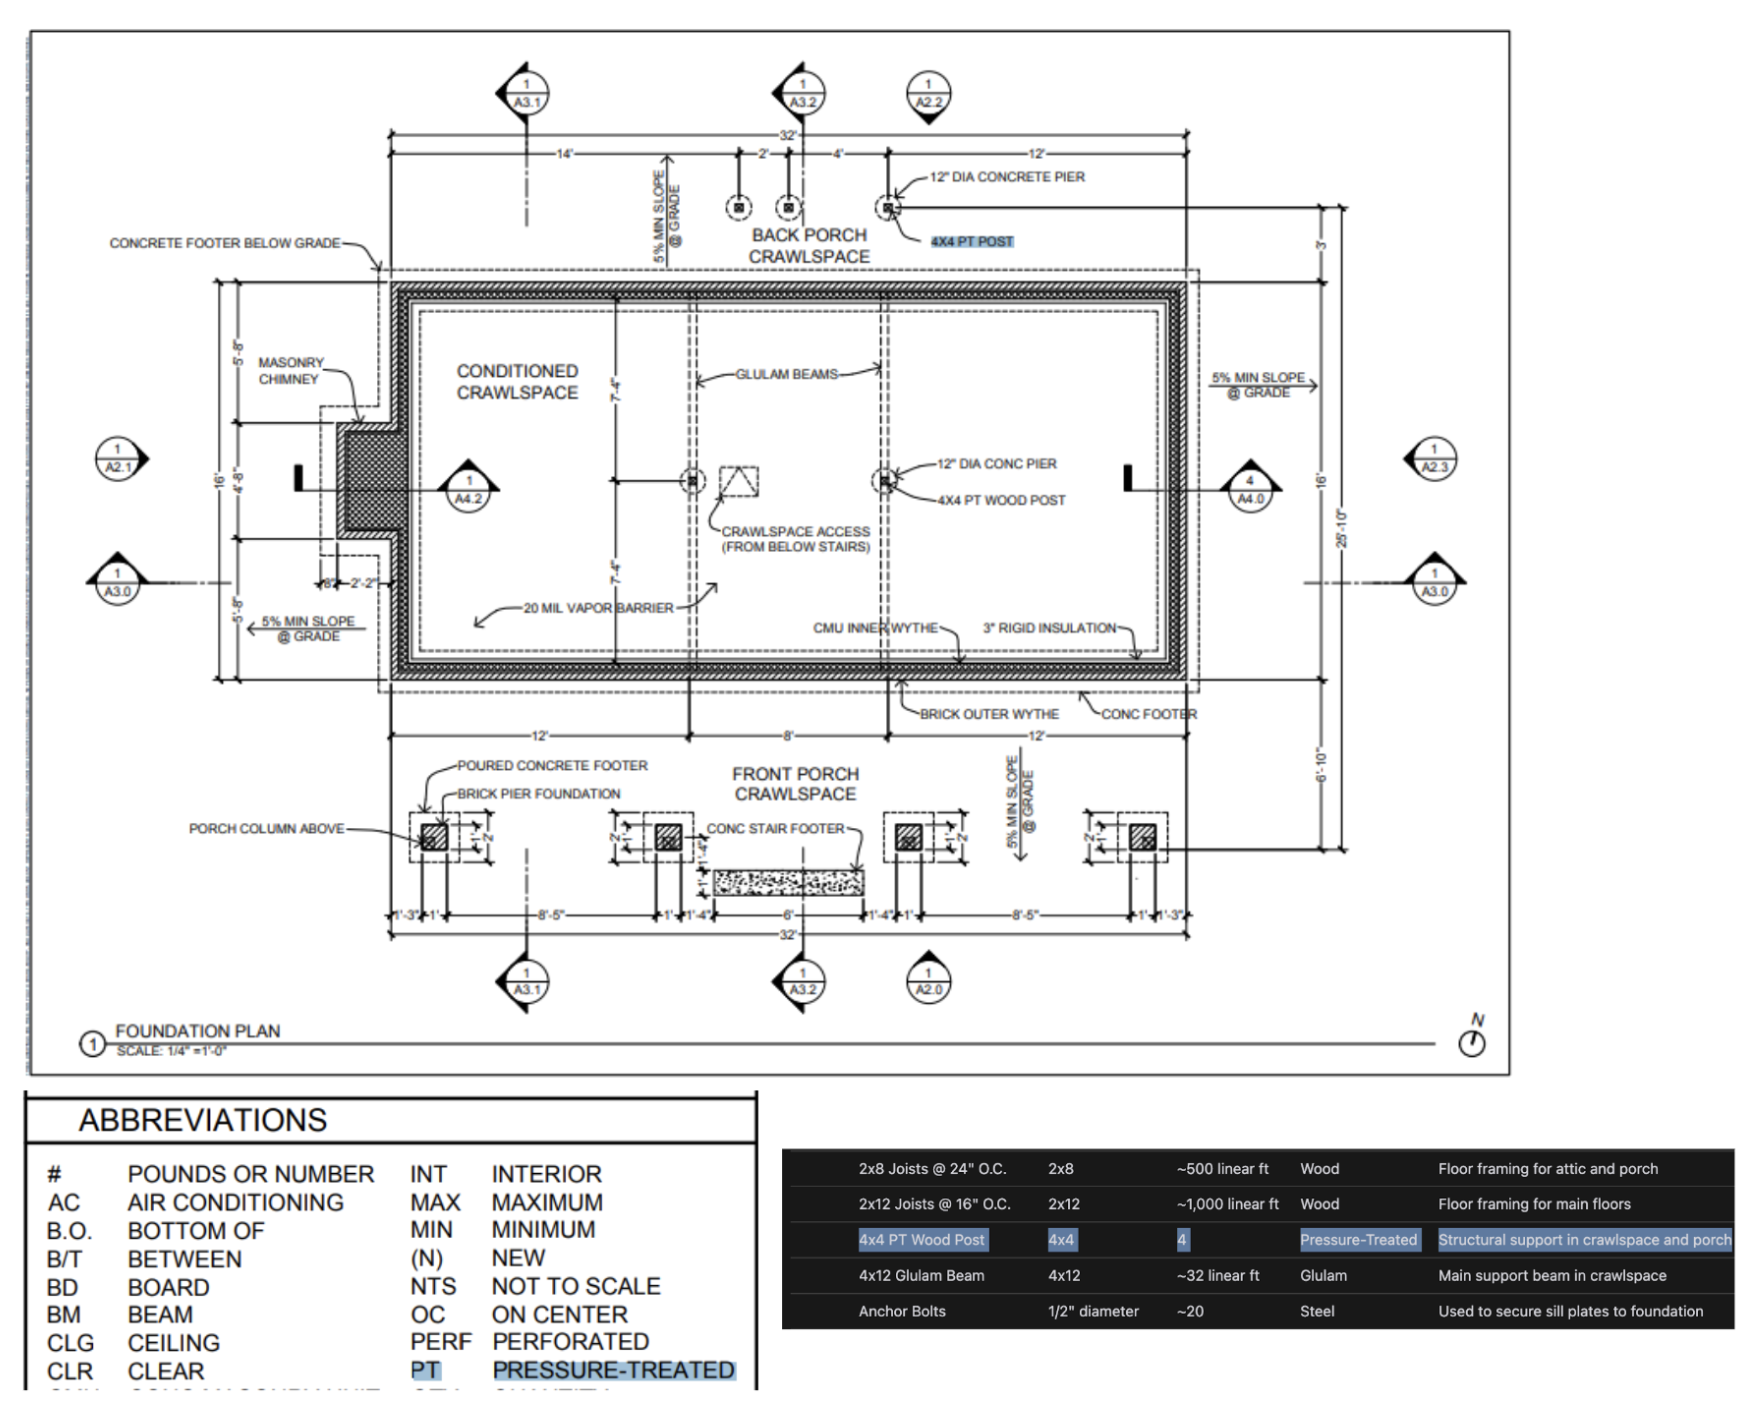
Em testes internos, observamos que o o1 consegue identificar instalações e materiais em desenhos arquitetônicos muito detalhados e gerar uma lista completa de materiais. Uma das descobertas mais surpreendentes foi que o o1 consegue relacionar imagens diferentes: ele interpreta a legenda de uma página do projeto arquitetônico e a aplica corretamente a outra, sem instruções explícitas. No exemplo abaixo, o o1 usou a legenda para identificar que, na indicação dos pilares de madeira 4x4 PT, “PT” significa que a madeira foi tratada sob pressão.
6. Revisar, depurar e melhorar a qualidade do código
Os modelos de raciocínio são especialmente eficazes para revisar e melhorar grandes volumes de código. Como têm maior latência, é comum executar essas revisões em segundo plano.
“Oferecemos revisões automatizadas de código com IA em plataformas como GitHub e GitLab. Em geral, a revisão de código não é sensível à latência, mas exige entender as diferenças entre versões do código em vários arquivos. É aí que o o1 se destaca: ele detecta de forma confiável pequenas mudanças na base de código que poderiam passar despercebidas em uma revisão humana. Depois que passamos a usar os modelos da série o, conseguimos triplicar as taxas de conversão do produto.”
—CodeRabbit, startup de revisão de código com IA
A menor latência do GPT-4o e do GPT-4o mini pode torná-los mais adequados para escrever código. Ainda assim, observamos que o o3-mini também se destaca na geração de código em casos de uso um pouco menos sensíveis à latência.
“O o3-mini produz de forma consistente código de alta qualidade que resolve o problema. Quando o problema é bem definido, o modelo chega à solução correta com muita frequência, mesmo em tarefas de programação bastante difíceis. Enquanto outros modelos podem ser úteis apenas para fazer ajustes rápidos e pontuais no código, o o3-mini se destaca tanto no planejamento quanto na implementação de projetos complexos de software.”
—Windsurf, IDE colaborativo baseado em IA agêntica, desenvolvido pela Codeium
7. Avaliar e comparar o desempenho das respostas de outros modelos
Também observamos bons resultados ao usar modelos de raciocínio para avaliar respostas de outros modelos e comparar seu desempenho. Validar os dados é importante para garantir a qualidade e a confiabilidade dos conjuntos de dados, especialmente em áreas sensíveis como a saúde. Os métodos tradicionais de validação usam regras e padrões predefinidos. Já modelos avançados, como o o1 e o o3-mini, conseguem entender o contexto e raciocinar sobre os dados, o que torna a validação mais flexível e inteligente.
“Muitos clientes usam um LLM como avaliador em parte do processo de avaliação na Braintrust. Por exemplo, uma empresa da área da saúde pode usar um modelo executor como o gpt-4o para resumir perguntas de pacientes e depois avaliar a qualidade do resumo com o o1. Um cliente da Braintrust viu a pontuação F1 do avaliador passar de 0,12 com o 4o para 0,74 com o o1! Nesses casos, os clientes perceberam que o raciocínio do o1 faz toda a diferença na hora de identificar diferenças sutis entre as respostas geradas nas tarefas de avaliação mais difíceis e complexas.”
—Braintrust, plataforma de avaliação de IA
Como escrever prompts eficazes para modelos de raciocínio
Esses modelos apresentam os melhores resultados com prompts diretos. Algumas técnicas de engenharia de prompt, como pedir ao modelo que “pense passo a passo”, podem não melhorar o desempenho e, às vezes, até prejudicá-lo. Confira as boas práticas abaixo ou comece pelos exemplos de prompts.
- As mensagens de desenvolvedor substituem as mensagens de sistema: A partir do
o1-2024-12-17, os modelos de raciocínio aceitam mensagens de desenvolvedor no lugar de mensagens de sistema para seguir a hierarquia de instruções descrita na especificação do modelo. - Use prompts simples e diretos: Os modelos entendem bem instruções breves e claras e respondem bem a elas.
- Evite prompts de cadeia de pensamento: Como esses modelos raciocinam internamente, é desnecessário incluir instruções como “pense passo a passo” ou “explique seu raciocínio”.
- Use delimitadores para dar clareza: Use recursos como Markdown, tags XML e títulos de seção para distinguir as partes da entrada e ajudar o modelo a interpretar cada seção corretamente.
- Comece com zero-shot e use few-shot se necessário: Os modelos de raciocínio costumam produzir bons resultados sem exemplos few-shot. Por isso, tente primeiro escrever o prompt sem exemplos. Se os requisitos para a saída forem mais complexos, pode ser útil incluir no prompt alguns exemplos de entradas e das saídas desejadas. Verifique se os exemplos correspondem de perto às instruções do prompt. Divergências entre eles podem comprometer os resultados.
- Dê orientações específicas: Se quiser impor limites à resposta do modelo (por exemplo, “proponha uma solução com orçamento inferior a US$ 500”), indique esses limites explicitamente no prompt.
- Descreva com precisão o objetivo final: Nas instruções, defina parâmetros bem específicos para uma resposta satisfatória e incentive o modelo a continuar raciocinando e refinando a resposta até atender aos seus critérios de sucesso.
- Formatação em Markdown: A partir do
o1-2024-12-17, os modelos de raciocínio na API evitam gerar respostas formatadas em Markdown. Quando quiser que a resposta use essa formatação, inclua a stringFormatting re-enabledna primeira linha da mensagem de desenvolvedor.
Como manter os custos baixos e a exatidão alta
Com a chegada dos modelos o3 e o4-mini, a API Responses passou a tratar de outra forma os itens de raciocínio armazenados. Antes, com o1, o3-mini, o1-mini e o1-preview, a API sempre ignorava os itens de raciocínio nas requisições subsequentes, mesmo quando eles faziam parte dos itens de entrada dessas requisições. Com o3 e o4-mini, a API inclui no contexto do modelo alguns itens de raciocínio adjacentes às chamadas de função para melhorar o desempenho usando o mínimo possível de tokens de raciocínio.
Para obter os melhores resultados com essa mudança, recomendamos usar a API Responses com o parâmetro store definido como true e enviar todos os itens de raciocínio das requisições anteriores. Para isso, use previous_response_id ou envie todos os itens de saída de uma requisição anterior como itens de entrada da nova requisição. A OpenAI inclui automaticamente os itens de raciocínio relevantes no contexto do modelo e ignora os demais. Em casos de uso mais avançados, se você quiser controlar com mais precisão o que entra no contexto do modelo, recomendamos incluir pelo menos todos os itens de raciocínio entre a chamada de função mais recente e a mensagem anterior do usuário. Assim, quando você responder a uma chamada de função, o modelo poderá retomar o raciocínio de onde parou. Isso melhora o desempenho das chamadas de função e reduz o consumo total de tokens.
Se você usa a API chat completions, os itens de raciocínio nunca entram no contexto do modelo, pois essa API não mantém estado entre requisições. Em casos complexos com agentes de IA que envolvem muitas chamadas de função, isso resulta em um desempenho ligeiramente inferior do modelo e em maior consumo de tokens de raciocínio. Nos casos que não envolvem sequências complexas de chamadas de função, não deve haver perda de desempenho, independentemente da API utilizada.
Outros recursos
Para encontrar mais ideias, consulte o OpenAI Cookbook, que reúne exemplos de código e links para recursos de terceiros, ou saiba mais sobre nossos modelos e seus recursos de raciocínio: