Entenda como os modelos de raciocínio funcionam e como usá-los de forma eficaz.
Responses
Modelos de raciocínio usam tokens internos de raciocínio antes de produzir uma resposta. Isso ajuda o modelo a planejar, usar ferramentas de forma eficaz, examinar alternativas, lidar com ambiguidades e resolver tarefas mais difíceis que exigem várias etapas. Esses modelos funcionam especialmente bem na resolução de problemas complexos, na programação, no raciocínio científico e em fluxos de trabalho de várias etapas com agentes de IA. Também são os melhores modelos para o Codex CLI, nosso agente de programação leve.
Para a maioria das cargas de trabalho que exigem raciocínio, comece com gpt-6-astra. Para reduzir o custo, considere gpt-5.6-terra. Para obter o menor custo e a menor latência, considere gpt-5.6-luna. Se você usa um modelo GPT-5.6 ou GPT-6, consulte a seção sobre modo de raciocínio para conhecer a opção pro.
Os modelos de raciocínio funcionam melhor com a API Responses. A API chat completions continua disponível, mas com a API Responses você aproveita melhor a inteligência e o desempenho do modelo.
Primeiros passos com modelos de raciocínio
Faça uma chamada à API Responses e especifique o modelo e o esforço de raciocínio:
Como usar um modelo de raciocínio na API Responses
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
Esforço de raciocínio
O parâmetro reasoning.effort orienta o modelo sobre quanto raciocínio dedicar a uma tarefa.
Os valores aceitos variam conforme o modelo e podem incluir none, minimal, low, medium, high, xhigh e max. Com menos esforço, o modelo responde mais rápido e consome menos tokens. Com mais esforço, ele analisa a tarefa em maior profundidade para produzir respostas de melhor qualidade. Em todos os níveis de esforço, os modelos também adaptam o raciocínio à tarefa, usando menos tokens para tarefas simples e dedicando mais raciocínio às complexas.
O GPT-6 Astra não aceita o nível de esforço de raciocínio none. Se você definir reasoning.effort (Responses) ou reasoning_effort (Chat Completions) como none, a API retornará HTTP 400. O GPT-6.1 Sol não aceita none nem minimal e usa medium por padrão.
Use a API Responses para chamadas de função. A API chat completions não oferece suporte a chamadas de função com o GPT-6 Astra ou o GPT-6.1 Sol.
Os valores padrão também variam conforme o modelo. O gpt-5.5 usa o esforço de raciocínio medium por padrão. Esse é o melhor ponto de partida para aproveitar o equilíbrio entre qualidade, confiabilidade e desempenho do gpt-5.5.
Esforço
Quando usar
none
Tarefas em que a latência é crítica e que não se beneficiam de raciocínio nem de chamadas encadeadas a ferramentas. Para casos de uso sensíveis à latência com o gpt-5.5, recomendamos começar com low e passar para none se necessário.
Exemplos comuns incluem aplicativos de voz, recuperação rápida de informações e classificação.
low
Raciocínio eficiente com um pequeno aumento de latência. Ideal quando é preciso usar ferramentas, planejar, fazer buscas ou tomar decisões em várias etapas e, ao mesmo tempo, priorizar a velocidade e manter o custo baixo.
Exemplos comuns incluem análise de dados, redação de rascunhos, programação voltada à implementação e fluxos de trabalho de atendimento ao cliente ou de assistentes de chat.
medium
Tarefas em que a qualidade e a confiabilidade são importantes e que exigem planejamento, raciocínio complexo e discernimento. É a configuração padrão para a maioria das cargas de trabalho e oferece um bom equilíbrio na curva de Pareto entre latência, desempenho e custo.
Exemplos comuns incluem programação agêntica, pesquisa, trabalho com planilhas e slides e delegação de tarefas de longo prazo.
high
Problemas de raciocínio difíceis, depuração complexa, planejamento aprofundado e tarefas de alto valor em que a qualidade e a inteligência importam mais que a latência. Recomendado para fluxos de trabalho complexos e tarefas com agentes de IA.
Exemplos comuns incluem programação agêntica, pesquisa de longo prazo e trabalho intelectual. Dependendo da complexidade da tarefa, avalie tanto medium quanto high.
xhigh
Pesquisa aprofundada, fluxos de trabalho assíncronos e tarefas com agentes de IA que exigem execuções prolongadas. Use esse nível apenas quando suas avaliações mostrarem um benefício claro que justifique a latência e o custo adicionais.
Exemplos comuns incluem revisões de segurança e de código, produtividade empresarial, tarefas de pesquisa mais aprofundadas e fluxos de trabalho de programação complexos.
max
Raciocínio máximo para suas tarefas mais complexas. Se você já usa xhigh, avalie se max oferece melhor desempenho.
Para reduzir o tempo até o primeiro token visível em aplicativos sensíveis à latência, peça ao modelo que gere uma breve introdução antes de aprofundar o raciocínio.
Alguns modelos aceitam apenas parte desses valores. Consulte a página do modelo antes de escolher uma configuração.
Modo de raciocínio
Os modelos GPT-5.6 e GPT-6 oferecem os modos de raciocínio standard e pro na API Responses. O padrão é standard. Defina reasoning.mode como pro para tarefas difíceis que exigem mais processamento do modelo e toleram maior latência e consumo de tokens.
O modo e o esforço de raciocínio são independentes. O modo define se a execução será padrão ou Pro, enquanto reasoning.effort controla quanto raciocínio o modelo aplica nesse modo. Se você omitir reasoning.effort, o GPT-5.6 usará medium por padrão nos dois modos. O GPT-6.1 Sol, o GPT-6 Sol e o GPT-6 Luna também usam o esforço de raciocínio medium por padrão.
O modo Pro contabiliza todo o processamento que o modelo realiza para produzir a resposta final e cobra pelos tokens correspondentes de acordo com os preços por token padrão do modelo selecionado. No modo Pro, o modelo realiza mais processamento do que no modo padrão, o que aumenta o consumo de tokens e o custo. Os IDs de modelos Pro existentes mantêm o comportamento e os preços atuais.
Como funciona o raciocínio
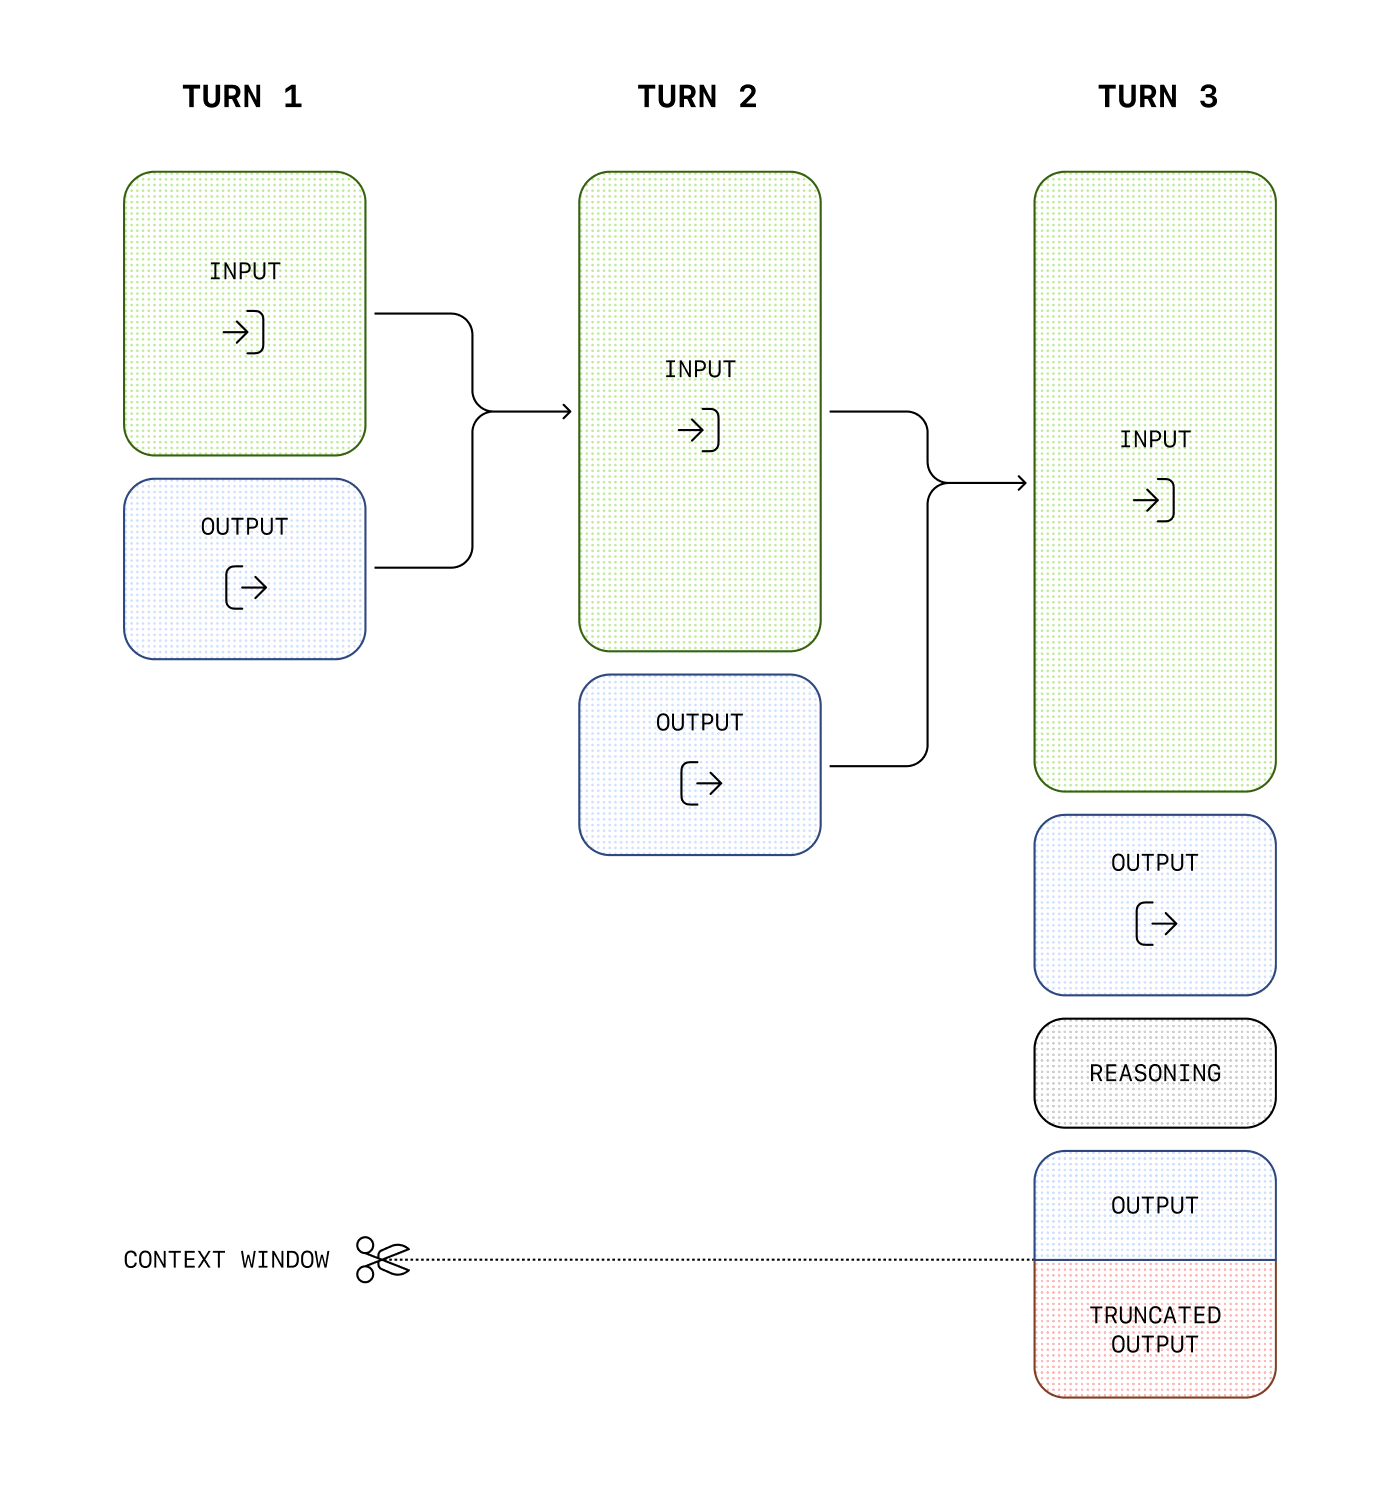
Além dos tokens de entrada e saída, os modelos de raciocínio usam tokens de raciocínio. Os modelos usam esses tokens para “pensar”, decompondo o prompt e considerando várias abordagens para gerar uma resposta. Nossos modelos de raciocínio, como gpt-5.5 e gpt-5.4, podem intercalar raciocínio e saída. Isso permite gerar tokens de saída visíveis antes e entre etapas de raciocínio, além de raciocinar entre chamadas a ferramentas.
Em modelos lançados antes do GPT-5.6, o comportamento padrão em uma conversa de várias etapas é levar adiante os tokens de entrada e saída de cada etapa sem incluir o raciocínio de turnos anteriores no contexto da próxima geração. Já os modelos GPT-5.6 incluem por padrão o raciocínio disponível de turnos anteriores. Use reasoning.context para escolher um desses comportamentos nos modelos compatíveis.
Embora os tokens de raciocínio não fiquem visíveis na API, eles ocupam espaço na janela de contexto do modelo e são cobrados como tokens de saída.
Controle de custos
Para gerenciar os custos dos modelos de raciocínio, você pode limitar o número total de tokens que o modelo gera com o parâmetro max_output_tokens. Esse total inclui tokens de raciocínio, tokens de saída visíveis e tokens de formatação não visíveis. Consulte a contagem de tokens de saída para saber como os tokens gerados entram no cálculo do uso e dos limites de saída.
Gerenciamento da janela de contexto
Ao criar respostas, garanta que haja espaço suficiente na janela de contexto para os tokens de raciocínio. Dependendo da complexidade do problema, os modelos podem gerar de algumas centenas a dezenas de milhares de tokens de raciocínio. Para ver o número exato de tokens de raciocínio usados, consulte o objeto de uso no objeto da resposta, em output_tokens_details:
Se a quantidade de tokens gerados atingir o limite da janela de contexto ou o valor que você definiu em max_output_tokens, a resposta terá status igual a incomplete e, em incomplete_details, o campo reason terá o valor max_output_tokens. Isso pode acontecer antes que o modelo produza qualquer token de saída visível. Nesse caso, pode haver cobrança pelos tokens de entrada e de raciocínio mesmo que você não receba uma resposta visível.
Para evitar isso, garanta que haja espaço suficiente na janela de contexto ou aumente o valor de max_output_tokens. Ao começar a experimentar esses modelos, a OpenAI recomenda reservar pelo menos 25.000 tokens para raciocínio e saída. À medida que você descobrir quantos tokens de raciocínio seus prompts exigem, poderá ajustar essa reserva.
Como lidar com respostas incompletas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
Como preservar o raciocínio entre chamadas
O estado da conversa e o estado do raciocínio têm finalidades diferentes. Ao repassar mensagens entre chamadas, você fornece ao modelo o histórico visível da conversa. Nos modelos compatíveis, a persistência do raciocínio também permite incluir itens de raciocínio compatíveis de turnos anteriores no próximo contexto do modelo.
A persistência do raciocínio dá continuidade à conversa sem expor o raciocínio bruto do modelo. Os itens de raciocínio permanecem opacos, e a API não retorna o texto do raciocínio contido neles. Defina reasoning.context para controlar quais itens de raciocínio disponíveis o modelo pode usar:
A família de modelos GPT-5.6 aceita all_turns e usa esse valor por padrão. Os modelos anteriores usam current_turn por padrão. O GPT-6.1 Sol também aceita all_turns. Omita reasoning.context ou defina seu valor como auto para usar o padrão do modelo selecionado.
Valor
Comportamento
auto
Usa o padrão do modelo selecionado. Omitir reasoning.context tem o mesmo efeito que usar auto.
current_turn
Disponibiliza o raciocínio do turno atual, mas não inclui o raciocínio de turnos anteriores no contexto da próxima geração.
all_turns
Inclui no contexto da próxima geração os itens de raciocínio disponíveis e compatíveis de turnos anteriores. Os modelos GPT-5.6 e o GPT-6.1 Sol aceitam esse valor.
O campo reasoning.context da resposta contém o modo efetivamente usado, current_turn ou all_turns. Confira esse campo em cada resposta para confirmar qual modo o modelo usou. Essa configuração não cria itens de raciocínio que ainda não estejam disponíveis.
all_turns só tem efeito quando a solicitação tem acesso a itens de respostas anteriores. Use previous_response_id, associe a resposta a uma conversa ou reenvie manualmente o histórico completo de respostas. Na primeira solicitação, current_turn e all_turns têm o mesmo comportamento porque ainda não há raciocínio anterior.
Só é possível reutilizar o raciocínio persistido dentro da mesma família de modelos. Por exemplo, gpt-5.6-sol, gpt-5.6-terra e gpt-5.6-luna podem reutilizar o raciocínio uns dos outros, mas o raciocínio não é transferido entre as famílias GPT-5.6 e GPT-5.5.
Quando você muda de família de modelos, a API omite do contexto do modelo o raciocínio incompatível, mesmo que reasoning.context esteja definido como all_turns.
Como continuar o raciocínio com respostas armazenadas
Use previous_response_id para implementar da forma mais simples uma integração que mantém o estado:
Como preservar o raciocínio usando uma resposta anterior
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";const client = new OpenAI();const first = await client.responses.create({ model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: "current_turn" },});const second = await client.responses.create({ model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"first = client.responses.create(model=model,input="Inspect this repository and identify the likely bug.",reasoning={"context": "current_turn"},)second = client.responses.create(model=model,previous_response_id=first.id,input="Now patch the bug and explain the change.",reasoning={"context": "all_turns"},)print(second.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
Use current_turn ao reenviar itens de respostas anteriores dos quais o modelo já não precisa. Esses itens de raciocínio podem permanecer no corpo da solicitação à API para manter a continuidade, mas o serviço não os inclui no contexto da nova geração. Isso pode reduzir o tamanho do contexto usado em fluxos de trabalho prolongados.
Como preservar o raciocínio sem armazenar respostas
Quando você cria uma resposta no modo sem estado, os itens de raciocínio no array output da resposta incluem a propriedade encrypted_content por padrão. O modo sem estado se aplica quando store é false ou quando sua organização usa zero retenção de dados (ZDR). Por compatibilidade, a API ainda aceita o valor legado reasoning.encrypted_content em include, mas ele é opcional.
A solicitação a seguir retorna o conteúdo de raciocínio criptografado sem especificar include:
1
2
3
4
5
6
7
8
9
10curlhttps://api.openai.com/v1/responses\-H"Content-Type: application/json"\-H"Authorization: Bearer $OPENAI_API_KEY"\-d'{ "model": "gpt-6-astra", "store": false, "reasoning": {"effort": "medium"}, "input": "What is the weather like today?", "tools": [ ... function config here ... ] }'
Os itens de raciocínio no array output incluem uma propriedade encrypted_content que contém os tokens de raciocínio criptografados. Você pode repassar esses tokens em chamadas futuras.
Para usar all_turns com store: false, preserve todos os itens de saída, acrescente a próxima mensagem do usuário e reenvie o histórico completo:
Como preservar o raciocínio sem armazenar respostas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const client = new OpenAI();const history = [ { role: "user", content: "Inspect this repository and identify the likely bug.", },];const first = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "current_turn" },});// Keep replayable output, including encrypted reasoning and assistant phase.history.push(...toResponseInputItems(first.output));history.push({ role: "user", content: "Now patch the bug and explain the change.",});const second = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"history = [ {"role": "user","content": "Inspect this repository and identify the likely bug.", }]first = client.responses.create(model=model,store=False,input=history,reasoning={"context": "current_turn"},)# Keep every output item, including encrypted reasoning and assistant phase.history.extend(item.to_dict() for item in first.output)history.append( {"role": "user","content": "Now patch the bug and explain the change.", })second = client.responses.create(model=model,store=False,input=history,reasoning={"context": "all_turns"},)print(second.output_text)
Ao fazer chamadas de função com um modelo de raciocínio na API Responses, reenvie os itens de raciocínio que a API retornou com essas chamadas, junto com as saídas das ferramentas. Assim, o modelo pode continuar raciocinando após uma chamada a uma ferramenta.
Você pode usar previous_response_id para repassar os itens de raciocínio à próxima solicitação. Se você gerencia o histórico da conversa manualmente, inclua a entrada original e todos os itens de saída de cada resposta na entrada da próxima solicitação. Mantenha esses itens na ordem original e acrescente os novos ao final.
Nos modelos de fronteira mais recentes, se você alterar o trecho do histórico que antecede um item de raciocínio, a API poderá descartar esse raciocínio. Consulte Mantenha o prefixo inalterado para saber como alterar instruções e saídas de ferramentas e como gerenciar conversas longas.
Como alterar o raciocínio durante a conversa
Use configuration_update para aumentar o esforço de raciocínio em tarefas difíceis ou reduzi-lo nas interações de rotina que se seguem. Insira a atualização entre as respostas e mantenha o valor de reasoning.effort definido na solicitação. Isso preserva o prefixo original do prompt para o cache de prompts.
Nos modelos GPT-6 e posteriores que oferecem esse recurso, você pode atualizar o esforço de raciocínio e o formato da resposta no modo padrão com um único agente.
Adicione o item a seguir antes da próxima mensagem do usuário no array input de uma solicitação HTTP à API Responses ou de uma solicitação WebSocket response.create:
Por exemplo, se a conversa começar com o esforço low definido na solicitação, essa atualização selecionará high para a próxima resposta e para as seguintes, até que outra atualização altere o valor.
Como aumentar o esforço de raciocínio na próxima interação
Preserve as atualizações com previous_response_id ou reenvie-as nas posições originais ao gerenciar manualmente o histórico da conversa. O campo reasoning.effort da resposta continua informando a configuração da solicitação, mesmo quando a atualização seleciona outro nível de esforço.
Você pode definir reasoning.effort e text.format no mesmo item configuration_update. Se você atualizar apenas uma dessas configurações, a outra manterá seu valor.
Não combine atualizações de configuração com compactação automática ou truncamento automático. O endpoint independente /responses/compact também rejeita históricos que contêm essas atualizações.
Você ainda pode compactar o histórico explicitamente ao incluir um item compaction_trigger em uma solicitação a /responses. Após a compactação, adicione um novo item configuration_update antes da próxima mensagem do usuário. Nesse item, especifique novamente o valor de cada configuração que você alterou, inclusive o formato da resposta, caso o tenha alterado.
Os requisitos habituais do cache de prompts continuam valendo. Para enviar instruções do usuário durante a geração de uma resposta, consulte Como orientar o modelo durante um turno.
Resumos de raciocínio
Embora não exponhamos os tokens brutos de raciocínio gerados pelo modelo, você pode usar o parâmetro summary para ver um resumo do raciocínio. Consulte a documentação dos modelos para verificar quais modelos de raciocínio oferecem resumos.
As opções de resumo de raciocínio variam conforme o modelo. Por exemplo, nosso modelo de Uso do computador aceita a opção de resumo concise, enquanto o o4-mini aceita detailed. Para obter o resumo mais detalhado disponível para um modelo, defina esse parâmetro como auto. Hoje, auto equivale a detailed na maioria dos modelos de raciocínio, mas pode haver opções mais específicas no futuro.
O resumo de raciocínio fica no array summary. Esse array pertence ao tipo reasoning de item de saída. A API só inclui essa saída quando você solicita explicitamente os resumos de raciocínio.
O exemplo a seguir mostra como fazer uma solicitação à API que inclua um resumo de raciocínio.
Como incluir um resumo de raciocínio na resposta da API
Python
1
2
3
4
5
6
7
8
9
10
11
12
13import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "What is the capital of France?", reasoning: { effort: "low", summary: "auto", },});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="What is the capital of France?",reasoning={"effort": "low", "summary": "auto"},)print(response.output)
Essa solicitação à API retorna um array de saída com a mensagem do assistente e um resumo do raciocínio que o modelo usou para gerar a resposta.
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
Em fluxos prolongados ou com uso intenso de ferramentas com GPT-5.5 e GPT-5.4 na API Responses, use o campo phase da mensagem do assistente para evitar encerramentos prematuros e outros comportamentos indesejados.
O campo phase é opcional na API, mas a OpenAI recomenda usá-lo. Use phase: "commentary" para atualizações intermediárias do assistente, como introduções antes de chamadas a ferramentas, e phase: "final_answer" para a resposta concluída. Não adicione phase às mensagens do usuário.
Em geral, usar previous_response_id é a maneira mais simples de preservar o estado anterior do assistente. Se você reenviar o histórico do assistente manualmente, preserve o valor original de phase em cada mensagem.
Se o campo phase estiver ausente ou for descartado, esses fluxos poderão interpretar introduções como respostas finais. Para orientações sobre prompts específicas do modelo, consulte Como escrever prompts para o GPT-5.5.
Como reenviar os valores de fase do assistente
Como reenviar os valores de fase do assistente
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: [ { role: "assistant", phase: "commentary", content: "I’ll inspect the logs and then summarize root cause and remediation.", }, { role: "assistant", phase: "final_answer", content: "Root cause: cache invalidation race.", }, { role: "user", content: "Great—now give me a rollout-safe fix plan.", }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input=[ {"role": "assistant","phase": "commentary","content": "I’ll inspect the logs and then summarize root cause and remediation.", }, {"role": "assistant","phase": "final_answer","content": "Root cause: cache invalidation race.", }, {"role": "user","content": "Great—now give me a rollout-safe fix plan.", }, ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: [ { role: :assistant, phase: :commentary, content: "I'll inspect the logs and then summarize root cause and remediation." }, { role: :assistant, phase: :final_answer, content: "Root cause: cache invalidation race." }, { role: :user, content: "Great—now give me a rollout-safe fix plan." } ])puts(response.output_text)
Orientações para escrever prompts
Leve em conta estas diferenças ao escrever prompts para um modelo de raciocínio. Os modelos GPT-5 com capacidade de raciocínio geralmente funcionam melhor quando recebem um objetivo claro, restrições bem definidas e requisitos explícitos para a saída, sem que você precise prescrever cada etapa intermediária.
Informe ao modelo a tarefa, as restrições e o formato de saída desejado.
Use reasoning.effort para ajustar o comportamento do modelo. Evite depender principalmente desse parâmetro para recuperar a qualidade das respostas.
Em fluxos de trabalho com agentes de IA ou que exijam muita pesquisa, defina os critérios de conclusão e explique como o modelo deve verificar o próprio trabalho.
Para saber mais sobre as práticas recomendadas ao usar modelos de raciocínio, consulte este guia.
Exemplos de prompts
Programação (refatoração)
Modelos de raciocínio podem implementar algoritmos complexos e gerar código. Este prompt pede ao modelo que refatore um componente React seguindo critérios específicos.
Refatorar código
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Refatorar código
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Programação (planejamento)
Os modelos de raciocínio também podem criar planos com várias etapas. Neste exemplo, o prompt pede ao modelo que crie a estrutura de arquivos e diretórios de uma solução completa e escreva o código em Python que implementa o caso de uso desejado.
Planeje e crie um projeto em Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Planeje e crie um projeto em Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Pesquisa em STEM
Os modelos da série o da OpenAI têm demonstrado excelente desempenho em pesquisas nas áreas de ciência, tecnologia, engenharia e matemática (STEM). Prompts que pedem ajuda com tarefas de pesquisa básica devem produzir bons resultados.
Faça perguntas sobre pesquisa científica básica
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Faça perguntas sobre pesquisa científica básica
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Exemplos de casos de uso
O Cookbook traz exemplos de como aplicar modelos de raciocínio em situações reais.