Saiba como gerenciar o estado da conversa ao interagir com um modelo.
Responses
A OpenAI oferece algumas formas de gerenciar o estado da conversa para preservar informações ao longo de várias mensagens ou turnos.
Se o GPT-5.5 tratar uma atualização intermediária como resposta final, verifique se sua integração preserva corretamente o campo phase da mensagem do assistente. Para mais detalhes, consulte Parâmetro de fase.
Como gerenciar manualmente o estado da conversa
Cada requisição de geração de texto é independente e não mantém estado. Ainda assim, você pode implementar conversas com vários turnos passando mensagens adicionais como parâmetros da requisição. Veja o exemplo de uma piada do tipo “toc, toc”:
Ao alternar mensagens user e assistant, você inclui o estado anterior da conversa em uma única requisição ao modelo.
Para compartilhar o contexto manualmente entre as respostas geradas, use a saída da resposta anterior do modelo como entrada e acrescente essa entrada à próxima requisição.
Em requisições sem estado a modelos de raciocínio, preserve todos os itens do array output da resposta. A API Responses retorna itens de raciocínio criptografados por padrão. Ao reenviar a saída completa, você mantém intactos os itens de raciocínio e os valores de phase das mensagens do assistente. Nos modelos que permitem persistir o raciocínio, você pode usar reasoning.context: "all_turns" para incorporar à próxima geração o raciocínio disponível dos turnos anteriores. Veja como preservar o raciocínio entre chamadas.
Ao reenviar itens de raciocínio, preserve o histórico da conversa que deu origem a esses itens. Consulte Mantenha o prefixo inalterado para entender como as alterações no histórico da conversa afetam o raciocínio.
No exemplo a seguir, pedimos ao modelo que conte uma piada e depois pedimos outra. Acrescentar as respostas anteriores às novas requisições ajuda a manter a conversa natural e a preservar o contexto das interações anteriores.
Gerencie manualmente o estado da conversa com a API chat completions.
APIs da OpenAI para gerenciar o estado da conversa
Nossas APIs facilitam o gerenciamento automático do estado da conversa, sem que você precise passar as entradas manualmente a cada turno.
Recomendamos usar a API Responses. Como ela mantém o estado, basta um parâmetro para gerenciar o contexto entre conversas.
Se você usa o endpoint Chat Completions, precisa gerenciar o estado manualmente, conforme descrito acima.
Como usar a API Conversations
A API Conversations funciona em conjunto com a API Responses para armazenar o estado da conversa em um objeto de longa duração com um identificador persistente próprio. Depois de criar um objeto de conversa, você pode reutilizá-lo em diferentes sessões, dispositivos ou tarefas.
As conversas armazenam itens, como mensagens, chamadas de ferramentas, saídas de ferramentas e outros dados.
Em uma interação com vários turnos, passe conversation ao gerar as próximas respostas para manter o estado e compartilhar o contexto entre elas. Assim, você dispensa o encadeamento de vários itens de resposta.
Gerencie o estado da conversa com as APIs Conversations e Responses
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Como passar o contexto da resposta anterior
Outra forma de gerenciar o estado da conversa é usar o parâmetro previous_response_id para compartilhar o contexto entre as respostas geradas. Com esse parâmetro, você pode encadear respostas e dar continuidade à conversa.
Encadeie respostas entre turnos usando o ID da resposta anterior
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id no modo WebSocket
No modo WebSocket da API Responses, previous_response_id funciona da mesma forma que no modo HTTP para dar continuidade à conversa. A diferença é que você envia eventos response.create sucessivos pelo mesmo socket persistente.
O cache de cada conexão mantém as respostas mais recentes na memória para que a conversa continue com baixa latência. Quando você usa stream_id, cada fluxo pode reter sua resposta mais recente. O parâmetro previous_response_id continua definindo de qual resposta a próxima deriva. Assim, um novo fluxo pode partir de uma resposta de outro fluxo enquanto ela estiver disponível. Se não for possível localizar uma resposta cujo ID não esteja no cache, envie um novo turno com previous_response_id definido como null e inclua todo o contexto de entrada.
Por padrão, os objetos de resposta ficam armazenados por 30 dias. Você pode consultá-los na página de logs do painel ou recuperá-los pela API. Para desativar esse comportamento, defina store como false ao criar uma resposta.
O prazo de expiração (TTL) de 30 dias não se aplica aos objetos de conversa nem aos itens que eles contêm. Os itens de qualquer resposta vinculada a uma conversa ficam armazenados sem esse prazo de expiração.
A OpenAI só usa os dados enviados pela API para treinar seus modelos com seu consentimento explícito. Saiba mais.
Mesmo quando você usa previous_response_id, a API cobra todos os tokens de entrada das respostas anteriores da cadeia como tokens de entrada.
Como gerenciar a janela de contexto
Entender como funciona a janela de contexto ajuda a criar conversas encadeadas e a gerenciar o estado ao longo das interações com o modelo.
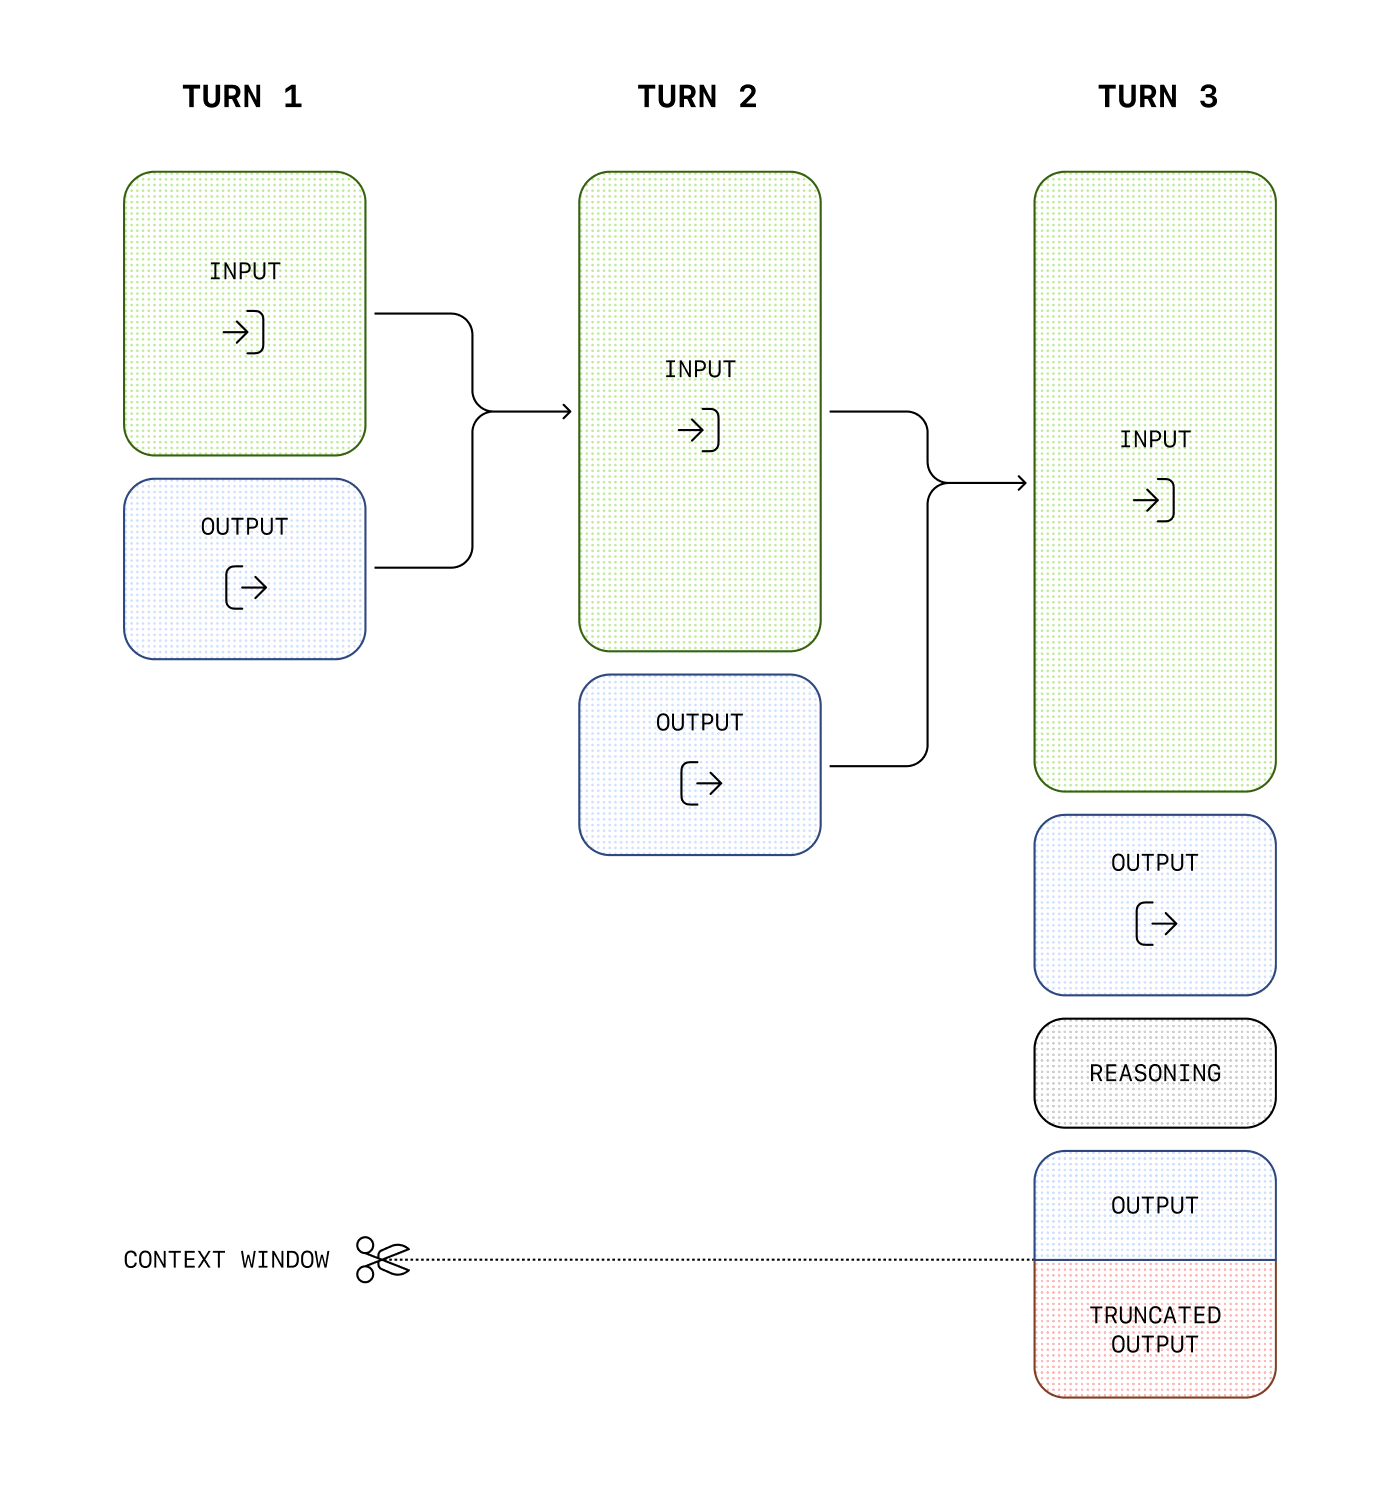
A janela de contexto é o número máximo de tokens que podem ser usados em uma única requisição. Esse limite inclui tokens de entrada, de saída e de raciocínio. Para saber o tamanho da janela de contexto do seu modelo, consulte os detalhes dos modelos.
Como gerenciar o contexto na geração de texto
À medida que as entradas se tornam mais complexas ou que você acrescenta turnos à conversa, é preciso considerar os limites de tokens de saída e da janela de contexto. As entradas e saídas do modelo são medidas em tokens. O modelo decompõe as entradas em tokens para analisar seu conteúdo e sua intenção, e combina tokens para gerar saídas coerentes. Cada modelo tem limites para o uso de tokens ao longo de uma requisição de geração de texto.
Tokens de saída são os tokens que o modelo gera em resposta a um prompt. Cada modelo tem seus próprios limites de tokens de saída. Por exemplo, gpt-4o-2024-08-06 pode gerar até 16.384 tokens de saída.
A janela de contexto define o total de tokens disponíveis para entrada e saída e, em alguns modelos, também para tokens de raciocínio. Compare os limites da janela de contexto dos nossos modelos. Por exemplo, gpt-4o-2024-08-06 tem uma janela de contexto de 128 mil tokens.
Ao incluir mais contexto, dados ou exemplos para o modelo, você pode criar um prompt longo que ultrapasse o limite da janela de contexto. Nesse caso, a saída pode ser truncada.
Por exemplo, em uma requisição à API chat completions com o modelo o1, os seguintes tokens entram na contagem total da janela de contexto:
Tokens de entrada (entradas que você inclui no array messages ao usar Chat Completions)
Tokens de saída (tokens gerados em resposta ao seu prompt)
Tokens de raciocínio (usados pelo modelo para planejar a resposta)
Por exemplo, em uma requisição à API Responses com um modelo que tem o raciocínio habilitado, como o modelo o1, os seguintes tokens entram na contagem total da janela de contexto:
Tokens de entrada (entradas que você inclui no array input da API Responses)
Tokens de saída (tokens gerados em resposta ao seu prompt)
Tokens de raciocínio (usados pelo modelo para planejar a resposta)
Os tokens gerados além do limite da janela de contexto podem ser truncados nas respostas da API.