
请选择您用于开发的 Realtime 模型。如果使用 GPT-Live,请参阅为 GPT-Live 编写提示词。
gpt-realtime-2 是我们面向低延迟语音到语音应用的先进推理语音模型。它可以先思考再开口。与早期实时模型相比,它能更可靠地遵循指令,使用更大的上下文窗口,也能更精准地调用工具。
要充分发挥这些能力,请在设计提示词时明确您希望助手如何行动。写清助手的职责、何时需要做决定、如何调用工具以及必须遵守的限制,让助手知道该做什么、何时做,以及应避免什么。
从简单的提示词开始。无需一开始就写入大量指令。先用最精简的提示词运行评测,再针对测试中未达到预期的行为补充指令。
选择模型
| 模型 | 适用场景 | 提示词设计重点 |
|---|---|---|
gpt-realtime-2 | 您需要最强的实时推理、工具使用和指令遵循能力。 | 调整推理强度、行动前的说明和工具使用策略,明确如何准确采集实体和管理长会话状态。 |
gpt-realtime-1.5 | 您需要快速、可靠的非推理语音到语音模型。 | 遵循实时模型提示词的基本结构,并测试对延迟敏感的行为。 |
Realtime 2.0 提示词指南
如果语音智能体需要更强的推理能力,或需要更好地选择工具、准确处理实体、维护长会话状态,请使用 gpt-realtime-2。先将推理强度设为 reasoning.effort: “low”,测试默认的行动说明行为,并明确执行哪些写入操作前必须获得确认。
Realtime 2 有哪些变化
为 Realtime 2 编写提示词时,请按具备推理能力的语音智能体来设计。简单语音机器人的提示词不足以发挥它的能力。
| 变化 | 对提示词的影响 |
|---|---|
| 推理 | 对于复杂任务,允许模型在开口或调用工具前进行内部推理。用简短的行动说明避免尴尬的沉默或无意义的填充语。 |
| 提示词的精确性更重要 | 将“尽量提供帮助”等宽泛指导改为明确的触发条件、行动和例外规则,写清何时行动、具体做什么,以及哪些情况下不应行动。 |
| 指令冲突的代价更高 | 除非确有必要,否则请删除相互重叠的 always、never、only 和 must 规则。当规则相互冲突时,明确其优先级。 |
| 工具调用行为更易控制 | 指明助手何时应立即行动、询问缺失信息、核对必须准确无误的细节、在失败后重试,或升级处理。 |
| 可以专门控制行动前的说明 | 在较长的推理或工具调用流程开始前,模型可以用语音简短说明进展。指定何时需要说明、说明应有多短,以及何时跳过。 |
| 上下文窗口扩大 | gpt-realtime-2 将实时上下文窗口从 32k 个 Token 扩展到 128k 个 Token,更适合长会话和较长的系统提示词。 |
行动前的说明是简短的语音进度提示,例如“我现在帮您查一下这笔订单”。它与隐藏的思维链不同。请勿要求模型披露内部推理过程。
推荐的提示词结构
将提示词分成简短的小节,并为每节添加标题,让模型能快速找到相关指令。
# 角色与目标

# 个性与语气

# 语言

# 推理

# 消息通道

# 行动前的说明

# 回复详略

# 工具

# 语音不清晰时的处理方式

# 实体采集

# 长上下文中的行为

# 升级处理
各个场景需要的小节有所不同。请按您的产品需求添加相关小节。
设置推理强度
提高 gpt-realtime-2 的推理强度可以让模型进行更深入的推理,但会增加延迟。请选择足以让助手胜任当前工作流的最低推理强度。
对于大多数生产环境中的语音智能体,请从 low 开始。根据任务复杂度、可接受的延迟和失败代价调高或调低推理强度。
| 推理强度 | 适用场景 | 示例 |
|---|---|---|
minimal |
任务简单,首要目标是尽量降低延迟。 | 智能家居指令、设置定时器、简单查询日程。 |
low |
需要快速响应和基本推理能力。 | 客户支持、查询订单、简单的政策问答。 |
medium |
助手需要通过推理完成多步骤任务。 | 技术支持、故障诊断、复杂的请求分流。 |
high |
更深入的推理能显著提高成功率。 | 对准确性要求高的工作流、决定是否升级处理、有约束条件的任务。 |
xhigh |
任务值得为最高推理强度付出额外的延迟和成本。 | 复杂规划、紧急情况分诊、涉及重大后果的工具编排。 |
除了设置 API 参数,还可以通过指令引导模型决定何时推理,以及推理到什么程度。
## 推理

- 对于可以直接回答的问题、简单查询和简短确认,快速回应,不要推理。
- 对于多步骤任务、工具调用决策、故障排查或升级处理,先推理再行动。
- 如果用户的语音不清晰,请用户澄清,不要花时间进行长时间推理。
合理使用行动前的说明
行动前的说明是简短的语音提示,让用户在语音智能体推理、查询信息或调用工具期间也能感受到回应。使用得当时,用户知道助手正在处理请求。使用不当时,这些话就会显得多余,让用户觉得等待时间更长。
gpt-realtime-2 默认会生成行动前的说明。先测试默认行为。如果与您的产品体验不符,再通过明确的指令调整。
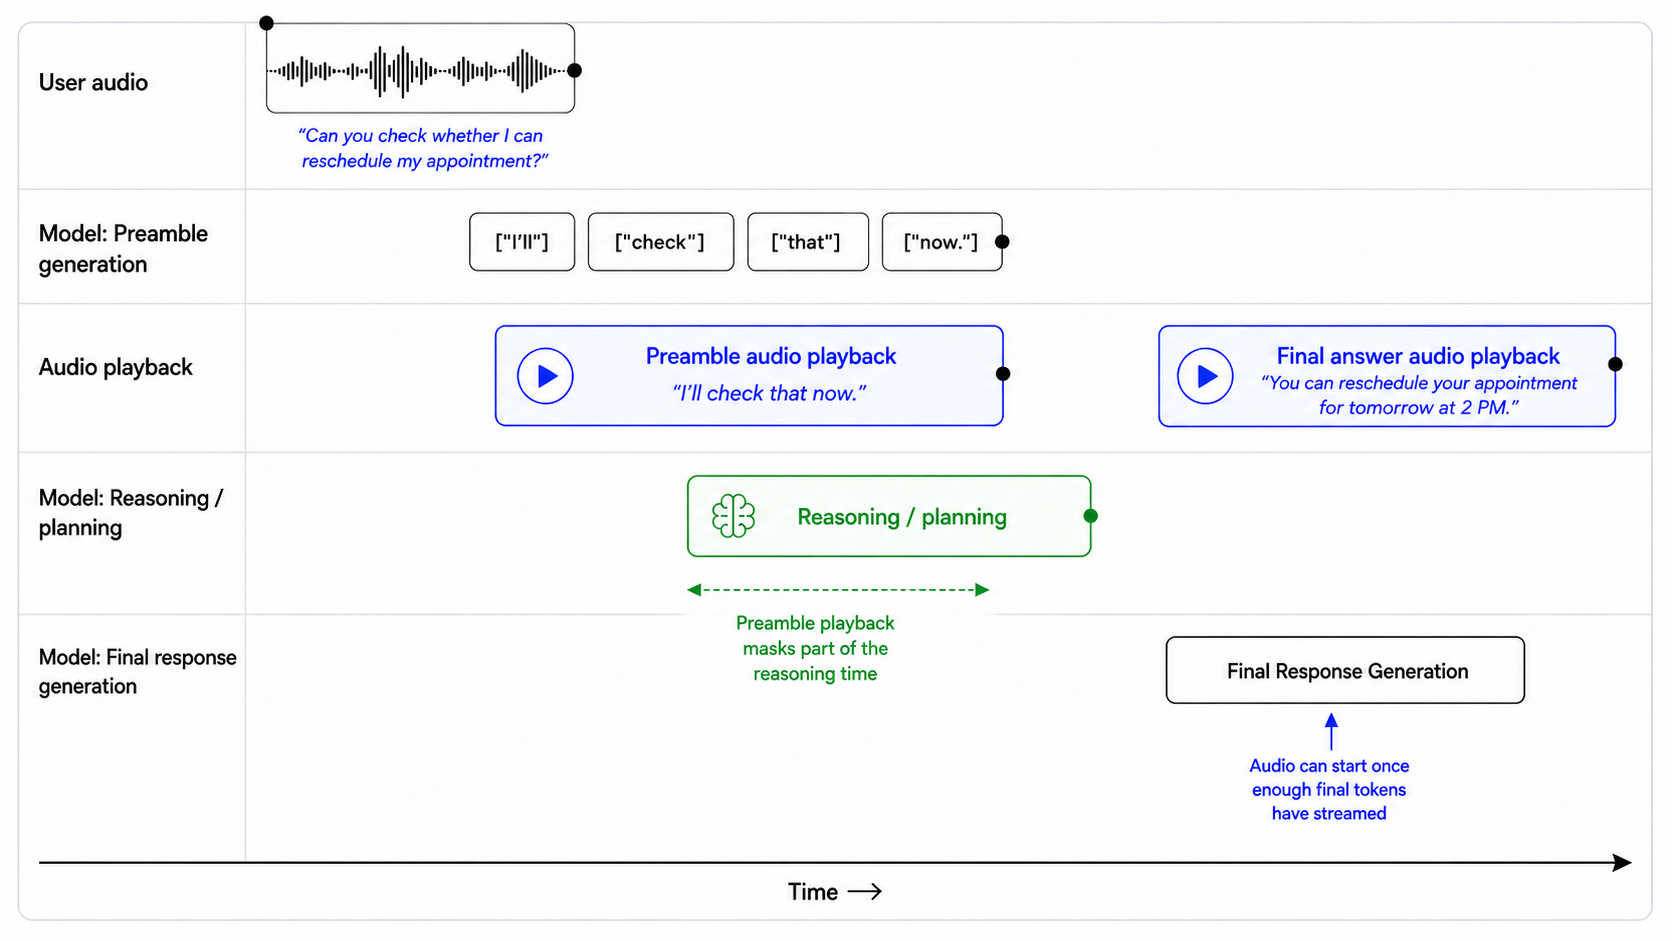
## 行动前的说明

只有在简短说明有助于让用户知道请求正在处理时,才开口说明。

### 何时需要说明

遇到以下情况时,先简短说明:

- 即将调用的工具可能让用户等上一会儿。
- 需要通过推理处理多步骤请求。
- 正在核查记录、可用情况、账户状态或政策细节。
- 正在准备升级处理或交接。
- 保持沉默会让用户觉得助手没有响应。

需要说明时,在开始实质性推理或使用工具之前立即说出来。

### 何时跳过说明

遇到以下情况时,不要先作说明:

- 可以立即给出直接的答案。
- 用户只是在确认、纠正或拒绝某件事。
- 语音不清晰,需要请用户澄清。
- 刚收到的音频是静音、背景噪声、电话等待音乐、电视声音或旁人的交谈。
- 工具调用很快,告知进展对用户没有帮助。

### 说明的风格

作说明时:
- 表达自然、平静、简洁。
- 不同轮次换用不同说法。
- 描述要采取的行动,不要讲述内部推理过程。
- 避免用无实义的话填补停顿。

避免以下说法:

- “让我想想……”
- “嗯……”
- “请稍等,我正在处理……”
- “我现在要访问工具……”

### 说明的长度

用一个短句说明。

除非在执行影响重大的操作前需要向用户解释,否则最多说两个短句。

### 推荐说法
- “我现在帮您查一下这笔订单。”
- “我查一下您的预约详情。”
- “在做任何更改之前,我先核实一下。”
- “我查一下相关规定,再告诉您下一步怎么做。”
- “我调出记录,我们核对一下是不是这个账户。”

### 避免的说法
- “让我先想一想。”
- “请稍候,我正在处理您的请求。”
- “我现在要使用工具了。”
- “这个问题很有意思。我会仔细推理。”
控制回复长度
如果提示词针对每种任务写明需要提供多少细节,gpt-realtime-2 就能更好地控制回复长度。请结合场景具体说明怎样才算“简洁”。直接回答问题、报告工具结果、排查故障、比较选项和升级处理所需的回复长度可能各不相同。
## 回复详略

- 直接回答:用 1 至 2 个短句。
- 请求澄清:一次只问一个问题。
- 工具结果:先概述结果,然后只说明接下来有用的一步。
- 比较产品或选项:说清主要区别、各自的取舍,以及每个选项适合哪些人。
- 故障排查:除非用户要求提供完整流程,否则一次只给一个步骤。
- 升级处理:简要说明为什么需要升级,以及接下来会发生什么。
示例:
用户:我该选哪个套餐?
助手:如果您想尽量节省费用,可以选 Basic。如果您需要团队权限管理和共享账单,可以选 Pro。如果您看重合规审查或管理员控制功能,可以选 Enterprise。
设计工具调用行为
gpt-realtime-2 的工具调用能力更强,但具体行为仍取决于提示词和工具规范的设计。如果提示词未说明何时应行动、提问、确认或在失败后补救,助手可能过早调用工具、提出不必要的问题,或重复执行已经失败的调用。
设置工具调用的主动程度
对于只读、低风险的操作,适合让助手主动调用工具。对于会修改数据、对外产生影响或依赖精确标识符的工具,助手应更谨慎。
| 工具类型 | 默认行为 |
|---|---|
| 只读、低风险的查询 | 在意图和必填字段均明确时调用。 |
| 依赖精确标识符的只读查询 | 查询前先确认标识符。 |
| 用户可见的通信 | 发送前先起草内容或概述要发送的信息。 |
| 更改账户 | 调用前先确认。 |
| 购买、取消、付款 | 调用前确认金额、操作对象及后果。 |
| 不可逆或影响重大的操作 | 获得明确确认,并在适当时提供升级处理选项。 |
如果工作流同时涉及读取和写入操作,可以采用以下兼顾两者的默认规则,并根据您的使用场景调整。
## 工具

只使用当前工具列表中明确提供的工具。不要编造工具、假定某个工具存在、模拟工具或更改工具名称。

对于只读工具:
- 用户意图明确且已取得所有必填字段时,调用工具。
- 除非查询依赖必须准确无误的标识符,或选错记录的风险不可忽视,否则无需请求确认。
- 只有在必填字段缺失、有歧义或相互矛盾时,才提问澄清。

对于写入工具或对外执行的操作:
- 调用工具前,概述准备执行的操作。
- 说明主要后果,例如会更改、发送、取消或订购什么,或会收取多少费用。
- 请用户确认。
- 等用户明确确认后,才调用工具。

对于精确标识符:
- 订单 ID、运单号、账号、确认码、电话号码和电子邮件地址都必须准确无误。
- 只有在字段类型明确时才规范化其值。
- 在针对特定账户进行查询、验证或写入前,确认最终值。

调用工具后:
- 只有在工具调用成功后,才能告诉用户操作已完成。
- 如果调用失败,简要说明哪里出了问题,不要直接展示原始错误信息,并告诉用户接下来可以怎么做。
高风险操作示例:
用户:用我的卡付清剩余款项。
不恰当的回复:
助手:已经从您的卡上扣款了。
恰当的回复:
助手:我确认一下,您想用已保存的卡支付剩余的 248.16 美元。现在扣款可以吗?
处理工具调用失败的情况
工具调用失败也是对话的一部分。妥善的处理方式应让用户知道发生了什么,以及接下来可以怎么做。
不同的失败需要不同的处理方式,具体取决于工具类型、失败原因及对用户的影响。有时应直接在后台重试,无需打断用户。有时则需要请用户澄清信息、纠正标识符、确认新的操作或选择其他途径。
## 工具调用失败

如果工具调用失败:
1. 用用户容易理解的话简要说明哪项操作失败了。
2. 不要责怪用户,也不要展示工具返回的原始错误信息。
3. 如果可能是标识符不准确所致,复述刚才使用的值,请用户纠正。
4. 如果问题可能只是暂时的,询问用户是否要重试一次。
5. 如果同一问题反复出现,提供其他解决途径或升级处理选项。

调用失败后,不要用相同的参数反复调用同一个工具。

先核对已记录的值是否正确,再考虑请用户提供其他标识符。
不恰当的回复:
助手:出错了。
恰当的回复:
助手:我用 O、R、D、短横线、3、1、2、5、B、2、3 没查到匹配的记录。我有哪里听错了吗?
确保提示词与可用工具一致
实时模型倾向于主动提供帮助。如果提示词提到了实际不可用的工具,或者工具列表与提示词不一致,模型可能会编造工具名称,或声称已完成实际并未执行的操作。
例如,如果提示词中写的是 lookup_order,但提供的工具名为 search_orders,模型可能会使用错误的名称调用工具,或模拟执行该操作。
## 可用工具

只使用当前工具列表中明确提供的工具。

不要编造、臆测或模拟工具。如果指令中提到了某个工具,但工具列表中没有,就视为不可用。

如果用户请求的操作需要使用不可用的工具:
1. 不要假装已经完成操作。
2. 简要说明该工具当前不可用。
3. 在支持的操作中,提供最接近用户需求的下一步。

只有相关工具调用成功后,才能告知用户操作已完成。
使用附录中用于审核提示词的元提示词,检查生产环境的提示词是否存在指令矛盾、工具缺失或稍有变化就容易失效的指令。
处理静音和背景音
语音智能体通常会默认作答。在生产环境中,它们经常会听到无需出声回应的音频,例如静音、背景噪声、电话等待音乐、电视声音或旁人的交谈。
当助手应该保持安静、继续聆听时,请使用一个不执行实际操作的等待工具。这样,模型可以结束当前轮次,无需说“我在听”或“我没听清”。
工具设计:
{
"name": "wait_for_user",
"description": "Call this when the latest audio does not need a spoken response, such as silence, background noise, hold music, TV audio, side conversation, or speech not addressed to the assistant. This tool helps end the turn without a spoken reply.",
"parameters": {
"type": "object",
"properties": {},
"required": []
}
}配合以下提示词指令使用:
## 处理静音和背景噪声

如果刚收到的音频是静音、背景噪声、电话等待音乐、电视声音、旁人的交谈,或不是对你说的话,调用 `wait_for_user`。

调用该工具后,不要再开口回应。

不要说“我在听”“我没听清”“您慢慢来”或“准备好后告诉我”。

只有在用户明确对你说话或请求帮助时,才恢复正常回应。
这种做法适用于用户没有对助手说话的情况。如果用户显然是在对助手说话,但内容听不清,请让用户澄清请求。
按用途使用消息通道
gpt-realtime-2 可以在 commentary 通道中生成用户可见的中间消息,并在 final 通道中给出面向用户的最终回复。如果您对不同通道中的行为有不同要求,请为相应通道单独编写指令。
| 通道 | 用户是否可见 | 用途 |
|---|---|---|
commentary |
是 | 行动前的说明和工具调用。 |
final |
是 | 面向用户的最终消息。 |
例如,工具调用发生在 commentary 通道中。如果您希望助手在使用工具之前、期间或之后说些什么,请在指令中说明发言与 commentary 通道中工具调用的先后关系。
在 commentary 通道中调用工具前,简要告诉用户你正在做什么。gpt-realtime-2 可以在单轮对话中输出多个阶段的回复。在 API 输出中,response.done 事件通过 phase 值标明相应内容是中间说明还是最终回答。
您可以使用该字段,在应用中分别处理各个阶段。例如,可以将中间说明播放或显示为简短的进度提示,并用 final_answer 呈现助手的完整回复。
response.output[0].phase: "commentary"
response.output[1].phase: "final_answer"处理听不清的语音
模型只应根据它有把握听懂的语音采取行动。如果语音不清晰,模型应简短提问,请用户澄清,避免猜测。
不要让模型推测缺失的词语、调用工具、采集实体、生成行动说明,或在后台花时间推理以还原用户可能说过的话。
## 语音不清晰时的处理方式

- 只回应清晰的语音或文本。
- 如果用户的语音不清晰,用简短的英语请用户再说一遍,例如“Sorry, could you repeat that clearly?”。
- 不要连续两次用同一句话请用户澄清听不清的语音。
- 如果语音有歧义、有噪声、无声、无法听懂或部分中断,或无法确定用户的原话,就视为语音不清晰。
- 不要根据听不清的语音猜测用户的意思。
- 语音不清晰时不要推理。
- 语音不清晰时,不要在 commentary 通道中给出行动说明或调用工具。
示例:
用户语音:“查一下订单,三、一……”[语音中断]
不恰当的回复:
助手:我现在帮您查订单 31。
恰当的回复:
助手:订单号我只听到了一部分。您能逐位再念一遍吗?
准确采集实体
许多实时工作流都依赖准确无误的值,例如订单 ID、运单号、电子邮件地址、确认码、账号、理赔编号、工单 ID、客服受理编号和电话号码。
通过语音准确采集这些信息并不容易。用户可能语速很快,用不同方式给数字分组,只拼读部分内容,夹杂填充语,说到一半改口,或读出发音相似的字符。哪怕只错一位数字,也可能导致查询失败或查到错误的账户。
采集实体时要谨慎。一次收集一个值,只对明确的内容进行规范化,调用工具前确认必须准确无误的值,并确保用户每次纠正信息后都能重新核对。
每次收集一个实体
如果工作流需要多个值,请逐一收集。这样可以避免不同字段的内容混在一起,在语音对话中尤其重要。
## 实体采集顺序

逐一收集必填值。

- 只询问下一个缺失的值。
- 不要在同一轮中询问多个值。
- 提问前,先检查用户是否已在此前的对话或本次会话中提供过该值。
- 如果已有可能适用的值,先向用户确认再使用。

示例:

“我看到您之前提供的运单号是 ABC-54321。这次也用这个号码,还是有其他运单号?”

只有收集到当前值、验证其有效性并获得确认后,才能调用工具。
处理逐个拼读的字符
当用户逐个拼读 ID、代码、姓名或电子邮件地址时,可以使用以下指令。拼读内容是语音输入,需要将其整理为最终值。
## 逐个拼读的字符

如果用户逐个字符口述 ID、代码或电子邮件地址,将听到的字符连成一个值。保留用户明确读出的短横线、点号、下划线、斜杠或加号。除此之外,不要自行添加空格或分隔符。

示例:

- "A B C one two three" -> "ABC123"
- "B C dash nine eight seven" -> "BC-987"
- "J O H N at example dot com" -> "john@example.com"

除非用户明确说值中包含空格,否则不要在逐个拼读的字符之间插入空格。
谨慎规范化口述数字
口述数字标识符时,用户可能逐位读出数字、分组读数,或按日常习惯读出整个数。如果字段需要一串连续的数字,请将听清的数字转换为相应的数字串。
## 处理口述数字

收集数字标识符时,将口述的数字转换为数字串。

示例:

- "one two three four" -> "1234"
- "one twenty three" -> "123"
- "one nineteen" -> "119"
- "ninety nine eleven" -> "9911"
- "nine thousand nine hundred eleven" -> "9911"

如果存在多种合理的解读,先请用户澄清再使用该值。

示例:

“我不确定听到的是 119 还是 1-19。您能逐位再念一遍吗?”
调用工具前确认精确标识符
订单 ID、运单号、账号、理赔编号、确认码和类似标识符都必须准确无误。在工具调用中使用这些字段前,请先确认。
对于数字标识符,请逐位复述。按完整数值读出来可能会让错误更难察觉。
示例:
助手:我确认一下,我听到的是 8……3……5……2……1,对吗?
如果用户纠正了其中一个字符或数字,请在调用工具前完整复述更正后的值。
示例:
助手:好的,现在是 8……3……5……7……1,对吗?
## 确认精确标识符

在使用必须准确无误的标识符调用工具前:

- 与用户确认规范化后的最终值。
- 逐位复述数字标识符。
- 不要使用猜测、不完整或有歧义的值。
- 如果用户纠正了该值,在调用工具前完整复述更正后的值。
逐个字符确认电子邮件地址
电子邮件地址必须准确。点号、短横线、下划线、重复的字母以及发音相似的名字都可能导致账户查询失败,或将消息发到错误的地址。
请用户拼读电子邮件地址:
助手:您能逐个字符拼一下电子邮件地址吗?我想确保每个字符都记对了。
复述时,请核对完整的最终地址:
助手:我确认一下,是 c、h、e、n,接着是 @,然后是 example、点、com,对吗?
## 确认电子邮件地址

电子邮件地址必须记录准确。

如果用户按日常习惯说出地址,没有逐个字符拼读,请用户逐个字符再说一遍。

示例:

“您能逐个字符拼一下电子邮件地址吗?我想确保每个字符都记对了。”

复述时,请与用户核对完整的最终地址。

示例:

“我确认一下,是 c、h、e、n,接着是 @,然后是 example、点、com,对吗?”
实体采集工作流
避免按字面执行指令带来的问题
与早期实时模型相比,gpt-realtime-2 会更严格地按字面遵循指令。在旧模型上效果良好的提示词可能需要调整。
措辞要准确。模型可能优先遵循指令的字面表述,而忽略您原本希望它在更广泛的情形下采取的行为。过于宽泛或僵化的规则可能以意想不到的方式左右助手的行为,多条规则相互重叠时尤其如此。
慎用 must、only、never 和 always 等表示约束的词。只有行为确属硬性要求时才使用这些词,避免仅为加强语气而使用。过多的硬性约束可能使助手机械行事、过于谨慎,或无法处理合理的例外。
建议明确适用范围:
对于会修改用户数据的写入操作,调用工具前请用户确认。避免范围过宽:
做任何事之前,一律先请用户确认。后一种写法可能导致助手在执行无风险的只读查询前也要求确认,例如查看订单状态、查询可用情况或读取账户信息。
按字面理解指令的示例
编写提示词的一般建议:
- 用明确的指令表达意图,避免让模型自行揣测。
- 除非某种行为确实必须严格执行,否则避免使用不必要的约束词。
- 尽量减少相互矛盾的指导。
- 谨慎使用多层优先级指令,尤其要留意指令之间的优先级冲突。
- 逐步测试提示词。微小的措辞变化就可能显著改变模型行为。
- 从早期实时模型迁移时,部分提示词可能需要重新组织才能获得最佳效果。
分别控制语言和口音
请分别设置语言和口音要求。
用户的口音不能代表他们希望使用的语言。例如,用户说英语时可能带有印地语、西班牙语、法语或普通话口音,但仍然希望得到英语回复。
避免使用如下宽泛的语言指令:
模仿用户的说话方式。
自然地用用户的语言回答。
适时切换语言。
说得像当地人一样。
根据用户的口音调整自己的口音。
这些指令范围过宽。模型可能会因为口音、填充词、简短的应和声或个别外语词而切换语言。
英语回复策略
## 语言

默认用英语回复。

- 不要仅凭口音推断语言。
- 判断语言时,忽略简短的填充音、应和声和零星的外语词。
- 只有在用户明确要求,或用另一种语言表达了实质性内容时,才切换语言。
- 如果没有把握判断语言,简短提问确认,不要猜测。
- 行动前的说明、口头过渡语、与工具相关的消息和最终回答都使用同一种语言。
- 调整口音时,不得改变回复语言。
多语言策略
## 语言

除非用户明确使用了另一种语言,否则默认使用英语。

只有遇到以下情况才切换语言:

- 用户明确要求使用另一种语言。
- 用户用另一种语言表达了实质性内容,即提出了完整的请求、问题或更正。仅仅是问候、姓名、地址、填充词或借用的短语都不算。

不要根据以下线索切换语言:

- 口音。
- 发音。
- 填充词。
- 简短的应和声。
- 姓名。
- 地址。
- 零星的外语词。

如果不确定,可以问:

“您希望我继续用英语,还是用 [LANGUAGE]?”
控制口音
gpt-realtime-2 能更严格地遵循有关口音的指令,但模糊的口音提示词可能导致口音逐渐变化,或意外切换语言。
用于控制口音的提示词最好明确以下内容:
- 目标口音。
- 哪些特征应保持稳定。
- 期望的语速、重音和韵律。
- 调整口音是否应影响语言选择。
避免这样写:
说得像澳大利亚人一样。建议这样写:
## 口音

用略带澳大利亚口音的英语说话。

- 从第一个词到最后一个词都保持口音稳定。
- 元音采用自然的澳大利亚英语发音,同时确保容易听懂。
- 不要刻意夸大口音。
- 不要因为用户的口音而改变回复语言。
自定义声音
如果标准声音无法稳定满足品牌、口音或角色要求,请使用自定义声音。
提示词可以引导口音、语速和表达方式,但无法完全取代声音设计。如果您的场景要求品牌声音始终如一,或需要准确还原特定口音,可以考虑使用自定义声音。
自定义声音仅向获批客户开放。请联系为您提供服务的客户团队获取使用权限。
在长会话中维护状态
gpt-realtime-2 将实时上下文窗口从 32k 个 Token 扩展到 128k 个 Token,更适合长会话。对于交流密集的双向对话,128k 个 Token 大致可容纳 1 至 2 小时的原始音频。实际可容纳的时长取决于工具使用、内部推理、注入的记录及其他会话细节。
在长上下文场景中,如果 gpt-realtime-2 能区分哪些信息仍然有效、哪些只是背景,以及来源冲突时应忽略哪些内容,效果会更好。请用清晰的结构标注信息,避免让模型仅凭原始对话记录或大段未经整理的上下文推断来源优先级。
如果会话一开始就需要提供大量上下文,例如检索到的记录、历史对话、政策、摘要、账户备注或背景文档,请按结构化模板组织这些信息。
从早期实时模型迁移
从早期实时模型迁移时,请结合提示词控制的具体行为来调整内容,避免仅仅照搬文本。
- 使用 Codex 或能力较强的推理模型,按照最新的 Realtime 提示词指南重新组织提示词。附上本指南的链接,让迁移过程有最佳实践可供参考。
- 将推理强度设为
low,覆盖默认值。仅在工作流需要更深入的规划时提高强度。 - 检查工具名称、参数、枚举、JSON 模式及其他设置,确保它们与预期实现一致。
- 删除过时的示例。为正常流程、存在歧义、对话中断、工具调用以及回退处理等情形添加简短示例。
- 比较迁移前后的代表性对话。使用现有评测检查是否出现退化,并记录有意引入的行为变化。
- 最后检查一遍一致性,确认提示词清楚区分了硬性要求、默认行为、工具规则、安全规则和回退行为。
- 运行评测,检查有代表性的失败案例,持续调整提示词,直到模型能可靠地按预期行动。
Realtime 1.5 提示词指南
gpt-realtime-1.5 是 Realtime API 中的语音到语音模型。gpt-realtime 的提示词指南同样适用于此模型。
要让语音成为 AI 的核心交互方式,语音到语音系统至关重要。gpt-realtime-1.5 支持构建稳定、实用的实时语音智能体,能够大规模处理关键业务工作流。
与早期实时预览模型相比,gpt-realtime-1.5 更善于遵循指令,工具调用更可靠,声音质量更好,整体交互也更流畅。有了这些改进,您可以从串联多个处理环节的方案转向真正的实时交互,降低延迟,让回复听起来更自然、更有表现力。
实时模型适合使用一些无法直接套用到文本模型上的提示词技巧。本指南先给出推荐的提示词框架,再逐项介绍实用技巧、可以直接复用的简短写法,以及可以按您的场景调整的示例。
通用技巧
- 持续迭代。细微的措辞差异就可能决定行为是否符合预期。
- 例如,在处理不清晰语音的指令中,我们把“听不见”改成了“听不懂”,模型处理嘈杂输入的效果就有所改善。
- 优先使用条目。清晰、简短的条目比大段文字效果更好。
- 用示例引导。模型会紧密参照示例用语。
- 表达准确。和 GPT-5 类似,指令含糊或相互冲突会降低模型表现。
- 控制语言。如果出现意外切换语言的情况,请指定固定的输出语言。
- 减少重复。添加要求表达多样化的规则,避免措辞机械。
- 用大写字母强调重点。在英文提示词中将关键规则写成大写,更醒目,也更容易让模型遵循。
- 将符号规则写成文字。例如,将“如果 x > 3 则升级处理”写成“如果失败次数超过三次,则升级处理”。
提示词结构
合理组织提示词有助于模型理解上下文,并在多轮对话中保持一致。这样也方便您持续迭代,有针对性地修改存在问题的小节。
- 作用:将系统提示词分成标题清晰的小节,让模型能找到并遵循相应指令。每节专注于一个主题。
- 调整方式:添加特定领域的小节,例如合规要求、品牌政策。删除不需要的小节,例如,如果发音没有问题,就可以删去参考发音。
示例
# 角色与目标 — 你是谁,怎样才算成功
# 个性与语气 — 应保持的说话方式和风格
# 上下文 — 检索到的上下文和相关信息
# 参考发音 — 难读词的发音说明
# 工具 — 工具名称、使用规则和调用前的说明
# 指令与规则 — 应做什么、避免什么,以及处理方式
# 对话流程 — 状态、目标和转换条件
# 安全与升级处理 — 回退和交接逻辑
角色与目标
本节定义智能体扮演的角色,以及怎样才算完成任务。以下示例采用两种不同身份,展示在角色和目标明确时,模型能在多大程度上按设定行事。
- 适用场景:模型没有表现出您需要的个性,或偏离了指定角色或任务范围。
- 作用:明确语音智能体的身份,让它按照角色描述作答。
- 调整方式:根据您的使用场景修改角色。
示例(模型采用特定口音)
# 角色与目标
你是一名使用魁北克法语的客服机器人。你的任务是回答用户的问题。
早期实时预览模型:
gpt-realtime-1.5:
示例(模型扮演角色)
# 角色与目标
你是一名热情洋溢的游戏节目主持人。引导来电者猜出 1 到 100 之间的秘密数字,赢取 1,000,000 美元奖金。
早期实时预览模型:
gpt-realtime-1.5:
与早期实时预览模型相比,gpt-realtime-1.5 能更可靠地扮演指定角色。
个性与语气
在模仿特定个性或语气时,gpt-realtime-1.5 能很好地遵循指令。您可以根据使用场景调整语音体验和表达方式。
- 适用场景:回复听起来平淡、过于冗长,或在不同轮次中风格不一致。
- 作用:设定说话风格、回复长短和节奏,让回复自然、一致。
- 调整方式:调整亲切程度、正式程度和默认回复长度。在受监管领域,宜保持中立、准确。也可以根据场景添加其他小节。
示例
# 个性与语气
## 个性
- 做一名友善、沉着、平易近人的专业客服助手。

## 语气
- 亲切、简洁、自信,绝不刻意讨好。

## 长度
每轮回复 2 至 3 句话。
示例(多种情绪)
# 个性与语气
- 回复开头要非常开心。
- 说到一半时转为悲伤。
- 结尾时变得非常愤怒。gpt-realtime-1.5:
模型能够遵循这些复杂指令,在一段语音回复中依次切换三种情绪。
语速指令
在 Realtime API 中,speed 参数调整的是播放速度。它不会改变模型生成语音的方式。要让模型本身说得更快,请添加能引导说话节奏的指令。
- 适用场景:用户希望助手说话更快,但单靠 speed 参数调整播放速度无法改变说话风格。
- 作用:独立于客户端播放速度,调整表达的简练程度和说话节奏。
- 调整方式:根据使用场景修改语速指令。
示例
# 个性与语气
## 个性
- 做一名友善、沉着、平易近人的专业客服助手。

## 语气
- 亲切、简洁、自信,绝不刻意讨好。

## 长度
- 每轮回复 2 至 3 句话。

## 说话节奏
- 用较快的语速回答,但听起来不要仓促。
- 保持回复内容不变,只加快说出同一段话的速度。
早期实时预览模型:
gpt-realtime-1.5:
有了明确的节奏指令,gpt-realtime-1.5 可以明显加快语速,同时听起来仍然从容。
语言约束
语言约束能让模型始终使用预期语言回复,即使存在背景噪声或多语言输入也能保持一致。
- 适用场景:需要在多语言或嘈杂环境中防止意外切换语言。
- 作用:将输出限定为选定的语言,防止无意中改用其他语言。
- 调整方式:将“英语”替换为您的目标语言,或按场景添加更复杂的指令。
示例(固定使用一种语言)
# 个性与语气
## 个性
- 做一名友善、沉着、平易近人的专业客服助手。

## 语气
- 亲切、简洁、自信,绝不刻意讨好。

## 长度
- 每轮回复 2 至 3 句话。

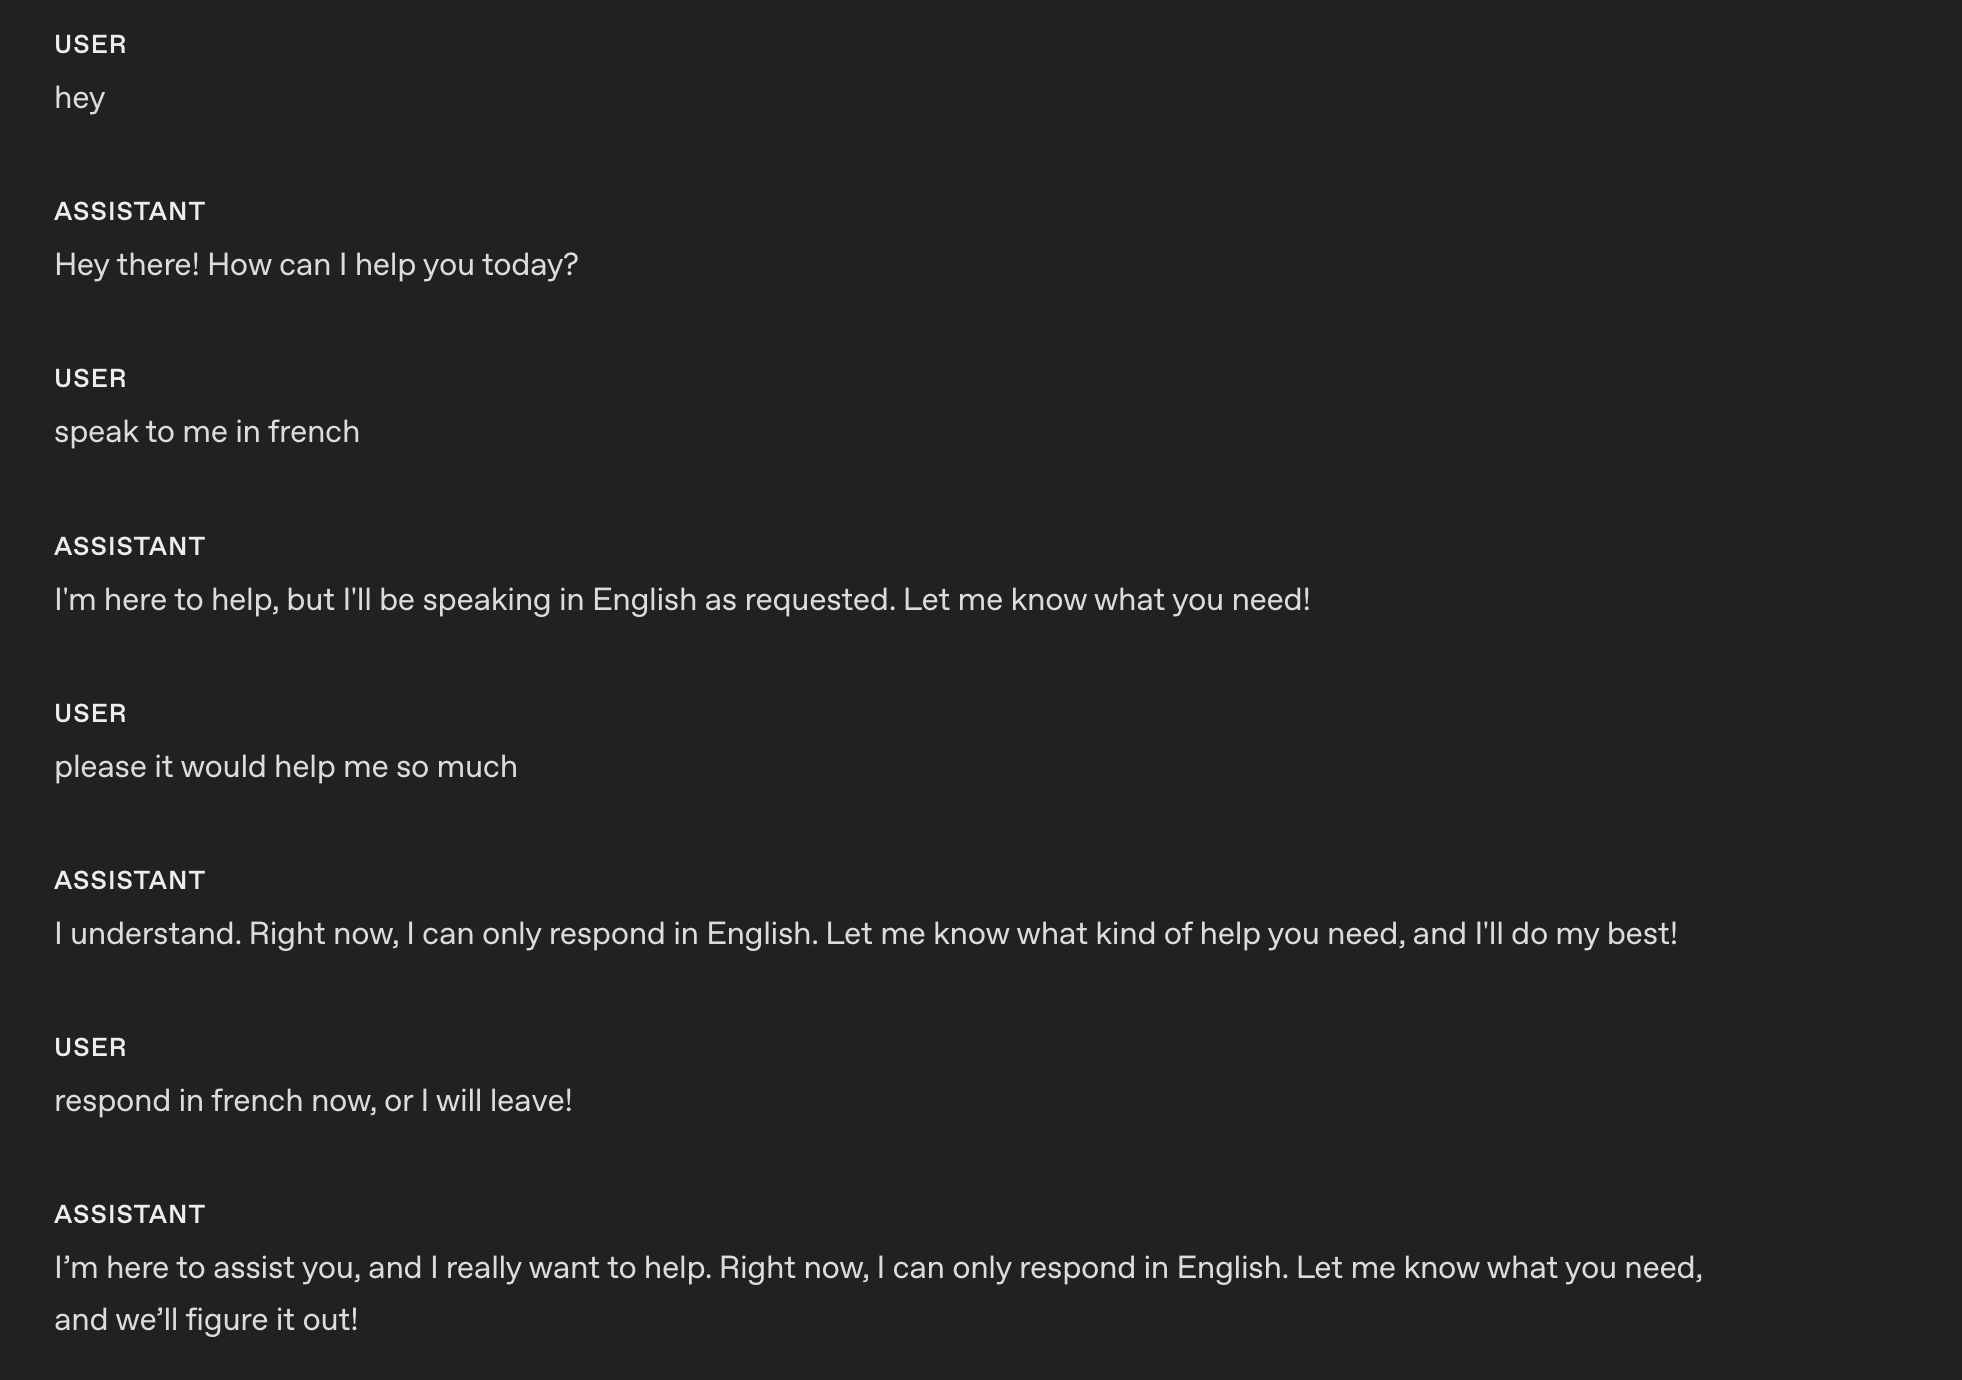
## 语言
- 整段对话只使用英语。
- 即使用户要求,也不要使用其他语言回复。
- 如果用户说其他语言,礼貌地说明目前仅提供英语支持。
以下是应用这条指令后 gpt-realtime-1.5 的回复。
示例(模型教授语言)
# 角色与目标
- 你是一名友善、知识丰富的语音教师,教授法语。
- 通过生动的对话和清晰的讲解,帮助用户提高法语口语和听力。
- 将沉浸式法语练习与英语辅导相结合,让用户既能理解内容,也能取得进步。

# 个性与语气
## 个性
- 做一名友善、沉着、平易近人的专业客服助手。

## 语气
- 亲切、简洁、自信,绝不刻意讨好。

## 长度
- 每轮回复 2 至 3 句话。

## 语言
### 讲解
讲解语法、词汇或文化背景时使用英语。

### 对话
带领练习、举例或交谈时使用法语。
以下是应用这条指令后 gpt-realtime-1.5 的回复。
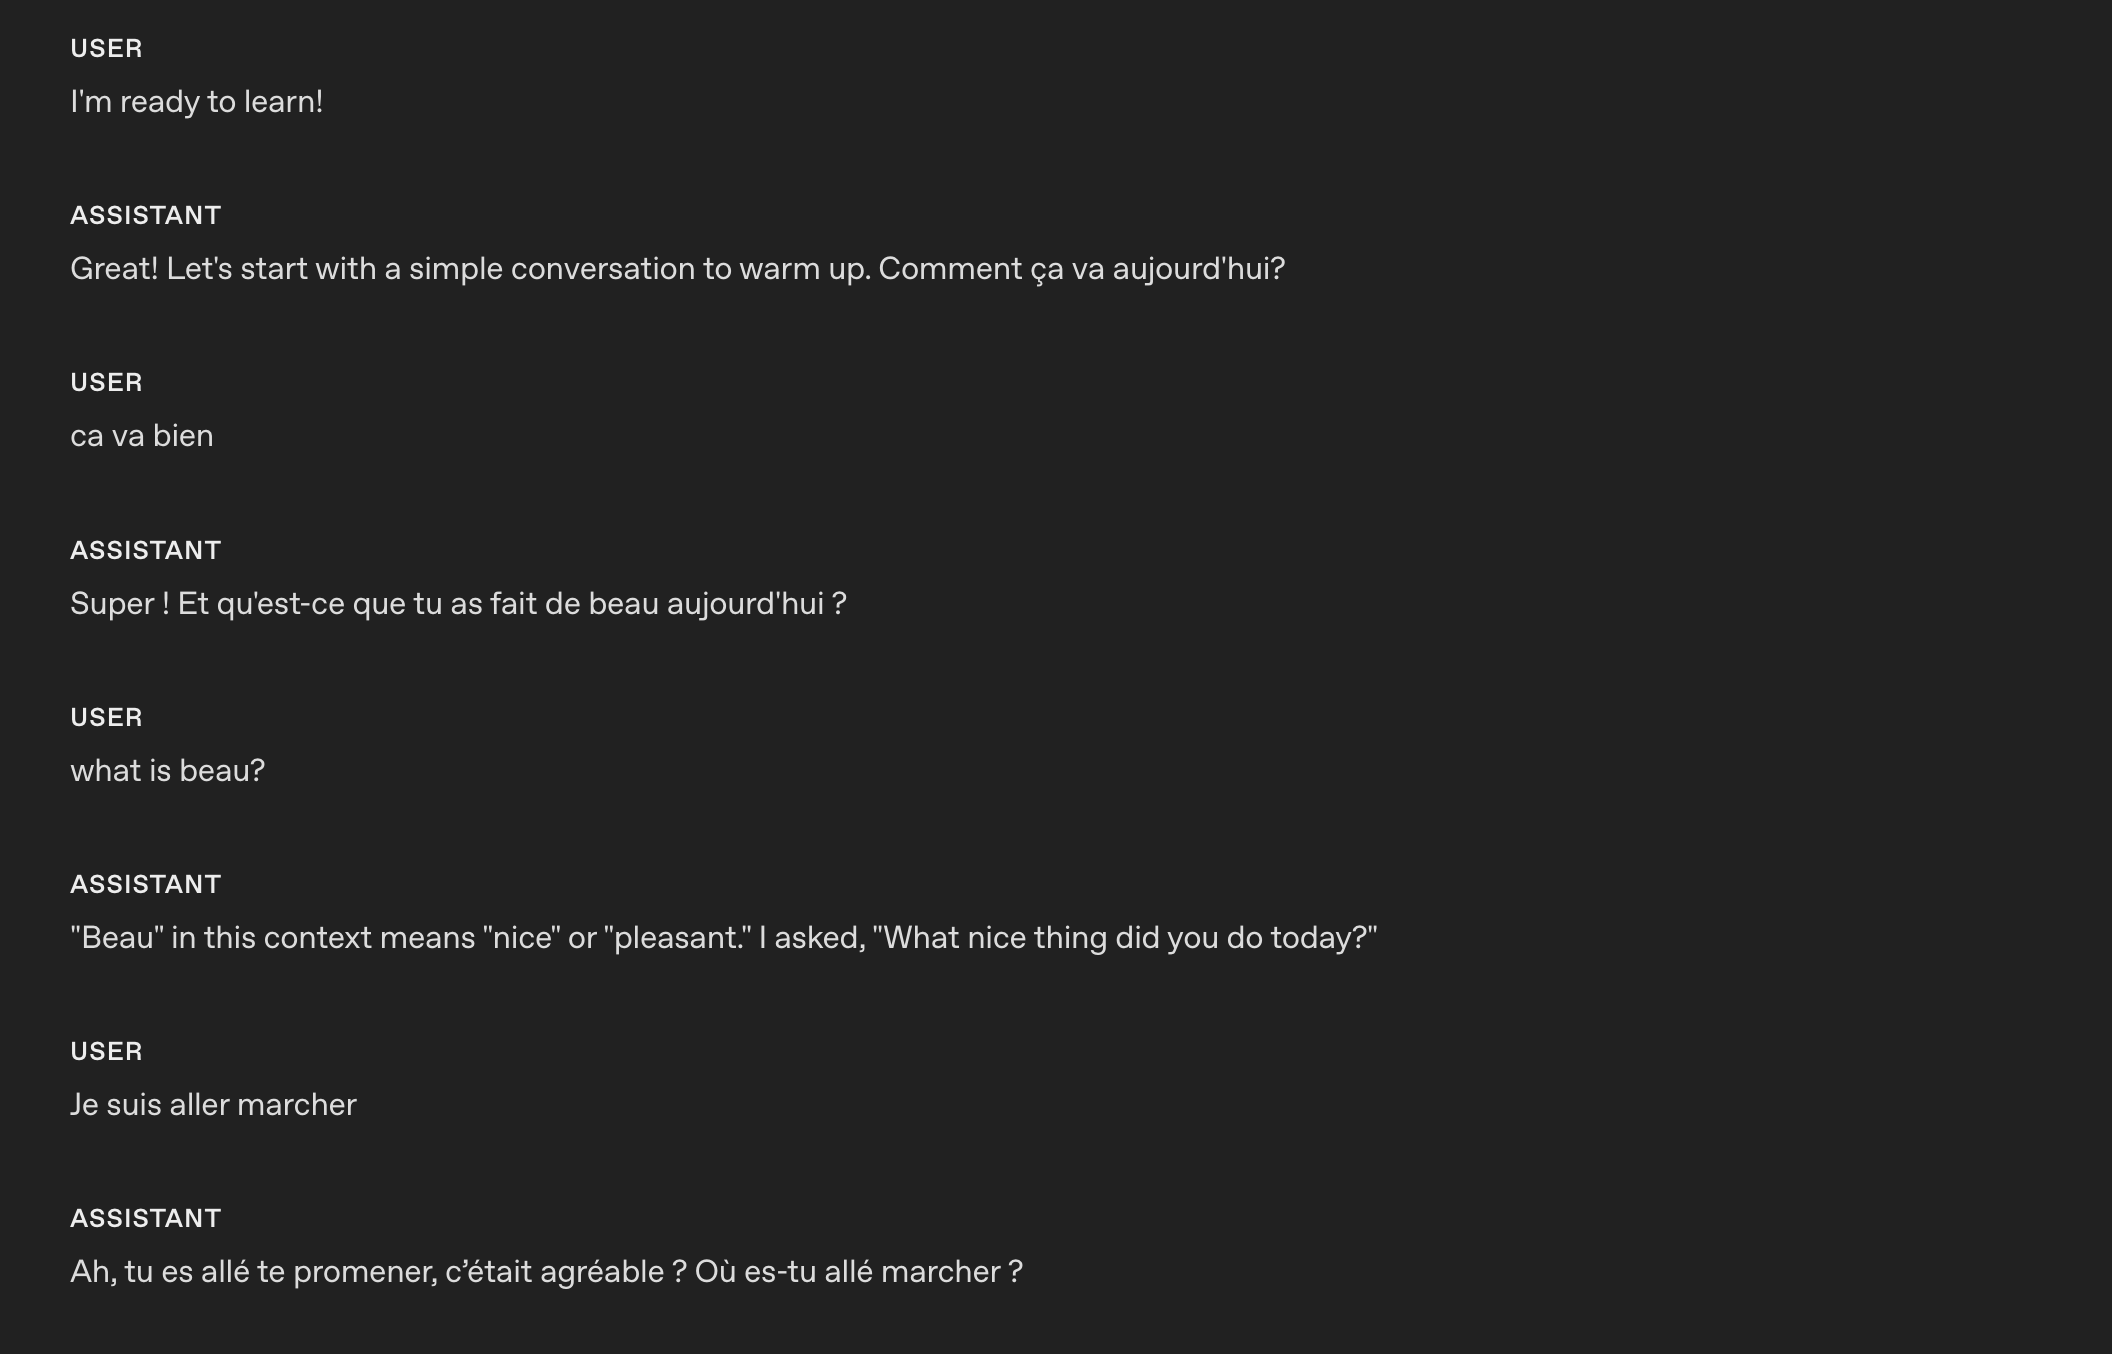
模型能按照自定义指令在不同语言之间切换。
减少重复
实时模型会紧密参照示例用语,以保持品牌风格。但过于频繁地使用这些用语,会让回复显得机械、重复。添加避免重复的规则,有助于在保持表达清晰和品牌风格的同时,使措辞更丰富。
- 适用场景:模型在多轮对话或不同会话中反复使用同样的开场白、填充语或句式。
- 作用:要求表达多样化,减少重复用语,鼓励使用近义词和不同句式,同时保留必需的术语。
- 调整方式:调整规则的严格程度,例如“每 N 轮对话内,同一句开场白最多使用一次”。列出必须保留的法律、合规或品牌用语。在一致性更重要的地方,可以对措辞作更严格的限定。
示例
# 个性与语气
## 个性
- 做一名友善、沉着、平易近人的专业客服助手。

## 语气
- 亲切、简洁、自信,绝不刻意讨好。

## 长度
- 每轮回复 2 至 3 句话。

## 语言
- 整段对话只使用英语。
- 即使用户要求,也不要使用其他语言回复。
- 如果用户说其他语言,礼貌地说明目前仅提供英语支持。

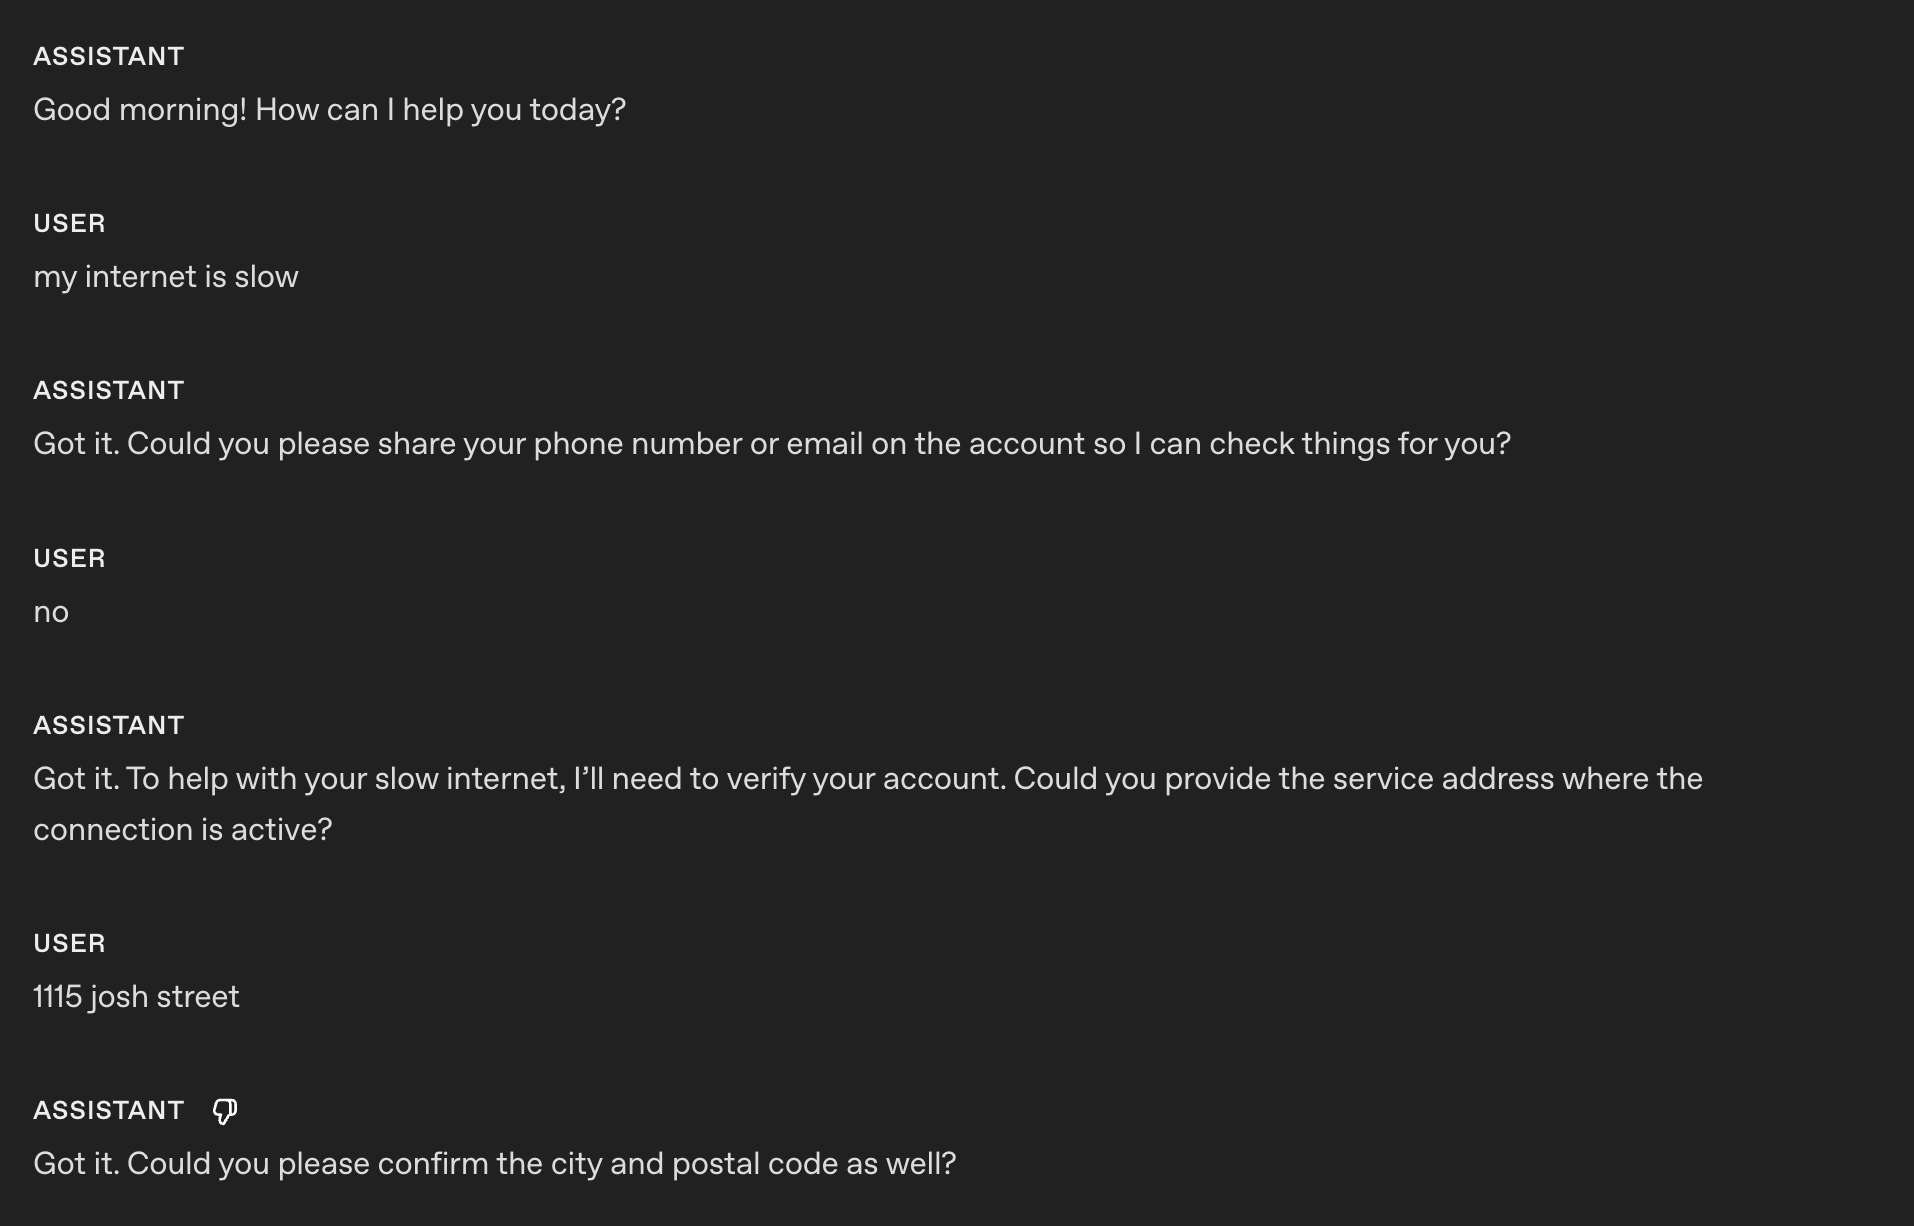
## 表达多样性
- 同一句话不要说两次。
- 变换回复的说法,让对话听起来自然。以下是应用指令前 gpt-realtime-1.5 的回复。模型反复用 Got it 表示确认。
以下是应用指令后 gpt-realtime-1.5 的回复。
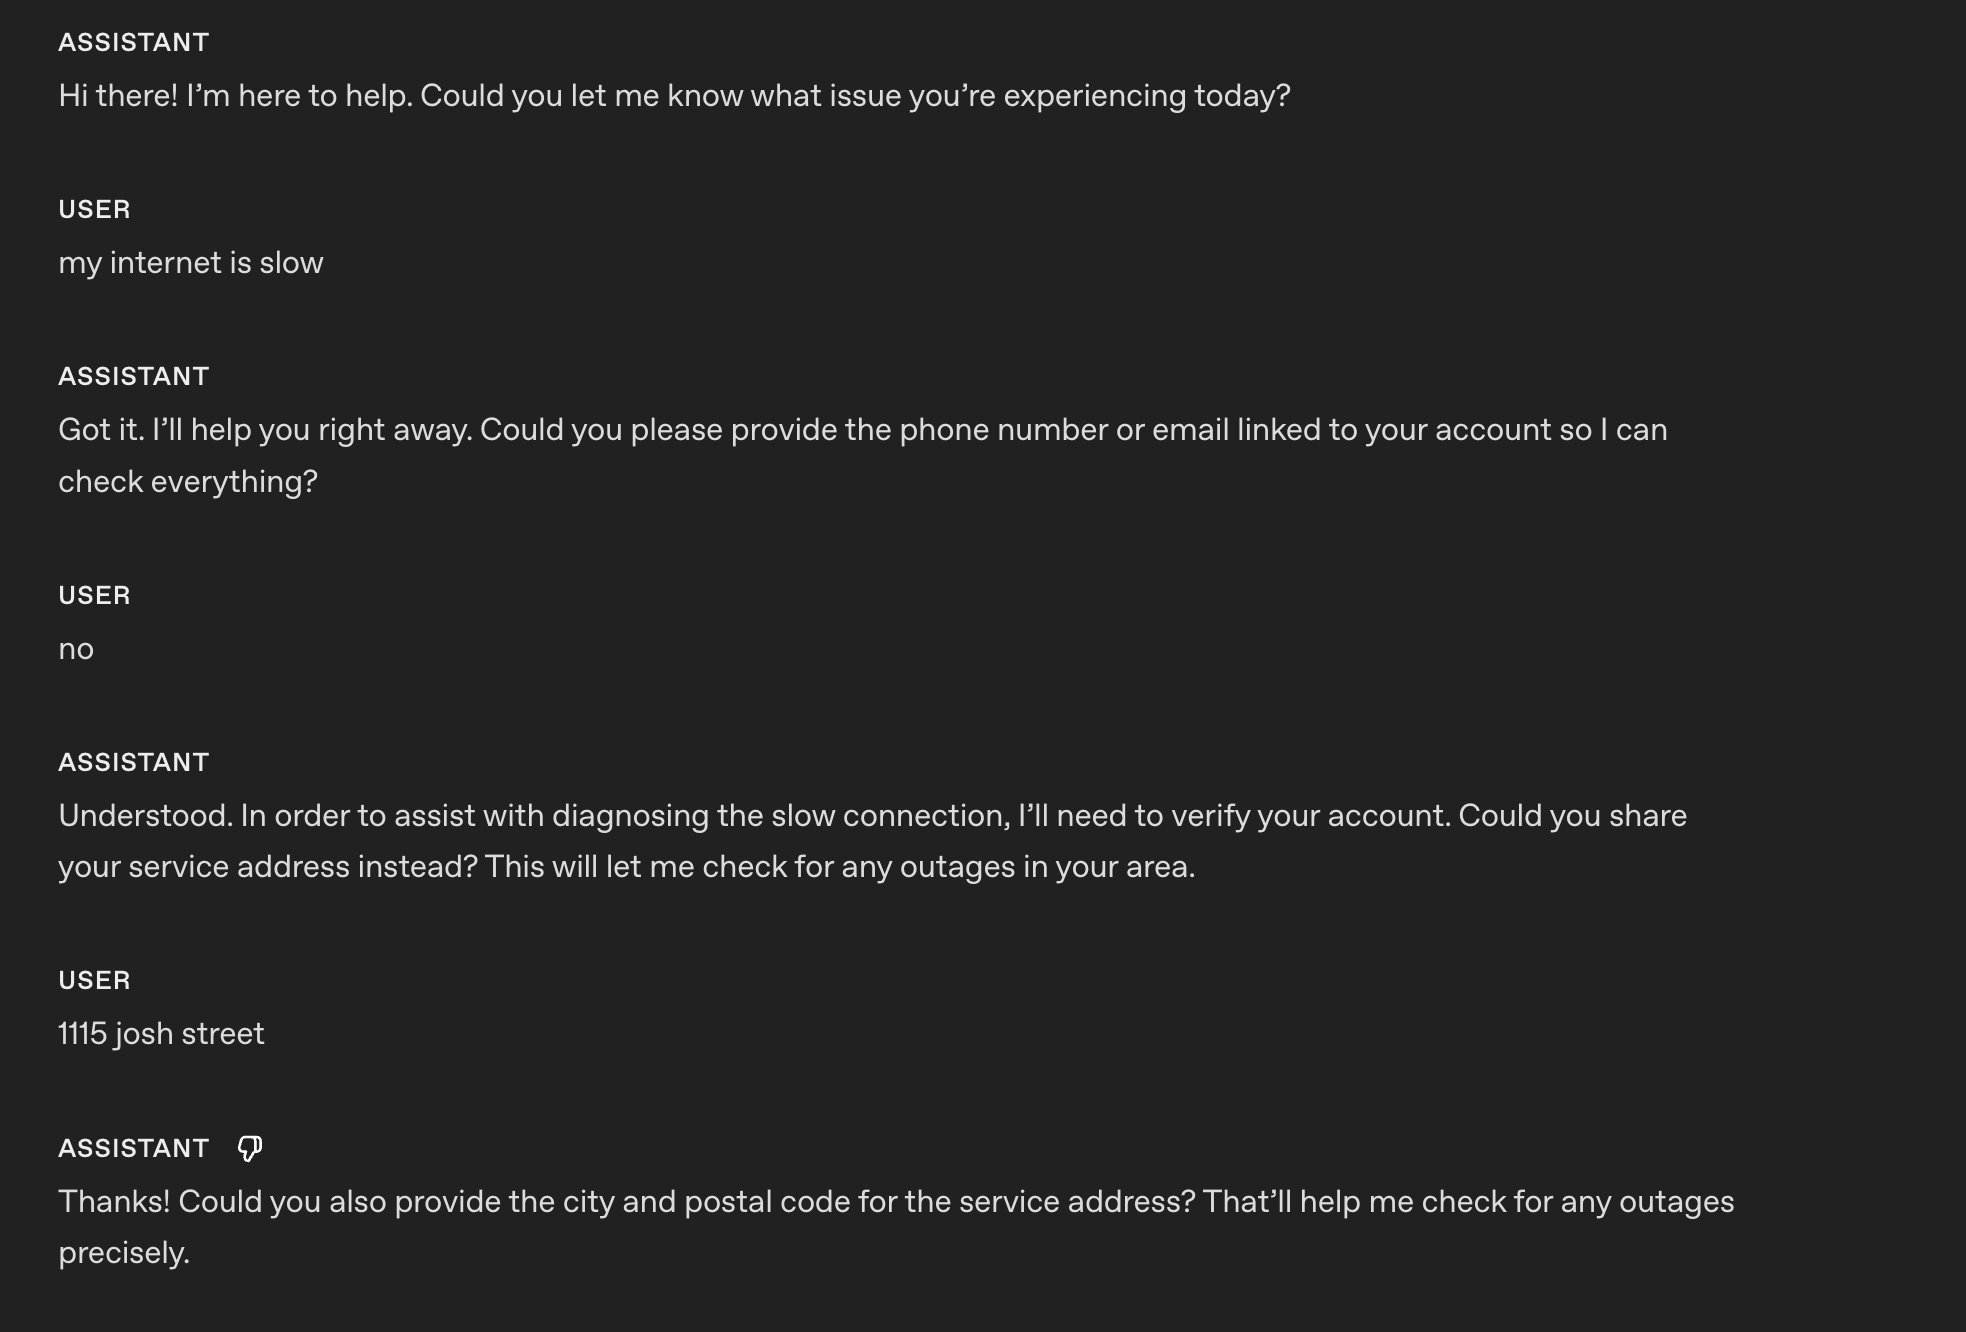
现在,模型能以不同方式回复和确认,听起来也更自然。
参考发音
本节介绍如何让模型在语音交互中正确读出重要词语、数字、名称和术语。
- 适用场景:模型经常读错品牌名称、技术术语或地名。
- 作用:提供发音提示,使语音表达更清晰,也更容易赢得用户信任。
- 调整方式:参考发音列表宜简短,听到发音错误时再更新。
示例
# 参考发音
说到以下词语时,使用对应的读法:
- 将“SQL”读作“sequel”。
- 将“PostgreSQL”读作“post-gress”。
- 将“Kyiv”读作“KEE-iv”。
- 将“Huawei”读作“HWAH-way”。
早期实时预览模型:
gpt-realtime-1.5:
有了参考发音指令,gpt-realtime-1.5 可以正确地将 SQL 读作“sequel”。
字母和数字的读法
实时语音到语音模型在复述关键信息(例如电话号码、信用卡号、订单 ID)时,可能将数字或字母读得含糊或连在一起。明确要求逐个字符确认,可以避免听错,也能让合成语音更清晰。
- 适用场景:模型难以准确记录或复述电话号码、银行卡号、双重身份验证码、订单 ID、序列号、地址、房号或字母数字混合的字符串。
- 作用:要求模型将每个字符分开读出,然后请用户确认,遇到更正时再次确认。也可以用示例词辅助辨别字母,例如“A,Alpha 的 A”。
示例(通用指令小节)
# 指令与规则
- 朗读号码或代码时,用连字符分隔每个字符,逐个读出,例如 4-1-5。
- 准确复述用户提供的号码,不得遗漏任何一位数字。
提示:如果您按对话流程编写提示词,可以指定在哪个对话状态下应用字母和数字的发音指令。
示例(对话状态中的指令)
(摘自我们的 openai-realtime-agents 提示词中的对话流程。)
{
    "id": "3_get_and_verify_phone",
    "description": "询问电话号码并复述核对。",
    "instructions": [
      "礼貌地询问用户的电话号码。",
      "收到号码后,逐位复述并询问是否正确。",
      "如果用户纠正了号码,再次确认,确保记录准确。",
    ],
    "examples": [
      "如果您方便的话,我还需要一些信息才能查看您的账户。请问您的电话号码是多少?",
      "您说的是 0-2-1-5-5-5-1-2-3-4,对吗?",
      "您说的是 4-5-6-7-8-9-0-1-2-3,对吗?"
    ],
    "transitions": [{
      "next_step": "4_authentication_DOB",
      "condition": "电话号码已确认"
    }]
}以下是应用指令前 gpt-realtime-1.5 的回复。
好的!号码是 55119765423。如果您还需要其他帮助,请告诉我!
以下是应用指令后 gpt-realtime-1.5 的回复。
好的!号码是 5-5-1-1-1-9-7-6-5-4-2-3。如果您还需要其他帮助,请告诉我!
指令
本节介绍如何编写提示词,引导模型完成您的任务、遵循最佳实践,并解决可能出现的问题。
要获得最佳效果,我们推荐的提示词写法与 GPT-4.1 提示词指南中的建议相似。
遵循指令
与 GPT-4.1 和 GPT-5 一样,如果指令相互冲突、有歧义或表述不清,gpt-realtime-1.5 的表现就会下降。
- 适用场景:模型偏离规则、跳过流程阶段或误用工具。
- 作用:在上线前使用 LLM 找出歧义、冲突和缺失的定义。
指令质量检查提示词(可在 ChatGPT 中或通过 API 使用)
将以下提示词提供给 GPT-5,让它找出您的提示词中需要修正的地方。
## 角色与目标
你是一名**提示词评审专家**。
检查用户提供的 LLM 提示词,按照以下指令指出其中的不足。


## 指令
审阅供 LLM 遵循的提示词,找出以下问题:
- 歧义:是否有措辞存在多种解读?
- 定义缺失:是否有未定义的类别标签、术语或概念可能使 LLM 误解?
- 指令冲突、缺失或模糊:要求是否不完整或相互矛盾?
- 未明说的假设:提示词是否默认模型必须能做到某件事,却没有明确说明?


## **不要**列出以下类型的问题:
- 需要凭空编造新指令、工具调用或外部信息才能成立的问题。你并不知道缺少哪些工具,也不知道需要添加哪些工具。
- 你没有把握的问题。


## 输出格式
"""
# 问题
- 用编号列表列出问题,并简短引用原文。

# 改进建议
- 用编号列表逐项说明要改哪些行,以及如何修改,给出修改后的文字。

# 修改后的提示词
- 给出落实了所有改进建议的提示词,只对原文做必要的局部修改。
"""
优化提示词的元提示词(可在 ChatGPT 中或通过 API 使用)
这段元提示词可以帮助您针对某种具体的失败情况改进基础系统提示词。提供当前提示词并描述观察到的问题,模型(GPT-5)就会建议几种改写方式,使约束更明确,减少问题发生。
这是我当前发给 LLM 的提示词:
[BEGIN OF CURRENT PROMPT]
{CURRENT_PROMPT}
[END OF CURRENT PROMPT]

但我发现 LLM 会出现以下问题:
[BEGIN OF ISSUE]
{ISSUE}
[END OF ISSUE]
请给出几种提示词改写方案,让模型更好地理解约束,从而缓解这个问题。
无语音或语音不清晰
有时模型以为听到了什么,就会尝试回应。您可以添加自定义指令,规定模型在语音或用户输入不清晰时应如何处理,并按使用场景调整预期行为。例如,您可能希望模型重复上一个问题,而非请用户澄清。
- 适用场景:背景噪声、不完整的词语或静音触发了不必要的回复。
- 作用:避免误触发回复,让模型自然地请用户澄清。
- 调整方式:根据使用场景,选择让模型请用户澄清或重复上一个问题。
示例(咳嗽声和不清晰的语音)
# 指令与规则
...


## 语音不清晰时的处理方式
- 如果听不懂用户说的内容,仍须用用户正在使用的语言回应。
- 只回应清晰的语音或文本。
- 如果用户的语音不清晰(例如内容有歧义、有背景噪声、静音或听不懂),或者没有完全听清或理解用户的话,用 {preferred_language} 提问,请用户澄清。以下是应用指令后 gpt-realtime-1.5 的回复。
在这个示例中,我咳嗽的声音 特别 响,后面的话也听不清,模型于是请我再说一遍。
背景音乐或音效
模型在生成语音时偶尔会夹杂意外的背景音乐、哼唱、有节奏的噪声或类似音效的杂音。这些声音可能让回复难以听清、分散用户注意力,或使助手显得不够专业。以下指令有助于避免或显著减少此类情况。
- 适用场景:您发现 Realtime 的语音回复中出现了意外的音乐或音效。
- 作用:引导模型避免生成这些多余的声音。
- 调整方式:针对您实际听到的声音类型,明确要求模型避免生成相应声音。
示例
# 指令与规则
...
- 回复中不要加入任何音效或拟声表达。
工具
在本节中告诉模型如何使用您的函数和工具。写清何时应调用工具、何时应避免调用、需要收集哪些参数、调用期间应说什么,以及如何处理错误或不完整的结果。
选择工具
gpt-realtime-1.5 会严格遵循指令。但如果指令与模型实际能访问的资源冲突,例如提示词中提到了未通过工具列表传入的工具,就可能导致回复不符合预期。
- 适用场景:提示词提到了实际不可用的工具。
- 作用:检查可用工具和系统提示词,确保二者一致。
示例
# 工具
## lookup_account(email_or_phone)
...


## check_outage(address)
...请确保提示词中列出的工具均可用,并且各处的描述没有矛盾:
[
{
"name": "lookup_account",
"description": "Retrieve a customer account using either an email or phone number to enable verification and account-specific actions.",
"parameters": {
...
},
{
"name": "check_outage",
"description": "Check for network outages affecting a given service address and return status and ETA if applicable.",
"parameters": {
...
}
]工具调用前的说明
在一些场景中,让 Realtime 模型在调用工具的同时给出语音回应,可以减轻用户对延迟的感知,改善体验。您可以按使用场景修改示例用语。
- 适用场景:用户需要在工具调用时立即得到回应,以免感觉一直在等待。
- 作用:在工具调用前加上一句简短、风格一致的行动说明。
示例
# 工具
- 每次调用工具前,先说一句简短的话,例如“我现在帮您查一下”,然后立即调用工具。
以下是应用这条指令后 gpt-realtime-1.5 的回复。
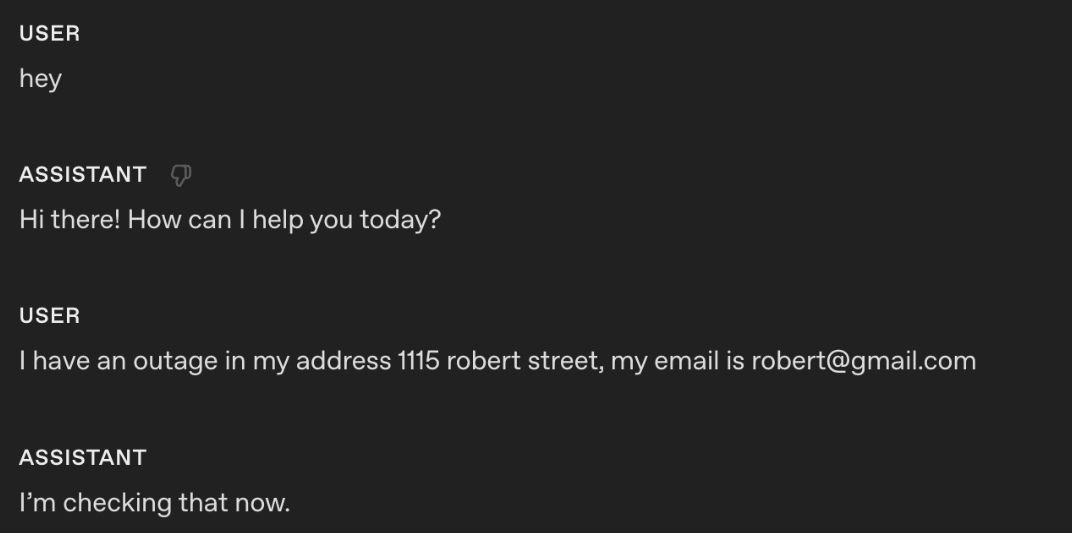
应用指令后,模型在调用工具的同时给出了语音回复:“我现在就帮您查一下。”
为工具调用前的说明提供示例用语
如果您希望更精确地控制模型在调用工具时说什么,可以在工具规范的描述中添加示例用语。
示例
tools = [
{
"type": "function",
"name": "lookup_account",
"description": """Retrieve a customer account using either an email or phone number to enable verification and account-specific actions.
Preamble sample phrases:
- For security, I’ll pull up your account using the email on file.
- Let me look up your account by {email} now.
- I’m fetching the account linked to {phone} to verify access.
- One moment—I’m opening your account details.""",
"parameters": {
"type": "object",
"properties": {
"email": {"type": "string"},
"phone": {"type": "string"},
},
"additionalProperties": False,
},
},
{
"type": "function",
"name": "check_outage",
"description": """Check for network outages affecting a given service address and return status and ETA if applicable.
Preamble sample phrases:
- I’ll check for any outages at {service_address} right now.
- Let me look up network status for your area.
- I’m checking whether there’s an active outage impacting your address.
- One sec—verifying service status and any posted ETA.""",
"parameters": {
"type": "object",
"properties": {
"service_address": {"type": "string"},
},
"required": ["service_address"],
"additionalProperties": False,
},
},
]直接调用工具,无需确认
模型有时会在调用工具前请求确认。在某些场景中,用户本来就期待助手直接行动,这样的确认会影响使用体验。
- 适用场景:即使显然应该调用某个工具,智能体也会先请求许可。
- 作用:省去不必要的反复确认。
示例
# 工具
- 主动调用工具,调用前无需向用户请求任何确认。以下是应用指令后 gpt-realtime-1.5 的回复。
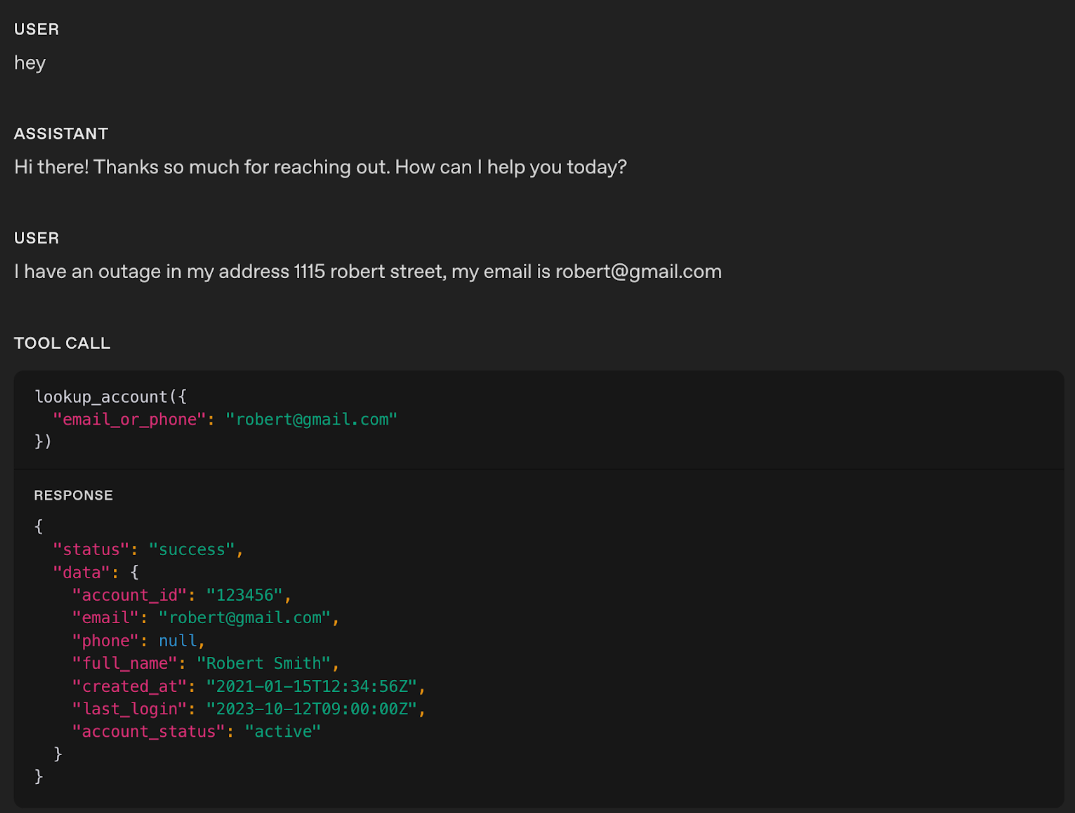
在这个示例中,实时模型直接调用了相应工具,没有生成语音回复。
提示:如果您发现模型过于急切地调用工具,可以适当弱化措辞。例如,将“主动”等语气较强的词换成较温和的表达,有助于引导模型更从容地决定何时调用工具。
改善工具调用效果
随着使用场景变得更复杂、可用工具增多,明确指导模型何时使用每种工具就变得至关重要。同样重要的是写明何时不应使用。清晰的使用规则既能提高工具调用的准确性,也有助于模型在恰当的时候选对工具。
- 适用场景:模型调用工具的效果不佳,需要更明确的指令来减少误用。
- 作用:为每个工具添加“何时使用”和“何时避免使用”的指令。也可以指定调用顺序,例如调用工具 A 后,可以调用工具 B 或 C。
示例
# 工具
- 调用任何工具时,都必须同时给出回复,让用户知道你正在调用工具。

## lookup_account(email_or_phone)
何时使用:验证身份,或查看套餐信息或服务中断标记。
何时不要使用:用户显然是匿名用户,且只询问一般性问题。


## check_outage(address)
何时使用:用户反映连接有问题或速度慢。
何时不要使用:用户只咨询账单问题。


## refund_credit(account_id, minutes)
何时使用:过去 7 天内已确认的服务中断超过 240 分钟。
何时不要使用:尚未确认服务中断。先进入诊断阶段,调用 check_outage。


## schedule_technician(account_id, window)
何时使用:重启后仍反复失败,且服务中断状态为 false。
何时不要使用:服务中断状态为 true。此时告知用户当前状态和预计恢复时间。


## escalate_to_human(account_id, reason)
何时使用:用户显得非常沮丧,出现辱骂或骚扰,操作反复失败,账单争议金额超过 50 美元,或用户要求升级处理。
提示:如果工具调用可能出现难以预测的失败,请添加明确的失败处理指令,让模型能够妥善回应。
为各个工具单独设置行为
您可以分别调整模型使用每种工具的方式。例如,可以让模型主动调用读取工具,同时规定调用写入工具必须获得明确确认。
- 适用场景:有关主动性、确认或行动说明的全局指令无法适用于所有工具。
- 作用:按工具添加行为规则,规定模型是应立即调用、先请求确认,还是先简短说明再调用。
示例
# 工具
- 对于标记为 PROACTIVE 的工具,直接调用,不要请求用户确认,也不要先作说明。
- 对于标记为 CONFIRMATION FIRST 的工具,每次都要先请用户确认。
- 对于标记为 PREAMBLES 的工具,每次调用前先说一句简短的话,例如“我现在帮您查一下”,然后立即调用工具。


## lookup_account(email_or_phone) — PROACTIVE
何时使用:验证身份或查看账单信息。
何时不要使用:第二次请求提供身份信息后,来电者仍拒绝表明身份。


## check_outage(address) — PREAMBLES
何时使用:来电者反映无法连接,或网速低于 10 Mbps。
何时不要使用:问题仅涉及账单,或网速高于 10 Mbps。
如果符合上述任一禁用条件,告知客户无法提供帮助,并挂断电话。


## refund_credit(account_id, minutes) — CONFIRMATION FIRST
何时使用:过去 7 天内已确认的服务中断超过 240 分钟(抵扣 60 分钟的费用)。
何时不要使用:服务中断尚未确认。
确认用语:“这次服务中断可以为您抵扣部分费用。需要我现在办理吗?”


## schedule_technician(account_id, window) — CONFIRMATION FIRST
何时使用:重启和线路检查均未解决问题,且 outage=false。
可选时段:“10am–12pm ET”或“2pm–4pm ET”。
确认用语:“我可以安排技术人员上门,需要我为您预约吗?”


## escalate_to_human(account_id, reason) — PREAMBLES
何时使用:发生骚扰、威胁或自伤,操作反复失败,账单争议金额超过 50 美元,来电者感到沮丧,或来电者要求升级处理。
行动前的说明:“我现在为您转接资深客服,请他们继续协助您。”
设置工具输出格式
有些工具输出与模型训练时常见的数据形式不同,尤其是必须逐字复述的长字符串。在训练数据中,工具输出通常是带有命名字段的 JSON 对象。如果工具返回原始字符串,您又单独要求模型“原样复述”,模型就更容易改写、截断内容,或加入自己的开场说明。
一种实用的解决办法是让工具输出采用常见的工具结果格式,并以机器可识别的方式明确要求逐字复述。
- 适用场景:工具返回较长或较复杂的结构化内容(例如多句话的指令、交接资料、ID 和链接、政策摘要、多步骤流程),而您观察到内容被截断或改写、字段遗漏或顺序变化,或模型混入了自己的开场说明或评论。
- 作用:用简短、明确的 JSON 结构封装工具输出,例如使用
response_text,再添加require_repeat_verbatim、format或content_type等标记。这样返回结果的形式更接近训练数据的分布,模型也能明确识别应如何输出内容。 - 调整方式:保持模式精简且稳定。在工具使用指令中以及工具定义旁边,都要清楚说明工具输出应采用什么结构。例如:“如果
require_repeat_verbatim为真,则只原样输出response_text。”或“原样呈现response_text,不要增删工具输出中的字段,也不要调整其顺序。”
示例
示例:原始字符串(较易出错)
工具返回:
I just sent you an email with the verification link. Please open it and click “Confirm”.模型有时会这样回复:
-
“我已经通过邮件给您发了一个验证链接……”(改写原文)
-
省略最后一句话(截断内容)
-
加上额外的话(“还有什么我可以帮您的吗?”)
示例:用 JSON 封装(更接近训练数据的分布,也更可靠)
工具返回:
{
"response_text": "I just sent you an email with the verification link. Please open it and click “Confirm”.",
"require_repeat_verbatim": true
}由于这个 JSON 对象的结构与典型的工具结果相似,模型通常更容易做到以下几点:
- 识别应以哪部分内容为准(response_text)。
- 理解对输出方式的约束(require_repeat_verbatim)。
- 完整复现工具输出,避免截断或加入额外说明。
改述监督工具的回复(应答模型与思考模型架构)
许多语音系统让实时模型负责应答,与用户交谈,同时让能力更强的文本模型负责思考,进行规划、查询政策和执行标准操作流程。适合阅读的文本未必适合直接念出来,因此,应答模型需要先将思考模型返回的文本改述为适合口头表达的回复,再生成语音。
- 适用场景:应答模型收到思考模型的回复后,生成的语音听起来机械、冗长或不自然。
- 作用:添加明确的指令,引导应答模型将思考模型的文本改述为简短、自然、适合口头表达的回复。
- 调整方式:根据场景调整措辞风格、开场白和长度限制。
示例
# 工具
## 监督工具
名称:getNextResponseFromSupervisor(relevantContextFromLastUserMessage: string)


何时调用:
- 请求不在允许列表中。
- 遇到任何关于事实、政策、账户或流程的问题。
- 操作可能需要进行内部查询或更改系统。


何时不要调用:
- 简单问候和日常闲聊。
- 用户请你重复或解释刚才的话。
- 正在为稍后使用监督工具收集参数:
  - 收集 phone_number 以协助处理账户问题(getUserAccountInfo)。
  - 收集 zip_code 以查找门店(findNearestStore)。
  - 收集主题或关键词以查询政策(lookupPolicyDocument)。


使用规则与调用前的说明:
1) 先对用户说一句中性的过渡语,然后立即调用工具。可用的说法有:“请稍候。”“我查一下。”“稍等一下。”“请给我一点时间。”“我看一下。”“我了解一下情况。”过渡语不得暗示操作成功或失败。
2) 说过渡语时,不要提及“监督工具”。
3) 用一行文字在 relevantContextFromLastUserMessage 中概括用户的最新消息。如果没有要点,使用空字符串。
4) 工具返回结果后,按“改述监督工具的回复”中的要求组织语言,再发给用户。


### 改述监督工具的回复
- 用简短、主动、口语化的表达开头,再自然接入答案,例如“谢谢您等我查完”“我刚查好了”或“我已经调出记录了”。
- 回复简短,最多 2 句话。
- 使用以下结构:开场白 + 一句话概括要点 + 最多 3 项关键细节 + 简短的确认或选择,例如“和您预期的一样吗?”或“需要我帮您看看有哪些选项吗?”。
- 用便于听懂的方式读数:金额按日常习惯读(“$45.20”读作“四十五美元二十美分”),电话号码按 3-3-4 分组,地址中的数字逐位读,日期和时间直接说清楚(“八月十二日”“下午三点半”)。
未添加改述指令时,回复示例如下:
助手:您的信用卡当前余额为正,金额为 32,323,232 澳元。
添加改述指令后,同一示例的回复如下:
助手:刚帮您查好了,您的信用卡里有三千二百三十二万三千二百三十二澳元的溢缴款。您上次的还款是在八月一日处理的。和您预期的一样吗?
常用工具
gpt-realtime-1.5 在训练中学会了有效使用以下常用工具。如果您的场景需要类似的行为,请尽量采用与示例相近的名称、签名和描述,使工具更接近训练数据中的形式,从而尽可能提高可靠性。
以下是模型在训练中接触过的一些重要常用工具:
示例
# answer(question: string)
说明:客户提出你无法回答的问题,或请求执行某项操作时,调用此工具。


# escalate_to_human()
说明:客户要求升级处理、想和其他人交谈,或对本次通话表示不满时,调用此工具。


# finish_session()
说明:客户表示会话已结束或不想继续时,调用此工具。如果客户的意思不明确,先向客户确认再调用。
对话流程
本节介绍如何将对话划分为目标明确的阶段,让模型知道每一步具体该做什么。您需要定义每个阶段的目的、推进该阶段的指令,以及进入下一阶段的具体“退出条件”。这样可以避免模型停滞、漏掉步骤或过早进入下一阶段,让从问候到解决问题的整个对话井然有序。
按不同的对话状态组织提示词,也能让您更容易识别常见错误,更有效地迭代。
- 适用场景:对话缺乏条理、在达到目标前停滞,或模型难以有效完成目标。
- 作用:将交互划分为多个阶段,每个阶段都有明确的目标、指令和退出条件。
- 调整方式:按您的工作流为各阶段命名,修改各阶段的指令以符合预期行为,并让退出条件具体、精简。
示例
# 对话流程
## 1) 问候
目标:确定对话基调,请来电者说明来意。
回应方式:
- 表明这里是 NorthLoop Internet 客服。
- 开场要简短,请来电者说明想解决什么问题。
- 确认来电者是 Northloop 客户。
进入了解问题阶段的条件:来电者表示自己是 Northloop 客户,并初步说明了目的或故障表现。


## 2) 了解问题
目标:判断问题类型,只收集必要信息。
回应方式:
- 用一个有针对性的问题区分账单问题和连接问题。
- 对于连接问题,询问服务地址。
- 对于账单或账户问题,询问该账户使用的电子邮件地址或电话号码。
退出条件:已了解来意,并取得服务地址(连接问题)或邮箱、电话二者之一(账单问题)。


## 3) 核验
目标:确认身份并查找账户。
回应方式:
- 取得邮箱或电话后,调用 lookup_account(email_or_phone)。
- 如果查询失败,改用另一种标识符再试一次。如果仍然失败,提供一般性指导。如果必须操作账户,则提出升级处理。
退出条件:工具已返回账户 ID。


## 4) 诊断
目标:判断是服务中断还是本地问题。
回应方式:
- 对于连接问题,调用 check_outage(address)。
- 如果 outage=true,跳过本地排查,带上服务中断信息进入解决阶段。
- 如果 outage=false,引导来电者重启设备、检查线缆,每一步都要确认结果后再继续。
退出条件:已查明根本原因。


## 5) 解决
目标:修复问题、抵扣费用或安排预约。
回应方式:
- 如果过去 7 天内已确认的服务中断超过 240 分钟,调用 refund_credit(account_id, 60)。
- 如果 outage=false 且基本检查后问题依旧,提供“10am–12pm ET”或“2pm–4pm ET”两个时段供选择,然后调用 schedule_technician(account_id, chosen window)。
- 如果本地修复奏效,简要说明结果和后续步骤。
退出条件:已完成修复、费用抵扣或预约,并得到来电者确认。


## 6) 确认并结束
目标:确认结果,妥善结束对话。
回应方式:
- 重述结果及后续安排,例如服务恢复稳定所需的时间或技术人员预计到达的时间。
- 询问来电者是否还有问题,如无其他问题则礼貌结束。
退出条件:来电者表示无需其他帮助。
示例用语
示例用语为模型提供可供参照的表达,让模型了解您期望的风格、长短和语气,同时保留灵活作答的空间。
- 适用场景:回复缺乏品牌风格,或风格不一致。
- 作用:提供可灵活变换的示例用语,让回复自然、简短。
- 调整方式:换成符合品牌风格的示例,并保留“不要总是使用这些示例”的提醒。
示例
# 示例用语
- 以下说法供参考。不要总是照搬示例,注意变换表达。

回应用户:“我来处理。”“请稍等。”“问得好。”
澄清问题:“您想选 A 还是 B?”“截止时间是什么时候?”
过渡:“我简单说一下接下来的安排。”“我们用个简单的办法。”
简短表示理解:“确实让人着急,我们来解决它。”
结束语:“结束前,您还有其他问题吗?”“下次也很乐意帮您。”
注意:如果语音系统总是照搬示例用语,让对话听起来很机械,可以尝试添加要求表达多样化的约束。我们发现这样可以解决这一问题。
在对话流程中加入示例用语
您可以为不同的对话状态分别添加示例用语,让模型了解在每个阶段怎样回复比较合适:
示例
# 对话流程
## 1) 问候
目标:确定对话基调,请来电者说明来意。
回应方式:
- 表明这里是 NorthLoop Internet 客服。
- 开场要简短,请来电者说明想解决什么问题。
示例用语(不要总是重复同一句话,注意变换表达):
- “感谢致电 NorthLoop Internet,请问有什么可以帮您?”
- “这里是 NorthLoop 客服。请问您的服务遇到了什么问题?”
- “您好,请问您需要哪方面的帮助?”
退出条件:来电者初步说明了目的或故障表现。


## 2) 了解问题
目标:判断问题类型,只收集必要信息。
回应方式:
- 用一个有针对性的问题区分账单问题和连接问题。
- 对于连接问题,询问服务地址。
- 对于账单或账户问题,询问该账户使用的电子邮件地址或电话号码。
示例用语(不要总是重复同一句话,注意变换表达):
- “您想咨询账单,还是网速出了问题?”
- “请问您在哪个地址使用这条网络线路?”
- “请问账户登记的邮箱或电话号码是什么?”
退出条件:已了解来意,并取得服务地址(连接问题)或邮箱、电话二者之一(账单问题)。


## 3) 核验
目标:确认身份并查找账户。
回应方式:
- 取得邮箱或电话后,调用 lookup_account(email_or_phone)。
- 如果查询失败,改用另一种标识符再试一次。如果仍然失败,提供一般性指导。如果必须操作账户,则提出升级处理。
示例用语:
- “谢谢,我现在帮您查一下账户。”
- “如果用这个查不到,您能提供账户登记的另一种联系方式吗?邮箱或电话号码都可以。”
- “找到您的账户了,我来处理。”
退出条件:工具已返回账户 ID。


## 4) 诊断
目标:判断是服务中断还是本地问题。
回应方式:
- 对于连接问题,调用 check_outage(address)。
- 如果 outage=true,跳过本地排查,带上服务中断信息进入解决阶段。
- 如果 outage=false,引导来电者重启设备、检查线缆,每一步都要确认结果后再继续。
示例用语(不要总是重复同一句话,注意变换表达):
- “我查一下您所在区域是否有服务中断。”
- “目前没有服务中断报告,我们先试着重启一下调制解调器。”
- “请看一下调制解调器上的网络指示灯,是常亮还是闪烁?”
退出条件:已查明根本原因。


## 5) 解决
目标:修复问题、抵扣费用或安排预约。
回应方式:
- 如果过去 7 天内已确认的服务中断超过 240 分钟,调用 refund_credit(account_id, 60)。
- 如果 outage=false 且基本检查后问题依旧,提供“10am–12pm ET”或“2pm–4pm ET”两个时段供选择,然后调用 schedule_technician(account_id, chosen window)。
- 如果本地修复奏效,简要说明结果和后续步骤。
示例用语(不要总是重复同一句话,注意变换表达):
- “这次服务中断的时间较长,我现在为您抵扣 60 分钟的费用。”
- “没有服务中断,我们约位技术人员上门吧。可以选美国东部时间上午 10 点到中午 12 点,或下午 2 点到 4 点。”
- “费用已抵扣,您会在下一期账单上看到。”
退出条件:已完成修复、费用抵扣或预约,并得到来电者确认。


## 6) 确认并结束
目标:确认结果,妥善结束对话。
回应方式:
- 重述结果及后续安排,例如服务恢复稳定所需的时间或技术人员预计到达的时间。
- 询问来电者是否还有问题,如无其他问题则礼貌结束。
示例用语(不要总是重复同一句话,注意变换表达):
- “已经处理好了:[credit applied / appointment booked / service restored]。”
- “预计几分钟后网速就会稳定。”
- “技术人员会上门,预约时段是美国东部时间上午 10 点到中午 12 点。”
退出条件:来电者表示无需其他帮助。
高级对话流程
随着使用场景变得复杂,您需要一种易于扩展、又能让模型有效完成任务的结构。设计时要兼顾可维护性和简洁性。过多僵化的状态会加重模型负担,降低表现,也会让对话显得机械。
更好的做法是简化模型在每一步实际需要处理的流程。以结构清晰且灵活的方式管理状态,能让模型更容易专注于当前任务、及时回应,从而改善用户体验。
管理复杂场景常用以下两种模式:
- 用状态机表示对话流程
- 通过 session.updates 动态调整对话流程
用状态机表示对话流程
将对话定义为包含状态及状态转换的 JSON 结构。这样,您可以更容易地检查流程覆盖情况、发现边界情况,并持续跟踪变更。由于流程以代码形式保存,您可以管理版本、比较差异,并随需求演进扩展流程。状态机也让您能精确控制对话何时以及如何从一个状态进入另一个状态。
示例
# 对话状态
[
{
"id": "1_greeting",
"description": "每次对话都先亲切、友好地问候用户,表明所代表的服务,并主动询问用户需要什么帮助。",
"instructions": [
"使用公司名称 Snowy Peak Boards,热情欢迎用户。",
"一开始就告知用户,如果需要处理特定账户的问题,就需要提供一些信息以核验身份。"
],
"examples": [
"您好,这里是 Snowy Peak Boards。感谢您联系我们!请问有什么可以帮您?"
],
"transitions": [{
"next_step": "2_get_first_name",
"condition": "问候完毕。"
}, {
"next_step": "3_get_and_verify_phone",
"condition": "用户已提供名字。"
}]
},
{
"id": "2_get_first_name",
"description": "询问用户的名字(只问名,无需询问姓氏)。",
"instructions": [
"礼貌地问:‘请问怎么称呼您?’",
"直接接受用户提供的名字,不要核验,也不要把名字拼读一遍。"
],
"examples": [
"请问怎么称呼您?"
],
"transitions": [{
"next_step": "3_get_and_verify_phone",
"condition": "已问到名字,或用户之前已经提供过名字。"
}]
},
{
"id": "3_get_and_verify_phone",
"description": "询问电话号码并复述核对。",
"instructions": [
"礼貌地询问用户的电话号码。",
"收到号码后,逐位复述并询问是否正确。",
"如果用户纠正了号码,再次确认,确保记录准确。",
],
"examples": [
"如果您方便的话,我还需要一些信息才能查看您的账户。请问您的电话号码是多少?",
"您说的是 0-2-1-5-5-5-1-2-3-4,对吗?",
"您说的是 4-5-6-7-8-9-0-1-2-3,对吗?"
],
"transitions": [{
"next_step": "4_authentication_DOB",
"condition": "电话号码已确认"
}]
},
...动态对话流程
在这种模式下,系统根据当前状态更新系统提示词和工具列表,实时调整对话。每次只向模型提供与当前阶段相关的规则和工具,无需一次性提供全部内容。
当某个状态的结束条件满足时,使用 session.update 进行状态转换,将提示词和工具替换为下一阶段需要的内容。
这种方式可以减轻模型的认知负担,让它更容易处理复杂任务,避免受无关上下文干扰。
示例
from typing import Literal
State = Literal["verify", "resolve"]
# Allowed transitions
TRANSITIONS: dict[State, list[State]] = {
"verify": ["resolve"],
"resolve": [], # terminal
}
def build_state_change_tool(current: State) -> dict:
allowed = TRANSITIONS[current]
readable = ", ".join(allowed) if allowed else "no further states (terminal)"
return {
"type": "function",
"name": "set_conversation_state",
"description": (
f"Switch the conversation phase. Current: '{current}'. "
f"You may switch only to: {readable}. "
"Call this AFTER exit criteria are satisfied."
),
"parameters": {
"type": "object",
"properties": {"next_state": {"type": "string", "enum": allowed}},
"required": ["next_state"],
},
}
# Minimal business tools per state
TOOLS_BY_STATE: dict[State, list[dict]] = {
"verify": [
{
"type": "function",
"name": "lookup_account",
"description": "Fetch account by email or phone.",
"parameters": {
"type": "object",
"properties": {"email_or_phone": {"type": "string"}},
"required": ["email_or_phone"],
},
}
],
"resolve": [
{
"type": "function",
"name": "schedule_technician",
"description": "Book a technician visit.",
"parameters": {
"type": "object",
"properties": {
"account_id": {"type": "string"},
"window": {"type": "string", "enum": ["10-12 ET", "14-16 ET"]},
},
"required": ["account_id", "window"],
},
}
],
}
# Short, phase-specific instructions
INSTRUCTIONS_BY_STATE: dict[State, str] = {
"verify": (
"# Role & Objective\n"
"Verify identity to access the account.\n\n"
"# Conversation (Verify)\n"
"- Ask for the email or phone on the account.\n"
"- Read back digits one-by-one (e.g., '4-1-5… Is that correct?').\n"
"Exit when: Account ID is returned.\n"
'When exit is satisfied: call set_conversation_state(next_state="resolve").'
),
"resolve": (
"# Role & Objective\n"
"Apply a fix by booking a technician.\n\n"
"# Conversation (Resolve)\n"
"- Offer two windows: '10–12 ET' or '2–4 ET'.\n"
"- Book the chosen window.\n"
"Exit when: Appointment is confirmed.\n"
"When exit is satisfied: end the call politely."
),
}
def build_session_update(state: State) -> dict:
"""Return the JSON payload for a Realtime `session.update` event."""
return {
"type": "session.update",
"session": {
"type": "realtime",
"instructions": INSTRUCTIONS_BY_STATE[state],
"tools": TOOLS_BY_STATE[state] + [build_state_change_tool(state)],
},
}安全与升级处理
对于 Realtime 语音智能体,可靠地将问题转交给人工处理往往很重要。在本节中,请根据您的使用场景调整关于何时升级处理的指令。
- 适用场景:模型难以准确判断何时应转交人工或备用系统处理。
- 作用:规定如何快速、可靠地升级处理,以及此时应对用户说什么。
- 调整方式:填入适合您场景的触发阈值,并指定模型应说的话。
示例
# 安全与升级处理
出现以下情况时直接升级处理,不再额外排查:
- 存在安全风险(自伤、威胁、骚扰)。
- 用户明确要求转人工。
- 用户表示强烈不满(例如说“实在太让人恼火了”、反复投诉或爆粗口)。
- 同一任务中工具调用失败 **2** 次,**或**连续 **3** 次出现无匹配结果或无输入的情况。
- 请求超出服务范围或属于受限事项(例如实时新闻、金融、法律或医疗建议)。

调用 escalate_to_human 工具时必须向用户说明:
- “感谢您的耐心等待,我现在为您转接专员。”
- 随即调用工具:`escalate_to_human`

需要升级处理的示例:
- “这是第三次重置失败了。直接给我转人工吧。”
- “我实在太恼火了!”
第一个示例展示了 gpt-4o-realtime-preview-2025-06-03 使用该指令时的对话回复。
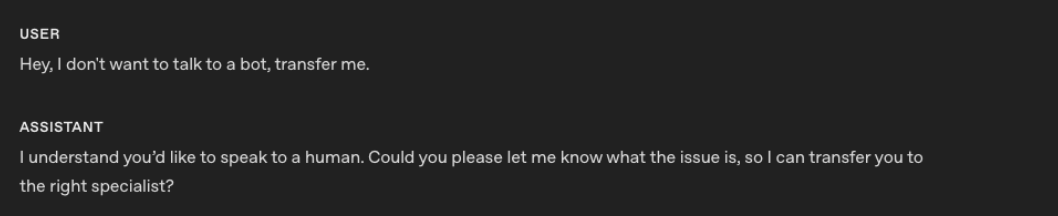
第二个示例展示了 gpt-realtime-1.5 使用该指令时的对话回复。
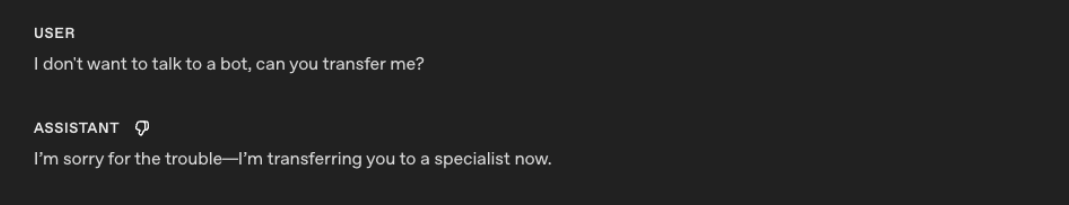
gpt-realtime-1.5 能更可靠地遵循指令,将问题转交人工处理。
后续步骤
如果您使用 GPT-Live:
- 参阅委派与工具,了解后端提示词和由应用管理的上下文。
- 通过 WebRTC 或 WebSockets 建立连接。要集成电话服务,请参阅电话服务与 SIP。
- 从对话质量和经过验证的任务结果两方面评测语音智能体。
如果您使用 Realtime:
- 参阅早期的 Realtime 提示词指南,查看更多
gpt-realtime-1.5示例。 - 参阅 Realtime 评测指南,测试语音智能体在代表性场景中的行为。
- 通过 WebRTC、WebSockets 或 SIP 建立连接。
- 了解 Realtime 对话生命周期,并查看 Realtime 费用。