
Chez Alpic, nous pensons que la prochaine génération de produits et de services reposera sur des expériences conçues dès le départ autour de l’IA. Dans ces interfaces, les utilisateurs collaborent avec des modèles au lieu de suivre des parcours prédéfinis comme dans les interfaces classiques.
Dès qu’OpenAI a lancé l’Apps SDK, nous avons commencé à l’utiliser. En trois mois, nous avons développé vingt-quatre applications ChatGPT pour nos propres besoins et pour nos clients B2B et B2C, dans des secteurs comme le voyage, le commerce de détail et le SaaS.
Nous avons vite compris que développer une application ChatGPT est fondamentalement différent de développer une application web ou mobile classique. Des pratiques qui fonctionnent bien sur le web, comme récupérer les données au dernier moment, piloter l’état depuis l’interface ou demander à l’utilisateur de configurer lui-même l’application, se révèlent souvent inefficaces dans un environnement agentique et peuvent même nuire à l’expérience.
Cet article rassemble les 15 leçons les plus importantes que nous avons tirées du développement d’applications ChatGPT en conditions réelles. Nous expliquons ensuite comment nous les avons intégrées à Skybridge, un framework open source destiné à la communauté, et à un Skill Codex pour aider les développeurs à imaginer, créer, tester et publier leurs applications beaucoup plus rapidement.
Le problème à trois corps
Dans une application web classique, les choses étaient simples : il n’y avait qu’un utilisateur et une interface. Dans une application ChatGPT, un troisième corps entre en jeu : le modèle.
L’une des difficultés du développement pour ChatGPT consiste à gérer la circulation de l’information entre ces trois acteurs. Si l’utilisateur clique sur le bouton « Sélectionner » de votre widget, l’interface change à l’écran. Mais le modèle, qui mène la conversation, ignore ce qui a changé tant que vous ne lui transmettez pas explicitement ce contexte. Si l’utilisateur demande ensuite « Donne-moi plus de détails sur ce produit », le modèle ne sait pas quel produit l’utilisateur a sous les yeux.
Nous appelons cela l’asymétrie du contexte : chacun des trois acteurs connaît une partie du système, mais aucun n’en a une vue d’ensemble. Pour créer de bonnes applications ChatGPT, il faut décider quelles informations partager, quand les partager et qui doit y avoir accès. C’est ce qui fait la différence entre une application laborieuse à utiliser et une expérience agentique fluide.
1. Une partie du contexte doit rester privée
Notre premier réflexe a été de « tout partager partout ». C’est aussi l’une de nos premières erreurs.
En pratique, il faut souvent donner aux différentes parties d’une application ChatGPT des vues volontairement différentes d’un même état. Pourquoi ?
- Pour les performances : les widgets ont souvent besoin de bien plus de données que le modèle. Dans une application de réservation de voyages, par exemple, le widget peut avoir besoin d’images, de plusieurs tarifs et d’options préchargées. Transmettre toutes ces données au modèle augmenterait la consommation de tokens et la latence, tout en noyant les informations pertinentes.
- Pour la logique de l’application : certaines informations doivent être accessibles à certains acteurs et rester cachées aux autres. Dans l’une de nos premières applications, le jeu d’enquête Murder in the Valleys, le modèle doit connaître l’identité du meurtrier pour jouer son rôle correctement. L’interface et l’utilisateur doivent l’ignorer. Dans un jeu de type Time’s Up, c’est l’inverse : l’interface montre le mot secret à l’utilisateur, tandis que le modèle doit l’ignorer.
Nous en avons tiré une règle plus précise que « toujours tout synchroniser » : décidez explicitement qui doit savoir quoi. Nous avons concrétisé cette règle en utilisant différents champs dans la sortie de l’outil :
| Champ | Rôle | Qui y a accès ? |
|---|---|---|
| structuredContent | Données typées pour le widget et le modèle | Le widget et le modèle (via les fonctions toolOutput et callTool) |
| _meta | Métadonnées de la réponse | Le widget uniquement, le modèle n’y a pas accès |
Dans notre jeu de Time’s Up, par exemple, nous transmettions le mot secret uniquement au widget, dans le champ _meta. Le modèle devait alors deviner le mot à partir des indices de l’utilisateur.
2. Le chargement différé se prête mal aux applications d’IA
Venant du développement web, nous avions le réflexe de différer le chargement : récupérer les données au clic, charger les détails à la demande et réduire au minimum le volume de données transmis au départ.
Dans ChatGPT, la logique s’inverse. Chaque appel d’outil entraîne un délai, souvent de plusieurs secondes, du fait de l’exécution en bac à sable pour des raisons de sécurité et du temps de raisonnement du modèle.
Nous avons donc pris l’habitude d’envoyer autant de données que possible dès la première réponse de l’outil, puis d’alimenter le widget avec ces données via window.openai.toolOutput. Le résultat était presque toujours plus rapide et plus réactif.
Bien sûr, si votre widget peut récupérer des données en toute sécurité depuis un point de terminaison d’API public et n’a pas besoin de les partager avec le modèle, vous pouvez y effectuer des appels XHR classiques. Mais la plupart du temps, pour préserver le caractère conversationnel de l’expérience, vous voudrez que le modèle puisse appeler les outils de façon autonome.
3. Le modèle doit savoir ce que voit l’utilisateur
Un problème discret mais crucial se pose lorsque l’utilisateur interagit avec un widget, par exemple en sélectionnant un produit dans une liste, puis pose une question dans la discussion. Si le modèle ignore à quel élément de l’interface l’utilisateur fait référence, il ne pourra pas répondre correctement.
Pour y remédier, nous avons utilisé window.openai.setWidgetState(state). Cette méthode permet d’enregistrer des données d’état précises qui seront ajoutées au contexte du modèle lors de son prochain échange avec l’utilisateur.
À mesure que nos applications se complexifiaient, nous devions ajouter setWidgetState à de nombreux endroits pour que le modèle puisse suivre la navigation. Nous avons donc choisi de décrire le contexte de l’interface de manière déclarative. Au lieu de programmer une mise à jour du contexte du modèle à chaque interaction, nous ajoutons un attribut data-llm directement aux composants :
<div
data-llm={
selectedTab === "details"
? "User is viewing product details"
: "User is viewing reviews"
}
>
Product details
</div>Pour automatiser ce mécanisme, nous avons créé un plugin Vite qui extrait ces attributs et met automatiquement à jour widgetState. Le modèle reçoit ainsi le contexte pertinent au bon moment, sans que les développeurs aient à synchroniser manuellement chaque interaction.
Vous retrouverez ce plugin Vite, ainsi que de nombreuses autres solutions présentées dans cet article, dans le framework open source que nous avons créé pour partager notre expérience avec la communauté.
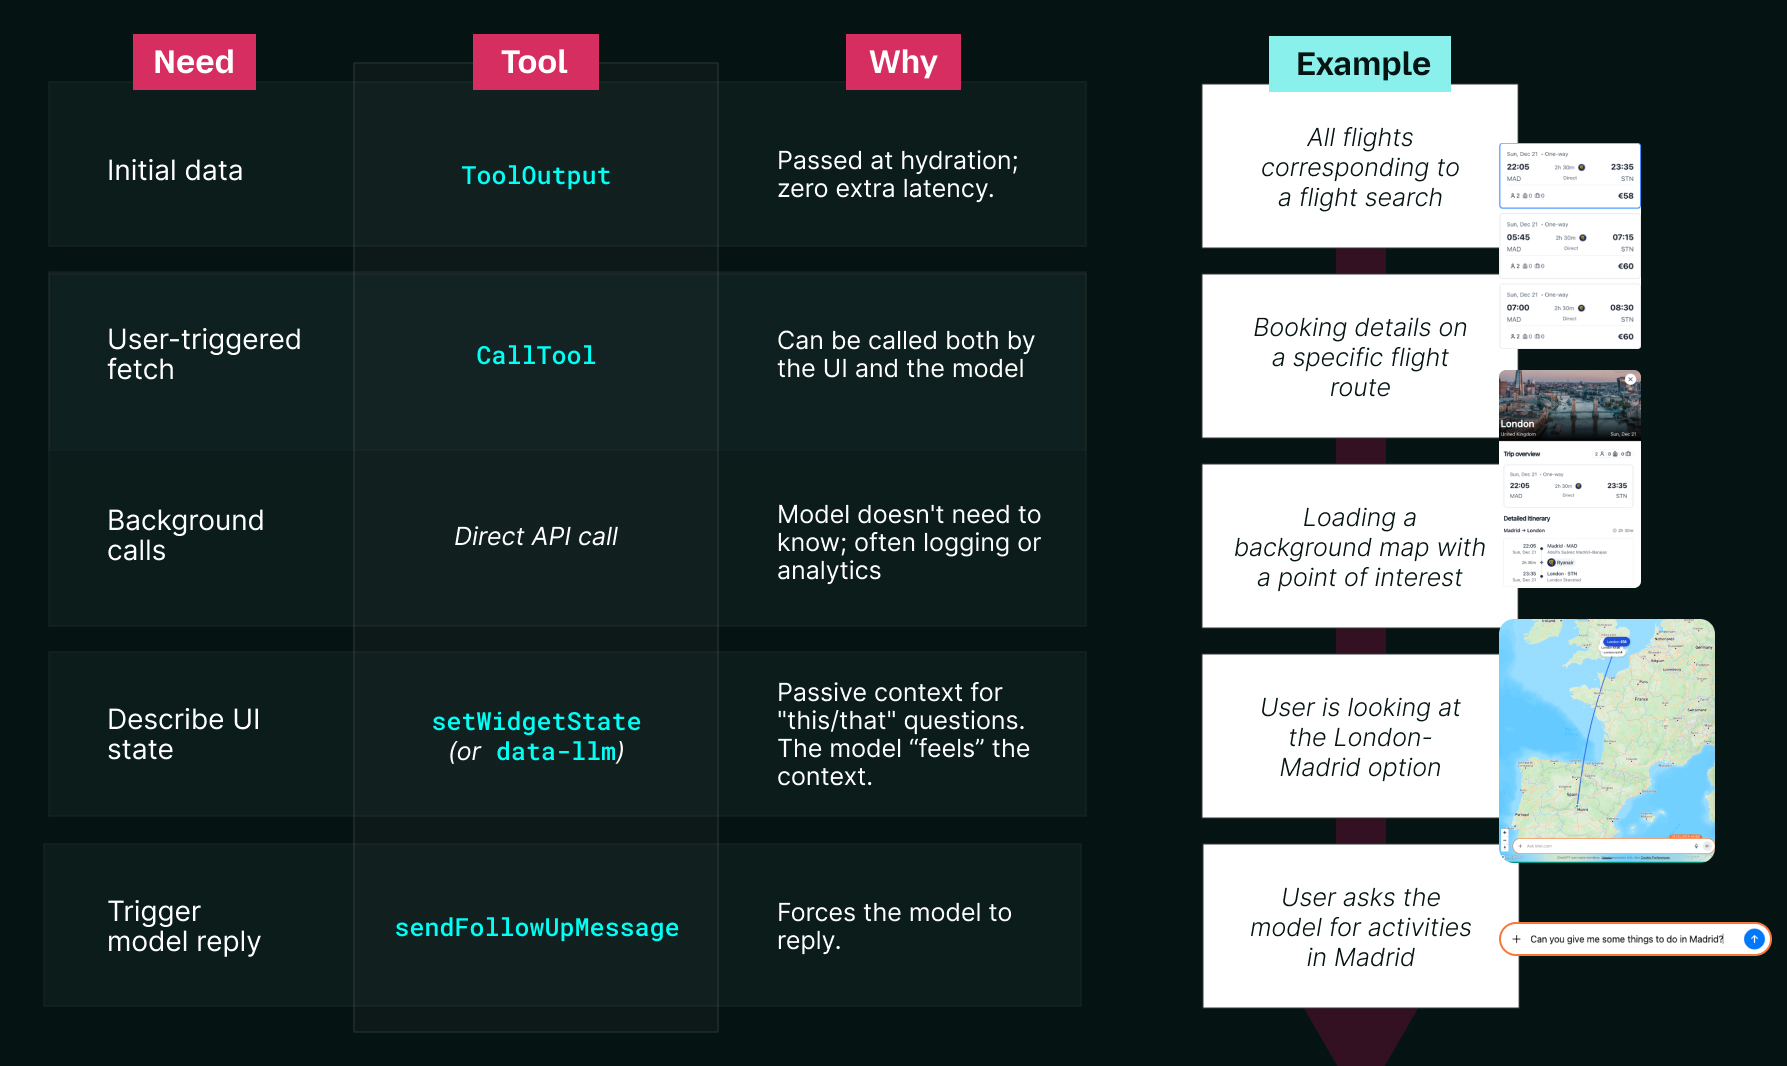
4. À chaque type d’interaction son API
Dans les applications ChatGPT, le widget, le serveur et le modèle communiquent par plusieurs voies. Ces voies ne sont pas interchangeables : chacune répond à un type d’interaction particulier.
L’une des grandes leçons que nous avons tirées de ce travail est qu’il faut décrire explicitement ces échanges et choisir le mécanisme qui prendra en charge chaque partie de l’expérience.
Voici le schéma de ces échanges :
Ces leçons posent les bases d’une application ChatGPT : comment partager le contexte, comment informer le modèle de ce que voit l’utilisateur et comment les interactions se propagent dans le système. Voyons maintenant ce que cela implique pour la conception de l’interface.
Repenser les interfaces pour l’IA
Les applications ChatGPT évoluent dans un environnement entièrement nouveau. Nous avons vite appris à mettre de côté nos idées préconçues sur les interfaces pour tirer pleinement parti des nouvelles possibilités. Pour créer des applications efficaces, nous avons dû apprendre de nouveaux principes de conception et nous défaire de certaines habitudes.
5. L’interface doit s’adapter à plusieurs modes d’affichage et à leurs contraintes
Les applications ChatGPT n’ont pas de mise en page unique. Selon la manière dont l’application est appelée et le moment où elle l’est, un même widget peut s’afficher dans trois modes différents.
Les applications peuvent apparaître dans le fil de la conversation, en incrustation (PiP) par-dessus celle-ci, ou en plein écran lorsqu’il faut davantage de place. L’incrustation et le plein écran permettent de créer des interfaces plus riches, mais y superposent aussi des éléments que le widget ne contrôle pas. Pour éviter de couper du contenu et faciliter les interactions, il est essentiel de tenir compte des zones à laisser libres sur chaque appareil, par exemple celle qu’occupe le bouton de fermeture toujours visible sur mobile.
Avec le temps, nous avons dégagé quelques repères pour choisir le mode d’affichage :
| Affichage | Quand l’utiliser | |
|---|---|---|
| Dans le fil | Mode par défaut. Le widget reste dans l’historique de la conversation. | Pour des interactions rapides. |
| Plein écran | Le widget occupe tout l’écran, avec la barre de discussion en bas. | Si votre widget est complexe et a besoin de beaucoup d’espace, par exemple pour afficher une carte. |
| Incrustation | Le widget conserve les dimensions du mode dans le fil, mais reste au-dessus de la conversation. | Si votre widget reste utile lors des échanges qui suivent la génération de la réponse. |
6. Une interface intégrée doit rester visuellement cohérente
Au début, nous ne savions pas quelle liberté prendre dans la conception visuelle d’une application ChatGPT. Cette nouvelle interface devait paraître familière aux utilisateurs et rester cohérente, tant d’une application à l’autre qu’avec l’écosystème ChatGPT. Contrairement à un produit autonome, un widget s’insère dans une interface existante, où la moindre incohérence visuelle saute aux yeux.
Heureusement, le kit d’interface de l’Apps SDK d’OpenAI nous a donné une base claire.
Construit avec Tailwind CSS, il fournit des composants prêts à l’emploi, des icônes et des tokens de design conformes au système de design de ChatGPT. Grâce à ce kit, nous avons pu avancer rapidement et créer des widgets qui s’intègrent naturellement à l’interface, même lorsque nous développions des composants sur mesure, par exemple pour notre intégration de Mapbox.
7. Filtrer d’abord en langage naturel
Les tableaux de bord classiques proposent des barres latérales remplies de cases à cocher et de curseurs pour sélectionner des plages de valeurs. Dans une interface agentique, c’est souvent un pas en arrière. Si l’utilisateur peut exprimer directement son intention en langage naturel, par exemple « Des destinations ensoleillées en Europe pour moins de 200 $ », lui imposer plusieurs manipulations complique inutilement sa recherche. Il devrait pouvoir se contenter de formuler sa demande.
Nous avons donc choisi une approche « sans filtres » pour la plupart de nos applications. Au lieu d’une barre latérale proposant des options de filtrage et de tri, nous fournissons au modèle une liste de valeurs (LOV) pour les paramètres de nos outils.
Le modèle peut ainsi utiliser directement le message de l’utilisateur en entrée, sans avoir à « deviner » les options disponibles. Il peut donc traduire une demande en langage naturel en paramètres attendus par notre API côté serveur. Si l’utilisateur demande une destination « ensoleillée », le modèle sait qu’il doit appeler l’outil avec weather=“sunny”.
8. Les fichiers ouvrent de nouvelles possibilités d’interaction
En développant des applications plus complexes, nous avons compris que les fichiers méritaient autant d’attention que les autres entrées. Dans les applications ChatGPT, ils permettent de nouvelles interactions. Au lieu de commencer par un formulaire ou des filtres, l’utilisateur peut partir d’un élément qu’il a déjà sous la main.
Dans une application de commerce en ligne, par exemple, l’utilisateur peut envoyer la photo d’un produit dans la discussion et demander au modèle de l’identifier. Il peut ensuite retrouver un produit correspondant ou en découvrir d’autres directement dans le widget.
Pour cela, les fichiers doivent pouvoir circuler des deux côtés du système. Côté modèle, les outils peuvent exploiter directement les fichiers envoyés dans la discussion via openai/fileParams. Le modèle peut ainsi raisonner à partir d’images ou d’autres ressources fournies par l’utilisateur. Côté interface, les widgets peuvent aussi manipuler directement les fichiers avec window.openai.uploadFile et window.openai.getFileDownloadUrl. Ils peuvent ainsi demander à l’utilisateur d’envoyer un fichier à une étape du parcours ou générer des fichiers qu’il pourra télécharger et réutiliser.
Passer en production
Lorsque les applications quittent l’environnement de développement local, d’autres questions se posent en matière de sécurité, de configuration et d’outillage. C’est l’objet de cette troisième série de leçons.
9. Les CSP prennent la relève de CORS
Pour des raisons de sécurité, OpenAI affiche les applications dans deux iframes imbriquées. Les politiques de sécurité du contenu (CSP) sont un mécanisme natif d’isolation des iframes. Dans cette configuration, elles s’appliquent strictement, d’où le grand classique : « Ça marche en local, mais ça casse en production. »
En développement web classique, on peut parfois s’en sortir avec une politique permissive. L’Apps SDK exige beaucoup de précision.
Dans le manifeste de l’application, il faut donc déclarer avec soin les domaines autorisés pour chaque type d’interaction :
| Champ | Rôle | Exemple | Erreurs courantes |
|---|---|---|---|
| connectDomains | Requêtes API et XHR | https://api.weather.com | Déclarer l’API de production et oublier celle de préproduction. |
| resourceDomains | Images, polices, scripts | https://cdn.jsdelivr.net | Utiliser un CDN générique comme delivr.net sans l’ajouter aux domaines autorisés. |
| frameDomains | Intégration d’iframes | https://www.youtube.com | Intégrer une vidéo YouTube ou une instance Mapbox sans autoriser le domaine correspondant. |
| redirectDomains | Liens externes qui s’ouvrent sans avertissement | https://app.alpic.ai | Oublier le domaine de paiement ou celui de l’URL de rappel OAuth. |
En faisant de la configuration des CSP une priorité dès le départ, nous avons économisé beaucoup de temps de débogage en production.
10. Quelques paramètres du widget ont des effets majeurs
Au-delà des CSP, quelques paramètres du widget déterminent la répartition du contrôle entre le widget, le modèle et l’environnement hôte. On les néglige facilement, alors qu’ils fixent des limites essentielles pour la navigation, l’accès aux outils et la publication.
Hôte et navigation
widgetDomainest obligatoire pour soumettre l’application. Il définit la destination par défaut du bouton « Ouvrir dans <App> » en mode plein écran et sert à déterminer les origines autorisées, puisque les widgets s’affichent sous<widgetDomain>.web-sandbox.oaiusercontent.com. Nous avons utilisésetOpenInAppUrlpour diriger les utilisateurs vers le chemin approprié selon le contexte.
Modèle et accès aux outils
- Les annotations des outils doivent respecter les consignes de publication. Des paramètres comme
readOnly,destructiveHintetopenWorldHintsont obligatoires et font l’objet d’une validation lors de la soumission. - La visibilité des outils a son importance : les outils que le modèle ne doit pas pouvoir appeler doivent être explicitement déclarés privés.
Droits d’exécution du widget
widgetAccessibledétermine si le widget peut appeler lui-même des outils viacallTool.
Pris séparément, ces paramètres semblent mineurs. Ensemble, ils déterminent si l’application fonctionnera correctement une fois publiée.
Raccourcir les cycles de développement
L’Apps SDK évolue rapidement et nous avons pris plaisir à développer des applications au fil de ses évolutions. Pour rendre le développement plus fluide et plus efficace, nous avons décidé de créer notre propre framework open source et de le partager avec la communauté. Voici ce que nous avons appris pour vous éviter certaines des difficultés que nous avons rencontrées au début.
11. Le rechargement à chaud permet d’itérer rapidement
L’une de nos premières priorités a été de raccourcir les cycles de développement. Les ressources restent longtemps en cache et sont transmises via JSON-RPC. Cette combinaison empêche le rechargement à chaud standard des modules, tel que le proposent Vite ou Next.js, de fonctionner tel quel dans les applications ChatGPT.
Après avoir étudié en détail le fonctionnement interne de Vite, nous avons créé un plugin Vite qui recharge les widgets en direct dans ChatGPT. Le plugin intercepte les requêtes de ressources adressées au serveur MCP et injecte les mises à jour en temps réel dans l’iframe de ChatGPT. Pouvoir constater immédiatement dans ChatGPT l’effet d’une modification apportée dans l’IDE a considérablement raccourci nos cycles de développement.
12. Certains tests gagnent à être exécutés hors de ChatGPT
Les tests dans ChatGPT restent la référence, mais un émulateur local permet d’avancer plus vite lors des premières itérations. C’est particulièrement vrai lorsque vous travaillez sur des définitions d’outils qui nécessitent d’actualiser la connexion au serveur MCP personnalisé dans ChatGPT.
Pour accélérer ces premières itérations, nous avons créé un émulateur local léger qui simule l’environnement hôte de ChatGPT, avec des outils de débogage et des journaux propres aux applications. Nous pouvions ainsi vérifier en quelques millisecondes les changements d’état et de mise en page dans React, et réserver les tests dans ChatGPT à la validation des interactions avec le modèle et des cas limites.
13. Les tests sur mobile nécessitent une prise en charge spécifique
Les tests sur mobile ont posé une autre difficulté. Pour tester dans ChatGPT, vous devez rendre votre serveur local accessible via un tunnel. Or, Vite utilise localhost par défaut, si bien que la même URL est inaccessible depuis d’autres appareils.
Nous avons étendu notre plugin Vite pour qu’il prenne en charge la redirection des domaines sur les ports exposés via le tunnel. Nous avons ainsi pu tester sur des appareils iOS et Android et intégrer la validation sur mobile à notre workflow habituel.
14. Des abstractions familières, comme les hooks React, accélèrent le développement frontend
L’Apps SDK offre des fonctionnalités puissantes, mais les expose surtout via des API JavaScript de bas niveau. Comme nous utilisons React depuis longtemps, nous voulions retrouver des concepts que nous maîtrisions déjà.
Nous avons donc introduit des abstractions adaptées à React : des hooks comme useCallTool, useWidgetState et useLocale, ainsi que des mécanismes de gestion d’état plus avancés comme createStore, qui s’appuie sur Zustand pour gérer les flux de données complexes. Retrouver ces pratiques familières du frontend a réduit le volume de code répétitif et rapproché le développement des widgets de nos workflows web habituels.
Intégrer ces leçons à un Skill Codex
15. Transformer les leçons en outils réutilisables
À mesure que nous retrouvions les mêmes schémas dans plusieurs applications, nous avons compris que les redécouvrir à chaque fois nous ralentissait. Pour rendre le développement d’applications ChatGPT plus rapide et plus prévisible, nous avons décidé d’intégrer ces leçons directement à nos outils, pour nous-mêmes comme pour la communauté.
Deux projets complémentaires en sont issus :
- Le framework Skybridge : ce framework React open source reprend de nombreuses pratiques décrites dans cet article sous forme de briques réutilisables. On y retrouve notamment nos hooks (
useCallTool,useToolInfo), les outils de développement (HMR et émulateur local) et l’attribut data-llm. - Le Skill Codex chatgpt-apps-builder : à partir du framework, nous avons créé un Skill Codex dédié à l’ensemble du cycle de vie de l’application :
- Recherche d’idées : explorer ce qui peut rendre une application « agentique », au-delà d’un simple portage de sa version web.
- Génération de code : écrire simultanément le frontend React et le backend du serveur MCP, tous deux préconfigurés avec les bonnes pratiques de conception d’interface et d’expérience utilisateur.
- Tests en local : démarrer les serveurs de développement et connecter les applications locales à ChatGPT pour itérer en temps réel grâce au rechargement à chaud.
- Assurance qualité et publication : vérifier méthodiquement que l’application respecte les consignes de soumission d’OpenAI, notamment en validant les CSP, en tenant compte des zones à laisser libres à l’écran et en effectuant des tests en production.
- Déploiement de l’application : accompagner les dernières étapes de la mise en production et les itérations suivantes.
Pour installer et utiliser le Skill, exécutez la commande suivante :
npx skills add alpic-ai/skybridgeConclusion
Développer des applications ChatGPT oblige à repenser la circulation du contexte, le comportement des interfaces et la collaboration entre les utilisateurs et les modèles. Beaucoup des leçons de cet article viennent du décalage entre nos habitudes de développement web et le fonctionnement réel des systèmes agentiques.
En partageant ces leçons et en les intégrant à notre framework open source et à notre Skill Codex, nous espérons que les équipes passeront moins de temps à redécouvrir les mêmes problèmes et davantage à explorer les possibilités de ce nouveau mode d’interaction. Les applications ChatGPT les plus convaincantes iront au-delà du simple portage de produits existants : elles seront conçues dès le départ pour cette nouvelle façon d’interagir avec l’IA.