

Há um ano, lançamos a API Responses para dar a desenvolvedores e empresas uma base para criar agentes úteis e confiáveis. Ao dar aos modelos acesso a ferramentas hospedadas, abrimos caminho para que a IA evoluísse dos assistentes de chat para sistemas capazes de agir em seu nome. Hoje, a API Responses oferece várias ferramentas para executar fluxos de trabalho com agentes de IA, além de novos recursos e primitivas projetados especificamente para desenvolver aplicações com modelos mais capazes.
Milhares de desenvolvedores já usam a API Responses para aumentar a produtividade em áreas como atendimento ao cliente, direito, ciências da vida e turismo, entre outras. Já compartilhamos muitas histórias de sucesso desses setores. Hoje, celebramos cinco histórias menos conhecidas de desenvolvedores que criaram produtos com a API Responses ao longo do último ano.
Como detectar e corrigir falhas em agentes de IA
Por Alexis Gauba e Ben Hylak, da Raindrop AI
Ferramentas: Ferramentas desenvolvidas sob medida
Modelos: GPT-5.2 (GPT-5.4 em teste)
Algumas das empresas de IA mais ambiciosas do mundo usam a plataforma de monitoramento Raindrop para detectar quando seus agentes se comportam de forma inesperada em produção. À medida que os agentes se tornaram mais complexos, essas falhas passaram a ter consequências mais graves.
Sem a API Responses, teria sido muito mais difícil criar esse tipo de sistema de monitoramento, e o resultado teria sido bem menos confiável.
O sistema executa análises em segundo plano com a API Responses por meio do Vercel AI SDK. Assim, a equipe pode compartilhar ferramentas entre diferentes provedores de modelos e executar o sistema em diferentes ambientes. Esses fluxos de trabalho identificam comportamentos incomuns. Quando algo dá errado, o sistema alerta os desenvolvedores e ajuda a diagnosticar a causa do problema.
A plataforma se concentra em três sistemas principais:
- Monitoramento do comportamento dos agentes
- Detecção de falhas e emissão de alertas
- Ferramentas de investigação e depuração para desenvolvedores
Juntos, esses sistemas permitem que as equipes descubram, acompanhem e corrijam problemas em agentes de IA antes que afetem os sistemas em produção.
Arquitetura de monitoramento
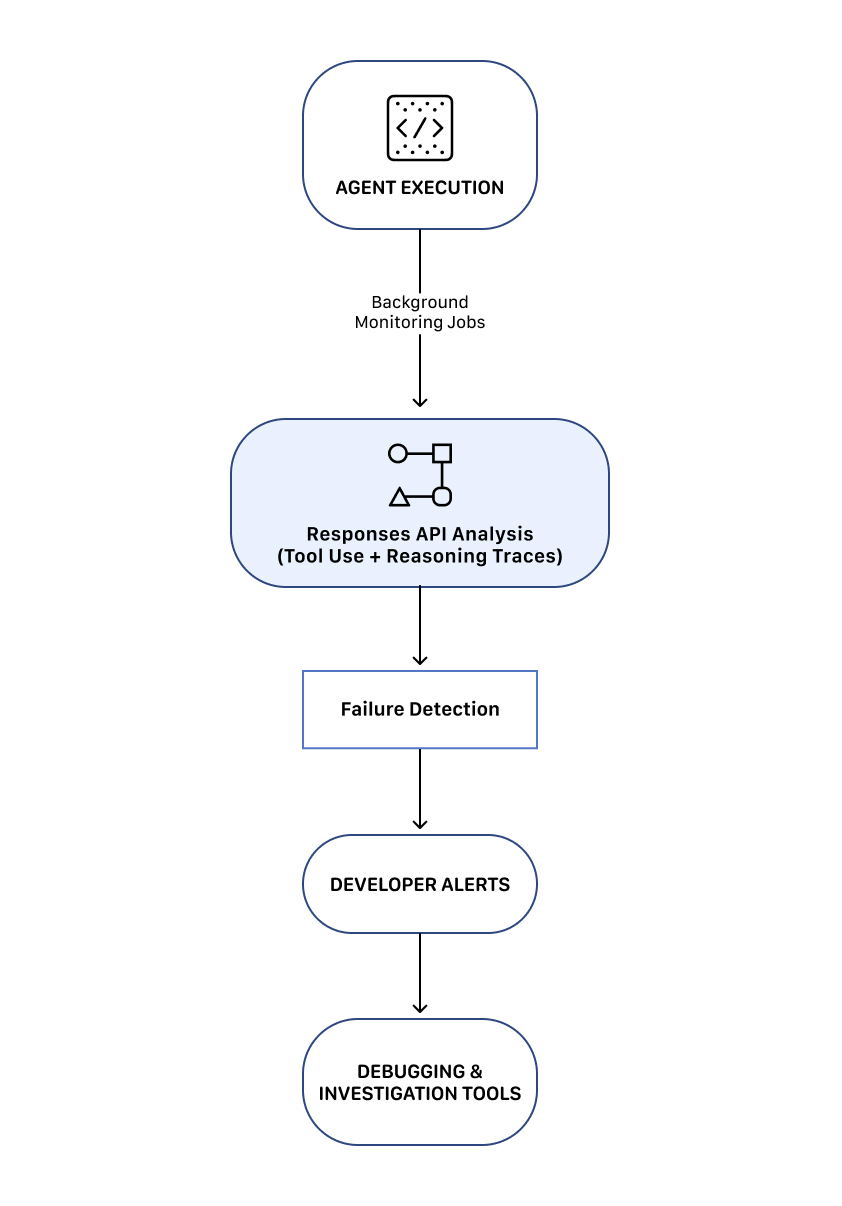
Com essa arquitetura, as equipes podem monitorar continuamente o comportamento dos agentes e responder rapidamente quando surgem problemas.
1. Monitoramento do comportamento dos agentes
O sistema avalia continuamente o comportamento de cada agente para verificar se ele funciona conforme o esperado.
Os desenvolvedores podem definir condições que caracterizam resultados indesejados, e a plataforma pode emitir um alerta quando essas condições são atendidas.
2. Detecção de falhas e emissão de alertas
Quando detecta anomalias, a Raindrop notifica os desenvolvedores e apresenta as informações de que eles precisam para investigar o problema.
A plataforma oferece ferramentas para:
- Acompanhar mudanças de comportamento entre versões do agente
- Identificar quais alterações nos prompts ou no sistema causaram falhas
- Examinar registros de raciocínio e chamadas de ferramentas
Assim, os desenvolvedores podem identificar rapidamente a causa raiz das falhas e implantar correções.
3. Ferramentas de investigação e depuração
A Raindrop também oferece ferramentas que ajudam os desenvolvedores a diagnosticar problemas nos fluxos de trabalho dos agentes. Com esses recursos, as equipes podem usar o que descobriram sobre as falhas para melhorar o sistema.
A Raindrop AI usa a API Responses para executar todos os seus fluxos de análise de longa duração em segundo plano. Sem a API, implementar esses sistemas de monitoramento seria muito mais difícil.
Fluxos de raciocínio aprofundado para dados complexos
Por Eric Provencher, do Repo Prompt
Ferramentas utilizadas: Codex com App Server + MCP, pesquisa na Web
Modelo utilizado: GPT-5.3-Codex
Durante o planejamento ou as revisões, usamos um agente separado para selecionar e organizar o contexto com antecedência. Assim, o modelo de raciocínio não desperdiça sua janela de contexto procurando informações e pode dedicar o máximo possível da sua capacidade de raciocínio à resolução da tarefa.
Eric Provencher criou um sistema que ajuda desenvolvedores e pesquisadores a fazer análises aprofundadas de grandes acervos de documentos, bases de código e conjuntos de dados.
O Repo Prompt se concentra na engenharia de contexto: reúne, organiza e estrutura automaticamente as informações relevantes para que um modelo de raciocínio possa analisá-las de forma eficaz.
Enquanto muitos sistemas de agentes se concentram na coleta de dados, a arquitetura de Eric separa a coleta de contexto do raciocínio aprofundado. O sistema usa fluxos de trabalho com agentes para reunir as informações relevantes e, em seguida, repassa essa seleção a um modelo de raciocínio dedicado exclusivamente à análise.
A plataforma usa a API Responses da OpenAI para orquestrar fluxos de trabalho com agentes e tarefas de raciocínio de longa duração em atividades como:
- Análise de grandes bases de código e planejamento de arquitetura
- Fluxos de revisão aprofundada de código
- Análise de grandes acervos de documentos para pesquisa
- Análise de documentos médicos e científicos
O sistema tem três componentes principais: fluxos de trabalho com agentes que preparam o contexto, modelos de raciocínio aprofundado (fluxo “Oracle”) e ciclos iterativos de pesquisa e análise.
1. Fluxo de trabalho do agente que prepara o contexto
A primeira etapa fica a cargo de um agente que prepara o contexto. Nesse fluxo, o agente analisa grandes repositórios de dados para determinar quais informações são relevantes para uma consulta específica.
Com as ferramentas e os recursos de raciocínio do modelo disponíveis pela API Responses, o agente identifica arquivos relevantes, relações entre documentos e trechos importantes.
O resultado dessa etapa é um pacote de contexto estruturado que serve de entrada para a etapa de raciocínio.
2. Fluxo de raciocínio aprofundado “Oracle”
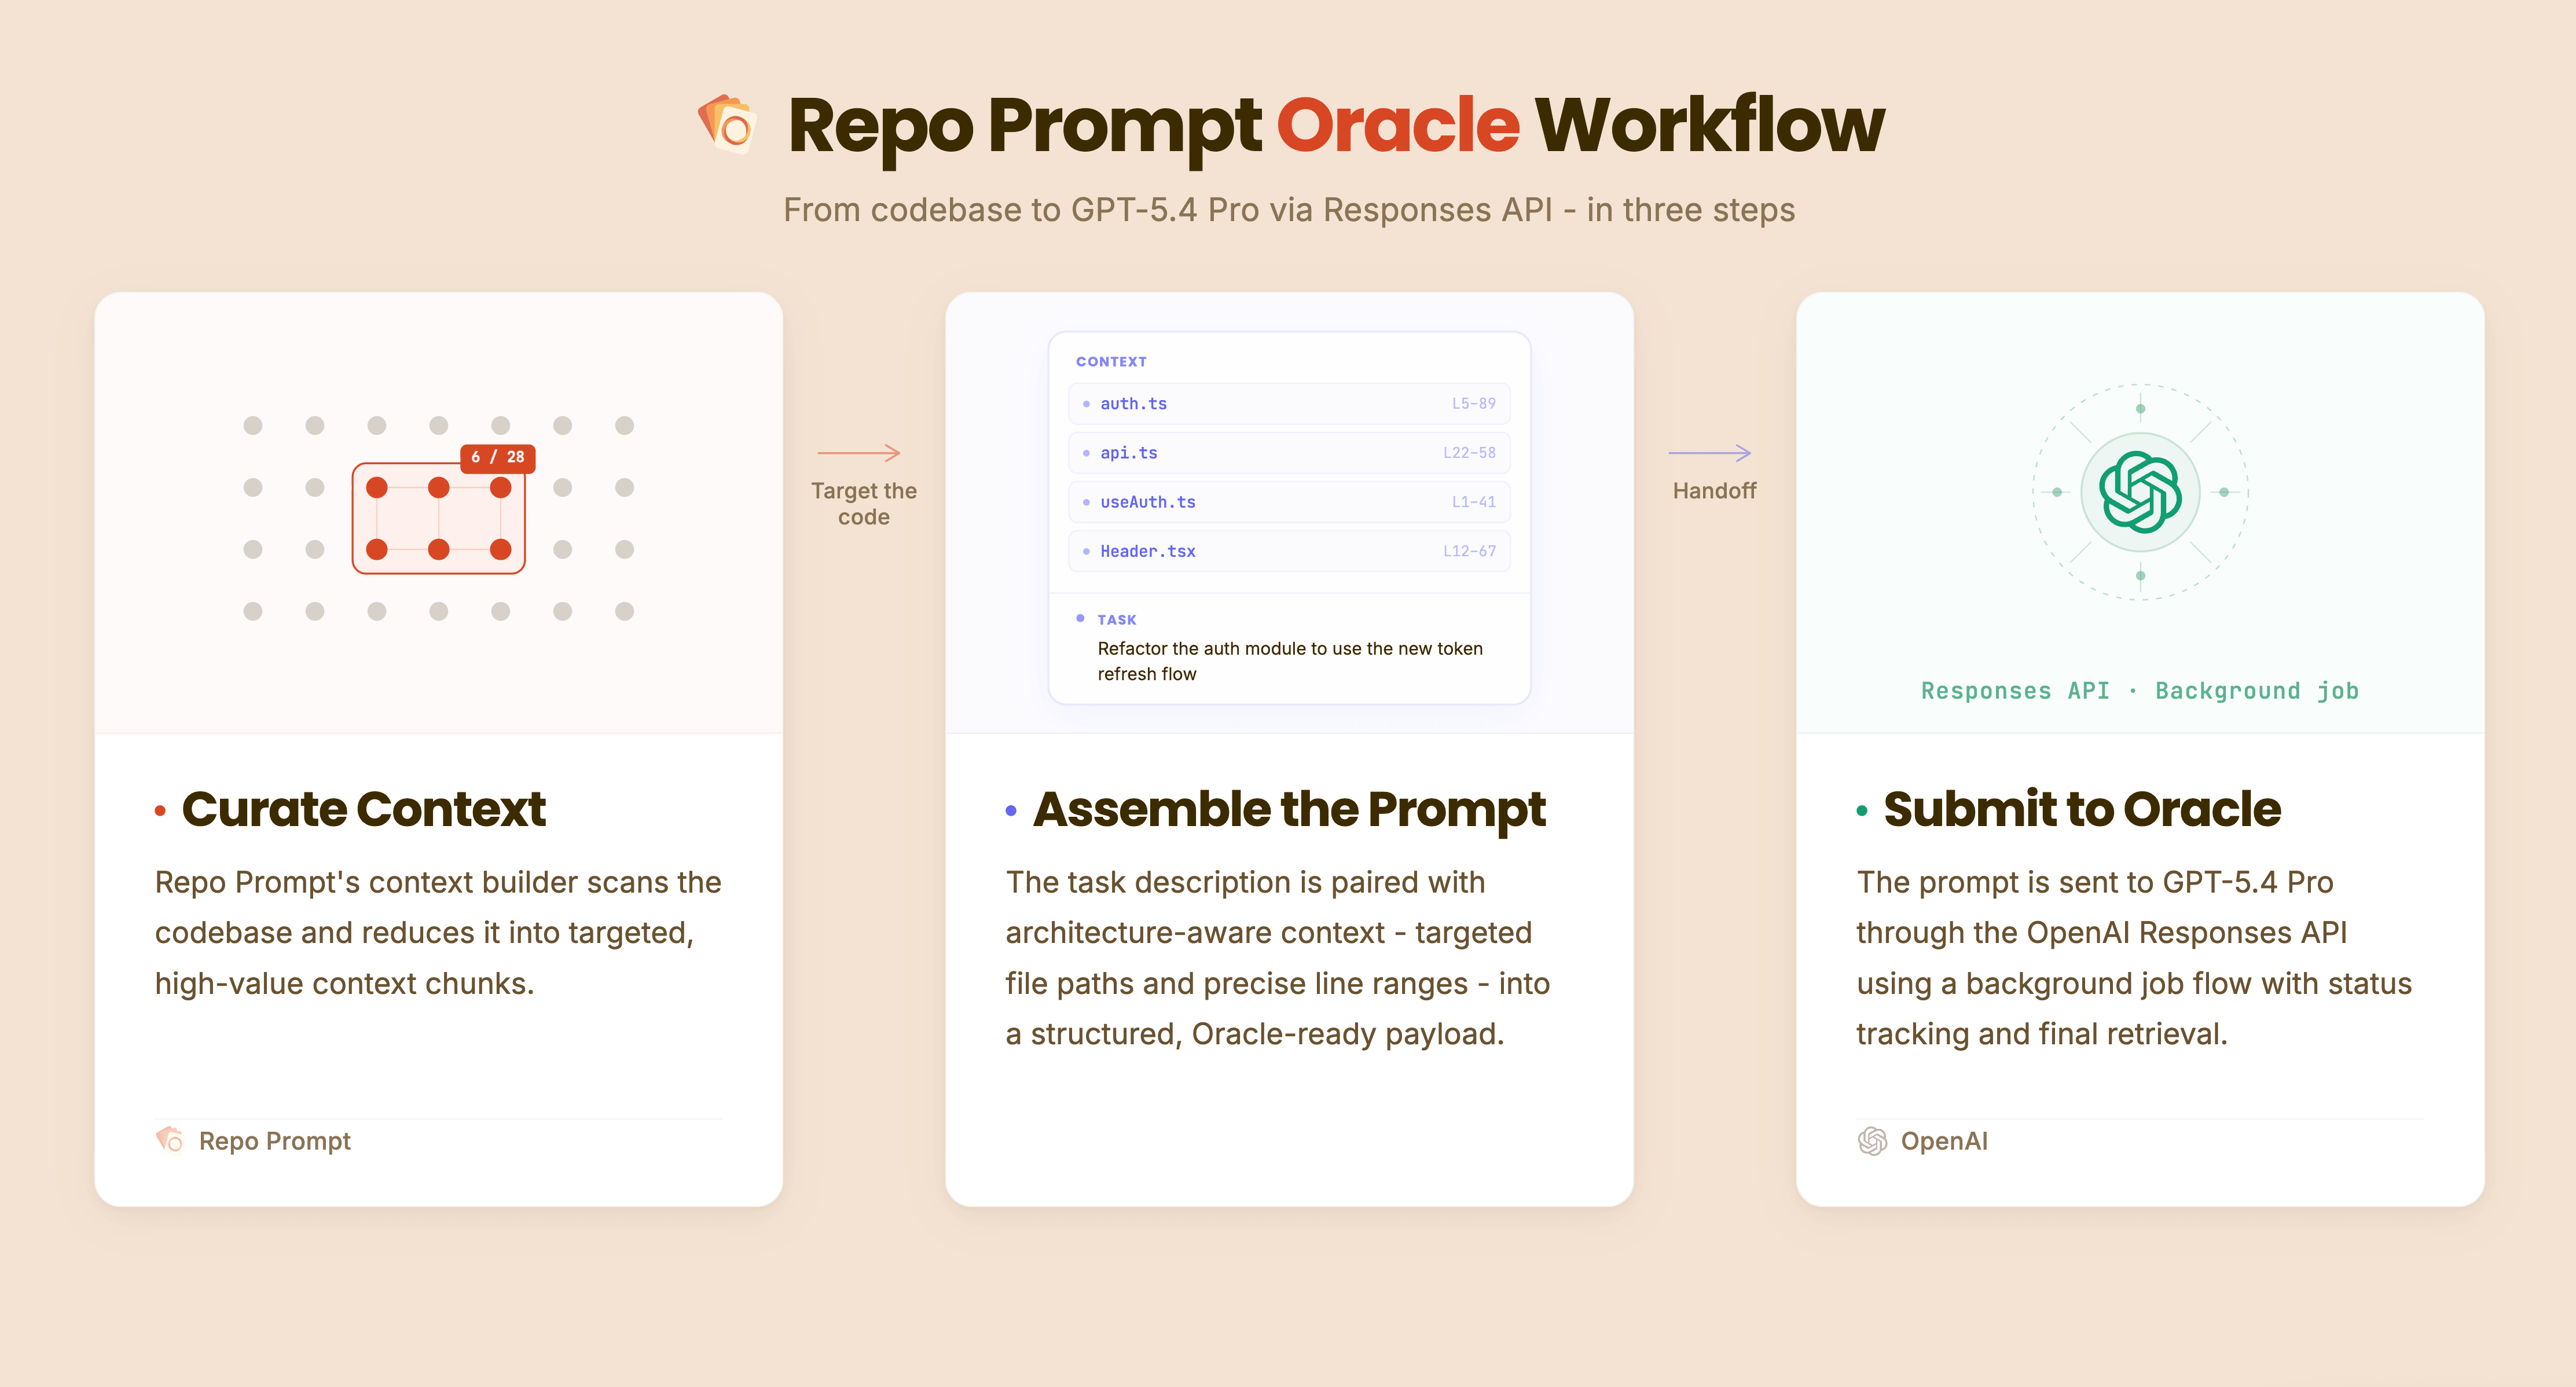
Ao contrário dos agentes que preparam o contexto, o “Oracle”, modelo de raciocínio aprofundado, não chama ferramentas nem busca informações adicionais. Ele se dedica inteiramente à análise do contexto que recebeu.
Separar a pesquisa do raciocínio permite que o modelo dedique toda a sua capacidade de raciocínio à compreensão do problema. Em muitos fluxos de trabalho, a etapa de raciocínio pode se estender por longos períodos enquanto o modelo analisa relações complexas entre as informações fornecidas.
3. Ciclos iterativos de pesquisa e análise
O sistema também permite repetir o ciclo de raciocínio. Depois que o modelo de raciocínio gera uma saída, outro agente pode revisar os resultados e determinar se é necessário aprofundar a investigação.
Se necessário, o sistema inicia outro ciclo de coleta de contexto e raciocínio. Isso permite conduzir investigações de longa duração em que o sistema refina a análise a cada ciclo.
Fluxo de trabalho iterativo

O sistema usa vários recursos da API Responses:
- Tarefas em segundo plano: permitem executar tarefas de raciocínio que podem durar minutos ou horas
- Orquestração de agentes: coordena os ciclos em que os agentes coletam contexto, raciocinam e validam os resultados
- Observabilidade: permite monitorar e gerenciar fluxos de raciocínio de longa duração durante a execução
A plataforma usa modelos Codex para reunir e estruturar o contexto relevante. Em seguida, repassa essa seleção a modelos de raciocínio mais capazes para uma análise aprofundada. Esses recursos viabilizam a arquitetura híbrida da plataforma, que combina fluxos de trabalho com agentes e modelos de raciocínio aprofundado.
Uma interface de conversa para colecionadores de discos de vinil
Por Ash Ryan Arnwine, do Collxn
Ferramentas: Pesquisa na Web e 16 ferramentas personalizadas
Modelos: GPT-5.4, GPT-5 nano
Senti que a API Responses me poupava trabalho em comparação com alternativas como montar um sistema completo de geração aumentada por recuperação.
Ash Ryan Arnwine criou o “Collxn” (o nome remete a “collection”, coleção em inglês), um pequeno serviço com uma grande missão: ajudar colecionadores de vinil a redescobrir o que já têm nas prateleiras e a interagir com seus discos.
Muitos colecionadores catalogam grandes acervos no Discogs, às vezes com milhares de discos. O Collxn se conecta à coleção e envia um e-mail diário chamado “Daily Drop”. Cada edição destaca um disco diferente e traz detalhes sobre o artista, convidando o colecionador a ouvir de novo a música que já tem em casa.
E, como é mais divertido percorrer uma coleção de discos quando dá para fazer perguntas, o Collxn usa a API Responses da OpenAI para oferecer uma interface de chat em que os usuários podem literalmente conversar com seus discos.
Interface de conversa com chamadas de ferramentas
O aplicativo usa a API Responses para oferecer uma interface de chat chamada “Ask This Drop”, na qual os usuários podem fazer perguntas sobre os discos apresentados no Daily Drop.
O modelo tem acesso a ferramentas da API do Discogs para buscar informações diretamente no Discogs ao responder a uma pergunta.
Por exemplo, os usuários podem perguntar:
- Qual é o preço de mercado deste disco hoje?
- Que outros álbuns esse artista lançou?
- Quão rara é essa prensagem?
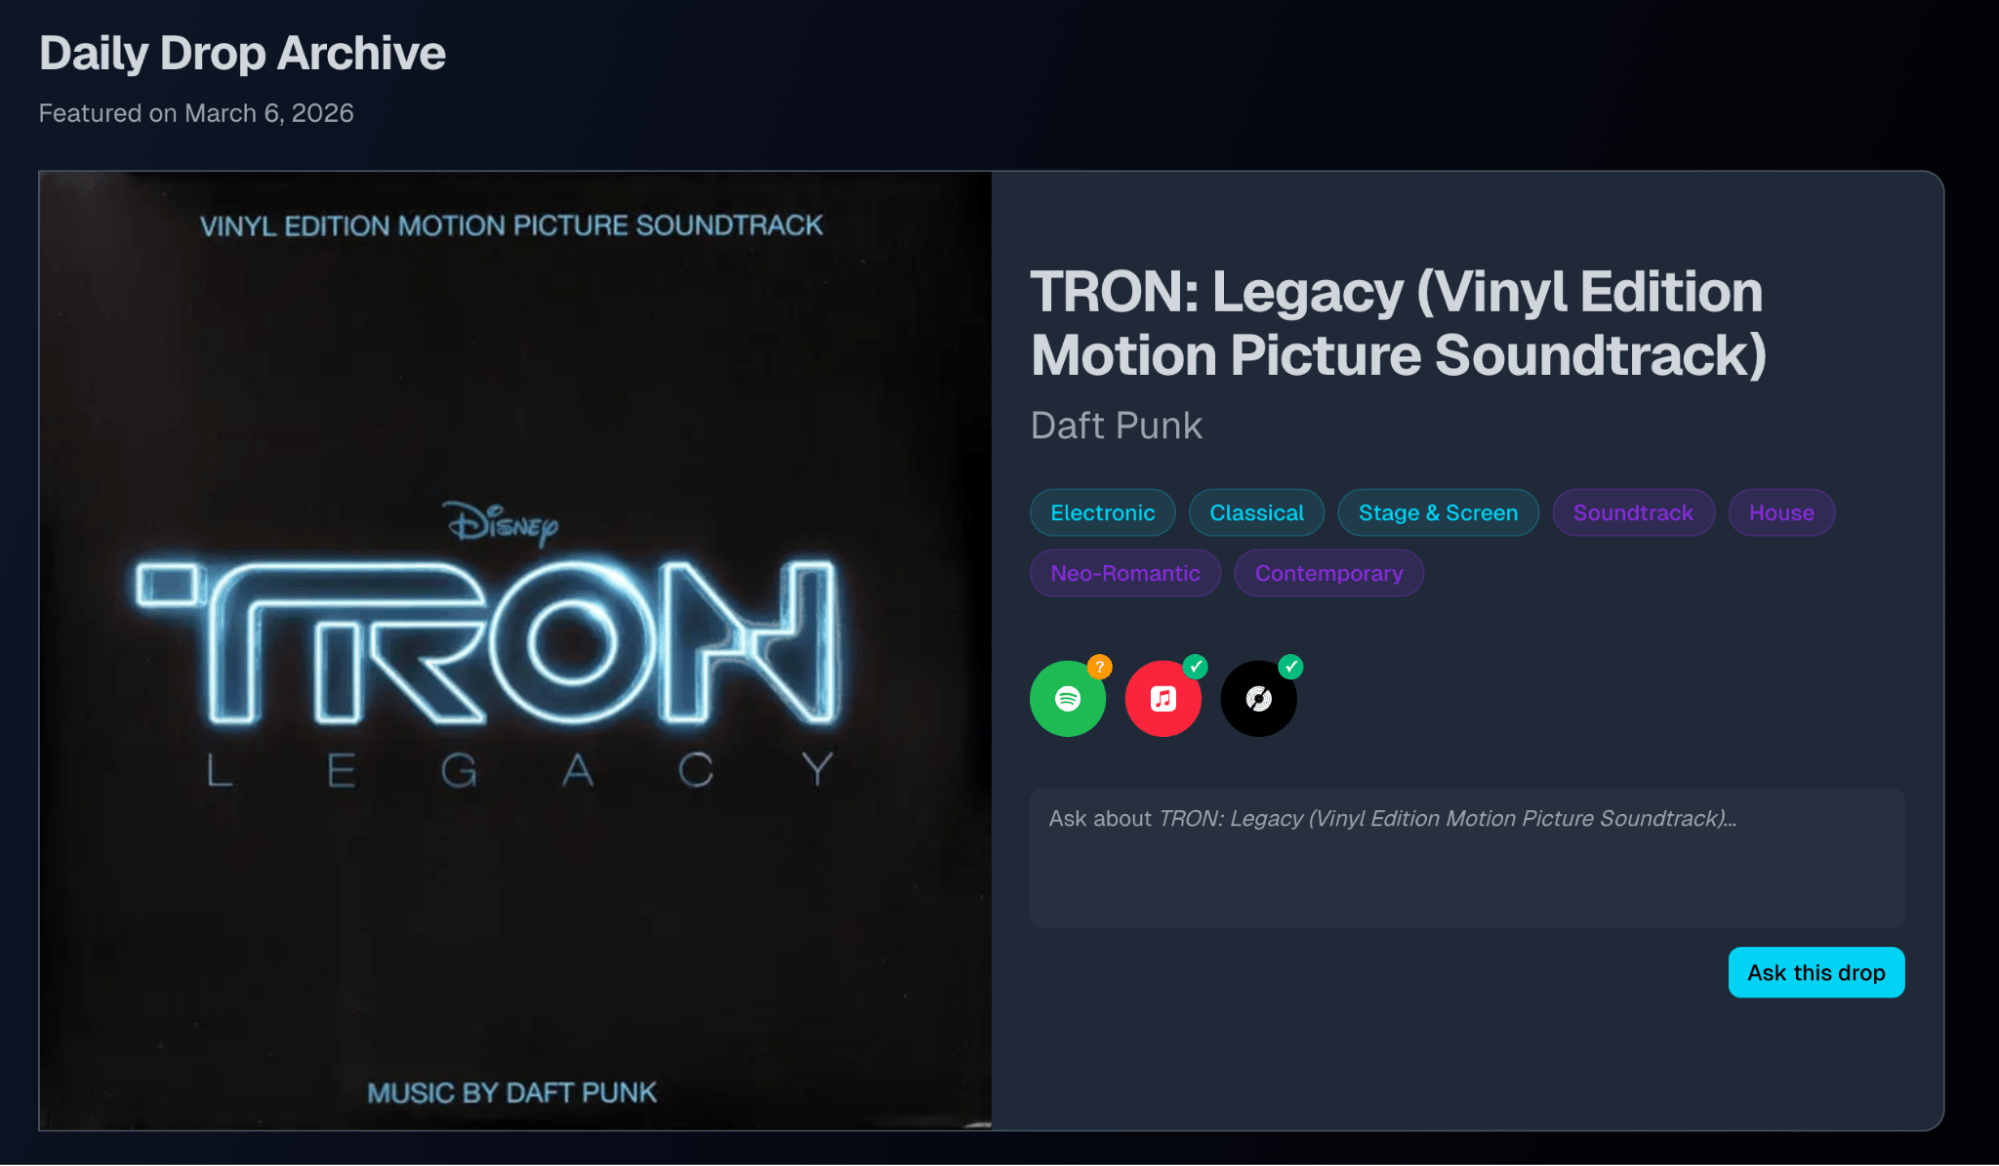
Com o Ask This Drop, os usuários do Collxn podem conversar com seus discos de vinil pelo chat.
Basta fazer uma pergunta para receber uma resposta gerada a partir de dados do Discogs em tempo real e de informações da própria coleção de discos.
Assim, o colecionador pode conversar com um acervo que antes era estático e explorar suas conexões com o universo da música.
Daily Drop e notícias sobre os artistas
O Collxn também usa o OpenAI Agents SDK para gerar uma seção de “notícias recentes” sobre o artista em destaque no e-mail Daily Drop.
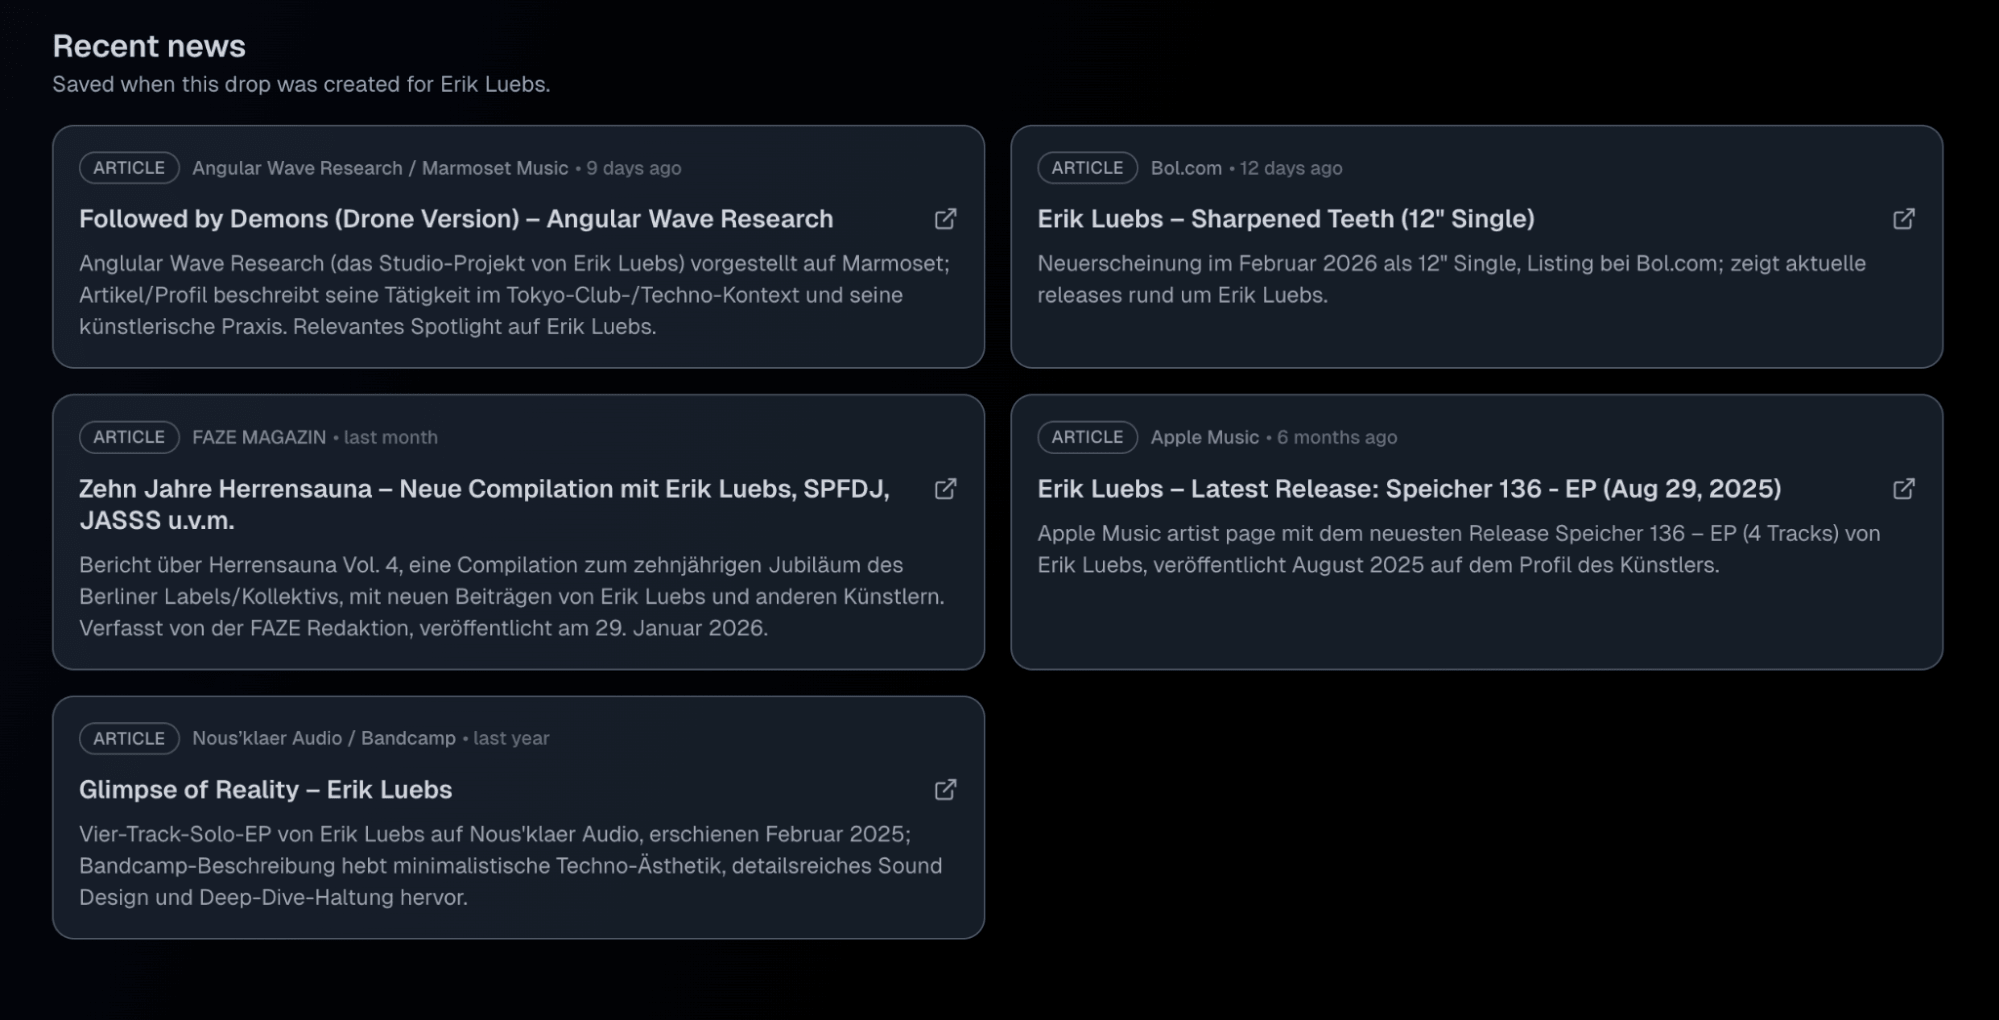
O Collxn usa o OpenAI Agents SDK para gerar a seção de notícias sobre o artista no Daily Drop.
Esse recurso usa um agente com pesquisa na Web para encontrar artigos recentes ou novidades sobre o artista e incluir essas informações no e-mail diário. Entre os usuários da versão beta, a seção de notícias logo se tornou uma das partes mais populares do produto, pois aproxima quem coleciona discos do que acontece hoje no mundo da música.
Ash acabou migrando o Collxn para a API Responses para lançar o “Ask This Drop”. Com a mudança, o aplicativo passou a oferecer raciocínio em várias etapas durante as conversas, além de chamadas a ferramentas integradas e personalizadas. O Collxn usa a ferramenta integrada de pesquisa na Web da API Responses para buscar notícias sobre artistas diretamente no chat. Também usa 16 ferramentas personalizadas para trabalhar com a API do Discogs, consultar a conta do usuário no Collxn e executar outras tarefas.
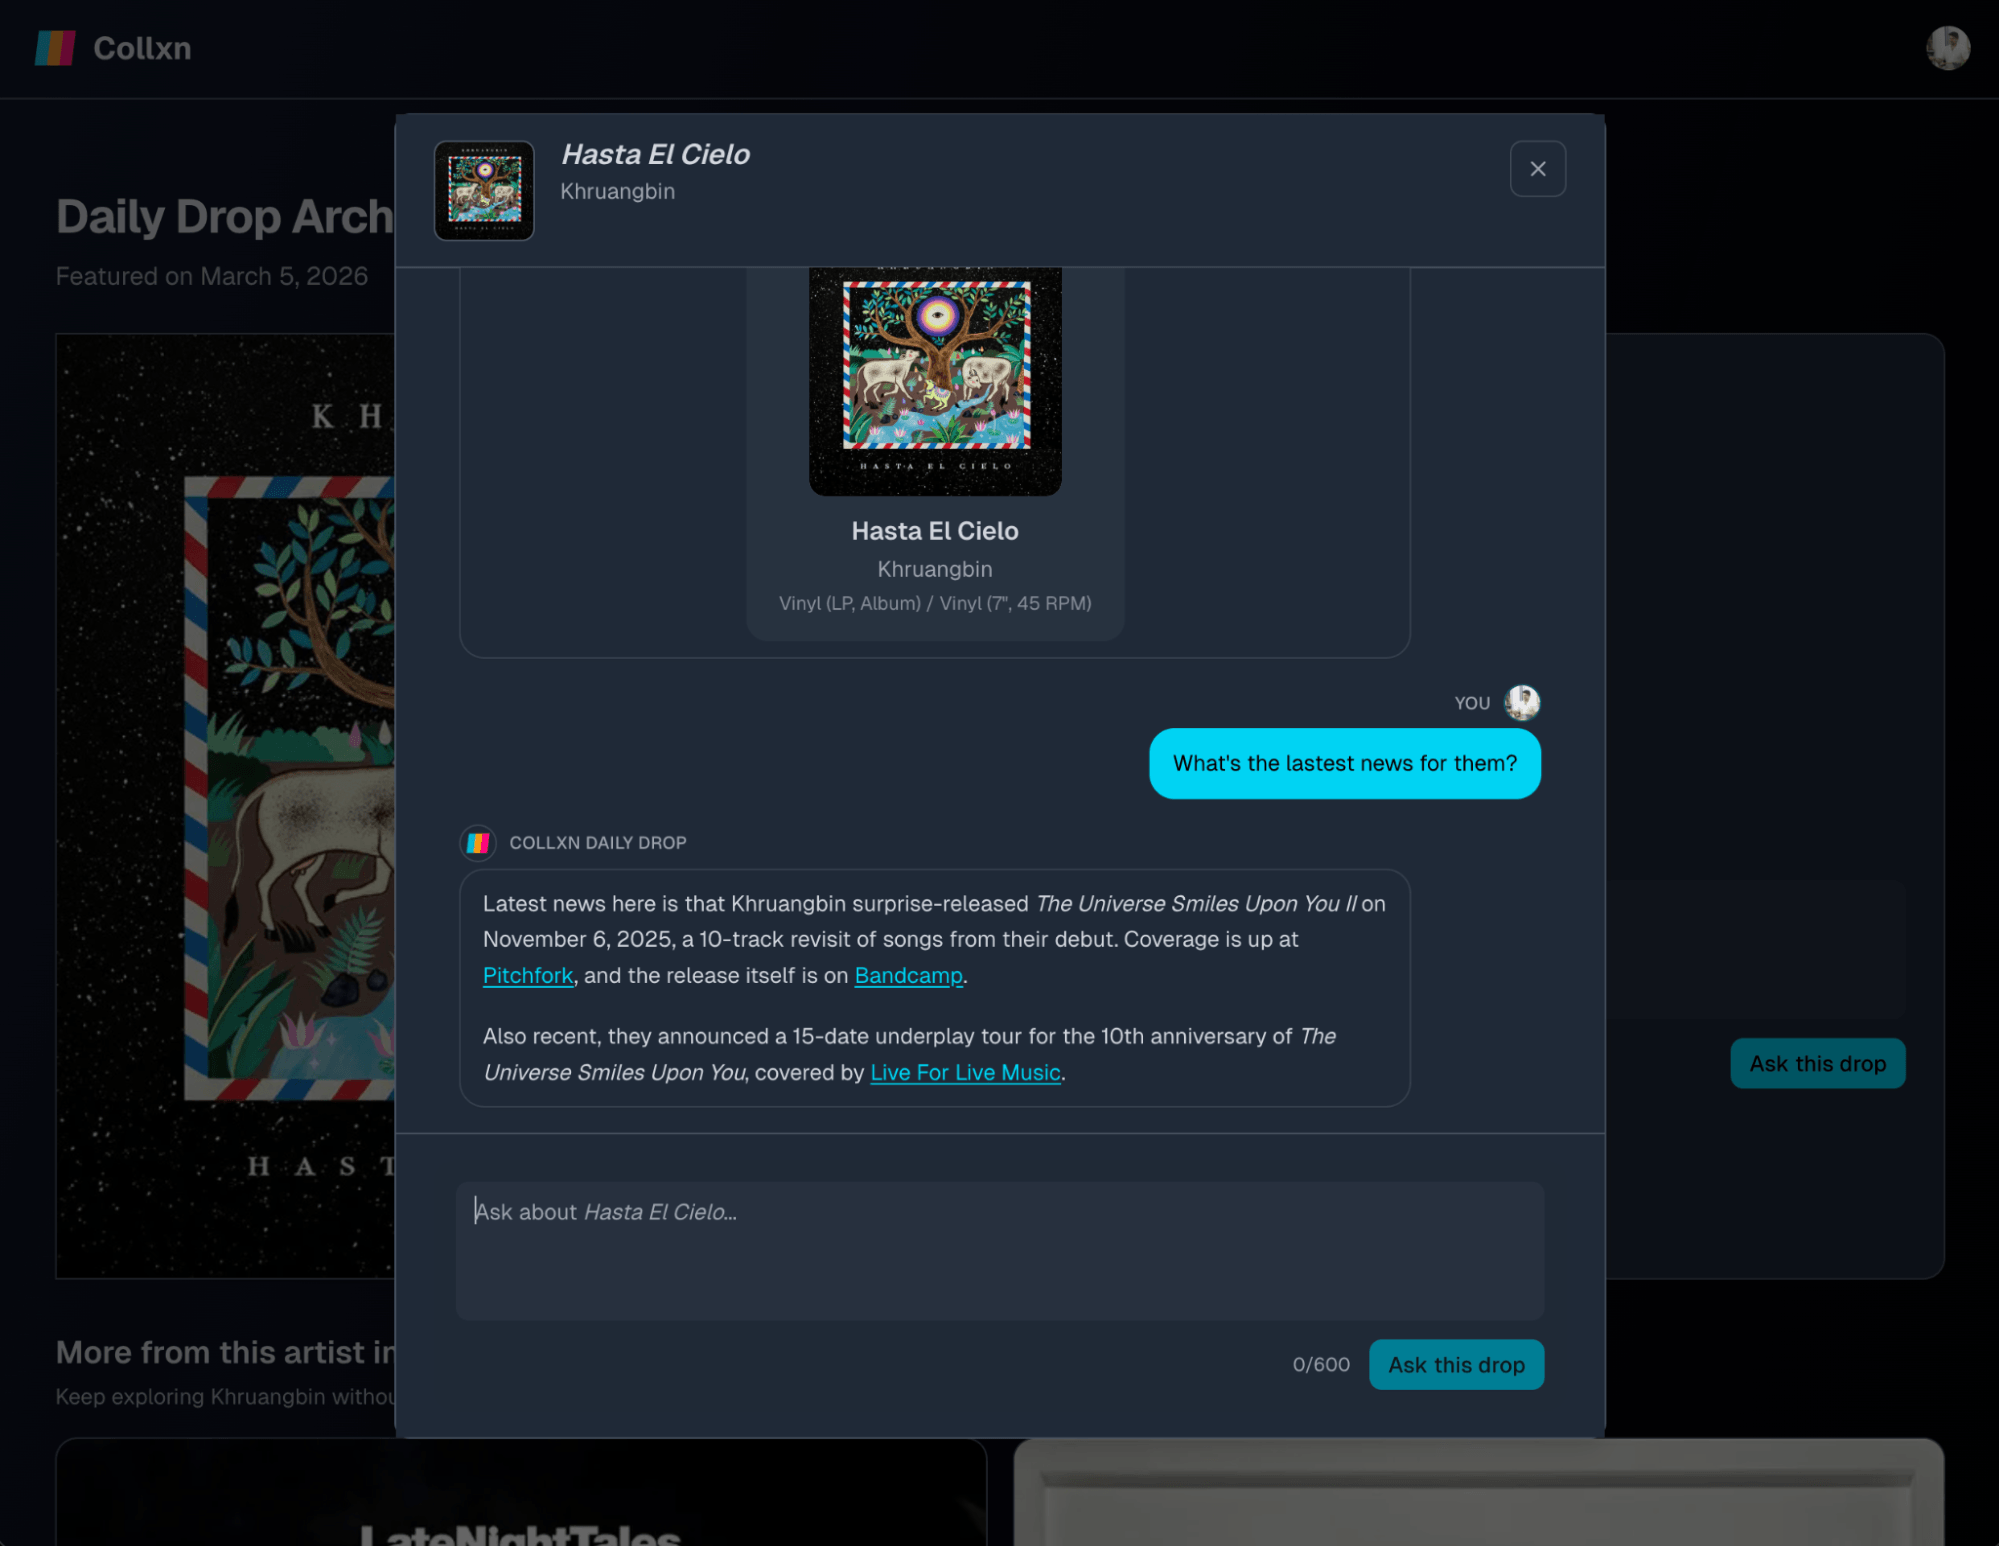
A ferramenta de pesquisa na Web da API Responses permite buscar notícias sobre artistas em tempo real no “Ask This Drop” do Collxn.
A API Responses também mantém o estado das conversas, o que torna mais simples e rápido lidar com interações de chat que envolvem várias trocas de mensagens. Ash observou que, de modo geral, usar a API Responses simplificou a arquitetura em comparação com a alternativa de criar um sistema completo de geração aumentada por recuperação (RAG).
Como transformar gravações de tela em demonstrações interativas de produtos
Por Nick Sorrentino e Pawel Wszola, da equipe do Arcade
Ferramentas: Uso do computador
Modelos: GPT-5.2, computer-use-preview
Ao integrar a geração de conteúdo via API, reduzimos pela metade o número de etapas necessárias para publicar uma demonstração. Com isso, a taxa de publicação e a adoção do produto aumentaram significativamente.
O Arcade transforma algo que a maioria das equipes já faz, uma gravação de tela, em uma demonstração interativa de produto pronta para o público. Em vez de apresentar o produto ao vivo ou escrever um passo a passo, a equipe grava o fluxo de trabalho uma única vez, e o Arcade cuida do resto.
Nos bastidores, a plataforma analisa a gravação e gera automaticamente um tutorial guiado que explica o que acontece em cada etapa.
Como a demonstração é gerada
Durante uma sessão de gravação:
- O usuário grava a tela enquanto executa um fluxo de trabalho.
- No computador ou no navegador, o Arcade captura diretamente interações como cliques, digitação e rolagem em formato estruturado.
- Em dispositivos móveis, o ambiente isolado do iOS impede que os aplicativos capturem interações em todo o sistema. Nesse caso, o usuário faz uma gravação de tela comum do aplicativo.
- A gravação é enviada à API Responses da OpenAI com a ferramenta de uso do computador, que analisa os quadros do vídeo e infere quais interações ocorreram.
- O sistema converte as ações inferidas em etapas estruturadas.
- O Arcade gera o texto da narração e os pontos interativos que orientam o público ao longo da demonstração.
Essas etapas compõem automaticamente o tutorial interativo que o usuário vê.
Em seguida, o sistema envia as ações estruturadas à API chat completions, que gera os títulos e as descrições dos pontos interativos que aparecem ao longo da demonstração. Os usuários podem ajustar o texto gerado com as ferramentas integradas de edição com IA, por exemplo, para encurtar ou reescrever um trecho.
Metade das ações para criar uma demonstração
Automatizar a narração reduziu consideravelmente o esforço necessário para publicar um tutorial de produto.
Depois que o Arcade integrou o fluxo de trabalho via API:
- O número mediano de ações necessárias antes da publicação caiu 50%
- No percentil 80, o número de ações caiu de cerca de 230 para cerca de 120
- As taxas de publicação e a adoção do produto aumentaram
Ao simplificar a criação das demonstrações, o Arcade permitiu que as equipes transformassem gravações brutas em demonstrações interativas prontas para o público com muito mais rapidez.
Como medir e melhorar a visibilidade das marcas nas respostas da IA
Por Tunde Adeyinka e Ramon Silva, da Hexagon
Ferramentas utilizadas: Pesquisa na Web
Modelo utilizado: GPT-5.2 Chat
Tunde Adeyinka e Ramon Silva fundaram a Hexagon para responder a uma nova pergunta dos varejistas: como os assistentes de IA falam dos seus produtos?
Os assistentes de IA influenciam cada vez mais a maneira como as pessoas descobrem produtos. A Hexagon ajuda as empresas a acompanhar como suas marcas aparecem nas respostas geradas por IA e a melhorar esses resultados ao longo do tempo.
A plataforma usa a API Responses da OpenAI em três sistemas principais:
1. Arquitetura de simulação de respostas
A Hexagon executa um pipeline diário de simulação para medir como os assistentes de IA respondem a perguntas sobre produtos. Todos os dias, o sistema gera milhares de prompts realistas, entre eles perguntas que consumidores fariam, pedidos de recomendação de produtos e consultas de compras, e os envia à API Responses. O sistema analisa as respostas para acompanhar a visibilidade das marcas no conteúdo gerado por IA.
Com isso, os varejistas que usam a plataforma podem ver com que frequência seus produtos aparecem e como as respostas mudam ao longo do tempo.
2. Pipeline de geração de conteúdo com vários agentes
Além de analisar os dados, a Hexagon usa a API Responses para gerar conteúdo otimizado que melhora a visibilidade das marcas nas respostas da IA.
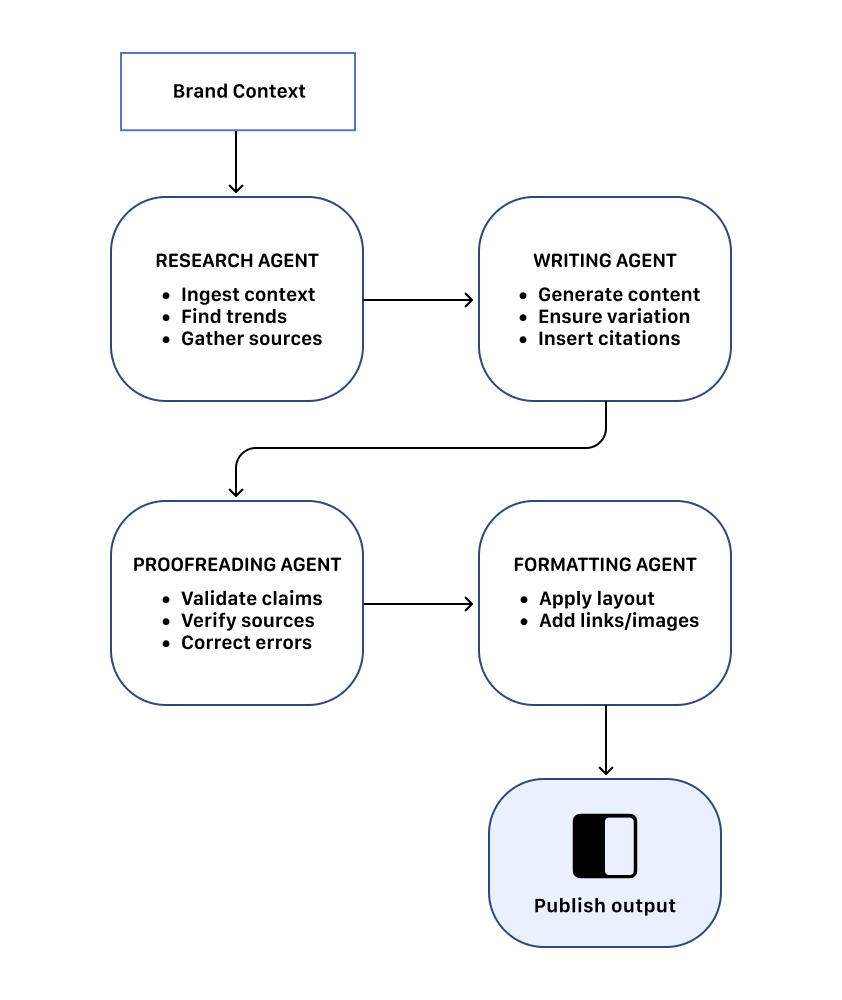
O sistema usa uma arquitetura com quatro agentes. Cada agente executa uma etapa especializada do pipeline e repassa seus resultados à etapa seguinte até que o conteúdo final seja produzido e publicado. Antes da publicação, os agentes se comunicam em ciclos não determinísticos para refinar o conteúdo a cada iteração.
3. Painel e ferramentas para clientes
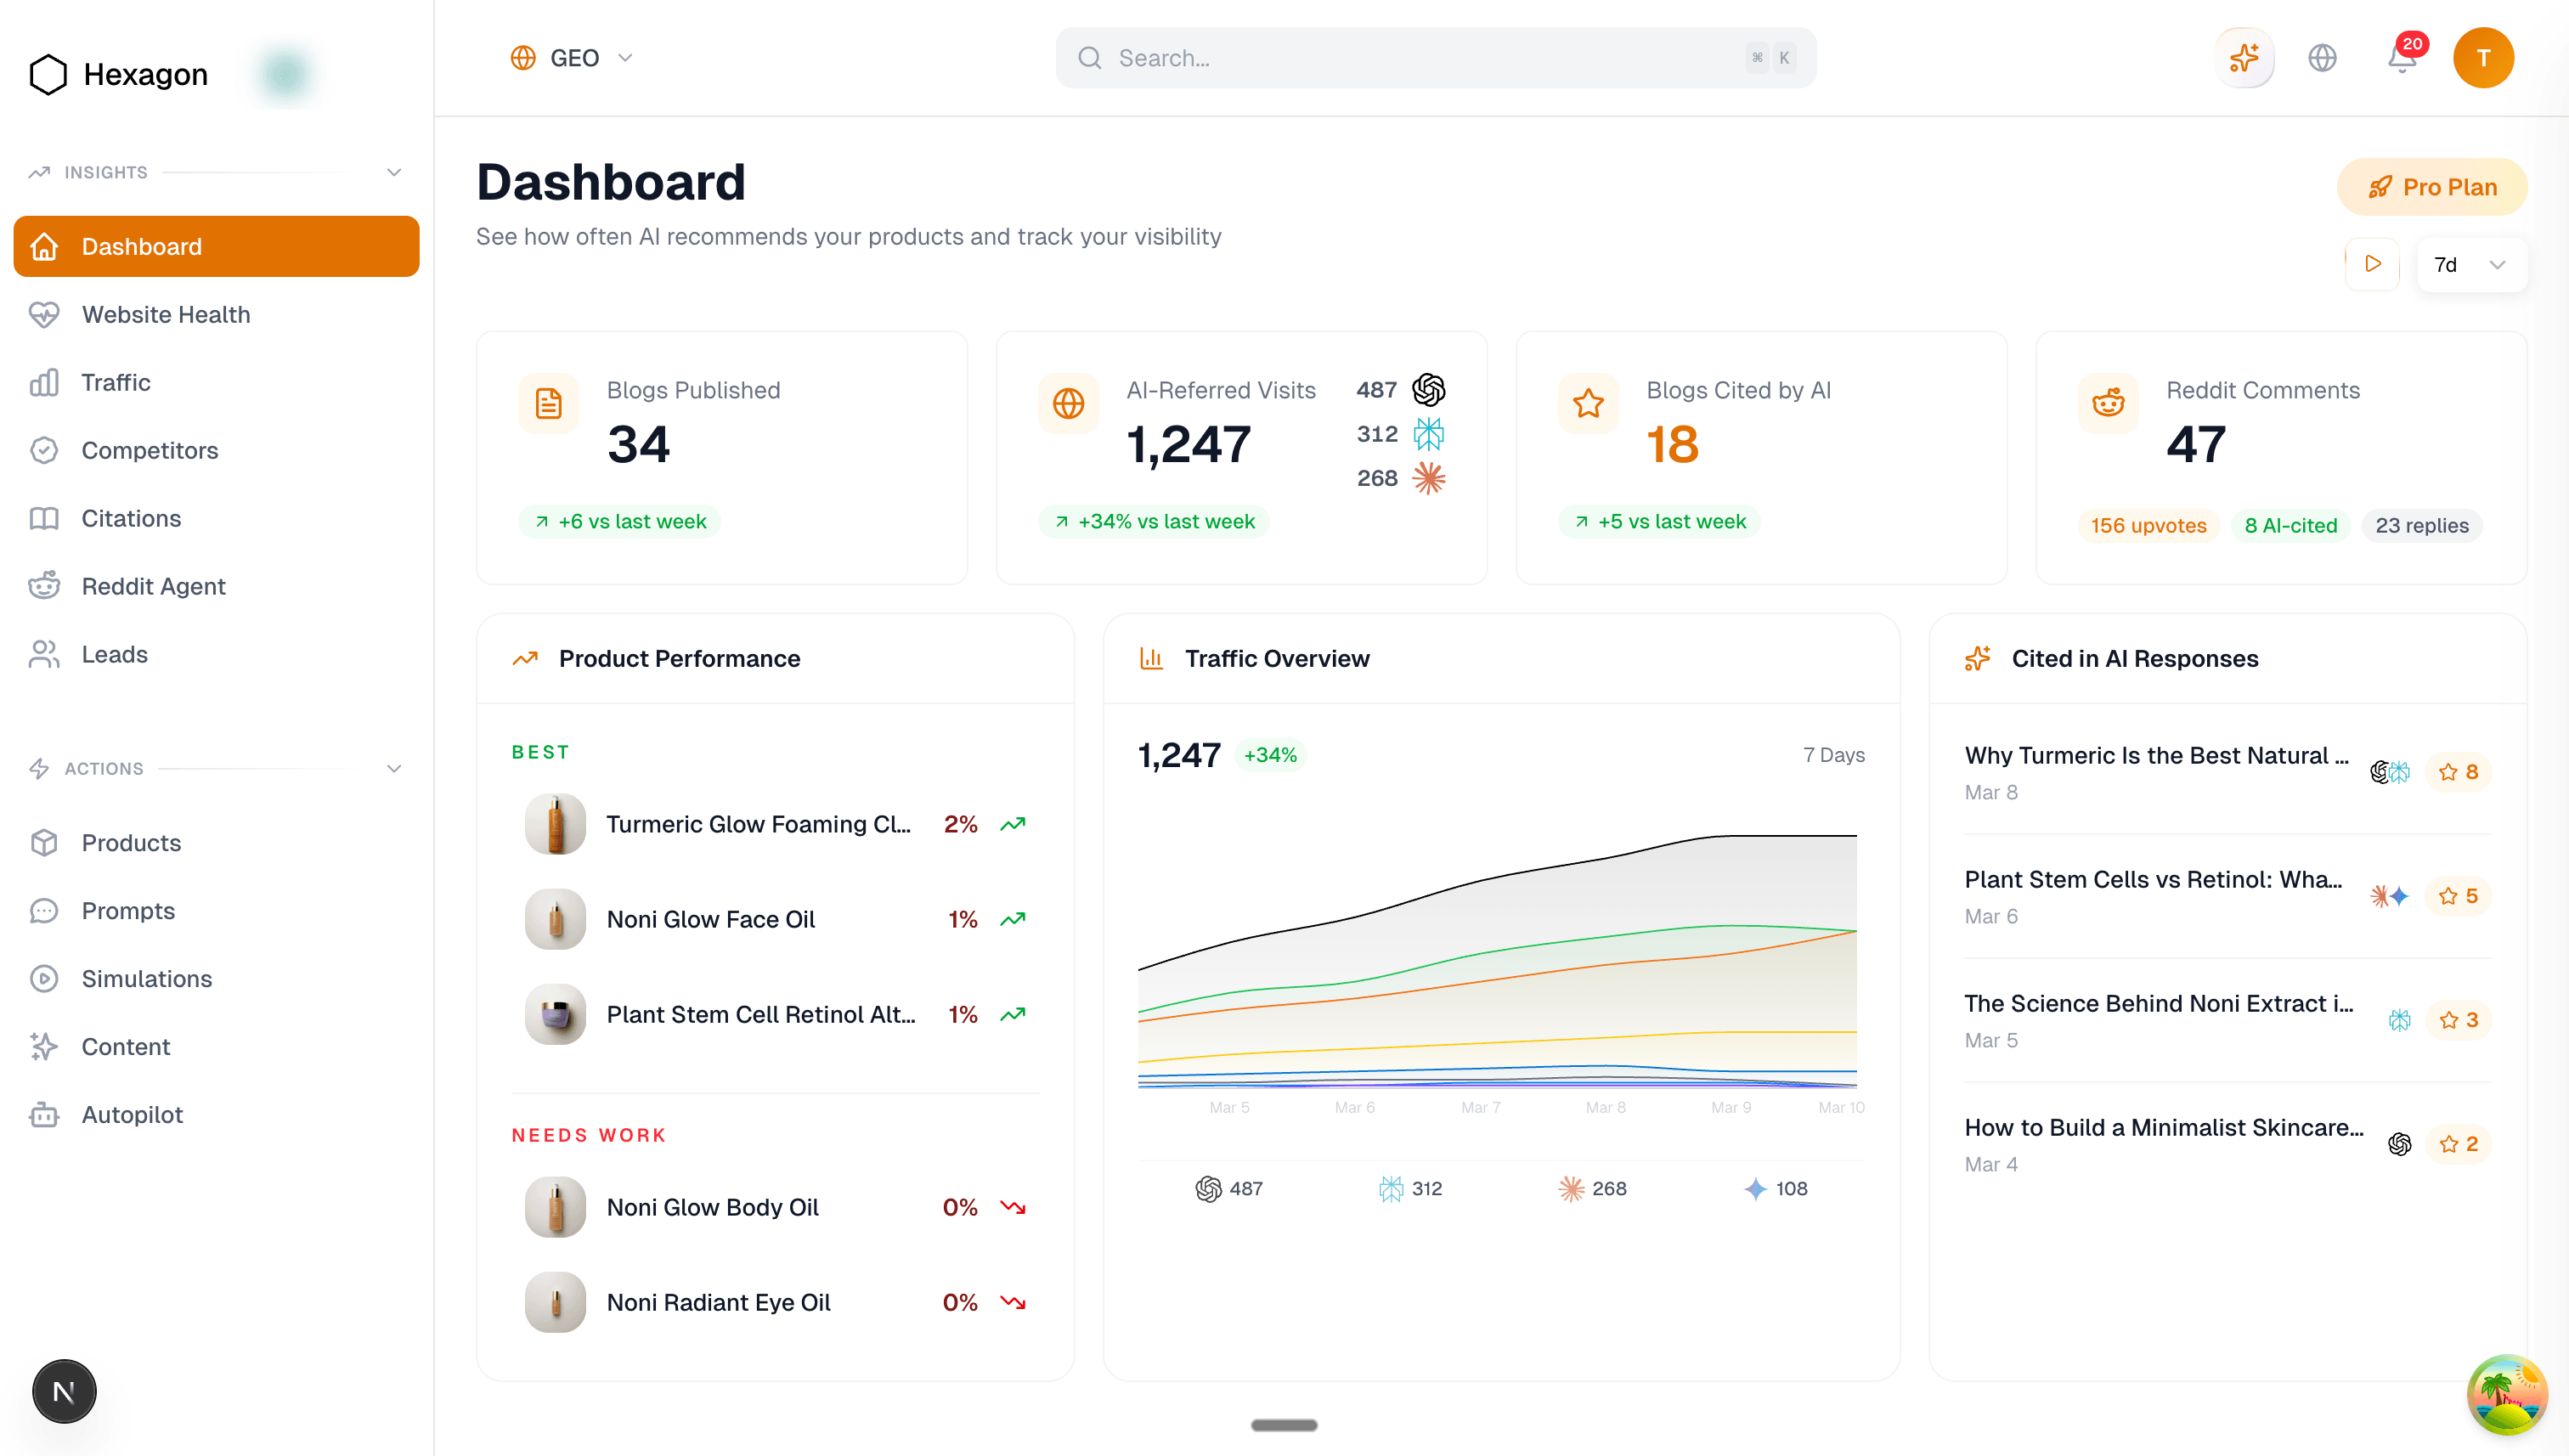
A plataforma também inclui o “Hexi”, um chatbot criado com o recurso de chamada de função da API Responses. Ao conversar com o Hexi, os clientes podem explorar as análises e gerar por conta própria resumos dos dados de visibilidade de suas marcas nas respostas da IA. A Hexagon apresenta essas análises em um painel no qual os varejistas acompanham como seus produtos aparecem nas respostas geradas por IA.
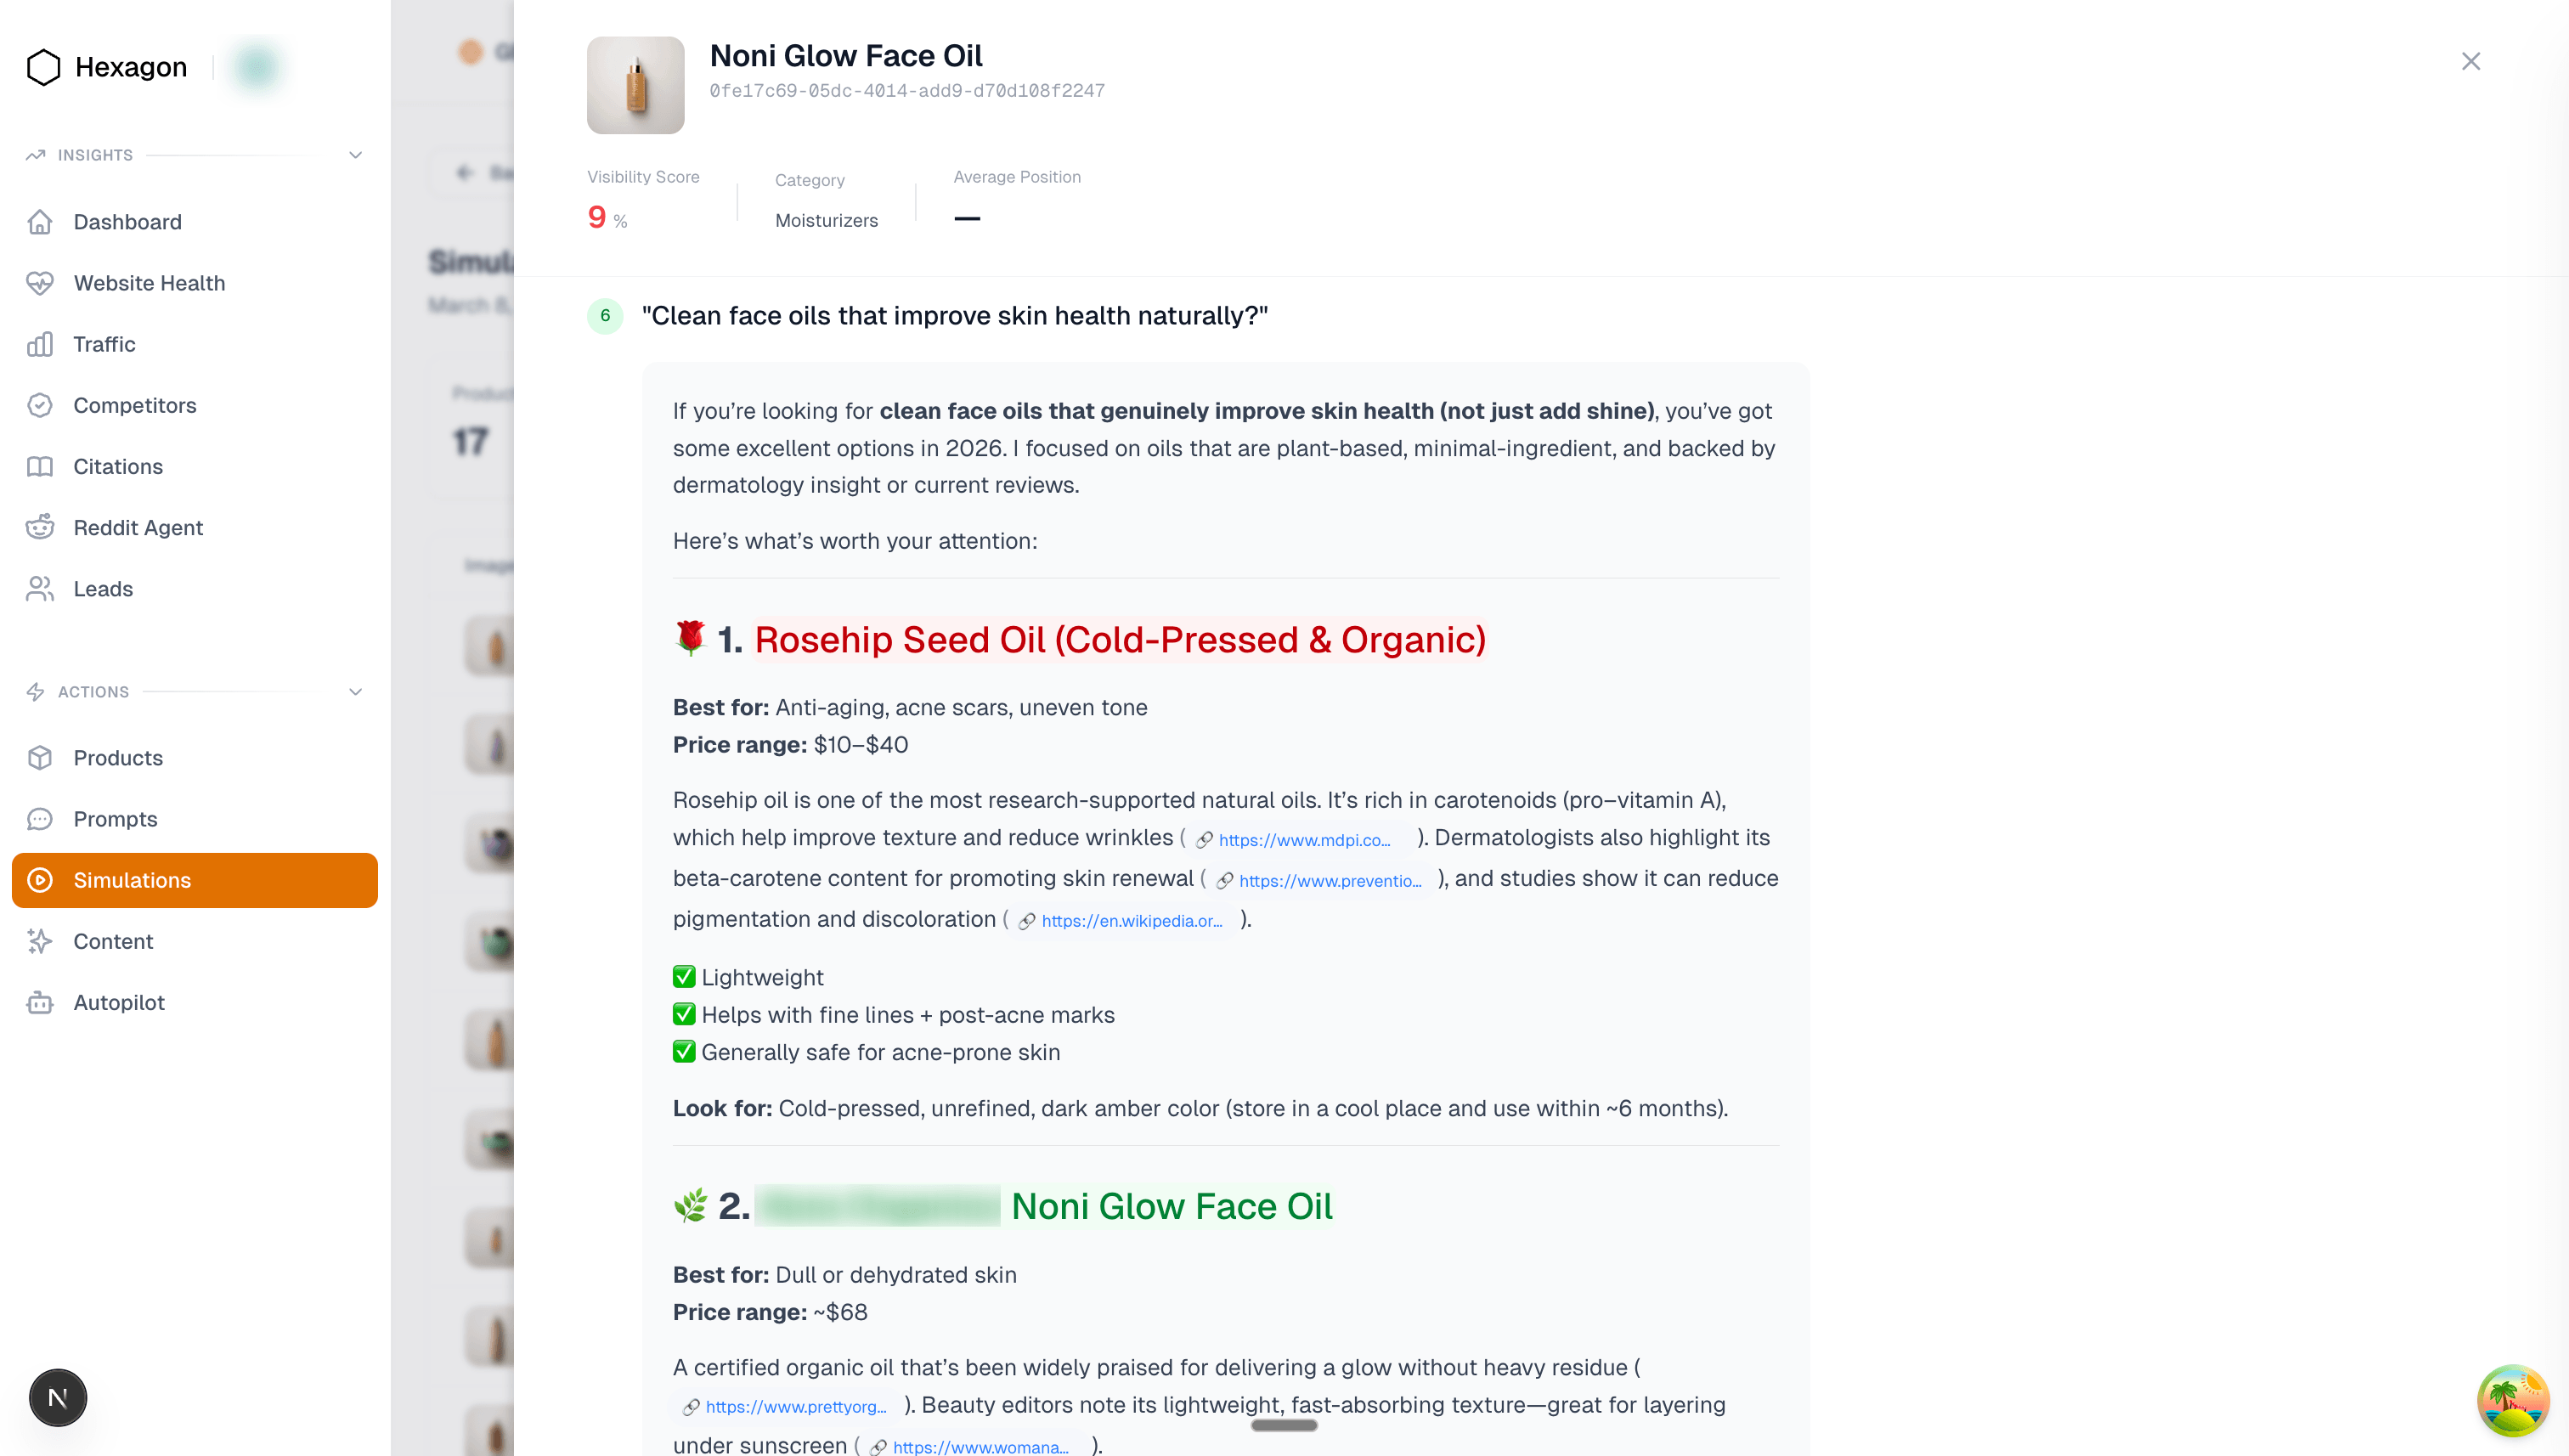
A Hexagon usa vários recursos importantes da API Responses para tornar as simulações realistas e úteis em todo o produto:
- Pesquisa na Web: reproduz respostas obtidas com a navegação na Web habilitada, semelhantes às do ChatGPT.
- Parâmetro de localização do usuário: simula consultas de diferentes regiões para testar como os resultados variam conforme a localização.
- Esforço de raciocínio: controla a profundidade e a complexidade das respostas.
- Número máximo de tokens de saída: limita o tamanho das respostas em textos longos.
- Persistência de contexto: mantém o contexto entre chamadas, permitindo fluxos de trabalho com vários agentes.
Com a API Responses, obtivemos respostas de melhor qualidade e maior persistência do contexto entre chamadas. Esses dois fatores são fundamentais para os pipelines de várias etapas que sustentam a plataforma da Hexagon.
Para concluir
Em um ano, a API Responses se tornou uma peça central para quem desenvolve software com agentes de IA.
Essas cinco histórias mostram o que isso significa na prática: sistemas com vários agentes que coordenam ferramentas, detectam bugs, executam fluxos de trabalho e ajudam a lançar produtos com IA.
A própria plataforma evolui rapidamente, com melhorias na orquestração e ecossistemas de ferramentas mais completos. Entre as novidades estão os contêineres hospedados pela OpenAI com acesso à rede e as ferramentas de shell.
Mais ferramentas.
Mais recursos.
Mais desenvolvedores criando coisas que o restante de nós ainda nem imaginou.
Vamos ver o que os desenvolvedores vão criar no segundo ano.