
À son lancement, il y a près d’un an, OpenClaw a montré au monde ce qu’un agent persistant pouvait accomplir. Dans une session Codex classique, une personne guide l’agent vers un objectif défini. Les agents persistants, eux, fonctionnent 24 heures sur 24, 7 jours sur 7. Leur champ d’action est large et ils peuvent prendre des initiatives sans intervention de l’utilisateur.
Malgré les capacités de ces agents, leur déploiement en conditions réelles reste limité. Il soulève de nombreuses difficultés nouvelles par rapport aux logiciels classiques. Avec ces derniers, nous pouvions compter sur le comportement déterministe du code et de sa configuration, et les menaces venaient principalement d’attaquants externes. Les agents persistants peuvent modifier leur configuration et écrire du code arbitraire pour atteindre un objectif. Une attaque peut alors venir de l’intérieur, lorsqu’un agent agit d’une manière contraire aux intentions de l’utilisateur.
Chez OpenAI, nous avons déployé des agents persistants dans toute l’entreprise, dont plusieurs centaines d’agents OpenClaw. Cet article présente certaines des mesures de sécurité qui nous ont permis d’y déployer OpenClaw.
Séparez les composants de confiance des environnements d’exécution non fiables
Pour sécuriser les agents persistants, nous avons dû isoler la logique déterministe de confiance de l’environnement d’exécution du LLM, que nous considérons comme non fiable. Cette logique englobe des composants critiques qui gèrent notamment le réseau, l’identité et le bac à sable. Il s’agit de code statique classique qui, sauf bug, devrait se comporter conformément à sa configuration. Nous considérons les agents, leur environnement d’exécution et le code qu’ils écrivent comme non fiables. Dans cet environnement, les agents peuvent générer du code à la volée pour atteindre un objectif, sans que son comportement puisse être garanti.
Pour permettre cette séparation dans OpenClaw, nous avons ajouté au projet open source la prise en charge de l’exécution du harnais à distance. La passerelle OpenClaw Gateway peut ainsi s’exécuter dans un conteneur distinct de celui du harnais de l’agent et, dans notre cas, dans un cluster distinct.
Grâce à cette séparation, nous avons pu traiter le code de la passerelle qui configure l’agent comme du code déterministe de confiance. Nous avons ainsi pu concentrer nos efforts sur l’exécution de la charge de travail de l’agent en bac à sable, puisque nous considérons ce code comme non fiable.
Imposez des limites de sécurité strictes
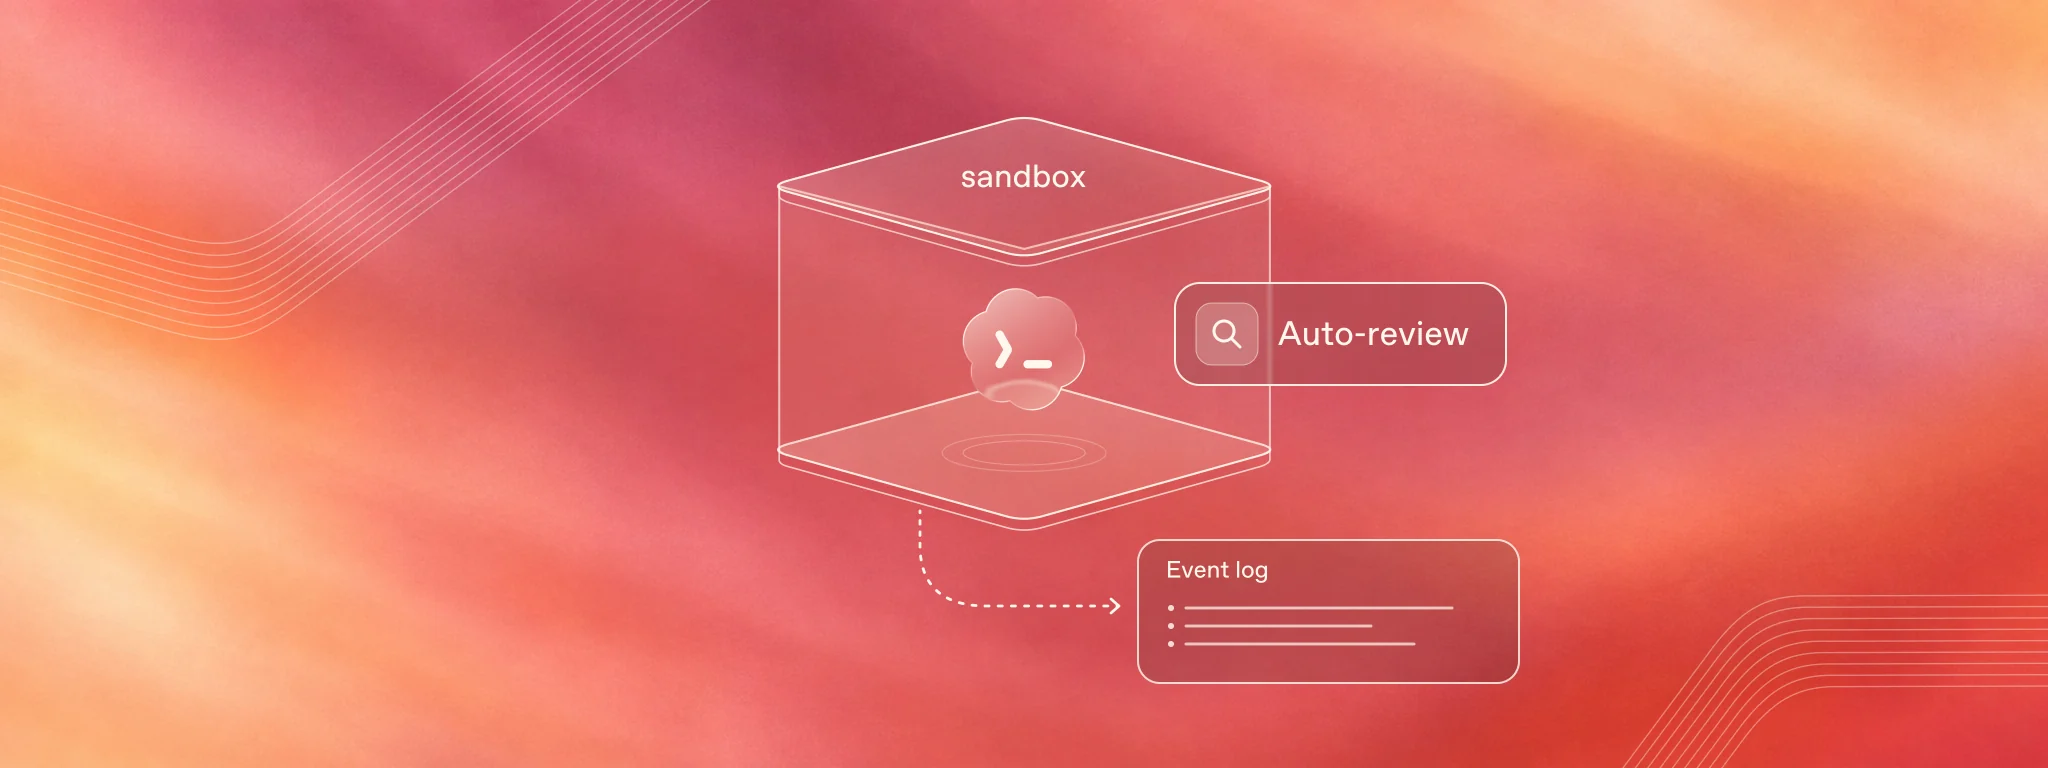
Le bac à sable impose des limites de sécurité aux charges de travail des agents en restreignant les actions qu’ils peuvent effectuer.
Pour notre déploiement d’OpenClaw, nous avons appliqué les restrictions suivantes dans le bac à sable :
- Réseau : pour contrôler les points de terminaison accessibles à l’agent, nous avons utilisé une liste d’autorisation gérée par l’organisation et explicitement interdit l’accès aux points de terminaison soumis à restriction.
- Espace de travail : pour contrôler l’accès aux fichiers, nous avons autorisé l’écriture uniquement dans les répertoires de travail des agents.
- Processus : pour contrôler les processus accessibles à l’agent, nous avons utilisé l’isolation des processus assurée par le bac à sable Linux de Codex.
- Secrets : pour contrôler l’accès aux secrets, nous confions leur gestion à un service intermédiaire chargé des identifiants. Les secrets restent ainsi invisibles pour l’agent.
Pour notre déploiement d’OpenClaw, nous avons utilisé le bac à sable intégré au harnais de Codex. Voici quelques-uns de nos paramètres. Le fichier requirements.toml restreint les options disponibles pour configurer Codex, tandis que config.toml définit la configuration utilisée. Nous avons aussi activé des protections supplémentaires. Nous avons interdit le mode danger-full-access et opté pour la recherche web en cache, qui interroge le propre index d’OpenAI pour répondre aux requêtes de recherche.
requirements.toml
# Exclure le mode de bac à sable sans restriction "danger-full-access".
allowed_sandbox_modes = ["read-only", "workspace-write"]

# Autoriser uniquement la recherche hébergée en cache et exclure la recherche hébergée en direct.
allowed_web_search_modes = ["cached"]

# Imposer le proxy réseau géré.
experimental_network.enabled = true

# Empêcher la configuration utilisateur d’étendre la liste des domaines autorisés.
experimental_network.managed_allowed_domains_only = true

# Autoriser uniquement ces destinations. Remplacez-les par les hôtes nécessaires à la charge de travail.
experimental_network.allowed_domains = [
  "github.com",
  "api.github.com",
  "codeload.github.com",
]

# Bloquer explicitement ces destinations, y compris les points de terminaison de métadonnées du cloud.
experimental_network.denied_domains = [
  "pastebin.com",
  "*.pastebin.com",
  "webhook.site",
  "metadata.google.internal",
  "169.254.169.254",
]
config.toml
# Sélectionner le profil d’autorisations défini ci-dessous.
default_permissions = "openclaw"

# Utiliser la recherche hébergée en cache.
web_search = "cached"

[permissions.openclaw.filesystem]
# Autoriser les lectures nécessaires à l’environnement d’exécution minimal.
":minimal" = "read"

# Autoriser la lecture et la modification de l’espace de travail de l’agent.
"/home/dev-user/openclaw-workspaces" = "write"

# Autoriser l’accès en lecture seule aux ressources gérées.
"/home/dev-user/read-only" = "read"

# Interdire l’accès aux identifiants SSH.
"/home/dev-user/.ssh" = "deny"

[permissions.openclaw.network]
# Autoriser l’accès au réseau via le proxy imposé par l’administrateur.
enabled = true

# Ne pas hériter d’un proxy en amont.
allow_upstream_proxy = false

# Maintenir la protection du proxy relative aux adresses locales et privées.
allow_local_binding = false

# Désactiver l’écoute SOCKS5.
enable_socks5 = false

# Désactiver la prise en charge d’UDP par SOCKS5.
enable_socks5_udp = false

# Interdire au proxy d’écouter sur des adresses autres que les adresses de bouclage.
dangerously_allow_non_loopback_proxy = false

# Interdire l’accès sans restriction aux sockets Unix.
dangerously_allow_all_unix_sockets = false

[shell_environment_policy]
# Conserver le filtrage par défaut des variables d’environnement sensibles.
ignore_default_excludes = false

# Retirer les identifiants GitHub de l’environnement des commandes exécutées par l’agent.
# Les identifiants stockés dans des fichiers accessibles restent visibles.
exclude = [
  "GH_TOKEN",
  "GITHUB_TOKEN",
  "OPENCLAW_GITHUB_BASIC_AUTH",
  "OPENCLAW_GITHUB_READONLY_BASIC_AUTH",
]

[apps._default]
# Désactiver les applications sauf si elles sont activées individuellement.
enabled = false

# Désactiver par défaut les opérations destructrices des applications.
destructive_enabled = false

# Désactiver par défaut les opérations des applications en monde ouvert.
open_world_enabled = false
Ajoutez des protections fondées sur des modèles
Les mesures présentées jusqu’ici sont statiques : elles s’appuient sur du code déterministe classique pour empêcher un agent d’agir à l’encontre des intentions de l’utilisateur. À mesure que les modèles gagnent en capacité, nous avons aussi besoin de mécanismes de défense dont l’efficacité augmente avec les ressources de calcul disponibles. D’autres modèles peuvent jouer ce rôle.
Avec la Révision automatique, un second agent peut surveiller et approuver les actions de l’agent principal. À force de devoir examiner chaque demande d’autorisation, les personnes sollicitées se lassent et prennent l’habitude de tout accepter sans vérification. En confiant un premier examen à un LLM, nous réservons l’attention humaine aux décisions d’approbation qui présentent le plus d’enjeux. OpenClaw et Codex intègrent tous deux cette fonctionnalité.
Dans notre déploiement d’OpenClaw, nous imposons la révision automatique de toutes les actions des agents.
Distinguez l’identité de l’agent de celle de l’utilisateur
Lorsqu’un agent effectue une action, nous devons pouvoir auditer cette action, accorder à l’agent l’accès aux ressources et déterminer si l’initiative vient de l’agent ou de l’utilisateur. Attribuer une identité à l’agent nous le permet. Certaines spécifications en cours d’élaboration, comme WAG, donnent aux agents leur propre accès aux ressources. D’autres, comme XAA, leur permettent d’agir au nom de l’utilisateur par délégation OAuth. L’identité d’un agent se distingue d’un compte de service, qui donne à un bot un accès distinct à l’API. Il convient de les utiliser conjointement. Par exemple, votre agent devrait agir sous sa propre identité et accéder aux services tiers au moyen de comptes de service liés à cette identité.
Dans notre déploiement d’OpenClaw, chaque agent dispose d’une identité unique associée à un compte de service ChatGPT. Chaque agent dispose ainsi de son propre identifiant d’accès à l’inférence, distinct de celui de l’utilisateur, et les équipes peuvent connecter des plugins personnalisés à l’agent. Nous pouvons également auditer les actions de l’agent et, si nécessaire, désactiver son accès à l’inférence.
Observez l’ensemble du cycle de vie
Une observabilité complète permet aux opérateurs de comprendre tout le cycle de vie des agents, depuis leur configuration jusqu’aux actions qu’ils ont effectuées. Pour les agents persistants, cette couverture est indispensable pour détecter les actions contraires aux intentions de l’utilisateur et en retracer le déroulement.
Dans notre déploiement d’OpenClaw, nous consignons chaque modification de configuration sur le plan de contrôle ainsi que chaque tour d’exécution de l’agent. Comme ces tours peuvent contenir des informations sensibles, l’accès aux journaux est strictement réservé à quelques membres de l’équipe de sécurité.
Conclusion
Le déploiement d’agents persistants en est encore à ses débuts. Faute de bonnes pratiques établies, de nombreuses entreprises ont aujourd’hui du mal à les adopter.
Lorsque nous avons lancé notre projet pilote OpenClaw chez OpenAI, nous avons constaté une forte hausse de la productivité et de l’adoption des agents dans toute l’entreprise, aussi bien au sein des équipes techniques que des équipes non techniques. Aujourd’hui, plus de 500 agents prennent des initiatives en arrière-plan pour accomplir des tâches concrètes. Par exemple, ils ouvrent automatiquement des pull requests à la suite de retours sur un produit ou mènent en continu des expériences sur les données de nouvelles fonctionnalités.
Lors de l’OpenAI DevDay, nous avons annoncé OpenClaw Enterprise (OCE), un plan de contrôle open source pour les agents, indépendant de tout fournisseur. Avec OCE, vous pouvez lancer un agent en utilisant le préréglage standard de Codex, qui intègre une grande partie des protections présentées dans cet article. Le projet est encore en phase pilote. Nous prévoyons de publier la version 1.0 d’ici la fin de l’année.
Nous pensons que bon nombre des avancées les plus importantes que l’IA apportera aux entreprises viendront des agents persistants. En partageant ce que nous avons appris et en développant OCE au grand jour, nous espérons permettre à chacun de déployer ces agents de manière plus sûre.