
このガイドでは、LLM を使うさまざまなユースケースでレイテンシを短縮するための基本原則を紹介します。ここで取り上げる手法は、多くのお客様や開発者と本番アプリケーションに取り組むなかで得られたものです。個別の処理を担うワークフローから、会話全体を扱うチャットアプリケーションまで、幅広い開発に応用できます。
レイテンシを短縮する手法は数多くあります。このガイドでは、アプローチごとに整理し、7 つの原則にまとめています。
最後に、これらの原則をどのように適用できるかを例に沿って見ていきます。
7 つの原則
トークン処理の高速化
レイテンシを短縮しようとすると、まず推論速度が思い浮かぶかもしれません。後ほど紹介するように、改善できる点はほかにも数多くあります。推論速度とは、LLM が実際にトークンを処理する速さのことで、通常は TPM(1 分あたりのトークン数)または TPS(1 秒あたりのトークン数)で測ります。
推論速度に最も影響するのはモデルのサイズです。小規模なモデルは一般に高速でコストも低く、使い方によっては大規模なモデルを上回ることもあります。小規模なモデルで高い品質を維持するには、次の手法を検討できます。
- プロンプトを長くし、指示をより詳しく記述する
- フューショットの例を追加するか、既存の例を増やす
- ファインチューニングや蒸留を活用する
予測出力機能などを使って推論を最適化することもできます。コード編集のように出力の大部分が事前にわかっている場合、予測出力を使うと生成時のレイテンシを大幅に短縮できます。予測した出力をモデルに渡すことで、LLM は変わらない部分にかける処理を減らし、実際の変更箇所に集中できます。
推論速度には、利用できる
計算リソースの量や、追加で行う
推論の最適化も影響します。
多くの場合、これらの要因を直接調整することはできません。ただし、インフラをある程度自分で管理でき、改善を試したい場合は、より高速なハードウェアを使うか、
エンジンの負荷に余裕を持たせて運用することで、TPM が多少向上する可能性があります。推論基盤の実装に携わっている場合は、このガイドの範囲を超えるものの、ほかにも数多くの
推論の最適化手法
を検討できます。
出力トークン数の削減
LLM を使うとき、ほとんどの場合、最も時間がかかるのはトークンの生成です。目安として、出力トークン数を半分にすると、レイテンシも約半分に短縮できる可能性があります。出力を短くする方法は、その形式によって異なります。
自然言語を生成する場合は、簡潔に答えるようモデルに指示すると効果が得られることがあります(例:「20 語未満で」「手短に」)。フューショットの例やファインチューニングを使い、短い応答をモデルに学習させる方法もあります。
構造化出力を生成する場合は、可能な範囲で出力の構文を簡潔にします。たとえば、関数名を短くする、名前付き引数を省略する、パラメーターをまとめるといった方法があります。
あまり一般的ではありませんが、max_tokens や stop_tokens を使って生成を早めに終了することもできます。
出力トークンを 1 つ減らすだけでも、ミリ秒単位の時間を節約できます。
入力トークン数の削減
入力トークン数を減らすとレイテンシは短くなりますが、通常、その効果は大きくありません。プロンプトを半分に短縮しても、レイテンシの改善は 1~5% 程度にとどまることがあります。文書や画像などで非常に大きなコンテキストを扱う場合を除き、ほかの改善に時間をかけた方がよいでしょう。
一方、実際に非常に大きなコンテキストを扱っている場合や、ほかの手段をすべて試したうえでなお性能を限界まで引き出したい場合は、次の方法で入力トークン数を減らせます。
- モデルのファインチューニングにより、長い指示や例を不要にします。
- 入力コンテキストのフィルタリングを行い、RAG の検索結果を絞り込んだり、HTML から不要な部分を取り除いたりします。
- 複数のプロンプトで共通する先頭部分をできるだけ長くします。そのために、RAG の検索結果や履歴など、リクエストごとに変わる部分をプロンプトの後方に配置します。これにより、多くの LLM プロバイダーが使用する KV キャッシュを活用しやすくなり、リクエストごとに処理する入力トークンが減ります。
プロンプトキャッシュの仕組みについては、ドキュメントをご覧ください。
リクエスト数の削減
リクエストを送るたびに、応答が返るまでの往復時間がかかります。回数が増えると、この時間も積み重なります。
LLM に順番に実行させたいステップがある場合は、ステップごとにリクエストを送る代わりに、すべてのステップを 1 つのプロンプトにまとめ、結果を 1 回の応答で受け取る方法を検討してください。余分な往復時間を省けるうえ、複数の応答を扱う処理も簡素化できる可能性があります。
具体的には、1 つのプロンプト内に各ステップを番号付きリストで記述し、それぞれの結果を JSON オブジェクトの名前付きフィールドに入れて返すようモデルに指示します。こうすれば、各結果を個別に解析して参照できます。
並列化
LLM で複数のステップを実行する場合、並列処理が有効なことがあります。
各ステップを厳密な順序で実行する必要がなければ、個別の呼び出しに分けて並列実行できます。シャツを 2 枚同時に干しても、乾くまでの時間は 1 枚のときと同じです。
一方、厳密な順序で実行する必要があっても、投機的実行を活用できる場合があります。特に、モデレーションのように、ある結果がほかよりも出やすい分類ステップで効果的です。
- ステップ 1 とステップ 2 を同時に開始します(例:入力のモデレーションと物語の生成)。
- ステップ 1 の結果を確認します。
- 結果が予想と異なる場合はステップ 2 をキャンセルし、必要に応じて再試行します。
ステップ 1 の結果が予想どおりなら、その実行による追加のレイテンシは実質ゼロです。
ユーザーの待ち時間の短縮
ユーザーにとって、ただ待つことと処理の進み具合を見られることには大きな違いがあります。次の手法を使って、進捗が伝わるようにしましょう。
- ストリーミング:待ち時間を 1 秒以下に短縮できる、最も効果的な方法です。ChatGPT で応答が完成するまで何も表示されなかったら、使い心地は大きく変わるでしょう。
- チャンク単位の処理:出力をユーザーに表示する前にモデレーションや翻訳などの処理が必要な場合は、一括処理する代わりにチャンクに分けて処理することを検討してください。出力をバックエンドにストリーミングし、処理が済んだチャンクからフロントエンドに送ります。
- 処理ステップの表示:複数のステップを実行したり、ツールを使ったりする場合は、その様子をユーザーに表示します。実際の進捗が具体的に伝わるほど効果的です。
- 読み込み状態の表示:スピナーやプログレスバーだけでも効果があります。
処理ステップや読み込み状態の表示は、主にユーザーが感じる待ち時間を短くします。一方、ストリーミングやチャンク単位の処理では、ユーザーが応答を早く読み終えられるため、アプリが処理を開始してからユーザーが読み終えるまでの時間も実際に短くなります。
LLM を使うかどうかの判断
言語モデルは高性能で用途も広いため、より高速な従来の手法が適している場面でも使われることがあります。そうした場面を見極めることで、レイテンシを大幅に短縮できる可能性があります。たとえば、次のようなケースです。
- ハードコーディング:取り得る出力が限られていれば、LLM で生成する必要はないかもしれません。操作の確認、依頼を断るメッセージ、定型的な入力を求める案内は、あらかじめ文面を用意するのに適しています。それぞれに複数の言い回しを用意することもできます。
- 事前計算:カテゴリーの選択など、入力が限られている場合は、複数の応答をあらかじめ生成しておき、同じユーザーに同じ応答を二度表示しないようにするだけで済みます。
- UI の活用:指標の概要やレポート、検索結果は、LLM が生成した文章よりも、用途に合わせて設計した従来の UI コンポーネントで表示する方が伝わりやすい場合があります。
- 従来の最適化手法:LLM を使うアプリケーションにも、従来の最適化手法を適用できます。二分探索、キャッシュ、ハッシュマップの活用や、時間計算量の検討は、言語モデルを使う場合にも引き続き役立ちます。
例
サンプルアプリケーションを使って、レイテンシを改善できそうな箇所を特定し、対策を考えてみましょう。
ここでは、実際の本番アプリケーションを参考にした架空のカスタマーサービスボットのアーキテクチャとプロンプトを分析します。まずアーキテクチャとプロンプトで初期構成を確認し、分析と最適化でレイテンシを短縮する過程をたどります。
この例で適用する原則は一部です。実際のユースケースでも、すべての手法を使う必要はありません。
アーキテクチャとプロンプト
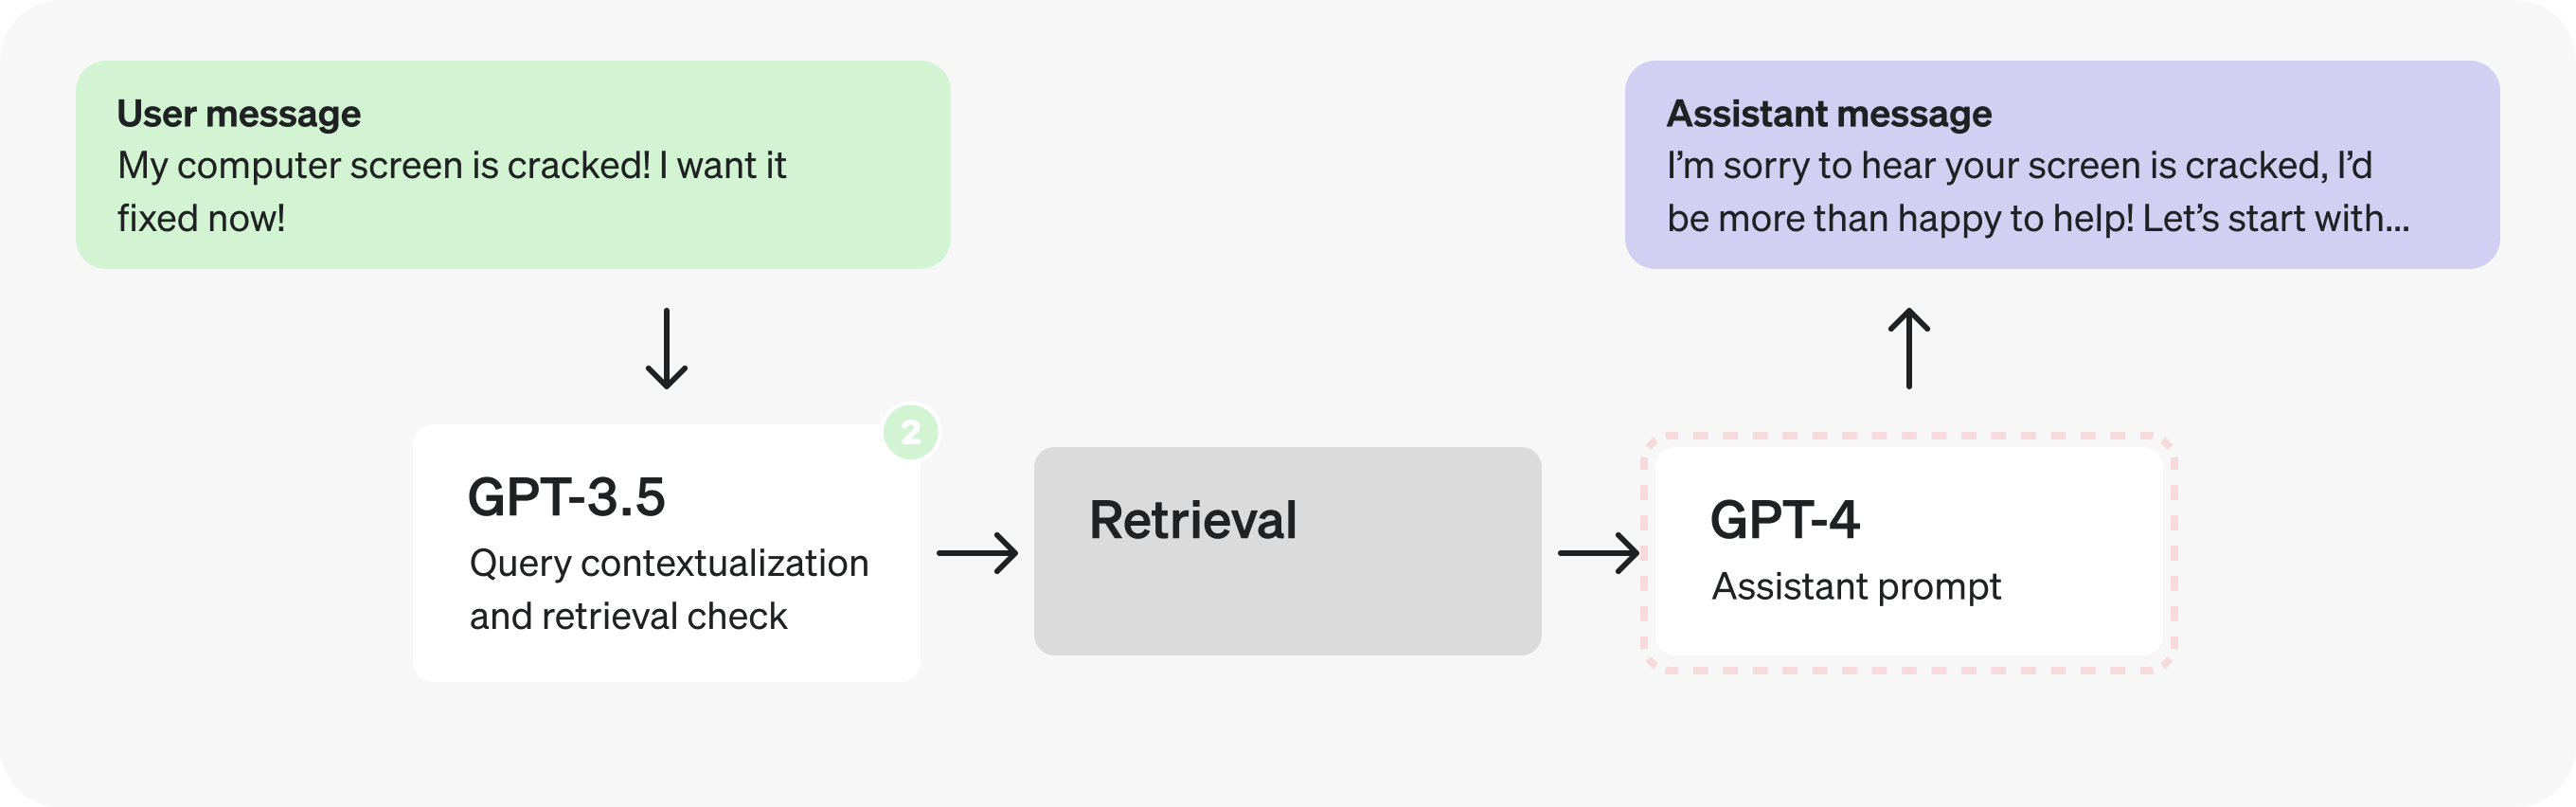
以下は、これから変更を加える初期アーキテクチャです。対象は架空のカスタマーサービスボットです。
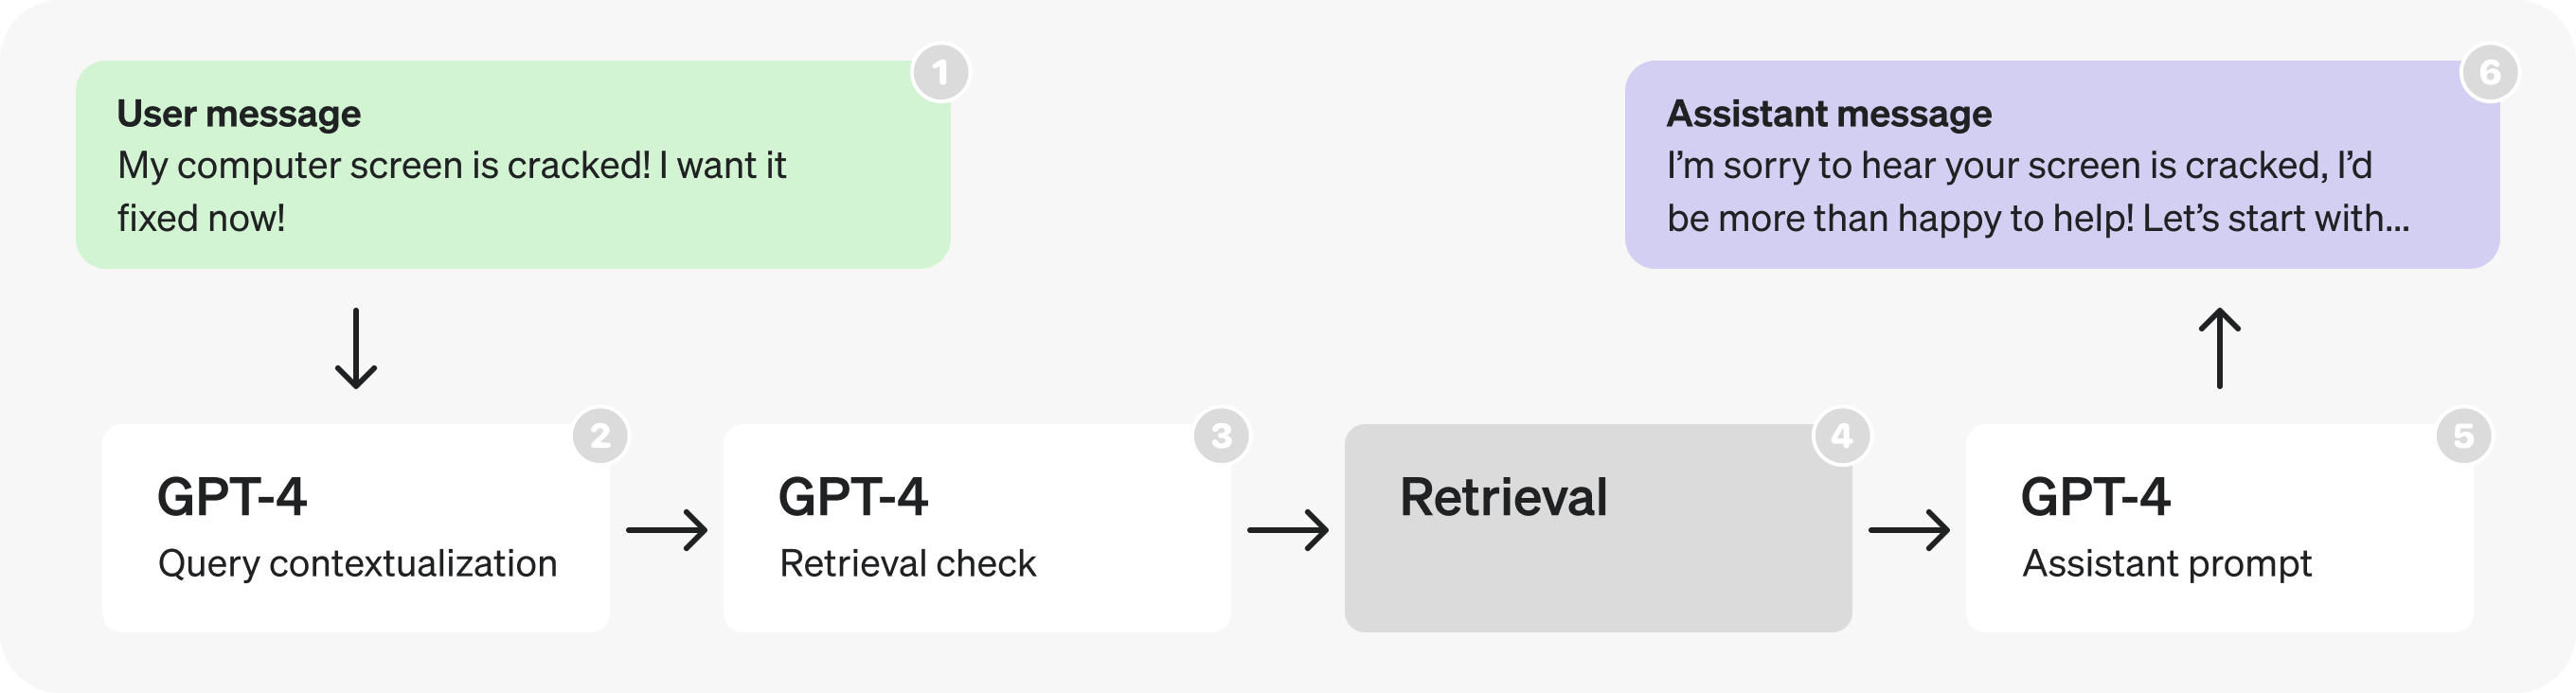
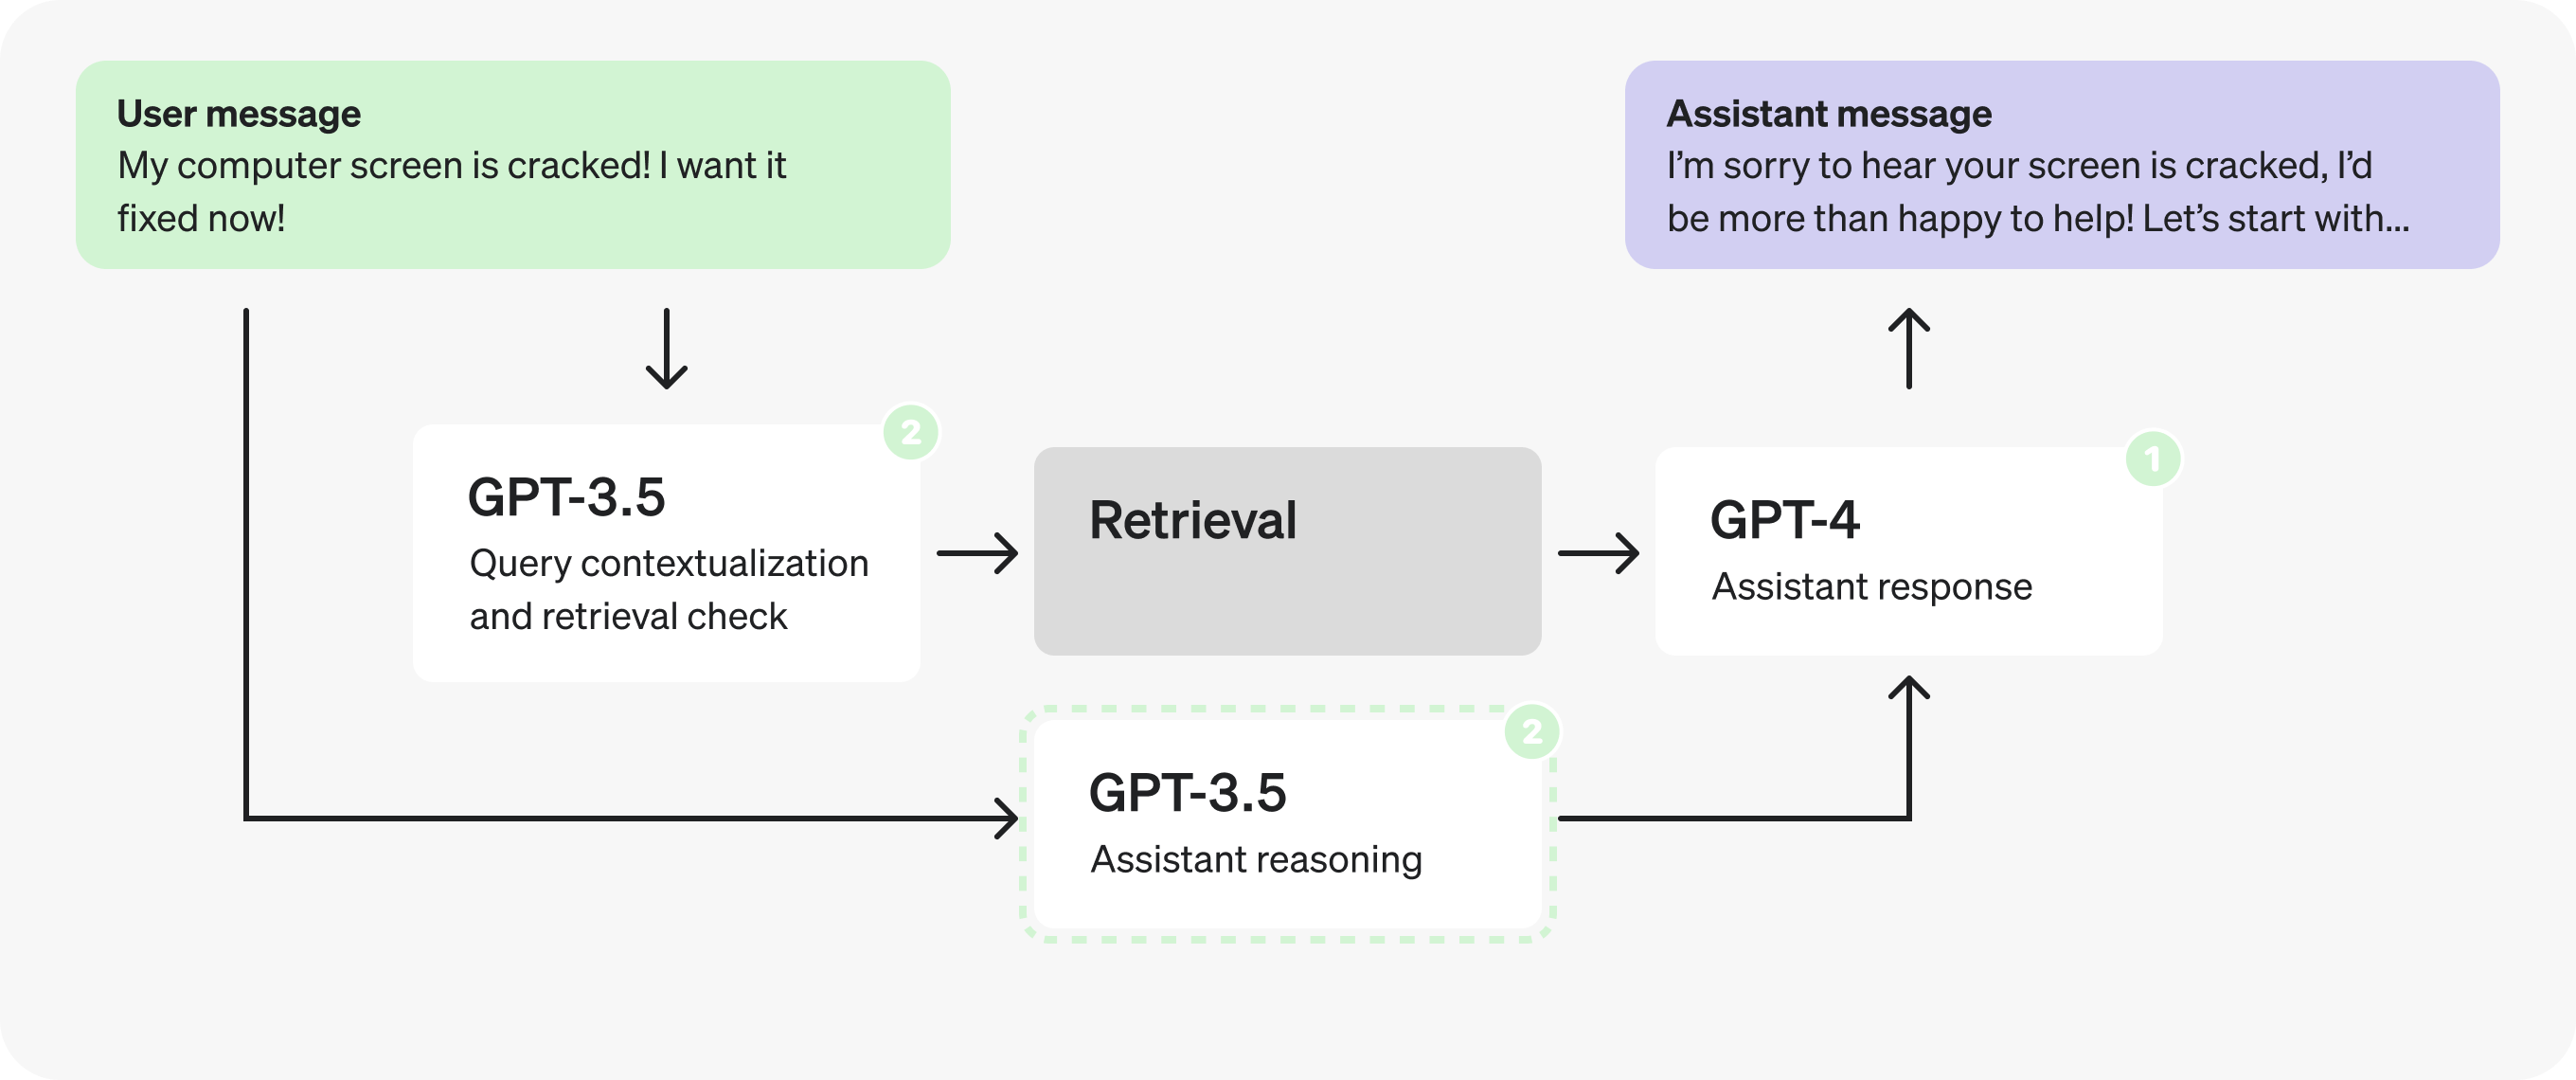
図に示した処理の流れは次のとおりです。
- 進行中の会話でユーザーがメッセージを送ります。
- 最後のメッセージを、単独で意味が通じるクエリに書き換えます(プロンプト内の例を参照)。
- クエリに回答するために追加の情報をリアルタイムで検索する必要があるかを判定します。
- 検索を実行して結果を取得します。
- アシスタントがユーザーのクエリと検索結果をもとに推論し、応答を生成します。
- ユーザーに応答を返します。
図の各処理で使用するプロンプトを以下に示します。説明のために簡略化した架空の例ですが、構成や指示の書き方は本番アプリケーションで使われるものに合わせています。
「[user input here]」のようなプレースホルダーは、実行時に実際のデータに置き換わる部分を示します。
分析と最適化
パート 1:検索用プロンプトの検討
アーキテクチャを見てまず目につくのは、GPT-4 を続けて呼び出している箇所です。このような箇所には改善の余地があり、複数の呼び出しを 1 回にまとめたり、並列で実行したりできることがよくあります。
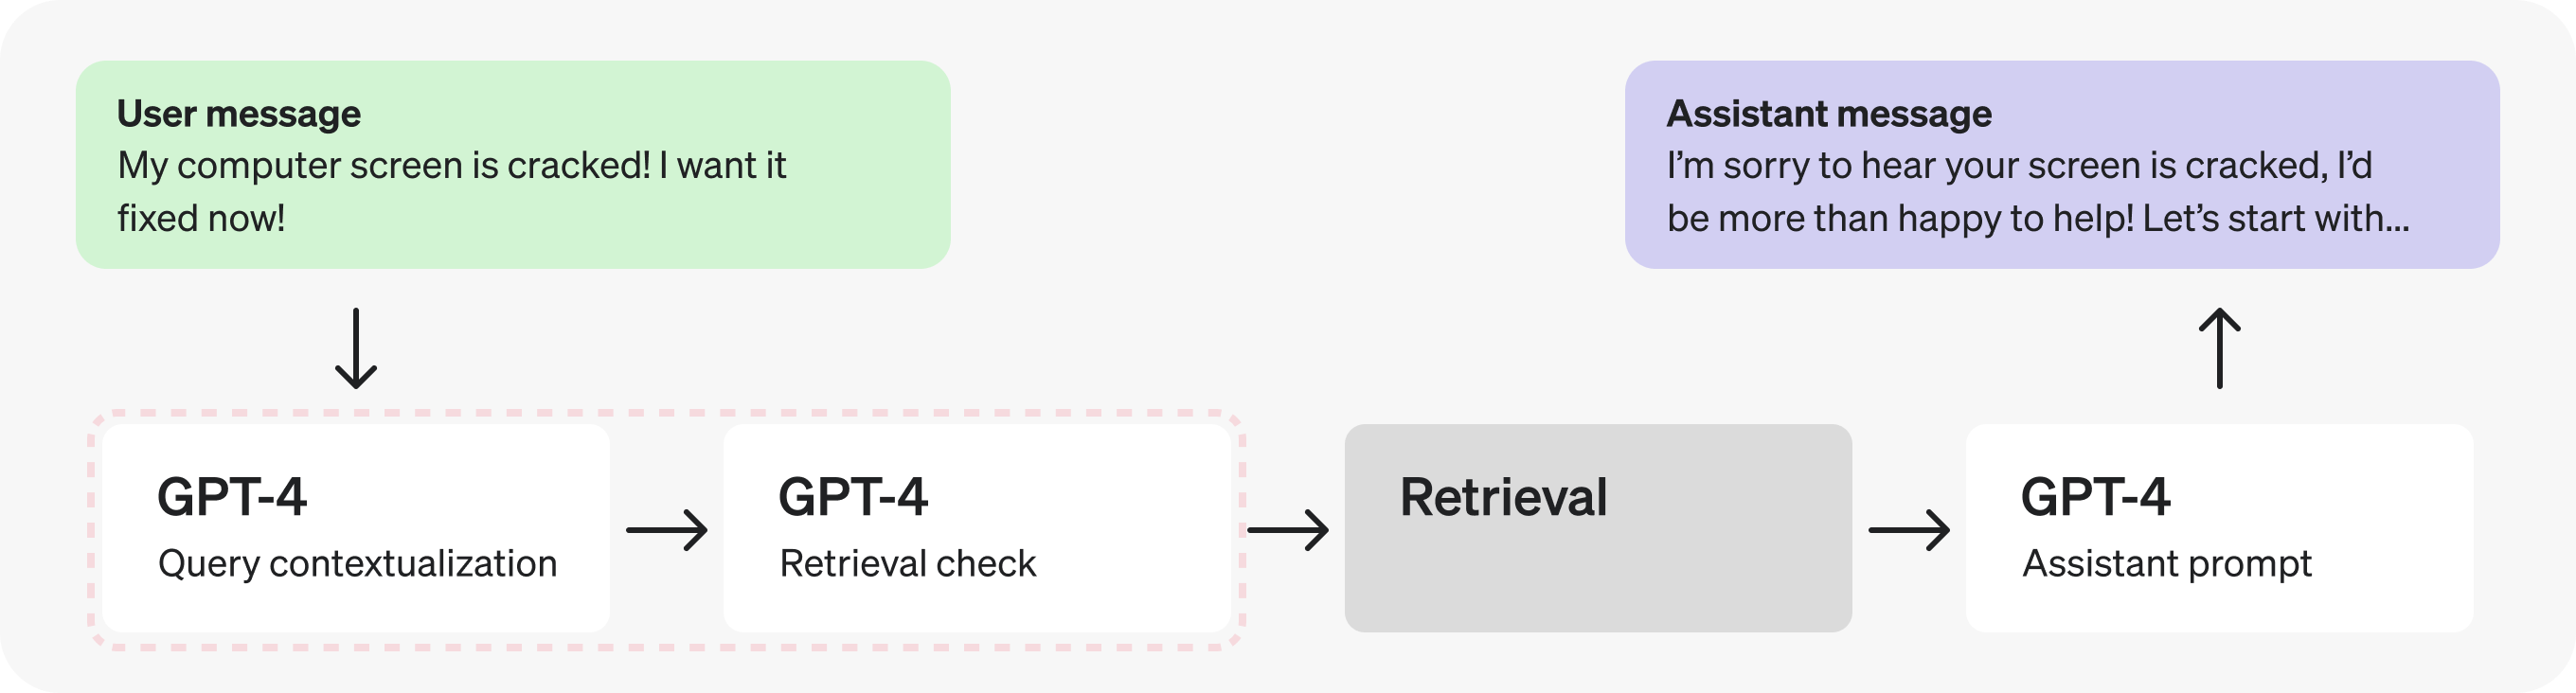
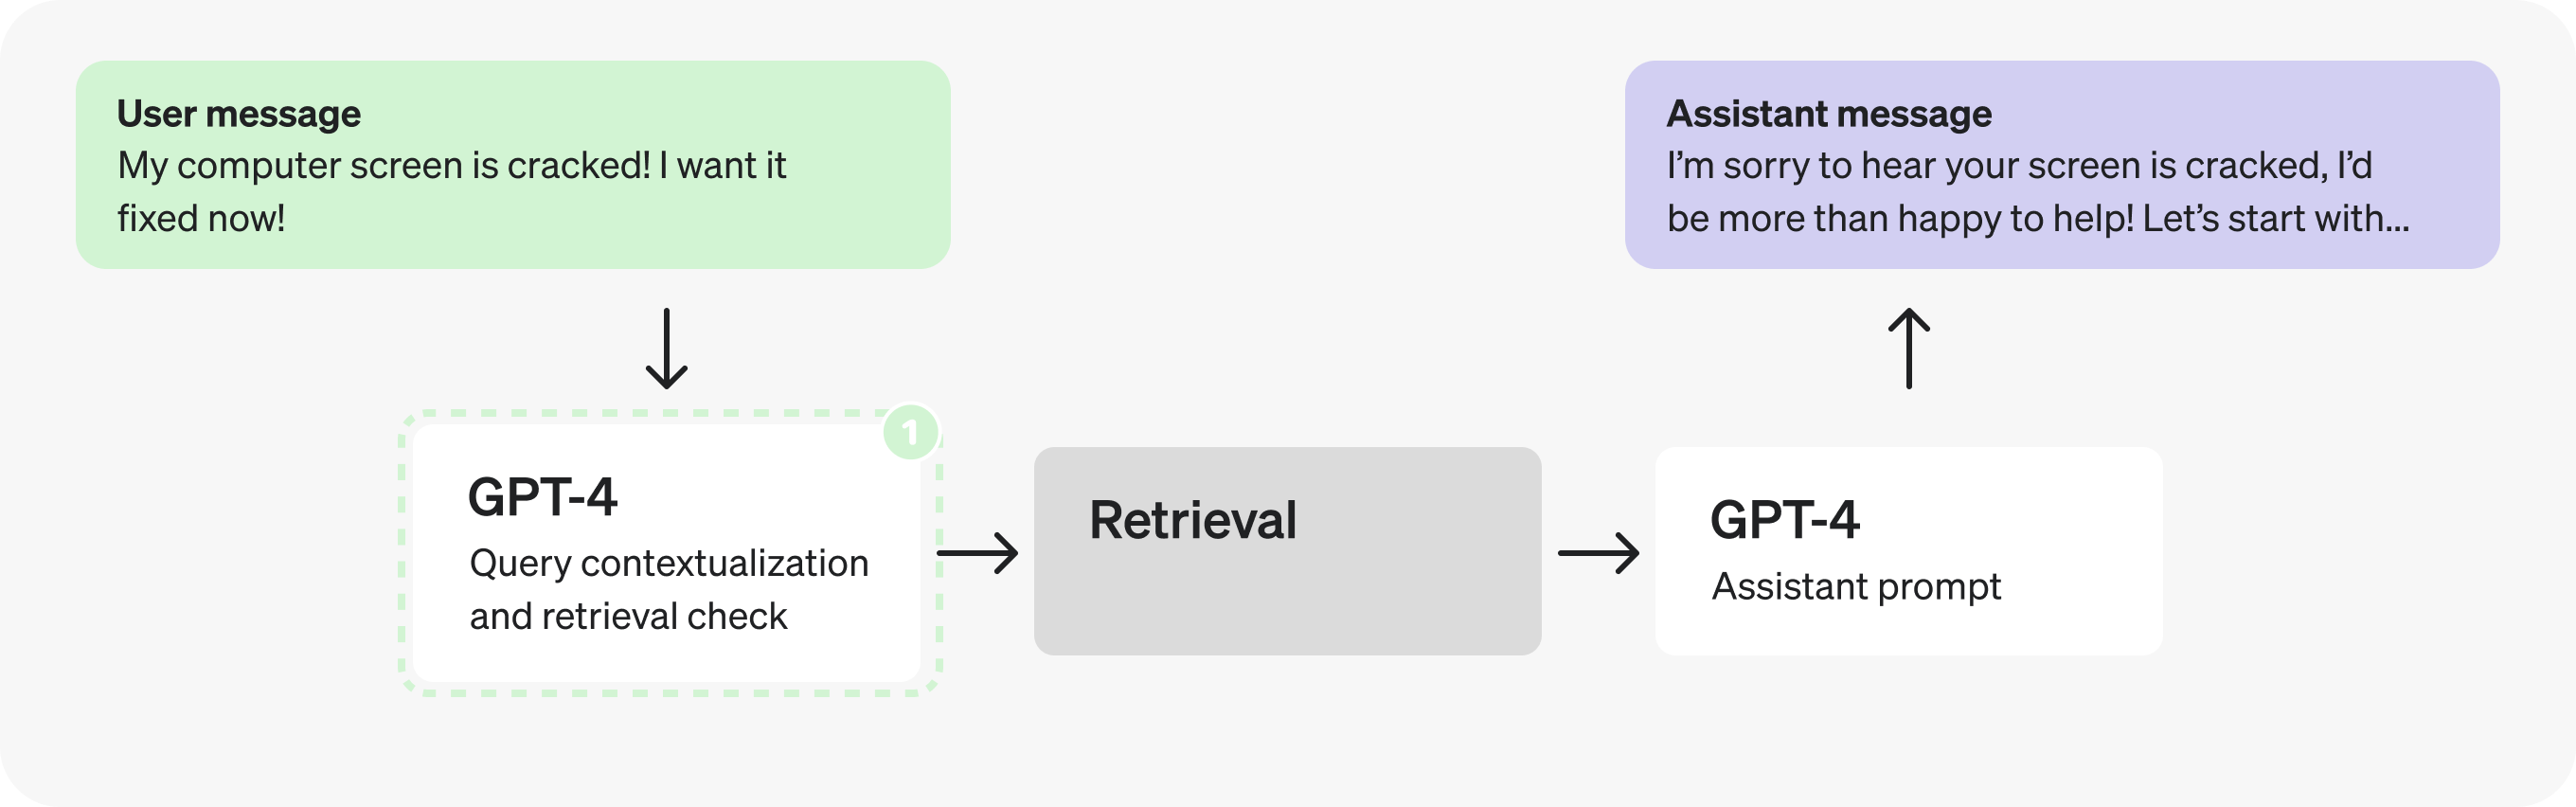
この例では、リアルタイム検索の要否を判定するには、コンテキストを補ったクエリが必要です。そこで、両方の処理を 1 つのプロンプトにまとめて、リクエスト数を減らします。
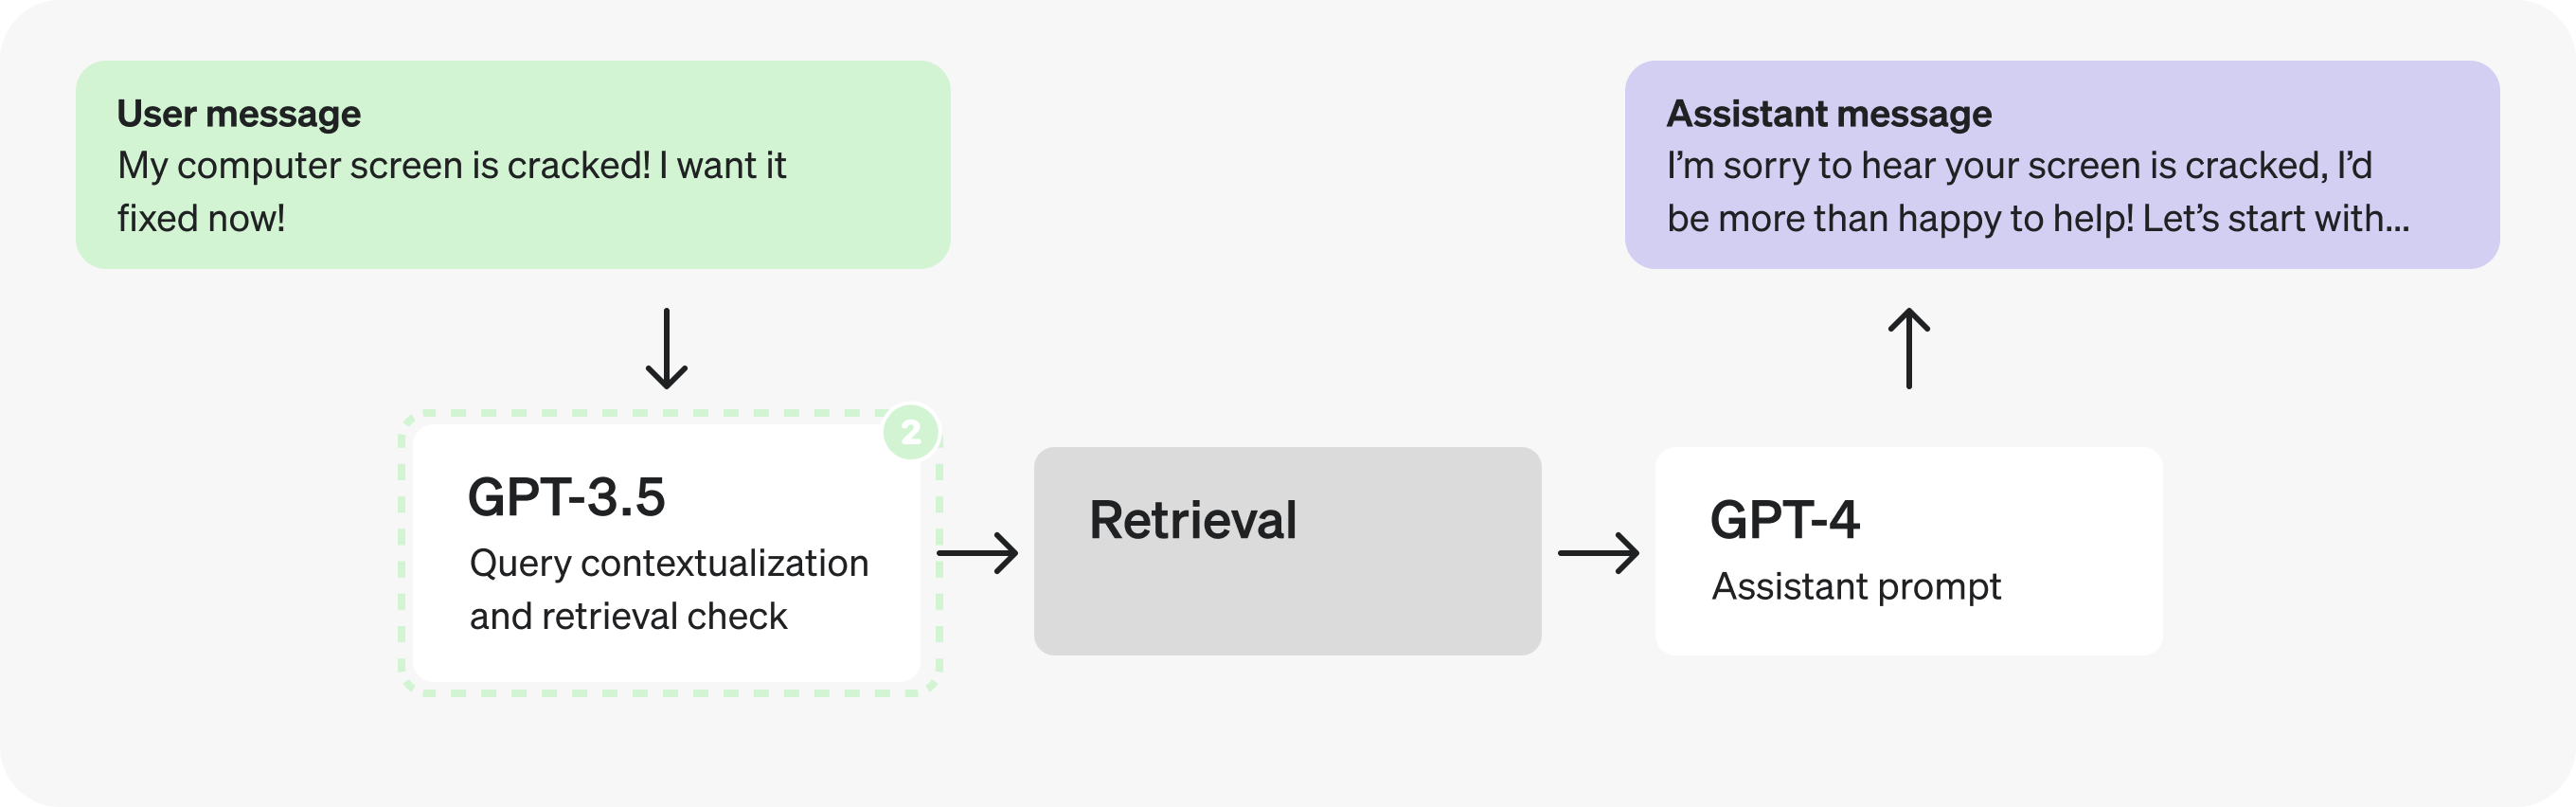
コンテキストの補完もリアルタイム検索の要否判定も、手順が明確で比較的単純なタスクです。そのため、ファインチューニングした小規模なモデルでも対応できる可能性が高いでしょう。GPT-3.5 に切り替えれば、トークン処理を高速化できます。
パート 2:アシスタントのプロンプトの分析
次に、アシスタントのプロンプトを見てみましょう。JSON の各フィールドを埋める過程には、それぞれ異なるステップがいくつもあるようです。これらのステップは並列化できるかもしれません。
ただしここでは、テストの結果、JSON に含まれる推論ステップを分けると応答の品質が下がったと仮定します。そのため、別の方法を検討します。
GPT-4 の代わりに、ファインチューニングした GPT-3.5 を使えるでしょうか。 可能性はありますが、一般に、回答の形式や内容が決まっていない場合は、幅広いケースに対応できる GPT-4 にアシスタントの応答を任せるのが適切です。一方、個々の推論ステップを見ると、すべてに GPT-4 相当の推論能力が必要とは限りません。各ステップで行うことは明確で範囲も限られているため、ファインチューニングの有力な候補です。
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
}ここでは 2 つの選択肢を比較する必要があります。1 回のリクエストで GPT-4 にすべてを生成させるか、それともリクエストを 2 回に分けて順番に実行し、最終応答以外を GPT-3.5 に任せるかです。2 つの原則の間にトレードオフがあります。前者はリクエスト数を減らせますが、後者はトークン処理を高速化できる可能性があります。
多くの最適化と同様に、どちらが適切かは条件によって変わります。たとえば、次の点を考慮します。
responseフィールドとそれ以外のフィールドに含まれるトークン数の比率- 大半のフィールドの処理が速くなることで、平均してどれだけレイテンシが短くなるか
- リクエストが 1 回から 2 回になることで、平均してどれだけレイテンシが長くなるか
結論はケースによって異なるため、本番環境の実例を使ってテストするのが最も確実です。ここではテストの結果、プロンプトを 2 つに分けてトークン処理を高速化する方が有利だったと仮定します。
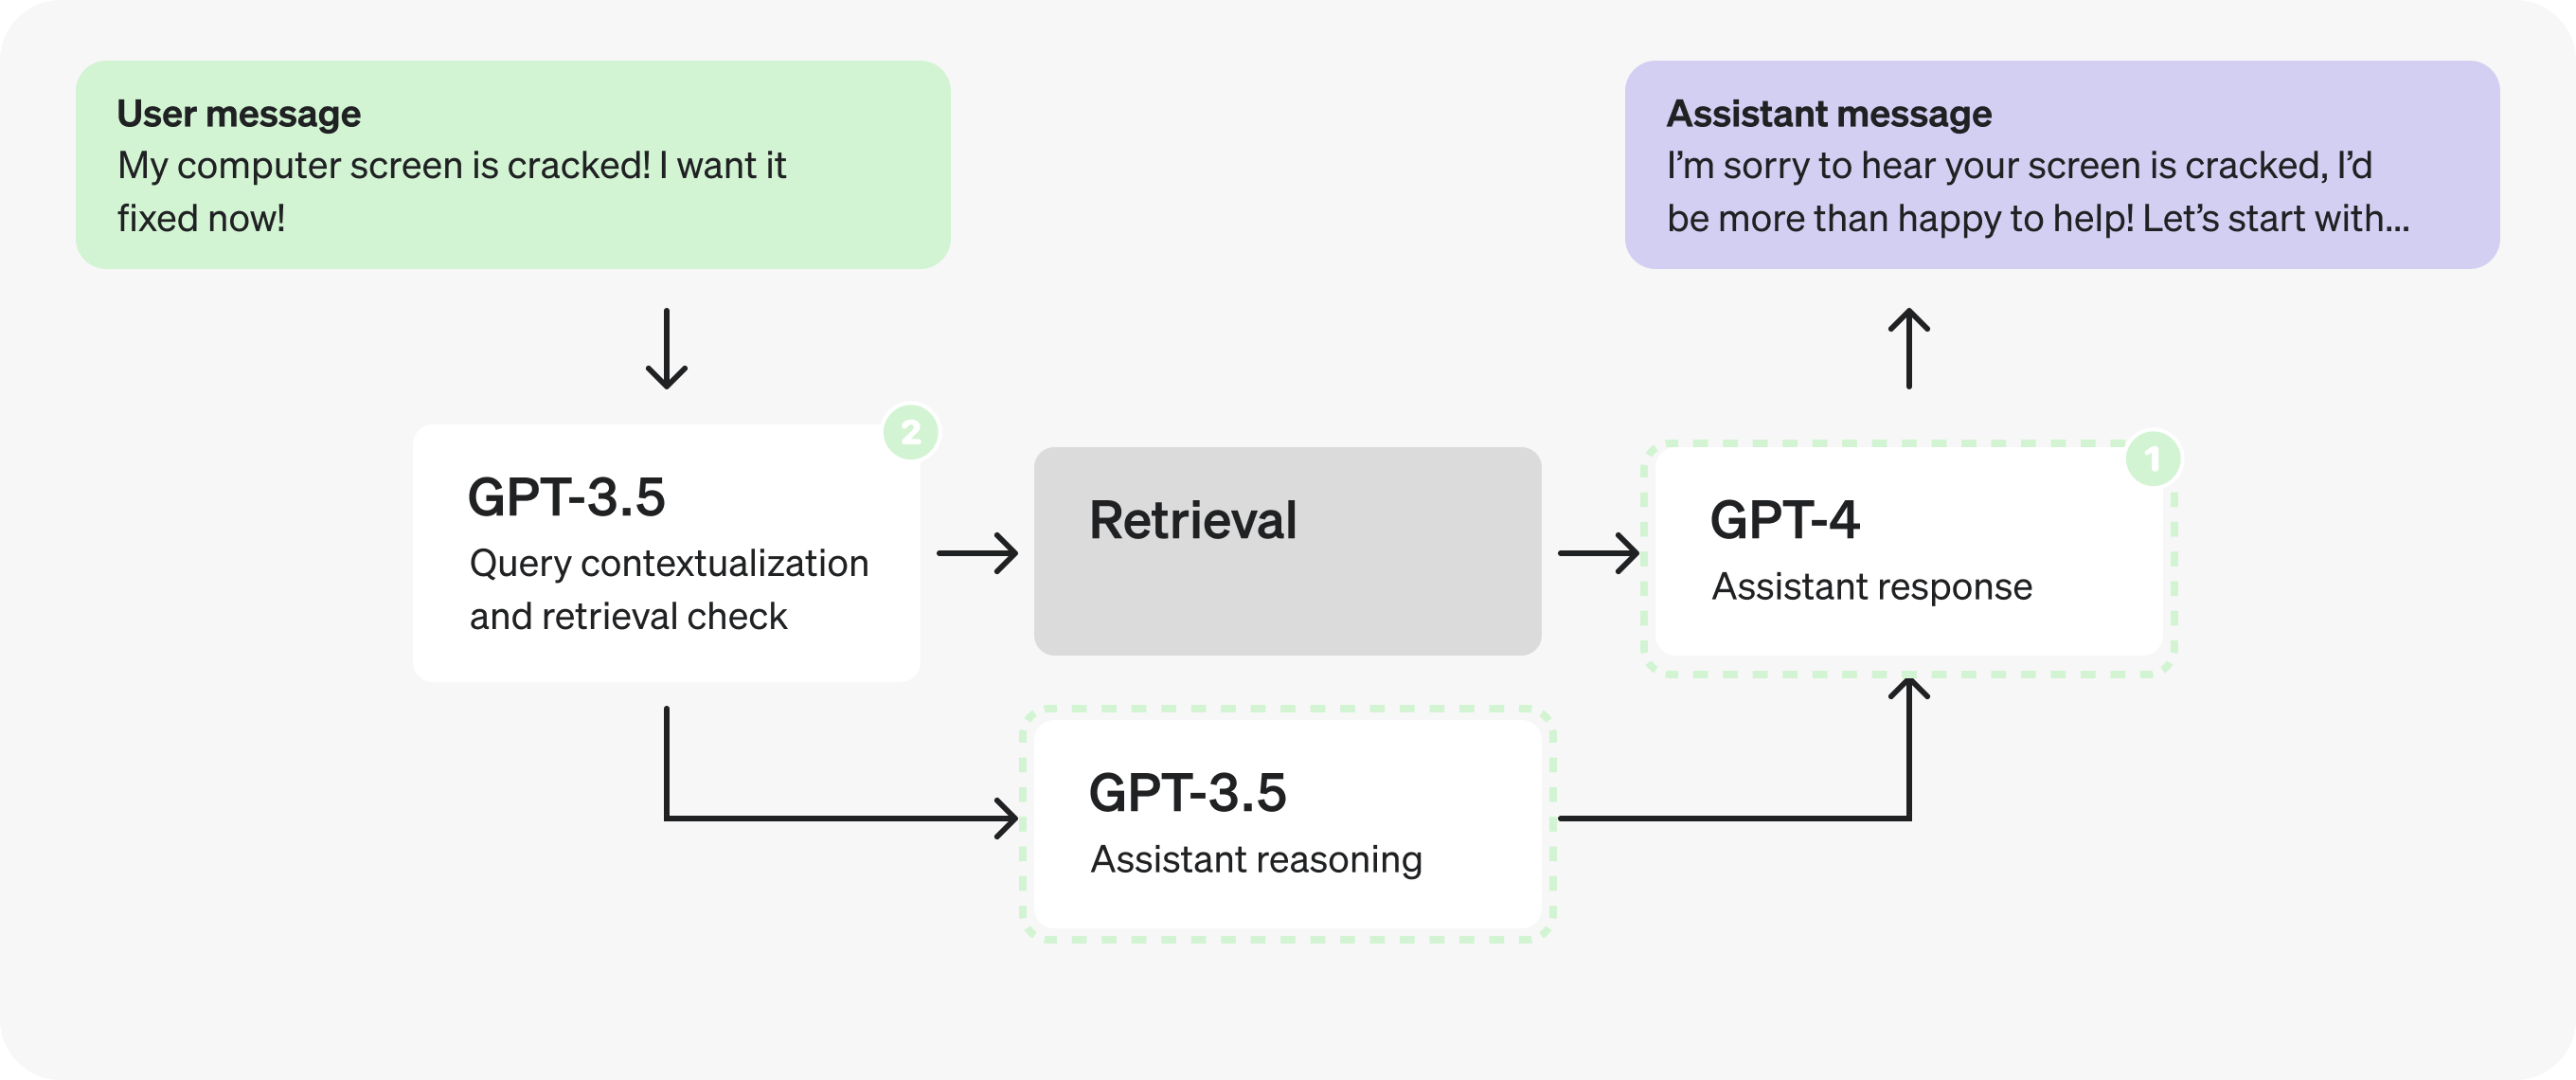
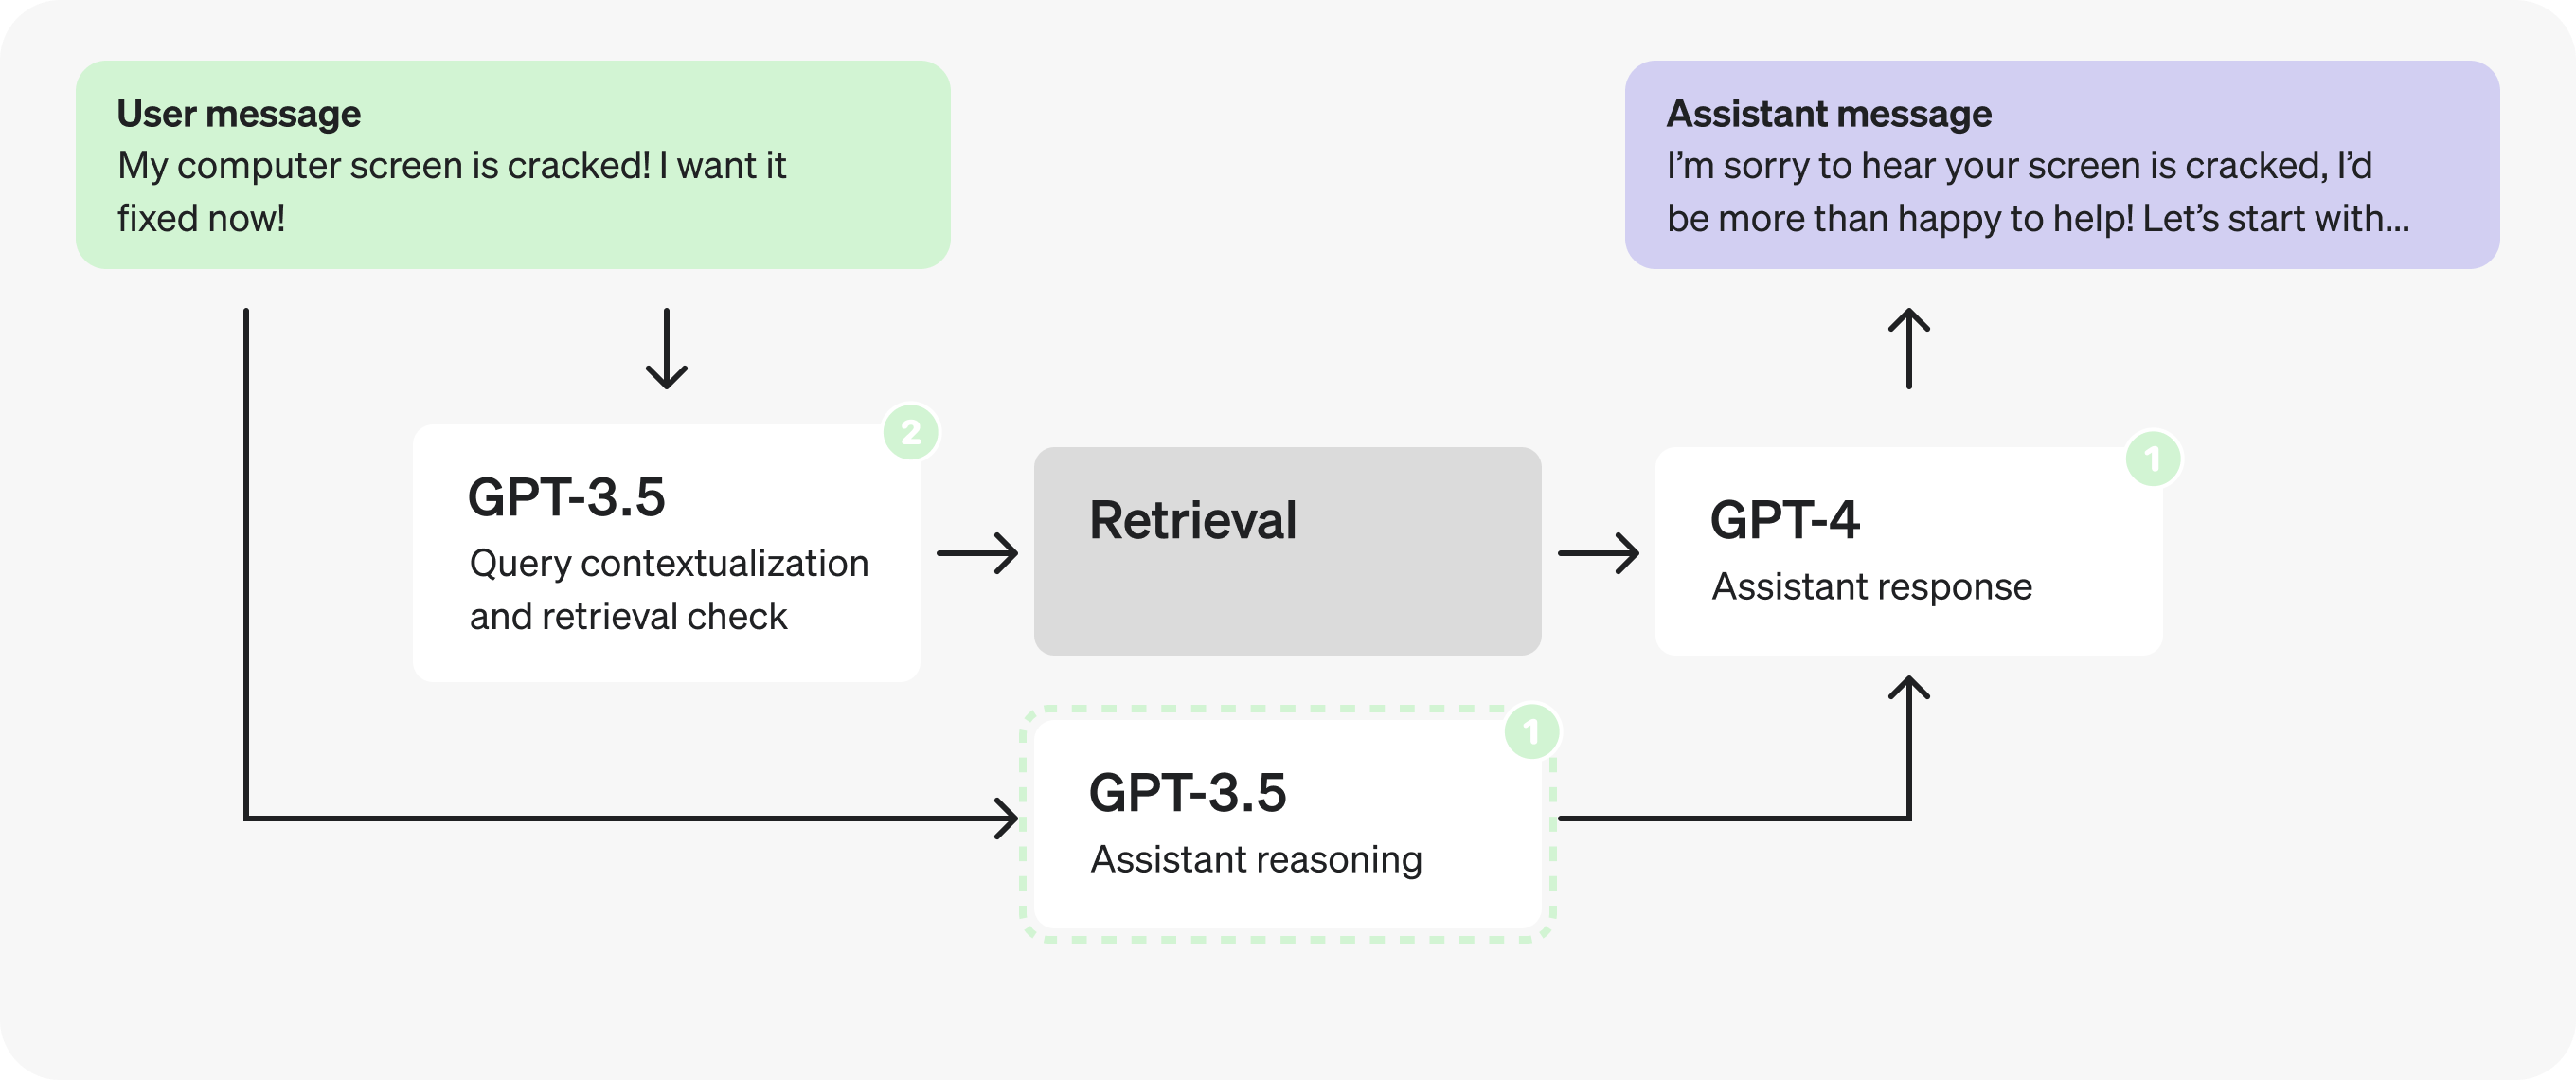
注:response と enough_information_in_context は 2 つ目のプロンプトにまとめます。こうすれば、検索で取得したコンテキストを両方のプロンプトに渡さずに済みます。
推論用のプロンプトが検索で取得したコンテキストに依存しなくなったので、処理を並列化し、検索用のプロンプトと同時に実行できます。
パート 3:構造化出力の最適化
推論用のプロンプトをもう一度見てみましょう。
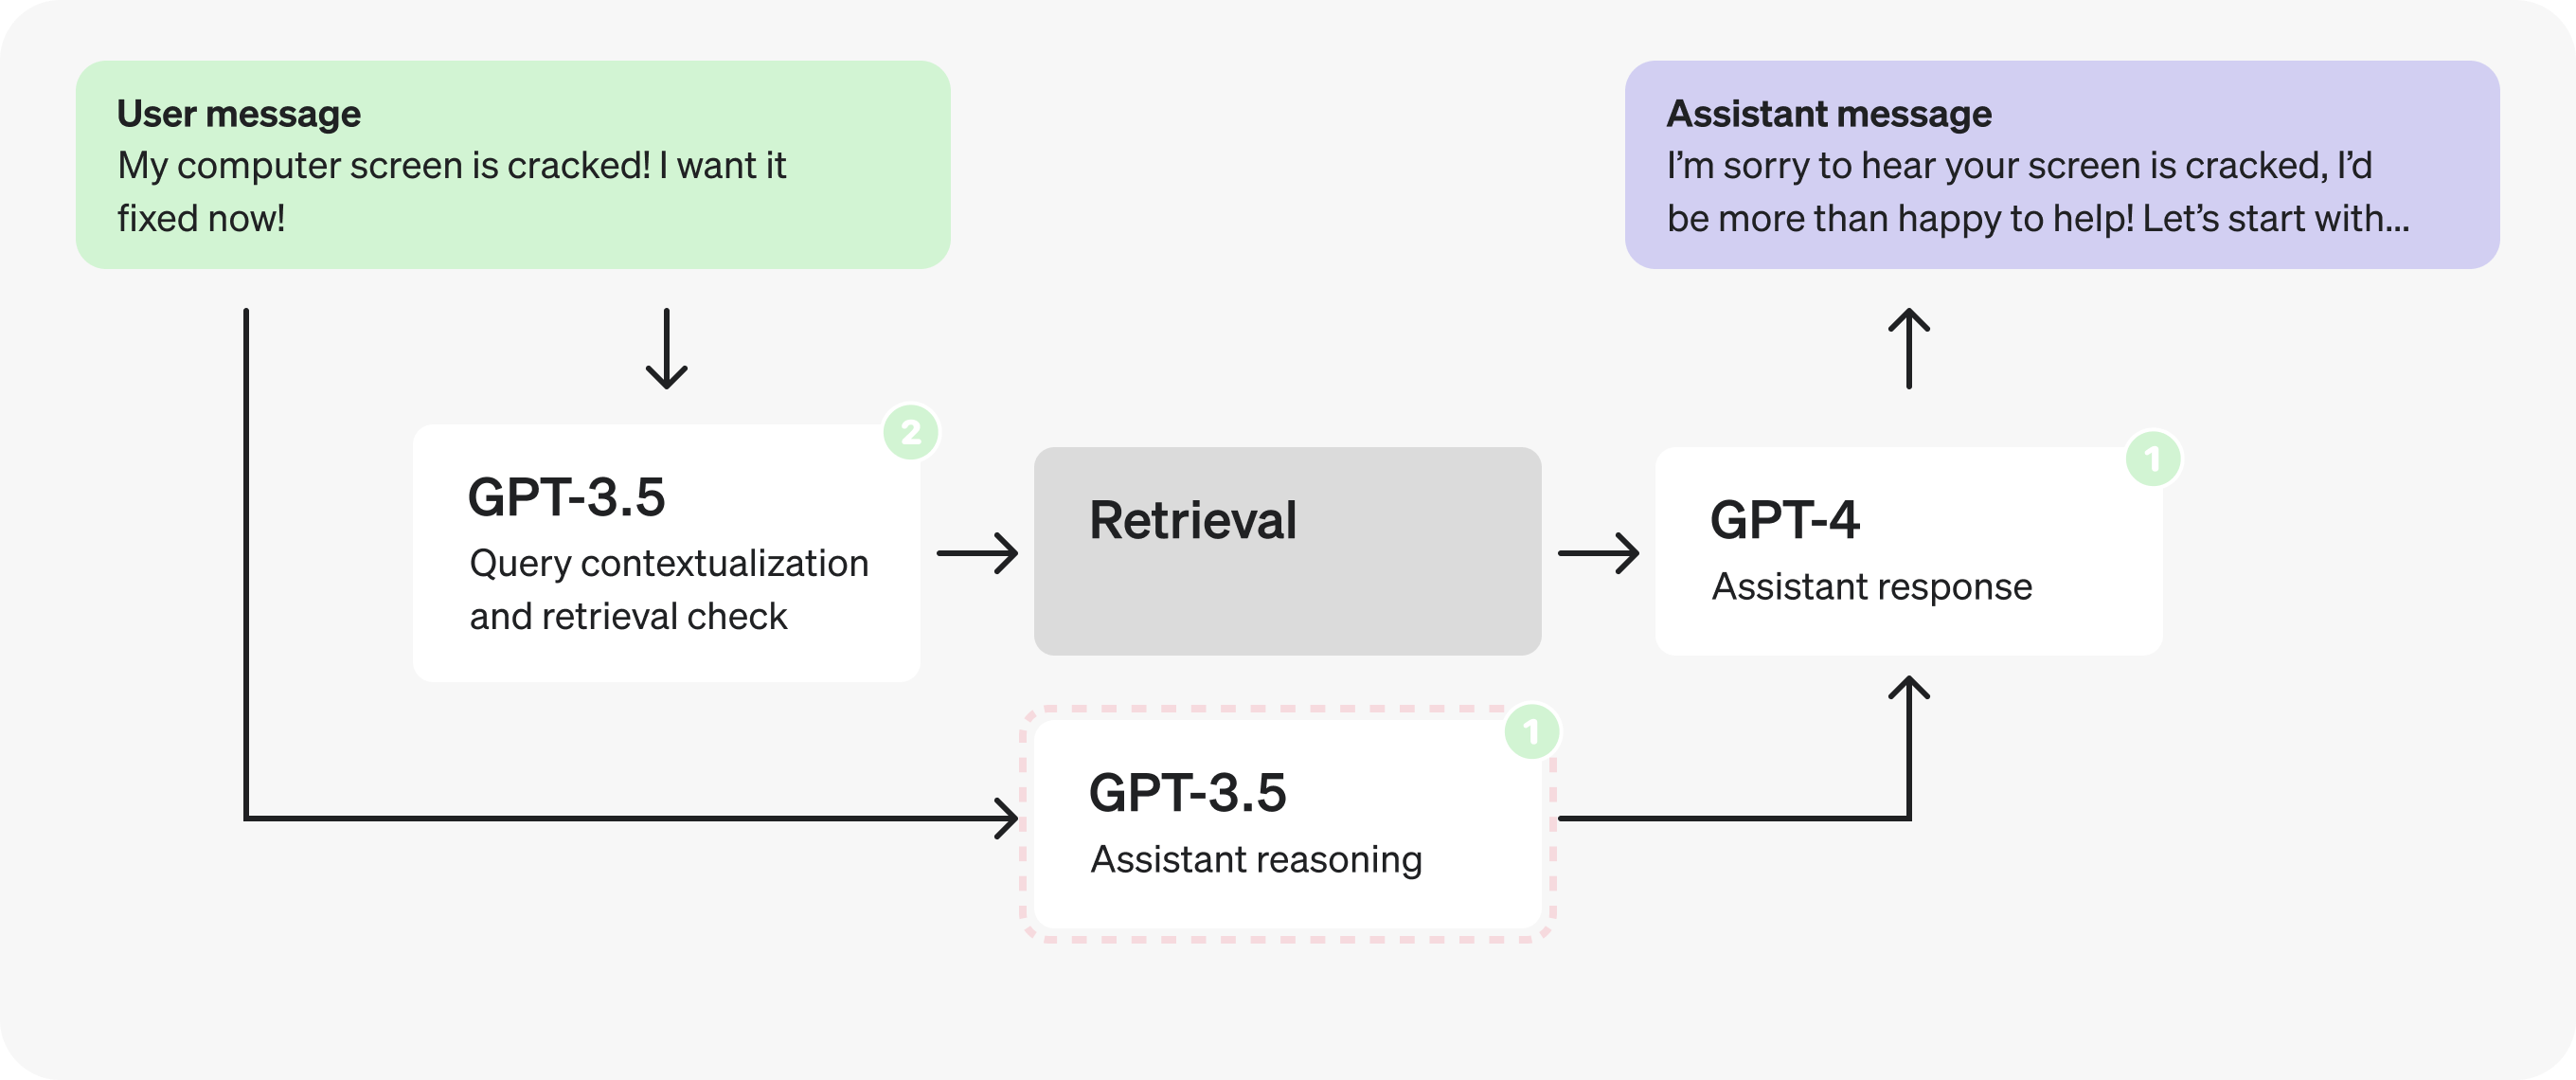
推論結果を格納する JSON を詳しく見ると、フィールド名自体がかなり長いことがわかります。
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
}フィールド名を短くして説明をコメントに移せば、出力トークン数を減らせます。
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
}
この小さな変更で、出力トークンが 19 個減りました。GPT-3.5 では数ミリ秒の短縮にとどまるかもしれませんが、GPT-4 では最大 1 秒ほど短縮できる可能性があります。
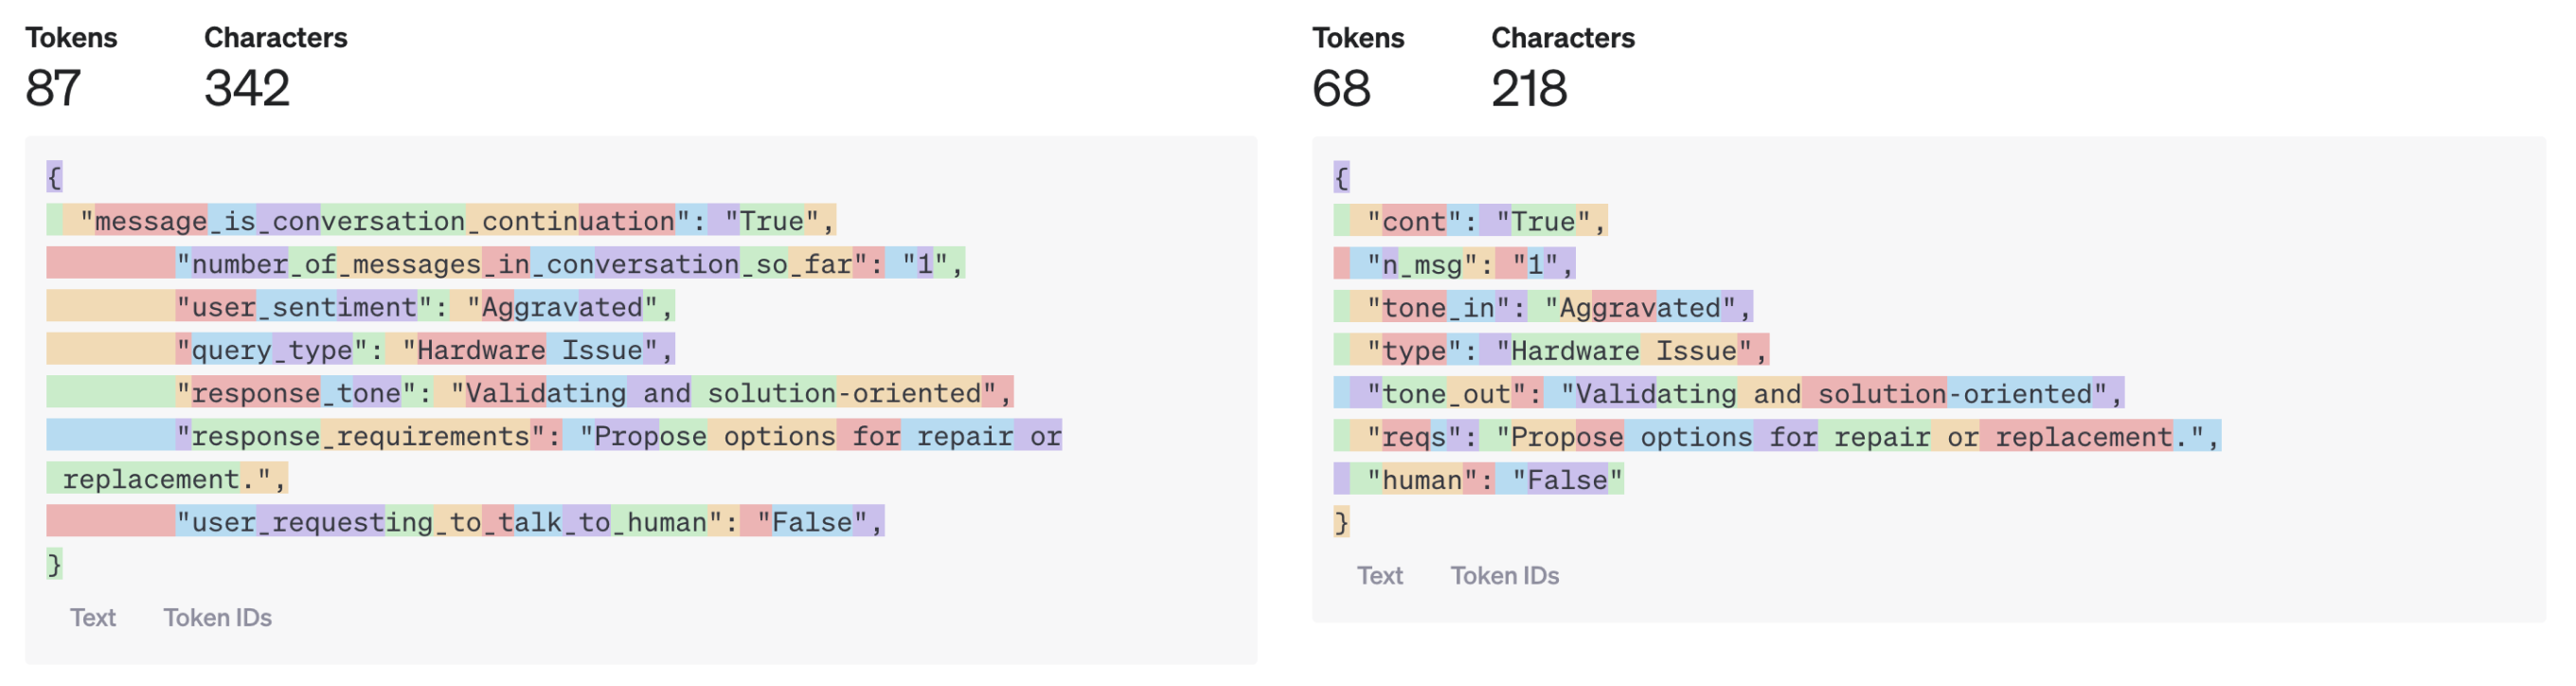
モデルの出力が長くなれば、この変更の効果もかなり大きくなると考えられます。
さらに、JSON のフィールド名を 1 文字にしたり、すべての値を配列に入れたりする方法もあります。ただし、そこまで短くすると応答の品質が下がり始める可能性があります。この場合も、判断するにはテストが最も確実です。
例のまとめ
カスタマーサービスボットの例で行った最適化を振り返ります。
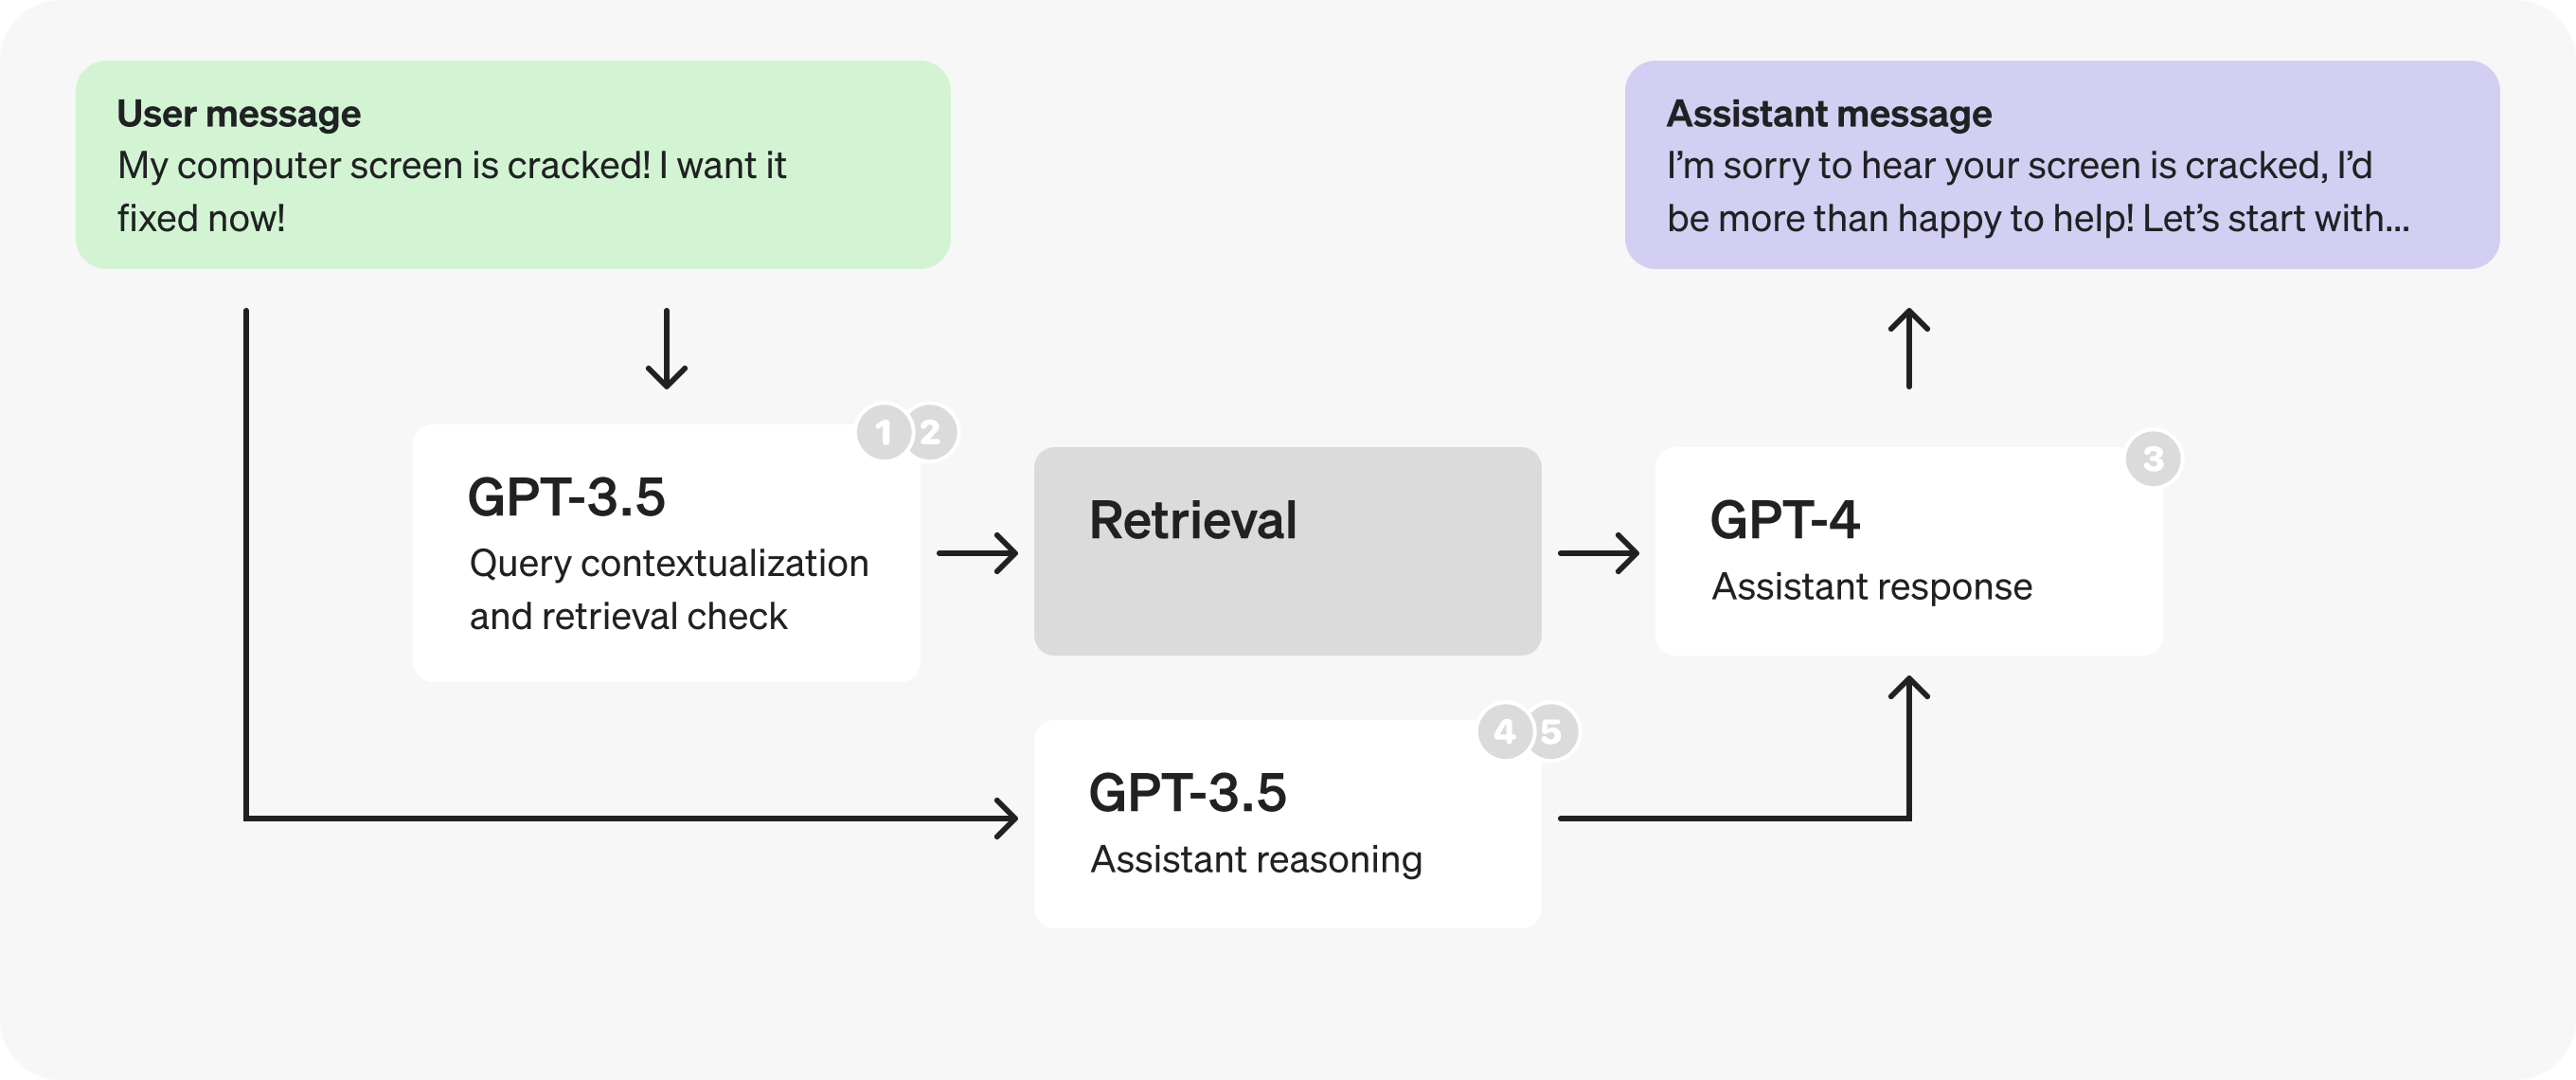
- クエリへのコンテキストの補完とリアルタイム検索の要否判定をひとまとめにして、リクエスト数を減らしました。
- 新しいプロンプトでは、より小規模でファインチューニング済みの GPT-3.5 に切り替えて、トークン処理を高速化しました。
- アシスタントのプロンプトを 2 つに分け、推論にはより小規模でファインチューニング済みの GPT-3.5 を使うことで、ここでもトークン処理を高速化しました。
- 並列化により、リアルタイム検索の要否判定と推論を同時に実行しました。
- 推論用のフィールド名を短くし、コメントをプロンプト内に移して、出力トークン数を減らしました。