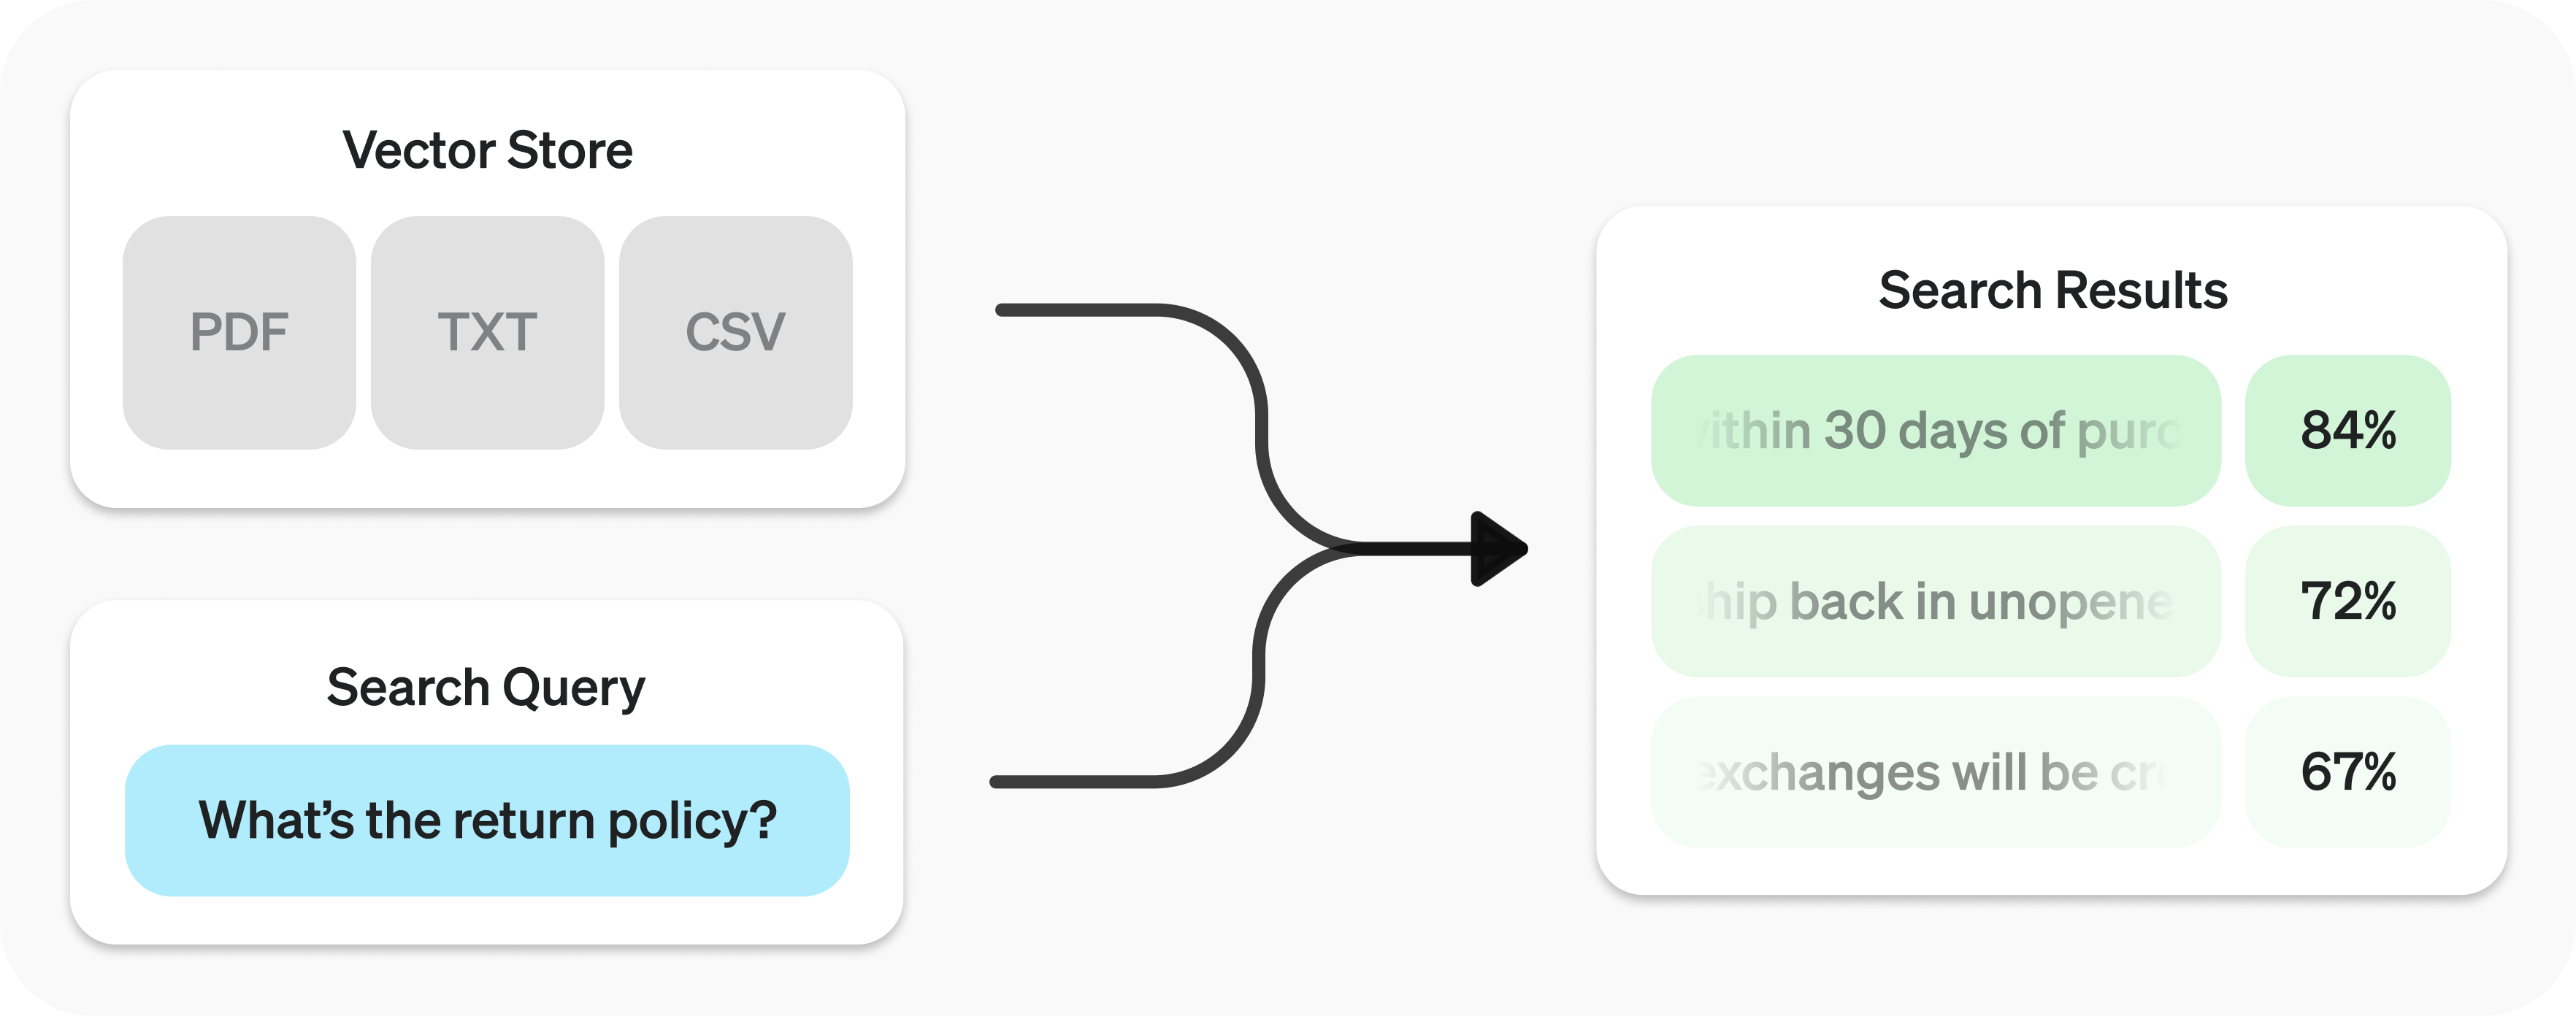
Retrieval API を使うと、自分のデータに対してセマンティック検索
Retrieval API は、データのインデックスとして機能するベクトルストア
ベクトルストアを作成 し、ファイルをアップロードします。
1
2
3
4
5
6
7
8
9
10
11
12
13 import OpenAI from "openai";
const client = new OpenAI();
const vector_store = await client.vectorStores.create({
// Create vector store
name: "Support FAQ",
});
await client.vectorStores.files.uploadAndPoll(
vector_store.id,
// Upload file
fs.createReadStream("customer_policies.txt")
); 1
2
3
4
5
6
7
8
9
10
11
12 from openai import OpenAI
client = OpenAI()
vector_store = client.vector_stores.create( # Create vector store
name = "Support FAQ" ,
)
client.vector_stores.files.upload_and_poll( # Upload file
vector_store_id = vector_store.id,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{Name: openai.String("Support FAQ")})
if err != nil {
panic(err)
}
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
_, err = client.VectorStores.Files.UploadAndPoll(context.Background(), vectorStore.ID, openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.VectorStoreCreateParams;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
var store =
client.vectorStores().create(VectorStoreCreateParams.builder().name("Support FAQ").build());
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
store.id(),
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(file.id(), FileRetrieveParams.builder().vectorStoreId(store.id()).build());
}
System.out.println(store.id()); 1
2
3
4
5
6
7
8
9
10
11
12
13 require "openai"
require "pathname"
client = OpenAI::Client.new
store = client.vector_stores.create(name: "Support FAQ")
file = client.vector_stores.files.upload_and_poll(
store.id,
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{file.status}" unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(store.id) 検索クエリを送信 し、関連する結果を取得します。
1
2
3
4
5 const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6 user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search("vs_123", query: "What is the return policy?")
puts(results.data&.first&.content) セマンティック検索 は、ベクトル埋め込み を使って、クエリと意味的に関連する結果を見つける手法です。クエリと共通するキーワードが少ない、あるいはまったくないために従来の検索手法では見逃しやすい結果も見つけられます。
たとえば、"When did we go to the moon?"(人類が月に行ったのはいつですか?)というクエリで得られる結果を見てみましょう。
テキスト
キーワードの類似度
意味の類似度
初の月面着陸は 1969 年 7 月でした。
0%
65%
初めて月面に降り立ったのはニール・アームストロング氏です。
27%
43%
月餅を食べたら、おいしかったです。
40%
28%
(英語の原文でのキーワードの類似度には積集合と和集合の比 を、意味の類似度にはコサイン類似度 を使っています。埋め込みモデルは text-embedding-3-small です。)
最も関連性の高い結果の原文には、検索クエリに含まれる単語が一つもありません。このように単語が一致しなくても検索できるため、セマンティック検索は規模を問わずナレッジベースの検索に有効です。
セマンティック検索にはベクトルストア を使います。ベクトルストアについては、このガイドの後半で詳しく説明します。ここでは、セマンティック検索の具体的な使い方を説明します。
search 関数で query を自然言語で指定すると、ベクトルストアを検索できます。結果はリストで返され、各結果には該当するチャンク、類似度スコア、元のファイルが含まれます。
1
2
3 const results = await client.vectorStores.search(vector_store.id, {
query: "How many woodchucks are allowed per passenger?",
}); 1
2
3
4 results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = "How many woodchucks are allowed per passenger?" ,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("How many woodchucks are allowed per passenger?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder()
.query("How many woodchucks are allowed per passenger?")
.build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "How many woodchucks are allowed per passenger?"
)
puts(results.data&.first&.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42 {
"object" : "vector_store.search_results.page" ,
"search_query" : "How many woodchucks are allowed per passenger?" ,
"data" : [
{
"file_id" : "file-12345" ,
"filename" : "woodchuck_policy.txt" ,
"score" : 0.85 ,
"attributes" : {
"region" : "North America" ,
"author" : "Wildlife Department"
},
"content" : [
{
"type" : "text" ,
"text" : "According to the latest regulations, each passenger is allowed to carry up to two woodchucks."
},
{
"type" : "text" ,
"text" : "Ensure that the woodchucks are properly contained during transport."
}
]
},
{
"file_id" : "file-67890" ,
"filename" : "transport_guidelines.txt" ,
"score" : 0.75 ,
"attributes" : {
"region" : "North America" ,
"author" : "Transport Authority"
},
"content" : [
{
"type" : "text" ,
"text" : "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks."
}
]
}
],
"has_more" : false ,
"next_page" : null
} デフォルトでは 1 回のレスポンスに含まれる結果は最大 10 件ですが、max_num_results パラメーターで上限を 50 件まで設定できます。
クエリの表現によって検索精度が変わるため、検索に適した表現に自動で書き換える設定を用意しています。rewrite_query=true を指定して search を実行すると、この機能が有効になります。
書き換え後のクエリは、検索結果の search_query フィールドで確認できます。
元のクエリ 書き換え後
本社ビルの高さを知りたいです。
本社ビル 高さ
危険物の輸送にはどのような安全規則が適用されますか?
危険物 安全規則
サービスの問題について苦情を申し立てるにはどうすればよいですか?
サービス 苦情 申し立て手順
属性を使うと、特定の期間に検索対象を限定するなど、条件を指定して結果を絞り込めます。filters に条件を定義し、必要に応じて組み合わせることで、セマンティック検索を実行する前にファイルの属性に基づいて検索対象を絞り込めます。
比較フィルター は、指定した key に対応するファイルの attributes 内の値を、指定した value と比較します。複合フィルター は、複数のフィルターを and や or で組み合わせます。
1
2
3
4
5 {
"type" : "eq" | "ne" | "gt" | "gte" | "lt" | "lte" | "in" | "nin" , // comparison operators
"key" : "attributes_key" , // attributes key
"value" : "target_value" // value to compare against
} 1
2
3
4 {
"type" : "and" | "or" , // logical operators
"filters" : [ ... ]
} 以下にフィルターの例を示します。
ファイル名で絞り込む例では、カスタム属性 filename の値を照合します。ベクトルストアの各ファイルに {"filename": "example.txt"} のように明示的に設定してください。アップロードしたファイルの名前が自動で照合に使われることはありません。
Region Date range Filenames Exclude filenames Complex 地域
1
2
3
4
5 {
"type" : "eq" ,
"key" : "region" ,
"value" : "us"
} 期間
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 {
"type" : "and" ,
"filters" : [
{
"type" : "gte" ,
"key" : "date" ,
"value" : 1704067200 // unix timestamp for 2024-01-01
},
{
"type" : "lte" ,
"key" : "date" ,
"value" : 1710892800 // unix timestamp for 2024-03-20
}
]
} ファイル名
1
2
3
4
5 {
"type" : "in" ,
"key" : "filename" ,
"value" : [ "example.txt" , "example2.txt" ]
} ファイル名による除外
1
2
3
4
5 {
"type" : "nin" ,
"key" : "filename" ,
"value" : [ "draft.txt" , "internal_notes.md" ]
} 複合条件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 {
"type" : "or" ,
"filters" : [
{
"type" : "and" ,
"filters" : [
{
"type" : "or" ,
"filters" : [
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X123"
},
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X999"
}
]
},
{
"type" : "eq" ,
"key" : "confidentiality" ,
"value" : "top_secret"
}
]
},
{
"type" : "eq" ,
"key" : "language" ,
"value" : "en"
}
]
}
ファイル検索で十分に関連性の高い結果が得られない場合は、ranking_options を調整して回答の質を改善できます。たとえば、ranker に auto や default-2024-08-21 を指定し、score_threshold を 0.0 から 1.0 の範囲で設定できます。score_threshold を高くすると、関連性の高いチャンクに結果を絞れますが、有用なチャンクが除外されることもあります。ranking_options.hybrid_search を指定した場合は、hybrid_search.embedding_weight(rrf_embedding_weight)と hybrid_search.text_weight(rrf_text_weight)も調整できます。これらの重みは、逆順位融合で、埋め込みによる意味の一致とスパース検索によるキーワードの一致をそれぞれどの程度重視するかを決めます。意味の類似度を重視する場合は前者を、テキストに共通する語句を重視する場合は後者を大きくしてください。少なくとも一方の重みを 0 より大きくする必要があります。
ベクトルストアは、Retrieval API とファイル検索 ツールでセマンティック検索を行うためのコンテナです。ベクトルストアにファイルを追加すると、自動的にチャンクに分割され、各チャンクの埋め込みが生成されてインデックスに登録されます。
ベクトルストアには vector_store_file オブジェクトが格納されます。それぞれの元となるのが file オブジェクトです。
オブジェクトの種類
説明
fileFiles API を通じてアップロードしたコンテンツを表します。ベクトルストアでよく使われるほか、ファインチューニングなどにも使われます。
vector_store検索対象のファイルを格納するコンテナです。
vector_store.fileチャンク分割と埋め込みの生成を終えた file を、特定の vector_store に関連付けた状態で表すラッパー型です。attributes マップを含みます。
料金は、すべてのベクトルストアの合計ストレージ使用量に基づきます。使用量は、ファイルの解析で得られたチャンクと、それぞれに対応する埋め込みのサイズで決まります。
ストレージ使用量
料金
1 GB まで(全ストアの合計)
無料
1 GB を超える分
1 GB あたり 1 日 0.10 ドル
Create Retrieve Update Delete List 作成
1
2
3
4 await client.vectorStores.create({
name: "Support FAQ",
file_ids: ["file_123"],
}); 1
2
3
4 client.vector_stores.create(
name = "Support FAQ" ,
file_ids = [ "file_123" ]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{
Name: openai.String("Support FAQ"),
FileIDs: []string{"file_123"},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreCreateParams;
String fileId = "file_123";
var store =
client
.vectorStores()
.create(
VectorStoreCreateParams.builder().name("Support FAQ").addFileId(fileId).build());
System.out.println(store.id()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.create(
name: "Support FAQ",
file_ids: ["file_123"]
)
puts(store.id) 取得
1 await client.vectorStores.retrieve("vs_123"); 1
2
3 client.vector_stores.retrieve(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Get(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().retrieve(vectorStoreId).id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.retrieve("vs_123")
puts(store.id) 更新
1
2
3 await client.vectorStores.update("vs_123", {
name: "Support FAQ Updated",
}); 1
2
3
4 client.vector_stores.update(
vector_store_id = "vs_123" ,
name = "Support FAQ Updated"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
Name: openai.String("Support FAQ Updated"),
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.Name)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder().name("Updated knowledge base").build());
System.out.println(store.name()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update("vs_123", name: "Updated knowledge base")
puts(store.name) 削除
1 await client.vectorStores.delete("vs_123"); 1
2
3 client.vector_stores.delete(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Delete(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().delete(vectorStoreId).deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.delete("vs_123")
puts(deleted.deleted) 一覧
await client.vectorStores.list(); client.vector_stores.list() package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStores, err := client.VectorStores.List(context.Background(), openai.VectorStoreListParams{})
if err != nil {
panic(err)
}
fmt.Println(vectorStores.Data)
} import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
System.out.println(client.vectorStores().list().data()); require "openai"
client = OpenAI::Client.new
stores = client.vector_stores.list(limit: 10)
puts((stores.data || []).length)
一部の操作は非同期で実行され、完了までに時間がかかることがあります。たとえば、create で vector_store.file を作成する場合がこれにあたります。操作の完了を待ってから次の処理に進むには、create_and_poll などのヘルパー関数を使ってください。ステータスを個別に確認することもできます。ベクトルストアからのファイル削除には結果整合性が適用されるため、削除後もしばらくはそのファイルの内容が検索結果に含まれることがあります。
ファイル追加のレート制限は、ベクトルストア ID ごとに適用されます。/vector_stores/{vector_store_id}/files/vector_stores/{vector_store_id}/file_batches
Create Upload Retrieve Update Delete List 作成
1
2
3 await client.vectorStores.files.createAndPoll("vs_123", {
file_id: "file_123",
}); 1
2
3
4 client.vector_stores.files.create_and_poll(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileNewParams{
FileID: "file_123",
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "vs_123";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(vectorStoreId, FileCreateParams.builder().fileId(fileId).build());
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create_and_poll("vs_123", file_id: "file_123")
unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
raise "File indexing did not complete: #{file.last_error&.message || file.status}"
end
puts(file.id) アップロード
1
2
3
4 await client.vectorStores.files.uploadAndPoll(
"vs_123",
fs.createReadStream("customer_policies.txt")
); 1
2
3
4 client.vector_stores.files.upload_and_poll(
vector_store_id = "vs_123" ,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
result, err := client.VectorStores.Files.UploadAndPoll(context.Background(), "vs_123", openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(result.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
String vectorStoreId = "vs_123";
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(
file.id(), FileRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9
10
11
12 require "openai"
require "pathname"
client = OpenAI::Client.new
vector_store_file = client.vector_stores.files.upload_and_poll(
"vs_123",
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{vector_store_file.status}" unless vector_store_file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(vector_store_file.id) 取得
1
2
3 await client.vectorStores.files.retrieve("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.retrieve(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Get(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.retrieve(
fileId,
com.openai.models.vectorstores.files.FileRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.retrieve("file_123", vector_store_id: "vs_123")
puts(file.id) 更新
1
2
3
4 await client.vectorStores.files.update("file_123", {
vector_store_id: "vs_123",
attributes: { key: "value" },
}); 1
2
3
4
5 client.vector_stores.files.update(
vector_store_id = "vs_123" ,
file_id = "file_123" ,
attributes = { "key" : "value" }
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Update(context.Background(), "vs_123", "file_123", openai.VectorStoreFileUpdateParams{
Attributes: map[string]openai.VectorStoreFileUpdateParamsAttributeUnion{
"key": {OfString: openai.String("value")},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileUpdateParams;
String fileId = "file_123";
String vectorStoreId = "vs_123";
var file =
client
.vectorStores()
.files()
.update(
fileId,
FileUpdateParams.builder()
.vectorStoreId(vectorStoreId)
.attributes(
FileUpdateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.update("file_123", vector_store_id: "vs_123", attributes: { category: "policy" })
puts(file.id) 削除
1
2
3 await client.vectorStores.files.delete("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.delete(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Files.Delete(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.delete(
fileId,
com.openai.models.vectorstores.files.FileDeleteParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.files.delete("file_123", vector_store_id: "vs_123")
puts(deleted.deleted) 一覧
1 await client.vectorStores.files.list("vs_123"); 1
2
3 client.vector_stores.files.list(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.Files.List(context.Background(), "vs_123", openai.VectorStoreFileListParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().files().list(vectorStoreId).data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.files.list("vs_123")
puts((files.data || []).length)
作成
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 await client.vectorStores.fileBatches.createAndPoll("vs_123", {
files: [
{
file_id: "file_123",
attributes: { department: "finance" },
},
{
file_id: "file_456",
chunking_strategy: {
type: "static",
static: {
max_chunk_size_tokens: 1200,
chunk_overlap_tokens: 200,
},
},
},
],
}); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 client.vector_stores.file_batches.create_and_poll(
vector_store_id = "vs_123" ,
files = [
{
"file_id" : "file_123" ,
"attributes" : { "department" : "finance" }
},
{
"file_id" : "file_456" ,
"chunking_strategy" : {
"type" : "static" ,
"static" : {
"max_chunk_size_tokens" : 1200 ,
"chunk_overlap_tokens" : 200
}
}
}
]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileBatchNewParams{
Files: []openai.VectorStoreFileBatchNewParamsFile{
{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileBatchNewParamsFileAttributeUnion{
"department": {OfString: openai.String("finance")},
},
},
{
FileID: "file_456",
ChunkingStrategy: openai.FileChunkingStrategyParamUnion{OfStatic: &openai.StaticFileChunkingStrategyObjectParam{
Static: openai.StaticFileChunkingStrategyParam{MaxChunkSizeTokens: 1200, ChunkOverlapTokens: 200},
}},
},
},
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.StaticFileChunkingStrategy;
import com.openai.models.vectorstores.filebatches.FileBatchCreateParams;
import com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams;
import com.openai.models.vectorstores.filebatches.VectorStoreFileBatch;
String vectorStoreId = "vs_123";
String fileId = "file_123";
String fileId2 = "file_456";
var first =
FileBatchCreateParams.File.builder()
.fileId(fileId)
.attributes(
FileBatchCreateParams.File.Attributes.builder()
.putAdditionalProperty("department", JsonValue.from("finance"))
.build())
.build();
var second =
FileBatchCreateParams.File.builder()
.fileId(fileId2)
.staticChunkingStrategy(
StaticFileChunkingStrategy.builder()
.maxChunkSizeTokens(1200)
.chunkOverlapTokens(200)
.build())
.build();
var batch =
client
.vectorStores()
.fileBatches()
.create(
vectorStoreId,
FileBatchCreateParams.builder().addFile(first).addFile(second).build());
while (batch.status().equals(VectorStoreFileBatch.Status.IN_PROGRESS)) {
Thread.sleep(1000);
batch =
client
.vectorStores()
.fileBatches()
.retrieve(
batch.id(),
FileBatchRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(batch.status()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.create_and_poll(
"vs_123",
files: [
{
file_id: "file_123",
attributes: { department: "finance" }
},
{
file_id: "file_456",
chunking_strategy: {
type: :static,
static: {
max_chunk_size_tokens: 1_200,
chunk_overlap_tokens: 200
}
}
}
],
timeout: 600
)
raise "File ingestion ended with status: #{batch.status}" unless batch.status == OpenAI::VectorStores::VectorStoreFileBatch::Status::COMPLETED
raise "File ingestion failed for #{batch.file_counts.failed} file(s)" if batch.file_counts.failed.positive?
# Live validation of per-file batches returned default chunking despite overrides.
file = client.vector_stores.files.retrieve("file_456", vector_store_id: "vs_123")
strategy = file.chunking_strategy
unless strategy.is_a?(OpenAI::StaticFileChunkingStrategyObject) &&
strategy.static.max_chunk_size_tokens == 1_200 &&
strategy.static.chunk_overlap_tokens == 200
raise "Requested chunking was not applied to #{file.id}: #{strategy.to_json}"
end
puts(batch.status) 取得
1
2
3 await client.vectorStores.fileBatches.retrieve("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.retrieve(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Get(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.retrieve(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.retrieve(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) キャンセル
1
2
3 await client.vectorStores.fileBatches.cancel("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.cancel(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Cancel(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.Status)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.cancel(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchCancelParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.cancel(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 一覧
1
2
3 await client.vectorStores.fileBatches.listFiles("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.list_files(
"vsfb_123" ,
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.FileBatches.ListFiles(context.Background(), "vs_123", "vsfb_123", openai.VectorStoreFileBatchListFilesParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.listFiles(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchListFilesParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.file_batches.list_files(
"vsfb_123",
vector_store_id: "vs_123"
)
puts((files.data || []).length)
バッチを作成する方法は 2 通りあります。すべてのファイルに同じ設定を適用する場合は file_ids を渡し、必要に応じて attributes と chunking_strategy の一方または両方を指定します。ファイルごとに設定を変える場合は、files 配列でファイルごとのオブジェクトを渡します。各オブジェクトには file_id を含め、必要に応じて attributes と chunking_strategy を指定します。この 2 つの方法は併用できません。
単一のベクトルストアにファイルを取り込む際のスループットを高めるには、可能な限りバッチ作成を使うことをおすすめします。バッチでは 1 回のリクエストで最大 500 ファイルを追加できます。通常、ファイルごとに作成リクエストを多数送る場合よりも競合が減り、処理全体にかかる時間が短くなります。
各 vector_store.file には、属性値を格納する辞書 attributes を関連付けられます。セマンティック検索 で属性による絞り込み を行う際に、この辞書の値を参照できます。辞書には最大 16 個のキーを設定でき、各キーの長さは最大 256 文字です。
1
2
3
4
5
6
7
8 await client.vectorStores.files.create("<vector_store_id>", {
file_id: "file_123",
attributes: {
region: "US",
category: "Marketing",
date: 1672531200, // Jan 1, 2023
},
}); 1
2
3
4
5
6
7
8
9 client.vector_stores.files.create(
vector_store_id = "<vector_store_id>" ,
file_id = "file_123" ,
attributes = {
"region" : "US" ,
"category" : "Marketing" ,
"date" : 1672531200 # Jan 1, 2023
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.New(context.Background(), "<vector_store_id>", openai.VectorStoreFileNewParams{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileNewParamsAttributeUnion{
"region": {OfString: openai.String("US")},
"category": {OfString: openai.String("Marketing")},
"date": {OfFloat: openai.Float(1672531200)},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "<vector_store_id>";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
FileCreateParams.builder()
.fileId(fileId)
.attributes(
FileCreateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create("<vector_store_id>", file_id: "file_123", attributes: { category: "policy" })
puts(file.id) vector_store オブジェクトには、expires_after で有効期限ポリシーを設定できます。ベクトルストアの有効期限が切れると、関連付けられたすべての vector_store.file オブジェクトが削除され、以降はそれらに対する料金は発生しません。
1
2
3
4
5
6 await client.vectorStores.update("vs_123", {
expires_after: {
anchor: "last_active_at",
days: 7,
},
}); 1
2
3
4
5
6
7 client.vector_stores.update(
vector_store_id = "vs_123" ,
expires_after = {
"anchor" : "last_active_at" ,
"days" : 7
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
ExpiresAfter: openai.VectorStoreUpdateParamsExpiresAfter{Days: 7},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ExpiresAfter)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder()
.expiresAfter(
VectorStoreUpdateParams.ExpiresAfter.builder()
.anchor(JsonValue.from("last_active_at"))
.days(7)
.build())
.build());
System.out.println(store.expiresAfter().orElseThrow()); 1
2
3
4
5
6
7
8
9
10
11 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update(
"vs_123",
expires_after: {
anchor: :last_active_at,
days: 7
}
)
puts(store.expires_after) ファイルサイズの上限は 512 MB です。各ファイルのトークン数は 5,000,000 以下にしてください。トークン数はファイルを追加するときに自動で計算されます。
デフォルトでは max_chunk_size_tokens は 800、chunk_overlap_tokens は 400 に設定されています。各ファイルは 800 トークンずつのチャンクに分割され、隣り合うチャンクが 400 トークンずつ重なる形でインデックスに登録されます。
分割方法は、ベクトルストアにファイルを追加するときに chunking_strategy
max_chunk_size_tokens は 100 以上 4096 以下である必要があります。chunk_overlap_tokens は 0 以上である必要があり、max_chunk_size_tokens / 2 を超えないようにしてください。
対応ファイル形式 MIME タイプが text/ で始まる場合、文字エンコーディングは utf-8、utf-16、ascii のいずれかである必要があります。
ファイル形式
MIME タイプ
.ctext/x-c
.cpptext/x-c++
.cstext/x-csharp
.csstext/css
.docapplication/msword
.docxapplication/vnd.openxmlformats-officedocument.wordprocessingml.document
.gotext/x-golang
.htmltext/html
.javatext/x-java
.jstext/javascript
.jsonapplication/json
.mdtext/markdown
.pdfapplication/pdf
.phptext/x-php
.pptxapplication/vnd.openxmlformats-officedocument.presentationml.presentation
.pytext/x-python
.pytext/x-script.python
.rbtext/x-ruby
.shapplication/x-sh
.textext/x-tex
.tsapplication/typescript
.txttext/plain
検索を実行した後は、その結果をもとに回答を生成できます。検索結果と元のクエリを OpenAI のモデルに渡すと、検索結果を根拠とした回答が得られます。
1
2
3
4
5
6
7
8
9 import OpenAI from "openai";
const client = new OpenAI();
const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6
7
8
9
10 from openai import OpenAI
client = OpenAI()
user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "What is the return policy?"
)
puts(results.data) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 const formattedResults = formatResults(results.data);
// Join the text content of all results
const textSources = results.data
.map((result) => result.content.map((c) => c.text).join("\n"))
.join("\n");
const completion = await client.chat.completions.create({
model: "gpt-6-astra",
messages: [
{
role: "developer",
content:
"Produce a concise answer to the query based on the provided sources.",
},
{
role: "user",
content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`,
},
],
});
console.log(completion.choices[0].message.content); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 # Use results and user_query from the preceding search step.
formatted_results = format_results(results.data)
" \n " .join( " \n " .join(c.text for c in result.content) for result in results.data)
completion = client.chat.completions.create(
model = "gpt-6-astra" ,
messages = [
{
"role" : "developer" ,
"content" : "Produce a concise answer to the query based on the provided sources." ,
},
{
"role" : "user" ,
"content" : f "Sources: { formatted_results }\n\n Query: ' { user_query } '" ,
},
],
)
print (completion.choices[ 0 ].message.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46 package main
import (
"context"
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
userQuery := "What is the return policy?"
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)},
})
if err != nil {
panic(err)
}
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6-astra",
Messages: []openai.ChatCompletionMessageParamUnion{
openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."),
openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)),
},
})
if err != nil {
panic(err)
}
fmt.Println(completion.Choices[0].Message.Content)
}
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
import com.openai.models.vectorstores.VectorStoreSearchParams;
import java.util.stream.Collectors;
String vectorStoreId = "vs_123";
String query = "What is the return policy?";
var results =
client
.vectorStores()
.search(vectorStoreId, VectorStoreSearchParams.builder().query(query).build());
String sources =
results.data().stream()
.map(
result ->
"<result file_id='"
+ result.fileId()
+ "' file_name='"
+ result.filename()
+ "'>"
+ result.content().stream()
.map(content -> "<content>" + content.text() + "</content>")
.collect(Collectors.joining())
+ "</result>")
.collect(Collectors.joining());
var completion =
client
.chat()
.completions()
.create(
ChatCompletionCreateParams.builder()
.model("gpt-6-astra")
.addDeveloperMessage(
"Answer the query concisely using only the provided sources.")
.addUserMessage(
"Sources: <sources>" + sources + "</sources>\n\nQuery: " + query)
.build());
completion.choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 require "openai"
client = OpenAI::Client.new
query = "What is the return policy?"
results = client.vector_stores.search("vs_123", query: query)
sources = (results.data || []).map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id='#{result.file_id}' file_name='#{result.filename}'>#{content}</result>"
end.join
completion = client.chat.completions.create(
model: "gpt-6-astra",
messages: [
{
role: :developer,
content: "Answer the query concisely using only the provided sources."
},
{
role: :user,
content: "Sources: <sources>#{sources}</sources>\n\nQuery: #{query}"
}
]
)
puts(completion.choices.fetch(0).message.content) "Our return policy allows returns within 30 days of purchase." この例で使っている format_results 関数は、以下のように実装できます。
1
2
3
4
5
6
7
8
9
10
11 function formatResults(results) {
let formattedResults = "";
for (const result of results.data) {
let formattedResult = `<result file_id='${result.file_id}' file_name='${result.filename}'>`;
for (const part of result.content) {
formattedResult += `<content>${part.text}</content>`;
}
formattedResults += formattedResult + "</result>";
}
return `<sources>${formattedResults}</sources>`;
} 1
2
3
4
5
6
7
8
9
10 def format_results (results):
formatted_results = ""
for result in results.data:
formatted_result = (
f "<result file_id=' { result.file_id } ' file_name=' { result.filename } '>"
)
for part in result.content:
formatted_result += f "<content> { part.text } </content>"
formatted_results += formatted_result + "</result>"
return f "<sources> { formatted_results } </sources>" 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 package main
import (
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 import com.openai.models.vectorstores.VectorStoreSearchResponse;
import java.util.List;
static String formatResults(List<VectorStoreSearchResponse> results) {
var formatted = new StringBuilder("<sources>");
for (var result : results) {
formatted
.append("<result file_id='")
.append(result.fileId())
.append("' file_name='")
.append(result.filename())
.append("'>");
for (var part : result.content()) {
formatted.append("<content>").append(part.text()).append("</content>");
}
formatted.append("</result>");
}
return formatted.append("</sources>").toString();
} 1
2
3
4
5
6
7
8 def format_results(results)
sources = results.map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id=\"#{result.file_id}\" file_name=\"#{result.filename}\">#{content}</result>"
end
"<sources>#{sources.join}</sources>"
end