使用する API を選択して、音声アプリケーションの利用量の測定方法とコストの管理方法を確認してください。
GPT-Live の利用量とコスト
GPT-Live では、音声での会話と、推論やツールの実行を担うバックエンドが分かれています。音声セッションの料金はセッション時間で決まり、バックエンドの料金は使用するモデルとツールで決まるため、それぞれ別に見積もります。
音声セッションの料金
GPT-Live の音声セッションには、現行のモデルの単価が秒単位で適用されます。セッション時間の端数を分単位で切り上げることはありません。
セッションの利用時間には、ユーザーやアシスタントが話している時間のほか、どちらも話していない時間や、バックエンドが処理を行っている時間も含まれます。
見積もりには、セッションを開始してから閉じるまでの時間を使います。再生した音声の長さだけを測るのではなく、API が報告するセッション時間を使ってください。マイク入力をミュートしてもセッションは閉じません。会話が終わったらセッションを閉じ、最終的な利用量を取得してください。
バックエンドのモデルとツールの料金は、API の料金を参照してください。
WebRTC の初期化時の料金
POST /v1/live/sessions リクエストで WebRTC セッションを作成すると、初期化時に音声利用時間 15 秒分の料金が発生します。セッションが開始すると、この金額はセッション時間に応じた料金に充当されます。料金を見積もる際に、開始したセッションの利用時間にさらに 15 秒を加算しないでください。
たとえば、後述の 90 秒のセッションには、初期化時に課金された 15 秒がすでに含まれています。105 秒分の料金がかかるわけではありません。再接続のコストや、ユーザーが話す準備ができる前にセッションを作成するアプリケーションのコストを評価する際は、セッション作成時の料金も考慮してください。
バックエンドの料金
バックエンドの呼び出しには、音声を使わないアプリケーションと同様に、音声セッションとは別に料金がかかります。モデルの入力トークンと出力トークン、対応モデルでキャッシュされた入力、該当する場合は画像やツールの料金を見積もりに含めてください。アプリケーションが他のサービスを呼び出す場合は、その料金も含めます。
バックエンドの処理は音声フロントエンドとは別に最適化できます。コスト最適化の一般ガイドを参考に、リクエスト数とトークン使用量を削減してください。対応するバックエンドモデルでは、プロンプトキャッシュを活用できます。再利用する指示やツール定義など、変化の少ない内容をプロンプトの先頭に置いてください。
バックエンドの選択によって、会話の長さも変わります。最適化によってユーザーの待ち時間が長くなったり、アシスタントがタスクを完了できる確率が変わったりする場合は、音声とバックエンドを合わせたコストを比較してください。
会話のコストの見積もり
音声セッションが 1 回の会話では、次の式で総コストを求めます。
総コスト =(課金対象の音声利用時間(秒)÷ 60 × 音声の 1 分あたりの単価)+ バックエンドのコスト
たとえば、音声の単価を 1 分あたり $0.05 とすると、90 秒の音声セッションは $0.075 です。バックエンドのモデルとツールの料金が合計 $0.02 なら、会話全体のコストは $0.095 です。
| 内訳 | 計算 | コスト |
|---|---|---|
| 音声セッション | 90 秒 ÷ 60 × $0.05 | $0.075 |
| バックエンドの処理 | モデルとツールの料金の合計 | $0.02 |
| 会話全体の合計 | $0.075 + $0.02 | $0.095 |
上記の単価とバックエンドのコストは例です。実際の見積もりには、現行の音声単価、バックエンドで計測した利用量、使用したモデルとツールの単価を使ってください。タスクが複数の音声セッションにまたがる場合は、各セッションの利用時間を合計し、セッション間に行ったバックエンド処理も含めます。
最適化の方法
ユーザーが必要以上に会話したり待ったりせずにタスクを完了できるようにします。タスクに必要な確認やチェックは維持してください。
セッション開始前のコンテキストの準備
音声セッションを開始する前に、アプリケーションがすでに利用を許可されている情報を集めておきます。たとえば、注文に関する問い合わせを受けるアシスタントは、注文番号と現在の注文状況を把握した状態で会話を始められます。ユーザーは同じ情報を繰り返し伝えたり、再検索を待ったりせずに済みます。
コンテキストは最新の状態に保ち、タスクに関係する内容に絞ってください。音声モデルには会話に必要な情報を渡し、詳細な記録とワークフローはバックエンドで管理します。セッションの設定と処理の委任とツールを参照してください。
ツールの待ち時間の短縮
待ち時間を短くすると、ユーザー体験の向上と音声セッションのコスト削減につながります。たとえば、バックエンドで gpt-5.6-luna を Fast モードで使用し、互いに依存しないツール呼び出しを並列に実行するとします。この最適化により、ユーザーがタスクを終えて音声セッションを 1 分早く閉じられれば、音声料金を $0.05 節約できます。バックエンドの追加コストがこの節約額を下回れば、総コストも下がります。
委任イベントが届く前に、文字起こしの断片をもとに先回りして検索を開始することもできます。バックエンドのコストを計測する際は、先回りして実行したものの、結果を使わなかった処理も含めてください。
モデル、接続、ストリーミング、ツールの最適化については、バックエンドのレイテンシの短縮を参照してください。音声エージェントの評価を使って、ユーザーにとって有用な音声応答が返るまでの時間と、タスクが成功したかどうかを検証してください。
長時間のタスク実行中のセッション終了
音声フロントエンドとアプリケーションが管理するバックエンドは、それぞれ独立して動作できます。クライアントに処理を委任すると、音声セッションが開いている間も、閉じた後も、バックエンドワーカーは実行を継続できます。音声セッションを閉じる前に、タスクの状態と会話のコンテキストを保存してください。
無操作時のタイムアウト、再開のトリガー、コンテキストの復元手順については、アイドル状態のセッションの終了と再開を参照してください。
常駐型のエージェントでは、バックエンドがゴールモードでのコーディングなど時間のかかるタスクを処理している間、音声セッションを閉じます。ユーザーが戻ったときに新しい音声セッションを開始できるように、会話を再開というボタンを用意してください。バックエンドの完了イベントをきっかけに新しいセッションを開始し、結果が用意できたことをユーザーに通知する方法もあります。
会話を復元するには、保存したコンテキストと検証済みのタスク結果を input に含めて、新しいセッションを開始します。たとえば、次の開始イベントを新しい WebSocket 接続で送信します。
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}session.started を受信してから音声のストリーミングを開始してください。サポートされている履歴の形式については、過去の会話を使ったセッションの初期化を参照してください。
以前のセッションを store: true で保存していた場合は、そのセッションをフォークすることもできます。どちらの方法でも、検証済みのバックエンドのタスク状態はアプリケーションで保持してください。
セッションを閉じると、音声を使わない時間 1 分につき $0.05 を節約できます。この節約額と、再接続にかかるコストや会話の中断がユーザー体験に与える影響を比較してください。
バックエンドモデルの選択
まず、タスクに必要な精度と信頼性を満たすモデルを選びます。次に、音声セッションの利用時間、モデルの利用量、ツール呼び出し、再試行を含めて、会話全体のコストを比較します。これらの要素をどう比較して選ぶかは、モデル選択ガイドを参照してください。
大きなバックエンドモデルでも、タスクを短時間で完了でき、音声セッションの節約額がトークン料金の増加分を上回れば、総コストは下がります。逆に、安価なモデルでも、処理に時間がかかる、ツール呼び出しを繰り返す、タスクに失敗するといった場合には、総コストが高くなることがあります。
成功したタスク 1 件あたりのコストを、完了率や完了までの時間と併せて比較してください。完了できた作業が少ないために安価な構成が有利に見えてしまわないよう、失敗した試行と再試行も総コストに含めます。比較を計画する際は、Cookbook の音声エージェント評価の例を活用してください。
実際の利用量のモニタリング
セッションごとに、音声の利用時間とバックエンドの利用量を分けて記録してください。GPT-Live は音声の累計利用時間を秒単位で報告します。
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}更新のたびに、それまでの利用時間のスナップショットを最新の値で置き換えます。スナップショットの値を合計しないでください。session.close を送信した後も、session.closed が届くまでイベントを受信し続け、そのイベントの最終的な usage.seconds を 1 回だけ記録します。アプリケーションが切断前に最終利用量を取得できるよう、セッションを正常に終了する手順に従ってください。
Responses に処理を委任する場合は、バックエンドのレスポンスの usage を、入れ子の response.completed イベントから読み取ります。このイベントは response.event を通じて届きます。レスポンス ID を使ってバックエンドの各レスポンスを 1 回だけ計上し、そのモデルの単価を適用するために必要な入力、出力、キャッシュ済みトークンの内訳を保存してください。アプリケーションが独立してバックエンド処理を実行する場合は、それらのリクエストの利用量も取得します。
代表的な会話をいくつか選び、見積もった総コストと実際の総コストを比較してください。評価のためだけに行うモデル呼び出しはアプリケーションの利用量と区別し、タスクの成否と併せてコストを確認します。
Realtime API の料金
ここでは、Realtime API の課金の仕組みとコストの最適化方法を説明します。音声エージェントのセッションでは、テキスト、音声、画像それぞれの入力トークンと出力トークンが計上されます。ストリーミング翻訳とストリーミング文字起こしのセッションは、音声の長さに応じて課金されます。料金はモデルごとに異なります。各モデルのページで確認してください(例:gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper、gpt-realtime)。
Realtime API の対話セッションは、一連の ターン で構成されます。各ターンでは、ユーザーが入力を追加すると Response が作成され、モデルが出力を生成します。サーバーは Conversation を保持します。これは、次のターンの入力となる Item のリストです。Response が返ると、その出力が自動的に Conversation に追加されます。
翻訳と文字起こしのセッションでは、ストリーミングの仕組みが異なります。クライアントは音声を連続して送信し、元の音声が届くのに合わせて、翻訳された音声、文字起こしの差分、または文字起こしイベントを受信します。これらのセッションは通常の Response のライフサイクルを使用しません。コストの見積もりとモニタリングには、Response ごとのトークン使用量ではなく、音声の長さに応じた単価を使ってください。
Response ごとの料金
Realtime API では Response が作成されると料金が発生し、入力トークン数と出力トークン数に応じて課金されます(入力音声の文字起こし料金については後述します)。現在、ネットワーク帯域幅や接続に料金はかかりません。Response は手動で作成できるほか、音声区間検出(VAD)を有効にすると自動で作成できます。VAD は無音の入力を除外するため、クライアントが手動で会話の入力に追加しない限り、無音の音声は入力トークンに計上されません。
Response を作成するたびに、会話全体がモデルに送信されます。各ターンの出力は Item としてサーバー側の Conversation に追加され、後続のターンの入力に含まれます。そのため、セッションの後半のターンほど料金が高くなります。
テキストトークンの料金は、トークン化ツールを使って見積もれます。音声トークンは、ユーザーメッセージでは音声 100 ミリ秒につき 1 トークン、アシスタントメッセージでは音声 50 ミリ秒につき 1 トークンです。実際のトークン数には、メッセージの内容以外に特殊トークンも含まれるため、数に多少の差が生じます。たとえば、本文がテキスト 10 トークンのユーザーメッセージが、12 トークンとして計上されることがあります。
計算例
複数ターンにわたる Realtime API セッションで、トークンの料金がどのように発生するかを簡単な例で説明します。
会話の最初のターンで、100 トークンの指示と、音声 20 トークンのユーザーメッセージ(たとえば、ユーザーの発話を VAD が検出して追加したもの)を入力します。入力は合計 120 トークンです。Response を作成すると、アシスタントの出力メッセージ(音声 20 トークン、テキスト 10 トークン)が生成されます。
次に、ユーザーがもう一度音声メッセージを送って 2 ターン目を開始します。このターンでは何トークンが計上されるでしょうか。この時点の Conversation には、最初の指示、最初のユーザーメッセージ、1 ターン目のアシスタントの出力メッセージに加えて、2 件目のユーザーメッセージ(音声 25 トークン)が含まれています。このターンの入力はテキスト 110 トークンと音声 64 トークンで、さらにアシスタントが新たに生成するメッセージの出力トークンが加わります。
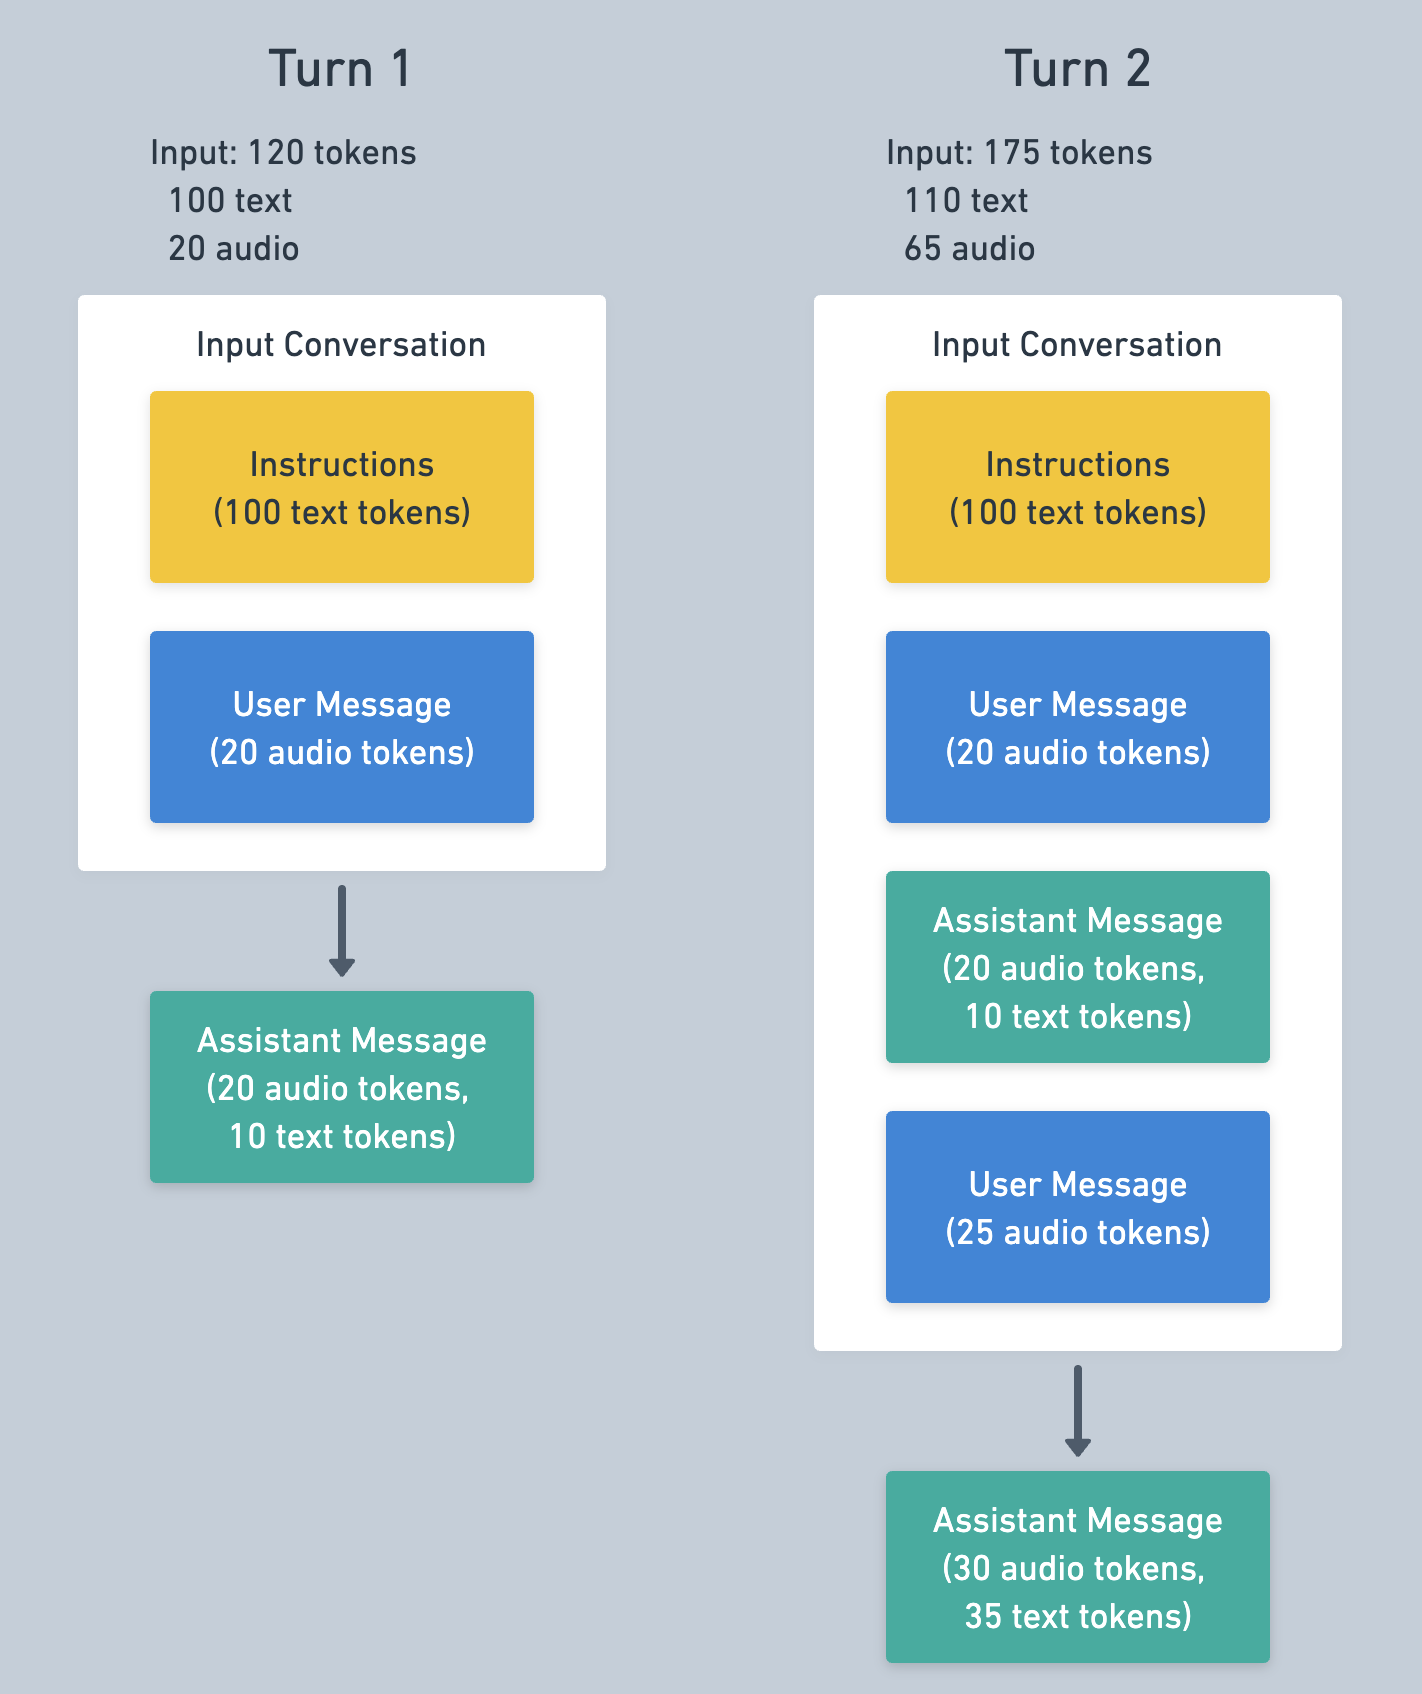
2 ターン目では、1 ターン目のメッセージにキャッシュが適用される可能性が高く、その場合は入力コストが下がります。詳しくは、後述のキャッシュの説明を参照してください。
Response で使用されたトークン数は、次のように response.done イベントから取得できます。
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}入力音声の文字起こし料金
Realtime API で入力音声の文字起こしを有効にすると、別途料金が発生します。入力音声の文字起こしには、音声変換モデルとは異なるモデルと料金体系が適用されます。gpt-transcribe は、確定したターンの文字起こしに使用してください。文字起こしは、入力音声バッファーに音声が書き込まれ、バッファーがコミットされた後に始まります。
入力音声の文字起こしの利用量は、conversation.item.input_audio_transcription.completed イベントから取得します。利用量を示すフィールドは文字起こしモデルによって異なります。gpt-transcribe は音声の長さに応じて課金されます。トークン使用量に応じて課金されるモデルはトークン数を返します。たとえば、音声の長さに基づく利用量は次の形式で返されます。
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}キャッシュ
Realtime API はプロンプトキャッシュに対応しています。キャッシュは自動的に適用され、複数ターンにわたるセッションの入力トークン料金を大幅に削減できます。Response の入力トークンが過去の Response のトークンと一致するとキャッシュの適用対象になりますが、必ず適用されるわけではありません。
キャッシュのヒット率を最大化するには、セッションの履歴を変更しないことが最も効果的です。会話の内容を削除または変更すると、入力が先頭から一致するのは変更箇所の手前までとなり、それ以降のキャッシュが使えなくなります。指示やツール定義は会話の先頭にあるため、セッションの途中で変更すると、後続のターンでキャッシュのヒット率が下がります。
切り詰め
会話のトークン数がモデルの入力トークン上限を超えると、会話が切り詰められます。具体的には、古いメッセージから順に Response の入力から除外されます。コンテキスト長が 32k で最大出力が 4,096 トークンのモデルでは、切り詰めが発生する前にコンテキストに含められるのは 28,224 トークンまでです。
クライアントでは、モデルの上限よりも小さいトークンウィンドウを設定できます。これはトークン使用量とコストを抑えるのに有効です。上限は token_limits.post_instructions で設定できます(後述の例のように、切り詰めのタイプを retention_ratio に設定した場合)。この上限は、指示のトークンを除いた Response の入力トークン数に適用されます。post_instructions を 1,000 に設定すると、入力が 1,000 トークンに収まるように、上限を超える分の Item は Response の生成時にモデルに送信されません。
切り詰めると会話の先頭付近でキャッシュが無効になります。毎ターン切り詰めが発生すると、キャッシュのヒット率は非常に低くなります。これを避けるには、一度に必要最小限より多くのメッセージを除外し、次の切り詰めまでの余裕を持たせます。クライアントは session.truncation.retention_ratio でこの割合を設定できます。サーバーのデフォルト値は 1.0 で、上限内に収めるのに必要な Item だけを除外します。0.8 の場合、切り詰め後に残すトークン数は上限の 80% となり、上限の 20% に相当する分を追加で除外します。
同じモデルで Realtime API のセッションあたりのコストを削減したい場合は、次の例のようにトークン数の上限を下げ、retention_ratio を 1 未満に設定することをおすすめします。コストを抑えられる一方で、各ターンでモデルが参照できる会話履歴が短くなる場合があります。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}次のように、切り詰めを完全に無効にすることもできます。無効にすると、Conversation が長すぎて Response を作成できない場合にエラーが返ります。Conversation の長さを手動で管理したい場合に便利です。
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}その他の最適化方法
mini モデルの利用
Realtime の音声変換モデルには標準サイズと mini サイズがあり、mini モデルは大幅に安価です。一方で、mini モデルは指示に従う能力や Function Calling の性能が標準モデルに及ばない傾向があります。まず大きなモデルでアプリケーションをテストし、アプリケーションとプロンプトを改善してから、mini モデルを使った最適化を試すことをおすすめします。
Conversation の編集
サーバーでは自動的に切り詰めが行われますが、Conversation を手動で編集してコストを管理する方法もあります。この API は、クライアントがサーバー側の Conversation を全面的に制御できるように設計されているため、必要に応じて Item を追加したり削除したりできます。
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}古いメッセージを削除すると、入力トークン数とコストを抑えられます。ただし、重要な内容まで失われることがあるため、古いメッセージを要約に置き換える方法がよく使われます。Conversation から Item を削除するには、上記のように conversation.item.delete メッセージを送ります。Item の追加には conversation.item.create メッセージを使います。
コストの見積もり
Realtime API のトークン使用量は複数の要素で決まるため、事前にコストを見積もるのが難しい場合があります。Realtime Playground で実際に使用する予定のプロンプトと関数を試し、サンプルセッションのトークン使用量を測定するのが効果的です。セッションのトークン使用量は、Realtime Playground の「Logs」タブでセッション ID の横に表示されます。