OpenAI は、会話の状態を管理する方法をいくつか提供しています。会話の状態の管理は、複数のメッセージやターンにわたって情報を保持するために重要です。
GPT-5.5 が途中の状況報告を最終回答として扱う問題を調べる際は、
連携実装でアシスタントメッセージの phase フィールドが正しく保持されているか確認してください。
詳しくは、フェーズ
パラメーターをご覧ください。
テキスト生成リクエストはそれぞれ独立しており、状態を保持しませんが、追加のメッセージをパラメーターとして渡すことで、 複数ターンの会話 を実装できます。ノックノックジョークの例を見てみましょう。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: [
    {
      role: "user",
      content: "knock knock.",
    },
    {
      role: "assistant",
      content: "Who's there?",
    },
    {
      role: "user",
      content: "Orange.",
    },
  ],
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI

client = OpenAI()

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()

	completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model: "gpt-6-astra",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Knock knock."),
			openai.AssistantMessage("Who's there?"),
			openai.UserMessage("Orange."),
		},
	})
	if err != nil {
		panic(err)
	}

	fmt.Println(completion.Choices[0].Message.Content)
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

ChatCompletionCreateParams params =
    ChatCompletionCreateParams.builder()
        .model("gpt-6-astra")
        .addUserMessage("Knock knock.")
        .addAssistantMessage("Who's there?")
        .addUserMessage("Orange.")
        .build();

client.chat().completions().create(params).choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);

ChatCompletion completion = await client.CompleteChatAsync(
    [
        new UserChatMessage("Knock knock."),
        new AssistantChatMessage("Who's there?"),
        new UserChatMessage("Orange."),
    ]
);

Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23require "openai"

client = OpenAI::Client.new

completion = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: [
    {
      role: :user,
      content: "Knock knock."
    },
    {
      role: :assistant,
      content: "Who's there?"
    },
    {
      role: :user,
      content: "Orange."
    }
  ]
)

puts(completion.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: [
    { role: "user", content: "knock knock." },
    { role: "assistant", content: "Who's there?" },
    { role: "user", content: "Orange." },
  ],
});

console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfInputItemList: responses.ResponseInputParam{
				responses.ResponseInputItemParamOfMessage("Knock knock.", responses.EasyInputMessageRoleUser),
				responses.ResponseInputItemParamOfMessage("Who's there?", responses.EasyInputMessageRoleAssistant),
				responses.ResponseInputItemParamOfMessage("Orange.", responses.EasyInputMessageRoleUser),
			},
		},
	})
	if err != nil {
		panic(err)
	}

	fmt.Println(response.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.List;

ResponseCreateParams params =
    ResponseCreateParams.builder()
        .model("gpt-6-astra")
        .inputOfResponse(
            List.of(
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.USER)
                        .content("Knock knock.")
                        .build()),
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.ASSISTANT)
                        .content("Who's there?")
                        .build()),
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.USER)
                        .content("Orange.")
                        .build())))
        .build();

client.responses().create(params).output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult response = await client.CreateResponseAsync(
    "gpt-6-astra",
    [
        ResponseItem.CreateUserMessageItem("Knock knock."),
        ResponseItem.CreateAssistantMessageItem("Who's there?"),
        ResponseItem.CreateUserMessageItem("Orange."),
    ]
);

Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23require "openai"

client = OpenAI::Client.new

response = client.responses.create(
  model: "gpt-6-astra",
  input: [
    {
      role: :user,
      content: "Knock knock."
    },
    {
      role: :assistant,
      content: "Who's there?"
    },
    {
      role: :user,
      content: "Orange."
    }
  ]
)

puts(response.output_text)
user と assistant のメッセージを交互に並べることで、過去の会話の状態をモデルへの 1 回のリクエストに含められます。
生成されたレスポンス間でコンテキストを手動で共有するには、モデルの前回のレスポンスの出力を入力に含め、その入力を次のリクエストに追加します。
リーズニングモデルへのステートレスなリクエストでは、レスポンスの output 配列に含まれるすべての項目を保持してください。Responses API は、デフォルトで暗号化された推論項目を返します。出力全体を再度渡すことで、推論項目とアシスタントの phase 値をそのまま保持できます。推論の永続化をサポートするモデルでは、reasoning.context: "all_turns" を使用して、以前のターンで得られた利用可能な推論を次の生成に含められます。詳しくは、呼び出し間での推論の保持をご覧ください。
次の例では、モデルにジョークを話すよう依頼し、続けて別のジョークをリクエストします。このように過去のレスポンスを新しいリクエストに追加すると、以前のやり取りのコンテキストを保持し、自然な会話を続けやすくなります。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const openai = new OpenAI();

let history = [
  {
    role: "user",
    content: "tell me a joke",
  },
];

const completion = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: history,
});

console.log(completion.choices[0].message.content);

history.push(completion.choices[0].message);
history.push({
  role: "user",
  content: "tell me another",
});

const secondCompletion = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: history,
});

console.log(secondCompletion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=history,
)

print(response.choices[0].message.content)

history.append(response.choices[0].message)
history.append({"role": "user", "content": "tell me another"})

second_response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=history,
)

print(second_response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()
	history := []openai.ChatCompletionMessageParamUnion{
		openai.UserMessage("Tell me a joke."),
	}

	first, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model:    "gpt-6-astra",
		Messages: history,
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.Choices[0].Message.Content)

	history = append(history,
		openai.AssistantMessage(first.Choices[0].Message.Content),
		openai.UserMessage("Tell me another."),
	)
	second, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model:    "gpt-6-astra",
		Messages: history,
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.Choices[0].Message.Content)
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

var params =
    ChatCompletionCreateParams.builder()
        .model("gpt-6-astra")
        .addUserMessage("Tell me a joke.")
        .build();
var first = client.chat().completions().create(params);
first.choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);

var second =
    client
        .chat()
        .completions()
        .create(
            params.toBuilder()
                .addAssistantMessage(first.choices().get(0).message().content().orElseThrow())
                .addUserMessage("Tell me another.")
                .build());
second.choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);

List<ChatMessage> messages = [new UserChatMessage("Tell me a joke.")];
ChatCompletion first = await client.CompleteChatAsync(messages);
Console.WriteLine(first.Content[0].Text);

messages.Add(new AssistantChatMessage(first));
messages.Add(new UserChatMessage("Tell me another."));
ChatCompletion second = await client.CompleteChatAsync(messages);
Console.WriteLine(second.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"

client = OpenAI::Client.new
history = [
  {
    role: :user,
    content: "Tell me a joke."
  }
]

first = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: history
)
puts(first.choices.fetch(0).message.content)

history << {
  role: :assistant,
  content: first.choices.fetch(0).message.content
}
history << {
  role: :user,
  content: "Tell me another."
}

second = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: history
)
puts(second.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35import OpenAI from "openai";
import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";

const openai = new OpenAI();

let history = [
  {
    role: "user",
    content: "tell me a joke",
  },
];

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: history,
  store: false,
});

console.log(response.output_text);

// Add replayable output items, including reasoning items, to the history
history.push(...toResponseInputItems(response.output));

history.push({
  role: "user",
  content: "tell me another",
});

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  input: history,
  store: false,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(response.output_text)

# Add all response output items, including encrypted reasoning items, to the conversation
history += response.output

history.append({"role": "user", "content": "tell me another"})

second_response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50package main

import (
	"context"
	"encoding/json"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()
	history := responses.ResponseInputParam{
		responses.ResponseInputItemParamOfMessage("tell me a joke", responses.EasyInputMessageRoleUser),
	}
	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
		Store: openai.Bool(false),
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	history = append(history, outputAsInput(first.Output)...)
	history = append(history, responses.ResponseInputItemParamOfMessage("tell me another", responses.EasyInputMessageRoleUser))
	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
		Store: openai.Bool(false),
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}

func outputAsInput(output []responses.ResponseOutputItemUnion) []responses.ResponseInputItemUnionParam {
	input := make([]responses.ResponseInputItemUnionParam, 0, len(output))
	for _, item := range output {
		var converted responses.ResponseInputItemUnion
		if err := json.Unmarshal([]byte(item.RawJSON()), &converted); err != nil {
			panic(err)
		}
		input = append(input, converted.ToParam())
	}
	return input
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.ArrayList;

var history = new ArrayList<ResponseInputItem>();
history.add(
    ResponseInputItem.ofEasyInputMessage(
        EasyInputMessage.builder()
            .role(EasyInputMessage.Role.USER)
            .content("Tell me a joke.")
            .build()));

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .inputOfResponse(history)
                .store(false)
                .build());
first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
first.output().stream()
    .map(item -> JsonValue.from(item).convert(ResponseInputItem.class))
    .forEach(history::add);
history.add(
    ResponseInputItem.ofEasyInputMessage(
        EasyInputMessage.builder()
            .role(EasyInputMessage.Role.USER)
            .content("Tell me another.")
            .build()));

client
    .responses()
    .create(
        ResponseCreateParams.builder()
            .model("gpt-6-astra")
            .inputOfResponse(history)
            .store(false)
            .build())
    .output()
    .stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

List<ResponseItem> history =
[
    ResponseItem.CreateUserMessageItem("Tell me a joke."),
];

CreateResponseOptions options = new("gpt-6-astra", history)
{
    StoredOutputEnabled = false,
    IncludedProperties =
    {
        IncludedResponseProperty.ReasoningEncryptedContent,
    },
};
ResponseResult first = await client.CreateResponseAsync(options);
Console.WriteLine(first.GetOutputText());

history.AddRange(first.OutputItems);
history.Add(ResponseItem.CreateUserMessageItem("Tell me another."));

options = new("gpt-6-astra", history)
{
    StoredOutputEnabled = false,
    IncludedProperties =
    {
        IncludedResponseProperty.ReasoningEncryptedContent,
    },
};
ResponseResult second = await client.CreateResponseAsync(options);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"

client = OpenAI::Client.new
history = [
  {
    role: :user,
    content: "Tell me a joke."
  }
]

first = client.responses.create(
  model: "gpt-6-astra",
  input: history,
  store: false
)
puts(first.output_text)

history.concat(first.output)
history << {
  role: :user,
  content: "Tell me another."
}

second = client.responses.create(
  model: "gpt-6-astra",
  input: history,
  store: false
)
puts(second.output_text)
OpenAI の API を使うと、会話の状態を自動で管理しやすくなり、会話のターンごとに入力を手動で渡す必要がなくなります。
代わりに Responses API を使用することをお勧めします。状態を保持する API なので、パラメーターを指定するだけで会話間のコンテキストを管理できます。
Chat Completions エンドポイントを使用する場合は、前述の方法で状態を手動で管理する必要があります。
Conversations API は Responses API と連携し、固有の永続的な識別子を持つ、長期間存続するオブジェクトとして会話の状態を保持します。会話オブジェクトを作成すると、セッション、デバイス、ジョブをまたいで使い続けられます。
会話には、メッセージ、ツール呼び出し、ツールの出力、その他のデータを項目として保存できます。
const conversation = await client.conversations.create();
conversation = openai.conversations.create()
conversation, err := client.Conversations.New(context.Background(), conversations.ConversationNewParams{})
if err != nil {
	panic(err)
}
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;

var conversation = client.conversations().create();

System.out.println(conversation.id());
conversation = client.conversations.create
複数ターンのやり取りでは、後続のレスポンスに conversation を渡すことで、状態を保持し、コンテキストを共有できます。複数のレスポンス項目をつなぎ合わせる必要はありません。
1
2
3
4
5
6
7const response = await client.responses.create({
  model: "gpt-6-astra",
  input: [{ role: "user", content: "What are the five Ds of dodgeball?" }],
  conversation: conversation.id,
});

console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(
    model="gpt-6-astra",
    input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],
    conversation=conversation.id,
)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
	Model: "gpt-6-astra",
	Conversation: responses.ResponseNewParamsConversationUnion{
		OfString: openai.String(conversation.ID),
	},
	Input: responses.ResponseNewParamsInputUnion{
		OfString: openai.String("What are the five Ds of dodgeball?"),
	},
})
if err != nil {
	panic(err)
}
fmt.Println(response.OutputText())
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var conversation = client.conversations().create();

var response =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .conversation(conversation.id())
                .input("What are the five Ds of dodgeball?")
                .build());

response.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7response = client.responses.create(
  model: "gpt-6-astra",
  conversation: conversation.id,
  input: "What are the five Ds of dodgeball?"
)

puts(response.output_text)
前のレスポンスからのコンテキストの引き継ぎ
会話の状態を管理するもう 1 つの方法は、previous_response_id パラメーターを使って、生成されたレスポンス間でコンテキストを共有することです。このパラメーターを使うと、レスポンスをつなげて、スレッド形式の会話を作成できます。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: "tell me a joke",
  store: true,
});

console.log(response.output_text);

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  previous_response_id: response.id,
  input: [{ role: "user", content: "explain why this is funny." }],
  store: true,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="tell me a joke",
)
print(response.output_text)

second_response = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input=[{"role": "user", "content": "explain why this is funny."}],
)
print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Tell me a joke."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model:              "gpt-6-astra",
		PreviousResponseID: openai.String(first.ID),
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Explain why this is funny."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder().model("gpt-6-astra").input("Tell me a joke.").build());

first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));

var second =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .input("Explain why this is funny.")
                .previousResponseId(first.id())
                .build());
second.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult first = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Tell me a joke."
);
Console.WriteLine(first.GetOutputText());

ResponseResult second = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Explain why this is funny.",
    previousResponseId: first.Id
);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"

client = OpenAI::Client.new

first = client.responses.create(
  model: "gpt-6-astra",
  input: "Tell me a joke."
)
puts(first.output_text)

second = client.responses.create(
  model: "gpt-6-astra",
  previous_response_id: first.id,
  input: "Explain why this is funny."
)
puts(second.output_text)
次の例では、モデルにジョークを話すよう依頼します。その後、別のリクエストで、そのジョークがなぜ面白いのか説明を求めます。モデルには適切な回答に必要なコンテキストがすべて揃っています。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: "tell me a joke",
  store: true,
});

console.log(response.output_text);

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  previous_response_id: response.id,
  input: [{ role: "user", content: "explain why this is funny." }],
  store: true,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="tell me a joke",
)
print(response.output_text)

second_response = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input=[{"role": "user", "content": "explain why this is funny."}],
)
print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Tell me a joke."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model:              "gpt-6-astra",
		PreviousResponseID: openai.String(first.ID),
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Explain why this is funny."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder().model("gpt-6-astra").input("Tell me a joke.").build());

first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));

var second =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .input("Explain why this is funny.")
                .previousResponseId(first.id())
                .build());
second.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult first = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Tell me a joke."
);
Console.WriteLine(first.GetOutputText());

ResponseResult second = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Explain why this is funny.",
    previousResponseId: first.Id
);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"

client = OpenAI::Client.new

first = client.responses.create(
  model: "gpt-6-astra",
  input: "Tell me a joke."
)
puts(first.output_text)

second = client.responses.create(
  model: "gpt-6-astra",
  previous_response_id: first.id,
  input: "Explain why this is funny."
)
puts(second.output_text)
Responses API の WebSocket モードを使用する場合、会話を継続する際の previous_response_id の意味は HTTP モードと同じですが、持続的なソケット接続上で response.create イベントを繰り返し送信します。
接続ごとのローカルキャッシュは、低レイテンシで会話を継続できるように、直近のレスポンスをメモリに保持します。stream_id を使用すると、各レーンで最新のレスポンスを保持できます。レスポンスの継承関係は引き続き previous_response_id によって決まるため、別のレーンのレスポンスが利用可能な間は、そのレスポンスからフォークして新しいレーンを作成できます。キャッシュされていない ID を解決できない場合は、previous_response_id を null に設定し、入力コンテキスト全体を渡して新しいターンを送信してください。
Response オブジェクトは、デフォルトで 30 日間保存されます。ダッシュボードの
ログページで表示するか、
API 経由で取得できます。
Response の作成時に store を false に設定すると、
この保存動作を無効にできます。
Conversation オブジェクトとその中の項目には、30 日間の TTL は適用されません。会話に関連付けられたレスポンスの項目は、30 日間の TTL なしで永続化されます。
OpenAI は、お客様の明示的な同意なしに、API 経由で送信されたデータをモデルのトレーニングに使用することはありません。詳しくはこちらをご覧ください。
previous_response_id を使用する場合でも、連結されたレスポンスに含まれる過去の入力トークンはすべて、API の入力トークンとして課金されます。
コンテキストウィンドウの管理
コンテキストウィンドウを理解すると、スレッド形式の会話を作成し、モデルとのやり取り全体で状態を適切に管理しやすくなります。
コンテキストウィンドウ は、1 回のリクエストで使用できるトークン数の上限です。この上限には、入力トークン、出力トークン、推論トークンが含まれます。使用するモデルのコンテキストウィンドウについては、モデルの詳細をご覧ください。
テキスト生成のコンテキスト管理
入力が複雑になったり、会話のターン数が増えたりすると、 出力トークン と コンテキストウィンドウ の両方の上限を考慮する必要があります。モデルの入出力は、トークン単位で計測されます。入力はトークンに分解されて内容や意図の分析に使われ、出力はトークンを組み合わせて筋の通った内容に構成されます。モデルには、テキスト生成リクエストのライフサイクル全体で使用できるトークン数の上限があります。
- 出力トークン は、モデルがプロンプトに応じて生成するトークンです。出力トークン数の上限はモデルごとに異なります。たとえば、
gpt-4o-2024-08-06 は最大 16,384 の出力トークンを生成できます。
- コンテキストウィンドウ は、入力トークンと出力トークン(一部のモデルでは推論トークンも含みます)に使用できるトークンの総数を表します。モデルごとのコンテキストウィンドウの上限を比較してください。たとえば、
gpt-4o-2024-08-06 のコンテキストウィンドウは合計 128k トークンです。
モデルに渡すコンテキスト、データ、例などを追加してプロンプトが大きくなると、モデルに割り当てられたコンテキストウィンドウを超えるおそれがあり、出力が途中で切れる可能性があります。
テキストに含まれるトークン数を確認するには、tiktoken ライブラリで構築されたトークナイザーツールを使用してください。
たとえば、o1 モデルを指定して Chat Completions に API リクエストを送信する場合、次のトークン数がコンテキストウィンドウの合計に算入されます。
- 入力トークン(Chat Completions の
messages 配列に含める入力)
-
出力トークン(プロンプトに応じて生成されるトークン)
- 推論トークン(モデルがレスポンスを計画するために使用するトークン)
たとえば、o1 モデルのような推論が有効なモデルで Responses API に API リクエストを送信する場合、次のトークン数がコンテキストウィンドウの合計に算入されます。
- 入力トークン(Responses API の
input 配列に含める入力)
-
出力トークン(プロンプトに応じて生成されるトークン)
- 推論トークン(モデルがレスポンスを計画するために使用するトークン)
コンテキストウィンドウの上限を超えて生成されたトークンは、API レスポンスで切り捨てられる場合があります。
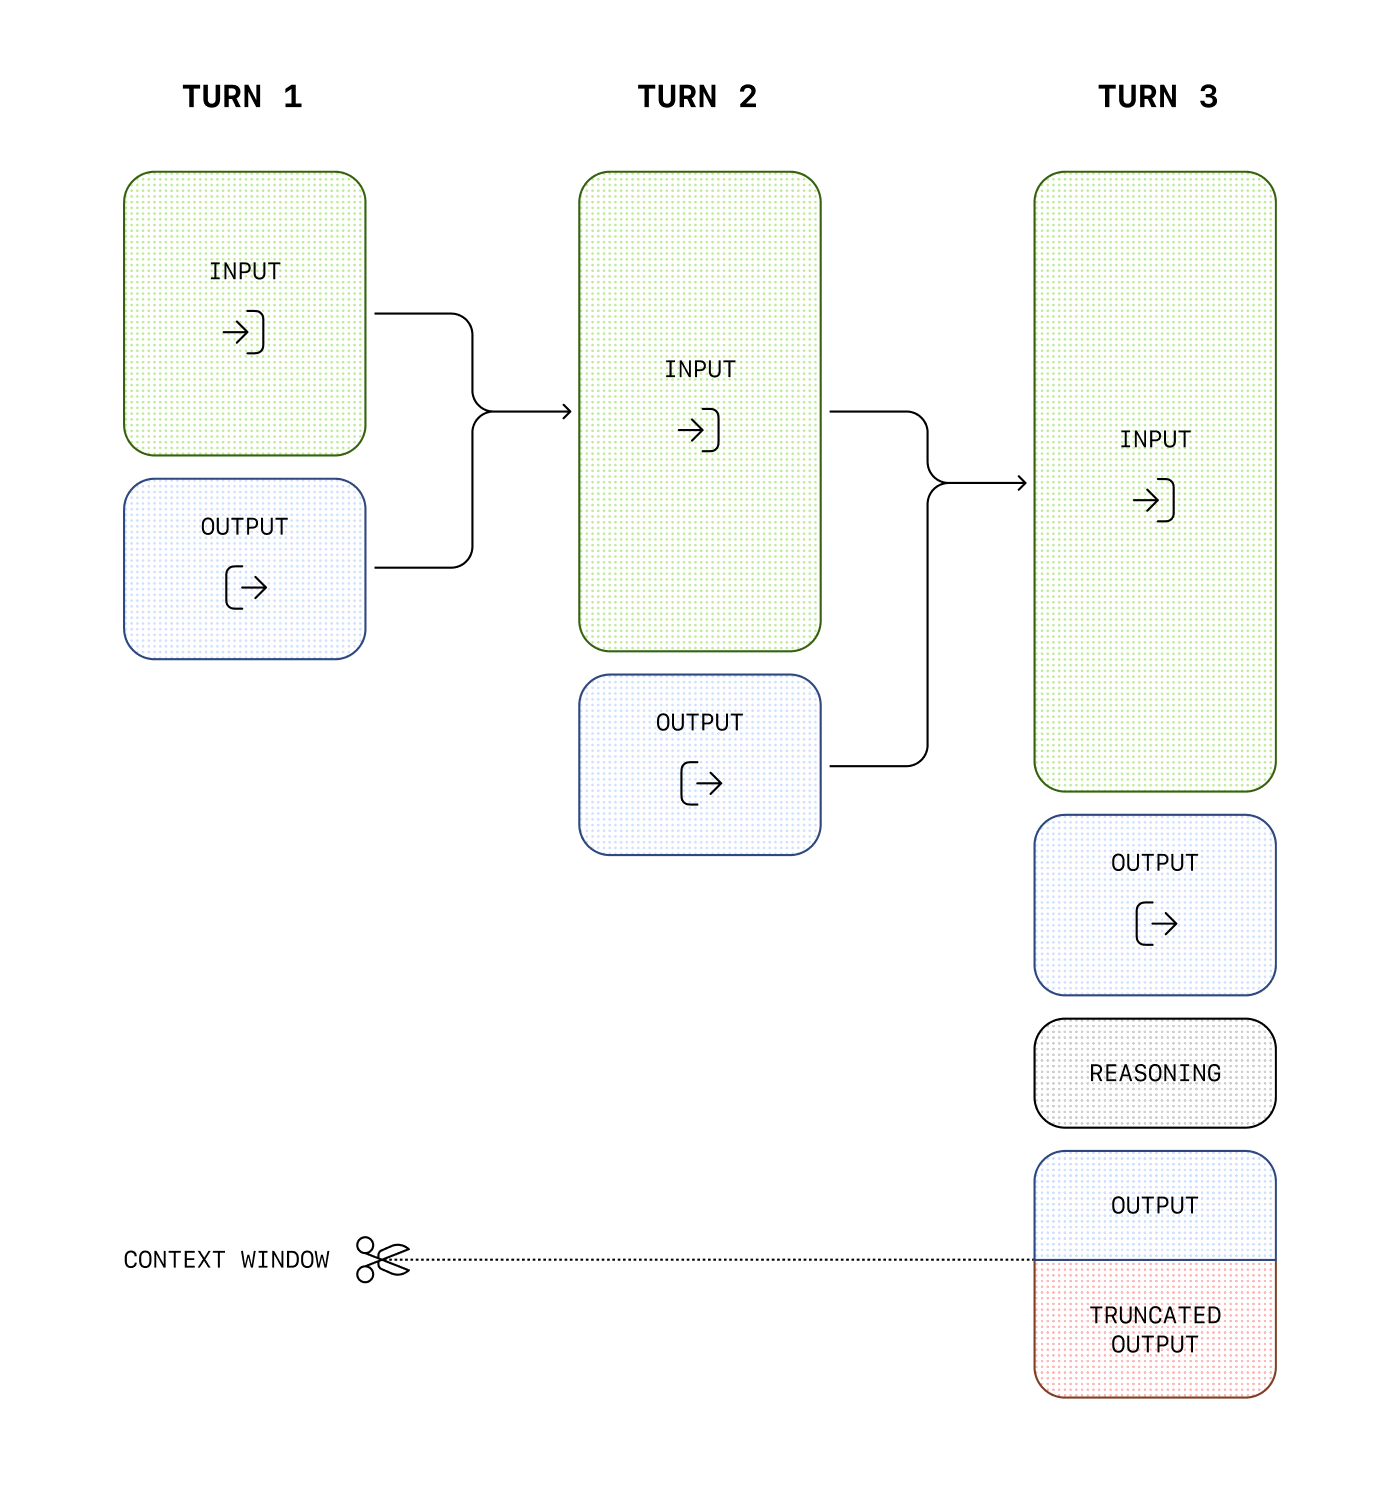
トークナイザーツールを使うと、メッセージで使用するトークン数を見積もれます。
コンパクションの詳しいガイダンスは、現在
コンパクションに掲載されています。
より具体的な例やユースケースは、OpenAI Cookbook を参照してください。また、API を使ってモデルの機能を拡張する方法については、次のガイドで詳しく説明しています。
