OpenAI では、会話の状態を管理する方法をいくつか用意しています。会話の状態を管理すると、複数のメッセージやターンにわたって情報を引き継げます。
GPT-5.5 が途中経過の報告を最終回答として扱う場合は、API との連携処理でアシスタントメッセージの phase フィールドを正しく保持しているか確認してください。詳しくは、フェーズパラメーターを参照してください。
テキスト生成リクエストはそれぞれ独立しており、状態を保持しません。それでも、過去のメッセージをリクエストのパラメーターに含めれば、複数ターンの会話を実装できます。「コンコン」「どなたですか?」という掛け合いで始まるジョークを例に見てみましょう。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: [
    {
      role: "user",
      content: "knock knock.",
    },
    {
      role: "assistant",
      content: "Who's there?",
    },
    {
      role: "user",
      content: "Orange.",
    },
  ],
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI

client = OpenAI()

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()

	completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model: "gpt-6-astra",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Knock knock."),
			openai.AssistantMessage("Who's there?"),
			openai.UserMessage("Orange."),
		},
	})
	if err != nil {
		panic(err)
	}

	fmt.Println(completion.Choices[0].Message.Content)
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

ChatCompletionCreateParams params =
    ChatCompletionCreateParams.builder()
        .model("gpt-6-astra")
        .addUserMessage("Knock knock.")
        .addAssistantMessage("Who's there?")
        .addUserMessage("Orange.")
        .build();

client.chat().completions().create(params).choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);

ChatCompletion completion = await client.CompleteChatAsync(
    [
        new UserChatMessage("Knock knock."),
        new AssistantChatMessage("Who's there?"),
        new UserChatMessage("Orange."),
    ]
);

Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23require "openai"

client = OpenAI::Client.new

completion = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: [
    {
      role: :user,
      content: "Knock knock."
    },
    {
      role: :assistant,
      content: "Who's there?"
    },
    {
      role: :user,
      content: "Orange."
    }
  ]
)

puts(completion.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: [
    { role: "user", content: "knock knock." },
    { role: "assistant", content: "Who's there?" },
    { role: "user", content: "Orange." },
  ],
});

console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfInputItemList: responses.ResponseInputParam{
				responses.ResponseInputItemParamOfMessage("Knock knock.", responses.EasyInputMessageRoleUser),
				responses.ResponseInputItemParamOfMessage("Who's there?", responses.EasyInputMessageRoleAssistant),
				responses.ResponseInputItemParamOfMessage("Orange.", responses.EasyInputMessageRoleUser),
			},
		},
	})
	if err != nil {
		panic(err)
	}

	fmt.Println(response.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.List;

ResponseCreateParams params =
    ResponseCreateParams.builder()
        .model("gpt-6-astra")
        .inputOfResponse(
            List.of(
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.USER)
                        .content("Knock knock.")
                        .build()),
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.ASSISTANT)
                        .content("Who's there?")
                        .build()),
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.USER)
                        .content("Orange.")
                        .build())))
        .build();

client.responses().create(params).output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult response = await client.CreateResponseAsync(
    "gpt-6-astra",
    [
        ResponseItem.CreateUserMessageItem("Knock knock."),
        ResponseItem.CreateAssistantMessageItem("Who's there?"),
        ResponseItem.CreateUserMessageItem("Orange."),
    ]
);

Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23require "openai"

client = OpenAI::Client.new

response = client.responses.create(
  model: "gpt-6-astra",
  input: [
    {
      role: :user,
      content: "Knock knock."
    },
    {
      role: :assistant,
      content: "Who's there?"
    },
    {
      role: :user,
      content: "Orange."
    }
  ]
)

puts(response.output_text)
user と assistant のメッセージを交互に並べると、それまでの会話の状態を 1 回のリクエストでモデルに渡せます。
生成した応答のコンテキストを手動で引き継ぐには、モデルの前回の応答に含まれる出力を、次のリクエストの入力に追加します。
リーズニングモデルにステートレスなリクエストを送る場合は、応答の output 配列に含まれるすべての項目を保持してください。Responses API はデフォルトで暗号化された推論項目を返します。出力をすべて次のリクエストに渡すことで、推論項目とアシスタントの phase の値をそのまま引き継げます。推論の永続化に対応するモデルでは、reasoning.context: "all_turns" を指定すると、以前のターンでの推論のうち利用可能なものを次の生成時に取り込めます。詳しくは、呼び出し間での推論の保持を参照してください。
推論項目を次のリクエストに渡すときは、その項目の生成に使われた会話履歴もそのまま保持してください。会話履歴を編集すると推論にどのような影響があるかについては、プレフィックスを変更せずに保持するを参照してください。
次の例では、モデルにジョークを 1 つ頼み、続けて別のジョークを頼みます。このように前の応答を新しいリクエストに追加すると、それまでのやり取りを踏まえて自然に会話を続けられます。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const openai = new OpenAI();

let history = [
  {
    role: "user",
    content: "tell me a joke",
  },
];

const completion = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: history,
});

console.log(completion.choices[0].message.content);

history.push(completion.choices[0].message);
history.push({
  role: "user",
  content: "tell me another",
});

const secondCompletion = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: history,
});

console.log(secondCompletion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=history,
)

print(response.choices[0].message.content)

history.append(response.choices[0].message)
history.append({"role": "user", "content": "tell me another"})

second_response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=history,
)

print(second_response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()
	history := []openai.ChatCompletionMessageParamUnion{
		openai.UserMessage("Tell me a joke."),
	}

	first, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model:    "gpt-6-astra",
		Messages: history,
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.Choices[0].Message.Content)

	history = append(history,
		openai.AssistantMessage(first.Choices[0].Message.Content),
		openai.UserMessage("Tell me another."),
	)
	second, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model:    "gpt-6-astra",
		Messages: history,
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.Choices[0].Message.Content)
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

var params =
    ChatCompletionCreateParams.builder()
        .model("gpt-6-astra")
        .addUserMessage("Tell me a joke.")
        .build();
var first = client.chat().completions().create(params);
first.choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);

var second =
    client
        .chat()
        .completions()
        .create(
            params.toBuilder()
                .addAssistantMessage(first.choices().get(0).message().content().orElseThrow())
                .addUserMessage("Tell me another.")
                .build());
second.choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);

List<ChatMessage> messages = [new UserChatMessage("Tell me a joke.")];
ChatCompletion first = await client.CompleteChatAsync(messages);
Console.WriteLine(first.Content[0].Text);

messages.Add(new AssistantChatMessage(first));
messages.Add(new UserChatMessage("Tell me another."));
ChatCompletion second = await client.CompleteChatAsync(messages);
Console.WriteLine(second.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"

client = OpenAI::Client.new
history = [
  {
    role: :user,
    content: "Tell me a joke."
  }
]

first = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: history
)
puts(first.choices.fetch(0).message.content)

history << {
  role: :assistant,
  content: first.choices.fetch(0).message.content
}
history << {
  role: :user,
  content: "Tell me another."
}

second = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: history
)
puts(second.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35import OpenAI from "openai";
import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";

const openai = new OpenAI();

let history = [
  {
    role: "user",
    content: "tell me a joke",
  },
];

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: history,
  store: false,
});

console.log(response.output_text);

// Add replayable output items, including reasoning items, to the history
history.push(...toResponseInputItems(response.output));

history.push({
  role: "user",
  content: "tell me another",
});

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  input: history,
  store: false,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(response.output_text)

# Add all response output items, including encrypted reasoning items, to the conversation
history += response.output

history.append({"role": "user", "content": "tell me another"})

second_response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50package main

import (
	"context"
	"encoding/json"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()
	history := responses.ResponseInputParam{
		responses.ResponseInputItemParamOfMessage("tell me a joke", responses.EasyInputMessageRoleUser),
	}
	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
		Store: openai.Bool(false),
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	history = append(history, outputAsInput(first.Output)...)
	history = append(history, responses.ResponseInputItemParamOfMessage("tell me another", responses.EasyInputMessageRoleUser))
	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
		Store: openai.Bool(false),
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}

func outputAsInput(output []responses.ResponseOutputItemUnion) []responses.ResponseInputItemUnionParam {
	input := make([]responses.ResponseInputItemUnionParam, 0, len(output))
	for _, item := range output {
		var converted responses.ResponseInputItemUnion
		if err := json.Unmarshal([]byte(item.RawJSON()), &converted); err != nil {
			panic(err)
		}
		input = append(input, converted.ToParam())
	}
	return input
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.ArrayList;

var history = new ArrayList<ResponseInputItem>();
history.add(
    ResponseInputItem.ofEasyInputMessage(
        EasyInputMessage.builder()
            .role(EasyInputMessage.Role.USER)
            .content("Tell me a joke.")
            .build()));

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .inputOfResponse(history)
                .store(false)
                .build());
first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
first.output().stream()
    .map(item -> JsonValue.from(item).convert(ResponseInputItem.class))
    .forEach(history::add);
history.add(
    ResponseInputItem.ofEasyInputMessage(
        EasyInputMessage.builder()
            .role(EasyInputMessage.Role.USER)
            .content("Tell me another.")
            .build()));

client
    .responses()
    .create(
        ResponseCreateParams.builder()
            .model("gpt-6-astra")
            .inputOfResponse(history)
            .store(false)
            .build())
    .output()
    .stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

List<ResponseItem> history =
[
    ResponseItem.CreateUserMessageItem("Tell me a joke."),
];

CreateResponseOptions options = new("gpt-6-astra", history)
{
    StoredOutputEnabled = false,
    IncludedProperties =
    {
        IncludedResponseProperty.ReasoningEncryptedContent,
    },
};
ResponseResult first = await client.CreateResponseAsync(options);
Console.WriteLine(first.GetOutputText());

history.AddRange(first.OutputItems);
history.Add(ResponseItem.CreateUserMessageItem("Tell me another."));

options = new("gpt-6-astra", history)
{
    StoredOutputEnabled = false,
    IncludedProperties =
    {
        IncludedResponseProperty.ReasoningEncryptedContent,
    },
};
ResponseResult second = await client.CreateResponseAsync(options);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"

client = OpenAI::Client.new
history = [
  {
    role: :user,
    content: "Tell me a joke."
  }
]

first = client.responses.create(
  model: "gpt-6-astra",
  input: history,
  store: false
)
puts(first.output_text)

history.concat(first.output)
history << {
  role: :user,
  content: "Tell me another."
}

second = client.responses.create(
  model: "gpt-6-astra",
  input: history,
  store: false
)
puts(second.output_text)
OpenAI の API を使うと、会話の状態を自動で管理できるため、ターンごとに入力を手動で渡す必要がなくなります。
Responses API の使用をおすすめします。この API は状態を保持するため、パラメーターを指定するだけで会話のコンテキストを引き継げます。
Chat Completions エンドポイントを使う場合は、前述の手順で状態を手動で管理する必要があります。
Conversations API は Responses API と連携し、会話の状態を固有の永続的な識別子を持つオブジェクトとして長期にわたって保持します。作成した会話オブジェクトは、セッション、デバイス、ジョブをまたいで使い続けられます。
会話には、メッセージ、ツール呼び出し、ツールの出力などのデータが項目として保存されます。
const conversation = await client.conversations.create();
conversation = openai.conversations.create()
conversation, err := client.Conversations.New(context.Background(), conversations.ConversationNewParams{})
if err != nil {
	panic(err)
}
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;

var conversation = client.conversations().create();

System.out.println(conversation.id());
conversation = client.conversations.create
複数ターンのやり取りでは、後続の応答を生成するときに conversation を渡すと、状態が保持され、その後の応答でもコンテキストを共有できます。複数の応答項目を自分でつなぐ必要はありません。
1
2
3
4
5
6
7const response = await client.responses.create({
  model: "gpt-6-astra",
  input: [{ role: "user", content: "What are the five Ds of dodgeball?" }],
  conversation: conversation.id,
});

console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(
    model="gpt-6-astra",
    input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],
    conversation=conversation.id,
)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
	Model: "gpt-6-astra",
	Conversation: responses.ResponseNewParamsConversationUnion{
		OfString: openai.String(conversation.ID),
	},
	Input: responses.ResponseNewParamsInputUnion{
		OfString: openai.String("What are the five Ds of dodgeball?"),
	},
})
if err != nil {
	panic(err)
}
fmt.Println(response.OutputText())
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var conversation = client.conversations().create();

var response =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .conversation(conversation.id())
                .input("What are the five Ds of dodgeball?")
                .build());

response.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7response = client.responses.create(
  model: "gpt-6-astra",
  conversation: conversation.id,
  input: "What are the five Ds of dodgeball?"
)

puts(response.output_text)
会話の状態は、previous_response_id パラメーターを使って、生成した応答間でコンテキストを共有する方法でも管理できます。このパラメーターで応答を順につなぐと、一連のやり取りを会話のスレッドとして扱えます。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: "tell me a joke",
  store: true,
});

console.log(response.output_text);

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  previous_response_id: response.id,
  input: [{ role: "user", content: "explain why this is funny." }],
  store: true,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="tell me a joke",
)
print(response.output_text)

second_response = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input=[{"role": "user", "content": "explain why this is funny."}],
)
print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Tell me a joke."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model:              "gpt-6-astra",
		PreviousResponseID: openai.String(first.ID),
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Explain why this is funny."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder().model("gpt-6-astra").input("Tell me a joke.").build());

first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));

var second =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .input("Explain why this is funny.")
                .previousResponseId(first.id())
                .build());
second.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult first = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Tell me a joke."
);
Console.WriteLine(first.GetOutputText());

ResponseResult second = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Explain why this is funny.",
    previousResponseId: first.Id
);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"

client = OpenAI::Client.new

first = client.responses.create(
  model: "gpt-6-astra",
  input: "Tell me a joke."
)
puts(first.output_text)

second = client.responses.create(
  model: "gpt-6-astra",
  previous_response_id: first.id,
  input: "Explain why this is funny."
)
puts(second.output_text)
Responses API の WebSocket モードでも、会話を続けるときの previous_response_id の働きは HTTP モードと同じです。WebSocket モードではソケット接続を維持し、その接続で response.create イベントを繰り返し送信します。
接続ごとのキャッシュは直近の応答をメモリに保持するため、少ない待ち時間で会話を続けられます。stream_id を使うと、各レーンで最新の応答を保持できます。どの応答から会話が続くかは引き続き previous_response_id で決まるため、別のレーンの応答が利用可能な間は、その応答から新しいレーンをフォークできます。キャッシュにない ID を解決できない場合は、previous_response_id を null に設定し、入力コンテキスト全体を含めて新しいターンを送信してください。
応答オブジェクトはデフォルトで 30 日間保存されます。ダッシュボードのログページで確認できるほか、API 経由で取得することもできます。応答の作成時に store を false に設定すると、保存を無効にできます。
会話オブジェクトとその中の項目には、30 日間の TTL(有効期間)は適用されません。会話に紐づけた応答の項目も、30 日間の TTL なしで保存されます。
OpenAI は、お客様の明示的な同意がない限り、API 経由で送信されたデータをモデルのトレーニングに使用しません。詳細はこちらをご覧ください。
previous_response_id を使う場合も、一連の応答でそれまでに使用した入力トークンは、すべて API の入力トークンとして課金されます。
コンテキストウィンドウの仕組みを理解しておくと、会話のスレッドを作成し、モデルとのやり取りを通じて状態を管理しやすくなります。
コンテキストウィンドウは、1 回のリクエストで使用できるトークン数の上限です。この上限には、入力トークン、出力トークン、推論トークンが含まれます。使用するモデルのコンテキストウィンドウの大きさは、モデルの詳細で確認できます。
入力が複雑になったり、会話に含めるターンが増えたりすると、出力トークンとコンテキストウィンドウの両方の上限を考慮する必要があります。モデルの入出力量はトークン単位で計測されます。モデルは入力をトークンに分解して内容や意図を分析し、トークンを組み合わせて筋の通った出力を生成します。1 回のテキスト生成リクエストの処理中に使用できるトークン数には、モデルごとに上限があります。
- 出力トークンは、プロンプトに応じてモデルが生成するトークンです。出力トークン数の上限はモデルによって異なります。たとえば、
gpt-4o-2024-08-06 は最大 16,384 トークンを出力できます。
- コンテキストウィンドウは、入力と出力に使用できるトークンの合計数の上限です。モデルによっては推論トークンもこの合計に含まれます。モデルごとのコンテキストウィンドウの上限を比較できます。たとえば、
gpt-4o-2024-08-06 のコンテキストウィンドウは合計 128,000 トークンです。
モデルに渡すコンテキストやデータ、例などを追加してプロンプトが大きくなると、モデルのコンテキストウィンドウの上限を超え、出力が途中で切れることがあります。
トークナイザーツールは tiktoken ライブラリを使って構築されており、任意の文字列のトークン数を確認できます。
たとえば、Chat Completions に o1 モデルを指定して API リクエストを送ると、次のトークン数がコンテキストウィンドウの合計に算入されます。
- 入力トークン(
messages 配列に含めて Chat Completions に渡す入力)
- 出力トークン(プロンプトに応じて生成されるトークン)
- 推論トークン(モデルが応答を組み立てるために使うトークン)
たとえば、Responses API に o1 モデルなどの推論に対応したモデルを指定してリクエストを送ると、次のトークン数がコンテキストウィンドウの合計に算入されます。
- 入力トークン(
input 配列に含めて Responses API に渡す入力)
- 出力トークン(プロンプトに応じて生成されるトークン)
- 推論トークン(モデルが応答を組み立てるために使うトークン)
生成されたトークンのうち、コンテキストウィンドウの上限を超えた分は、API の応答で切り捨てられることがあります。
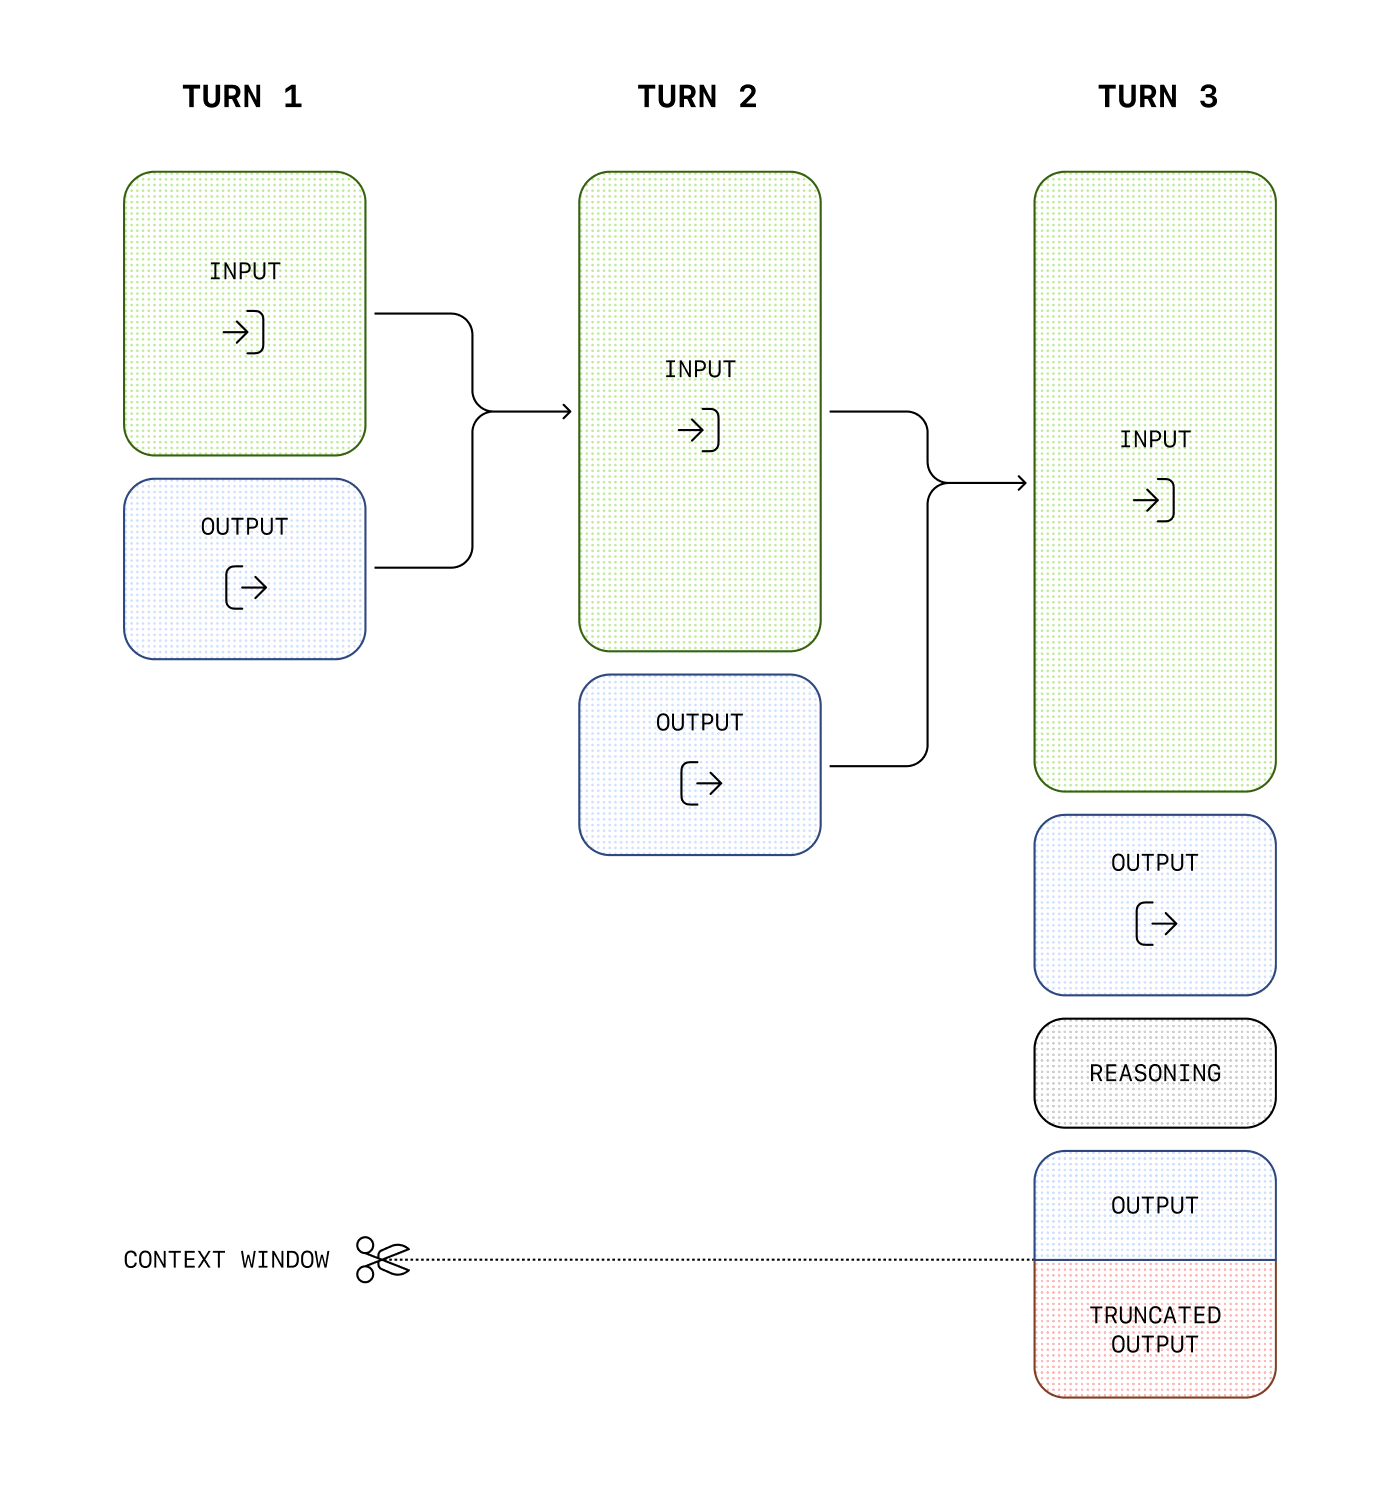
メッセージで使用するトークン数は、トークナイザーツールで見積もれます。
コンパクションの詳しい手順は、コンパクションのガイドに掲載しています。
より具体的な例やユースケースは OpenAI Cookbook をご覧ください。API を使ってモデルの機能を拡張する方法は、次のガイドで説明しています。
