
LLM の回答の正確さと動作の一貫性を高める方法
LLM の最適化は簡単ではありません。
私たちはスタートアップから大企業まで、多くの開発者と取り組んできました。最適化を難しくしているのは、どの現場でも次のような判断です。
- 精度を高めるには何から始めればよいかを見極めること
- いつ、どの手法を使うかを判断すること
- 本番運用に十分な精度を見定めること
本稿では、LLM の精度と動作を最適化するための考え方を紹介します。プロンプトエンジニアリング、検索拡張生成(RAG)、ファインチューニングを取り上げ、それぞれをいつ、どのように使うか、またどこでつまずきやすいかを説明します。
読み進める際には、ご自身のユースケースで何をもって正確とするのかを考えてみてください。たとえば、出来の悪い広告文を人が手直しする場合と、顧客に 100 ドルを返金するはずが 1,000 ドルを返金してしまう場合では、誤りの重みが違います。LLM の精度を議論する前に、失敗したときのコストと、成功したときの節約額や収益をおおまかに把握しておきましょう。本稿の最後で、本番運用に「十分な」精度を考える際に、この点を改めて取り上げます。
LLM 最適化の考え方
最適化の解説では、プロンプトエンジニアリングから始めて、検索拡張生成、ファインチューニングへと順番に進む手順がよく紹介されます。しかし、実際にはこの順序が当てはまらないことも少なくありません。それぞれの手法が解決する問題は異なるので、改善したい点に合った手法を選ぶ必要があります。
LLM の最適化は、次のように 2 つの軸で捉えるとわかりやすくなります。

一般的な LLM タスクでは、図の左下にあるプロンプトエンジニアリングから始めます。プロンプトを試し、結果から学び、評価してベースラインを定めます。その段階で得られた回答を確認し、誤りの原因を見極めたら、次のいずれかの軸に沿って改善します。
- コンテキストの最適化: 必要な背景知識が学習データに含まれていなかった場合、モデルの知識が古い場合、または社内固有の情報が必要な場合は、コンテキストを最適化します。この軸では回答の正確さを最大限に高めます。
- LLM の最適化: 出力が安定せず形式に誤りがある場合、口調や文体が適切でない場合、または決められた推論の手順を一貫してたどれない場合は、LLM を最適化します。この軸では動作の一貫性を最大限に高めます。
実際の最適化では、結果を評価し、改善方法について仮説を立てて試し、再度評価して次の手を考えるというサイクルを繰り返します。典型的な流れを見てみましょう。
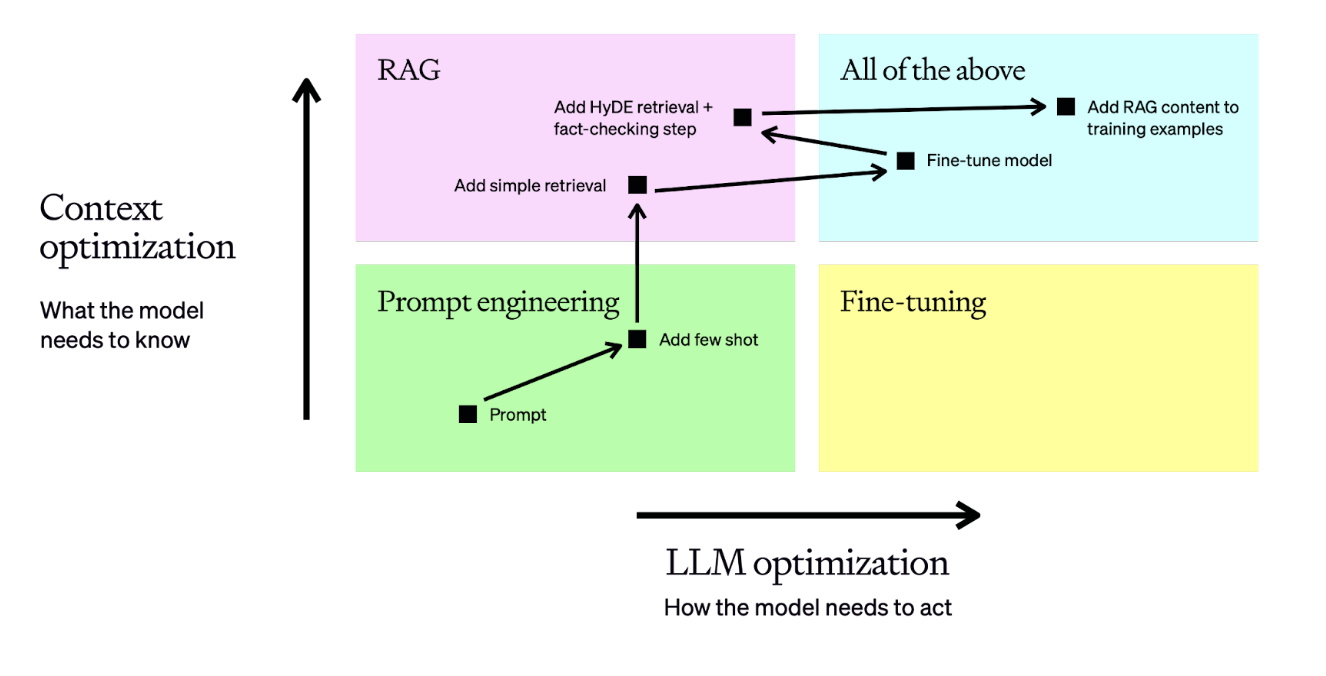
この例では、次の手順で進めます。
- まずプロンプトを用意し、その性能を評価します。
- 固定のフューショット例を追加します。これにより、結果の一貫性が高まると期待できます。
- 質問に応じてフューショット例を動的に取得する検索ステップを追加します。各入力に合ったコンテキストを渡すことで性能が向上します。
- 50 件以上の例を含むデータセットを用意し、モデルをファインチューニングして一貫性を高めます。
- 検索を調整し、ハルシネーションを検出するためのファクトチェックを追加して、さらに精度を高めます。
- 改善した RAG 入力を含む新しい学習例を使い、ファインチューニング済みのモデルを再学習します。
これは、難しい業務課題に取り組む際の典型的な最適化の流れです。各段階で、より関連性の高いコンテキストが必要なのか、モデルの動作をもっと安定させる必要があるのかを判断できます。それがわかれば、改善に向けて最初にどこに手を入れるかが決まります。
この考え方を踏まえて、それぞれの領域で実際に使える手法を見ていきましょう。まずは図の左下にあるプロンプトエンジニアリングです。
プロンプトエンジニアリング
一般に、最初に取り組むのに最も適しているのはプロンプトエンジニアリングです**。要約、翻訳、コード生成など、ゼロショットで本番運用に必要な精度と一貫性を達成できるユースケースでは、多くの場合これだけで十分です。
プロンプトエンジニアリングから始めると、そのユースケースで何をもって正確とするかを明確にできます。最初に行うのは入力を 1 つ渡すことなので、返ってきた出力が期待どおりかどうかを判断できなければなりません。期待と違った場合は、なぜ違ったのかを調べると、次の改善にどの手法を使うべきかが見えてきます。
まずはシンプルなプロンプトを用意し、期待する出力を具体的に思い描きます。次に、コンテキスト、指示、例を加えて、望む出力が得られるまでプロンプトを調整します。
最適化の方法
ここでは主に、OpenAI API ドキュメントのプロンプトエンジニアリングガイドで紹介している方法を使います。各方法がコンテキスト、LLM、またはその両方の改善にどう役立つかを次の表に示します。
| 方法 | コンテキストの最適化 | LLM の最適化 |
|---|---|---|
| 明確な指示を書く | X | |
| 複雑なタスクを簡単なサブタスクに分割する | X | X |
| GPT に「考える」時間を与える | X | |
| 変更の効果を体系的にテストする | X | X |
| 参照用のテキストを提供する | X | |
| 外部ツールを使う | X |
表だけでは具体的な使い方をイメージしにくいので、実例で試してみましょう。ここでは、gpt-4-turbo を使ってアイスランド語の文を訂正します。
ここまでで、プロンプトエンジニアリングが出発点として適していること、そして調整の仕方によって性能をかなり高められることがわかりました。
ただし、プロンプトエンジニアリングの最大の課題は、適用範囲を広げると限界に突き当たりやすいことです。固定のコンテキストに情報を追加するだけでは扱いきれないほど幅広い問題に対応するには、コンテキストを動的に渡す必要があります。また、フューショット例だけでは、求められる動作の一貫性に届かないこともあります。
長いコンテキストを扱えるモデルでは、プロンプトエンジニアリングの適用範囲が広がります。ただし、複雑な指示を含む非常に長いプロンプトでは、モデルが全体に注意を向け続けるのが難しくなることがあります。必ずコンテキストの長さを変えて評価し、途中の情報を見落とす現象が起きていないか確かめましょう。この現象は「Lost in the middle」と呼ばれ、LLM が一度に与えられたすべてのトークンに均等に注意を向けられないことを指します。その結果、一見ランダムに情報を見落とすことがあります。長いコンテキストを使う場合は、十分な評価を組み合わせる必要があります。オープンソースの貢献者である Greg Kamradt 氏は、干し草の山から針を探す評価(NITA)を作成しました。長い文書のさまざまな位置に特定の情報を埋め込み、それをどの程度正しく取り出せるかを評価するものです。この評価から、長いコンテキストの課題がわかります。すべての情報をコンテキストに入れれば検索の手順は大幅に簡素化できますが、その分、精度が犠牲になります。
では、プロンプトエンジニアリングだけで実際にどこまで改善できるのでしょうか。答えはユースケースによって異なり、判断の根拠となるのが評価です。
評価
この段階で得たい成果は、よく練られたプロンプトと、質問と正解を組にした評価セットです。20 組以上の質問と正解を用意し、失敗例を詳しく調べて原因の仮説を立てられれば、より高度な最適化手法を試すためのベースラインが整います。
次の手法に進む前に、改善を素早く繰り返せるよう、評価の自動化も検討しましょう。実際に効果があった方法には、次のようなものがあります。
- 評価指標として ROUGE や BERTScore を使い、おおよその傾向をつかみます。人による評価との相関はそれほど強くありませんが、今回の変更でモデルの出力がどれだけ変わったかを手早く把握できます。
- G-Eval の論文で紹介されているように、GPT-4 を評価者として使います。LLM に採点表を渡し、できるだけ客観的に出力を評価させます。
詳しくは、これらの方法を実例に沿って試せるクックブックをご覧ください。
最適化手法の選び方
プロンプトエンジニアリングを行い、評価セットも用意したのに、モデルが期待どおりに動かないとします。次に重要なのは、どこで失敗しているかを診断し、改善に最も適した手法を見極めることです。
判断の基本となる考え方を次の図に示します。
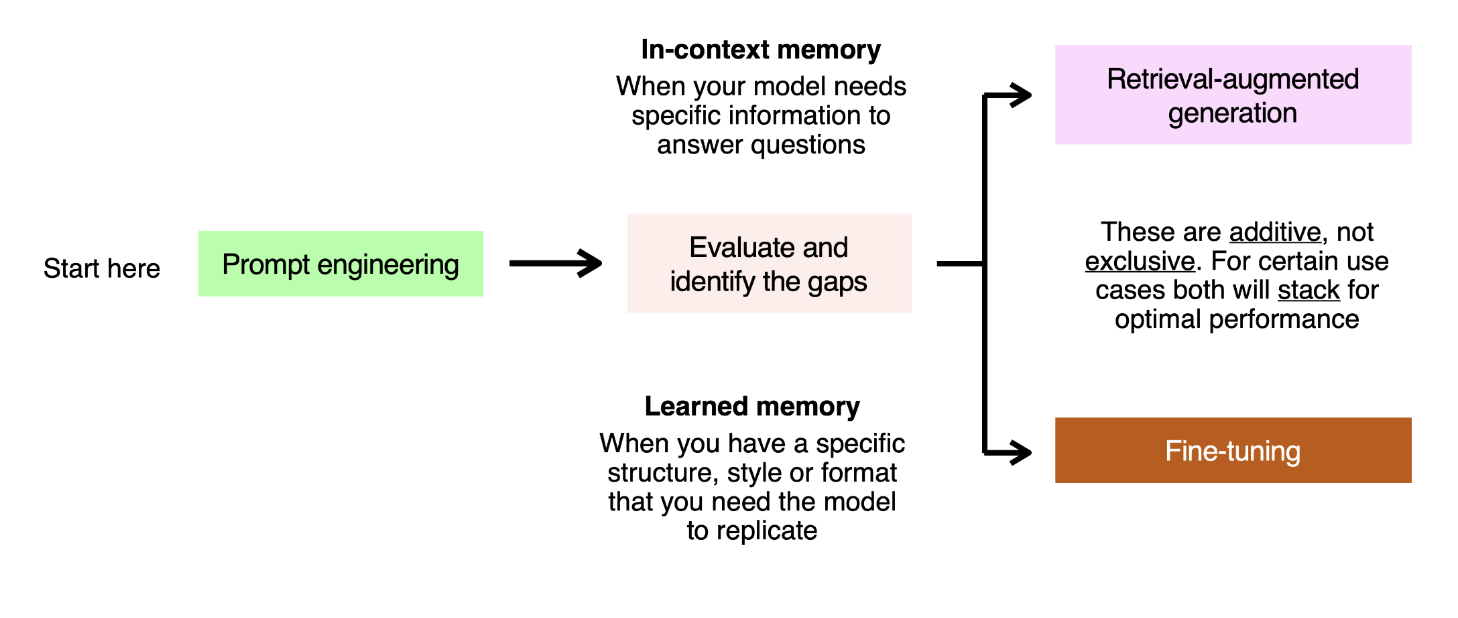
評価で正解できなかった質問ごとに、コンテキスト内の記憶と学習による記憶のどちらに問題があるかを考えます。たとえば、試験で正解するために、次の 2 つの方法が考えられます。
- 過去 6 か月間、授業に出席し、ある概念が実際にどう働くかを多くの例で繰り返し学びました。これが学習による記憶です。LLM では、プロンプトと期待する回答の例を示し、モデルにそこから学習させます。
- 手元に教科書があり、解答に必要な情報を調べられます。これがコンテキスト内の記憶です。LLM では、関連情報をコンテキストウィンドウに入れることで対処します。プロンプトエンジニアリングで固定の情報を渡す方法も、RAG で大規模に自動化する方法もあります。
この 2 つの最適化手法は併用でき、効果を積み重ねられます。ユースケースによっては、最適な性能を得るために両方が必要です。
まず、短期記憶に相当する部分に問題があると仮定しましょう。この場合には RAG を使います。
検索拡張生成(RAG)
RAG では、コンテンツを検索し、その情報で LLM のプロンプトを拡張してから回答を生成します。モデルがタスクを解決するために特定分野のコンテキストを参照できるようにする手法です。
RAG は、LLM の精度と一貫性を高めるうえで非常に有効です。OpenAI の顧客による最大規模の導入事例の多くは、プロンプトエンジニアリングと RAG だけで実現しています。
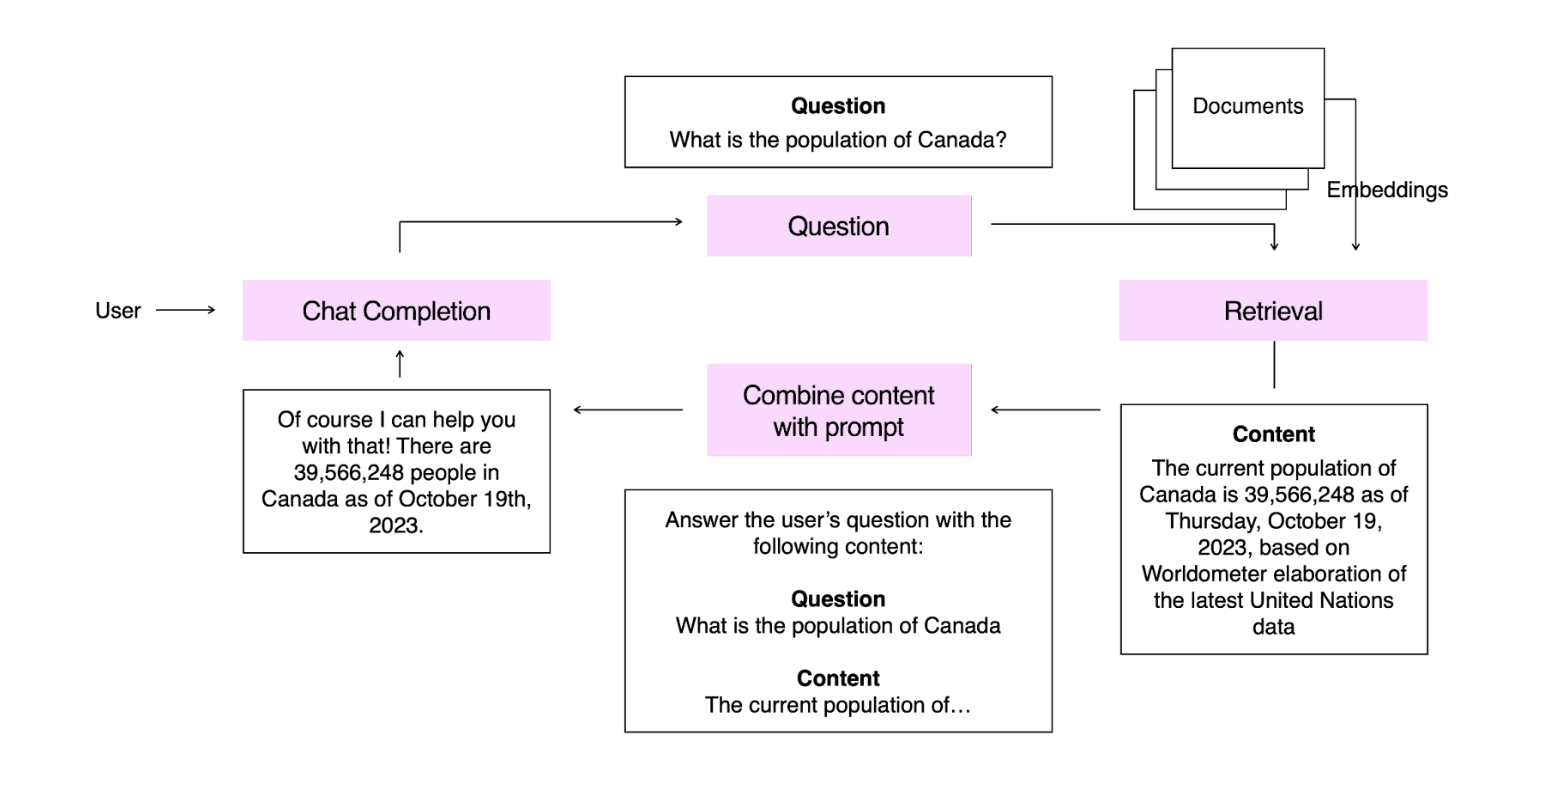
この例では、統計情報を収録したナレッジベースの内容をあらかじめ埋め込みベクトルに変換しています。ユーザーが質問すると、その質問も埋め込みベクトルに変換し、ナレッジベースから最も関連性の高い内容を検索します。その内容をモデルに渡すと、モデルが質問に回答します。
RAG アプリケーションでは、新たに検索も最適化の対象になります。RAG を機能させるには、適切なコンテキストをモデルに渡し、そのうえでモデルが正しく回答しているかを評価する必要があります。この 2 点を組み合わせると、RAG の評価は次の図のように整理できます。
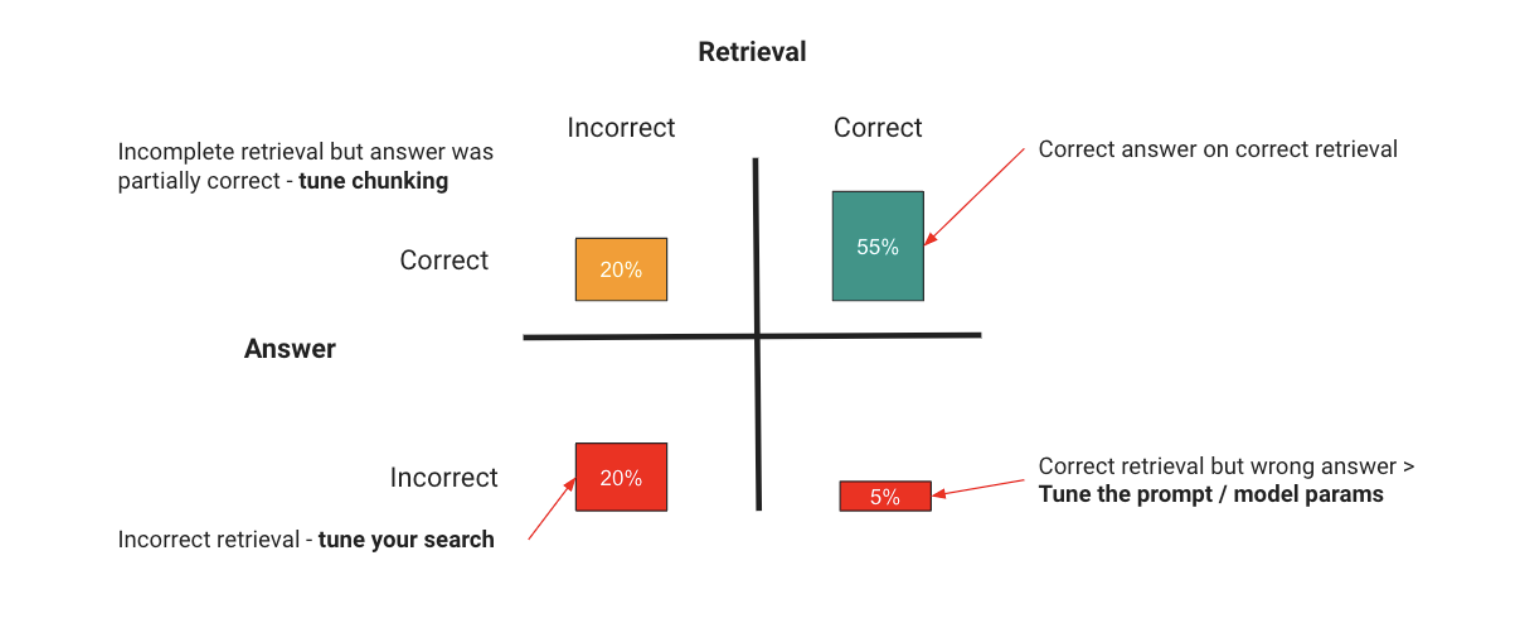
RAG アプリケーションで問題が起こり得るのは、次の 2 か所です。
| 対象 | 問題 | 対処方法 |
|---|---|---|
| 検索 | 誤ったコンテキストを渡すと、モデルは正しく回答できません。無関係なコンテキストが多すぎる場合も、必要な情報が埋もれ、ハルシネーションの原因になります。 | 次のような方法で検索を最適化します。 - 適切な結果が返るように検索を調整する - 検索結果に含まれるノイズを減らす - 各検索結果に含める情報を増やす これらは一例です。RAG の性能調整はそれ自体が一つの専門分野で、LlamaIndex や LangChain などのライブラリにはさまざまな調整方法が用意されています。 |
| LLM | 適切なコンテキストを渡しても、モデルがそれを正しく使えないことがあります。 | プロンプトエンジニアリングで、モデルへの指示とモデルが用いる手順を改善します。例を示すと精度が上がる場合は、ファインチューニングも取り入れます。 |
基本は冒頭で紹介した考え方と同じです。評価を通じて問題の箇所を特定し、それを修正するための最適化を行います。RAG で変わるのは、検討すべき軸に検索が加わる点です。
RAG が解決できるのは、コンテキスト内学習に関する問題です。一方、多くのユースケースでは、LLM がタスクを習得し、安定して確実に実行できるかどうかが課題になります。この場合に使うのがファインチューニングです。
ファインチューニング
学習による記憶に問題がある場合、多くの開発者は、対象分野に特化した比較的小さなデータセットで LLM を追加学習させ、特定のタスクに最適化します。これをファインチューニングと呼びます。
ファインチューニングを行う目的は、通常、次の 2 つのいずれかです。
- 特定のタスクでモデルの精度を高めるため: タスクを正しく実行した例を数多く示し、そのタスクに特化したデータでモデルを学習させることで、学習による記憶の問題を解決します。
- モデルの効率を高めるため: より少ないトークン、またはより小さなモデルで同じ精度を達成します。
ファインチューニングは、学習例を集めたデータセットの準備から始まります。学習例はモデルが実運用で受け取る入力を忠実に反映している必要があるため、この準備が最も重要です。
多くの顧客がプロンプトベーキングと呼ばれる方法を使っています。試験運用中にプロンプトの入力と出力を幅広く記録し、そのログから例を選び抜くことで、実際の利用状況を反映した効果的な学習セットを作成できます。
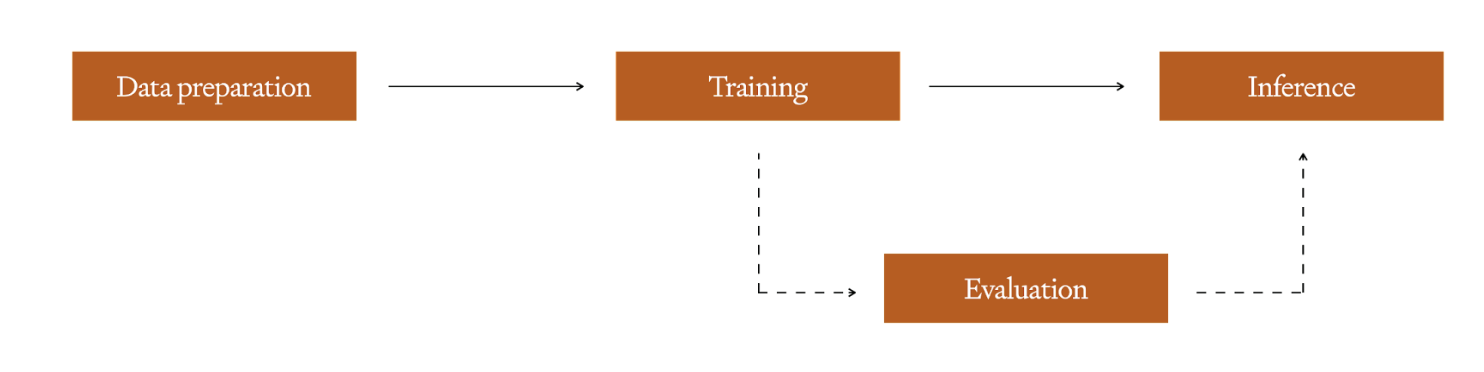
データセットを整えたら、学習を実行してファインチューニング済みのモデルを作成します。利用する学習プラットフォームやフレームワークによっては、ほかの機械学習モデルと同様に、ハイパーパラメーターを調整できます。過学習を検出できるよう、学習後の評価に使うデータは必ず学習データとは別に確保しておくことを推奨します。良質な学習セットの作り方については、ファインチューニングのドキュメントにあるガイドをご覧ください。学習が完了すると、新しいファインチューニング済みモデルを推論に使用できます。
ここでは、OpenAI のモデルカスタマイズ機能の利用事例をもとに、ファインチューニングの効果を高める方法を紹介します。基本的な考え方は、他社のサービスやオープンソースのツールにも当てはまります。
- プロンプトエンジニアリングから始める: プロンプトエンジニアリングの段階で、ベースラインに使える評価セットを整えておきます。基本となるプロンプトに手応えを得るまで、少ない投資で試行錯誤できます。
- 少数の質の高い例から始める: 基盤モデルをファインチューニングする場合、学習データは量より質が重要です。まずは 50 件以上の例で学習して評価します。必要な精度に届かず、誤答の原因がコンテキストではなく動作やその一貫性にある場合は、学習セットを増やします。
- 実運用を代表する例を選ぶ: よくある落とし穴の一つは、ファインチューニング用の例と、本番で LLM に渡される入力とで、書式や構成が微妙に異なることです。たとえば RAG アプリケーションでは、検索結果を含む RAG の例でモデルをファインチューニングします。そうすれば、本番で初めてコンテキストの使い方をゼロショットで判断させずに済みます。
各手法の組み合わせ
これらの手法は組み合わせて使えます。初期の評価でコンテキストと動作の両方に問題が見つかった場合、本番のシステムではファインチューニングと RAG の両方を使うことになるかもしれません。併用すれば、それぞれの弱点を補えます。主な利点は次のとおりです。
- ファインチューニングにより、プロンプトエンジニアリングに必要なトークンを最小限に抑えられます。プロンプト内の指示やフューショット例の代わりに、多数の学習例を使って一貫した動作をモデルに定着させます。
- 複雑な動作も、十分なファインチューニングを通じてモデルに習得させられます。
- RAG を使ってコンテキストを追加し、最新の情報やユースケース固有の情報をモデルに渡せます。
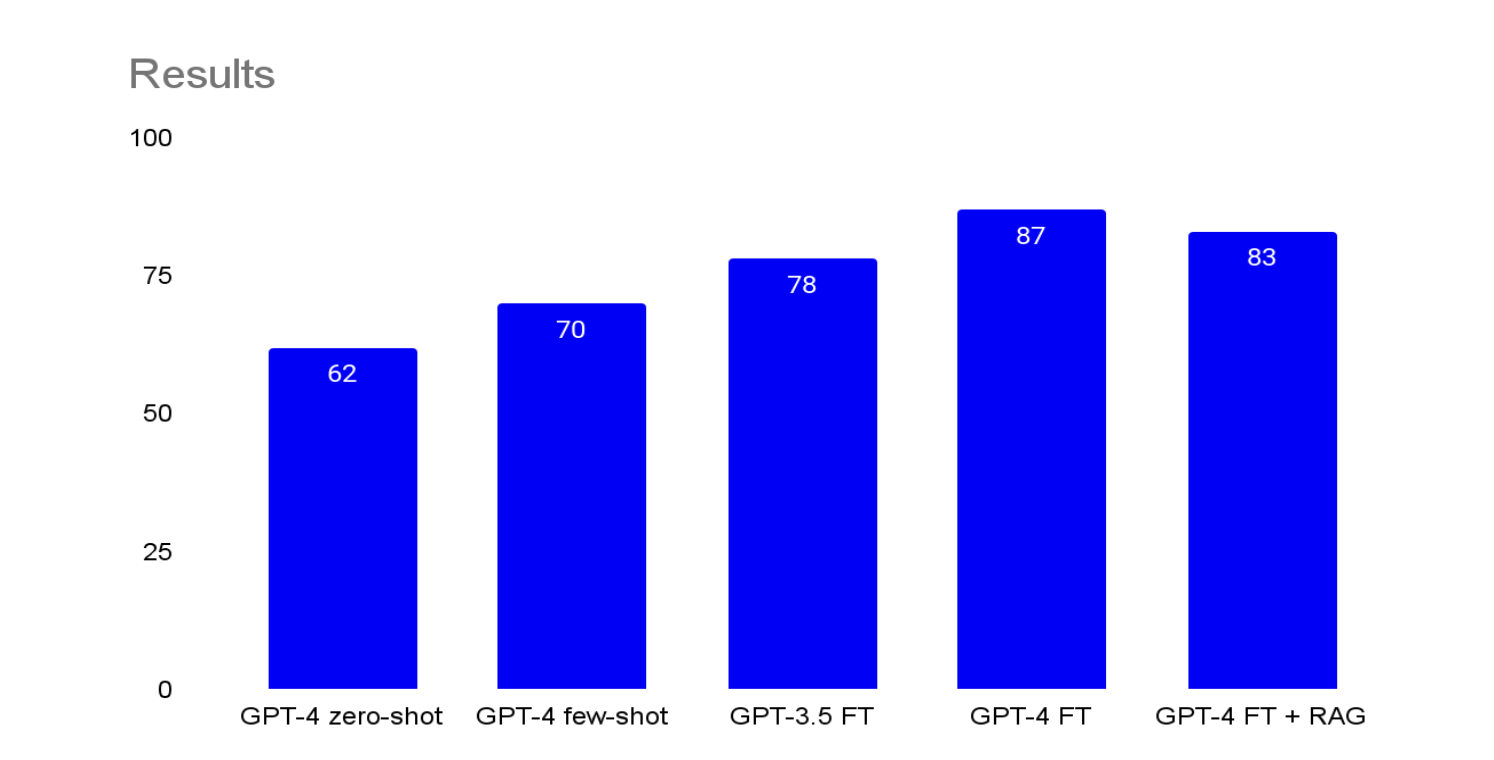 調整方法別の BLEU スコア(100 点満点)
ここまでで、RAG とファインチューニングがそれぞれどのような場合に適しているかを見てきました。もう一つ考慮したいのが、これらを導入すると、改善を繰り返すのに時間がかかるという点です。
- RAG では、LLM の動作に加えて検索も調整する必要があります。
- ファインチューニングでは、追加の調整を行うたびに学習を再実行し、学習セットと検証セットを管理する必要があります。
どちらも手間と時間がかかることがあり、LLM アプリケーションが複雑になるにつれて、変更によって以前は正しく処理できたケースで問題が起きることもあります。本稿で特に覚えておいてほしいのは、複雑な RAG やファインチューニングを導入する前に、基本的な手法で可能な限り精度を高めることです。高度な手法だからという理由で両方を使うのではなく、達成したい精度を基準に選びましょう。
本番運用に「十分な」精度
LLM の精度向上には際限がありません。既製の手法だけで 99.999% の精度に達することはまず期待できません。では、どの程度の精度で十分だと判断すればよいのでしょうか。ここでは、安心して LLM を本番に導入するための判断基準と、導入したシステムのリスクを管理する方法を考えます。
これには、ビジネスと技術の両面から考えると役立ちます。それぞれの基本的な考え方を紹介し、カスタマーサービスのヘルプデスクを例に、両面でどのようにリスクを管理するかを見ていきます。
ビジネス面
ルールベースのシステムや従来の機械学習システム、あるいは人による対応では、どのような結果になるかを比較的予測できます。それに慣れた事業部門にとって、LLM を信頼して業務を任せるのは簡単ではありません。どんな失敗が起こり得るかをあらかじめ列挙できず、予測も難しいシステムでは、導入の判断が難しくなります。
カスタマーサービスの事例では、次の進め方が有効でした。
まず、主な成功パターンと失敗パターンを洗い出し、それぞれの金銭的な影響を見積もります。これにより、試験運用の成績から、システムでどれだけ節約できそうか、どれだけのコストがかかりそうかを具体的に示せます。
- たとえば、以前は人が解決していた問い合わせを AI が解決できれば、1 件あたり 20 ドルを節約できるとします。
- 人による対応が不要なのに担当者に引き継いだ場合の推定コストは、1 件あたり 40 ドル
- 最悪の場合、顧客が AI の対応に不満を感じて解約し、1,000 ドルの損失が発生します。失敗したケースの 5% でこれが起きると仮定します。
| 事象 | 1 件あたりの価値 | 件数 | 合計金額 |
|---|---|---|---|
| AI が解決 | +20 | 815 | $16,300 |
| AI が失敗(担当者への引き継ぎ) | -40 | 175.75 | $7,030 |
| AI が失敗(解約) | -1000 | 9.25 | $9,250 |
| 収支 | +20 | ||
| 損益分岐点となる精度 | 81.5% |
もう一つ行ったのは、業務全体への影響を把握するために、実際の対応結果から指標を測定することです。カスタマーサービスであれば、たとえば次のような比較ができます。
- 人だけで対応した場合と AI が対応した場合の顧客満足度(CSAT)スコア
- 対応済みの案件を事後にレビューして測定した、人と AI の判断の正確さ
- 人が対応した場合と AI が対応した場合の解決までの時間
この事例では、数回の試験運用で具体的なデータが得られたことで、次の 2 つの判断ができました。
- LLM を使ったシステムから人への引き継ぎが想定より多くても、既存のシステムに比べて運用コストは大幅に削減できました。つまり、正しく処理できなかった 15% の大半が早めに人へ引き継いだケースであれば、精度が 85% でも許容できると判断できます。
- 不正行為に関する案件で誤った解決策を選ぶなど、失敗のコストが非常に高い場合は、人が対応を主導し、AI は補助に回ることにしました。この場合は、判断の正確さを示す指標をもとに、すべてを AI に任せるのは難しいと判断しました。
技術面
技術面での役割はより明確です。期待できる価値と失敗時のコストを事業部門が把握したら、技術チームは、失敗してもユーザーの体験を損なわずに対応できるシステムを構築します。
もう一度カスタマーサービスを例に、顧客の意図を 85% の精度で判定できるモデルがあるとします。判定を誤る残り 15% の影響を小さくするために、技術チームは次のような工夫ができます。
- 判定に自信がない場合は顧客に追加情報を尋ねるよう、プロンプトを設計します。初回の判定精度は下がるかもしれませんが、2 回のやり取りで意図を判定できれば、最終的な精度は上がる可能性があります。
- 二次対応のアシスタントが意図判定の段階に差し戻せるようにします。ユーザーの待ち時間は少し増えますが、誤った判定からシステムが自力で立て直せます。
- 意図がはっきりしない場合は人に引き継ぐよう、プロンプトを設計します。短期的には運用コストの削減幅が小さくなりますが、長期的には顧客の解約リスクを抑えられる可能性があります。
こうした判断はユーザー体験に反映されます。精度を高める分だけ応答が遅くなることもあれば、人による介入が増えることもあります。その影響は、ビジネス面で説明したコストモデルに反映します。
このようにビジネス面と技術面の判断を分けて考えると、業務の実情に即した精度目標を設定できます。
実務への応用
本稿では、LLM の精度を最大限に高めるための考え方と手法、本番運用に必要な精度の判断方法を紹介しました。この枠組みと手法を使えば、本番導入までの道筋を繰り返し組み立てられます。実際にどのような成果が得られるかを知りたい方は、Morgan Stanley や Klarna などの顧客事例をご覧ください。
皆さんの取り組みがうまくいくことを願っています。これらの手法を使ってどのようなものを作っていただけるか、楽しみにしています。