
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.埋め込みとは
OpenAI のテキスト埋め込みを使うと、文字列同士の関連度を測定できます。埋め込みの代表的な用途は次のとおりです。
- 検索(検索クエリとの関連度順に結果を表示)
- クラスタリング(類似度に基づいて文字列をグループ化)
- レコメンド(関連するテキストを持つ項目を推薦)
- 異常検知(他のデータとの関連度が低い外れ値を検出)
- 多様性の測定(類似度の分布を分析)
- 分類(各文字列に最も類似度の高いラベルを割り当て)
埋め込みは、浮動小数点数を並べたベクトル(リスト)です。2 つのベクトル間の距離で関連度を測ります。距離が短いほど関連度が高く、長いほど関連度が低いと考えられます。
埋め込みの料金については、料金ページをご覧ください。リクエストの料金はトークン数に応じて決まり、入力に含まれるトークンが課金対象です。
埋め込みの取得方法
埋め込みを取得するには、埋め込み API エンドポイントに、文字列と埋め込みモデル名(例:text-embedding-3-small)を送信します。
1
2
3
4
5
6
7
8
9
10import OpenAI from "openai";
const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "Your text string goes here",
  encoding_format: "float",
});

console.log(embedding);
1
2
3
4
5
6
7
8
9from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(
input="Your text string goes here", model="text-embedding-3-small"
)
print(response.data[0].embedding)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
embedding, err := client.Embeddings.New(context.Background(), openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{
OfString: openai.String("Your text string goes here."),
},
})
if err != nil {
panic(err)
}
fmt.Println(len(embedding.Data[0].Embedding))
}1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("The food was delicious and the waiter...")
.build());
System.out.println(embedding.data().get(0).embedding());1
2
3
4
5
6
7
8
9
10
11using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync(
"The food was delicious and the waiter was friendly."
);
Console.WriteLine($"Dimensions: {embedding.ToFloats().Length}");1
2
3
4
5
6
7
8
9
10require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "The food was delicious and the waiter..."
)
puts(response.data.fetch(0).embedding)1
2
3
4
5
6
7curl https://api.openai.com/v1/embeddings \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"input": "Your text string goes here",
"model": "text-embedding-3-small"
}'レスポンスには、埋め込みベクトル(浮動小数点数のリスト)と付随するメタデータが含まれます。埋め込みベクトルを取り出してベクトルデータベースに保存すると、さまざまな用途に活用できます。
123456789101112131415161718{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422, -0.005336422007530928, -4.547132266452536e-5,
        -0.024047505110502243
      ]
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}
埋め込みベクトルのデフォルトの次元数は、1536(text-embedding-3-small)または 3072(text-embedding-3-large)です。概念を表現する能力を保ちながら次元数を減らすには、dimensions パラメータを指定します。埋め込みの次元数について詳しくは、埋め込みの活用例をご覧ください。
埋め込みモデル
OpenAI は、高性能な第 3 世代の埋め込みモデルを 2 種類提供しています。モデル ID に -3 が含まれているのが目印です。詳しくは、埋め込みモデル v3 の発表記事をご覧ください。
料金は入力トークン単位で計算されます。次の表は、1 ページあたり約 800 トークンと仮定した場合に、1 米ドルで処理できるテキストのページ数の目安です。
| モデル | 1 米ドルあたりのページ数(概算) | MTEB での評価スコア | 最大入力トークン数 |
|---|---|---|---|
| text-embedding-3-small | 62,500 | 62.3% | 8192 |
| text-embedding-3-large | 9,615 | 64.6% | 8192 |
| text-embedding-ada-002 | 12,500 | 61.0% | 8192 |
活用例
Amazon の食品レビューデータセットを使って、代表的な活用例を紹介します。
レビューの埋め込みの取得
このデータセットには、2012 年 10 月までに Amazon ユーザーが投稿した食品レビューが計 568,454 件含まれています。ここでは、例として直近の 1,000 件を使います。レビューは英語で書かれており、肯定的または否定的な評価に偏る傾向があります。各レビューには、ProductId、UserId、Score、タイトル(Summary)、本文(Text)が含まれます。次に例を示します。
| 商品 ID | ユーザー ID | 評価 | タイトル | 本文 |
|---|---|---|---|---|
| B001E4KFG0 | A3SGXH7AUHU8GW | 5 | Good Quality Dog Food | I have bought several of the Vitality canned… |
| B00813GRG4 | A1D87F6ZCVE5NK | 1 | Not as Advertised | Product arrived labeled as Jumbo Salted Peanut… |
次の例では、レビューのタイトルと本文を 1 つのテキストにまとめます。モデルはこのテキストをエンコードし、1 つの埋め込みベクトルを出力します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import { mkdir, writeFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const reviews = ["A rich cup of coffee.", "A bright herbal tea."];

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: reviews.map((review) => review.replaceAll("\n", " ")),
});

const csvField = (value) => `"${value.replaceAll('"', '""')}"`;
const rows = response.data.map(({ embedding }, index) =>
  [csvField(reviews[index]), csvField(JSON.stringify(embedding))].join(",")
);

await mkdir("output", { recursive: true });
await writeFile(
  "output/embedded_1k_reviews.csv",
  ["combined,ada_embedding", ...rows].join("\n") + "\n"
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17from pathlib import Path
from openai import OpenAI
client = OpenAI()
def get_embedding(text, model="text-embedding-3-small"):
text = text.replace("\n", " ")
return client.embeddings.create(input=[text], model=model).data[0].embedding
df["ada_embedding"] = df.combined.apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
Path("output").mkdir(exist_ok=True)
df.to_csv("output/embedded_1k_reviews.csv", index=False)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68import (
"context"
"encoding/csv"
"encoding/json"
"fmt"
"log"
"os"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
reviews := []string{"A rich cup of coffee.", "A bright herbal tea."}
if err := os.MkdirAll("output", 0755); err != nil {
return err
}
file, err := os.Create("output/embedded_1k_reviews.csv")
if err != nil {
return err
}
defer file.Close()
writer := csv.NewWriter(file)
if err := writer.Write([]string{"combined", "ada_embedding"}); err != nil {
return err
}
for _, review := range reviews {
vector, err := embedding(ctx, &client, strings.ReplaceAll(review, "\n", " "))
if err != nil {
return err
}
encoded, err := json.Marshal(vector)
if err != nil {
return err
}
if err := writer.Write([]string{review, string(encoded)}); err != nil {
return err
}
}
writer.Flush()
if err := writer.Error(); err != nil {
return err
}
if err := file.Close(); err != nil {
return err
}
fmt.Println("Saved output/embedded_1k_reviews.csv")
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
static String csvField(String value) {
return "\"" + value.replace("\"", "\"\"") + "\"";
}
List<String> reviews = List.of("A rich cup of coffee.", "A bright herbal tea.");
Path output = Path.of("output", "embedded_1k_reviews.csv");
Files.createDirectories(output.getParent());
try (var writer = Files.newBufferedWriter(output)) {
writer.write("combined,ada_embedding\n");
for (String review : reviews) {
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of(review.replace("\n", " ")))
.build())
.data()
.get(0)
.embedding();
writer.write(csvField(review) + "," + csvField(embedding.toString()) + "\n");
}
}
System.out.println(output);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26using System.Text.Json;
using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] reviews = ["A rich cup of coffee.", "A bright herbal tea."];
Directory.CreateDirectory("output");
using StreamWriter writer = new("output/embedded_1k_reviews.csv");
await writer.WriteLineAsync("combined,ada_embedding");
foreach (string review in reviews)
{
float[] vector = await EmbedAsync(client, review.Replace("\n", " ", StringComparison.Ordinal));
string encoded = JsonSerializer.Serialize(vector);
await writer.WriteLineAsync($"{CsvField(review)},{CsvField(encoded)}");
}
Console.WriteLine("Saved output/embedded_1k_reviews.csv");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static string CsvField(string value) => "\"" + value.Replace("\"", "\"\"", StringComparison.Ordinal) + "\"";1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20require "csv"
require "fileutils"
require "json"
require "openai"
client = OpenAI::Client.new
reviews = ["A rich cup of coffee.", "A bright herbal tea."]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews.map { |review| review.tr("\n", " ") }
)
FileUtils.mkdir_p("output")
CSV.open("output/embedded_1k_reviews.csv", "w") do |csv|
csv << ["combined", "ada_embedding"]
response.data.each do |embedding|
csv << [reviews.fetch(embedding.index), JSON.generate(embedding.embedding)]
end
end保存したファイルからデータを読み込むには、次のコードを実行します。
1
2
3
4
5from ast import literal_eval
import pandas as pd

df = pd.read_csv("output/embedded_1k_reviews.csv")
df["ada_embedding"] = df.ada_embedding.apply(literal_eval).apply(np.array)埋め込みを検索用のベクトルストアに保存する場合など、一般に次元数の多い埋め込みを使うほど、コストが高くなり、計算資源、メモリ、ストレージの消費量も増えます。
新しい 2 種類の埋め込みモデルは、どちらも埋め込みの性能と利用コストのバランスを調整できる手法で学習しています。具体的には、dimensions API パラメータを指定することで、概念を表現する能力を保ちながら埋め込みを短くできます(数列の末尾からいくつかの値を取り除きます)。たとえば MTEB ベンチマークでは、text-embedding-3-large の埋め込みを 256 次元に短縮しても、text-embedding-ada-002 の短縮していない 1536 次元の埋め込みを上回る性能を維持できます。次元数の変更が性能に与える影響について詳しくは、埋め込みモデル v3 の発表記事をご覧ください。
通常は、埋め込みの生成時に dimensions パラメータを指定することをおすすめします。生成後に次元数を変更する必要がある場合もあります。手動で次元数を変更した場合は、次の例のように、変更後の埋め込みベクトルを必ず正規化してください。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import OpenAI from "openai";

const client = new OpenAI();

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: "float",
});

const shortened = response.data[0].embedding.slice(0, 256);
const magnitude = Math.hypot(...shortened);
const normalized = shortened.map((value) =>
  magnitude === 0 ? 0 : value / magnitude
);

console.log(normalized);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI
import numpy as np
client = OpenAI()
def normalize_l2(x):
x = np.array(x)
if x.ndim == 1:
norm = np.linalg.norm(x)
if norm == 0:
return x
return x / norm
else:
norm = np.linalg.norm(x, 2, axis=1, keepdims=True)
return np.where(norm == 0, x, x / norm)
response = client.embeddings.create(
model="text-embedding-3-small", input="Testing 123", encoding_format="float"
)
cut_dim = response.data[0].embedding[:256]
norm_dim = normalize_l2(cut_dim)
print(norm_dim)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
private static List<Double> normalizeL2(List<Float> embedding) {
double norm =
Math.sqrt(embedding.stream().mapToDouble(value -> value.doubleValue() * value).sum());
return embedding.stream().map(value -> norm == 0 ? 0.0 : value / norm).toList();
}
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Testing 123")
.encodingFormat(EmbeddingCreateParams.EncodingFormat.FLOAT)
.build());
List<Float> shortened = embedding.data().get(0).embedding().subList(0, 256);
System.out.println(normalizeL2(shortened));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync("Testing 123");
float[] shortened = embedding.ToFloats().Span[..256].ToArray();
double magnitude = Math.Sqrt(shortened.Sum(value => (double)value * value));
double[] normalized =
magnitude == 0
? shortened.Select(value => (double)value).ToArray()
: shortened.Select(value => value / magnitude).ToArray();
Console.WriteLine(System.Text.Json.JsonSerializer.Serialize(normalized));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "Testing 123",
encoding_format: :float
)
shortened = response.data.fetch(0).embedding.first(256)
magnitude = Math.sqrt(shortened.sum { |value| value**2 })
normalized = shortened.map { |value| magnitude.zero? ? 0 : value / magnitude }
puts(normalized)次元数を動的に変更できるため、用途に応じて埋め込みを柔軟に使い分けられます。たとえば、最大 1024 次元の埋め込みにしか対応していないベクトルデータストアでも、最も高性能な埋め込みモデル text-embedding-3-large を利用できます。dimensions API パラメータに 1024 を指定すると、埋め込みが 3072 次元から 1024 次元に短縮されます。精度は多少下がりますが、ベクトルのサイズを小さくできます。
ユーザーの質問に回答する際に参照したい事実や情報が、モデルの学習データに含まれていないことはよくあります。対処方法の 1 つは、次の例のように、モデルのコンテキストウィンドウに情報を追加することです。多くの用途で効果がありますが、トークンのコストは高くなります。このノートブックでは、この方法と埋め込みを使った検索を比較し、それぞれの利点と制約を検討します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";

const client = new OpenAI();
const article =
  "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
const question = `Use the article below to answer the question. If the answer cannot be found, say "I don't know."

Article:
${article}

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;

const response = await client.chat.completions.create({
  model: "gpt-4.1-mini",
  messages: [
    {
      role: "system",
      content: "You answer questions about the 2022 Winter Olympics.",
    },
    { role: "user", content: question },
  ],
  temperature: 0,
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."
Article:
\"\"\"
{wikipedia_article_on_curling}
\"\"\"
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""
response = client.chat.completions.create(
messages=[
{
"role": "system",
"content": "You answer questions about the 2022 Winter Olympics.",
},
{"role": "user", "content": query},
],
model=GPT_MODEL,
temperature=0,
)
print(response.choices[0].message.content)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import (
"context"
"fmt"
"log"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-4.1-mini", Temperature: openai.Float(0), Messages: []openai.ChatCompletionMessageParamUnion{
openai.SystemMessage("You answer questions about the 2022 Winter Olympics."),
openai.UserMessage("Use the article to answer the question. If the answer cannot be found, write \"I don't know.\"\n\nArticle: At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?")},
})
if err != nil {
return err
}
fmt.Println(completion.Choices[0].Message.Content)
return nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
String article =
"At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
String question =
"Use the below article on the 2022 Winter Olympics to answer the subsequent question. "
+ "If the answer cannot be found, write \"I don't know.\"\n\n"
+ "Article:\n"
+ article
+ "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletionCreateParams params =
ChatCompletionCreateParams.builder()
.model("gpt-4.1-mini")
.addSystemMessage("You answer questions about the 2022 Winter Olympics.")
.addUserMessage(question)
.temperature(0)
.build();
client.chat().completions().create(params).choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12using OpenAI.Chat;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-4.1-mini";
ChatClient client = new(model, key);
string article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
string query = $"Use the article to answer the question. If the answer cannot be found, write I don't know.\nArticle: {article}\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletion result = await client.CompleteChatAsync(
[new SystemChatMessage("You answer questions about the 2022 Winter Olympics."), new UserChatMessage(query)],
new ChatCompletionOptions { Temperature = 0 });
Console.WriteLine(result.Content[0].Text);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."
question = <<~QUESTION
Use the article below to answer the question. If the answer cannot be found, say "I don't know."
Article:
#{article}
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?
QUESTION
response = client.chat.completions.create(
model: "gpt-4.1-mini",
messages: [
{
role: :system,
content: "You answer questions about the 2022 Winter Olympics."
},
{
role: :user,
content: question
}
],
temperature: 0
)
puts(response.choices.fetch(0).message.content)関連度の高い文書を取得するには、クエリの埋め込みベクトルと各文書の埋め込みベクトルのコサイン類似度を計算し、スコアが上位の文書を返します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";

const client = new OpenAI();
const reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...reviews, "delicious beans"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = reviews
  .map((review, index) => ({
    review,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score)
  .slice(0, 3);

console.log(results);
1
2
3
4
5
6
7
8
9
10def search_reviews(df, product_description, n=3, pprint=True):
embedding = get_embedding(product_description, model="text-embedding-3-small")
df["similarities"] = df.ada_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_reviews(df, "delicious beans", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "delicious beans")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> reviews =
List.of(
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange.");
var reviewEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(reviews)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("delicious beans"))
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, reviews.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, reviewEmbeddings.get(index).embedding()))
.reversed())
.limit(3)
.map(reviews::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."];
OpenAIEmbeddingCollection batch = await client.GenerateEmbeddingsAsync(texts);
float[][] vectors = batch.Select(item => item.ToFloats().ToArray()).ToArray();
float[] query = await EmbedAsync(client, "delicious beans");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"
client = OpenAI::Client.new
reviews = [
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews + ["delicious beans"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = reviews.map.with_index do |review, index|
{
review: review,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }.first(3)
puts(results)コード検索の仕組みは、埋め込みを使ったテキスト検索と似ています。ここでは、指定したリポジトリ内のすべての Python ファイルから Python 関数を抽出する方法を示します。次に、text-embedding-3-small モデルを使って各関数をインデックス化します。
コードを検索するには、同じモデルを使って自然言語のクエリを埋め込みに変換します。次に、クエリの埋め込みと各関数の埋め込みのコサイン類似度を計算します。コサイン類似度が高い関数ほど、クエリとの関連度が高いと判断できます。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const client = new OpenAI();
const functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...functions, "Completions API tests"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = functions
  .map((source, index) => ({
    source,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score);

console.log(results);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16df["code_embedding"] = df["code"].apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
def search_functions(df, code_query, n=3, pprint=True, n_lines=7):
embedding = get_embedding(code_query, model="text-embedding-3-small")
df["similarities"] = df.code_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_functions(df, "Completions API tests", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"def add(a, b): return a + b", "def complete(prompt): return prompt"}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "Completions API tests")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> functions =
List.of("def add(a, b): return a + b", "def complete(prompt): return prompt");
var functionEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(functions)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Completions API tests")
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, functions.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, functionEmbeddings.get(index).embedding()))
.reversed())
.map(functions::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["def add(a, b): return a + b", "def complete(prompt): return prompt"];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = await EmbedAsync(client, "Completions API tests");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
functions = [
"function add(a, b) { return a + b; }",
"function complete(prompt) { return prompt; }"
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: functions + ["Completions API tests"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = functions.map.with_index do |source, index|
{
source: source,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }
puts(results)埋め込みベクトル間の距離が短いほど類似度が高いため、埋め込みはレコメンドにも役立ちます。
次の例は、基本的なレコメンドの仕組みを示しています。候補となる文字列のリストと、比較の基準となる文字列を 1 つ受け取ります。それぞれの埋め込みを計算し、基準の文字列との類似度が高い順に候補を並べて返します。リンク先のノートブックでは、この関数を応用して、AG ニュースデータセットから抽出したニュース記事 2,000 件の概要を対象に、指定した記事との類似度が高い上位 5 件の記事を返します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from "openai";

const client = new OpenAI();
const strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: strings,
});

const query = data[0].embedding;
const recommendations = data
  .map(({ embedding }, index) => {
    const dotProduct = embedding.reduce(
      (total, value, dimension) => total + value * query[dimension],
      0
    );
    const similarity =
      dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
    return { index, text: strings[index], similarity };
  })
  .sort((left, right) => right.similarity - left.similarity);

console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings(
strings: list[str],
index_of_source_string: int,
model="text-embedding-3-small",
) -> list[int]:
"""Return nearest neighbors of a given string."""
# get embeddings for all strings
embeddings = [embedding_from_string(string, model=model) for string in strings]
# get the embedding of the source string
query_embedding = embeddings[index_of_source_string]
# get distances between the source embedding and other embeddings (function from embeddings_utils.py)
distances = distances_from_embeddings(
query_embedding, embeddings, distance_metric="cosine"
)
# get indices of nearest neighbors (function from embeddings_utils.py)
indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances(
distances
)
return indices_of_nearest_neighbors1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query := vectors[0]
matches := nearest(query, vectors)
for _, match := range matches {
fmt.Println(match.Index)
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> strings =
List.of(
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly.");
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(strings)
.build())
.data();
List<Float> query = embeddings.get(0).embedding();
var nearestNeighbors =
IntStream.range(0, embeddings.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) -> {
List<Float> candidate = embeddings.get(index).embedding();
double dotProduct = 0;
double queryMagnitude = 0;
double candidateMagnitude = 0;
for (int dimension = 0; dimension < query.size(); dimension++) {
double queryValue = query.get(dimension);
double candidateValue = candidate.get(dimension);
dotProduct += queryValue * candidateValue;
queryMagnitude += queryValue * queryValue;
candidateMagnitude += candidateValue * candidateValue;
}
return 1 - dotProduct / Math.sqrt(queryMagnitude * candidateMagnitude);
}))
.toList();
System.out.println(nearestNeighbors);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = vectors[0];
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked)
{
Console.WriteLine(match.Index);
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31require "openai"
client = OpenAI::Client.new
strings = [
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: strings
)
query = response.data.fetch(0).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
recommendations = response.data.map.with_index do |embedding, index|
{
index: index,
text: strings.fetch(index),
similarity: similarity.call(embedding.embedding)
}
end.sort_by { |recommendation| -recommendation.fetch(:similarity) }
puts(recommendations)埋め込みの次元数は、元のモデルの複雑さによって異なります。この高次元データを可視化するために、t-SNE アルゴリズムを使ってデータを 2 次元に変換します。
各レビューを、投稿者が付けた星の数に応じて色分けします。
- 星 1 つ:赤
- 星 2 つ:濃いオレンジ
- 星 3 つ:金色
- 星 4 つ:ターコイズ
- 星 5 つ:濃い緑
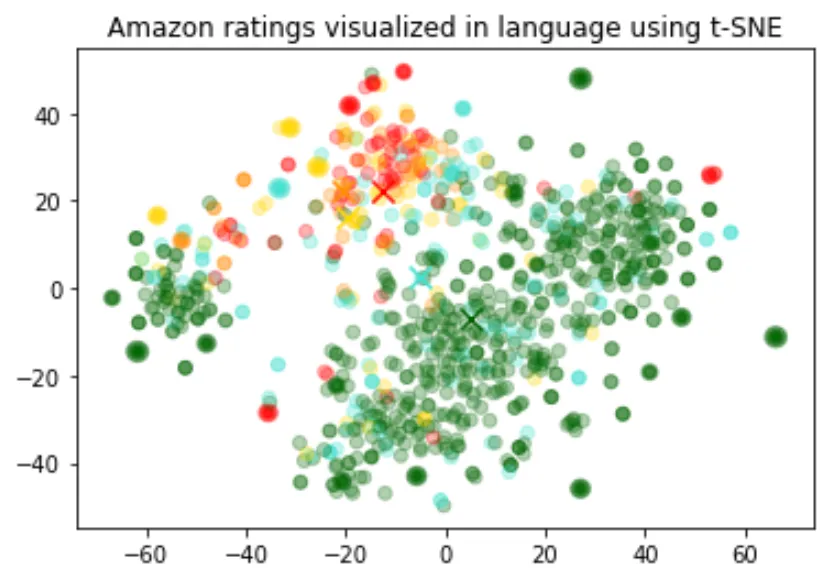
図を見ると、おおよそ 3 つのクラスタに分かれており、そのうちの 1 つでは否定的なレビューが大半を占めているようです。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24from ast import literal_eval
import numpy as np
import pandas as pd
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
import matplotlib

df = pd.read_csv("output/embedded_1k_reviews.csv")
matrix = np.array(df.ada_embedding.apply(literal_eval).to_list())

# Create a t-SNE model and transform the data
tsne = TSNE(
    n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200
)
vis_dims = tsne.fit_transform(matrix)

colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]
x = [x for x, y in vis_dims]
y = [y for x, y in vis_dims]
color_indices = df.Score.values - 1

colormap = matplotlib.colors.ListedColormap(colors)
plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)
plt.title("Amazon ratings visualized in language using t-SNE")機械学習モデルでは、埋め込みを使って自由記述テキストを特徴量に変換できます。予測に関係する入力の一部が自由記述テキストであれば、どの機械学習モデルでも埋め込みを取り入れることで性能が向上します。埋め込みを使ってカテゴリ変数を特徴量に変換することもできます。職種名のようにカテゴリの数が多く、それぞれの名称に意味がある場合に特に有効です。この用途では、一般に検索用の埋め込みよりも類似度測定用の埋め込みのほうが高い性能を発揮します。
埋め込みには一般に、多くの情報が凝縮されています。たとえば、SVD や PCA で入力の次元数をわずか 10% 減らしただけでも、個々の下流タスクの性能はたいてい低下します。
次のコードでは、データを学習用とテスト用に分割します。これらのデータは、続く 2 つの活用例である回帰と分類で使います。
1
2
3
4
5from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    list(df.ada_embedding.values), df.Score, test_size=0.2, random_state=42
)
埋め込みを特徴量として使った回帰
埋め込みを使うと、テキストから数値を予測できます。この例では、レビューの本文から、投稿者が付けた星の数を予測します。埋め込みにはテキストの意味に関する情報が豊富に含まれているため、レビューがごく少数でも、ある程度正確に予測できます。
評価を 1 から 5 までの連続変数とみなし、アルゴリズムが予測値を浮動小数点数で返せるようにします。機械学習アルゴリズムは、予測値と実際の評価の差を最小化します。この例の平均絶対誤差は 0.39 で、予測と実際の評価のずれは平均で星半分未満です。
1
2
3
4
5from sklearn.ensemble import RandomForestRegressor

rfr = RandomForestRegressor(n_estimators=100)
rfr.fit(X_train, y_train)
preds = rfr.predict(X_test)今度は、1 から 5 までの連続値を予測する代わりに、レビューを星 1 つから星 5 つまでの 5 段階に分類して、星の数を正確に当てることを目指します。
学習後のモデルは、評価の微妙な違いを読み取る必要がある星 2~4 つのレビューに比べて、星 1 つと星 5 つのレビューをはるかに正確に予測できます。こうしたレビューでは感情がより強く表れているためと考えられます。
1
2
3
4
5
6from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

clf = RandomForestClassifier(n_estimators=100)
clf.fit(X_train, y_train)
preds = clf.predict(X_test)埋め込みを使えば、ラベル付きの学習データがなくてもゼロショット分類ができます。まず、各クラスの名前または短い説明を埋め込みに変換します。新しいテキストをゼロショットで分類するには、その埋め込みをすべてのクラスの埋め込みと比較し、類似度が最も高いクラスを予測結果とします。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";

const client = new OpenAI();
const labels = ["negative", "positive"];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...labels, "The coffee arrived quickly and tastes great."],
});

const review = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * review[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...review));
};

const [negative, positive] = data.map(({ embedding }) => similarity(embedding));
console.log(positive > negative ? "positive" : "negative");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18df = df[df.Score != 3]
df["sentiment"] = df.Score.replace(
{1: "negative", 2: "negative", 4: "positive", 5: "positive"}
)
labels = ["negative", "positive"]
label_embeddings = [get_embedding(label, model=model) for label in labels]
def label_score(review_embedding, label_embeddings):
return cosine_similarity(review_embedding, label_embeddings[1]) - cosine_similarity(
review_embedding, label_embeddings[0]
)
prediction = (
"positive" if label_score(get_embedding("Sample Review", model=model), label_embeddings) > 0 else "negative"
)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59import (
"context"
"fmt"
"log"
"math"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
negative, err := embedding(ctx, &client, "negative")
if err != nil {
return err
}
positive, err := embedding(ctx, &client, "positive")
if err != nil {
return err
}
review, err := embedding(ctx, &client, "Sample Review")
if err != nil {
return err
}
score := cosineSimilarity(review, positive) - cosineSimilarity(review, negative)
prediction := "negative"
if score > 0 {
prediction = "positive"
}
fmt.Println(prediction)
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("negative", "positive", "Sample Review"))
.build())
.data();
List<Float> review = embeddings.get(2).embedding();
double negative = cosineSimilarity(review, embeddings.get(0).embedding());
double positive = cosineSimilarity(review, embeddings.get(1).embedding());
System.out.println(positive > negative ? "positive" : "negative");1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
float[] negative = await EmbedAsync(client, "negative");
float[] positive = await EmbedAsync(client, "positive");
float[] review = await EmbedAsync(client, "Sample Review");
double score = CosineSimilarity(review, positive) - CosineSimilarity(review, negative);
Console.WriteLine(score > 0 ? "positive" : "negative");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"
client = OpenAI::Client.new
labels = ["negative", "positive"]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: labels + ["The coffee arrived quickly and tastes great."]
)
review = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(review).sum { |value, review_value| value * review_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
review_magnitude = Math.sqrt(review.sum { |value| value**2 })
dot_product / (magnitude * review_magnitude)
end
negative, positive = response.data.first(2).map do |embedding|
similarity.call(embedding.embedding)
end
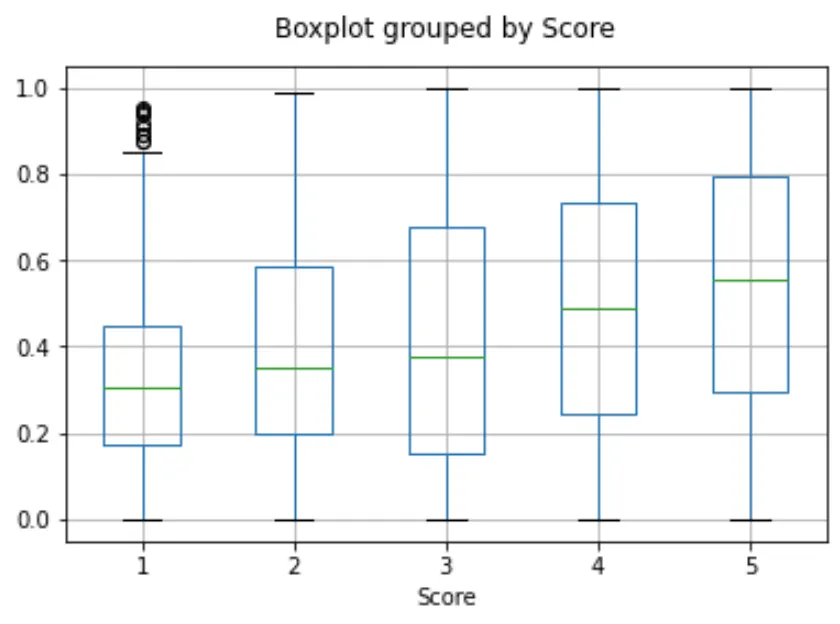
puts((positive > negative) ? "positive" : "negative")ユーザーが投稿したすべてのレビューの埋め込みを平均すると、そのユーザーの埋め込みが得られます。同様に、ある商品に関するすべてのレビューの埋め込みを平均すると、その商品の埋め込みが得られます。この方法の有用性を示すため、ここでは 5 万件のレビューを取り出して、ユーザーごと、商品ごとにより多くのレビューを分析します。
これらの埋め込みの有用性は、別のテストデータセットで評価します。ユーザーの埋め込みと商品の埋め込みの類似度を、評価ごとにプロットします。この方法を使うと、ユーザーが商品を受け取る前でも、その商品を気に入るかどうかをランダムな予測より高い精度で予測できます。
user_embeddings = df.groupby("UserId").ada_embedding.apply(np.mean)
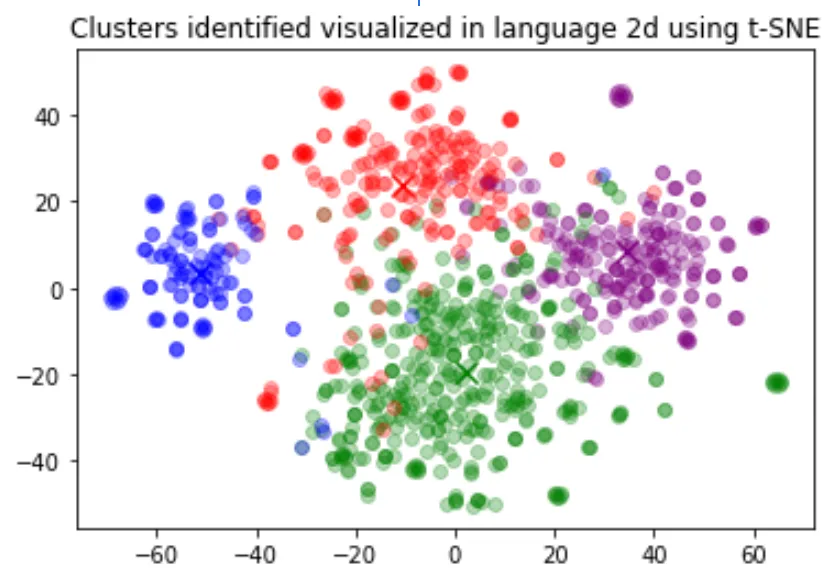
prod_embeddings = df.groupby("ProductId").ada_embedding.apply(np.mean)クラスタリングは、大量のテキストデータの傾向を把握する方法の 1 つです。埋め込みは各テキストの意味をベクトルで表現するため、この用途に適しています。クラスタリングを使えば、教師なし学習でデータセットに潜むグループを見つけられます。
この例では、4 つの明確なクラスタが見つかります。1 つは主にドッグフードに関するレビュー、1 つは主に否定的なレビュー、残りの 2 つは主に肯定的なレビューで構成されています。
1
2
3
4
5
6
7
8
9import numpy as np
from sklearn.cluster import KMeans

matrix = np.vstack(df.ada_embedding.values)
n_clusters = 4

kmeans = KMeans(n_clusters=n_clusters, init="k-means++", random_state=42)
kmeans.fit(matrix)
df["Cluster"] = kmeans.labels_
よくある質問
埋め込み生成前の文字列のトークン数の確認方法
Python では、OpenAI のトークナイザー tiktoken を使って文字列をトークンに分割できます。
コード例は次のとおりです。
1
2
3
4
5
6
7
8
9
10
11import tiktoken


def num_tokens_from_string(string: str, encoding_name: str) -> int:
    """Returns the number of tokens in a text string."""
    encoding = tiktoken.get_encoding(encoding_name)
    num_tokens = len(encoding.encode(string))
    return num_tokens


num_tokens_from_string("tiktoken is great!", "cl100k_base")
text-embedding-3-small などの第 3 世代の埋め込みモデルには、cl100k_base エンコーディングを使用してください。
詳しい説明とコード例は、OpenAI Cookbook のガイド「tiktoken でトークン数を数える方法」をご覧ください。
近い順に K 個の埋め込みベクトルを高速に取得する方法
大量のベクトルを高速に検索するには、ベクトルデータベースの使用をおすすめします。ベクトルデータベースと OpenAI API を組み合わせる例は、GitHub 上の OpenAI Cookbook に掲載しています。
距離関数の選び方
コサイン類似度をおすすめします。通常、どの距離関数を選んでも結果に大きな違いはありません。
OpenAI の埋め込みはベクトルの長さが 1 になるように正規化されているため、次の性質があります。
- コサイン類似度は内積だけで求められるため、計算がやや高速
- コサイン類似度とユークリッド距離のどちらを使っても順位は同じ
埋め込みのオンライン共有
はい、共有できます。埋め込みを含め、モデルへの入力とモデルからの出力はお客様に帰属します。API に入力するコンテンツが適用法令や OpenAI の利用規約に違反しないようにする責任は、お客様にあります。
v3 埋め込みモデルが把握している出来事の範囲
text-embedding-3-large と text-embedding-3-small は、2021 年 9 月より後に起きた出来事についての知識を持っていません。通常、テキスト生成モデルほど大きな制約にはなりませんが、例外的なケースでは性能が低下することがあります。