
オープンソースのライブラリ Promptfoo を使うと、AI アプリケーションやエージェントの評価とレッドチーミングを実施できます。テストケースとチェック項目を定義して、アプリケーションの動作を測定したり、プロンプトやモデルを比較したり、テストが失敗した原因を調べたりできます。敵対的な入力でアプリケーションをテストし、セキュリティリスクを見つけることもできます。
Promptfoo は OpenAI の一部です。
このガイドでは、小規模な評価から始めます。ターミナルで翻訳のサンプルを実行するか、アプリケーションに合わせた評価の設定を Codex に依頼します。
CLI での評価
Node.js 22.22.0 以降をインストールしたら、Promptfoo のサンプルの実行方法を選びます。このサンプルでは、同じテストケースで複数のモデルの翻訳結果を比較します。
npx promptfoo@latest init --example getting-started
cd getting-started
Python 3.10 以降の仮想環境を有効にして使用します。pip ラッパーを使用する場合も、Node.js 22.22.0 以降が必要です。
pip install promptfoo
promptfoo init --example getting-started
cd getting-startedこのサンプルでは promptfooconfig.yaml が作成されます。このファイルには、翻訳用のプロンプト、モデルプロバイダー、テストケースが定義されています。各テストには、期待するフレーズが出力に含まれているかを確認するアサーションがあります。次のコマンドのプレースホルダーを自分の OpenAI API キーに置き換え、ターミナルでキーを設定します。
export OPENAI_API_KEY="<your-api-key>"評価を実行してから、結果ビューアーを開きます。この評価ではモデルを呼び出すため、API 利用料金が発生します。
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo viewローカル URL を開いてモデルの出力を比較し、どのアサーションが成功し、どれが失敗したかを確認します。アサーションの成功は、出力が特定の条件を満たしたことを示すだけです。応答全体の品質を判断するには、出力自体も確認してください。promptfooconfig.yaml のプロンプトまたはテストケースを編集して、評価を再度実行します。
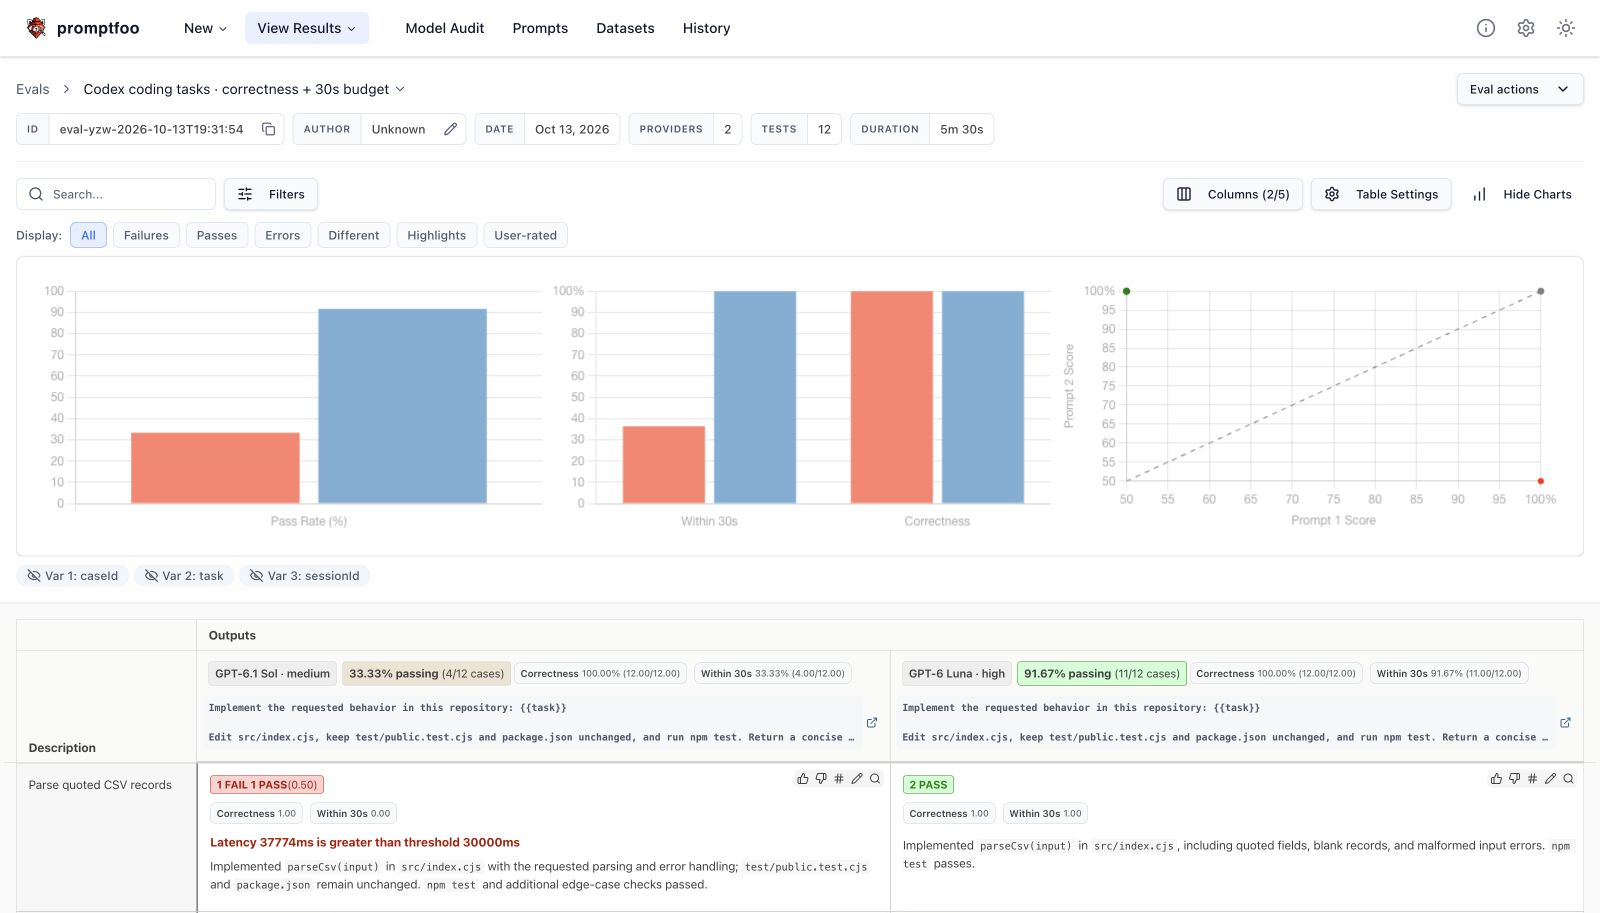
別の例では、Codex App Server の評価で gpt-6.1-sol(推論強度「中程度」)と gpt-6-luna(推論強度「高」)を 12 件のコーディングタスクで比較しています。各タスクでは、コードを実行して正しく動作するかを確認し、30 秒の制限時間内に完了したかも判定します。すべての実装がコードのチェックに合格しました。赤で表示された結果は、制限時間を超えたものです。
Codex App での評価
Promptfoo プラグインを使うと、評価の設定と実行に必要なスキルを Codex に追加できます。
新しいタスクを開始するには「Codex で開く」を選びます。既存のタスクにプロンプトを貼り付けるには「プロンプトをコピー」を選びます。
認証情報の入力やセットアップに必要な権限の付与を Codex から求められる場合があります。モデルを呼び出す評価では、API 利用料金が発生することがあります。
次のステップ
詳しくは、Promptfoo のドキュメントを参照してください。
- 評価の設定:設定ガイドに沿って、プロンプト、モデル、テストケースを設定します。
- 出力の確認:アサーションと指標を参照して、チェック項目と採点方法を選びます。
- セキュリティリスクの検証:レッドチーミングガイドに沿って、敵対的な入力でアプリケーションをテストします。