
サンドボックスは、エージェントが利用できる、隔離された Unix ライクな実行環境です。ファイルシステム、シェル、インストール済みのパッケージ、マウントしたデータ、公開ポート、スナップショットを利用でき、外部システムへのアクセスも制御できます。
モデルがこうしたワークスペースを必要としているのに、プロンプトのコンテキストしか与えられないと、エージェントのワークフローは不安定になります。大量の文書や生成した成果物を扱う場合、コマンドを実行する場合、プレビューを確認する場合、中断した作業を再開する場合には、いずれもエージェント自身が中身を調べて変更できる環境が必要です。
サンドボックスエージェントは、TypeScript 版と Python 版の Agents SDK で利用できます。
このガイドでは、アプリケーション側でハーネスを実行する Agents SDK のサンドボックスを扱います。OpenAI が管理するハーネスを利用する場合は、Agents API でのサンドボックスの接続を参照してください。
エージェントがファイルの操作、コマンドの実行、データルームのマウント、成果物の作成、サービスの公開を行う場合や、状態を引き継いで後から作業を続ける場合には、サンドボックスを使用します。
設計上重要なのは、ハーネスとコンピュートの境界です。ハーネスはモデルを取り巻くコントロールプレーンで、エージェントループ、モデル呼び出し、ツールへのルーティング、ハンドオフ、承認、トレース、復旧、実行状態を管理します。コンピュートはサンドボックスの実行を担う部分です。ここではモデルの指示に従い、ファイルの読み書き、コマンドの実行、依存関係のインストール、マウントしたストレージの利用、ポートの公開、状態のスナップショットの作成を行います。
この 2 つを分離すると、アプリケーションは機密性の高い制御処理を信頼できるインフラ内に置き、プロバイダー固有の実行処理をサンドボックスに任せられます。サンドボックスでは、権限を絞った認証情報と必要なマウントだけを使って、ファイルを対象にコードを実行できます。ハーネスでは、認証、請求、監査ログ、人によるレビュー、復旧用の状態を個々のコンテナの外で管理できます。
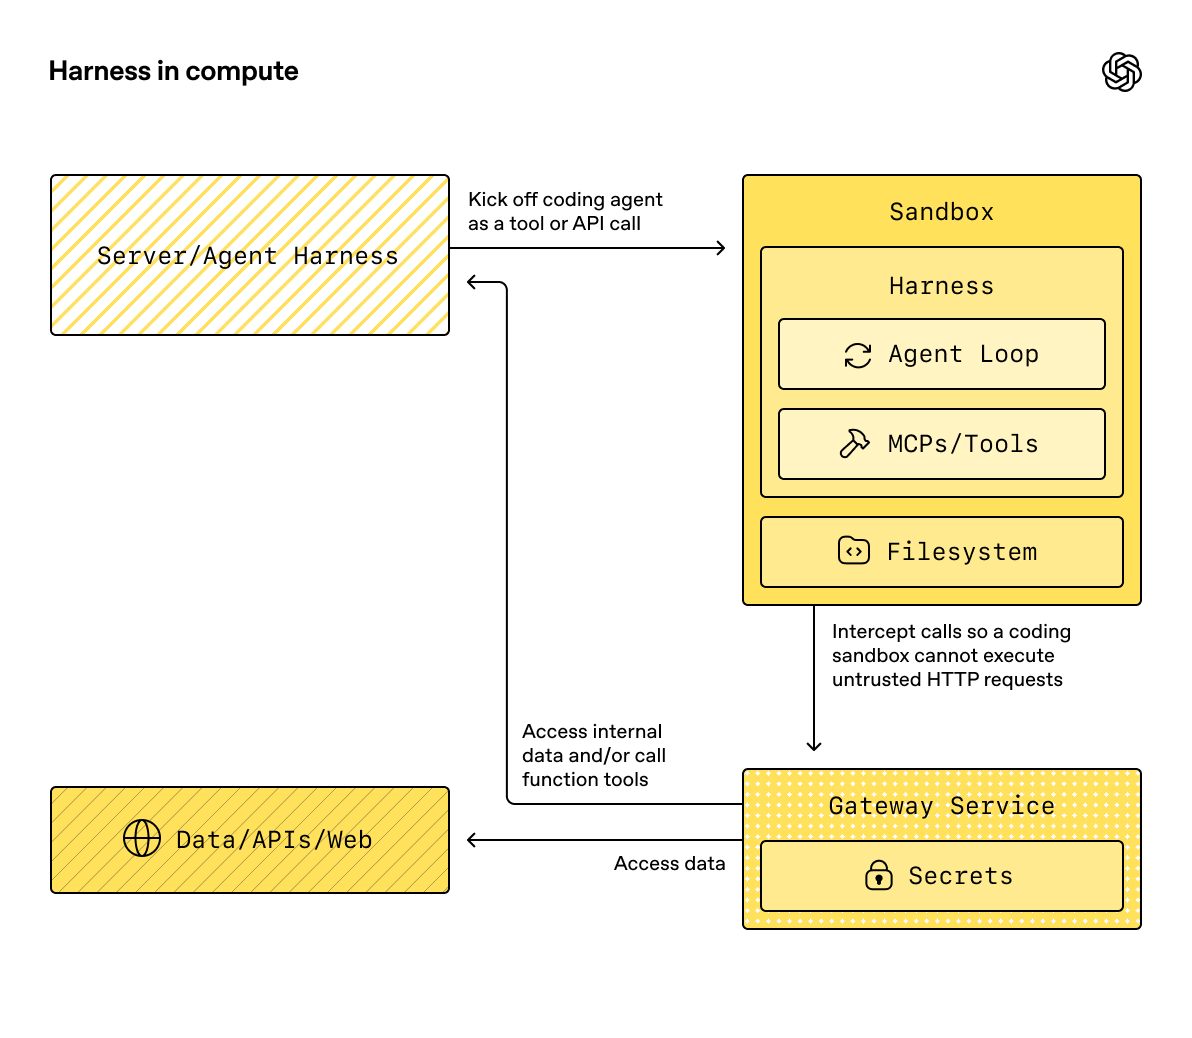
サンドボックス内でハーネスを動かす構成はプロトタイプには便利ですが、オーケストレーションとモデルの指示に基づく処理が同じ実行環境に置かれます。
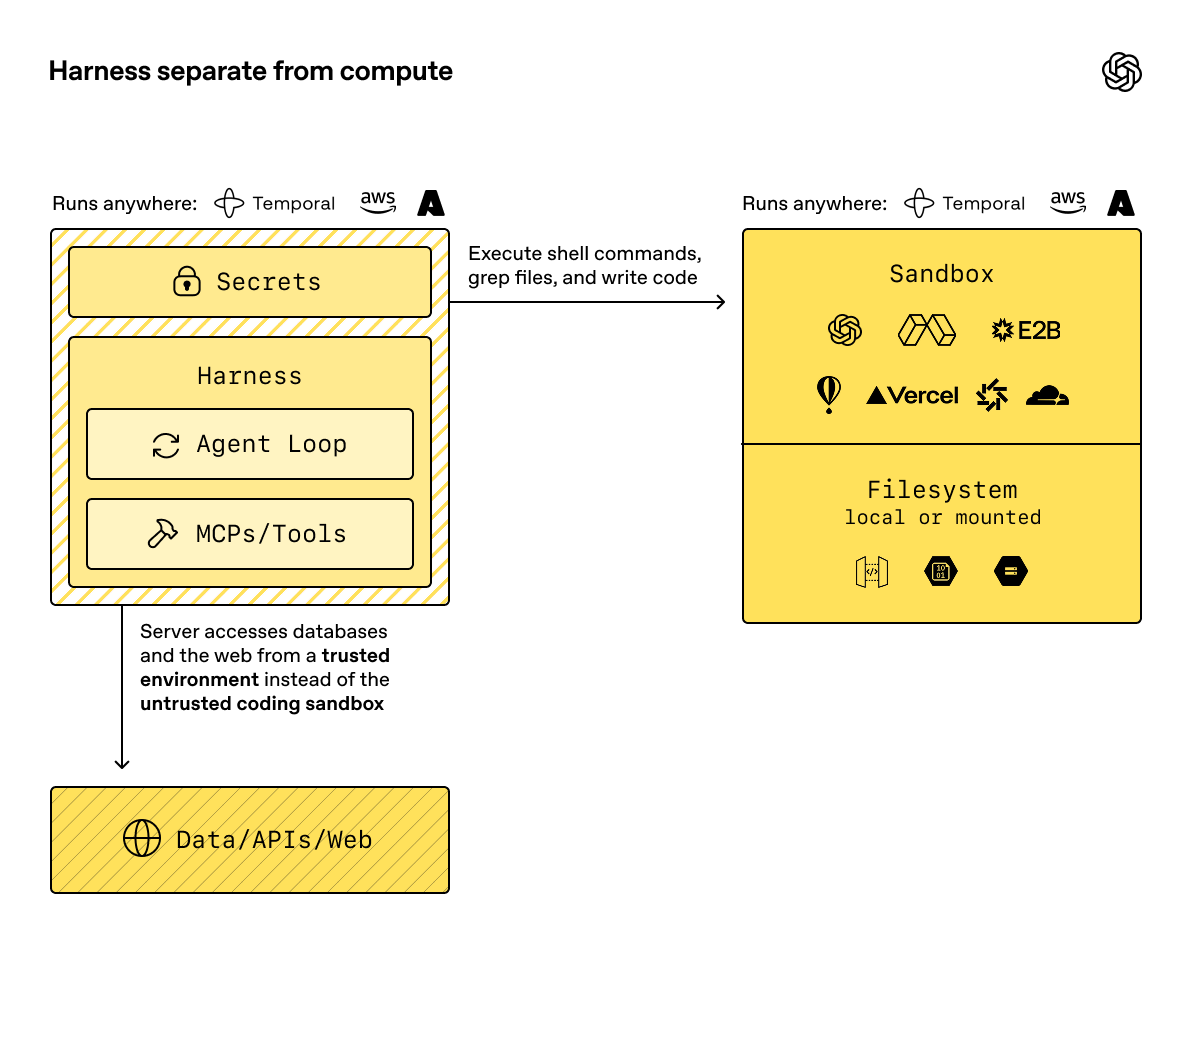
ハーネスはアプリケーション側のインフラで動かし、状態を保持するプロバイダー固有の実行処理はサンドボックスに任せられます。
サンドボックスが適する場面
プロンプトのコンテキストに基づく推論だけでは回答できず、サンドボックスのワークスペースでの作業結果が必要な場合に、サンドボックスを使用します。
たとえば、次のような場合です。
- 1 つのプロンプトだけでは足りず、ディレクトリに格納された複数の文書が必要な場合
- エージェントが書き出したファイルを、後でアプリケーションから確認する場合
- 作業の完了にコマンド、パッケージ、スクリプトが必要な場合
- ワークフローで Markdown、CSV、JSONL、スクリーンショット、生成したウェブサイトなどの成果物を作成する場合
- 公開ポートでサービスやノートブックを動かしたり、レポートのプレビューを表示したりする場合
- 人によるレビューのために作業を一時停止し、同じワークスペースで再開する場合
短いモデル応答だけで済み、永続的なワークスペースが不要な場合は、Responses API を直接呼び出すか、サンドボックスを使わずに Agents SDK の基本ランタイムを使用します。
ツールの 1 つとして時々シェルにアクセスするだけなら、まずツールの使用で紹介しているホスト型シェルツールを使用してください。ワークスペースの隔離、サンドボックスプロバイダーの選択、ファイルシステムの状態を引き継いだ作業の再開が製品の設計要件に含まれる場合は、サンドボックスエージェントを使用します。
サンドボックスで追加される機能
SandboxAgent も Agent の一種です。instructions、prompt、tools、handoffs、MCP サーバー、モデル設定、構造化出力、ガードレール、フックなど、通常のエージェントと同じインターフェースを利用できます。変わるのは実行環境の境界です。ランナーは、稼働中のサンドボックスセッションを使えるようにエージェントを準備します。ファイル、コマンド、ポート、プロバイダー固有の隔離機構は、このセッションが管理します。
| 構成要素 | 管理する内容 | 設計時に検討すること |
|---|---|---|
SandboxAgent |
エージェントの定義とサンドボックスのデフォルト設定 | エージェントに何をさせるか。どのサンドボックス設定をデフォルトとして持たせるか。 |
Manifest |
新規セッションのワークスペースの初期仕様 | 開始時にどのファイル、ディレクトリ、リポジトリ、マウント、環境設定、ユーザー、グループを用意するか。 |
| 機能 | エージェントに追加するサンドボックス固有の動作 | エージェントにどのサンドボックスツール、指示、ランタイムの動作が必要か。 |
| サンドボックスクライアント | プロバイダーとの連携 | ワークスペースを Unix-local、Docker、ホスト型プロバイダーのどこで動かすか。 |
| サンドボックスセッション | 稼働中の実行環境 | どこでコマンドを実行し、ファイルを変更し、ポートを開き、プロバイダーの状態を保持するか。 |
| サンドボックスの実行設定 | 実行ごとのセッションの取得元、クライアントオプション、新規セッションへの入力 | 今回の実行では、既存のセッションを渡すか、セッションを再開するか、新規に作成するか。 |
| 保存済みの状態 | RunState、シリアライズしたセッション状態、スナップショット |
後続の実行で進行中の作業にどう再接続するか。新しいワークスペースにどう初期データを取り込むか。 |
サンドボックス固有のデフォルト設定は SandboxAgent に指定します。実行ごとに使用するサンドボックスセッションは、その実行のサンドボックス設定で指定します。
サンドボックスエージェントでもターンの意味は変わりません。1 ターンはモデルの 1 ステップであり、シェルコマンドやサンドボックス操作を 1 回行うごとにターンが進むわけではありません。サンドボックスの実行層だけで完結する処理もあります。エージェントのランタイムが次のターンを消費するのは、サンドボックスでの作業後にモデルから新たな応答を得る必要がある場合だけです。
ワークスペースの作成
Manifest は、新しいサンドボックスワークスペースの初期内容と配置を定義します。エージェントが利用するファイル、リポジトリ、入力となる成果物、補助ファイル、マウント、出力ディレクトリ、環境設定を指定します。
マニフェストが定義するのは新規セッションの初期仕様です。稼働中のすべてのサンドボックスの状態を表すものではありません。実行に使うワークスペースは、再利用する稼働中のセッション、シリアライズしたセッション状態、または実行時に選んだスナップショットから取得することもあります。
マニフェストの各エントリのパスは、ワークスペースを基準とする相対パスです。絶対パスは指定できず、.. を使ってワークスペースの外を参照することもできません。この制約により、ローカル、Docker、ホスト型の各クライアントで同じワークスペース仕様を使えます。
| マニフェストの入力 | 用途 |
|---|---|
File、Dir |
小規模な合成入力データ、補助ファイル、出力ディレクトリを用意します。 |
| ローカルファイルまたはディレクトリ | ホストのファイルやディレクトリをサンドボックス内に配置します。 |
| Git リポジトリ | リポジトリをワークスペースに取得します。 |
S3Mount、GCSMount、R2Mount、AzureBlobMount、BoxMount、S3FilesMount |
外部ストレージをサンドボックス内から利用できるようにします。 |
environment |
サンドボックスの起動時に必要な環境変数を設定します。 |
users と groups |
アカウントのプロビジョニングをサポートするプロバイダーで、サンドボックス内の OS アカウントとグループを用意します。 |
マニフェストを設計する際は、次の点を考慮してください。
- リポジトリ、入力となる成果物、出力ディレクトリはマニフェストに含めます。
- 詳細なタスク仕様やリポジトリ固有の指示は、
repo/task.mdやAGENTS.mdなどのワークスペース内のファイルに記述します。 - 指示内では、
repo/task.mdやoutput/report.mdのように、ワークスペースを基準とする相対パスを使用します。 - ストレージのマウント範囲は、エージェントが読み書きする必要のある入力に限定します。
- マウントはワークスペース内の一時的なエントリとして扱います。スナップショット作成時や永続化時には、マウントしたリモートストレージはスキップされ、保存対象のワークスペースにその内容はコピーされません。
ファイルとストレージのマウント
必要なデータは、多くの場合すでに別の場所に保存されています。大きな文書をコンテキストに貼り付ける代わりに、サンドボックスにマウントして、エージェントがファイルとして扱えるようにします。
使用例は次のとおりです。
- デューデリジェンス用のデータルームをマウントし、出典を示した要約をエージェントに作成させます。
- サポートシステムからエクスポートしたデータをマウントし、問題を分類してレポートにまとめるようエージェントに依頼します。
- 生成した成果物をマウントして、別のシステムからレビューできるようにします。
マウント用ヘルパー、認証情報の扱い、永続化の動作は、プロバイダーとの連携方法によって異なります。アプリケーション側の取り決めは共通にします。エージェントが使う入力だけをマウントし、読み書きする場所をエージェントに伝え、生成した成果物は使用前に確認してください。
シークレットと認証情報の取り扱い
サンドボックスの認証情報はランタイム設定として扱い、プロンプトには含めません。パッケージマネージャー、ストレージのマウント、プロバイダーの API を利用するために、エージェントが認証情報にアクセスする必要がある場合もあります。ただし、ユーザープロンプト、エージェントへの指示、タスクファイル、コミットするマニフェスト、生成した成果物には、認証情報を含めないでください。
次のルールに従ってください。
- ホスト型のサンドボックスプロバイダーでは、プロバイダーが提供するシークレット管理機能を優先します。
- クラウドストレージの認証情報は、それを必要とするマウントまたはプロバイダーオプションに限定して使用します。
- サンドボックスのプロセスが起動時に必要とする値は
Manifest.environmentに設定します。機密情報を含むエントリや自動生成するエントリを永続化せずに再作成したい場合は、一時的なエントリとして指定します。 - シークレット、生成したマウント設定、ローカルトークン、実行後に残すべきでないファイルは保存しないでください。
- 成果物をサンドボックスの外に移す前に内容を確認します。エージェントが非公開文書やマウントしたストレージを読み取れる場合は、特に注意してください。
SDK は、マニフェストでの環境変数の指定と、プロバイダー固有のマウント用認証情報に対応しています。汎用のシークレットストアとの連携方法はプロバイダーによって異なります。共通する原則は、認証情報をモデルへの指示に含めず、ランタイムまたはサンドボックスプロバイダーから注入することです。
エージェントへの機能の追加
SandboxAgent には、サンドボックス固有の機能を追加できます。これらの機能を使うと、実行前にワークスペースを準備し、サンドボックス固有の指示を追加し、稼働中のセッションに紐づくツールを提供できます。また、そのエージェントでのモデルの動作や入力処理も調整できます。
| 機能 | 追加する場面 | 補足 |
|---|---|---|
Shell |
エージェントがシェルにアクセスする場合 | コマンドを実行できます。サンドボックスクライアントが対応していれば、対話的な入力も可能です。 |
Filesystem |
エージェントがファイルを編集したり、ローカルの画像を確認したりする場合 | apply_patch と view_image を追加します。パッチのパスはワークスペースのルートを基準とする相対パスです。 |
Skills |
サンドボックス内でスキルを検出して配置する場合 | .agents や .agents/skills を手動でマウントするより、この機能の使用を推奨します。 |
Memory |
後続の実行でメモリの成果物を読み取ったり生成したりする場合 | Shell が必要です。実行中にメモリを更新するには Filesystem も必要です。 |
Compaction |
長時間のワークフローでコンテキストの削減が必要な場合 | コンパクション項目の後で、モデルの動作と入力処理を調整します。 |
デフォルトでは、SandboxAgent にファイルシステム、シェル、コンパクションの各機能が含まれます。capabilities のリストを渡すとデフォルトのリストが置き換わるため、引き続き必要なデフォルト機能も含めてください。
用途に合う組み込み機能があれば、それを優先します。組み込み機能では提供できないサンドボックス固有のツールや指示が必要な場合にのみ、カスタム機能を作成してください。
スキルの読み込み
タスクによっては、繰り返し使う指示、スクリプト、参考資料、アセットをエージェントの起動前に用意する必要があります。Skills 機能を使うと、エージェントは実行中にこうした作業用の情報を見つけられます。
import {
Capabilities,
SandboxAgent,
gitRepo,
skills,
} from "@openai/agents/sandbox";
const agent = new SandboxAgent({
name: "Tax prep assistant",
instructions: "Use the mounted skill before preparing the return.",
capabilities: [
...Capabilities.default(),
skills({
from: gitRepo({
repo: "owner/tax-prep-skills",
ref: "main",
}),
}),
],
});スキルをワークスペースに配置する方法に合わせて、取得元を選びます。
- ローカルのスキルディレクトリが大きく、モデルにはまずインデックスを参照させて必要なものだけを読み込ませたい場合は、遅延読み込みに対応したローカルディレクトリを取得元にします。
- 小規模なローカルのスキル一式をあらかじめ配置する場合は、ローカルディレクトリを取得元にします。
- スキル一式を独自のサイクルでリリースする場合や、多数のサンドボックスで使用する場合は、Git リポジトリを取得元にします。
プレビューとポートの公開
成果物が、ファイルではなく実行中のプロセスである場合もあります。エージェントが作成したローカルアプリ、ノートブック、レポートサーバー、ブラウザープレビューなどのサービスをサンドボックスの外から確認するには、ポートを公開します。
ポートの設定方法はプロバイダーによって異なりますが、製品側の動作は共通です。エージェントがサンドボックス内でサービスを起動し、サンドボックスクライアントがポートを公開します。アプリケーションは、得られたプレビュー URL を共有したり、その URL でプレビューを確認したりできます。
サンドボックスエージェントの実行
サンドボックスを使う基本的な手順は次のとおりです。
- ワークスペースを定義する
Manifestを作成します。 - モデルが必要とする機能を備えた
SandboxAgentを作成します。 - 作業を実行する環境に合ったサンドボックスクライアントを選びます。
- 実行ごとのサンドボックス設定を指定して、エージェントを実行します。
- アプリケーションに必要な成果物を確認またはコピーし、必要に応じて作業を再開したり、スナップショットを作成したりします。
macOS または Linux でローカル開発を始める場合は、Unix-local を使用します。ランナーがエージェントのデフォルトのマニフェストから一時ワークスペースを作成し、実行後に削除できるため、最小限の手順でローカル実行を繰り返せます。
TypeScript 版 SDK を使用する場合は、UnixLocalSandboxClient でセッションを作成する前に、信頼できる Python 3 インタープリターをホストにインストールしてください。SDK はローカルファイルへのアクセスを保護するために Python を使用し、/usr/bin/python3、/usr/local/bin/python3、/opt/homebrew/bin/python3 を確認します。Python を別の場所にインストールした場合は、Node.js を起動する前に、ホストの環境変数 OPENAI_AGENTS_PYTHON に Python 実行ファイルの絶対パスを設定してください。Python が必要なのはホスト側です。サンドボックス内にパッケージとしてインストールする必要はありません。適切な Python インタープリターを利用できない場合、セッションの作成は失敗します。
import { run } from "@openai/agents";
import { Manifest, SandboxAgent, file, shell } from "@openai/agents/sandbox";
import { UnixLocalSandboxClient } from "@openai/agents/sandbox/local";
const manifest = new Manifest({
entries: {
"account_brief.md": file({
content:
"# Northwind Health\n\n" +
"- Segment: Mid-market healthcare analytics provider.\n" +
"- Renewal date: 2026-04-15.\n",
}),
"implementation_risks.md": file({
content:
"# Delivery risks\n\n" +
"- Security questionnaire is not complete.\n" +
"- Procurement requires final legal language by April 1.\n",
}),
},
});
const agent = new SandboxAgent({
name: "Renewal Packet Analyst",
model: "gpt-6-astra",
instructions:
"Review the workspace before answering. Keep the response concise, " +
"business-focused, and cite the file names that support each conclusion.",
defaultManifest: manifest,
capabilities: [shell()],
});
const result = await run(
agent,
"Summarize the renewal blockers and recommend the next two actions.",
{
sandbox: {
client: new UnixLocalSandboxClient(),
},
}
);
console.log(result.finalOutput);ローカルで動作する完全な例は、TypeScript のサンドボックスエージェントのクイックスタートと Python の unix_local_runner.py を参照してください。
プロバイダーの切り替え
プロバイダーはエージェントの定義ではなく、実行設定で指定します。SandboxAgent、マニフェスト、機能はそのまま使い、対象の環境に合わせてサンドボックスクライアントとプロバイダーオプションを切り替えます。
この例では、ローカルでコンテナによる隔離を行うために Docker を使用します。ホスト型プロバイダーでも同じ手順で、それぞれのクライアントクラスとオプションを使用します。
import { run } from "@openai/agents";
import { SandboxAgent } from "@openai/agents/sandbox";
import { DockerSandboxClient } from "@openai/agents/sandbox/local";
const agent = new SandboxAgent({
name: "Workspace reviewer",
model: "gpt-6-astra",
instructions: "Inspect the sandbox workspace before answering.",
});
const result = await run(agent, "Inspect the workspace.", {
sandbox: {
client: new DockerSandboxClient({
image: "node:22-bookworm-slim",
}),
},
});
console.log(result.finalOutput);実行可能な TypeScript の例は、サンドボックスクライアントのガイドと基本例を参照してください。SDK リポジトリにある Python の例では、basic.py でプロバイダーの選択、docker_runner.py で Docker の使用、main.py でデータルームを使ったワークフローを確認できます。
応用パターン
基本的な実行手順を確認したら、プロンプトにコンテキストを追加するだけでは足りず、エージェントがワークスペースを必要とするワークフローにサンドボックスを活用できます。以下はそれぞれ別の API ではなく、ワークフローの設計例です。同じハーネスでワークフローのルーティング、一時停止、再開、トレースを行い、各サンドボックスでは、必要なファイル、ツール、ポートを利用できる環境で処理を実行します。
| 例 | 説明 |
|---|---|
| データルームでの質疑応答 | マウントしたデータルームの資料に基づいて質問に回答します。 |
| データルームからの表の抽出 | マウントしたデータルームから表を抽出します。 |
| リポジトリのコードレビュー | リポジトリをクローンして内容を調べ、コードレビューの成果物を作成します。 |
| Vision を使ったウェブサイトの複製 | Vision API とスクリーンショットに基づくフィードバックを使ってウェブサイトを複製します。 |
| サンドボックスの再開 | 既存のサンドボックスで作業を再開します。 |
作業の再開と次回の初期状態の設定
エージェントの作業は、1 回のリクエストでは終わらないことがあります。ユーザーが成果物をレビューする場合、あるステップで承認が必要な場合、後で発生するイベントを待って次のステップに進む場合などです。
次の 3 種類の状態を区別してください。
| 状態の種類 | 復元するもの | 使用する場面 |
|---|---|---|
RunState |
モデルの項目、ツールの状態、承認、現在のエージェントの実行位置など、ハーネス側の状態 | 一時停止したワークフローをランナーで引き継ぐ場合 |
| セッション状態 | クライアントが再接続できるようにシリアライズしたサンドボックスセッション | アプリやジョブシステムがプロバイダーのセッション状態を直接保存する場合 |
snapshot |
新しいサンドボックスセッションの初期データとして使う、保存済みのワークスペースの内容 | 空のワークスペースではなく、保存したファイルや成果物を使って新しい実行を開始する場合 |
ランナーは次の順序で、使用するサンドボックスセッションを決定します。
- 稼働中のサンドボックスセッションを渡した場合、ランナーはそのセッションを直接再利用します。
- それ以外で、
RunStateから実行を再開する場合は、保存されたサンドボックスセッションの状態から再開します。 - それ以外で、シリアライズしたサンドボックスの状態を明示的に渡した場合は、その状態から再開します。
- いずれにも該当しない場合は、新しいサンドボックスセッションを作成します。その実行用のマニフェストが指定されていればそれを使い、指定されていなければエージェントのデフォルトのマニフェストを使います。
次の例では、停止したセッションの状態をシリアライズし、同じクライアントを使ってセッションを再開してから、再開したセッションを次の実行に渡します。
import { run } from "@openai/agents";
import { Manifest, SandboxAgent } from "@openai/agents/sandbox";
import { UnixLocalSandboxClient } from "@openai/agents/sandbox/local";
const manifest = new Manifest();
const client = new UnixLocalSandboxClient({
snapshot: { type: "local", baseDir: "/tmp/my-sandbox-snapshots" },
});
const agent = new SandboxAgent({
name: "Workspace builder",
model: "gpt-6-astra",
instructions: "Inspect the sandbox workspace before answering.",
});
const session = await client.create({ manifest });
let conversation = [];
let frozenSessionState;
try {
const firstResult = await run(agent, "Build the first version of the app.", {
maxTurns: 20,
sandbox: { session },
});
conversation = firstResult.history;
frozenSessionState = await client.serializeSessionState?.(session.state);
} finally {
await session.close?.();
}
if (!frozenSessionState || !client.deserializeSessionState || !client.resume) {
throw new Error("Sandbox client does not support session resume.");
}
const resumedSession = await client.resume(
await client.deserializeSessionState(frozenSessionState)
);
try {
conversation.push({
role: "user",
content: "Continue from the existing workspace and add tests.",
});
const secondResult = await run(agent, conversation, {
maxTurns: 20,
sandbox: { session: resumedSession },
});
console.log(secondResult.finalOutput);
} finally {
await resumedSession.close?.();
}manifest や snapshot などの新規セッション用の入力が適用されるのは、ランナーが新しいサンドボックスセッションを作成する場合だけです。稼働中の session を渡した場合、機能の適用時に、マウント以外の互換性のあるエントリを追加できます。ただし、稼働中のサンドボックスのルート、環境、ユーザー、グループの変更、既存エントリの削除、エントリの種類の置き換え、マウントエントリの追加や変更はできません。
このように役割を分けることで、ハーネスがエージェントループを再開し、サンドボックスプロバイダーがワークスペースを復元または再作成できます。各方法に対応する最新のサンプルコードは、TypeScript のセッション状態からの再開例と、Python の main.py および sandbox_agent_with_remote_snapshot.py を参照してください。
実行をまたいだメモリの永続化
サンドボックスメモリを使うと、サンドボックスエージェントは過去の実行で得た知見を次回以降の実行に活用できます。これは SDK が管理する会話用の Session メモリとは別の仕組みです。セッションはメッセージ履歴を保持します。一方、サンドボックスメモリは、ワークスペースでの過去の実行から役立つ知見を抽出し、エージェントが後で読めるファイルにまとめます。
過去の全ターンを再処理せずに、ユーザーの好み、訂正内容、プロジェクト固有の知見、タスクの要約を引き継ぐには、メモリを使用します。セッションの再開やスナップショットではワークスペースの状態を保持します。メモリでは、そこでの作業から得た、再利用できる指針を保持します。
import {
Manifest,
SandboxAgent,
filesystem,
memory,
shell,
} from "@openai/agents/sandbox";
const manifest = new Manifest();
const agent = new SandboxAgent({
name: "Memory-enabled reviewer",
instructions:
"Inspect the workspace and retain useful lessons for follow-up runs.",
defaultManifest: manifest,
capabilities: [memory(), filesystem(), shell()],
});デフォルトでは、メモリの読み取りと生成の両方が有効です。メモリを読み取るには、エージェントがメモリファイルを検索して開けるように、シェルへのアクセスが必要です。また、デフォルトでは、実行中のメモリ更新にファイルシステムへのアクセスも必要です。これにより、エージェントは古くなったメモリを修正したり、ユーザーの依頼に応じてメモリを更新したりできます。
メモリの読み取りでは、必要に応じて段階的に情報を取得します。実行開始時に SDK が memory_summary.md をコンテキストに追加します。過去の作業が関係しそうな場合はエージェントが MEMORY.md を検索し、さらに詳しい情報が必要な場合にだけロールアウトの要約を開きます。
| メモリのモード | 使用する場面 |
|---|---|
| デフォルトの読み書き | 既存のメモリを読み取り、新しいメモリも生成する場合 |
| 読み取り専用メモリ | メモリを読み取り、実行後に新しいメモリを生成しない場合 |
| 生成専用メモリ | 既存のメモリを使わずに、新しいメモリを生成する場合 |
| 読み取り設定 | 実行中の更新を無効にする場合 |
| 生成設定 | 追加のプロンプトなど、メモリ生成の設定を調整する場合 |
| レイアウト設定 | 同じサンドボックスワークスペース内で、エージェントごとにメモリの配置を分ける場合 |
デフォルトでは、メモリ関連の成果物はサンドボックスワークスペース内に次のように配置されます。
workspace/
  sessions/
    <rollout-id>.jsonl
  memories/
    memory_summary.md
    MEMORY.md
    raw_memories.md
    phase_two_selection.json
    raw_memories/
      <rollout-id>.md
    rollout_summaries/
      <rollout-id>_<slug>.md
    skills/
ランタイムはサンドボックスセッション中に、実行の各区間の記録を追記します。セッションを閉じると、メモリ生成処理がまず会話の要約と未整理のメモリを抽出し、そのメモリを MEMORY.md と memory_summary.md に統合します。後の実行でメモリを再利用するには、設定したメモリディレクトリを保持してください。同じサンドボックスセッションを稼働させたままにする、セッション状態から再開する、スナップショットから開始する、S3 などの永続ストレージをマウントする、といった方法があります。
複数ターンにわたるサンドボックスでのチャットでは、同じ SDK セッションを継続して使い、稼働中のサンドボックスセッションも共通にします。メモリが実行をグループ化する際には、明示的に指定した会話 ID、SDK セッション ID、実行グループ ID、実行ごとに生成する ID の順に、利用可能な ID を使います。サンドボックスセッション ID は稼働中のワークスペースを識別するもので、メモリの会話 ID とは異なります。
実行可能な TypeScript の例は、メモリのガイドを参照してください。Python では、memory.py でローカルのスナップショットを使う手順、memory_s3.py で S3 へのメモリの保存、memory_multi_agent_multiturn.py でエージェントごとにメモリの配置を分ける方法を確認できます。
サンドボックスエージェントの組み合わせ
サンドボックスエージェントは SDK の他の機能と組み合わせて使えます。
サンドボックスを使わずに依頼を受け付けるエージェントから、ワークスペースを多用する部分だけをサンドボックスエージェントに委任するには、ハンドオフを使用します。最上位の実行は継続し、次のターンではサンドボックスエージェントがアクティブなエージェントになります。
上位のオーケストレーターから 1 つ以上のサンドボックスエージェントをネストしたツールとして呼び出すには、エージェントをツールとして使用します。ツールとして使う各サンドボックスエージェントには、それぞれ独自のサンドボックス実行設定、サンドボックスクライアント、マニフェスト、プロバイダーオプションを指定できます。
例は handoffs.py と sandbox_agents_as_tools.py を参照してください。
サンドボックスプロバイダー
ローカルで手早く試行を繰り返すには Unix-local を、ローカルでコンテナによる隔離が必要な場合は Docker を使用します。タスクにマネージド実行環境、プロバイダー固有の隔離、スケーリング、プレビュー、ストレージのマウント、スナップショット、またはアプリケーションサーバーの外で管理すべき認証情報が必要になったら、ホスト型プロバイダーに移行します。
設定方法、認証情報、隔離、ストレージ、プレビュー、永続化の動作については、各プロバイダーのドキュメントを参照してください。
| プロバイダー | SDK クライアント | ドキュメントと例 |
|---|---|---|
| Blaxel | BlaxelSandboxClient |
サンドボックスの概要 |
| Cloudflare | CloudflareSandboxClient |
サンドボックスのドキュメント OpenAI Agents チュートリアル Sandbox Bridge の例 |
| Databricks | DatabricksSandboxClient |
Python を使用する場合は、databricks-openai[sandbox] をインストールしてください。サンドボックスのドキュメント OpenAI Agents SDK の使用例 Databricks SDK for Python ガイド |
| Daytona | DaytonaSandboxClient |
サンドボックスのドキュメント OpenAI Agents SDK ガイド |
| Docker | DockerSandboxClient |
Docker のドキュメント TypeScript 版 SDK で Docker を使う例 Python 版 SDK で Docker を使う例 |
| E2B | E2BSandboxClient |
サンドボックスのドキュメント OpenAI Agents SDK ガイド リリース告知記事 |
| Modal | ModalSandboxClient |
サンドボックスガイド 連携についてのブログ記事 サンプルリポジトリ Modal 拡張機能のリファレンス |
| Unix-local | UnixLocalSandboxClient |
TypeScript 版 SDK のローカル実行例 Python 版 SDK のローカル実行例 |
| Vercel | VercelSandboxClient |
サンドボックスのドキュメント OpenAI Agents SDK ガイド FastAPI テンプレート サンプルアプリ |