
OpenAI は、o3 や o4-mini などのリーズニングモデルと、GPT-4.1 などの GPT モデルを提供しています。この 2 系統のモデルは、それぞれ動作に違いがあります。
このガイドでは、次の内容を取り上げます。
- リーズニングモデルと非推論型の GPT モデルの違い
- リーズニングモデルが適した場面
- リーズニングモデルに効果的なプロンプトの書き方
仕組みについて詳しくは、リーズニングモデルのガイドをご覧ください。
リーズニングモデルと GPT モデルの違い
o シリーズのモデルは GPT モデルと得意なタスクが異なり、適したプロンプトも異なります。どちらかが一律に優れているわけではなく、それぞれに特性があります。
OpenAI は、o シリーズのモデル(「計画役」)が複雑なタスクに時間をかけて深く取り組めるように訓練しました。そのため、戦略の立案、複雑な問題の解決手順の策定、大量の曖昧な情報に基づく意思決定を得意とします。タスクの実行も正確かつ精密で、数学、科学、工学、金融サービス、法律サービスなど、通常は専門家の判断を要する分野に適しています。
一方、GPT モデル(「実行役」)は、応答が速くコスト効率に優れ、手順が明確なタスクを実行するように設計されています。たとえばアプリケーションでは、o シリーズのモデルで問題を解く戦略を立て、個々のタスクは GPT モデルで実行できます。特に、完璧な正確さよりも速度とコストを重視する場合に適した使い方です。
モデルの選び方
用途に照らして、最も重視する点は何でしょうか。
- 速度とコスト → GPT モデルは応答が速く、コストも低くなる傾向があります
- 明確に定義されたタスクの実行 → GPT モデルは実行内容が明示されたタスクを得意とします
- 正確性と信頼性 → o シリーズのモデルは信頼性の高い判断を下せます
- 複雑な問題の解決 → o シリーズのモデルは曖昧な点や複雑な条件を整理しながら問題を解けます
タスクの実行で速度とコストを最優先し、かつ、扱うタスクが単純で明確に定義されている場合は、GPT モデルが最適です。一方、正確性と信頼性を最優先し、かつ、解決に複数のステップを要する非常に複雑な問題を扱う場合は、o シリーズのモデルが適していると考えられます。
多くの AI ワークフローでは、両方のモデルを組み合わせます。エージェントによる計画と意思決定には o シリーズを、タスクの実行には GPT シリーズを使います。
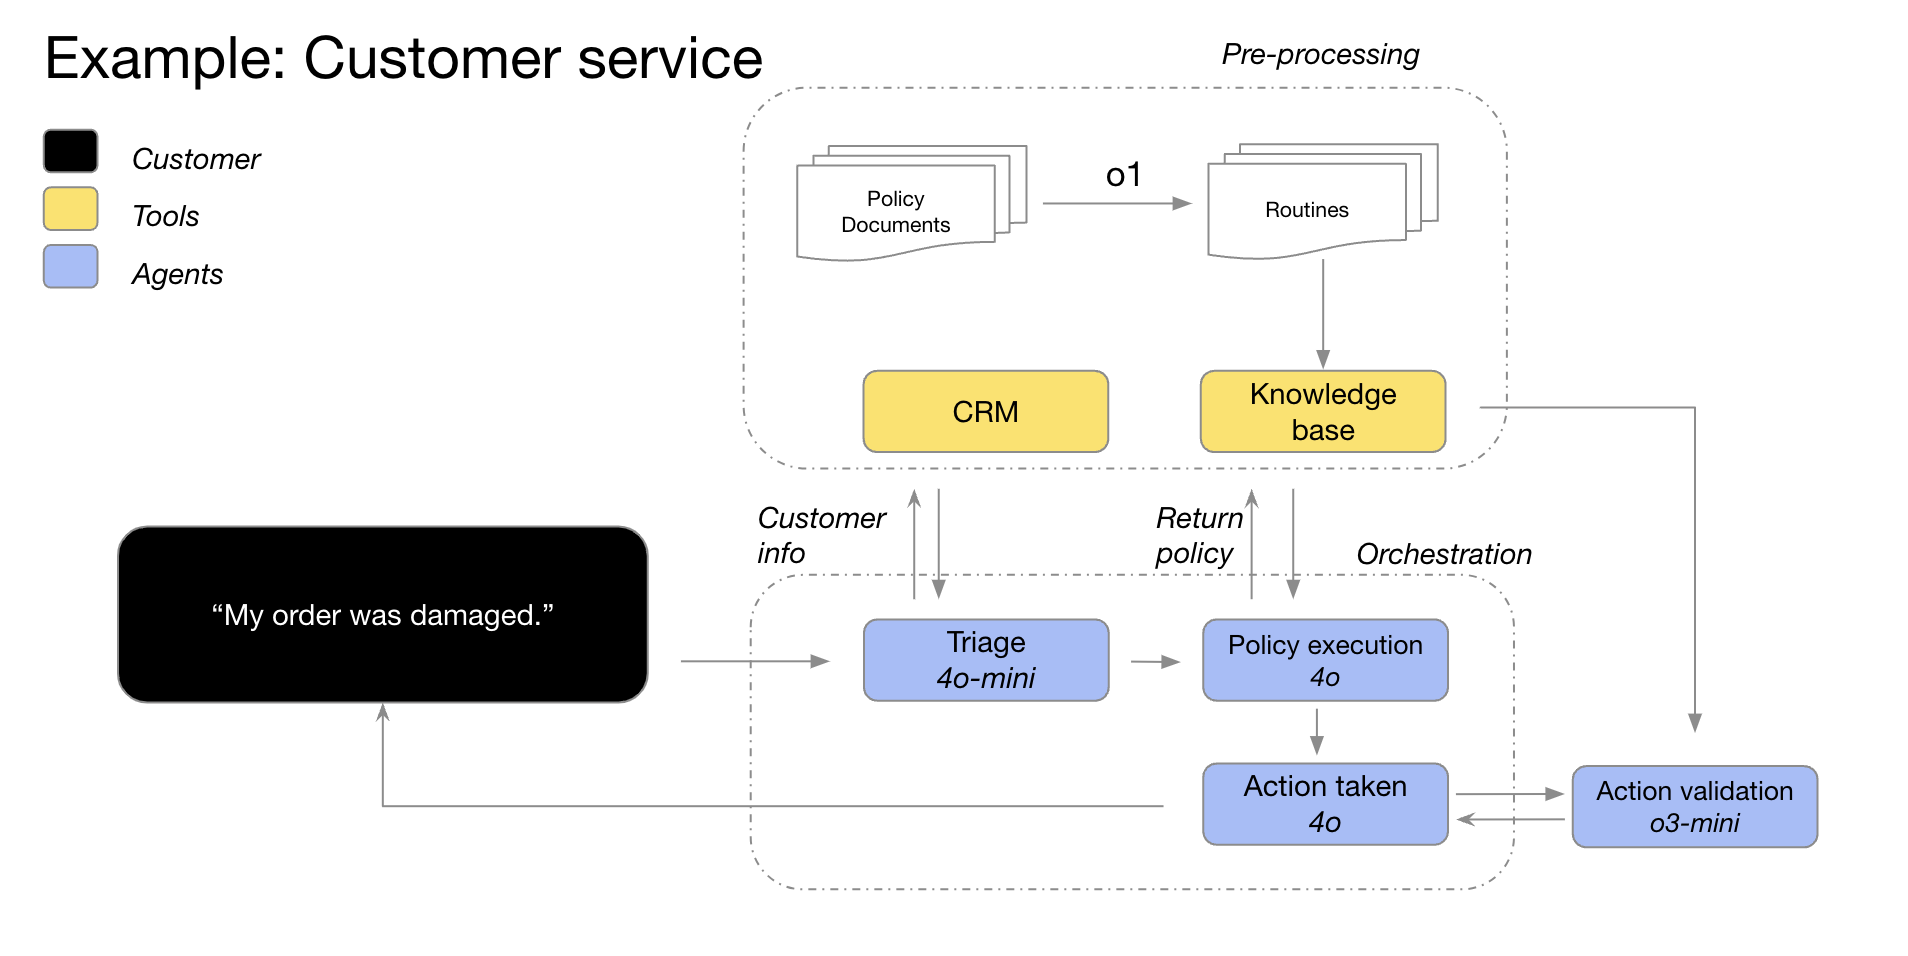
GPT-4o と GPT-4o mini が注文の詳細を顧客情報と照合して整理し、注文の問題点と適用される返品ポリシーを特定します。その情報をすべて o3-mini に渡すと、o3-mini がポリシーに照らして返品を受け付けられるかどうかを最終判断します。
リーズニングモデルが適した場面
ここでは、お客様や OpenAI 社内で成果が得られた使い方をいくつか紹介します。考えられる用途を網羅するものではありませんが、o シリーズのモデルを試す際の参考にしてください。
リーズニングモデルをすぐに使いたい方はクイックスタートへ →
1. 曖昧なタスクへの対応
リーズニングモデルは、情報が限られていたり断片的だったりしても、簡潔なプロンプトからユーザーの意図を読み取り、指示に不足がある場合にも対応できます。実際、根拠のない推測をしたり不足する情報を補おうとしたりする前に、確認の質問をすることがよくあります。
「o1 の推論能力のおかげで、当社のマルチエージェントプラットフォーム Matrix は、複雑な文書を扱う際にも、網羅的で読みやすく整理された詳細な回答を生成できます。たとえば、融資契約で制限対象の支払いが例外的に認められる枠(バスケット)を、Matrix は o1 と簡単なプロンプトだけで容易に特定できました。従来のモデルでは得られなかった性能です。細かな規定が詰まった融資契約を対象とする複雑なプロンプトのうち、52% で o1 が他のモデルより優れた結果を出しました。」
—Hebbia(法務・金融向け AI ナレッジプラットフォームを提供)
2. 膨大な情報に埋もれた重要事項の特定
大量の非構造化情報を入力したとき、リーズニングモデルはその内容を理解し、質問に答えるために最も関連性の高い情報だけを抽出することを得意とします。
「ある企業の買収を分析するため、o1 は契約書や賃貸借契約書など数十件の企業文書を調べ、取引に影響しうる見落としやすい条件を探しました。重要な条件を指摘するよう依頼したところ、脚注にある重大な『支配権の変更』条項を見つけました。会社が売却された場合、7,500 万ドルの融資を直ちに全額返済しなければならないという条項です。o1 はこうした細部まで見逃しません。そのおかげで当社の AI エージェントは、業務上きわめて重要な情報を特定し、金融の専門家を支援できます。」
—Endex(AI を活用した金融情報分析プラットフォーム)
3. 大規模なデータセットにまたがる関連性や微妙な違いの把握
リーズニングモデルは、契約書、財務諸表、保険金請求書類など、数百ページにわたって非構造化情報が詰まった複雑な文書を読み解くことに特に優れています。複数の文書の共通点を見つけ、明記はされていなくてもデータから読み取れる事実に基づいて判断できます。
「税務に関するリサーチでは、複数の文書を突き合わせて、筋の通った最終回答を導く必要があります。GPT-4o を o1 に切り替えたところ、文書同士の関係を読み解き、どの文書を単独で読んでも見えてこない結論を論理的に導く点で、o1 のほうがはるかに優れていました。o1 への切り替えで、一連の処理全体の性能が 4 倍になりました。驚くべき結果です。」
—Blue J(税務リサーチ向け AI プラットフォーム)
リーズニングモデルは、細かな条件を含むポリシーや規則を読み解き、目の前のタスクに当てはめて妥当な結論を導くことにも長けています。
「財務分析では、アナリストが株主持分をめぐる複雑なケースを扱うことが多く、関連する法的な細部まで理解する必要があります。私たちは、複数のプロバイダーの約 10 種類のモデルに、難しいもののよくある質問を出しました。資金調達は既存株主にどのような影響を与えるのか、特に株主が希薄化防止の権利を行使するとどうなるのか、という質問です。答えるには、資金調達前後の企業価値を踏まえ、希薄化の計算が循環する問題を解く必要があります。一流の金融アナリストでも 20~30 分かかる作業ですが、o1 と o3-mini は完璧にこなしました。さらに、10 万ドル分の株式を保有する株主への影響を、わかりやすい計算表で示してくれました。」
–BlueFlame AI(投資運用向け AI プラットフォーム)
4. エージェントによる複数ステップの計画立案
リーズニングモデルは、エージェントによる計画立案と戦略策定で重要な役割を果たします。成果が得られているのは、リーズニングモデルを「計画役」として使い、問題を解くための詳細な手順を組み立てる方法です。そのうえで、計画役のモデルが各ステップで高度な判断力と応答の速さのどちらを重視するかに応じて、適切な GPT モデルを選び、「実行役」として割り当てます。
「当社のエージェント基盤では o1 を計画役に使っています。複数ステップのタスクを完了できるよう、o1 がワークフロー内の他のモデルを取りまとめます。o1 はデータ型の選択や大きな問いを小さな問いに分解するのがとても得意なので、他のモデルは実行に専念できます。」
—Argon AI(製薬業界向け AI ナレッジプラットフォーム)
「仕事向け AI アシスタント Lindy では、多くのエージェント型ワークフローに o1 を使っています。モデルは Function Calling を使ってカレンダーやメールから情報を取得し、会議の日程調整やメールの送信など、日々のタスクの管理を自動で支援します。以前は問題が起きていたステップをすべて o1 に切り替えたところ、エージェントは一夜にしてほぼ完璧に動くようになりました。」
—Lindy.AI(仕事向け AI アシスタント)
5. 視覚情報に基づく推論
現時点で、画像認識に対応しているリーズニングモデルは o1 のみです。構造がわかりにくい図表や画質の低い写真など、読み取りが特に難しい視覚情報まで理解できる点が、GPT-4o との違いです。
「当社は、高級ジュエリーの模倣品、絶滅危惧種、規制薬物など、オンラインで扱われる数百万点の商品について、リスクとコンプライアンスの審査を自動化しています。当社で最も難しい画像分類タスクでは、GPT-4o の正解率は 50% でした。o1 ではパイプラインに一切手を加えずに、88% という高い正解率を達成しました。」
—SafetyKit(AI を活用したリスク・コンプライアンス管理プラットフォーム)
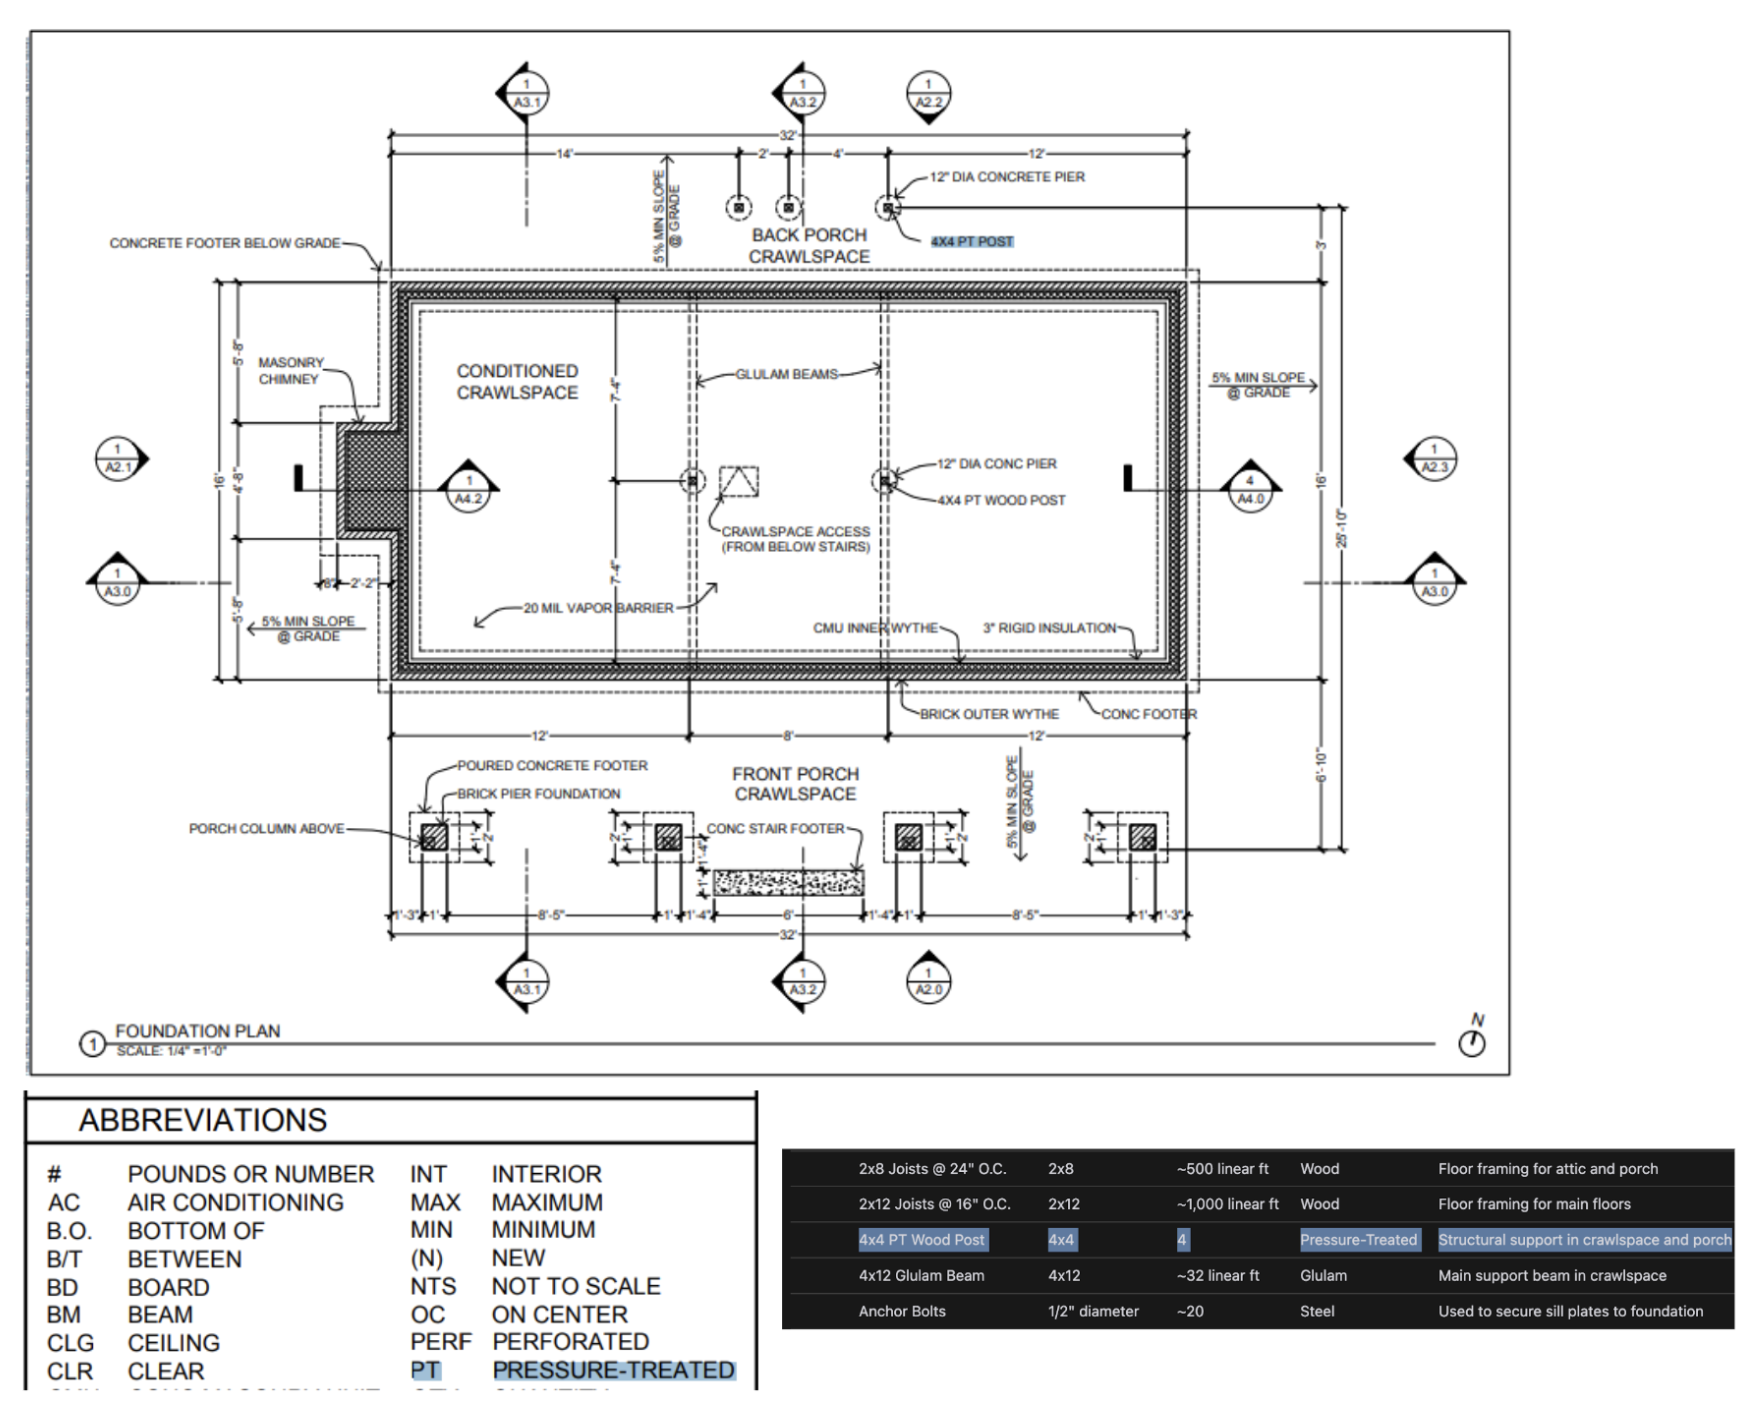
OpenAI の社内テストでは、o1 が非常に細かな建築図面から設備や資材を特定し、網羅的な部材表を作成できることを確認しました。特に意外だったのは、異なる画像を関連付けて読み取れることです。建築図面のあるページに載っている凡例を、明示的に指示しなくても別のページに正しく適用できました。下の例では、o1 が凡例をもとに、4×4 の木柱に付いた「PT」が加圧注入処理済みを意味すると判断しています。
6. コードのレビュー、デバッグ、品質改善
リーズニングモデルは、大量のコードのレビューと改善に特に効果的です。応答には比較的時間がかかるため、コードレビューをバックグラウンドで実行する使い方がよく見られます。
「当社は GitHub や GitLab などのプラットフォームで、AI による自動コードレビューを提供しています。コードレビュー自体では通常、応答時間はさほど重要ではありませんが、複数のファイルにまたがるコードの差分を理解する必要があります。ここで o1 が真価を発揮します。人間のレビュアーなら見落としかねないコードベースの小さな変更も、確実に検出できます。o シリーズのモデルに切り替えたところ、製品のコンバージョン率が 3 倍になりました。」
—CodeRabbit(AI コードレビューを手がけるスタートアップ)
応答の速い GPT-4o や GPT-4o mini のほうがコードの記述に向いている場合もありますが、応答時間の要件がやや緩い用途では、o3-mini もコード生成で際立った性能を発揮しています。
「o3-mini は、問題を解決する質の高いコードを安定して生成します。非常に難しいコーディングタスクでも、問題が明確に定義されていれば、高い頻度で正しい解決策にたどり着きます。他のモデルは小規模なコード変更を短時間で繰り返す用途にしか向かないこともありますが、o3-mini は複雑なソフトウェアシステムの設計を計画し、実装まで進めることに長けています。」
—Windsurf(Codeium が開発した、エージェント型 AI を活用する共同作業向け IDE)
7. 他のモデルの応答の評価とベンチマーク
リーズニングモデルは、他のモデルの応答をベンチマークで比較したり評価したりする用途でも優れた結果を出しています。データの検証は、データセットの品質と信頼性を確保するうえで重要です。医療など、慎重な取り扱いが求められる分野では特に欠かせません。従来の検証手法は事前に定義した規則やパターンを使いますが、o1 や o3-mini などの高度なモデルは、文脈を理解してデータについて推論できるため、状況に応じて柔軟に検証できます。
「Braintrust では、多くのお客様が評価プロセスの一部で LLM を評価者として使っています。たとえば医療関連企業なら、gpt-4o のような実行役のモデルで患者からの質問を要約し、その品質を o1 で評価できます。ある Braintrust のお客様では、評価者の F1 スコアが 4o の 0.12 から o1 の 0.74 に上がりました。こうした用途で特に難しく複雑な採点を行う際、o1 の推論能力を使うことで、生成された回答の微妙な違いを見分ける力が飛躍的に向上したという声が寄せられています。」
—Braintrust(AI 評価プラットフォーム)
リーズニングモデルに効果的なプロンプトの書き方
リーズニングモデルは、簡潔でわかりやすいプロンプトで最もよい結果を出します。「ステップごとに考えてください」と指示するなど、プロンプトエンジニアリングの手法によっては性能が向上せず、かえって低下することもあります。以下のベストプラクティスを参照するか、プロンプトの例から始めてください。
- システムメッセージに代わる開発者メッセージ:
o1-2024-12-17以降のリーズニングモデルは、システムメッセージに代わって開発者メッセージをサポートしています。これは、Model Spec で定めた指示の優先順位に沿って動作するためです。 - プロンプトは簡潔かつ直接的に:リーズニングモデルは、短く明確な指示を理解し、それに応えることを得意とします。
- 思考の連鎖を求めるプロンプトは避ける:モデルは内部で推論するため、「ステップごとに考えてください」「推論の過程を説明してください」と指示する必要はありません。
- 区切りを使って構造を明確に:Markdown、XML タグ、セクション見出しなどで入力の各部分を明確に区切ると、モデルがそれぞれのセクションを適切に解釈しやすくなります。
- まずはゼロショット、必要に応じてフューショット:リーズニングモデルはフューショットの例がなくてもよい結果を出せることが多いため、まずは例を含めずにプロンプトを書いてみてください。求める出力の要件が複雑な場合は、入力と期待する出力の組をいくつか示すと役立つことがあります。その際は、例の内容をプロンプトの指示とよく一致させてください。両者に食い違いがあると、結果の質が下がることがあります。
- 具体的な条件を明示:「予算が 500 ドル未満の解決策を提案してください」など、応答に設けたい制約があれば、プロンプトに明記してください。
- 最終目標はできるだけ具体的に:どのような応答なら目標を達成したといえるのか、その条件を指示の中で具体的に示してください。条件を満たすまで推論と改善を繰り返すようモデルに促しましょう。
- Markdown 書式:
o1-2024-12-17以降、API で利用するリーズニングモデルは、既定では応答に Markdown 書式を使いません。Markdown 書式の応答が必要な場合は、開発者メッセージの先頭行に文字列Formatting re-enabledを含めてください。
コストを抑えながら高い精度を保つ方法
o3 と o4-mini の登場により、Responses API で保存された推論アイテムの扱いが変わりました。従来のモデル(o1、o3-mini、o1-mini、o1-preview)では、後続の API リクエストに推論アイテムを入力アイテムとして含めても、常に無視されていました。o3 と o4-mini では、関数呼び出しに隣接する推論アイテムの一部がモデルのコンテキストに含まれます。これにより、推論トークンの使用量を最小限に抑えながらモデルの性能を高められます。
この変更を最大限に活かすには、Responses API の store パラメータを true に設定し、以前のリクエストの推論アイテムをすべて渡すことをおすすめします。previous_response_id を使うか、以前のリクエストの出力アイテムをすべて新しいリクエストの入力アイテムとして渡してください。OpenAI は、関連する推論アイテムを自動的にモデルのコンテキストに含め、関連しないものは無視します。モデルのコンテキストに含める内容をより細かく制御したい高度な用途では、少なくとも、直前のユーザーメッセージから最新の関数呼び出しまでの間にある推論アイテムをすべて含めることをおすすめします。そうすれば、関数呼び出しの結果を返したときにモデルが推論を最初からやり直す必要がなくなり、Function Calling の性能が向上し、全体のトークン使用量も減ります。
Chat Completions API はステートレスな API であるため、推論アイテムがモデルのコンテキストに含まれることはありません。そのため、エージェントが関数呼び出しを何度も行う複雑な用途では、モデルの性能がやや低下し、推論トークンの使用量も増えます。複数の関数呼び出しを複雑に組み合わせない場合は、どちらの API を使っても性能は低下しないと考えられます。
その他のリソース
活用のヒントは、サンプルコードや外部リソースへのリンクを掲載している OpenAI Cookbook で紹介しています。モデルとその推論能力については、以下もご覧ください。