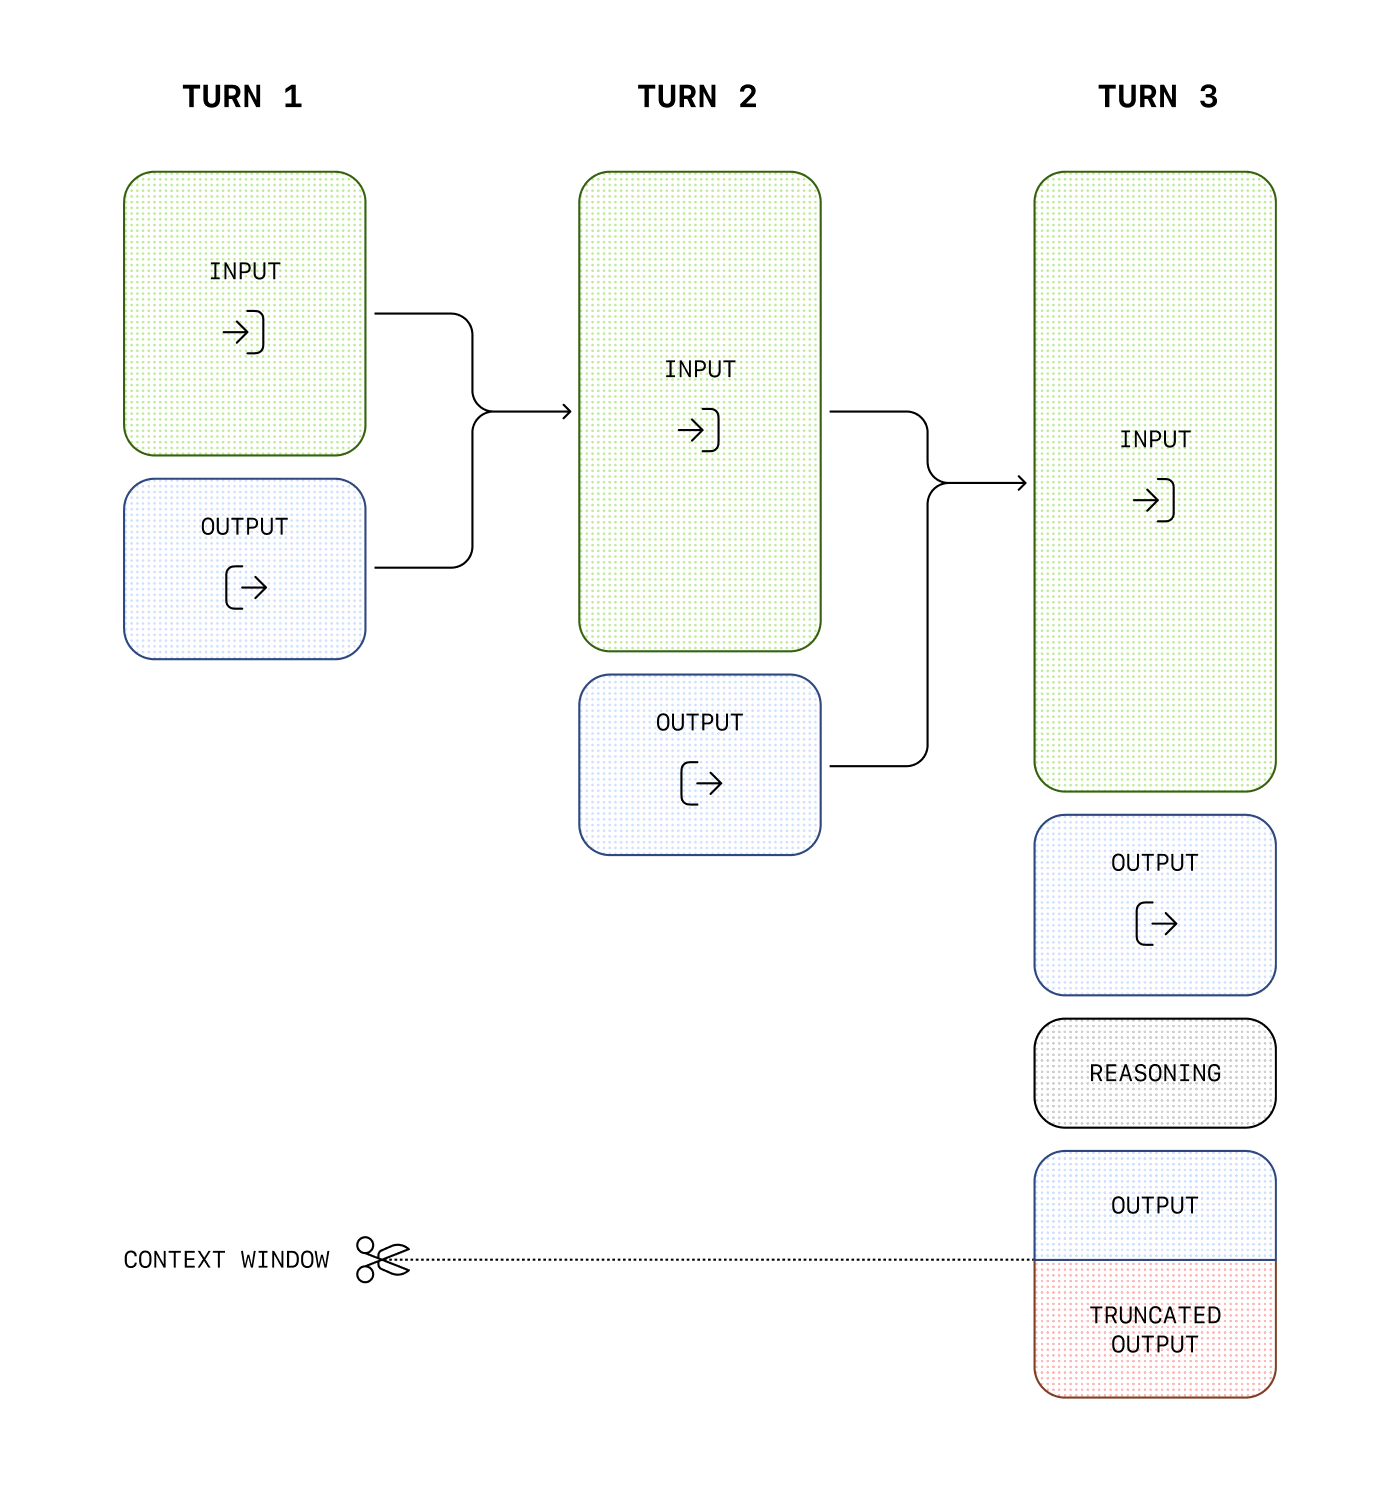
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
GPT-5.6 モデルは、Responses API で standard と pro の推論モードをサポートしています。デフォルトは standard です。モデルによる処理をより多く必要とし、レイテンシとトークン使用量の増加を許容できる難しいタスクでは、reasoning.mode を pro に設定してください。
推論モードと推論強度は独立しています。モードでは標準または pro での実行を選択し、reasoning.effort ではそのモード内でモデルが行う推論の量を制御します。reasoning.effort を省略すると、GPT-5.6 はどちらのモードでもデフォルトで medium を使用します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-5.6", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-5.6", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
モデルがすでに必要としなくなった古いレスポンス項目を再送する場合は、current_turn を使用します。継続性を保つために、これらの推論項目を API ペイロードに残すことはできますが、サービスは新しいサンプルのコンテキストには組み込みません。これにより、長時間にわたるワークフローでモデルに渡すコンテキストを減らせます。
Responses API でリーズニングモデルを使って Function Calling を行う場合は、関数の出力に加えて、最後の関数呼び出しで返された推論項目もすべて渡すことを強くお勧めします。モデルが複数の関数を連続して呼び出す場合は、最後の user メッセージ以降の推論項目、関数呼び出し項目、関数呼び出しの出力項目をすべて渡してください。これにより、モデルは推論プロセスを継続し、トークンを最大限効率よく使いながら、より良い結果を生成できます。
この API リクエストは、アシスタントのメッセージと、そのレスポンスを生成する際にモデルが行った推論の要約の両方を含む出力配列を返します。
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
OpenAI の o シリーズモデルは、複雑なアルゴリズムの実装やコードの生成ができます。このプロンプトでは、特定の条件に基づいて React コンポーネントをリファクタリングするよう o1 に依頼します。
コードのリファクタリング
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
コードのリファクタリング
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
コーディング(計画)
OpenAI の o シリーズモデルは、複数のステップからなる計画の作成にも優れています。このプロンプト例では、目的のユースケースを実装する Python コードと、ソリューション全体のファイルシステム構造を作成するよう o1 に依頼しています。
Python プロジェクトの計画と作成
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Python プロジェクトの計画と作成
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
STEM リサーチ
OpenAI の o シリーズモデルは、STEM 分野の研究で優れた性能を示しています。基礎研究のタスクへの支援を求めるプロンプトでも、優れた結果が期待できます。
基礎科学研究に関する質問
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
基礎科学研究に関する質問
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)