使用する API を選択して、使用量の計測方法と音声アプリケーションのコストを管理する方法を確認してください。
GPT-Live の使用量とコスト
GPT-Live では、音声会話と、推論やツールの実行を担うバックエンドが分離されています。音声セッションのコストは時間に応じて、バックエンドのコストは使用するモデルやツールに応じて決まるため、この 2 つは個別に見積もります。
音声セッションのコスト
GPT-Live の音声セッションは、現在のモデル料金に基づき、秒単位で課金されます。セッション時間が分単位に切り上げられることはありません。
アクティブなセッション時間には、ユーザーが話している時間、アシスタントが話している時間、双方が無言の時間、バックエンドが処理している時間が含まれます。
見積もりでは、セッションの開始から終了までのアクティブな時間を計上します。再生する音声の長さだけを測るのではなく、API が報告する時間を使用してください。マイク入力をミュートしてもセッションは終了しません。会話が終わったら、セッションを終了し、最終的な使用量を取得します。
バックエンドのモデルとツールの料金については、API の料金を参照してください。
WebRTC の初期化料金
WebRTC セッションを作成する POST /v1/live/sessions リクエストでは、セッションの初期化時に音声時間 15 秒分が課金されます。この金額は、セッションの実行開始後に時間に応じた料金から差し引かれます。コストを見積もる際は、実行中のセッション時間にさらに 15 秒を加算しないでください。
たとえば、以下の 90 秒のセッションには、初期化時に課金される 15 秒がすでに含まれています。105 秒分として課金されるわけではありません。再接続や、ユーザーが話す準備を整える前にセッションを作成するアプリケーションを評価する際は、セッション作成時の料金を考慮してください。
バックエンドのコスト
バックエンドの呼び出しは、音声を使用しないアプリケーションと同様に、音声セッションとは別に課金されます。モデルの入力・出力トークン、対応している場合はキャッシュ済み入力、該当する画像やツールの料金を含めてください。アプリケーションがほかのサービスを呼び出す場合は、そのコストも見積もりに含めます。
バックエンドの処理は、音声フロントエンドとは別に最適化できます。 一般的なコスト最適化ガイドを参考に、リクエスト数とトークン使用量を削減してください。 対応するバックエンドモデルでは、プロンプトキャッシュを活用できます。 再利用できる指示、ツール定義など、内容が変わらない情報を プロンプトの先頭に配置してください。
バックエンドの選択によって、会話の長さも変わる場合があります。最適化によってユーザーの待ち時間が長くなる場合や、アシスタントがタスクを完了する確実性が変わる場合は、音声とバックエンドを合わせたコストを比較してください。
会話コストの見積もり
音声セッションが 1 つの会話では、次のように計算します。
総コスト =(課金対象の音声秒数 ÷ 60 × 音声の 1 分あたりの料金)+ バックエンドのコスト
たとえば、音声料金を仮に 1 分あたり $0.05 とすると、90 秒の音声セッションのコストは $0.075 です。バックエンドのモデルとツールのコストが合計 $0.02 の場合、会話のコストは $0.095 になります。
| 項目 | 計算 | コスト |
|---|---|---|
| 音声セッション | 90 秒 ÷ 60 × $0.05 | $0.075 |
| バックエンドの処理 | モデルとツールの合計コスト | $0.02 |
| 会話の合計 | $0.075 + $0.02 | $0.095 |
上記の料金とバックエンドのコストは例です。実際には、現在の音声料金、計測したバックエンド使用量、適用されるモデルとツールの料金を使用してください。タスクが複数の音声セッションにまたがる場合は、それぞれの時間を合算し、セッション間に行われたバックエンド処理も含めます。
最適化の方法
不要な会話や待ち時間を減らし、ユーザーがタスクを完了できるようにすることに重点を置きます。タスクに必要な確認やチェックは維持してください。
セッション開始前の関連コンテキストの提供
音声セッションを開始する前に、アプリケーションがすでに使用許可を得ている情報を集めます。たとえば、注文に関するサポートを行うアシスタントは、注文番号と現在の状況を把握した状態で会話を始められます。これにより、ユーザーは同じ情報を繰り返したり、再照会を待ったりする必要がなくなります。
このコンテキストは最新の状態に保ち、タスクに関連する内容に絞ります。 音声モデルには会話に必要な情報を渡し、詳細な記録やワークフローはバックエンドで管理してください。 セッションの構成と 委任とツールを参照してください。
ツールの待ち時間の短縮
待ち時間を短くすると、ユーザー体験の向上と音声セッションのコスト削減につながります。
たとえば、バックエンドで gpt-5.6-luna を
Fast モードで使用し、独立したツール呼び出しを並列に実行するとします。
こうした最適化によってユーザーが作業を終え、音声セッションを 1 分早く終了できれば、
音声料金を $0.05 削減できます。
バックエンドの追加コストがこの削減額を下回れば、総コストも下がります。
委任イベントが届く前に、文字起こしの断片から先読みで照会を開始することもできます。 バックエンドのコストを計測する際は、 結果が使われなかった先読み処理も含めてください。
モデル、接続、ストリーミング、ツールの最適化については、バックエンドのレイテンシの削減を参照してください。 音声エージェントの評価を使って、有用な音声応答が得られるまでの時間と タスクの成功を検証します。
長時間タスク中のセッション終了
音声フロントエンドとアプリケーションが管理するバックエンドは、独立して実行できます。 クライアント委任を使うと、音声セッションが開いていても閉じていても、 バックエンドワーカーは実行を続けられます。 音声セッションを終了する前に、タスクの状態と会話のコンテキストを保存してください。
アンビエントエージェントでは、ゴールモードでのコーディングなど、 長時間のタスクをバックエンドが処理している間は音声セッションを終了します。 会話を再開 というラベルのボタンを用意して、ユーザーが戻ったときに新しい音声セッションを開始できるようにします。 または、バックエンドの完了イベントを使って新しいセッションを開始し、 結果が用意できたことをユーザーに通知します。
保存したコンテキストと検証済みのタスク結果を input に含めて
新しいセッションを開始し、会話を復元します。たとえば、
新しい WebSocket 接続を介して、次の開始イベントを送信します。
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}session.started を受信してから、音声のストリーミングを開始してください。
サポートされる履歴形式については、過去の会話を使ったセッションの初期化を
参照してください。
以前のセッションが store: true で保存されていれば、そのセッションをフォークすることもできます。どちらの方法を使う場合も、検証済みのバックエンドのタスク状態はアプリケーション内に保持してください。
セッションを終了すると、音声を使用しない待機時間 1 分あたり $0.05 を削減できます。この削減額を、再接続のコストやユーザー体験が中断される影響と比較してください。
適切なバックエンドモデルの選択
まず、タスクの精度と信頼性の要件を満たすモデルを選びます。 次に、音声時間、モデル使用量、ツール呼び出し、 再試行を含む会話の総コストを比較します。モデル選択ガイドでは、 これらのトレードオフのバランスを取る方法を説明しています。
大規模なバックエンドモデルでも、タスクをより速く完了し、音声セッションのコスト削減額が追加のトークンコストを上回れば、全体のコストを抑えられます。一方、安価なモデルでも、処理に時間がかかる、ツール呼び出しを繰り返す、タスクに失敗するといった場合は、全体のコストが高くなることがあります。
成功したタスク 1 件あたりのコストを、完了率や完了までの時間と合わせて比較してください。完了した作業が少ないために安価な構成のほうが優れて見えることのないよう、失敗した試行や再試行も合計に含めます。比較を計画する際は、音声エージェント評価の Cookbookを活用してください。
実際の使用量の監視
セッションごとに、音声時間とバックエンド使用量を別々に記録します。GPT-Live は、累積音声時間を秒単位で報告します。
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}更新のたびに、前回の時間のスナップショットが置き換えられます。スナップショットの値を合算しないでください。
session.close を送信した後は、session.closed を受信するまでイベントの受信を続け、
その最終的な usage.seconds を 1 回だけ記録します。
正常終了の手順に従い、
切断前にアプリケーションが最終的な使用量を取得できるようにしてください。
Responses 委任では、response.event を介して配信される、ネストされた
response.completed イベントからバックエンド応答の usage を読み取ります。
応答 ID を使って各バックエンド応答を 1 回だけ計上し、
そのモデルの料金を適用するために必要な入力・出力・キャッシュ済みトークンの詳細を保持します。
アプリケーションが独立して実行するバックエンド処理についても、それらのリクエストから使用量を取得してください。
代表的な会話について、見積もりと実際の合計を比較します。評価専用のモデル呼び出しはアプリケーションの使用量と分けて管理し、タスクの成功とコストを合わせて確認してください。
Realtime API のコスト
このドキュメントでは、Realtime API の課金の仕組みと、コストを最適化する方法を説明します。音声エージェントのセッションでは、テキスト、音声、画像の各モダリティで入出力トークンが計上されます。ストリーミング翻訳とストリーミング文字起こしのセッションは、音声の長さに応じて課金されます。料金はモデルごとに異なり、各モデルのページに記載されています(例:gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper、gpt-realtime)。
対話型の Realtime API セッションは、一連の ターンで構成されます。各ターンでは、ユーザーが入力を追加すると Response が作成され、モデルの出力が生成されます。サーバーは、次のターンへの入力となる Items のリストを Conversation として保持します。Response が返されると、その出力は自動的に Conversation に追加されます。
翻訳と文字起こしのセッションでは、異なるストリーミングアーキテクチャを使用します。クライアントは音声を継続的にストリーミング送信し、元の音声が届くのに合わせて、翻訳された音声、文字起こしの差分、または文字起こしイベントを受信します。これらのセッションでは通常の Response ライフサイクルを使用しないため、Response ごとのトークン使用量ではなく、音声の長さに基づく料金でコストを見積もり、監視してください。
Response ごとのコスト
Realtime API では、Response が作成された時点でコストが発生し、入出力トークン数に基づいて課金されます(入力音声の文字起こしのコストは除きます。後述)。現在、ネットワーク帯域幅や接続に料金はかかりません。Response は手動で作成できるほか、音声区間検出(VAD)が有効な場合は自動で作成することもできます。VAD は実質的に無音の入力音声を除外するため、クライアントが会話への入力として手動で追加しない限り、無音部分は入力トークンにカウントされません。
Response ごとに、会話全体がモデルに送信されます。各ターンの出力は Items としてサーバー上の Conversation に追加され、以降のターンの入力となるため、セッションの後半のターンほどコストが高くなります。
テキストトークンのコストは、OpenAI のトークン化ツールで見積もることができます。ユーザーメッセージの音声トークンは音声 100 ms あたり 1 トークン、アシスタントメッセージの音声トークンは音声 50 ms あたり 1 トークンです。トークン数にはメッセージの内容以外に特殊トークンも含まれるため、実際の数には多少の差が生じます。たとえば、内容が 10 テキストトークンのユーザーメッセージが、12 トークンとしてカウントされる場合があります。
例
複数ターンにわたる Realtime API セッションのトークンコストを、簡単な例で説明します。
会話の最初のターンでは、100 トークンの指示と、20 音声トークンのユーザーメッセージ(たとえば、ユーザーの発話に基づいて VAD が追加したもの)を追加し、入力は合計 120 トークンになります。Response を作成すると、アシスタントの出力メッセージ(音声 20 トークン、テキスト 10 トークン)が生成されます。
次に、ユーザーの音声メッセージをもう 1 つ追加して、2 ターン目を作成します。2 ターン目のトークン数はどうなるでしょうか。この時点の Conversation には、最初の指示、最初のユーザーメッセージ、1 ターン目に出力されたアシスタントメッセージに加えて、2 つ目のユーザーメッセージ(25 音声トークン)が含まれます。このターンの入力はテキスト 110 トークンと音声 64 トークンで、さらに新たなアシスタントメッセージの出力トークンが加わります。
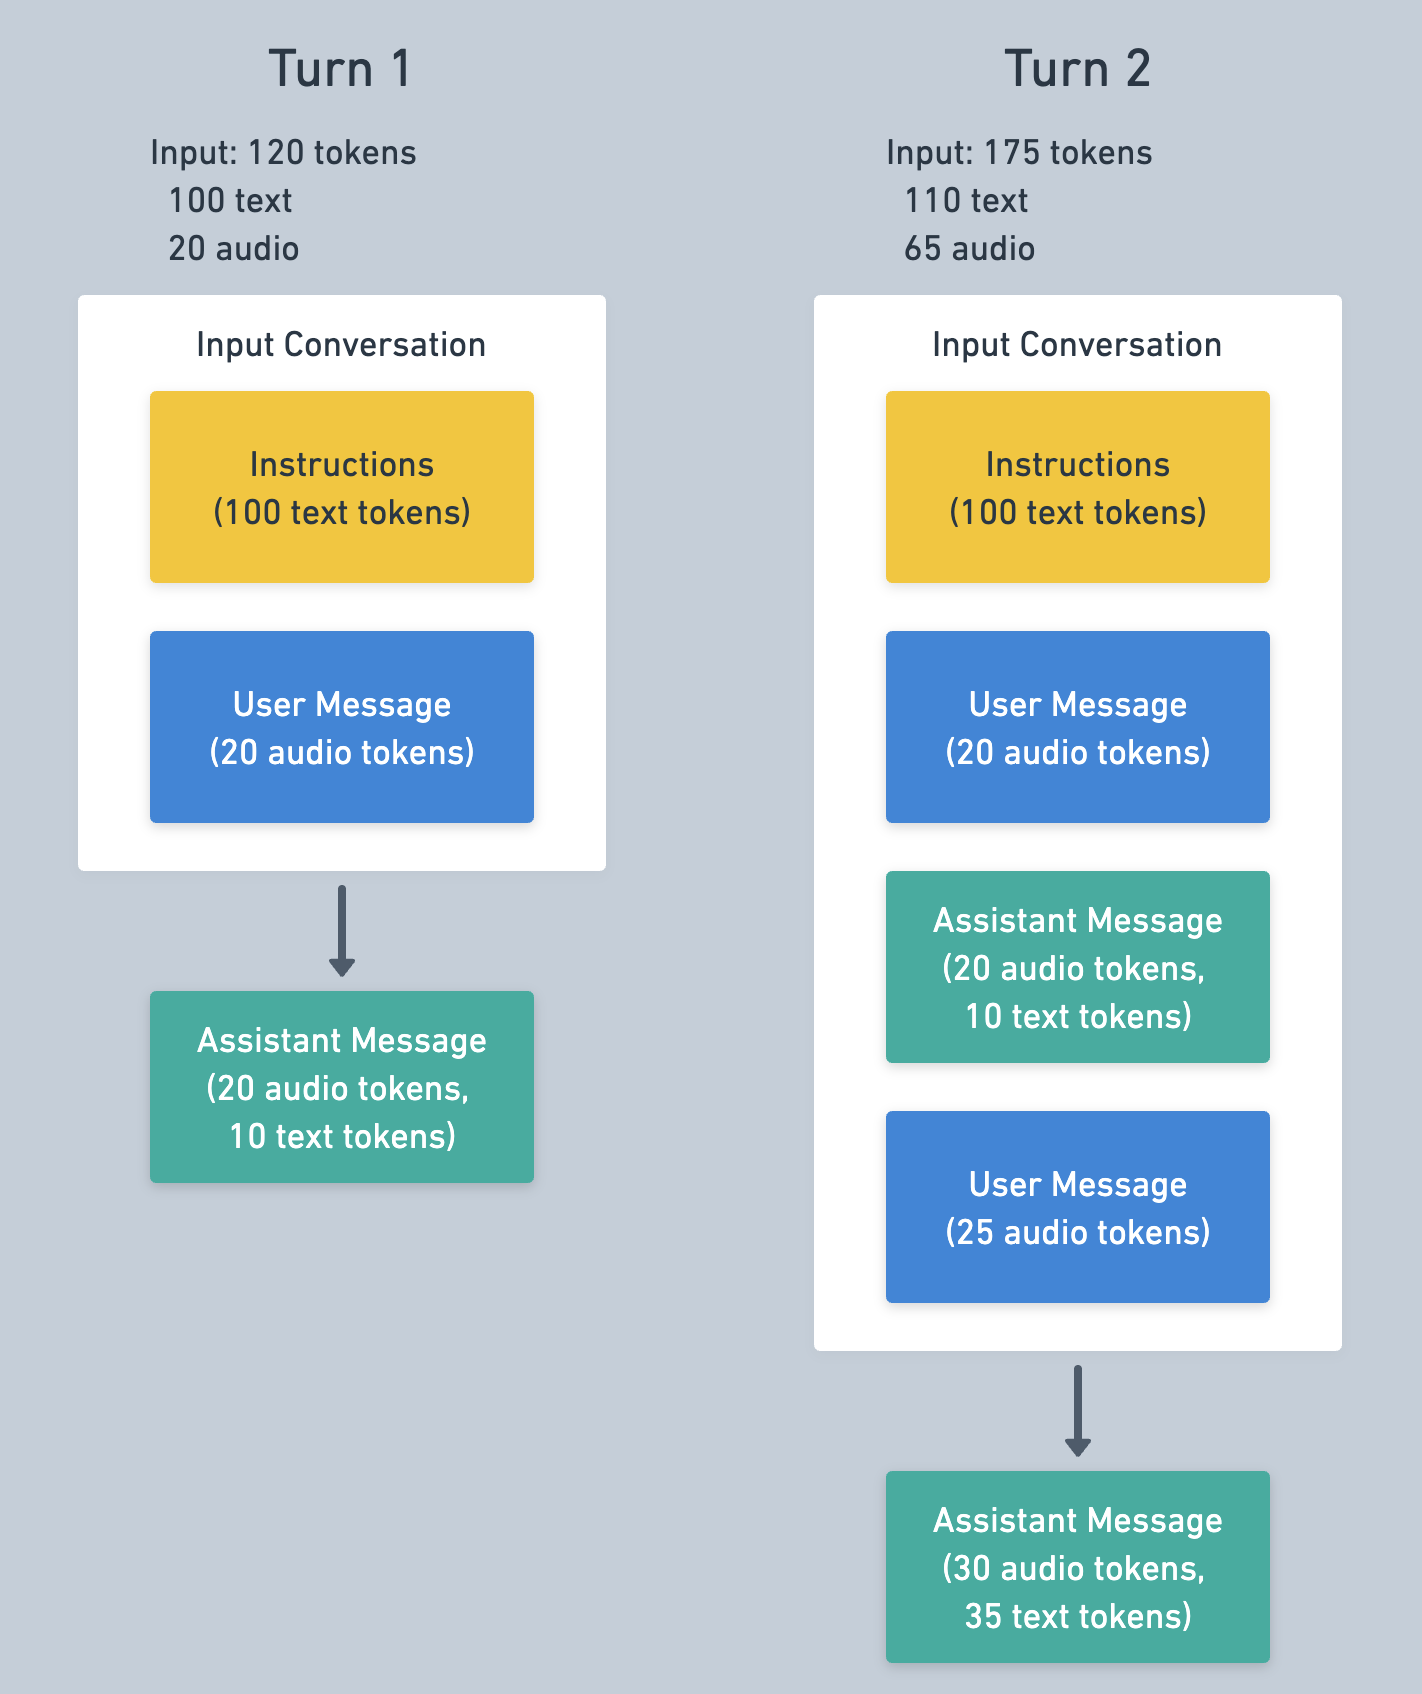
1 ターン目のメッセージは、2 ターン目ではキャッシュされている可能性が高く、入力コストを削減できます。キャッシュの詳細は後述します。
Response で使用されたトークン数は、次のような response.done イベントから取得できます。
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}入力音声の文字起こしのコスト
Realtime API では、会話の Response に加え、入力音声の文字起こしが有効な場合はその分も課金されます。入力音声の文字起こしには、whisper-1 や gpt-4o-transcribe など、speech2speech モデルとは異なるモデルを使用するため、別の料金体系が適用されます。文字起こしは、音声が入力音声バッファに書き込まれた後、手動または VAD によってコミットされると実行されます。
入力音声の文字起こしのトークン数は、次の例のように conversation.item.input_audio_transcription.completed イベントから取得できます。
{
"type": "conversation.item.input_audio_transcription.completed",
...
"transcript": "Hi, can you hear me?",
"usage": {
"type": "tokens",
"total_tokens": 26,
"input_tokens": 17,
"input_token_details": {
"text_tokens": 0,
"audio_tokens": 17
},
"output_tokens": 9
}
}キャッシュ
Realtime API はプロンプトキャッシュに対応しています。これは自動的に適用され、複数ターンのセッションで入力トークンのコストを大幅に削減できます。Response の入力トークンが以前の Response のトークンと一致するとキャッシュが適用されますが、ベストエフォートであり、保証はされません。
キャッシュ率を最大限に高めるには、セッションの既存の履歴を変更しないことが最も効果的です。会話内の内容を削除または変更すると、変更箇所までのキャッシュが無効になり、入力の一致する部分が以前より少なくなります。指示とツール定義は会話の先頭にあるため、セッションの途中でこれらを変更すると、以降のターンのキャッシュ率が低下します。
切り詰め
会話のトークン数がモデルの入力トークン上限を超えると、会話が切り詰められます。つまり、最も古いメッセージから順に Response の入力から削除されます。コンテキストが 32k で最大出力トークン数が 4,096 のモデルでは、切り詰めが発生する前にコンテキストに含められるのは 28,224 トークンまでです。
クライアントは、モデルの最大値より小さいトークンウィンドウを設定できます。これはトークン使用量とコストを管理するうえで有効です。以下のように切り詰めの種類を retention_ratio に設定した場合、token_limits.post_instructions の設定で制御できます。名前が示すとおり、この設定は指示のトークンを除いた、Response の最大入力トークン数を制御します。post_instructions を 1,000 に設定すると、入力トークンの上限である 1,000 を超える項目は、Response の生成時にモデルへ送信されません。
切り詰めが発生すると、会話の先頭付近のキャッシュが無効になります。毎ターン切り詰めが発生すると、キャッシュ率は非常に低くなります。この問題を緩和するため、クライアントは必要な数より多くのメッセージを削除するように切り詰めを設定できます。これにより、次の切り詰めが必要になるまでの余裕が増えます。この動作は session.truncation.retention_ratio の設定で制御できます。サーバーのデフォルト値は 1.0 で、切り詰め時に必要な分の項目だけを削除します。0.8 を指定すると、切り詰め時に最大値の 80% を保持し、さらに 20% を削除します。
特定のモデルで Realtime API のセッションあたりのコストを削減したい場合は、次の例のように、トークン数の上限を下げ、retention_ratio を 1 未満に設定することをお勧めします。ただし、コストが下がる一方で、各ターンでモデルが保持できる会話の情報量も減るというトレードオフが生じる可能性があります。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}以下のように、切り詰めを完全に無効にすることもできます。無効にすると、Conversation が長すぎて Response を作成できない場合にエラーが返されます。Conversation のサイズを手動で管理する場合に便利です。
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}その他の最適化方法
mini モデルの使用
Realtime の speech2speech モデルには、通常サイズと、大幅に安価な mini サイズがあります。主なトレードオフは指示への追従や Function Calling に関わる性能で、mini モデルではこれらの能力が劣る傾向があります。まず大きいモデルでアプリケーションをテストし、アプリケーションとプロンプトを改善してから、mini モデルによる最適化を試すことをお勧めします。
Conversation の編集
切り詰めはサーバー上で自動的に行われますが、Conversation を手動で編集することもコスト管理の方法の 1 つです。この API は、サーバー側の Conversation をクライアントが完全に制御できることを基本方針としており、クライアントは自由に項目を追加・削除できます。
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}古いメッセージを削除すると、入力トークン数とコストを効果的に削減できます。重要な内容まで削除してしまう可能性もありますが、一般的な対策として、古いメッセージを要約に置き換える方法があります。項目は、上記のように conversation.item.delete メッセージで Conversation から削除でき、conversation.item.create メッセージで追加できます。
コストの見積もり
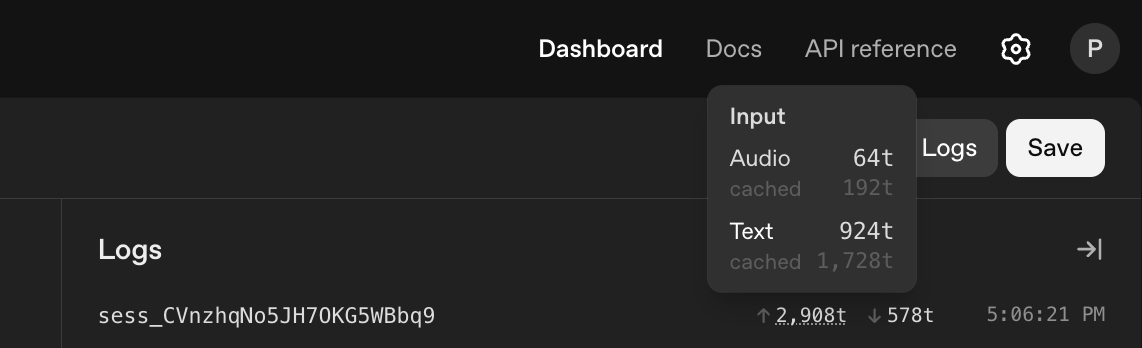
Realtime API のトークン使用量は複雑なため、コストを事前に見積もるのは難しい場合があります。実際に使用する予定のプロンプトと関数を Realtime Playground に設定し、サンプルセッションでトークン使用量を測定する方法が有効です。セッションのトークン使用量は、Realtime Playground の「ログ」タブで、セッション ID の横に表示されます。