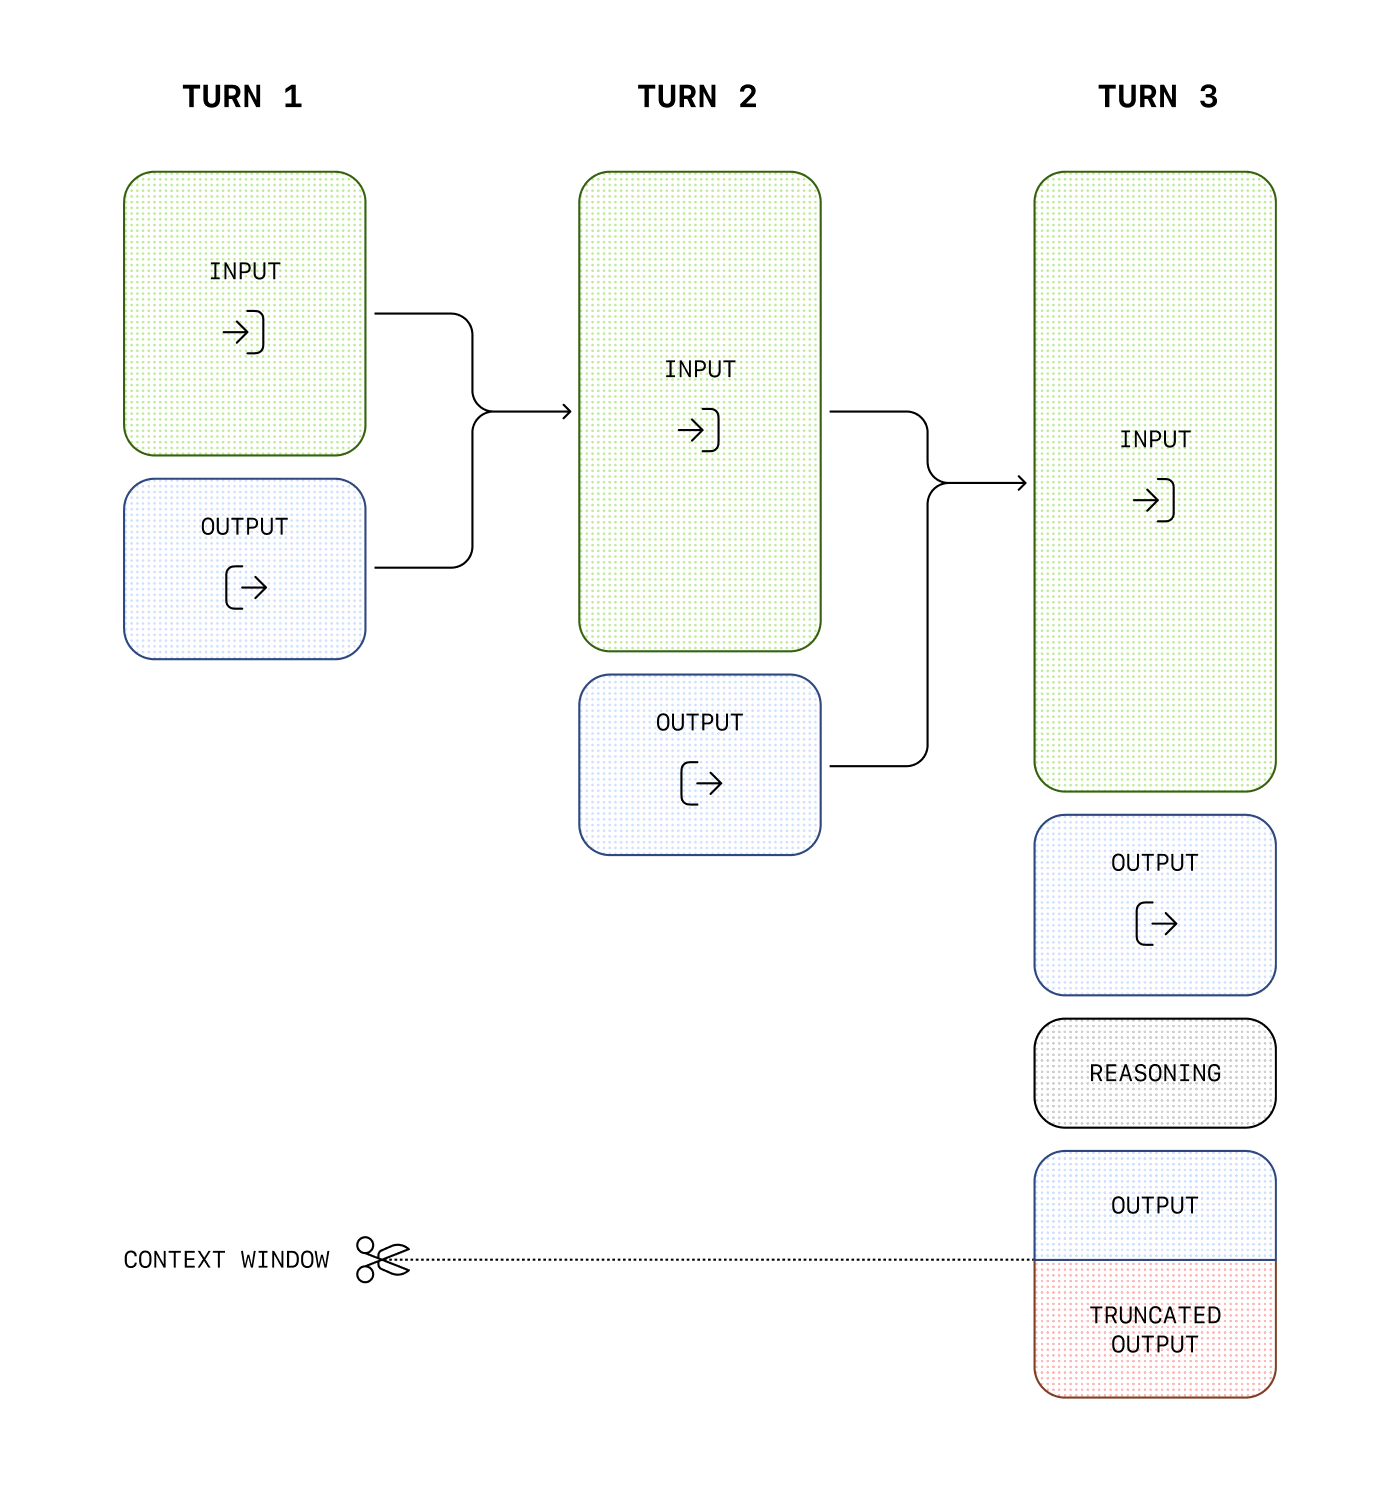
대화에서 여러 차례 메시지를 주고받는 동안 정보를 유지하려면 대화 상태를 관리해야 합니다. OpenAI는 이를 위한 몇 가지 방법을 제공합니다.
GPT-5.5가 중간 진행 상황을 최종 답변으로 처리한다면, API 연동 코드에서 어시스턴트 메시지의 phase 필드를 올바르게 보존하는지 확인하세요. 자세한 내용은 phase 매개변수 를 참고하세요.
텍스트 생성 요청은 각각 독립적이며 상태를 유지하지 않습니다. 그래도 요청 매개변수에 이전 메시지를 함께 전달하면 여러 턴에 걸친 대화 를 구현할 수 있습니다. 문을 두드리는 소리로 시작해 서로 말을 주고받는 농담을 예로 들어 보겠습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 import OpenAI from "openai";
const openai = new OpenAI();
const response = await openai.chat.completions.create({
model: "gpt-6-astra",
messages: [
{
role: "user",
content: "knock knock.",
},
{
role: "assistant",
content: "Who's there?",
},
{
role: "user",
content: "Orange.",
},
],
});
console.log(response.choices[0].message.content); 1
2
3
4
5
6
7
8
9
10
11
12
13
14 from openai import OpenAI
client = OpenAI()
response = client.chat.completions.create(
model = "gpt-6-astra" ,
messages = [
{ "role" : "user" , "content" : "knock knock." },
{ "role" : "assistant" , "content" : "Who's there?" },
{ "role" : "user" , "content" : "Orange." },
],
)
print (response.choices[ 0 ].message.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6-astra",
Messages: []openai.ChatCompletionMessageParamUnion{
openai.UserMessage("Knock knock."),
openai.AssistantMessage("Who's there?"),
openai.UserMessage("Orange."),
},
})
if err != nil {
panic(err)
}
fmt.Println(completion.Choices[0].Message.Content)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
ChatCompletionCreateParams params =
ChatCompletionCreateParams.builder()
.model("gpt-6-astra")
.addUserMessage("Knock knock.")
.addAssistantMessage("Who's there?")
.addUserMessage("Orange.")
.build();
client.chat().completions().create(params).choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 using OpenAI.Chat;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);
ChatCompletion completion = await client.CompleteChatAsync(
[
new UserChatMessage("Knock knock."),
new AssistantChatMessage("Who's there?"),
new UserChatMessage("Orange."),
]
);
Console.WriteLine(completion.Content[0].Text); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 require "openai"
client = OpenAI::Client.new
completion = client.chat.completions.create(
model: "gpt-6-astra",
messages: [
{
role: :user,
content: "Knock knock."
},
{
role: :assistant,
content: "Who's there?"
},
{
role: :user,
content: "Orange."
}
]
)
puts(completion.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14 import OpenAI from "openai";
const openai = new OpenAI();
const response = await openai.responses.create({
model: "gpt-6-astra",
input: [
{ role: "user", content: "knock knock." },
{ role: "assistant", content: "Who's there?" },
{ role: "user", content: "Orange." },
],
});
console.log(response.output_text); 1
2
3
4
5
6
7
8
9
10
11
12
13
14 from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model = "gpt-6-astra" ,
input = [
{ "role" : "user" , "content" : "knock knock." },
{ "role" : "assistant" , "content" : "Who's there?" },
{ "role" : "user" , "content" : "Orange." },
],
)
print (response.output_text) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/responses"
)
func main() {
client := openai.NewClient()
response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
Model: "gpt-6-astra",
Input: responses.ResponseNewParamsInputUnion{
OfInputItemList: responses.ResponseInputParam{
responses.ResponseInputItemParamOfMessage("Knock knock.", responses.EasyInputMessageRoleUser),
responses.ResponseInputItemParamOfMessage("Who's there?", responses.EasyInputMessageRoleAssistant),
responses.ResponseInputItemParamOfMessage("Orange.", responses.EasyInputMessageRoleUser),
},
},
})
if err != nil {
panic(err)
}
fmt.Println(response.OutputText())
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.List;
ResponseCreateParams params =
ResponseCreateParams.builder()
.model("gpt-6-astra")
.inputOfResponse(
List.of(
ResponseInputItem.ofEasyInputMessage(
EasyInputMessage.builder()
.role(EasyInputMessage.Role.USER)
.content("Knock knock.")
.build()),
ResponseInputItem.ofEasyInputMessage(
EasyInputMessage.builder()
.role(EasyInputMessage.Role.ASSISTANT)
.content("Who's there?")
.build()),
ResponseInputItem.ofEasyInputMessage(
EasyInputMessage.builder()
.role(EasyInputMessage.Role.USER)
.content("Orange.")
.build())))
.build();
client.responses().create(params).output().stream()
.flatMap(item -> item.message().stream())
.flatMap(message -> message.content().stream())
.flatMap(content -> content.outputText().stream())
.forEach(text -> System.out.println(text.text())); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 using OpenAI.Responses;
#pragma warning disable OPENAI001
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);
ResponseResult response = await client.CreateResponseAsync(
"gpt-6-astra",
[
ResponseItem.CreateUserMessageItem("Knock knock."),
ResponseItem.CreateAssistantMessageItem("Who's there?"),
ResponseItem.CreateUserMessageItem("Orange."),
]
);
Console.WriteLine(response.GetOutputText()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 require "openai"
client = OpenAI::Client.new
response = client.responses.create(
model: "gpt-6-astra",
input: [
{
role: :user,
content: "Knock knock."
},
{
role: :assistant,
content: "Who's there?"
},
{
role: :user,
content: "Orange."
}
]
)
puts(response.output_text)
user 메시지와 assistant 메시지를 번갈아 배치하면 모델에 보내는 요청 하나에 이전 대화 상태를 담을 수 있습니다.
모델이 응답을 생성할 때마다 컨텍스트를 직접 전달하려면 이전 응답의 출력을 다음 요청의 입력에 추가하세요.
상태를 유지하지 않는 방식으로 추론 모델을 호출할 때는 응답의 output 배열에 있는 모든 항목을 보존하세요. Responses API는 기본적으로 암호화된 추론 항목을 반환합니다. 전체 출력을 다음 요청에 그대로 전달하면 추론 항목과 어시스턴트 메시지의 phase 값이 유지됩니다. 추론 내용 저장을 지원하는 모델에서는 reasoning.context: "all_turns"를 사용해 다음 샘플을 생성할 때 이전 턴의 추론 내용 중 사용 가능한 부분을 포함할 수 있습니다. API 호출 간 추론 내용 보존하기 를 참고하세요.
추론 항목을 다음 요청에 다시 전달할 때는 모델이 해당 항목을 생성하는 데 사용한 대화 기록도 그대로 유지하세요. 대화 기록을 수정하면 추론에 어떤 영향을 미치는지는 접두부를 그대로 유지하기 에서 확인하세요.
다음 예제에서는 모델에 농담을 하나 해 달라고 한 뒤 다른 농담을 하나 더 요청합니다. 이렇게 새 요청에 이전 응답을 추가하면 앞선 대화의 컨텍스트가 유지되어 대화가 자연스럽게 이어집니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 import OpenAI from "openai";
const openai = new OpenAI();
let history = [
{
role: "user",
content: "tell me a joke",
},
];
const completion = await openai.chat.completions.create({
model: "gpt-6-astra",
messages: history,
});
console.log(completion.choices[0].message.content);
history.push(completion.choices[0].message);
history.push({
role: "user",
content: "tell me another",
});
const secondCompletion = await openai.chat.completions.create({
model: "gpt-6-astra",
messages: history,
});
console.log(secondCompletion.choices[0].message.content); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 from openai import OpenAI
client = OpenAI()
history = [{ "role" : "user" , "content" : "tell me a joke" }]
response = client.chat.completions.create(
model = "gpt-6-astra" ,
messages = history,
)
print (response.choices[ 0 ].message.content)
history.append(response.choices[ 0 ].message)
history.append({ "role" : "user" , "content" : "tell me another" })
second_response = client.chat.completions.create(
model = "gpt-6-astra" ,
messages = history,
)
print (second_response.choices[ 0 ].message.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
history := []openai.ChatCompletionMessageParamUnion{
openai.UserMessage("Tell me a joke."),
}
first, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6-astra",
Messages: history,
})
if err != nil {
panic(err)
}
fmt.Println(first.Choices[0].Message.Content)
history = append(history,
openai.AssistantMessage(first.Choices[0].Message.Content),
openai.UserMessage("Tell me another."),
)
second, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6-astra",
Messages: history,
})
if err != nil {
panic(err)
}
fmt.Println(second.Choices[0].Message.Content)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
var params =
ChatCompletionCreateParams.builder()
.model("gpt-6-astra")
.addUserMessage("Tell me a joke.")
.build();
var first = client.chat().completions().create(params);
first.choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println);
var second =
client
.chat()
.completions()
.create(
params.toBuilder()
.addAssistantMessage(first.choices().get(0).message().content().orElseThrow())
.addUserMessage("Tell me another.")
.build());
second.choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println); 1
2
3
4
5
6
7
8
9
10
11
12
13
14 using OpenAI.Chat;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);
List<ChatMessage> messages = [new UserChatMessage("Tell me a joke.")];
ChatCompletion first = await client.CompleteChatAsync(messages);
Console.WriteLine(first.Content[0].Text);
messages.Add(new AssistantChatMessage(first));
messages.Add(new UserChatMessage("Tell me another."));
ChatCompletion second = await client.CompleteChatAsync(messages);
Console.WriteLine(second.Content[0].Text); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 require "openai"
client = OpenAI::Client.new
history = [
{
role: :user,
content: "Tell me a joke."
}
]
first = client.chat.completions.create(
model: "gpt-6-astra",
messages: history
)
puts(first.choices.fetch(0).message.content)
history << {
role: :assistant,
content: first.choices.fetch(0).message.content
}
history << {
role: :user,
content: "Tell me another."
}
second = client.chat.completions.create(
model: "gpt-6-astra",
messages: history
)
puts(second.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 import OpenAI from "openai";
import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";
const openai = new OpenAI();
let history = [
{
role: "user",
content: "tell me a joke",
},
];
const response = await openai.responses.create({
model: "gpt-6-astra",
input: history,
store: false,
});
console.log(response.output_text);
// Add replayable output items, including reasoning items, to the history
history.push(...toResponseInputItems(response.output));
history.push({
role: "user",
content: "tell me another",
});
const secondResponse = await openai.responses.create({
model: "gpt-6-astra",
input: history,
store: false,
});
console.log(secondResponse.output_text); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 from openai import OpenAI
client = OpenAI()
history = [{ "role" : "user" , "content" : "tell me a joke" }]
response = client.responses.create(
model = "gpt-6-astra" ,
input = history,
store = False ,
)
print (response.output_text)
# Add all response output items, including encrypted reasoning items, to the conversation
history += response.output
history.append({ "role" : "user" , "content" : "tell me another" })
second_response = client.responses.create(
model = "gpt-6-astra" ,
input = history,
store = False ,
)
print (second_response.output_text) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50 package main
import (
"context"
"encoding/json"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/responses"
)
func main() {
client := openai.NewClient()
history := responses.ResponseInputParam{
responses.ResponseInputItemParamOfMessage("tell me a joke", responses.EasyInputMessageRoleUser),
}
first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
Model: "gpt-6-astra",
Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
Store: openai.Bool(false),
})
if err != nil {
panic(err)
}
fmt.Println(first.OutputText())
history = append(history, outputAsInput(first.Output)...)
history = append(history, responses.ResponseInputItemParamOfMessage("tell me another", responses.EasyInputMessageRoleUser))
second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
Model: "gpt-6-astra",
Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
Store: openai.Bool(false),
})
if err != nil {
panic(err)
}
fmt.Println(second.OutputText())
}
func outputAsInput(output []responses.ResponseOutputItemUnion) []responses.ResponseInputItemUnionParam {
input := make([]responses.ResponseInputItemUnionParam, 0, len(output))
for _, item := range output {
var converted responses.ResponseInputItemUnion
if err := json.Unmarshal([]byte(item.RawJSON()), &converted); err != nil {
panic(err)
}
input = append(input, converted.ToParam())
}
return input
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.ArrayList;
var history = new ArrayList<ResponseInputItem>();
history.add(
ResponseInputItem.ofEasyInputMessage(
EasyInputMessage.builder()
.role(EasyInputMessage.Role.USER)
.content("Tell me a joke.")
.build()));
var first =
client
.responses()
.create(
ResponseCreateParams.builder()
.model("gpt-6-astra")
.inputOfResponse(history)
.store(false)
.build());
first.output().stream()
.flatMap(item -> item.message().stream())
.flatMap(message -> message.content().stream())
.flatMap(content -> content.outputText().stream())
.forEach(text -> System.out.println(text.text()));
first.output().stream()
.map(item -> JsonValue.from(item).convert(ResponseInputItem.class))
.forEach(history::add);
history.add(
ResponseInputItem.ofEasyInputMessage(
EasyInputMessage.builder()
.role(EasyInputMessage.Role.USER)
.content("Tell me another.")
.build()));
client
.responses()
.create(
ResponseCreateParams.builder()
.model("gpt-6-astra")
.inputOfResponse(history)
.store(false)
.build())
.output()
.stream()
.flatMap(item -> item.message().stream())
.flatMap(message -> message.content().stream())
.flatMap(content -> content.outputText().stream())
.forEach(text -> System.out.println(text.text())); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 using OpenAI.Responses;
#pragma warning disable OPENAI001
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);
List<ResponseItem> history =
[
ResponseItem.CreateUserMessageItem("Tell me a joke."),
];
CreateResponseOptions options = new("gpt-6-astra", history)
{
StoredOutputEnabled = false,
IncludedProperties =
{
IncludedResponseProperty.ReasoningEncryptedContent,
},
};
ResponseResult first = await client.CreateResponseAsync(options);
Console.WriteLine(first.GetOutputText());
history.AddRange(first.OutputItems);
history.Add(ResponseItem.CreateUserMessageItem("Tell me another."));
options = new("gpt-6-astra", history)
{
StoredOutputEnabled = false,
IncludedProperties =
{
IncludedResponseProperty.ReasoningEncryptedContent,
},
};
ResponseResult second = await client.CreateResponseAsync(options);
Console.WriteLine(second.GetOutputText()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29 require "openai"
client = OpenAI::Client.new
history = [
{
role: :user,
content: "Tell me a joke."
}
]
first = client.responses.create(
model: "gpt-6-astra",
input: history,
store: false
)
puts(first.output_text)
history.concat(first.output)
history << {
role: :user,
content: "Tell me another."
}
second = client.responses.create(
model: "gpt-6-astra",
input: history,
store: false
)
puts(second.output_text)
OpenAI API를 사용하면 대화 상태를 자동으로 관리할 수 있어 매 턴마다 이전 입력을 직접 전달할 필요가 없습니다.
Responses API 사용을 권장합니다. 이 API는 상태를 유지하므로 매개변수 하나로 대화 간 컨텍스트를 관리할 수 있습니다.
Chat Completions 엔드포인트를 사용한다면 앞에서 설명한 방법으로 대화 상태를 직접 관리해야 합니다.
Conversations API 는 Responses API 와 함께 대화 상태를 장기간 유지되는 객체에 저장합니다. 이 객체에는 계속 사용할 수 있는 고유 식별자가 있습니다. 대화 객체를 한 번 만들면 세션, 기기 또는 작업이 바뀌어도 같은 객체를 사용할 수 있습니다.
대화 객체에는 메시지, 도구 호출, 도구 출력 및 기타 데이터가 개별 항목으로 저장됩니다.
const conversation = await client.conversations.create(); conversation = openai.conversations.create() conversation, err := client.Conversations.New(context.Background(), conversations.ConversationNewParams{})
if err != nil {
panic(err)
} import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
var conversation = client.conversations().create();
System.out.println(conversation.id()); conversation = client.conversations.create 여러 턴에 걸쳐 대화할 때는 후속 응답을 생성하는 요청에 conversation을 전달하세요. 여러 응답 항목을 일일이 연결할 필요 없이 대화 상태를 유지하고 후속 응답 간에 컨텍스트를 공유할 수 있습니다.
1
2
3
4
5
6
7 const response = await client.responses.create({
model: "gpt-6-astra",
input: [{ role: "user", content: "What are the five Ds of dodgeball?" }],
conversation: conversation.id,
});
console.log(response.output_text); 1
2
3
4
5 response = openai.responses.create(
model = "gpt-6-astra" ,
input = [{ "role" : "user" , "content" : "What are the 5 Ds of dodgeball?" }],
conversation = conversation.id,
) 1
2
3
4
5
6
7
8
9
10
11
12
13 response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
Model: "gpt-6-astra",
Conversation: responses.ResponseNewParamsConversationUnion{
OfString: openai.String(conversation.ID),
},
Input: responses.ResponseNewParamsInputUnion{
OfString: openai.String("What are the five Ds of dodgeball?"),
},
})
if err != nil {
panic(err)
}
fmt.Println(response.OutputText()) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;
var conversation = client.conversations().create();
var response =
client
.responses()
.create(
ResponseCreateParams.builder()
.model("gpt-6-astra")
.conversation(conversation.id())
.input("What are the five Ds of dodgeball?")
.build());
response.output().stream()
.flatMap(item -> item.message().stream())
.flatMap(message -> message.content().stream())
.flatMap(content -> content.outputText().stream())
.forEach(text -> System.out.println(text.text())); 1
2
3
4
5
6
7 response = client.responses.create(
model: "gpt-6-astra",
conversation: conversation.id,
input: "What are the five Ds of dodgeball?"
)
puts(response.output_text) 대화 상태를 관리하는 또 다른 방법은 previous_response_id 매개변수로 응답 간에 컨텍스트를 공유하는 것입니다. 이 매개변수를 사용하면 응답을 차례로 연결해 하나의 대화 스레드를 구성할 수 있습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 import OpenAI from "openai";
const openai = new OpenAI();
const response = await openai.responses.create({
model: "gpt-6-astra",
input: "tell me a joke",
store: true,
});
console.log(response.output_text);
const secondResponse = await openai.responses.create({
model: "gpt-6-astra",
previous_response_id: response.id,
input: [{ role: "user", content: "explain why this is funny." }],
store: true,
});
console.log(secondResponse.output_text); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model = "gpt-6-astra" ,
input = "tell me a joke" ,
)
print (response.output_text)
second_response = client.responses.create(
model = "gpt-6-astra" ,
previous_response_id = response.id,
input = [{ "role" : "user" , "content" : "explain why this is funny." }],
)
print (second_response.output_text) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/responses"
)
func main() {
client := openai.NewClient()
first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
Model: "gpt-6-astra",
Input: responses.ResponseNewParamsInputUnion{
OfString: openai.String("Tell me a joke."),
},
})
if err != nil {
panic(err)
}
fmt.Println(first.OutputText())
second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
Model: "gpt-6-astra",
PreviousResponseID: openai.String(first.ID),
Input: responses.ResponseNewParamsInputUnion{
OfString: openai.String("Explain why this is funny."),
},
})
if err != nil {
panic(err)
}
fmt.Println(second.OutputText())
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;
var first =
client
.responses()
.create(
ResponseCreateParams.builder().model("gpt-6-astra").input("Tell me a joke.").build());
first.output().stream()
.flatMap(item -> item.message().stream())
.flatMap(message -> message.content().stream())
.flatMap(content -> content.outputText().stream())
.forEach(text -> System.out.println(text.text()));
var second =
client
.responses()
.create(
ResponseCreateParams.builder()
.model("gpt-6-astra")
.input("Explain why this is funny.")
.previousResponseId(first.id())
.build());
second.output().stream()
.flatMap(item -> item.message().stream())
.flatMap(message -> message.content().stream())
.flatMap(content -> content.outputText().stream())
.forEach(text -> System.out.println(text.text())); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 using OpenAI.Responses;
#pragma warning disable OPENAI001
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);
ResponseResult first = await client.CreateResponseAsync(
"gpt-6-astra",
"Tell me a joke."
);
Console.WriteLine(first.GetOutputText());
ResponseResult second = await client.CreateResponseAsync(
"gpt-6-astra",
"Explain why this is funny.",
previousResponseId: first.Id
);
Console.WriteLine(second.GetOutputText()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 require "openai"
client = OpenAI::Client.new
first = client.responses.create(
model: "gpt-6-astra",
input: "Tell me a joke."
)
puts(first.output_text)
second = client.responses.create(
model: "gpt-6-astra",
previous_response_id: first.id,
input: "Explain why this is funny."
)
puts(second.output_text) Responses API의 WebSocket 모드 에서 대화를 이어갈 때 previous_response_id는 HTTP 모드와 같은 방식으로 동작합니다. WebSocket 모드에서는 소켓 연결을 유지한 채 response.create 이벤트를 반복해서 보냅니다.
각 연결의 캐시는 최근 응답을 메모리에 보관해 다음 턴의 지연 시간을 줄입니다. stream_id를 사용하면 각 레인에서 해당 레인의 최신 응답을 유지할 수 있습니다. 어떤 응답에서 대화를 이어갈지는 여전히 previous_response_id로 지정하므로, 다른 레인의 응답을 아직 사용할 수 있다면 그 응답에서 새 레인을 분기할 수 있습니다. 캐시에 없는 ID로 이전 응답을 찾을 수 없다면 previous_response_id를 null로 설정하고 전체 입력 컨텍스트를 담아 새 턴을 보내세요.
모델 응답 데이터 보관 기간 응답 객체는 기본적으로 30일간 저장됩니다. 대시보드의 로그 페이지에서 확인하거나 API로 조회 할 수 있습니다. 응답을 생성할 때 store를 false로 설정하면 응답 객체 저장을 비활성화할 수 있습니다.
대화 객체와 그 안에 저장된 항목에는 30일의 보존 기간(TTL)이 적용되지 않습니다. 대화에 연결된 응답의 항목도 30일의 TTL 없이 저장됩니다.
OpenAI는 사용자의 명시적인 동의 없이 API로 전송된 데이터를 모델 학습에 사용하지 않습니다. 자세히 알아보기
previous_response_id를 사용하더라도 API에서는 연결된 응답의 이전 입력 토큰 전체에 입력 토큰 요금을 부과합니다.
컨텍스트 윈도우를 이해하면 대화 스레드를 구성하고 모델을 여러 번 호출하는 동안 대화 상태를 관리하는 데 도움이 됩니다.
컨텍스트 윈도우 는 요청 한 번에 사용할 수 있는 최대 토큰 수입니다. 이 한도에는 입력 토큰, 출력 토큰, 추론 토큰이 모두 포함됩니다. 사용하는 모델의 컨텍스트 윈도우 크기는 모델 세부 정보 에서 확인하세요.
입력이 복잡해지거나 대화에 포함하는 턴이 늘어나면 출력 토큰 한도와 컨텍스트 윈도우 한도를 모두 고려해야 합니다. 모델의 입력량과 출력량은 토큰
출력 토큰 은 모델이 프롬프트에 응답해 생성하는 토큰입니다. 출력 토큰 한도 는 모델마다 다릅니다. 예를 들어 gpt-4o-2024-08-06은 출력 토큰을 최대 16,384개까지 생성할 수 있습니다.컨텍스트 윈도우 는 입력과 출력에 사용할 수 있는 전체 토큰 수를 나타냅니다. 일부 모델에서는 추론 토큰 도 여기에 포함됩니다. 모델별 컨텍스트 윈도우 한도 를 비교해 보세요. 예를 들어 gpt-4o-2024-08-06의 전체 컨텍스트 윈도우는 128k 토큰입니다.
모델에 제공할 컨텍스트, 데이터 또는 예제를 추가하다 보면 프롬프트가 길어질 수 있습니다. 이때 모델의 컨텍스트 윈도우 한도를 초과하면 출력이 잘릴 수 있습니다.
특정 문자열의 토큰 수는 토크나이저 도구 로 확인할 수 있습니다. 이 도구는 tiktoken 라이브러리 로 만들었습니다.
예를 들어 Chat Completions 에 o1 모델 을 사용하는 API 요청을 보내면 다음 토큰이 모두 컨텍스트 윈도우 사용량에 포함됩니다.
입력 토큰(messages 배열에 담아 Chat Completions 에 전달하는 입력)
출력 토큰(모델이 프롬프트에 응답해 생성하는 토큰)
추론 토큰(모델이 응답을 계획하는 데 사용하는 토큰)
예를 들어 Responses API 에 o1 모델 처럼 추론 기능이 활성화된 모델을 사용하는 요청을 보내면 다음 토큰이 모두 컨텍스트 윈도우 사용량에 포함됩니다.
입력 토큰(input 배열에 담아 Responses API 에 전달하는 입력)
출력 토큰(모델이 프롬프트에 응답해 생성하는 토큰)
추론 토큰(모델이 응답을 계획하는 데 사용하는 토큰)
컨텍스트 윈도우 한도를 초과해 생성된 토큰은 API 응답에서 잘릴 수 있습니다.
토크나이저 도구 로 메시지에 사용할 토큰 수를 추정할 수 있습니다.
자세한 사용 방법은 이제 컨텍스트 압축 가이드에서 확인할 수 있습니다.
더 구체적인 예제와 활용 사례는 OpenAI Cookbook 에서 확인하세요. API로 모델의 기능을 확장하는 방법은 다음 가이드에서 알아볼 수 있습니다.