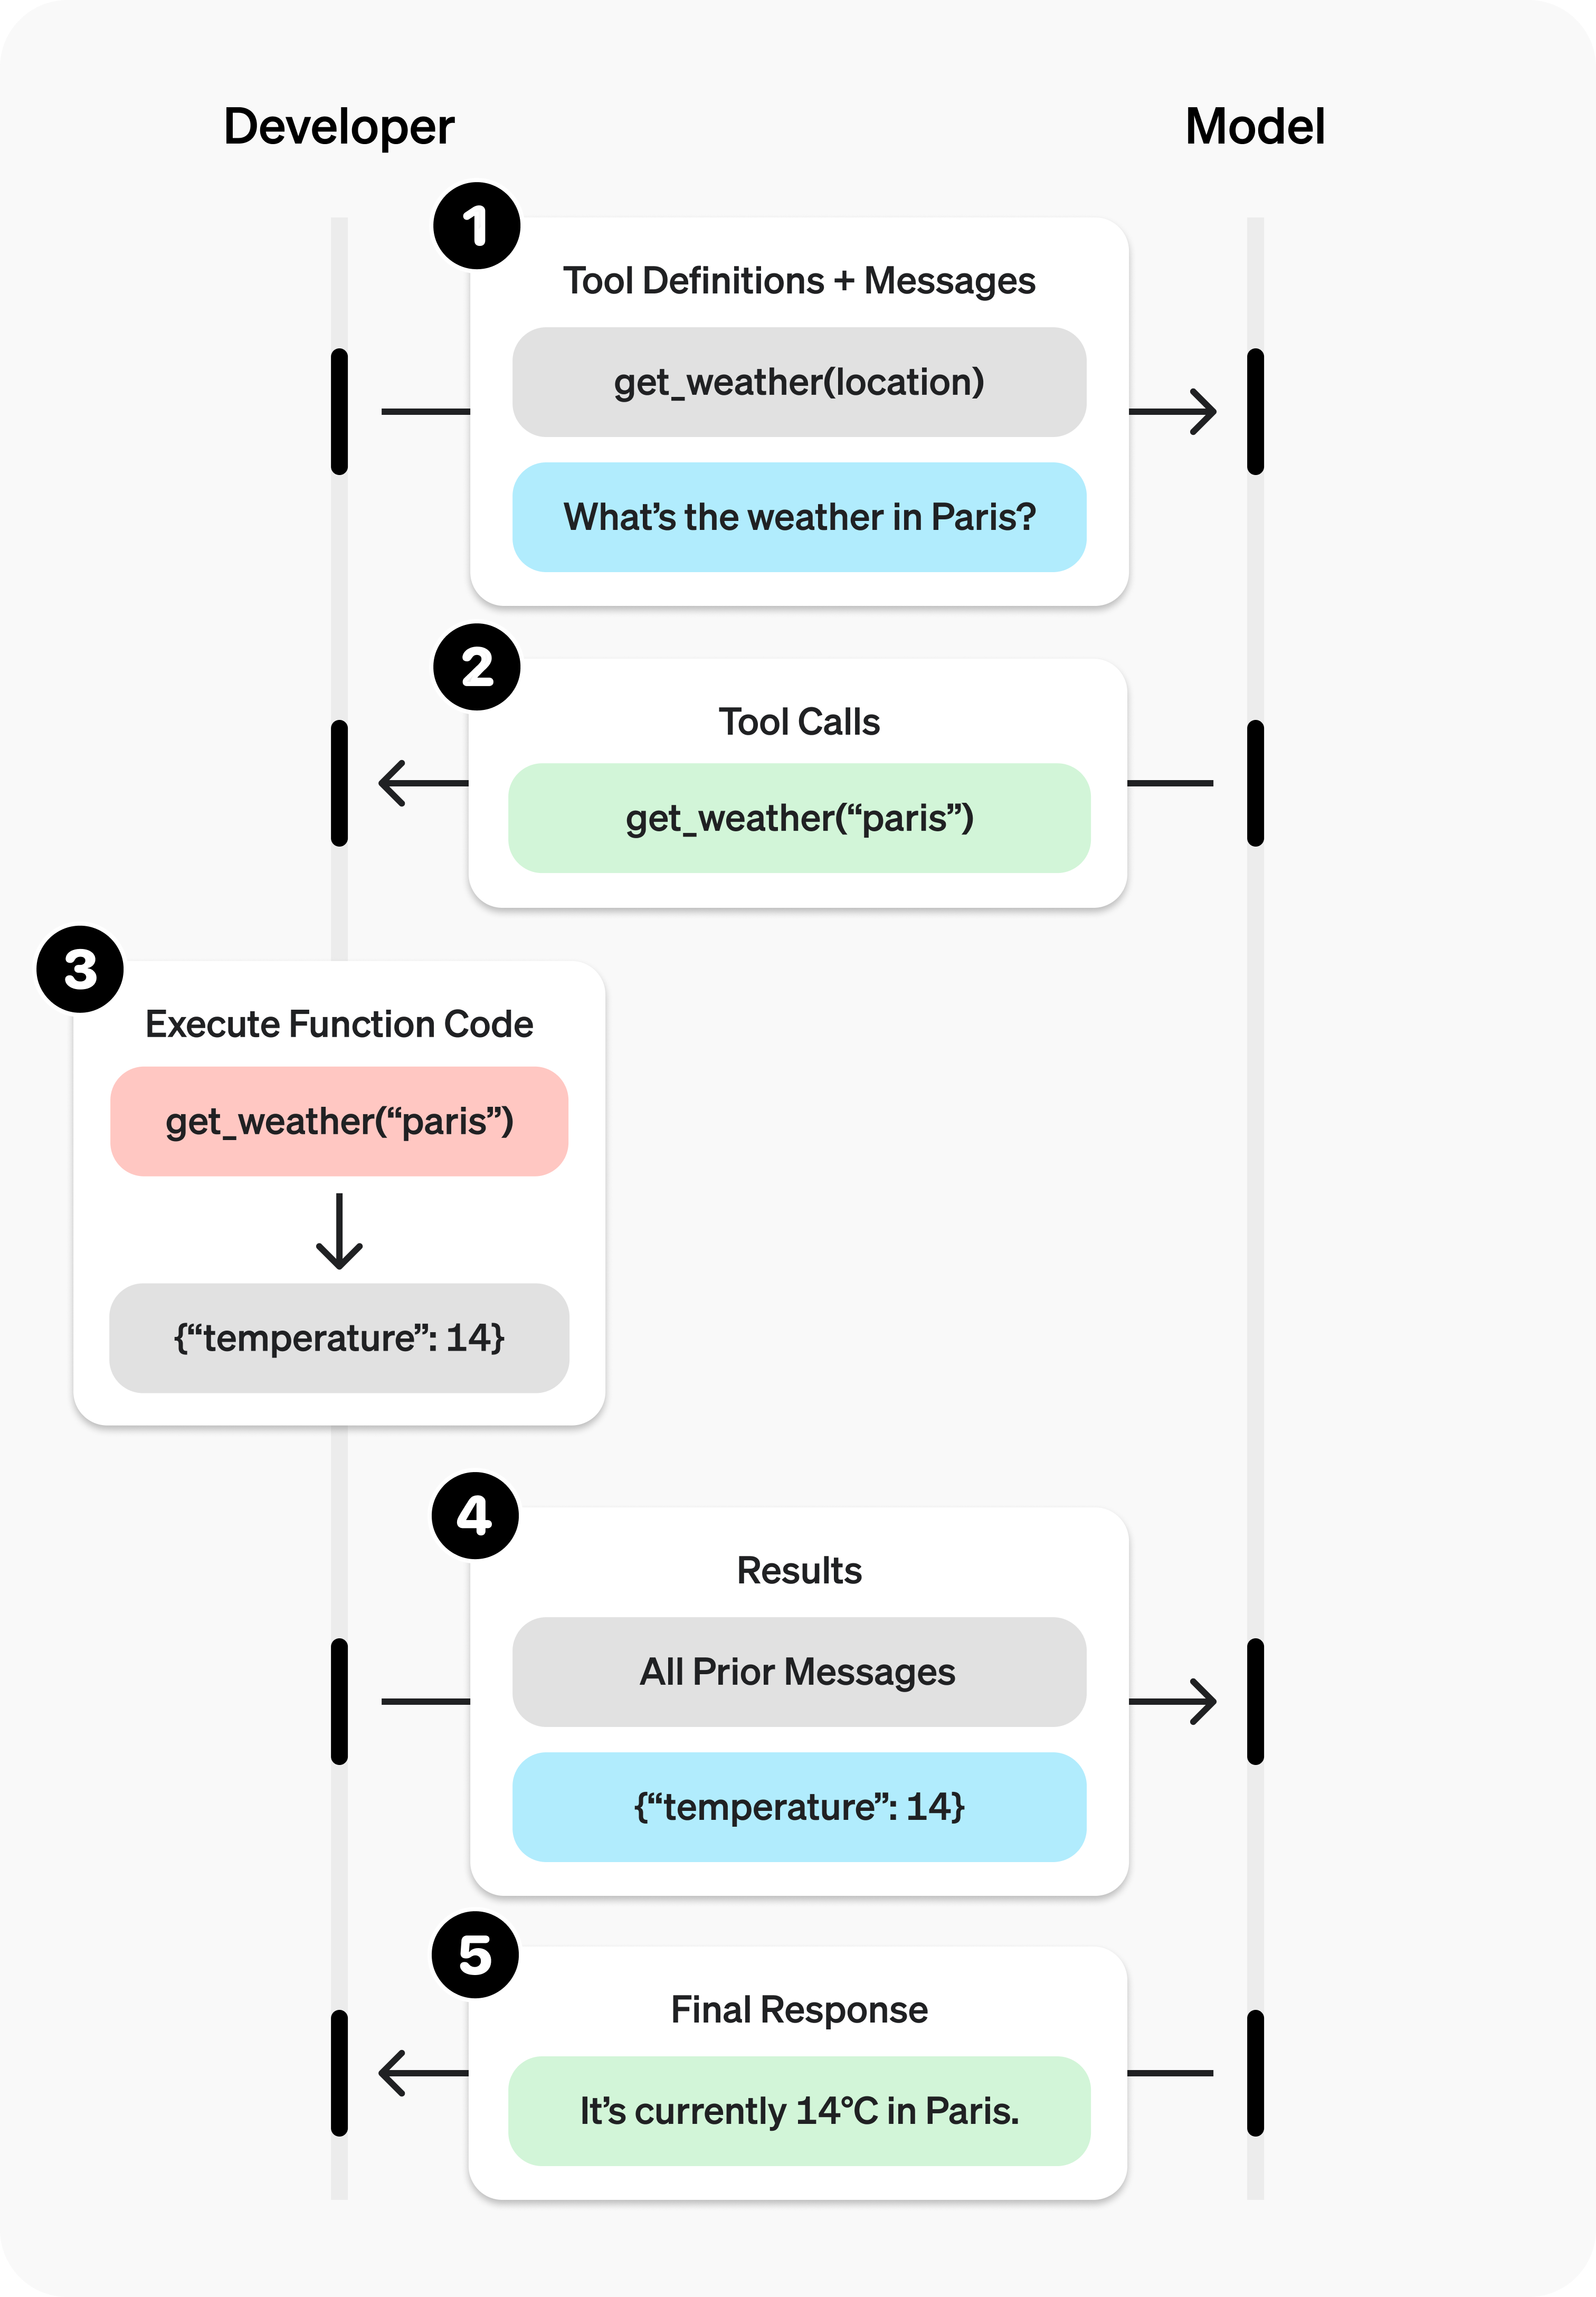
함수 호출(도구 호출이라고도 함)을 사용하면 OpenAI 모델이 외부 시스템과 유연하게 연동하여 학습 데이터에 없는 정보까지 활용할 수 있습니다. 이 가이드에서는 모델이 애플리케이션의 데이터를 조회하고 작업을 수행하도록 연결하는 방법을 설명합니다. JSON 스키마로 정의하는 함수 도구와 자유 형식 텍스트를 입력과 출력으로 사용하는 사용자 정의 도구를 살펴봅니다.
Agents API 세션에서는 함수를 사용해 함수를 등록하고 세션의 작업 요청을 처리하세요. 이 가이드의 예제는 Responses API와 Chat Completions 연동을 다룹니다.
애플리케이션에 함수가 많거나 스키마가 크다면 함수 호출과 도구 검색을 함께 사용할 수 있습니다. 자주 쓰지 않는 도구는 로드를 미뤘다가 모델에 필요할 때만 로드할 수 있습니다. gpt-5.4 이상의 모델만 tool_search를 지원합니다.
먼저 도구 호출에 쓰이는 주요 용어를 살펴봅니다. 이어서 실제 예제를 통해 도구를 호출하는 방법을 알아봅니다.
함수 또는 도구는 모델에 사용할 수 있다고 알려 준 기능을 통칭합니다. 모델은 프롬프트에 대한 응답을 생성하면서 지시를 따르려면 도구가 제공하는 데이터나 기능이 필요하다고 판단할 수 있습니다.
예를 들어 모델에 다음과 같은 도구를 제공할 수 있습니다.
특정 지역의 오늘 날씨 조회
사용자 ID로 계정 정보 조회
분실된 주문의 환불 처리
이 밖에도 모델이 프롬프트에 응답할 때 알아야 할 정보나 수행해야 할 작업에 맞춰 도구를 제공할 수 있습니다.
프롬프트를 담아 모델에 API 요청을 보낼 때 모델이 사용할 만한 도구 목록을 함께 보낼 수 있습니다. 예를 들어 모델이 세계 각지의 현재 날씨에 대한 질문에 답하도록 하려면 get_weather 도구를 제공하고 location을 인수로 받도록 정의할 수 있습니다.
함수 호출 또는 도구 호출은 모델이 반환하는 응답의 한 유형입니다. 모델은 프롬프트를 검토한 뒤 지시를 따르려면 제공된 도구 중 하나를 호출해야 한다고 판단할 때 이 응답을 반환합니다.
예를 들어 API 요청으로 “파리 날씨는 어때?”라는 프롬프트를 받으면 모델은 get_weather 도구를 호출하는 요청을 반환할 수 있습니다. 이때 Paris가 location 인수의 값입니다.
함수 호출 출력 또는 도구 호출 출력은 도구가 모델의 호출에 담긴 입력을 받아 생성한 응답입니다. 출력은 구조화된 JSON이나 일반 텍스트일 수 있으며, 어떤 도구 호출에 대한 결과인지 식별하는 참조를 포함해야 합니다. 아래 예제에서는 call_id가 이 역할을 합니다.
날씨 예제에서 각 단계는 다음과 같습니다.
모델에는 get_weather도구가 제공되며, 이 도구는 location을 인수로 받습니다.
“파리 날씨는 어때?”라는 프롬프트를 받으면 모델은 도구 호출을 반환합니다. 호출에 포함된 location 인수의 값은 Paris입니다.
도구 호출 출력으로 JSON 객체(예: 현재 기온이 섭씨 25도임을 나타내는 {"temperature": "25", "unit": "C"}), 이미지 콘텐츠 또는 파일 콘텐츠를 반환할 수 있습니다.
도구 정의, 원래 프롬프트, 모델의 도구 호출, 도구 호출 출력을 모두 모델에 다시 보내면 다음과 같은 최종 텍스트 응답을 받습니다.
The weather in Paris today is 25C.
함수는 JSON 스키마로 정의하는 도구의 한 종류입니다. 함수 정의에 따라 모델이 애플리케이션에 데이터를 전달하면 애플리케이션 코드에서 데이터를 조회하거나 모델이 제안한 작업을 수행할 수 있습니다.
함수 도구 외에도 자유 형식 텍스트를 입력과 출력으로 사용하는 사용자 정의 도구가 있습니다. 이 가이드에서 함께 다룹니다.
OpenAI 플랫폼은 내장 도구도 제공합니다. 모델은 이 도구로 웹 검색, 코드 실행, MCP 서버의 기능 이용 등 다양한 작업을 수행할 수 있습니다.
도구 호출 플로우
도구 호출은 애플리케이션과 모델이 OpenAI API를 통해 여러 단계에 걸쳐 요청과 응답을 주고받는 과정입니다. 도구 호출 플로우는 크게 다섯 단계로 나뉩니다.
호출할 수 있는 도구를 포함해 모델에 요청을 보냅니다.
모델에서 도구 호출을 받습니다.
애플리케이션에서 도구 호출의 입력으로 코드를 실행합니다.
도구 출력을 포함해 모델에 두 번째 요청을 보냅니다.
모델에서 최종 응답 또는 추가 도구 호출을 받습니다.
Responses를 사용하면 작업에 필요한 도구 호출 횟수만큼 이 플로우를 반복할 수 있습니다. 반복되는 호출을 조율하는 프레임워크가 필요하다면 Responses API와 Agents SDK 비교를 참고하세요.
함수 도구 예제
별자리별 오늘의 운세를 조회하는 get_horoscope 함수로 도구 호출 플로우를 처음부터 끝까지 살펴보겠습니다.
도구 호출 전체 예제
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72import OpenAI from "openai";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", function: { name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, }, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}const messages = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});messages.push(response.choices[0].message);for (const toolCall of response.choices[0].message.tool_calls ?? []) { if (toolCall.type !== "function") continue; if (toolCall.function.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const args = JSON.parse(toolCall.function.arguments); const horoscope = getHoroscope(args.sign); // 4. Provide function call results to the model messages.push({ role: "tool", tool_call_id: toolCall.id, content: JSON.stringify({ horoscope }), }); }}response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});// 5. The model should be able to give a response!console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","function": {"name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, },"strict": True, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."messages = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)messages.append(response.choices[0].message)for tool_call in response.choices[0].message.tool_calls or []:if tool_call.function.name =="get_horoscope":# 3. Execute the function logic for get_horoscope args = json.loads(tool_call.function.arguments) horoscope = get_horoscope(args["sign"])# 4. Provide function call results to the model messages.append( {"role": "tool","tool_call_id": tool_call.id,"content": json.dumps({"horoscope": horoscope}), } )response = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)# 5. The model should be able to give a response!print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}// Create a running input list we will add to over timelet input = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.responses.create({ model: "gpt-6-astra", tools, input,});// Preserve model output for the next turninput.push(...toResponseInputItems(response.output));for (const item of response.output) { if (item.type !== "function_call") continue; if (item.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const { sign } = JSON.parse(item.arguments); const horoscope = getHoroscope(sign); // 4. Provide function call results to the model input.push({ type: "function_call_output", call_id: item.call_id, output: horoscope, }); }}console.log("Final input:");console.log(JSON.stringify(input, null, 2));response = await openai.responses.create({ model: "gpt-6-astra", instructions: "Respond only with a horoscope generated by a tool.", tools, input,});// 5. The model should be able to give a response!console.log("Final output:");console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","name": "get_horoscope","strict": True,"description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."# Create a running input list we will add to over timeinput_list = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.responses.create(model="gpt-6-astra",tools=tools,input=input_list,)# Save function call outputs for subsequent requestsinput_list += response.outputfor item in response.output:if item.type =="function_call":if item.name =="get_horoscope":# 3. Execute the function logic for get_horoscope sign = json.loads(item.arguments)["sign"] horoscope = get_horoscope(sign)# 4. Provide function call results to the model input_list.append( {"type": "function_call_output","call_id": item.call_id,"output": horoscope, } )response = client.responses.create(model="gpt-6-astra",instructions="Respond only with a horoscope generated by a tool.",tools=tools,input=input_list,)# 5. The model should be able to give a response!print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75package mainimport ( "context" "encoding/json" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() tool := horoscopeResponseTool() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("What is my horoscope? I am an Aquarius.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } var functionOutput responses.ResponseInputItemUnionParam for _, output := range response.Output { if output.Type != "function_call" { continue } call := output.AsFunctionCall() if call.Name != "get_horoscope" { continue } var arguments struct { Sign string `json:"sign"` } if err := json.Unmarshal([]byte(call.Arguments), &arguments); err != nil { panic(err) } functionOutput = responses.ResponseInputItemParamOfFunctionCallOutput(getHoroscope(arguments.Sign)) functionOutput.OfFunctionCallOutput.CallID = openai.String(call.CallID) } if functionOutput.OfFunctionCallOutput == nil { panic("the model did not call get_horoscope") } response, err = client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", PreviousResponseID: openai.String(response.ID), Instructions: openai.String("Respond only with a horoscope generated by a tool."), Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{functionOutput}}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}func horoscopeResponseTool() responses.ToolUnionParam { parameters := map[string]any{ "type": "object", "properties": map[string]any{ "sign": map[string]any{"type": "string", "description": "An astrological sign like Taurus or Aquarius"}, }, "required": []string{"sign"}, "additionalProperties": false, } tool := responses.ToolParamOfFunction("get_horoscope", parameters, true) tool.OfFunction.Description = openai.String("Get today's horoscope for an astrological sign.") return tool}func getHoroscope(sign string) string { return fmt.Sprintf("%s: Next Tuesday you will befriend a baby otter.", sign)}
GPT-5나 o4-mini 같은 추론 모델의 응답에 도구 호출과 함께 추론 항목이 포함되어 있다면 도구 호출 출력을 보낼 때 해당 추론 항목도 모두 다시 보내야 합니다. 모델이 이 항목들을 생성하는 데 사용한 대화 기록을 보존하는 방법은 프리픽스 변경 시 권장 사항을 참고하세요.
함수 정의
함수는 일반적으로 각 API 요청의 tools 매개변수에 선언합니다. 도구 검색을 사용하면 애플리케이션이 로드를 미룬 함수를 대화 도중에 로드할 수도 있습니다. 어느 방식이든 호출 가능한 함수의 스키마 구조는 같습니다. 함수 정의에는 다음 속성이 있습니다.
12345678910111213141516171819202122{ "type": "function", "name": "get_weather", "description": "Retrieves current weather for the given location.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "City and country e.g. Bogotá, Colombia" }, "units": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "Units the temperature will be returned in." } }, "required": ["location", "units"], "additionalProperties": false }, "strict": true}
parameters는 JSON 스키마로 정의하므로 속성 타입, 열거형, 설명, 중첩 객체, 재귀 객체 등 스키마가 제공하는 다양한 기능을 활용할 수 있습니다.
네임스페이스 정의
네임스페이스를 사용하면 관련 도구를 crm, billing, shipping 같은 도메인별로 묶을 수 있습니다. 네임스페이스는 비슷한 도구를 정리하는 데 도움이 됩니다. 특히 CRM 검색 도구와 지원 티켓 검색 도구처럼 모델이 시스템이나 용도가 다른 도구 중 하나를 골라야 할 때 유용합니다.
모델에 많은 도구를 제공해야 한다면 tool_search로 도구 일부 또는 전체의 로드를 미룰 수 있습니다. tool_search 도구를 사용하면 모델이 관련 도구를 검색하고 컨텍스트에 추가한 뒤 사용할 수 있습니다. gpt-5.4 이상의 모델만 이 기능을 지원합니다. 자세한 내용은 도구 검색 가이드를 참고하세요.
가능하면 함수 스키마를 직접 정의하세요. Python과 JavaScript 클라이언트 라이브러리에는 pydantic과 zod 객체를 스키마로 변환하는 헬퍼도 있지만, 이 헬퍼가 모든 기능을 지원하지는 않습니다.
함수 스키마를 나타내는 객체 정의
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import OpenAI from "openai";import { z } from "zod";import { zodFunction } from "openai/helpers/zod";const openai = new OpenAI();const GetWeatherParameters = z.object({ location: z.string().describe("City and country e.g. Bogotá, Colombia"),});const tools = [ zodFunction({ name: "getWeather", parameters: GetWeatherParameters }),];const messages = [ { role: "user", content: "What's the weather like in Paris today?" },];const response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools, store: true,});console.log(response.choices[0].message.tool_calls);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20from openai import OpenAI, pydantic_function_toolfrom pydantic import BaseModel, Fieldclient = OpenAI()classGetWeather(BaseModel): location: str= Field(..., description="City and country e.g. Bogotá, Colombia")tools = [pydantic_function_tool(GetWeather)]completion = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,)print(completion.choices[0].message.tool_calls)
함수 정의 권장 사항
함수 이름, 매개변수 설명, 지시 사항을 명확하고 구체적으로 작성하세요.
함수의 목적과 각 매개변수의 용도 및 형식을 명시하고 출력이 무엇을 나타내는지 설명하세요.
각 함수를 언제 사용하고 언제 사용하지 말아야 하는지 시스템 프롬프트에 설명하세요. 일반적으로 모델이 해야 할 일을 정확하게 알려 주는 것이 좋습니다.
예제와 경계 사례를 포함하세요. 특히 같은 오류가 반복될 때 도움이 됩니다. (참고: 예제를 추가하면 추론 모델의 성능이 저하될 수 있습니다.)
로드를 미루는 도구는 함수 설명에 자세한 지침을 넣고 네임스페이스 설명은 간결하게 작성하세요. 네임스페이스 설명은 모델이 무엇을 로드할지 선택하는 데 도움이 되고, 함수 설명은 로드한 도구를 올바르게 사용하는 데 도움이 됩니다.
함수 수가 많거나 작업이 어렵다면 파인튜닝으로 함수 호출 정확도를 높이는 방법을 고려하세요. (쿡북)
토큰 사용량
내부적으로 함수 정의는 모델이 학습한 구문으로 시스템 메시지에 삽입됩니다. 따라서 호출 가능한 함수 정의도 모델의 컨텍스트 한도에 포함되며 입력 토큰으로 과금됩니다. 토큰 한도에 도달하면 처음에 로드하는 함수 수를 줄이거나, 가능하면 설명을 짧게 작성하거나, 도구 검색을 사용해 로드를 미룬 도구를 필요할 때만 로드하세요.
tool_choice를 "none"으로 설정하면 함수를 하나도 전달하지 않았을 때처럼 동작합니다.
도구 검색을 사용할 때도 tool_choice는 현재 턴에서 호출 가능한 도구에 적용됩니다. 특히 일부 도구를 로드한 뒤 모델이 그 도구만 사용하도록 제한할 때 유용합니다.
병렬 함수 호출
GPT-5부터 병렬 함수 호출을 지원하는 모델에서는 내장 도구를 함께 제공해도 함수를 병렬로 호출할 수 있습니다. 단, 병렬로 호출하는 함수 묶음에 내장 도구를 포함할 수는 없습니다.
모델은 한 턴에서 여러 함수를 호출할 수 있습니다. 이를 방지하려면 parallel_tool_calls를 false로 설정하세요. 그러면 도구를 호출하지 않거나 하나만 호출합니다.
참고: 현재 파인튜닝한 모델이 한 턴에서 여러 함수를 호출하면 해당 호출에는 엄격 모드가 적용되지 않습니다.
gpt-4.1-nano-2025-04-14 사용 시 참고: 이 gpt-4.1-nano 스냅샷에서는 병렬 도구 호출을 켜면 간혹 같은 도구에 대한 호출이 여러 번 포함될 수 있습니다. 이 스냅샷을 사용할 때는 병렬 도구 호출을 끄는 것이 좋습니다.
엄격 모드
strict를 true로 설정하면 함수 호출이 함수 스키마를 반드시 따르도록 할 수 있습니다. 엄격 모드를 항상 켜는 것이 좋습니다.
엄격 모드는 내부적으로 구조화된 출력값 기능을 사용하므로 다음 두 가지 요건을 충족해야 합니다.
additionalProperties를 false로 설정하세요. parameters에 포함된 모든 객체에 이 설정이 필요합니다.
properties의 모든 필드를 required로 지정하세요.
선택적 필드는 null을 type 옵션에 추가해 나타낼 수 있습니다(아래 예제 참고).
strict: true를 보냈을 때 스키마가 위 요건을 충족하지 않으면 요청이 거부되며 누락된 제약 조건에 대한 설명이 반환됩니다. strict를 생략하면 기본 동작은 API에 따라 달라집니다. Responses 요청에서는 가능한 경우 스키마를 엄격 모드에 맞게 정규화합니다. 스키마를 호환 가능한 형태로 변환할 수 없으면 엄격 모드를 해제하고 스키마 준수를 보장하지 않는 방식으로 함수를 호출합니다. 이 경우 응답의 도구 정의에 strict: false가 표시됩니다. Chat Completions 요청은 기본적으로 엄격 모드를 사용하지 않습니다. Responses에서도 엄격 모드를 사용하지 않고 스키마 준수를 보장하지 않는 호출 방식을 유지하려면 strict: false를 명시하세요.
엄격 모드 켜짐
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false } }}
엄격 모드 꺼짐
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], } }}
엄격 모드 켜짐
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false }}
엄격 모드 꺼짐
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], }}
모델이 함수 호출을 마치면 response.function_call_arguments.done 타입의 이벤트가 발생합니다. 이 이벤트에는 다음 필드를 포함한 전체 함수 호출이 담깁니다.
필드
설명
response_id
함수 호출이 속한 응답의 ID
output_index
응답 내 출력 항목의 인덱스. 응답에 포함된 개별 함수 호출을 구분합니다.
item
함수 호출 항목. name, arguments, id 필드를 포함합니다.
사용자 정의 도구
사용자 정의 도구는 JSON 스키마 기반 함수 도구와 대체로 같은 방식으로 작동합니다. 다만 도구에 필요한 입력 형식을 모델에 명시하는 대신 모델이 임의의 문자열을 도구 입력으로 전달할 수 있습니다. 응답을 불필요하게 JSON으로 감싸지 않아도 되고, 아래에서 설명하는 것처럼 응답에 사용자 정의 문법을 적용할 수도 있습니다.
다음 코드는 모델의 응답에서 Python 코드가 담긴 텍스트 문자열을 입력으로 받는 사용자 정의 도구를 만드는 예제입니다.
사용자 정의 도구 호출 예제
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the code_exec tool to print hello world to the console.", tools: [ { type: "custom", name: "code_exec", description: "Executes arbitrary Python code.", }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Use the code_exec tool to print hello world to the console.",tools=[ {"type": "custom","name": "code_exec","description": "Executes arbitrary Python code.", } ],)print(response.output)
입력에서 터미널을 어디서 나눌지는 터미널 정의만 결정합니다. 소문자로 작성하는 규칙은 이 과정에 영향을 주지 않습니다. 기준 패턴 사이에 자유 형식 텍스트가 필요하다면 전체를 하나의 정규식 터미널로 표현하세요. 그러면 렉서가 의도한 구조 전체를 정확히 한 번 매칭합니다.
터미널과 규칙
Lark에서는 터미널로 렉서 토큰을 정의하고(관례상 UPPERCASE), 규칙으로 파서의 생성 규칙을 정의합니다(관례상 lowercase). 지원되는 기능 범위 안에서 예측 가능한 결과를 얻으려면 문법을 명시적으로 작성하고 불필요한 복잡성을 줄이세요. 터미널과 규칙이 맡는 역할도 명확히 구분하세요.
CFG 규칙을 적용하기 전에 렉서가 터미널을 매칭합니다. 이때 가능한 한 길게 일치하는 텍스트를 선택합니다. 하나의 터미널을 여러 규칙으로 나눠 형태를 제어하려 해도 렉서는 그 규칙을 참조하지 않습니다. 렉서의 매칭을 결정하는 것은 터미널 정규식뿐입니다.
자유 형식 텍스트에서 패턴을 추출할 때는 단일 터미널을 사용하세요
임의의 텍스트에 포함된 패턴(예: 기준 패턴 사이에 어떤 내용이든 들어갈 수 있는 자연어)을 인식해야 한다면 하나의 터미널로 표현하세요. 자유 형식 텍스트 터미널과 파서 규칙을 번갈아 배치하지 마세요. 렉서는 가능한 한 길게 매칭하므로 의도한 경계를 지키지 않으며, 모델이 학습 분포를 벗어날 가능성이 매우 높습니다.
개별 토큰을 조합할 때는 규칙을 사용하세요
규칙은 경계가 명확한 터미널(숫자, 키워드, 문장 부호 등)을 조합해 더 큰 구조를 만들 때 적합합니다. 두 터미널 사이에 들어갈 내용을 제한하는 용도로는 적합하지 않습니다.
각 터미널의 역할과 범위를 정하고 독립적으로 정의하세요
명시적인 문자 클래스와 범위가 정해진 수량자를 사용하세요. 예를 들어 {0,10}처럼 범위를 정하고 모든 곳에 무제한 *를 쓰지 마세요. “마침표까지의 임의 텍스트”를 매칭하려면 /[^.\n]{0,10}*\./ 같은 패턴이 /.+\./보다 좋습니다. 매칭되는 텍스트가 지나치게 길어지는 것을 방지할 수 있습니다.
규칙은 토큰을 조합하는 데 사용하고 정규식 내부 동작은 정규식으로 제어하세요
규칙을 적절히 사용한 예제입니다.
start: exprNUMBER: /[0-9]+/PLUS: "+"MINUS: "-"expr: term (("+"|"-") term)*term: NUMBER
공백을 명시적으로 처리하세요
범위가 정해지지 않은 %ignore 지시문에 의존하지 마세요. 제한 없이 입력을 무시하면 문법이 지나치게 복잡해지거나 모델이 학습 분포를 벗어날 수 있습니다. 공백이 허용되는 위치마다 공백을 나타내는 터미널을 명시하세요.
문제 해결
문법이 너무 복잡해서 API가 거부한다면 규칙과 터미널을 단순화하고 범위가 정해지지 않은 %ignore 지시문을 제거하세요.
사용자 정의 도구 호출에 예상하지 못한 토큰이 들어 있다면 터미널 패턴이 겹치지 않는지, 렉서가 어떤 텍스트를 가장 길게 매칭하는지 확인하세요.
모델이 학습 분포를 벗어나면 문법적으로는 유효하지만 의미가 잘못된 출력이 생성됩니다. 출력이 지나치게 길거나 같은 내용이 반복되는 것이 징후입니다. 이 경우 다음을 시도하세요.
문법의 제약을 강화하세요.
프롬프트에 퓨샷 예제를 추가하고 도구 설명을 다듬으세요. 설명에 문법을 소개하고 모델이 이를 고려해 추론하고 문법에 맞게 응답하도록 지시하세요.
추론 수준을 높여 보세요. 예를 들어 medium에서 high로 변경하세요.
정규식 CFG
정규식 문맥 자유 문법 예제
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const grammar = "^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\\s+(?P<day>\\d{1,2})(?:st|nd|rd|th)?\\s+(?P<year>\\d{4})\\s+at\\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$";const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.", tools: [ { type: "custom", name: "timestamp", description: "Saves a timestamp in date + time in 24-hr format.", format: { type: "grammar", syntax: "regex", definition: grammar, }, }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23from openai import OpenAIclient = OpenAI()grammar =r"^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$"response = client.responses.create(model="gpt-6-astra",input="Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.",tools=[ {"type": "custom","name": "timestamp","description": "Saves a timestamp in date + time in 24-hr format.","format": {"type": "grammar","syntax": "regex","definition": grammar, }, } ],)print(response.output)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses" "github.com/openai/openai-go/v3/shared")func main() { client := openai.NewClient() grammar := `^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$` tool := responses.ToolParamOfCustom("timestamp") tool.OfCustom.Description = openai.String("Saves a timestamp in date and time format.") tool.OfCustom.Format = shared.CustomToolInputFormatParamOfGrammar(grammar, "regex") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.Output)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.CustomToolInputFormat;import com.openai.models.responses.CustomTool;import com.openai.models.responses.ResponseCreateParams;String grammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) " + "\\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$";ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input("Use timestamp to save August 7th 2025 at 10AM.") .addTool( CustomTool.builder() .name("timestamp") .description("Saves a timestamp in date and time format.") .format( CustomToolInputFormat.Grammar.builder() .syntax(CustomToolInputFormat.Grammar.Syntax.REGEX) .definition(grammar) .build()) .build()) .build();client.responses().create(params).output().forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newgrammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) \\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$"response = client.responses.create( model: "gpt-6-astra", input: "Use timestamp to save August 7th 2025 at 10AM.", tools: [ { type: :custom, name: "timestamp", description: "Saves a timestamp in date and time format.", format: { type: :grammar, syntax: :regex, definition: grammar } } ])puts(response.output)