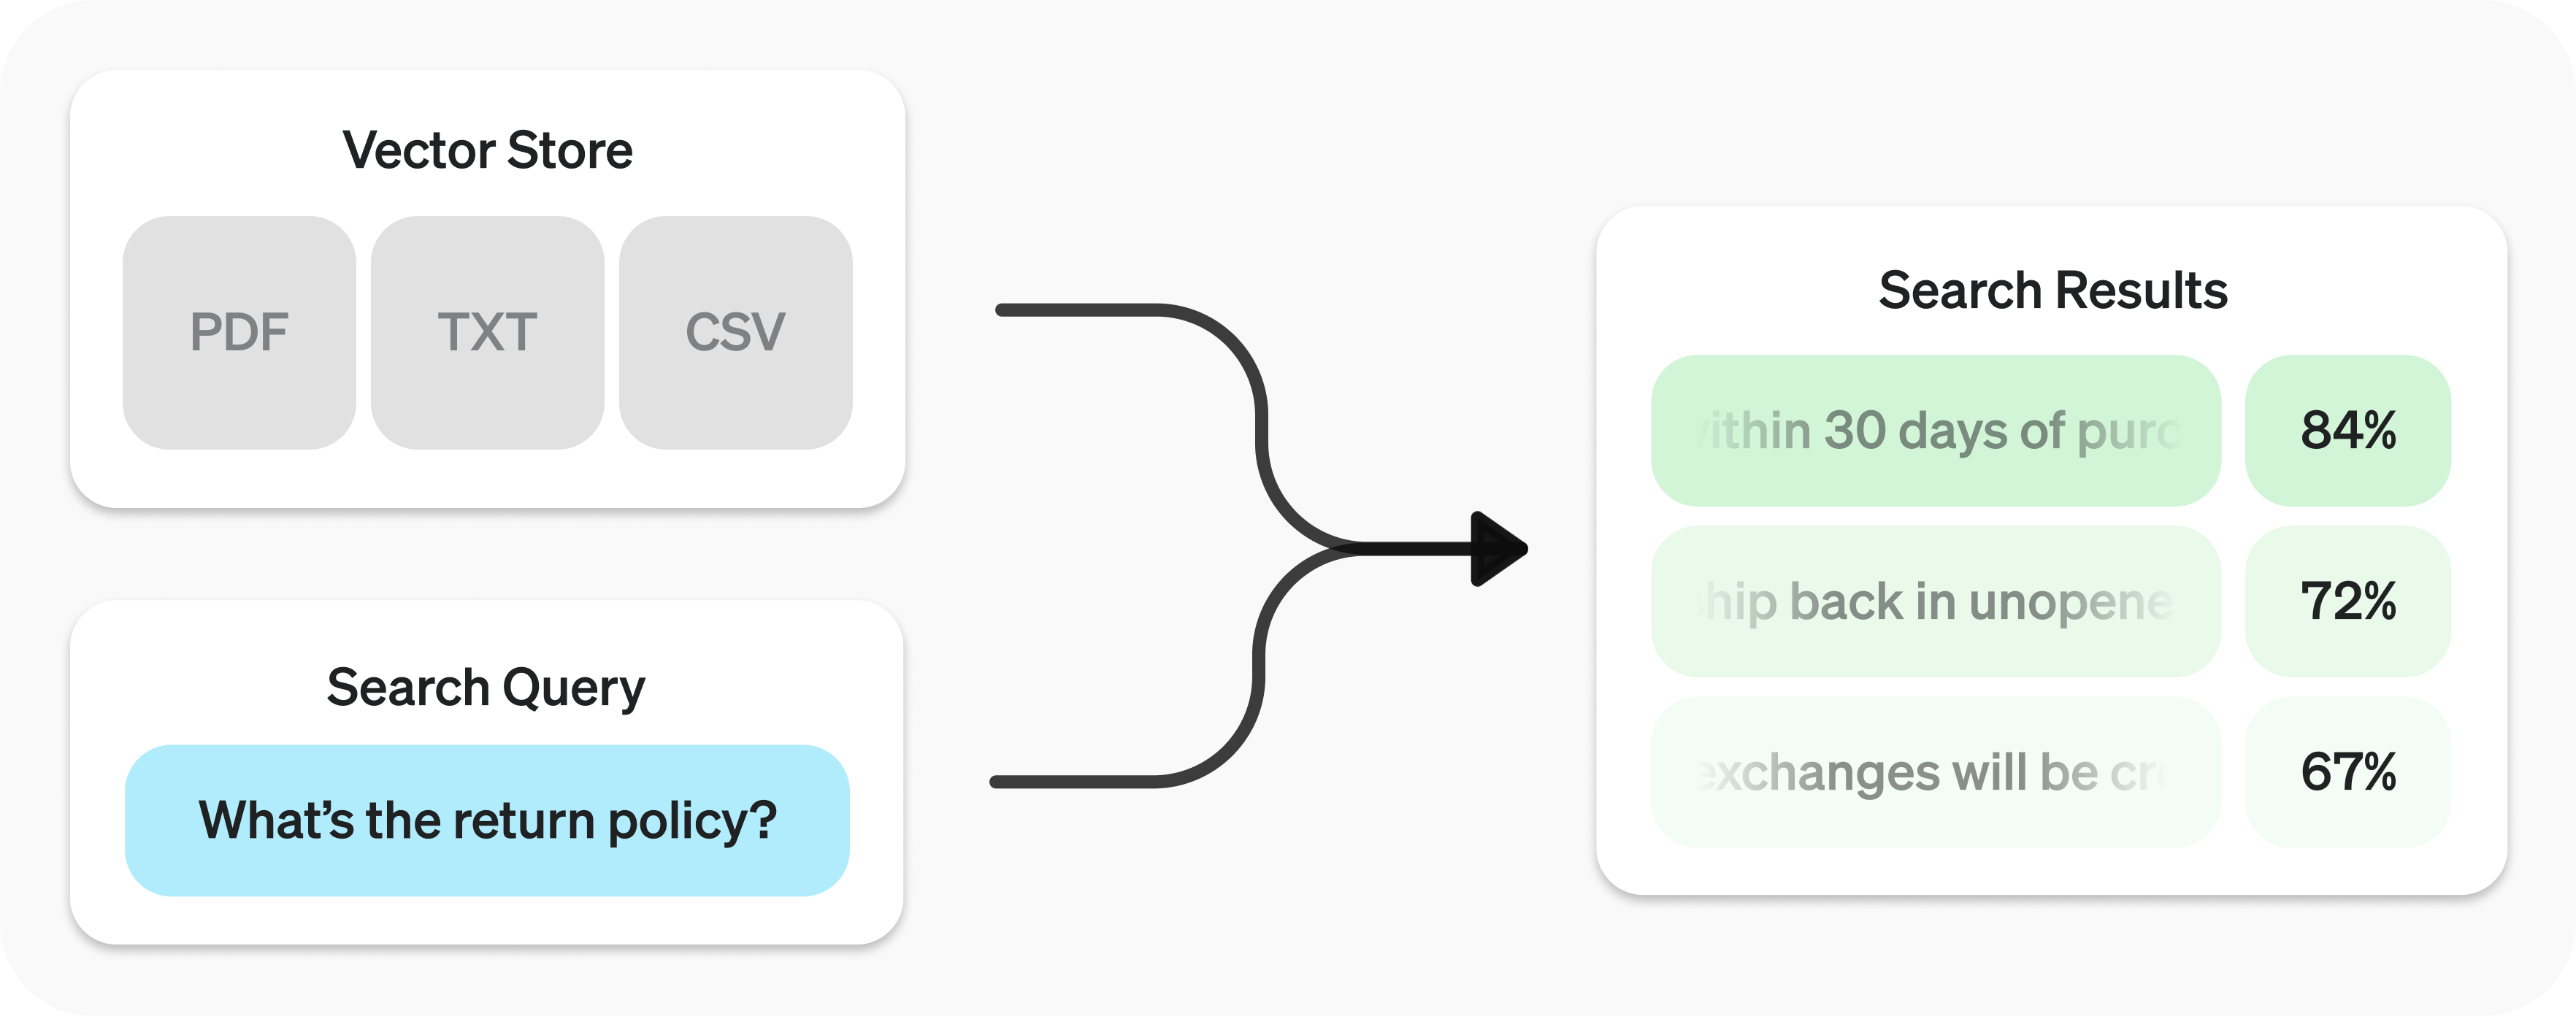
Retrieval API 를 사용하면 데이터에서 시맨틱 검색
Retrieval API는 데이터의 인덱스 역할을 하는 벡터 저장소
벡터 저장소를 만들고 파일을 업로드하세요.
1
2
3
4
5
6
7
8
9
10
11
12
13 import OpenAI from "openai";
const client = new OpenAI();
const vector_store = await client.vectorStores.create({
// Create vector store
name: "Support FAQ",
});
await client.vectorStores.files.uploadAndPoll(
vector_store.id,
// Upload file
fs.createReadStream("customer_policies.txt")
); 1
2
3
4
5
6
7
8
9
10
11
12 from openai import OpenAI
client = OpenAI()
vector_store = client.vector_stores.create( # Create vector store
name = "Support FAQ" ,
)
client.vector_stores.files.upload_and_poll( # Upload file
vector_store_id = vector_store.id,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{Name: openai.String("Support FAQ")})
if err != nil {
panic(err)
}
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
_, err = client.VectorStores.Files.UploadAndPoll(context.Background(), vectorStore.ID, openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.VectorStoreCreateParams;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
var store =
client.vectorStores().create(VectorStoreCreateParams.builder().name("Support FAQ").build());
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
store.id(),
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(file.id(), FileRetrieveParams.builder().vectorStoreId(store.id()).build());
}
System.out.println(store.id()); 1
2
3
4
5
6
7
8
9
10
11
12
13 require "openai"
require "pathname"
client = OpenAI::Client.new
store = client.vector_stores.create(name: "Support FAQ")
file = client.vector_stores.files.upload_and_poll(
store.id,
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{file.status}" unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(store.id) 검색 쿼리를 보내 관련 결과를 가져오세요.
1
2
3
4
5 const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6 user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search("vs_123", query: "What is the return policy?")
puts(results.data&.first&.content) 시맨틱 검색 은 벡터 임베딩 을 활용해 의미상 관련 있는 결과를 찾는 기법입니다. 검색어와 겹치는 키워드가 거의 없거나 전혀 없어 기존 검색 기법으로는 놓치기 쉬운 결과도 찾을 수 있습니다.
예를 들어 "When did we go to the moon?"(우리는 언제 달에 갔나요?)이라는 쿼리로 검색했을 때 나올 수 있는 결과를 살펴보세요.
텍스트
키워드 유사도
의미적 유사도
The first lunar landing occurred in July of 1969. (최초의 달 착륙은 1969년 7월에 이루어졌다.)
0%
65%
The first man on the moon was Neil Armstrong. (달에 처음 발을 디딘 사람은 닐 암스트롱이었다.)
27%
43%
When I ate the moon cake, it was delicious. (내가 먹은 월병은 맛있었다.)
40%
28%
(키워드 유사도는 합집합 대비 교집합의 비율 로 계산하고, 의미적 유사도는 코사인 유사도 를 사용해 text-embedding-3-small이 생성한 임베딩을 비교한 값입니다.)
가장 관련성이 높은 결과의 영어 원문에는 검색 쿼리에 쓰인 단어가 하나도 없습니다. 이처럼 시맨틱 검색은 표현이 달라도 관련 내용을 찾을 수 있어 규모에 관계없이 지식 베이스를 검색하는 데 효과적입니다.
시맨틱 검색에는 벡터 저장소 가 사용됩니다. 벡터 저장소는 가이드 뒷부분에서 자세히 다루고, 여기서는 시맨틱 검색이 어떻게 작동하는지 살펴봅니다.
search 함수를 호출할 때 query를 자연어로 지정하면 벡터 저장소를 검색할 수 있습니다. 반환된 결과 목록의 각 항목에는 관련 청크와 유사도 점수, 청크의 출처인 파일이 포함됩니다.
1
2
3 const results = await client.vectorStores.search(vector_store.id, {
query: "How many woodchucks are allowed per passenger?",
}); 1
2
3
4 results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = "How many woodchucks are allowed per passenger?" ,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("How many woodchucks are allowed per passenger?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder()
.query("How many woodchucks are allowed per passenger?")
.build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "How many woodchucks are allowed per passenger?"
)
puts(results.data&.first&.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42 {
"object" : "vector_store.search_results.page" ,
"search_query" : "How many woodchucks are allowed per passenger?" ,
"data" : [
{
"file_id" : "file-12345" ,
"filename" : "woodchuck_policy.txt" ,
"score" : 0.85 ,
"attributes" : {
"region" : "North America" ,
"author" : "Wildlife Department"
},
"content" : [
{
"type" : "text" ,
"text" : "According to the latest regulations, each passenger is allowed to carry up to two woodchucks."
},
{
"type" : "text" ,
"text" : "Ensure that the woodchucks are properly contained during transport."
}
]
},
{
"file_id" : "file-67890" ,
"filename" : "transport_guidelines.txt" ,
"score" : 0.75 ,
"attributes" : {
"region" : "North America" ,
"author" : "Transport Authority"
},
"content" : [
{
"type" : "text" ,
"text" : "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks."
}
]
}
],
"has_more" : false ,
"next_page" : null
} 기본적으로 응답에는 결과가 최대 10개 포함됩니다. max_num_results 매개변수로 최대 50개까지 설정할 수 있습니다.
같은 내용이라도 쿼리를 어떻게 표현하느냐에 따라 더 나은 검색 결과를 얻을 수 있습니다. 검색 성능을 높이도록 쿼리를 자동으로 재작성하려면 rewrite_query=true로 설정한 뒤 search를 실행하세요.
재작성된 쿼리는 결과의 search_query 필드에서 확인할 수 있습니다.
원래 쿼리 재작성된 쿼리
본사 건물의 높이가 얼마나 되는지 알고 싶습니다.
본사 건물 높이
위험물 운송 시 지켜야 할 안전 규정은 무엇인가요?
위험물 안전 규정
서비스 문제에 대해 어떻게 불만을 접수하나요?
서비스 불만 접수 절차
속성 필터링을 사용하면 특정 기간에 해당하는 파일만 검색하는 등 조건을 적용해 결과를 좁힐 수 있습니다. filters에서 조건을 정의하고 조합하면 시맨틱 검색을 수행하기 전에 파일 속성에 따라 검색 대상을 제한할 수 있습니다.
비교 필터 를 사용하면 특정 key에 대해 파일의 attributes에 저장된 값을 지정한 value와 비교할 수 있습니다. 복합 필터 를 사용하면 여러 필터를 and와 or로 조합할 수 있습니다.
1
2
3
4
5 {
"type" : "eq" | "ne" | "gt" | "gte" | "lt" | "lte" | "in" | "nin" , // comparison operators
"key" : "attributes_key" , // attributes key
"value" : "target_value" // value to compare against
} 1
2
3
4 {
"type" : "and" | "or" , // logical operators
"filters" : [ ... ]
} 다음은 필터 사용 예시입니다.
아래 파일명 예시에서는 사용자 지정 filename 속성의 값을 비교합니다. 각 벡터 저장소 파일에 이 속성을 {"filename": "example.txt"}와 같이 명시적으로 설정해야 합니다. 필터가 업로드된 파일의 이름을 자동으로 비교하지는 않습니다.
Region Date range Filenames Exclude filenames Complex 지역
1
2
3
4
5 {
"type" : "eq" ,
"key" : "region" ,
"value" : "us"
} 기간
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 {
"type" : "and" ,
"filters" : [
{
"type" : "gte" ,
"key" : "date" ,
"value" : 1704067200 // unix timestamp for 2024-01-01
},
{
"type" : "lte" ,
"key" : "date" ,
"value" : 1710892800 // unix timestamp for 2024-03-20
}
]
} 파일명
1
2
3
4
5 {
"type" : "in" ,
"key" : "filename" ,
"value" : [ "example.txt" , "example2.txt" ]
} 파일명으로 제외
1
2
3
4
5 {
"type" : "nin" ,
"key" : "filename" ,
"value" : [ "draft.txt" , "internal_notes.md" ]
} 복합 조건
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 {
"type" : "or" ,
"filters" : [
{
"type" : "and" ,
"filters" : [
{
"type" : "or" ,
"filters" : [
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X123"
},
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X999"
}
]
},
{
"type" : "eq" ,
"key" : "confidentiality" ,
"value" : "top_secret"
}
]
},
{
"type" : "eq" ,
"key" : "language" ,
"value" : "en"
}
]
}
파일 검색 결과의 관련성이 낮다면 ranking_options를 조정해 응답 품질을 개선할 수 있습니다. ranker에 auto 또는 default-2024-08-21 등을 지정하고 score_threshold를 0.0에서 1.0 사이의 값으로 설정할 수 있습니다. score_threshold를 높이면 관련성이 높은 청크만 결과에 포함되지만, 유용할 수 있는 청크도 일부 제외될 수 있습니다. ranking_options.hybrid_search를 지정한 경우에는 hybrid_search.embedding_weight(rrf_embedding_weight)와 hybrid_search.text_weight(rrf_text_weight)도 조정할 수 있습니다. 이 가중치는 역순위 융합에서 임베딩 기반 의미 검색과 희소 키워드 검색의 결과를 각각 얼마나 반영할지 결정합니다. 의미적 유사도를 강조하려면 첫 번째 가중치를, 텍스트의 일치도를 강조하려면 두 번째 가중치를 높이세요. 두 가중치 중 적어도 하나는 0보다 커야 합니다.
벡터 저장소는 Retrieval API와 파일 검색 도구에서 시맨틱 검색에 사용하는 컨테이너입니다. 벡터 저장소에 파일을 추가하면 파일이 자동으로 청크로 나뉘고, 각 청크의 임베딩이 생성되며 인덱싱이 이루어집니다.
벡터 저장소에는 vector_store_file 객체가 들어 있으며, 각 객체는 file 객체를 기반으로 합니다.
객체 유형
설명
fileFiles API 로 업로드한 콘텐츠를 나타냅니다. 주로 벡터 저장소와 함께 사용하며 파인튜닝 등 다른 용도로도 사용합니다.
vector_store검색할 수 있는 파일을 담는 컨테이너입니다.
vector_store.file청크 분할과 임베딩 생성을 거친 file이 vector_store에 연결된 상태를 나타내는 래퍼 유형입니다. attributes 맵을 포함합니다.
요금은 모든 벡터 저장소의 총 스토리지 사용량을 기준으로 부과됩니다. 사용량은 파일을 파싱해 얻은 청크와 해당 임베딩의 크기로 계산합니다.
스토리지 사용량
요금
1GB까지(전체 저장소 합계)
무료
1GB 초과분
GB당 하루 0.10달러
비용을 최소화하는 방법은 만료 정책 을 참고하세요.
Create Retrieve Update Delete List 생성
1
2
3
4 await client.vectorStores.create({
name: "Support FAQ",
file_ids: ["file_123"],
}); 1
2
3
4 client.vector_stores.create(
name = "Support FAQ" ,
file_ids = [ "file_123" ]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{
Name: openai.String("Support FAQ"),
FileIDs: []string{"file_123"},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreCreateParams;
String fileId = "file_123";
var store =
client
.vectorStores()
.create(
VectorStoreCreateParams.builder().name("Support FAQ").addFileId(fileId).build());
System.out.println(store.id()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.create(
name: "Support FAQ",
file_ids: ["file_123"]
)
puts(store.id) 조회
1 await client.vectorStores.retrieve("vs_123"); 1
2
3 client.vector_stores.retrieve(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Get(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().retrieve(vectorStoreId).id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.retrieve("vs_123")
puts(store.id) 수정
1
2
3 await client.vectorStores.update("vs_123", {
name: "Support FAQ Updated",
}); 1
2
3
4 client.vector_stores.update(
vector_store_id = "vs_123" ,
name = "Support FAQ Updated"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
Name: openai.String("Support FAQ Updated"),
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.Name)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder().name("Updated knowledge base").build());
System.out.println(store.name()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update("vs_123", name: "Updated knowledge base")
puts(store.name) 삭제
1 await client.vectorStores.delete("vs_123"); 1
2
3 client.vector_stores.delete(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Delete(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().delete(vectorStoreId).deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.delete("vs_123")
puts(deleted.deleted) 목록 조회
await client.vectorStores.list(); client.vector_stores.list() package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStores, err := client.VectorStores.List(context.Background(), openai.VectorStoreListParams{})
if err != nil {
panic(err)
}
fmt.Println(vectorStores.Data)
} import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
System.out.println(client.vectorStores().list().data()); require "openai"
client = OpenAI::Client.new
stores = client.vector_stores.list(limit: 10)
puts((stores.data || []).length)
create로 vector_store.file을 생성하는 작업 등 일부 작업은 비동기로 실행되므로 완료까지 시간이 걸릴 수 있습니다. create_and_poll과 같은 헬퍼 함수를 사용하면 작업이 완료될 때까지 기다릴 수 있습니다. 또는 작업 상태를 직접 확인할 수 있습니다. 벡터 저장소에서 파일을 삭제하면 변경 사항이 시차를 두고 반영되므로 삭제한 파일의 내용이 잠시 검색 결과에 나타날 수 있습니다.
파일 추가 요청 한도는 벡터 저장소 ID별로 적용됩니다. /vector_stores/{vector_store_id}/files/vector_stores/{vector_store_id}/file_batches
Create Upload Retrieve Update Delete List 생성
1
2
3 await client.vectorStores.files.createAndPoll("vs_123", {
file_id: "file_123",
}); 1
2
3
4 client.vector_stores.files.create_and_poll(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileNewParams{
FileID: "file_123",
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "vs_123";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(vectorStoreId, FileCreateParams.builder().fileId(fileId).build());
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create_and_poll("vs_123", file_id: "file_123")
unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
raise "File indexing did not complete: #{file.last_error&.message || file.status}"
end
puts(file.id) 업로드
1
2
3
4 await client.vectorStores.files.uploadAndPoll(
"vs_123",
fs.createReadStream("customer_policies.txt")
); 1
2
3
4 client.vector_stores.files.upload_and_poll(
vector_store_id = "vs_123" ,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
result, err := client.VectorStores.Files.UploadAndPoll(context.Background(), "vs_123", openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(result.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
String vectorStoreId = "vs_123";
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(
file.id(), FileRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9
10
11
12 require "openai"
require "pathname"
client = OpenAI::Client.new
vector_store_file = client.vector_stores.files.upload_and_poll(
"vs_123",
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{vector_store_file.status}" unless vector_store_file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(vector_store_file.id) 조회
1
2
3 await client.vectorStores.files.retrieve("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.retrieve(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Get(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.retrieve(
fileId,
com.openai.models.vectorstores.files.FileRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.retrieve("file_123", vector_store_id: "vs_123")
puts(file.id) 수정
1
2
3
4 await client.vectorStores.files.update("file_123", {
vector_store_id: "vs_123",
attributes: { key: "value" },
}); 1
2
3
4
5 client.vector_stores.files.update(
vector_store_id = "vs_123" ,
file_id = "file_123" ,
attributes = { "key" : "value" }
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Update(context.Background(), "vs_123", "file_123", openai.VectorStoreFileUpdateParams{
Attributes: map[string]openai.VectorStoreFileUpdateParamsAttributeUnion{
"key": {OfString: openai.String("value")},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileUpdateParams;
String fileId = "file_123";
String vectorStoreId = "vs_123";
var file =
client
.vectorStores()
.files()
.update(
fileId,
FileUpdateParams.builder()
.vectorStoreId(vectorStoreId)
.attributes(
FileUpdateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.update("file_123", vector_store_id: "vs_123", attributes: { category: "policy" })
puts(file.id) 삭제
1
2
3 await client.vectorStores.files.delete("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.delete(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Files.Delete(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.delete(
fileId,
com.openai.models.vectorstores.files.FileDeleteParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.files.delete("file_123", vector_store_id: "vs_123")
puts(deleted.deleted) 목록 조회
1 await client.vectorStores.files.list("vs_123"); 1
2
3 client.vector_stores.files.list(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.Files.List(context.Background(), "vs_123", openai.VectorStoreFileListParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().files().list(vectorStoreId).data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.files.list("vs_123")
puts((files.data || []).length)
생성
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 await client.vectorStores.fileBatches.createAndPoll("vs_123", {
files: [
{
file_id: "file_123",
attributes: { department: "finance" },
},
{
file_id: "file_456",
chunking_strategy: {
type: "static",
static: {
max_chunk_size_tokens: 1200,
chunk_overlap_tokens: 200,
},
},
},
],
}); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 client.vector_stores.file_batches.create_and_poll(
vector_store_id = "vs_123" ,
files = [
{
"file_id" : "file_123" ,
"attributes" : { "department" : "finance" }
},
{
"file_id" : "file_456" ,
"chunking_strategy" : {
"type" : "static" ,
"static" : {
"max_chunk_size_tokens" : 1200 ,
"chunk_overlap_tokens" : 200
}
}
}
]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileBatchNewParams{
Files: []openai.VectorStoreFileBatchNewParamsFile{
{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileBatchNewParamsFileAttributeUnion{
"department": {OfString: openai.String("finance")},
},
},
{
FileID: "file_456",
ChunkingStrategy: openai.FileChunkingStrategyParamUnion{OfStatic: &openai.StaticFileChunkingStrategyObjectParam{
Static: openai.StaticFileChunkingStrategyParam{MaxChunkSizeTokens: 1200, ChunkOverlapTokens: 200},
}},
},
},
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.StaticFileChunkingStrategy;
import com.openai.models.vectorstores.filebatches.FileBatchCreateParams;
import com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams;
import com.openai.models.vectorstores.filebatches.VectorStoreFileBatch;
String vectorStoreId = "vs_123";
String fileId = "file_123";
String fileId2 = "file_456";
var first =
FileBatchCreateParams.File.builder()
.fileId(fileId)
.attributes(
FileBatchCreateParams.File.Attributes.builder()
.putAdditionalProperty("department", JsonValue.from("finance"))
.build())
.build();
var second =
FileBatchCreateParams.File.builder()
.fileId(fileId2)
.staticChunkingStrategy(
StaticFileChunkingStrategy.builder()
.maxChunkSizeTokens(1200)
.chunkOverlapTokens(200)
.build())
.build();
var batch =
client
.vectorStores()
.fileBatches()
.create(
vectorStoreId,
FileBatchCreateParams.builder().addFile(first).addFile(second).build());
while (batch.status().equals(VectorStoreFileBatch.Status.IN_PROGRESS)) {
Thread.sleep(1000);
batch =
client
.vectorStores()
.fileBatches()
.retrieve(
batch.id(),
FileBatchRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(batch.status()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.create_and_poll(
"vs_123",
files: [
{
file_id: "file_123",
attributes: { department: "finance" }
},
{
file_id: "file_456",
chunking_strategy: {
type: :static,
static: {
max_chunk_size_tokens: 1_200,
chunk_overlap_tokens: 200
}
}
}
],
timeout: 600
)
raise "File ingestion ended with status: #{batch.status}" unless batch.status == OpenAI::VectorStores::VectorStoreFileBatch::Status::COMPLETED
raise "File ingestion failed for #{batch.file_counts.failed} file(s)" if batch.file_counts.failed.positive?
# Live validation of per-file batches returned default chunking despite overrides.
file = client.vector_stores.files.retrieve("file_456", vector_store_id: "vs_123")
strategy = file.chunking_strategy
unless strategy.is_a?(OpenAI::StaticFileChunkingStrategyObject) &&
strategy.static.max_chunk_size_tokens == 1_200 &&
strategy.static.chunk_overlap_tokens == 200
raise "Requested chunking was not applied to #{file.id}: #{strategy.to_json}"
end
puts(batch.status) 조회
1
2
3 await client.vectorStores.fileBatches.retrieve("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.retrieve(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Get(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.retrieve(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.retrieve(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 취소
1
2
3 await client.vectorStores.fileBatches.cancel("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.cancel(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Cancel(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.Status)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.cancel(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchCancelParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.cancel(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 목록 조회
1
2
3 await client.vectorStores.fileBatches.listFiles("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.list_files(
"vsfb_123" ,
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.FileBatches.ListFiles(context.Background(), "vs_123", "vsfb_123", openai.VectorStoreFileBatchListFilesParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.listFiles(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchListFilesParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.file_batches.list_files(
"vsfb_123",
vector_store_id: "vs_123"
)
puts((files.data || []).length)
배치를 생성할 때는 file_ids를 전달하고 필요에 따라 attributes와 chunking_strategy 중 하나 또는 둘 다 지정할 수 있습니다. 또는 files 배열에 파일별 객체를 담아 전달할 수 있습니다. 각 객체에는 file_id가 필수이며 attributes와 chunking_strategy는 선택 사항입니다. 두 방식은 함께 사용할 수 없습니다. 모든 파일에 같은 설정을 적용할지, 파일마다 설정을 다르게 지정할지에 따라 한 가지 방식을 선택하세요.
하나의 벡터 저장소에 파일을 추가할 때 처리량을 높이려면 가능하면 배치를 생성하는 것이 좋습니다. 배치를 사용하면 한 번의 요청에 최대 500개의 파일을 포함할 수 있습니다. 일반적으로 파일마다 별도의 생성 요청을 보낼 때보다 리소스 경합이 줄고 전체 처리 시간이 짧아집니다.
각 vector_store.file에는 속성값을 담은 딕셔너리인 attributes를 연결할 수 있습니다. 시맨틱 검색 을 수행할 때 속성 필터링 에서 이 값을 참조할 수 있습니다. 딕셔너리에는 키를 최대 16개까지 지정할 수 있으며, 각 키의 길이는 최대 256자입니다.
1
2
3
4
5
6
7
8 await client.vectorStores.files.create("<vector_store_id>", {
file_id: "file_123",
attributes: {
region: "US",
category: "Marketing",
date: 1672531200, // Jan 1, 2023
},
}); 1
2
3
4
5
6
7
8
9 client.vector_stores.files.create(
vector_store_id = "<vector_store_id>" ,
file_id = "file_123" ,
attributes = {
"region" : "US" ,
"category" : "Marketing" ,
"date" : 1672531200 # Jan 1, 2023
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.New(context.Background(), "<vector_store_id>", openai.VectorStoreFileNewParams{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileNewParamsAttributeUnion{
"region": {OfString: openai.String("US")},
"category": {OfString: openai.String("Marketing")},
"date": {OfFloat: openai.Float(1672531200)},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "<vector_store_id>";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
FileCreateParams.builder()
.fileId(fileId)
.attributes(
FileCreateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create("<vector_store_id>", file_id: "file_123", attributes: { category: "policy" })
puts(file.id) vector_store 객체의 expires_after로 만료 정책을 설정할 수 있습니다. 벡터 저장소가 만료되면 연결된 모든 vector_store.file 객체가 삭제되고 해당 객체에 대한 요금도 더 이상 부과되지 않습니다.
1
2
3
4
5
6 await client.vectorStores.update("vs_123", {
expires_after: {
anchor: "last_active_at",
days: 7,
},
}); 1
2
3
4
5
6
7 client.vector_stores.update(
vector_store_id = "vs_123" ,
expires_after = {
"anchor" : "last_active_at" ,
"days" : 7
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
ExpiresAfter: openai.VectorStoreUpdateParamsExpiresAfter{Days: 7},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ExpiresAfter)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder()
.expiresAfter(
VectorStoreUpdateParams.ExpiresAfter.builder()
.anchor(JsonValue.from("last_active_at"))
.days(7)
.build())
.build());
System.out.println(store.expiresAfter().orElseThrow()); 1
2
3
4
5
6
7
8
9
10
11 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update(
"vs_123",
expires_after: {
anchor: :last_active_at,
days: 7
}
)
puts(store.expires_after) 파일 하나의 최대 크기는 512MB입니다. 파일당 토큰 수는 5,000,000개 이하여야 하며, 파일을 첨부할 때 자동으로 계산됩니다.
기본적으로 max_chunk_size_tokens는 800으로, chunk_overlap_tokens는 400으로 설정됩니다. 따라서 모든 파일은 800토큰 단위의 청크로 나뉘어 인덱싱되며, 연속된 두 청크 사이에는 400토큰이 겹칩니다.
벡터 저장소에 파일을 추가할 때 chunking_strategy
max_chunk_size_tokens는 100 이상 4096 이하여야 합니다.chunk_overlap_tokens는 0 이상이어야 하며 max_chunk_size_tokens / 2를 초과하지 않아야 합니다.
지원되는 파일 형식 text/ MIME 유형의 인코딩은 utf-8, utf-16, ascii 중 하나여야 합니다.
파일 형식
MIME 유형
.ctext/x-c
.cpptext/x-c++
.cstext/x-csharp
.csstext/css
.docapplication/msword
.docxapplication/vnd.openxmlformats-officedocument.wordprocessingml.document
.gotext/x-golang
.htmltext/html
.javatext/x-java
.jstext/javascript
.jsonapplication/json
.mdtext/markdown
.pdfapplication/pdf
.phptext/x-php
.pptxapplication/vnd.openxmlformats-officedocument.presentationml.presentation
.pytext/x-python
.pytext/x-script.python
.rbtext/x-ruby
.shapplication/x-sh
.textext/x-tex
.tsapplication/typescript
.txttext/plain
쿼리를 실행한 뒤 검색 결과를 종합해 응답을 작성하려면 OpenAI 모델에 검색 결과와 원래 쿼리를 함께 전달하세요. 그러면 검색 결과에 근거한 응답을 받을 수 있습니다.
1
2
3
4
5
6
7
8
9 import OpenAI from "openai";
const client = new OpenAI();
const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6
7
8
9
10 from openai import OpenAI
client = OpenAI()
user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "What is the return policy?"
)
puts(results.data) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 const formattedResults = formatResults(results.data);
// Join the text content of all results
const textSources = results.data
.map((result) => result.content.map((c) => c.text).join("\n"))
.join("\n");
const completion = await client.chat.completions.create({
model: "gpt-6-astra",
messages: [
{
role: "developer",
content:
"Produce a concise answer to the query based on the provided sources.",
},
{
role: "user",
content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`,
},
],
});
console.log(completion.choices[0].message.content); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 # Use results and user_query from the preceding search step.
formatted_results = format_results(results.data)
" \n " .join( " \n " .join(c.text for c in result.content) for result in results.data)
completion = client.chat.completions.create(
model = "gpt-6-astra" ,
messages = [
{
"role" : "developer" ,
"content" : "Produce a concise answer to the query based on the provided sources." ,
},
{
"role" : "user" ,
"content" : f "Sources: { formatted_results }\n\n Query: ' { user_query } '" ,
},
],
)
print (completion.choices[ 0 ].message.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46 package main
import (
"context"
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
userQuery := "What is the return policy?"
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)},
})
if err != nil {
panic(err)
}
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6-astra",
Messages: []openai.ChatCompletionMessageParamUnion{
openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."),
openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)),
},
})
if err != nil {
panic(err)
}
fmt.Println(completion.Choices[0].Message.Content)
}
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
import com.openai.models.vectorstores.VectorStoreSearchParams;
import java.util.stream.Collectors;
String vectorStoreId = "vs_123";
String query = "What is the return policy?";
var results =
client
.vectorStores()
.search(vectorStoreId, VectorStoreSearchParams.builder().query(query).build());
String sources =
results.data().stream()
.map(
result ->
"<result file_id='"
+ result.fileId()
+ "' file_name='"
+ result.filename()
+ "'>"
+ result.content().stream()
.map(content -> "<content>" + content.text() + "</content>")
.collect(Collectors.joining())
+ "</result>")
.collect(Collectors.joining());
var completion =
client
.chat()
.completions()
.create(
ChatCompletionCreateParams.builder()
.model("gpt-6-astra")
.addDeveloperMessage(
"Answer the query concisely using only the provided sources.")
.addUserMessage(
"Sources: <sources>" + sources + "</sources>\n\nQuery: " + query)
.build());
completion.choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 require "openai"
client = OpenAI::Client.new
query = "What is the return policy?"
results = client.vector_stores.search("vs_123", query: query)
sources = (results.data || []).map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id='#{result.file_id}' file_name='#{result.filename}'>#{content}</result>"
end.join
completion = client.chat.completions.create(
model: "gpt-6-astra",
messages: [
{
role: :developer,
content: "Answer the query concisely using only the provided sources."
},
{
role: :user,
content: "Sources: <sources>#{sources}</sources>\n\nQuery: #{query}"
}
]
)
puts(completion.choices.fetch(0).message.content) "Our return policy allows returns within 30 days of purchase." 위 예시에서 사용한 format_results 함수는 다음과 같이 구현할 수 있습니다.
1
2
3
4
5
6
7
8
9
10
11 function formatResults(results) {
let formattedResults = "";
for (const result of results.data) {
let formattedResult = `<result file_id='${result.file_id}' file_name='${result.filename}'>`;
for (const part of result.content) {
formattedResult += `<content>${part.text}</content>`;
}
formattedResults += formattedResult + "</result>";
}
return `<sources>${formattedResults}</sources>`;
} 1
2
3
4
5
6
7
8
9
10 def format_results (results):
formatted_results = ""
for result in results.data:
formatted_result = (
f "<result file_id=' { result.file_id } ' file_name=' { result.filename } '>"
)
for part in result.content:
formatted_result += f "<content> { part.text } </content>"
formatted_results += formatted_result + "</result>"
return f "<sources> { formatted_results } </sources>" 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 package main
import (
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 import com.openai.models.vectorstores.VectorStoreSearchResponse;
import java.util.List;
static String formatResults(List<VectorStoreSearchResponse> results) {
var formatted = new StringBuilder("<sources>");
for (var result : results) {
formatted
.append("<result file_id='")
.append(result.fileId())
.append("' file_name='")
.append(result.filename())
.append("'>");
for (var part : result.content()) {
formatted.append("<content>").append(part.text()).append("</content>");
}
formatted.append("</result>");
}
return formatted.append("</sources>").toString();
} 1
2
3
4
5
6
7
8 def format_results(results)
sources = results.map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id=\"#{result.file_id}\" file_name=\"#{result.filename}\">#{content}</result>"
end
"<sources>#{sources.join}</sources>"
end