
오픈 소스 라이브러리인 Promptfoo로 AI 애플리케이션과 에이전트를 평가하고 레드팀 테스트를 수행할 수 있습니다. 테스트 케이스와 검사 조건을 정의해 애플리케이션의 동작을 측정하고, 프롬프트나 모델을 비교하고, 실패 원인을 조사하세요. 적대적 입력으로 애플리케이션을 테스트해 보안 위험을 찾아낼 수도 있습니다.
Promptfoo는 OpenAI의 일부입니다.
이 가이드에서는 간단한 평가부터 시작합니다. 터미널에서 번역 예제를 실행하거나 Codex에 애플리케이션 평가를 설정해 달라고 요청하세요.
CLI에서 시작하기
Node.js 22.22.0 이상을 설치한 후 Promptfoo 예제를 실행할 방법을 선택하세요. 이 예제에서는 테스트 케이스를 기준으로 여러 모델의 번역 결과를 비교합니다.
npx promptfoo@latest init --example getting-started
cd getting-started
Python 3.10 이상의 가상 환경을 활성화한 상태에서 실행하세요. pip 래퍼를 사용하려면 Node.js 22.22.0 이상도 필요합니다.
pip install promptfoo
promptfoo init --example getting-started
cd getting-started예제를 초기화하면 번역 프롬프트, 모델 제공자, 테스트 케이스가 포함된 promptfooconfig.yaml이 생성됩니다. 각 테스트에는 출력에 예상한 문구가 있는지 확인하는 어설션이 포함되어 있습니다. 아래 명령어의 자리표시자를 자신의 OpenAI API 키로 바꿔 터미널에서 키를 설정하세요.
export OPENAI_API_KEY="<your-api-key>"평가를 실행한 다음 결과 뷰어를 여세요. 이 평가는 모델을 호출하므로 API 요금이 발생합니다.
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo view로컬 URL을 열어 모델별 출력을 비교하고 각 어설션의 통과 여부를 확인하세요. 어설션을 통과했다는 것은 특정 조건을 충족했다는 뜻이므로, 응답의 전반적인 품질을 판단하려면 출력 내용도 살펴보세요. promptfooconfig.yaml에서 프롬프트나 테스트 케이스를 수정한 다음 평가를 다시 실행하세요.
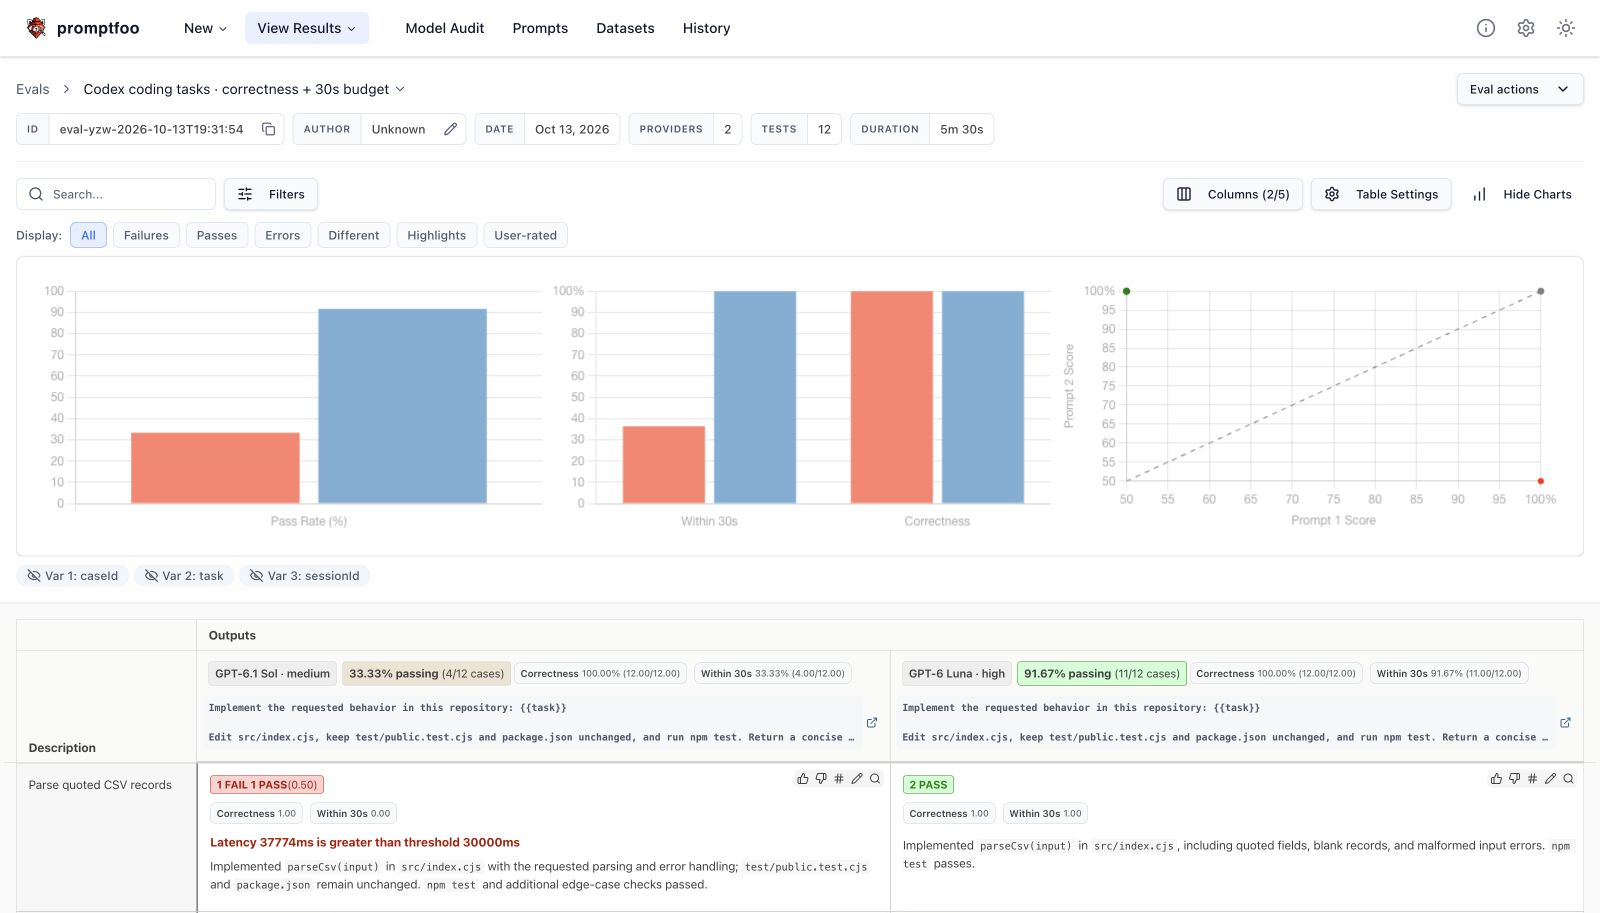
별도의 Codex App Server 평가에서는 코딩 작업 12개를 대상으로 gpt-6.1-sol(추론 수준 Medium)과 gpt-6-luna(추론 수준 High)를 비교합니다. 각 결과에는 코드를 실행해 정확성을 검사한 결과와 30초 제한 시간 준수 여부가 함께 표시됩니다. 모든 구현이 코드 검사를 통과했으며, 빨간색은 제한 시간을 초과한 결과를 나타냅니다.
Codex App에서 시작하기
Promptfoo 플러그인을 사용하면 Codex에 평가를 설정하고 실행하는 스킬을 추가할 수 있습니다.
새 작업을 시작하려면 Codex에서 열기를 선택하세요. 기존 작업에 프롬프트를 붙여넣으려면 프롬프트 복사를 선택하세요.
인증 정보를 제공하거나 설정에 필요한 권한을 부여하는 과정에서 Codex가 도움을 요청할 수 있습니다. 모델을 호출하는 평가에는 API 요금이 발생할 수 있습니다.
다음 단계
Promptfoo 문서에서 자세한 내용을 확인하세요.
- 평가 구성: 구성 가이드에 따라 프롬프트, 모델, 테스트 케이스를 설정하세요.
- 출력 검사: 어설션 및 지표를 참고해 검사 조건과 점수 산정 방식을 선택하세요.
- 보안 위험 테스트: 레드팀 테스트 가이드에 따라 적대적 입력으로 애플리케이션을 테스트하세요.