
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.임베딩이란?
OpenAI의 텍스트 임베딩은 문자열 간의 관련성을 측정합니다. 임베딩은 주로 다음과 같은 작업에 사용합니다.
- 검색 (검색어와의 관련성이 높은 순서로 결과를 정렬합니다)
- 군집화 (유사한 문자열을 그룹으로 묶습니다)
- 추천 (서로 관련 있는 문자열을 포함한 항목을 추천합니다)
- 이상 탐지 (다른 항목과 관련성이 낮은 이상치를 찾습니다)
- 다양성 측정 (유사도의 분포를 분석합니다)
- 분류 (각 문자열에 가장 유사한 레이블을 부여합니다)
임베딩은 부동 소수점 수로 이루어진 벡터(리스트)입니다. 두 벡터 사이의 거리로 관련성을 측정합니다. 거리가 가까울수록 관련성이 높고, 멀수록 관련성이 낮다고 볼 수 있습니다.
임베딩 요금은 요금 페이지에서 확인하세요. 요청 요금은 토큰 수를 기준으로 계산하며, 입력에 포함된 토큰을 집계합니다.
임베딩 얻기
임베딩을 얻으려면 임베딩 API 엔드포인트에 텍스트 문자열과 임베딩 모델 이름(예: text-embedding-3-small)을 함께 보내세요.
1
2
3
4
5
6
7
8
9
10import OpenAI from "openai";
const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "Your text string goes here",
  encoding_format: "float",
});

console.log(embedding);
1
2
3
4
5
6
7
8
9from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(
input="Your text string goes here", model="text-embedding-3-small"
)
print(response.data[0].embedding)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
embedding, err := client.Embeddings.New(context.Background(), openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{
OfString: openai.String("Your text string goes here."),
},
})
if err != nil {
panic(err)
}
fmt.Println(len(embedding.Data[0].Embedding))
}1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("The food was delicious and the waiter...")
.build());
System.out.println(embedding.data().get(0).embedding());1
2
3
4
5
6
7
8
9
10
11using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync(
"The food was delicious and the waiter was friendly."
);
Console.WriteLine($"Dimensions: {embedding.ToFloats().Length}");1
2
3
4
5
6
7
8
9
10require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "The food was delicious and the waiter..."
)
puts(response.data.fetch(0).embedding)1
2
3
4
5
6
7curl https://api.openai.com/v1/embeddings \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"input": "Your text string goes here",
"model": "text-embedding-3-small"
}'응답에는 임베딩 벡터(부동 소수점 수 리스트)와 추가 메타데이터가 포함됩니다. 임베딩 벡터를 추출해 벡터 데이터베이스에 저장하고 다양한 작업에 활용할 수 있습니다.
123456789101112131415161718{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422, -0.005336422007530928, -4.547132266452536e-5,
        -0.024047505110502243
      ]
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}
임베딩 벡터의 기본 길이는 1536(text-embedding-3-small) 또는 3072(text-embedding-3-large)입니다. 임베딩이 개념을 표현하는 능력을 유지하면서 차원 수를 줄이려면 dimensions 매개변수를 전달하세요. 임베딩 차원에 대한 자세한 내용은 임베딩 활용 사례를 참고하세요.
임베딩 모델
OpenAI는 성능이 뛰어난 3세대 임베딩 모델 두 가지를 제공합니다. 모델 ID의 -3이 3세대를 나타냅니다. 자세한 내용은 3세대 임베딩 모델 출시 안내 글을 참고하세요.
요금은 입력 토큰당 부과됩니다. 아래 표는 페이지당 약 800토큰을 기준으로 미화 1달러로 처리할 수 있는 텍스트 분량을 보여 줍니다.
| 모델 | 1달러당 페이지 수(근사치) | MTEB 평가 성능 | 최대 입력 토큰 수 |
|---|---|---|---|
| text-embedding-3-small | 62,500 | 62.3% | 8192 |
| text-embedding-3-large | 9,615 | 64.6% | 8192 |
| text-embedding-ada-002 | 12,500 | 61.0% | 8192 |
활용 사례
Amazon 식품 리뷰 데이터셋을 사용해 대표적인 활용 사례를 살펴봅니다.
리뷰 임베딩 얻기
이 데이터셋에는 2012년 10월까지 Amazon 사용자가 작성한 식품 리뷰 568,454개가 들어 있습니다. 예제에서는 이 중 가장 최근 리뷰 1,000개를 사용합니다. 리뷰는 영어로 작성되었으며 대체로 긍정적이거나 부정적인 의견을 담고 있습니다. 각 리뷰에는 ProductId, UserId, Score, 리뷰 제목(Summary), 리뷰 본문(Text)이 있습니다. 예시는 다음과 같습니다.
| 제품 ID | 사용자 ID | 평점 | 제목 | 본문 |
|---|---|---|---|---|
| B001E4KFG0 | A3SGXH7AUHU8GW | 5 | Good Quality Dog Food | I have bought several of the Vitality canned… |
| B00813GRG4 | A1D87F6ZCVE5NK | 1 | Not as Advertised | Product arrived labeled as Jumbo Salted Peanut… |
아래에서는 리뷰 제목과 본문을 하나의 텍스트로 합칩니다. 모델은 이 텍스트를 인코딩해 임베딩 벡터 하나를 출력합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import { mkdir, writeFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const reviews = ["A rich cup of coffee.", "A bright herbal tea."];

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: reviews.map((review) => review.replaceAll("\n", " ")),
});

const csvField = (value) => `"${value.replaceAll('"', '""')}"`;
const rows = response.data.map(({ embedding }, index) =>
  [csvField(reviews[index]), csvField(JSON.stringify(embedding))].join(",")
);

await mkdir("output", { recursive: true });
await writeFile(
  "output/embedded_1k_reviews.csv",
  ["combined,ada_embedding", ...rows].join("\n") + "\n"
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17from pathlib import Path
from openai import OpenAI
client = OpenAI()
def get_embedding(text, model="text-embedding-3-small"):
text = text.replace("\n", " ")
return client.embeddings.create(input=[text], model=model).data[0].embedding
df["ada_embedding"] = df.combined.apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
Path("output").mkdir(exist_ok=True)
df.to_csv("output/embedded_1k_reviews.csv", index=False)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68import (
"context"
"encoding/csv"
"encoding/json"
"fmt"
"log"
"os"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
reviews := []string{"A rich cup of coffee.", "A bright herbal tea."}
if err := os.MkdirAll("output", 0755); err != nil {
return err
}
file, err := os.Create("output/embedded_1k_reviews.csv")
if err != nil {
return err
}
defer file.Close()
writer := csv.NewWriter(file)
if err := writer.Write([]string{"combined", "ada_embedding"}); err != nil {
return err
}
for _, review := range reviews {
vector, err := embedding(ctx, &client, strings.ReplaceAll(review, "\n", " "))
if err != nil {
return err
}
encoded, err := json.Marshal(vector)
if err != nil {
return err
}
if err := writer.Write([]string{review, string(encoded)}); err != nil {
return err
}
}
writer.Flush()
if err := writer.Error(); err != nil {
return err
}
if err := file.Close(); err != nil {
return err
}
fmt.Println("Saved output/embedded_1k_reviews.csv")
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
static String csvField(String value) {
return "\"" + value.replace("\"", "\"\"") + "\"";
}
List<String> reviews = List.of("A rich cup of coffee.", "A bright herbal tea.");
Path output = Path.of("output", "embedded_1k_reviews.csv");
Files.createDirectories(output.getParent());
try (var writer = Files.newBufferedWriter(output)) {
writer.write("combined,ada_embedding\n");
for (String review : reviews) {
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of(review.replace("\n", " ")))
.build())
.data()
.get(0)
.embedding();
writer.write(csvField(review) + "," + csvField(embedding.toString()) + "\n");
}
}
System.out.println(output);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26using System.Text.Json;
using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] reviews = ["A rich cup of coffee.", "A bright herbal tea."];
Directory.CreateDirectory("output");
using StreamWriter writer = new("output/embedded_1k_reviews.csv");
await writer.WriteLineAsync("combined,ada_embedding");
foreach (string review in reviews)
{
float[] vector = await EmbedAsync(client, review.Replace("\n", " ", StringComparison.Ordinal));
string encoded = JsonSerializer.Serialize(vector);
await writer.WriteLineAsync($"{CsvField(review)},{CsvField(encoded)}");
}
Console.WriteLine("Saved output/embedded_1k_reviews.csv");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static string CsvField(string value) => "\"" + value.Replace("\"", "\"\"", StringComparison.Ordinal) + "\"";1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20require "csv"
require "fileutils"
require "json"
require "openai"
client = OpenAI::Client.new
reviews = ["A rich cup of coffee.", "A bright herbal tea."]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews.map { |review| review.tr("\n", " ") }
)
FileUtils.mkdir_p("output")
CSV.open("output/embedded_1k_reviews.csv", "w") do |csv|
csv << ["combined", "ada_embedding"]
response.data.each do |embedding|
csv << [reviews.fetch(embedding.index), JSON.generate(embedding.embedding)]
end
end저장된 파일에서 데이터를 불러오려면 다음 코드를 실행하세요.
1
2
3
4
5from ast import literal_eval
import pandas as pd

df = pd.read_csv("output/embedded_1k_reviews.csv")
df["ada_embedding"] = df.ada_embedding.apply(literal_eval).apply(np.array)검색을 위해 임베딩을 벡터 저장소에 저장하는 경우처럼 큰 임베딩을 사용할 때는 일반적으로 작은 임베딩을 사용할 때보다 비용이 많이 들고 연산 자원, 메모리, 저장 공간도 더 많이 필요합니다.
새 임베딩 모델 두 가지는 모두 개발자가 임베딩의 성능과 비용 사이에서 균형을 조절할 수 있는 기법으로 학습했습니다. 구체적으로는 dimensions API 매개변수를 전달하면 임베딩이 개념을 표현하는 능력을 유지하면서 길이를 줄일 수 있습니다. 벡터 끝에서 일부 숫자를 제거하는 방식입니다. 예를 들어 MTEB 벤치마크에서 text-embedding-3-large 임베딩은 길이를 256으로 줄여도 원래 길이 1536을 유지한 text-embedding-ada-002 임베딩보다 성능이 뛰어납니다. 차원 수가 성능에 미치는 영향은 3세대 임베딩 모델 출시 안내 글에서 자세히 확인할 수 있습니다.
일반적으로 임베딩을 생성할 때 dimensions 매개변수로 차원 수를 지정하는 것을 권장합니다. 경우에 따라 생성 후에 차원 수를 변경해야 할 수도 있습니다. 수동으로 차원 수를 변경할 때는 아래와 같이 변경된 임베딩 벡터를 반드시 정규화하세요.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import OpenAI from "openai";

const client = new OpenAI();

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: "float",
});

const shortened = response.data[0].embedding.slice(0, 256);
const magnitude = Math.hypot(...shortened);
const normalized = shortened.map((value) =>
  magnitude === 0 ? 0 : value / magnitude
);

console.log(normalized);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI
import numpy as np
client = OpenAI()
def normalize_l2(x):
x = np.array(x)
if x.ndim == 1:
norm = np.linalg.norm(x)
if norm == 0:
return x
return x / norm
else:
norm = np.linalg.norm(x, 2, axis=1, keepdims=True)
return np.where(norm == 0, x, x / norm)
response = client.embeddings.create(
model="text-embedding-3-small", input="Testing 123", encoding_format="float"
)
cut_dim = response.data[0].embedding[:256]
norm_dim = normalize_l2(cut_dim)
print(norm_dim)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
private static List<Double> normalizeL2(List<Float> embedding) {
double norm =
Math.sqrt(embedding.stream().mapToDouble(value -> value.doubleValue() * value).sum());
return embedding.stream().map(value -> norm == 0 ? 0.0 : value / norm).toList();
}
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Testing 123")
.encodingFormat(EmbeddingCreateParams.EncodingFormat.FLOAT)
.build());
List<Float> shortened = embedding.data().get(0).embedding().subList(0, 256);
System.out.println(normalizeL2(shortened));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync("Testing 123");
float[] shortened = embedding.ToFloats().Span[..256].ToArray();
double magnitude = Math.Sqrt(shortened.Sum(value => (double)value * value));
double[] normalized =
magnitude == 0
? shortened.Select(value => (double)value).ToArray()
: shortened.Select(value => value / magnitude).ToArray();
Console.WriteLine(System.Text.Json.JsonSerializer.Serialize(normalized));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "Testing 123",
encoding_format: :float
)
shortened = response.data.fetch(0).embedding.first(256)
magnitude = Math.sqrt(shortened.sum { |value| value**2 })
normalized = shortened.map { |value| magnitude.zero? ? 0 : value / magnitude }
puts(normalized)차원 수를 동적으로 변경하면 사용 환경에 맞춰 임베딩을 유연하게 활용할 수 있습니다. 예를 들어 최대 1024차원까지 지원하는 벡터 저장소에서도 성능이 가장 뛰어난 임베딩 모델인 text-embedding-3-large를 사용할 수 있습니다. dimensions API 매개변수를 1024로 지정하면 3072차원 임베딩이 1024차원으로 줄어듭니다. 정확도는 다소 낮아지지만 벡터 크기가 작아집니다.
사용자 질문에 답하는 데 필요한 핵심 사실이나 정보가 모델의 학습 데이터에 없는 경우가 많습니다. 아래 예제처럼 모델의 컨텍스트 윈도우에 정보를 추가하면 이 문제를 해결할 수 있습니다. 이 방법은 다양한 상황에서 효과적이지만 토큰 비용이 늘어납니다. 이 노트북에서는 이 방법과 임베딩 기반 검색의 장단점을 비교합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";

const client = new OpenAI();
const article =
  "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
const question = `Use the article below to answer the question. If the answer cannot be found, say "I don't know."

Article:
${article}

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;

const response = await client.chat.completions.create({
  model: "gpt-4.1-mini",
  messages: [
    {
      role: "system",
      content: "You answer questions about the 2022 Winter Olympics.",
    },
    { role: "user", content: question },
  ],
  temperature: 0,
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."
Article:
\"\"\"
{wikipedia_article_on_curling}
\"\"\"
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""
response = client.chat.completions.create(
messages=[
{
"role": "system",
"content": "You answer questions about the 2022 Winter Olympics.",
},
{"role": "user", "content": query},
],
model=GPT_MODEL,
temperature=0,
)
print(response.choices[0].message.content)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import (
"context"
"fmt"
"log"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-4.1-mini", Temperature: openai.Float(0), Messages: []openai.ChatCompletionMessageParamUnion{
openai.SystemMessage("You answer questions about the 2022 Winter Olympics."),
openai.UserMessage("Use the article to answer the question. If the answer cannot be found, write \"I don't know.\"\n\nArticle: At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?")},
})
if err != nil {
return err
}
fmt.Println(completion.Choices[0].Message.Content)
return nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
String article =
"At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
String question =
"Use the below article on the 2022 Winter Olympics to answer the subsequent question. "
+ "If the answer cannot be found, write \"I don't know.\"\n\n"
+ "Article:\n"
+ article
+ "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletionCreateParams params =
ChatCompletionCreateParams.builder()
.model("gpt-4.1-mini")
.addSystemMessage("You answer questions about the 2022 Winter Olympics.")
.addUserMessage(question)
.temperature(0)
.build();
client.chat().completions().create(params).choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12using OpenAI.Chat;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-4.1-mini";
ChatClient client = new(model, key);
string article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
string query = $"Use the article to answer the question. If the answer cannot be found, write I don't know.\nArticle: {article}\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletion result = await client.CompleteChatAsync(
[new SystemChatMessage("You answer questions about the 2022 Winter Olympics."), new UserChatMessage(query)],
new ChatCompletionOptions { Temperature = 0 });
Console.WriteLine(result.Content[0].Text);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."
question = <<~QUESTION
Use the article below to answer the question. If the answer cannot be found, say "I don't know."
Article:
#{article}
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?
QUESTION
response = client.chat.completions.create(
model: "gpt-4.1-mini",
messages: [
{
role: :system,
content: "You answer questions about the 2022 Winter Olympics."
},
{
role: :user,
content: question
}
],
temperature: 0
)
puts(response.choices.fetch(0).message.content)관련성이 가장 높은 문서를 찾으려면 검색어의 임베딩 벡터와 각 문서의 임베딩 벡터 사이의 코사인 유사도를 계산한 뒤 점수가 가장 높은 문서를 반환합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";

const client = new OpenAI();
const reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...reviews, "delicious beans"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = reviews
  .map((review, index) => ({
    review,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score)
  .slice(0, 3);

console.log(results);
1
2
3
4
5
6
7
8
9
10def search_reviews(df, product_description, n=3, pprint=True):
embedding = get_embedding(product_description, model="text-embedding-3-small")
df["similarities"] = df.ada_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_reviews(df, "delicious beans", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "delicious beans")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> reviews =
List.of(
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange.");
var reviewEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(reviews)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("delicious beans"))
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, reviews.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, reviewEmbeddings.get(index).embedding()))
.reversed())
.limit(3)
.map(reviews::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."];
OpenAIEmbeddingCollection batch = await client.GenerateEmbeddingsAsync(texts);
float[][] vectors = batch.Select(item => item.ToFloats().ToArray()).ToArray();
float[] query = await EmbedAsync(client, "delicious beans");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"
client = OpenAI::Client.new
reviews = [
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews + ["delicious beans"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = reviews.map.with_index do |review, index|
{
review: review,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }.first(3)
puts(results)코드 검색은 임베딩 기반 텍스트 검색과 비슷하게 동작합니다. 이 예제에서는 지정한 리포지터리의 모든 Python 파일에서 함수를 추출하는 방법을 보여 줍니다. 그런 다음 text-embedding-3-small 모델을 사용해 각 함수를 인덱싱합니다.
코드를 검색할 때는 같은 모델로 자연어 검색어를 임베딩합니다. 그런 다음 검색어 임베딩과 각 함수 임베딩 사이의 코사인 유사도를 계산합니다. 코사인 유사도가 가장 높은 결과가 검색어와 가장 관련이 있습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const client = new OpenAI();
const functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...functions, "Completions API tests"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = functions
  .map((source, index) => ({
    source,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score);

console.log(results);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16df["code_embedding"] = df["code"].apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
def search_functions(df, code_query, n=3, pprint=True, n_lines=7):
embedding = get_embedding(code_query, model="text-embedding-3-small")
df["similarities"] = df.code_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_functions(df, "Completions API tests", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"def add(a, b): return a + b", "def complete(prompt): return prompt"}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "Completions API tests")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> functions =
List.of("def add(a, b): return a + b", "def complete(prompt): return prompt");
var functionEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(functions)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Completions API tests")
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, functions.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, functionEmbeddings.get(index).embedding()))
.reversed())
.map(functions::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["def add(a, b): return a + b", "def complete(prompt): return prompt"];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = await EmbedAsync(client, "Completions API tests");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
functions = [
"function add(a, b) { return a + b; }",
"function complete(prompt) { return prompt; }"
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: functions + ["Completions API tests"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = functions.map.with_index do |source, index|
{
source: source,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }
puts(results)임베딩 벡터 사이의 거리가 가까울수록 유사도가 높으므로 임베딩을 추천에 활용할 수 있습니다.
아래 예제는 기본적인 추천 함수입니다. 문자열 목록과 기준 문자열 하나를 입력받아 각각의 임베딩을 계산한 뒤, 기준 문자열과 가장 유사한 문자열부터 순서대로 반환합니다. 연결된 노트북에서는 이 함수를 응용해 AG 뉴스 데이터셋에서 추출한 기사 설명 2,000개 중 주어진 기준 기사와 가장 유사한 기사 5개를 반환합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from "openai";

const client = new OpenAI();
const strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: strings,
});

const query = data[0].embedding;
const recommendations = data
  .map(({ embedding }, index) => {
    const dotProduct = embedding.reduce(
      (total, value, dimension) => total + value * query[dimension],
      0
    );
    const similarity =
      dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
    return { index, text: strings[index], similarity };
  })
  .sort((left, right) => right.similarity - left.similarity);

console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings(
strings: list[str],
index_of_source_string: int,
model="text-embedding-3-small",
) -> list[int]:
"""Return nearest neighbors of a given string."""
# get embeddings for all strings
embeddings = [embedding_from_string(string, model=model) for string in strings]
# get the embedding of the source string
query_embedding = embeddings[index_of_source_string]
# get distances between the source embedding and other embeddings (function from embeddings_utils.py)
distances = distances_from_embeddings(
query_embedding, embeddings, distance_metric="cosine"
)
# get indices of nearest neighbors (function from embeddings_utils.py)
indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances(
distances
)
return indices_of_nearest_neighbors1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query := vectors[0]
matches := nearest(query, vectors)
for _, match := range matches {
fmt.Println(match.Index)
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> strings =
List.of(
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly.");
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(strings)
.build())
.data();
List<Float> query = embeddings.get(0).embedding();
var nearestNeighbors =
IntStream.range(0, embeddings.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) -> {
List<Float> candidate = embeddings.get(index).embedding();
double dotProduct = 0;
double queryMagnitude = 0;
double candidateMagnitude = 0;
for (int dimension = 0; dimension < query.size(); dimension++) {
double queryValue = query.get(dimension);
double candidateValue = candidate.get(dimension);
dotProduct += queryValue * candidateValue;
queryMagnitude += queryValue * queryValue;
candidateMagnitude += candidateValue * candidateValue;
}
return 1 - dotProduct / Math.sqrt(queryMagnitude * candidateMagnitude);
}))
.toList();
System.out.println(nearestNeighbors);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = vectors[0];
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked)
{
Console.WriteLine(match.Index);
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31require "openai"
client = OpenAI::Client.new
strings = [
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: strings
)
query = response.data.fetch(0).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
recommendations = response.data.map.with_index do |embedding, index|
{
index: index,
text: strings.fetch(index),
similarity: similarity.call(embedding.embedding)
}
end.sort_by { |recommendation| -recommendation.fetch(:similarity) }
puts(recommendations)임베딩 크기는 임베딩을 생성하는 모델의 복잡도에 따라 달라집니다. 이 고차원 데이터를 시각화하기 위해 t-SNE 알고리즘으로 데이터를 2차원으로 변환합니다.
각 리뷰는 작성자가 매긴 별점에 따라 다음 색으로 표시합니다.
- 별 1개: 빨간색
- 별 2개: 진한 주황색
- 별 3개: 금색
- 별 4개: 청록색
- 별 5개: 진한 녹색
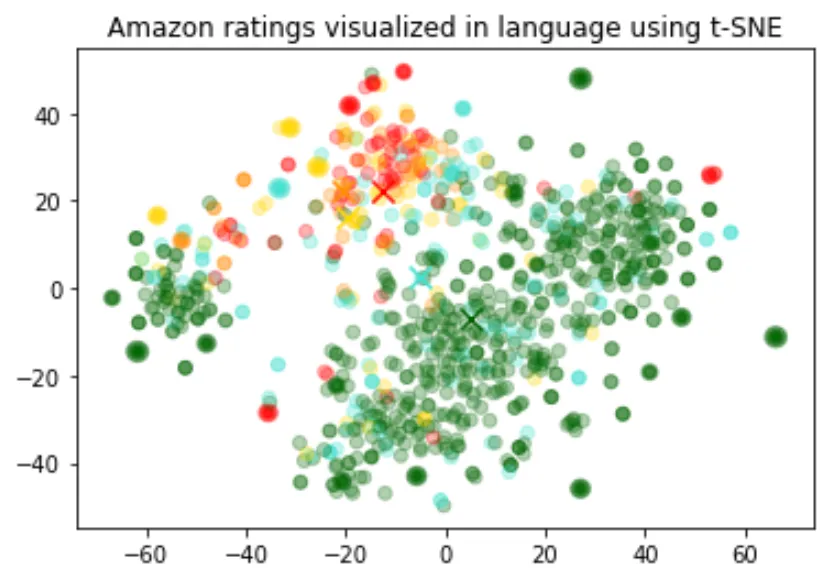
그래프에서는 대략 세 개의 군집이 보이며, 그중 하나는 대부분 부정적인 리뷰로 이루어져 있습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24from ast import literal_eval
import numpy as np
import pandas as pd
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
import matplotlib

df = pd.read_csv("output/embedded_1k_reviews.csv")
matrix = np.array(df.ada_embedding.apply(literal_eval).to_list())

# Create a t-SNE model and transform the data
tsne = TSNE(
    n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200
)
vis_dims = tsne.fit_transform(matrix)

colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]
x = [x for x, y in vis_dims]
y = [y for x, y in vis_dims]
color_indices = df.Score.values - 1

colormap = matplotlib.colors.ListedColormap(colors)
plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)
plt.title("Amazon ratings visualized in language using t-SNE")
머신러닝 모델에서는 임베딩을 자유 형식 텍스트의 범용 특성 인코더로 사용할 수 있습니다. 작업과 관련된 입력에 자유 형식 텍스트가 포함되어 있다면 어떤 머신러닝 모델이든 임베딩을 활용해 성능을 높일 수 있습니다. 임베딩은 머신러닝 모델에서 범주형 특성을 인코딩하는 데도 사용할 수 있습니다. 직함처럼 범주 이름에 의미가 있고 종류가 많을 때 특히 유용합니다. 이 작업에서는 일반적으로 유사도용 임베딩이 검색용 임베딩보다 성능이 좋습니다.
실험 결과, 임베딩 벡터에는 일반적으로 풍부한 정보가 밀도 높게 담겨 있었습니다. 예를 들어 SVD나 PCA로 입력 차원 수를 10%만 줄여도 특정 후속 작업의 성능이 대체로 떨어졌습니다.
다음 코드는 데이터를 학습 세트와 테스트 세트로 나눕니다. 이어지는 두 활용 사례인 회귀와 분류에서 이 데이터를 사용합니다.
1
2
3
4
5from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    list(df.ada_embedding.values), df.Score, test_size=0.2, random_state=42
)
임베딩 특성을 활용한 회귀
임베딩을 활용하면 수치를 간단하게 예측할 수 있습니다. 이 예제에서는 리뷰 본문을 바탕으로 작성자가 매긴 별점을 예측합니다. 임베딩에는 의미 정보가 풍부하게 담겨 있어 리뷰 수가 매우 적어도 비교적 정확하게 예측할 수 있습니다.
별점을 1과 5 사이의 연속 변수로 간주하고 알고리즘이 이 범위의 모든 부동 소수점 값을 예측할 수 있도록 합니다. 머신러닝 알고리즘은 예측값과 실제 별점 간의 차이를 최소화합니다. 이 예제에서 평균 절대 오차는 0.39로, 예측값은 실제 별점과 평균적으로 별 반 개 미만의 차이를 보입니다.
1
2
3
4
5from sklearn.ensemble import RandomForestRegressor

rfr = RandomForestRegressor(n_estimators=100)
rfr.fit(X_train, y_train)
preds = rfr.predict(X_test)이번에는 알고리즘이 1과 5 사이의 임의의 값을 예측하는 대신, 각 리뷰를 별 1개부터 5개까지 다섯 범주 중 하나로 분류해 정확한 별점을 맞히도록 합니다.
학습을 마친 모델은 미묘한 감정 차이가 있는 별 2~4개 리뷰보다 별 1개와 5개 리뷰의 별점을 훨씬 잘 예측합니다. 별점이 양극단에 있는 리뷰에서는 감정 표현이 더 뚜렷하기 때문으로 보입니다.
1
2
3
4
5
6from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

clf = RandomForestClassifier(n_estimators=100)
clf.fit(X_train, y_train)
preds = clf.predict(X_test)임베딩을 사용하면 레이블이 지정된 학습 데이터 없이도 제로샷 분류를 할 수 있습니다. 먼저 각 클래스의 이름이나 짧은 설명을 임베딩합니다. 새 텍스트를 제로샷 방식으로 분류할 때는 해당 텍스트의 임베딩을 모든 클래스 임베딩과 비교해 유사도가 가장 높은 클래스를 선택합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";

const client = new OpenAI();
const labels = ["negative", "positive"];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...labels, "The coffee arrived quickly and tastes great."],
});

const review = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * review[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...review));
};

const [negative, positive] = data.map(({ embedding }) => similarity(embedding));
console.log(positive > negative ? "positive" : "negative");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18df = df[df.Score != 3]
df["sentiment"] = df.Score.replace(
{1: "negative", 2: "negative", 4: "positive", 5: "positive"}
)
labels = ["negative", "positive"]
label_embeddings = [get_embedding(label, model=model) for label in labels]
def label_score(review_embedding, label_embeddings):
return cosine_similarity(review_embedding, label_embeddings[1]) - cosine_similarity(
review_embedding, label_embeddings[0]
)
prediction = (
"positive" if label_score(get_embedding("Sample Review", model=model), label_embeddings) > 0 else "negative"
)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59import (
"context"
"fmt"
"log"
"math"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
negative, err := embedding(ctx, &client, "negative")
if err != nil {
return err
}
positive, err := embedding(ctx, &client, "positive")
if err != nil {
return err
}
review, err := embedding(ctx, &client, "Sample Review")
if err != nil {
return err
}
score := cosineSimilarity(review, positive) - cosineSimilarity(review, negative)
prediction := "negative"
if score > 0 {
prediction = "positive"
}
fmt.Println(prediction)
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("negative", "positive", "Sample Review"))
.build())
.data();
List<Float> review = embeddings.get(2).embedding();
double negative = cosineSimilarity(review, embeddings.get(0).embedding());
double positive = cosineSimilarity(review, embeddings.get(1).embedding());
System.out.println(positive > negative ? "positive" : "negative");1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
float[] negative = await EmbedAsync(client, "negative");
float[] positive = await EmbedAsync(client, "positive");
float[] review = await EmbedAsync(client, "Sample Review");
double score = CosineSimilarity(review, positive) - CosineSimilarity(review, negative);
Console.WriteLine(score > 0 ? "positive" : "negative");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"
client = OpenAI::Client.new
labels = ["negative", "positive"]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: labels + ["The coffee arrived quickly and tastes great."]
)
review = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(review).sum { |value, review_value| value * review_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
review_magnitude = Math.sqrt(review.sum { |value| value**2 })
dot_product / (magnitude * review_magnitude)
end
negative, positive = response.data.first(2).map do |embedding|
similarity.call(embedding.embedding)
end
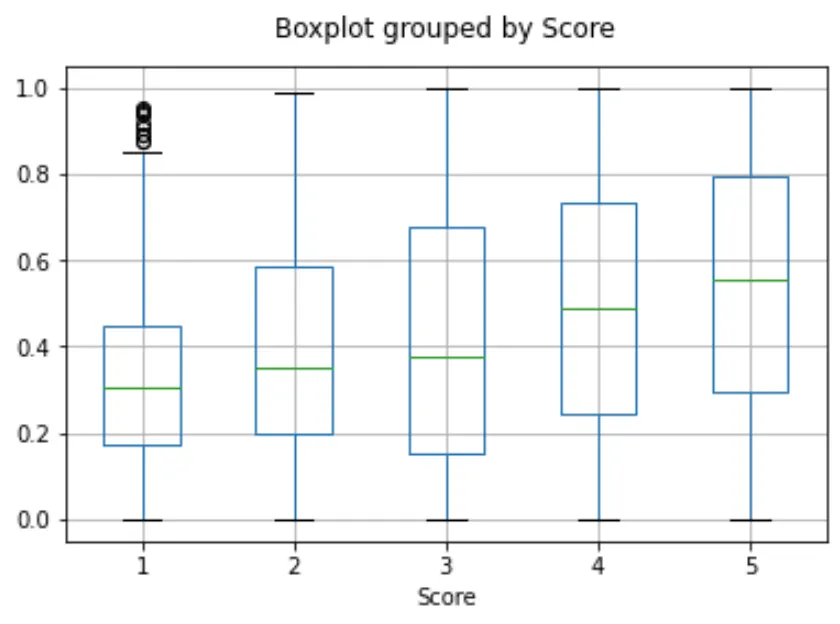
puts((positive > negative) ? "positive" : "negative")사용자가 작성한 모든 리뷰의 임베딩을 평균하면 사용자 임베딩을 얻을 수 있습니다. 마찬가지로 제품에 달린 모든 리뷰의 임베딩을 평균하면 제품 임베딩을 얻을 수 있습니다. 이 방법의 효과를 보여 주기 위해 전체 데이터셋에서 리뷰 5만 개를 추출해 사용자별, 제품별로 더 많은 리뷰를 포함했습니다.
별도의 테스트 세트에서 별점에 따른 사용자 임베딩과 제품 임베딩 간의 유사도를 그래프로 나타내 이 임베딩의 유용성을 평가합니다. 이 방법을 사용하면 사용자가 제품을 받기 전에도 제품을 좋아할지 무작위 추측보다 정확하게 예측할 수 있습니다.
user_embeddings = df.groupby("UserId").ada_embedding.apply(np.mean)
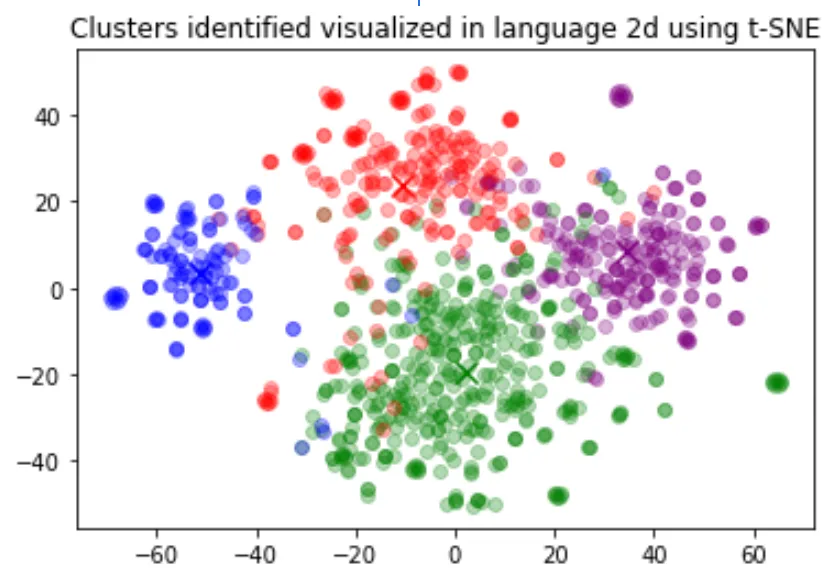
prod_embeddings = df.groupby("ProductId").ada_embedding.apply(np.mean)군집화는 대량의 텍스트 데이터를 파악하는 방법 중 하나입니다. 임베딩은 각 텍스트의 의미를 벡터로 표현하므로 이 작업에 유용합니다. 임베딩을 군집화하면 비지도 학습 방식으로 데이터셋에 숨어 있는 그룹을 찾아낼 수 있습니다.
이 예제에서는 뚜렷한 군집 네 개가 나타납니다. 하나는 주로 반려견 사료에 관한 리뷰, 하나는 부정적인 리뷰, 나머지 두 개는 긍정적인 리뷰로 이루어져 있습니다.
1
2
3
4
5
6
7
8
9import numpy as np
from sklearn.cluster import KMeans

matrix = np.vstack(df.ada_embedding.values)
n_clusters = 4

kmeans = KMeans(n_clusters=n_clusters, init="k-means++", random_state=42)
kmeans.fit(matrix)
df["Cluster"] = kmeans.labels_
자주 묻는 질문
임베딩을 생성하기 전에 문자열의 토큰 수를 어떻게 확인하나요?
Python에서는 OpenAI의 토크나이저 tiktoken으로 문자열을 토큰으로 나눌 수 있습니다.
예제 코드는 다음과 같습니다.
1
2
3
4
5
6
7
8
9
10
11import tiktoken


def num_tokens_from_string(string: str, encoding_name: str) -> int:
    """Returns the number of tokens in a text string."""
    encoding = tiktoken.get_encoding(encoding_name)
    num_tokens = len(encoding.encode(string))
    return num_tokens


num_tokens_from_string("tiktoken is great!", "cl100k_base")text-embedding-3-small과 같은 3세대 임베딩 모델에는 cl100k_base 인코딩을 사용하세요.
자세한 내용과 예제 코드는 OpenAI Cookbook의 tiktoken으로 토큰 수 계산하기를 참고하세요.
가장 가까운 임베딩 벡터 K개를 빠르게 찾으려면 어떻게 해야 하나요?
많은 벡터를 빠르게 검색하려면 벡터 데이터베이스 사용을 권장합니다. 벡터 데이터베이스와 OpenAI API를 함께 사용하는 예제는 GitHub의 OpenAI Cookbook에서 확인할 수 있습니다.
어떤 거리 함수를 사용해야 하나요?
코사인 유사도를 권장합니다. 일반적으로 어떤 거리 함수를 선택하느냐에 따른 차이는 크지 않습니다.
OpenAI 임베딩은 벡터의 길이가 1이 되도록 정규화되어 있어 다음과 같은 특성이 있습니다.
- 내적만으로 코사인 유사도를 구할 수 있어 계산이 조금 더 빠릅니다.
- 코사인 유사도로 순위를 매기든 유클리드 거리로 순위를 매기든 결과는 같습니다.
임베딩을 온라인에서 공유해도 되나요?
네. 고객은 OpenAI 모델에 제공한 입력과 모델에서 얻은 출력을 소유하며, 이는 임베딩에도 적용됩니다. OpenAI API에 입력하는 콘텐츠가 관련 법률이나 OpenAI 이용약관을 위반하지 않도록 할 책임은 고객에게 있습니다.
3세대 임베딩 모델은 최근 사건에 대해 알고 있나요?
아니요. text-embedding-3-large와 text-embedding-3-small 모델은 2021년 9월 이후에 발생한 사건에 대한 지식이 없습니다. 일반적으로 텍스트 생성 모델에서만큼 큰 제약은 아니지만, 일부 예외적인 상황에서는 성능이 떨어질 수 있습니다.