추론 모델은 응답을 생성하기 전에 내부적으로 추론 토큰을 사용합니다. 이를 통해 계획을 세우고, 도구를 효과적으로 사용하고, 여러 대안을 검토하고, 모호한 부분을 해소하면서 여러 단계가 필요한 어려운 작업을 해결할 수 있습니다. 추론 모델은 복잡한 문제 해결, 코딩, 과학적 추론, 여러 단계로 이루어진 에이전트 기반 워크플로우에 특히 적합합니다. OpenAI의 경량 코딩 에이전트인 Codex CLI에도 가장 적합한 모델입니다.
대부분의 추론 작업에는 gpt-6-astra부터 사용하세요. 비용을 줄이려면 gpt-5.6-terra를, 비용과 지연 시간을 모두 최소화하려면 gpt-5.6-luna를 고려하세요. GPT-5.6 또는 GPT-6 모델을 사용한다면 추론 모드에서 pro 옵션을 확인하세요.
추론 모델은 Responses API에서 더 잘 작동합니다. Chat Completions API도 계속 지원하지만 Responses를 사용하면 모델의 문제 해결 능력과 성능이 향상됩니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
추론 강도
reasoning.effort 매개변수는 작업을 수행할 때 모델이 얼마나 깊이 추론할지 조절합니다.
지원하는 값은 모델마다 다르며 none, minimal, low, medium, high, xhigh, max 등이 있습니다. 추론 강도를 낮추면 응답이 빨라지고 토큰 사용량이 줄어듭니다. 강도를 높이면 모델이 더 깊이 추론해 응답 품질이 높아집니다. 각 강도에서도 모델은 작업에 맞춰 추론량을 조절하므로 간단한 작업에는 토큰을 적게 사용하고 복잡한 작업은 더 깊이 추론합니다.
GPT-6 Astra는 추론 강도 none을 지원하지 않습니다. reasoning.effort(Responses) 또는 reasoning_effort(Chat Completions)를 none으로 설정하면 HTTP 400이 반환됩니다. GPT-6.1 Sol은 none과 minimal을 지원하지 않으며 기본값은 medium입니다.
함수 호출에는 Responses API를 사용하세요. Chat Completions에서는 GPT-6 Astra와 GPT-6.1 Sol의 함수 호출을 지원하지 않습니다.
기본값도 모델마다 다릅니다. gpt-5.5의 기본 추론 강도는 medium입니다. gpt-5.5에서 품질, 신뢰성, 성능을 균형 있게 확보하려면 이 설정으로 시작하는 것이 가장 좋습니다.
추론 강도
적합한 작업
none
지연 시간을 최소화해야 하고 추론이나 연속적인 도구 호출이 도움이 되지 않는 작업에 적합합니다. 지연 시간에 민감한 용도로 gpt-5.5를 사용한다면 먼저 low를 시도한 뒤 필요할 때 none으로 전환하는 것이 좋습니다.
대표적인 예로 음성 처리, 빠른 정보 검색, 분류가 있습니다.
low
지연 시간이 조금 늘어나는 대신 효율적으로 추론할 수 있습니다. 도구 사용, 계획 수립, 검색, 여러 단계의 의사 결정이 필요하면서 속도와 비용을 최적화해야 하는 작업에 적합합니다.
대표적인 예로 데이터 분석, 초안 작성, 구현 중심의 코딩, 고객 지원 및 채팅 어시스턴트 워크플로우가 있습니다.
medium
품질과 신뢰성이 중요하고 계획 수립, 복잡한 추론, 판단이 필요한 작업에 적합합니다. 대부분의 워크로드에 사용하는 기본 설정으로, 지연 시간, 성능, 비용의 파레토 곡선에서 균형이 잘 잡힌 지점에 해당합니다.
대표적인 예로 에이전트 기반 코딩, 리서치, 스프레드시트 및 슬라이드 작업, 장기 작업 위임이 있습니다.
high
어려운 추론, 복잡한 디버깅, 심층적인 계획 수립, 지연 시간보다 결과의 품질과 모델의 문제 해결 능력이 중요한 고부가가치 작업에 적합합니다. 복잡한 워크플로우와 에이전트 기반 작업에 권장합니다.
대표적인 예로 에이전트 기반 코딩, 장기 리서치, 지식 업무가 있습니다. 작업의 복잡도에 따라 medium과 high를 모두 평가하세요.
xhigh
심층 리서치, 비동기 워크플로우, 장시간 실행해야 하는 에이전트 기반 작업에 적합합니다. 평가 결과에서 추가 지연 시간과 비용을 감수할 만큼 이점이 분명할 때만 사용하세요.
대표적인 예로 보안 검토와 코드 리뷰, 기업 생산성 향상을 위한 작업, 심층적인 조사, 난도가 높은 코딩 워크플로우가 있습니다.
max
가장 복잡한 작업에 최대 추론 강도를 적용합니다. 현재 xhigh를 사용하고 있다면 max에서 성능이 더 좋아지는지 평가하세요.
지연 시간에 민감한 애플리케이션에서 사용자에게 첫 토큰을 더 빨리 표시하려면, 모델에 먼저 짧은 안내 문구를 생성한 뒤 더 깊이 추론하도록 요청하세요.
일부 모델은 위 값 중 일부만 지원하므로 설정을 선택하기 전에 해당 모델 페이지를 확인하세요.
추론 모드
GPT-5.6 및 GPT-6 모델은 Responses API에서 standard와 pro 추론 모드를 지원합니다. 기본값은 standard입니다. 모델의 연산이 더 많이 필요한 어려운 작업에서 지연 시간과 토큰 사용량 증가를 감수할 수 있다면 reasoning.mode를 pro로 설정하세요.
추론 모드와 추론 강도는 서로 독립적입니다. 모드는 표준 또는 Pro 실행 방식을 선택하고, reasoning.effort는 해당 모드에서 모델이 얼마나 깊이 추론할지 조절합니다. reasoning.effort를 생략하면 GPT-5.6은 두 모드 모두에서 medium을 기본값으로 사용합니다. GPT-6.1 Sol, GPT-6 Sol, GPT-6 Luna의 기본 추론 강도도 medium입니다.
Pro 모드에서는 모델이 최종 답변을 생성하는 데 사용한 토큰을 모두 합산해 선택한 모델의 표준 토큰 요금을 적용합니다. Pro 모드는 표준 모드보다 더 많은 연산을 수행하므로 토큰 사용량과 비용이 증가합니다. 기존 Pro 모델 ID에는 현재 동작 방식과 요금이 그대로 적용됩니다.
추론의 작동 원리
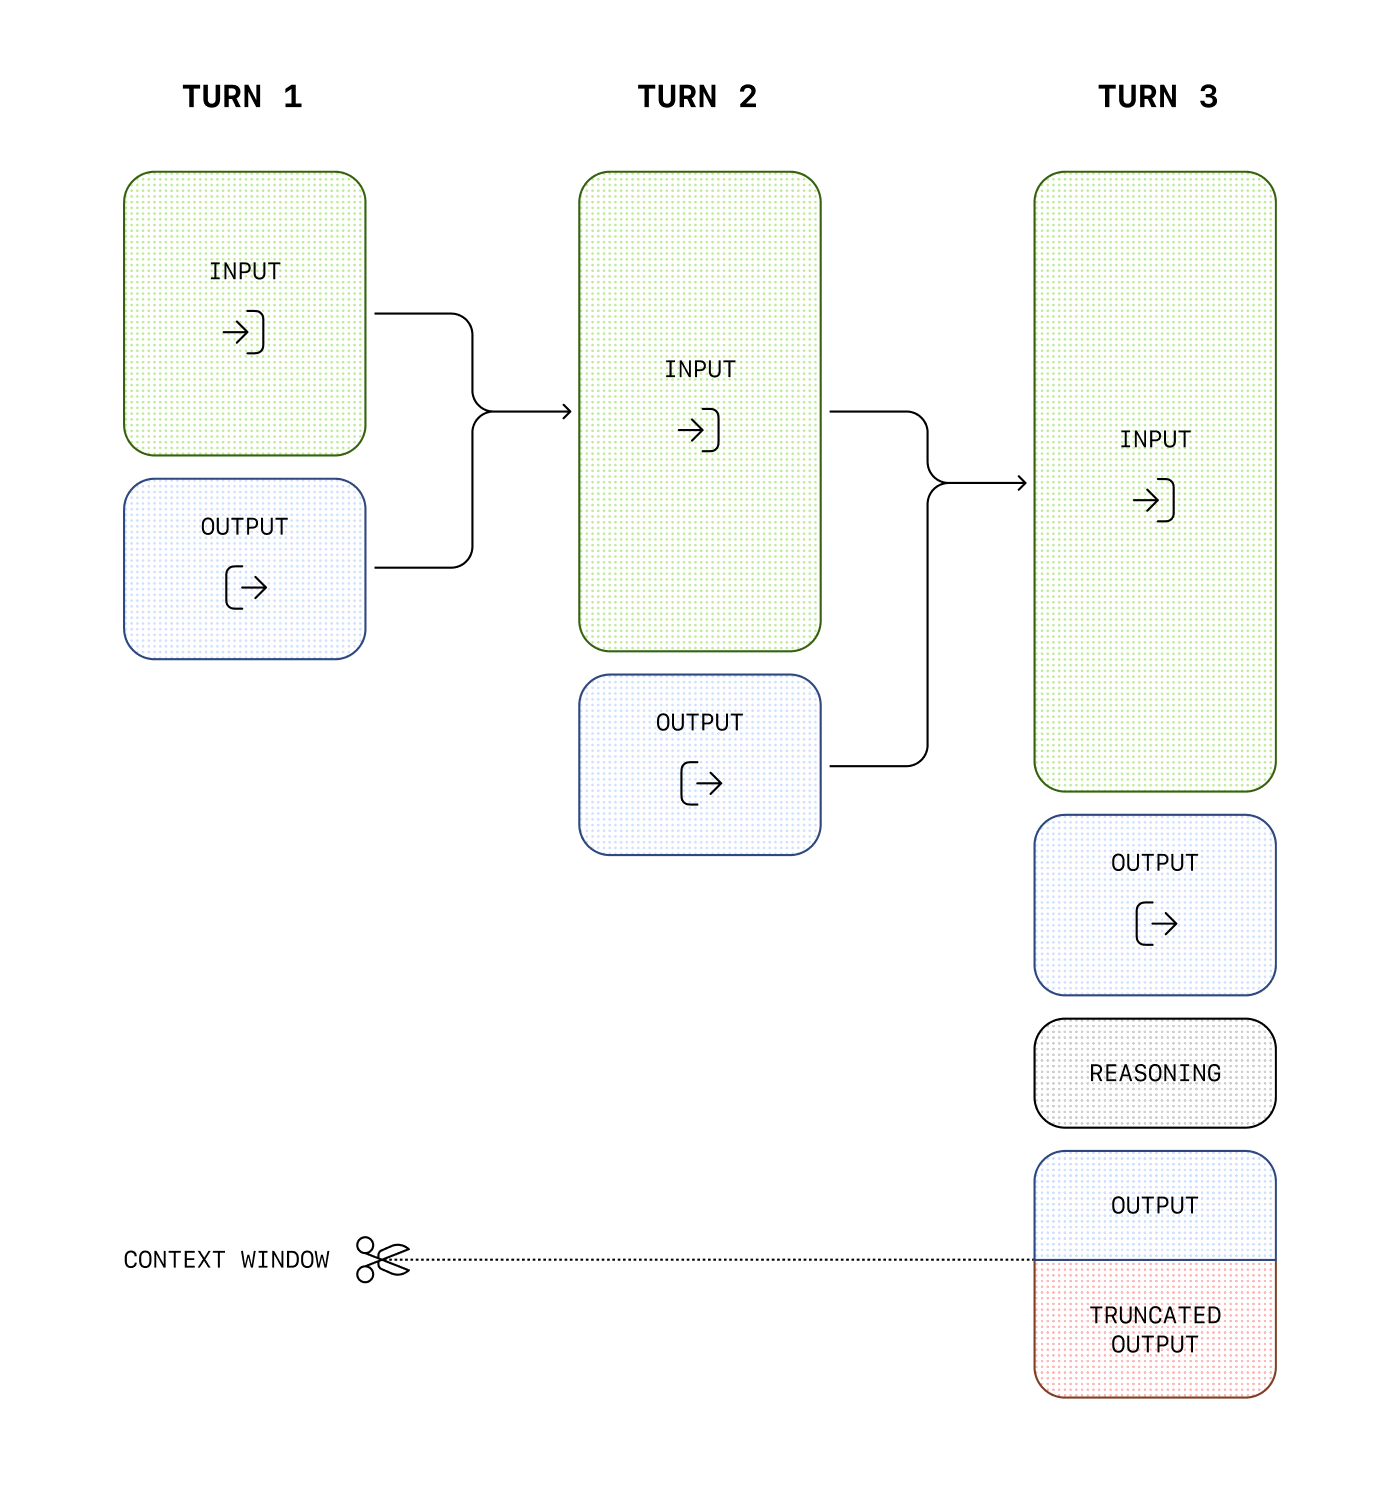
추론 모델은 입력 및 출력 토큰 외에 추론 토큰을 사용합니다. 모델은 이 토큰을 사용해 ‘생각’합니다. 즉, 프롬프트를 여러 부분으로 나누어 분석하고 응답을 생성할 여러 방법을 검토합니다. gpt-5.5와 gpt-5.4 같은 OpenAI 추론 모델은 추론과 출력을 번갈아 수행할 수 있습니다. 추론을 시작하기 전이나 추론 단계 사이에 사용자에게 보이는 출력 토큰을 생성할 수 있고, 도구 호출 사이에도 추론할 수 있습니다.
GPT-5.6 이전에 출시된 모델은 여러 단계로 이루어진 대화에서 기본적으로 각 단계의 입력 및 출력 토큰을 이어받지만, 다음 응답을 생성할 때 이전 턴의 추론은 컨텍스트에 포함하지 않습니다. GPT-5.6 모델은 기본적으로 이전 턴의 추론 중 사용 가능한 내용을 컨텍스트에 포함합니다. 이 설정을 지원하는 모델에서는 reasoning.context로 두 동작 중 하나를 선택할 수 있습니다.
API에서 추론 토큰의 내용은 볼 수 없지만, 추론 토큰도 모델의 컨텍스트 윈도우에서 공간을 차지하며 출력 토큰으로 과금됩니다.
비용 관리
추론 모델의 비용을 관리하려면 max_output_tokens 매개변수로 모델이 생성하는 전체 토큰 수를 제한하세요. 여기에는 추론 토큰, 사용자에게 보이는 출력 토큰, 사용자에게 보이지 않는 서식 토큰이 포함됩니다. 생성된 토큰이 사용량과 출력 한도에 어떻게 반영되는지는 출력 토큰 수를 참고하세요.
컨텍스트 윈도우 관리
응답을 생성할 때는 컨텍스트 윈도우에 추론 토큰을 위한 공간을 충분히 확보해야 합니다. 문제의 복잡도에 따라 모델이 생성하는 추론 토큰은 수백 개에서 수만 개에 이를 수 있습니다. 실제로 사용된 추론 토큰 수는 응답 객체의 usage 객체에 있는 output_tokens_details에서 확인할 수 있습니다.
컨텍스트 윈도우의 길이는 모델 레퍼런스 페이지에서 확인할 수 있으며 모델 스냅샷마다 다릅니다.
추론에 필요한 공간 확보
생성된 토큰 수가 컨텍스트 윈도우 한도나 설정한 max_output_tokens 값에 도달하면 응답의 status가 incomplete가 되고, incomplete_details의 reason이 max_output_tokens로 설정됩니다. 사용자에게 보이는 출력 토큰이 하나도 생성되기 전에 한도에 도달할 수 있습니다. 이 경우 표시할 응답이 없어도 입력 토큰과 추론 토큰에 대한 비용이 발생할 수 있습니다.
이를 방지하려면 컨텍스트 윈도우에 충분한 공간을 확보하거나 max_output_tokens 값을 높이세요. OpenAI는 이러한 모델을 처음 시험할 때 추론과 출력에 사용할 토큰을 최소 25,000개 확보할 것을 권장합니다. 프롬프트에 필요한 추론 토큰 수를 파악한 뒤에는 그에 맞춰 여유 공간을 조정할 수 있습니다.
불완전한 응답 처리하기
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
호출 간 추론 상태 유지
대화 상태와 추론 상태는 용도가 다릅니다. 호출 간에 메시지를 전달하면 모델이 사용자에게 보이는 대화 기록을 이용할 수 있습니다. 추론 상태 유지를 지원하는 모델은 이전 턴에서 유지된 추론 항목 중 호환되는 항목도 다음 컨텍스트에 포함할 수 있습니다.
추론 상태를 유지하면 모델이 추론을 이어갈 수 있습니다. 추론 항목의 내부 내용은 공개되지 않으며 API도 추론 원문을 반환하지 않습니다. 사용 가능한 추론 항목 중 모델이 어떤 항목을 이용할지는 reasoning.context로 지정하세요.
GPT-5.6 모델 제품군은 all_turns를 지원하며 기본값으로 사용합니다. 이전 모델의 기본값은 current_turn입니다. GPT-6.1 Sol도 all_turns를 지원합니다. 선택한 모델의 기본값을 사용하려면 reasoning.context를 생략하거나 auto로 설정하세요.
값
동작
auto
선택한 모델의 기본값을 사용합니다. reasoning.context를 생략해도 auto와 동일하게 동작합니다.
current_turn
현재 턴의 추론을 사용할 수 있습니다. 다음 응답을 생성할 때 이전 턴의 추론은 컨텍스트에 포함하지 않습니다.
all_turns
다음 응답을 생성할 때 이전 턴에서 사용 가능한 추론 항목 중 호환되는 항목을 컨텍스트에 포함합니다. GPT-5.6 모델과 GPT-6.1 Sol이 이 값을 지원합니다.
응답의 reasoning.context 필드에는 실제 적용된 모드인 current_turn 또는 all_turns가 표시됩니다. 모델이 어떤 모드를 사용했는지 확인하려면 각 응답에서 이 필드를 확인하세요. 이 설정으로 기존에 없던 추론 항목이 새로 생성되지는 않습니다.
all_turns는 요청에서 이전 응답 항목에 접근할 수 있을 때만 효과가 있습니다. previous_response_id를 사용하거나, 응답을 대화에 연결하거나, 전체 응답 기록을 직접 다시 전달하세요. 첫 요청에는 이전 추론이 없으므로 current_turn과 all_turns가 동일하게 동작합니다.
유지된 추론은 같은 모델 제품군 안에서만 재사용할 수 있습니다. 예를 들어 gpt-5.6-sol, gpt-5.6-terra, gpt-5.6-luna는 서로의 추론을 재사용할 수 있지만 GPT-5.6과 GPT-5.5 제품군 사이에서는 추론이 이어지지 않습니다.
모델 제품군을 변경하면 reasoning.context가 all_turns여도 API는 모델의 컨텍스트에서 호환되지 않는 추론을 제외합니다.
저장된 응답으로 추론 이어가기
상태를 유지하는 가장 간단한 방법은 previous_response_id를 사용하는 것입니다.
이전 응답으로 추론 상태 유지하기
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";const client = new OpenAI();const first = await client.responses.create({ model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: "current_turn" },});const second = await client.responses.create({ model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"first = client.responses.create(model=model,input="Inspect this repository and identify the likely bug.",reasoning={"context": "current_turn"},)second = client.responses.create(model=model,previous_response_id=first.id,input="Now patch the bug and explain the change.",reasoning={"context": "all_turns"},)print(second.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
모델에 더 이상 필요하지 않은 이전 응답 항목을 다시 전달할 때는 current_turn을 사용하세요. 추론의 연속성을 위해 해당 추론 항목을 API 페이로드에 남겨 둘 수 있지만, 서비스는 새 응답을 생성할 때 이 항목을 컨텍스트에 포함하지 않습니다. 이렇게 하면 장시간 실행되는 워크플로우에서 모델에 전달되는 컨텍스트를 줄일 수 있습니다.
응답을 저장하지 않고 추론 상태 유지하기
무상태 모드에서 응답을 생성하면 응답의 output 배열에 있는 추론 항목에 기본적으로 encrypted_content 속성이 포함됩니다. 무상태 모드는 store가 false이거나 조직에서 데이터 비보관(ZDR)을 사용할 때 적용됩니다. API는 호환성을 위해 기존 방식대로 reasoning.encrypted_content 값을 include에 지정하는 것도 허용하지만, 반드시 지정할 필요는 없습니다.
다음 요청은 include를 지정하지 않아도 암호화된 추론 내용을 반환합니다.
1
2
3
4
5
6
7
8
9
10curlhttps://api.openai.com/v1/responses\-H"Content-Type: application/json"\-H"Authorization: Bearer $OPENAI_API_KEY"\-d'{ "model": "gpt-6-astra", "store": false, "reasoning": {"effort": "medium"}, "input": "What is the weather like today?", "tools": [ ... function config here ... ] }'
output 배열의 추론 항목에는 암호화된 추론 토큰을 담은 encrypted_content 속성이 포함됩니다. 이 토큰을 이후 호출에 전달할 수 있습니다.
all_turns를 store: false와 함께 사용하려면 모든 출력 항목을 유지하고 다음 사용자 메시지를 추가한 뒤 전체 기록을 다시 전달하세요.
응답을 저장하지 않고 추론 상태 유지하기
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const client = new OpenAI();const history = [ { role: "user", content: "Inspect this repository and identify the likely bug.", },];const first = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "current_turn" },});// Keep replayable output, including encrypted reasoning and assistant phase.history.push(...toResponseInputItems(first.output));history.push({ role: "user", content: "Now patch the bug and explain the change.",});const second = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"history = [ {"role": "user","content": "Inspect this repository and identify the likely bug.", }]first = client.responses.create(model=model,store=False,input=history,reasoning={"context": "current_turn"},)# Keep every output item, including encrypted reasoning and assistant phase.history.extend(item.to_dict() for item in first.output)history.append( {"role": "user","content": "Now patch the bug and explain the change.", })second = client.responses.create(model=model,store=False,input=history,reasoning={"context": "all_turns"},)print(second.output_text)
추론 모델로 함수 호출을 수행할 때 Responses API를 사용한다면, 함수 호출과 함께 반환된 추론 항목을 도구 출력과 함께 다시 전달하세요. 그러면 모델이 도구 호출 후에도 추론을 이어갈 수 있습니다.
previous_response_id를 사용하면 추론 항목을 다음 요청으로 이어갈 수 있습니다. 대화 기록을 직접 관리한다면 원래 입력과 각 응답의 모든 출력 항목을 다음 요청의 입력에 포함하세요. 기존 항목의 순서를 유지하고 새 항목은 맨 뒤에 추가하세요.
최신 프런티어 모델을 사용할 때 추론 항목보다 앞선 대화 기록을 변경하면 API가 해당 추론을 컨텍스트에서 제외할 수 있습니다. 지침과 도구 출력을 변경하는 방법 및 긴 대화를 관리하는 방법은 접두부를 그대로 유지하기를 참고하세요.
대화 도중 추론 강도 변경하기
configuration_update를 사용하면 어려운 작업에는 추론 강도를 높이고 일상적인 후속 요청에는 강도를 낮출 수 있습니다. 요청 수준의 reasoning.effort는 그대로 두고 응답 사이에 업데이트를 추가하세요. 이렇게 하면 프롬프트 캐싱에 사용하는 원래 프롬프트 접두부가 유지됩니다.
GPT-6 이상 모델 중 이 기능을 지원하는 모델에서는 표준 모드에서 단일 에이전트를 사용할 때 추론 강도와 응답 형식을 변경할 수 있습니다.
요청의 input 배열에서 다음 사용자 메시지 앞에 아래 항목을 추가하세요. HTTP에서는 Responses 요청에, WebSocket에서는 response.create 요청에 추가하면 됩니다.
previous_response_id로 업데이트를 유지하거나, 대화 기록을 직접 관리할 때는 업데이트를 원래 위치에 넣어 다시 전달하세요. 응답의 reasoning.effort에는 업데이트로 선택한 강도와 관계없이 요청 수준의 설정값이 계속 표시됩니다.
reasoning.effort와 text.format을 같은 configuration_update 항목에서 함께 설정할 수 있습니다. 둘 중 하나만 변경하면 다른 설정은 기존 값을 유지합니다.
설정 업데이트를 자동 컨텍스트 압축이나 자동 잘림과 함께 사용하지 마세요. 독립 실행형 /responses/compact 엔드포인트도 이러한 업데이트가 포함된 기록을 거부합니다.
기록을 직접 압축하려면 compaction_trigger 항목을 /responses 요청에 포함하세요. 컨텍스트 압축 후에는 다음 사용자 메시지 앞에 새 configuration_update를 추가하고, 앞서 변경한 설정값을 모두 다시 지정하세요. 응답 형식을 변경했다면 그 값도 다시 지정하세요.
프롬프트 캐싱에는 기존 요구 사항이 그대로 적용됩니다. 응답을 생성하는 도중에 사용자 지침을 보내려면 턴 도중 지시하기를 참고하세요.
추론 요약
모델이 생성한 추론 토큰의 원문은 공개되지 않지만 summary 매개변수를 사용하면 모델의 추론을 요약한 내용을 볼 수 있습니다. 요약을 지원하는 추론 모델은 모델 문서에서 확인하세요.
지원하는 추론 요약 설정은 모델마다 다릅니다. 예를 들어 컴퓨터 사용 모델은 concise 요약을 지원하고 o4-mini는 detailed 요약을 지원합니다. 모델이 제공하는 가장 상세한 요약을 받으려면 이 매개변수를 auto로 설정하세요. 현재 대부분의 추론 모델에서 auto는 detailed와 동일하지만, 앞으로 더 세분화된 설정이 추가될 수 있습니다.
추론 요약은 summary 배열에 들어갑니다. 이 배열은 reasoning 유형의 출력 항목에 속합니다. 추론 요약을 명시적으로 요청해야 출력에 포함됩니다.
다음 예시는 추론 요약을 포함하는 API 요청을 보내는 방법을 보여 줍니다.
API 응답에 추론 요약 포함하기
Python
1
2
3
4
5
6
7
8
9
10
11
12
13import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "What is the capital of France?", reasoning: { effort: "low", summary: "auto", },});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="What is the capital of France?",reasoning={"effort": "low", "summary": "auto"},)print(response.output)
이 API 요청이 반환하는 출력 배열에는 어시스턴트 메시지와 모델이 해당 응답을 생성할 때 수행한 추론의 요약이 모두 포함됩니다.
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
최신 추론 모델에서 요약 기능을 사용하려면 안전한 배포를 위해 먼저 조직 인증을 완료해야 할 수 있습니다. 플랫폼 설정 페이지에서 인증을 시작하세요.
phase 매개변수
Responses API에서 GPT-5.5 또는 GPT-5.4로 장시간 실행되거나 도구 호출이 많은 플로우를 구성할 때는 어시스턴트 메시지의 phase 필드를 사용해 조기 종료 등의 오동작을 방지하세요.
phase는 API에서 선택 사항이지만 OpenAI는 사용을 권장합니다. 도구 호출 전 안내 문구와 같은 어시스턴트의 중간 업데이트에는 phase: "commentary"를, 완성된 답변에는 phase: "final_answer"를 사용하세요. 사용자 메시지에는 phase를 추가하지 마세요.
previous_response_id를 사용하면 이전 어시스턴트 상태가 유지되므로 대개 이 방법이 가장 간단합니다. 어시스턴트 메시지 기록을 직접 다시 전달할 때는 각 메시지의 원래 phase 값을 유지하세요.
phase가 없거나 전달 과정에서 누락되면 이러한 워크플로우에서 안내 문구를 최종 답변으로 처리할 수 있습니다. 모델별 프롬프트 작성 지침은 GPT-5.5 프롬프트 작성하기를 참고하세요.
어시스턴트 메시지의 단계 값 다시 전달하기
어시스턴트 메시지의 단계 값 다시 전달하기
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: [ { role: "assistant", phase: "commentary", content: "I’ll inspect the logs and then summarize root cause and remediation.", }, { role: "assistant", phase: "final_answer", content: "Root cause: cache invalidation race.", }, { role: "user", content: "Great—now give me a rollout-safe fix plan.", }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input=[ {"role": "assistant","phase": "commentary","content": "I’ll inspect the logs and then summarize root cause and remediation.", }, {"role": "assistant","phase": "final_answer","content": "Root cause: cache invalidation race.", }, {"role": "user","content": "Great—now give me a rollout-safe fix plan.", }, ],)print(response.output_text)
추론 모델은 복잡한 알고리즘을 구현하고 코드를 생성할 수 있습니다. 다음 프롬프트는 모델에 구체적인 기준에 맞춰 React 컴포넌트를 리팩터링해 달라고 요청합니다.
코드 리팩터링
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
코드 리팩터링
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
코딩(계획 수립)
추론 모델은 여러 단계로 이루어진 계획도 세울 수 있습니다. 다음 예시 프롬프트는 모델에 프로젝트 전체의 파일과 디렉터리 구조를 만들고 원하는 사용 사례를 구현하는 Python 코드를 작성해 달라고 요청합니다.
Python 프로젝트 계획하고 만들기
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Python 프로젝트 계획하고 만들기
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
STEM 리서치
OpenAI의 o 시리즈 모델은 STEM 분야 연구에서 뛰어난 성능을 보여 왔습니다. 프롬프트로 기초 연구에 필요한 작업을 도와달라고 요청하면 좋은 결과를 기대할 수 있습니다.
기초 과학 연구에 관해 질문하기
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
기초 과학 연구에 관해 질문하기
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)