사용하는 API를 선택해 사용량 측정 방식과 음성 애플리케이션의 비용 관리 방법을 확인하세요.
GPT-Live 사용량과 비용
GPT-Live에서는 음성 대화와 추론 및 도구 실행을 담당하는 백엔드가 분리되어 있습니다. 음성 세션 비용은 세션 지속 시간에 따라 달라지고, 백엔드 비용은 사용하는 모델과 도구에 따라 달라지므로 각각 산정하세요.
음성 세션 비용
GPT-Live 음성 세션에는 현재 모델 요금이 초 단위로 적용됩니다. 세션 지속 시간을 분 단위로 올림하지 않습니다.
사용자나 어시스턴트가 말하는 시간은 물론, 양쪽 모두 말하지 않는 시간과 백엔드가 작업하는 시간도 활성 세션 시간에 포함됩니다.
비용을 산정할 때는 세션이 시작된 시점부터 종료된 시점까지의 활성 시간을 계산하세요. 재생한 오디오의 길이만 측정하지 말고 API가 보고한 지속 시간을 사용하세요. 마이크 입력을 음소거해도 세션은 계속 열려 있습니다. 대화가 끝나면 세션을 종료하고 최종 사용량을 수집하세요.
백엔드 모델과 도구 요금은 API 요금에서 확인하세요.
WebRTC 초기화 요금
POST /v1/live/sessions 요청으로 WebRTC 세션을 생성하면 초기화 시 음성 사용 시간 15초분의 요금이 청구됩니다. 세션이 실행되면 이미 청구된 금액만큼 사용 시간 요금에서 차감됩니다. 비용을 산정할 때 세션 지속 시간에 15초를 더하지 마세요.
예를 들어 아래의 90초 세션에는 초기화 시 청구된 15초가 이미 포함되어 있으므로 105초분의 요금이 청구되지 않습니다. 재연결 비용이나 사용자가 말할 준비가 되기 전에 세션을 생성하는 애플리케이션의 비용을 산정할 때는 세션 생성 요금도 고려하세요.
백엔드 비용
음성을 사용하지 않는 애플리케이션에서와 마찬가지로 백엔드 호출에는 음성 세션과 별도로 요금이 부과됩니다. 모델의 입력 및 출력 토큰, 모델이 지원하는 경우 캐시된 입력, 해당하는 이미지 또는 도구 요금을 포함하세요. 애플리케이션이 다른 서비스를 호출한다면 해당 서비스의 비용도 포함하세요.
백엔드 작업은 음성 프런트엔드와 별도로 최적화할 수 있습니다. 일반 비용 최적화 가이드를 참고해 요청 수와 토큰 사용량을 줄이세요. 프롬프트 캐싱을 지원하는 백엔드 모델에서는 재사용할 지침, 도구 정의 등 자주 바뀌지 않는 내용을 프롬프트 앞부분에 배치하세요.
백엔드 구성에 따라 대화 길이도 달라질 수 있습니다. 최적화로 인해 사용자의 대기 시간이 길어지거나 어시스턴트가 작업을 얼마나 안정적으로 완료하는지가 달라진다면 음성 세션과 백엔드 비용을 합산해 비교하세요.
대화 비용 산정
음성 세션 하나로 이루어진 대화의 비용은 다음과 같습니다.
총비용 = (과금 대상 음성 시간(초) ÷ 60 × 분당 음성 요금) + 백엔드 비용
예를 들어 분당 음성 요금을 $0.05로 가정하면 90초 음성 세션의 비용은 $0.075입니다. 백엔드 모델과 도구 비용의 합계가 $0.02라면 대화 비용은 $0.095입니다.
| 항목 | 계산 | 비용 |
|---|---|---|
| 음성 세션 | 90초 ÷ 60 × $0.05 | $0.075 |
| 백엔드 작업 | 모델 및 도구 비용 합계 | $0.02 |
| 대화 총비용 | $0.075 + $0.02 | $0.095 |
위 요금과 백엔드 비용은 예시입니다. 실제로 계산할 때는 현재 음성 요금, 측정한 백엔드 사용량, 해당 모델과 도구의 요금을 사용하세요. 작업이 여러 음성 세션에 걸쳐 진행된다면 각 세션의 지속 시간을 합산하고 세션 사이에 수행한 백엔드 작업도 포함하세요.
최적화 전략
사용자가 작업을 마칠 때까지 불필요한 대화나 대기를 줄이세요. 작업에 필요한 확인 및 점검 절차는 유지하세요.
세션 시작 전에 관련 컨텍스트 제공하기
음성 세션을 시작하기 전에 애플리케이션에 이미 사용 권한이 있는 정보를 수집하세요. 예를 들어 주문 관련 문의를 처리하는 어시스턴트가 주문 번호와 현재 주문 상태를 미리 파악하면 사용자가 같은 정보를 다시 말하거나 추가 조회를 기다릴 필요가 없습니다.
작업에 필요한 컨텍스트만 선별하고 최신 상태로 유지하세요. 음성 모델에는 대화에 필요한 정보를 제공하고 상세 기록과 워크플로우는 백엔드에서 관리하세요. 세션 구성과 위임 및 도구를 참고하세요.
도구 호출 대기 시간 줄이기
대기 시간이 짧아지면 사용자 경험이 개선되고 음성 세션 비용도 줄어들 수 있습니다. 예를 들어 백엔드에서 gpt-5.6-luna를 패스트 모드로 사용하고 서로 독립적인 도구 호출을 병렬로 실행한다고 가정해 보세요. 이 최적화 덕분에 사용자가 작업을 마치고 음성 세션을 1분 일찍 종료하면 음성 요금이 $0.05 절감됩니다. 추가 백엔드 비용이 절감액보다 적으면 총비용도 줄어듭니다.
위임 이벤트가 도착하기 전에 전사된 텍스트의 일부를 바탕으로 필요한 정보를 미리 조회할 수도 있습니다. 백엔드 비용을 측정할 때는 미리 수행했지만 결과를 사용하지 않은 작업도 포함하세요.
모델, 연결, 스트리밍 및 도구를 최적화하는 방법은 백엔드 지연 시간 줄이기를 참고하세요. 음성 에이전트 평가를 통해 사용자에게 유용한 음성 응답이 나오기까지 걸리는 시간과 작업 성공 여부를 확인하세요.
오래 걸리는 작업 중에는 세션 종료하기
음성 프런트엔드와 애플리케이션에서 관리하는 백엔드는 독립적으로 실행할 수 있습니다. 클라이언트 위임을 사용하면 음성 세션이 열려 있든 닫혀 있든 백엔드 워커는 계속 실행될 수 있습니다. 작업 상태와 대화 컨텍스트를 저장한 뒤 음성 세션을 종료하세요.
비활성 시간 제한, 재시작 트리거, 컨텍스트 복원 워크플로우는 유휴 세션 종료 및 재개를 참고하세요.
상시 작동하는 에이전트의 경우 백엔드가 목표 모드에서 코딩하는 등 오래 걸리는 작업을 처리하는 동안에는 음성 세션을 종료하세요. 사용자가 돌아왔을 때 새 음성 세션을 시작할 수 있도록 대화 재개 버튼을 제공하세요. 또는 백엔드의 작업 완료 이벤트를 이용해 새 세션을 시작하고 결과가 준비되었다고 사용자에게 알리세요.
저장해 둔 컨텍스트와 검증된 작업 결과를 input에 넣어 새 세션을 시작하면 대화를 복원할 수 있습니다. 예를 들어 새 WebSocket 연결을 통해 다음 시작 이벤트를 보내세요.
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}session.started 이벤트를 받은 후 오디오 스트리밍을 시작하세요. 지원되는 대화 기록 형식은 이전 대화로 세션 초기화하기를 참고하세요.
이전 세션을 store: true로 저장했다면 해당 세션을 포크할 수도 있습니다. 어떤 방식을 사용하든 검증된 백엔드 작업 상태는 애플리케이션에 보관하세요.
세션을 종료하면 음성 세션의 유휴 시간 1분당 $0.05가 절감됩니다. 절감액과 재연결 비용을 비교하고, 대화가 끊기는 것이 사용자 경험에 미치는 영향도 고려하세요.
적합한 백엔드 모델 선택하기
먼저 작업에 필요한 정확도와 신뢰도를 충족하는 모델을 고르세요. 그런 다음 음성 세션 지속 시간, 모델 사용량, 도구 호출, 재시도를 포함한 대화 총비용을 비교하세요. 모델 선택 가이드에서 이러한 요소를 함께 고려하는 방법을 설명합니다.
더 큰 백엔드 모델이 작업을 더 빨리 완료하고, 그로 인해 절감되는 음성 세션 비용이 추가 토큰 비용보다 크다면 총비용은 낮아질 수 있습니다. 반대로 더 저렴한 모델이라도 작업에 시간이 더 걸리거나 도구를 반복해서 호출하거나 작업에 실패하면 총비용이 높아질 수 있습니다.
성공적으로 완료한 작업 한 건당 비용을 작업 완료율 및 완료 시간과 함께 비교하세요. 저렴한 구성이 단지 완료한 작업이 적다는 이유로 더 유리해 보이지 않도록 실패한 시도와 재시도 비용도 합산하세요. 비교를 계획할 때는 음성 에이전트 평가 Cookbook을 참고하세요.
실제 사용량 모니터링
세션별로 음성 세션 지속 시간과 백엔드 사용량을 구분해 기록하세요. GPT-Live는 누적 음성 사용 시간을 초 단위로 보고합니다.
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}업데이트를 받을 때마다 이전에 기록한 누적 시간을 새 값으로 대체하세요. 각 시점의 누적 시간을 합산하지 마세요. session.close를 보낸 후에도 session.closed가 도착할 때까지 이벤트를 계속 수신하고, 해당 이벤트의 최종 usage.seconds 값을 한 번만 기록하세요. 애플리케이션이 연결을 끊기 전에 최종 사용량을 수집할 수 있도록 정상 종료 절차를 따르세요.
Responses 위임을 사용하는 경우 백엔드 응답의 usage 값은 중첩된 response.completed 이벤트에서 확인하세요. 이 이벤트는 response.event를 통해 전달됩니다. 응답 ID를 기준으로 각 백엔드 응답을 한 번만 집계하고, 해당 모델의 요금을 적용하는 데 필요한 입력 토큰, 출력 토큰, 캐시된 토큰의 세부 사용량을 보관하세요. 애플리케이션이 독립적으로 수행하는 백엔드 작업이 있다면 해당 요청의 사용량도 수집하세요.
대표적인 대화 사례를 대상으로 예상 총비용과 실제 총비용을 비교하세요. 평가 전용 모델 호출은 애플리케이션 사용량과 구분하고, 비용과 작업 성공 여부를 함께 검토하세요.
Realtime API 비용
이 문서에서는 Realtime API의 과금 방식과 비용 최적화 전략을 설명합니다. 음성 에이전트 세션에서는 텍스트, 오디오, 이미지의 입력 및 출력 토큰이 누적됩니다. 스트리밍 번역 및 스트리밍 전사 세션에는 오디오 길이에 따라 요금이 부과됩니다. 요금은 모델마다 다르며 각 모델 페이지에서 확인할 수 있습니다. 예를 들어 gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper, gpt-realtime을 참고하세요.
Realtime API의 대화형 세션은 턴 단위로 진행됩니다. 각 턴에서 사용자가 입력을 추가하면 Response 객체가 생성되고 모델이 출력을 반환합니다. 서버가 관리하는 Conversation 객체에는 다음 턴의 입력을 구성하는 Item 목록이 담깁니다. Response가 반환되면 출력은 자동으로 Conversation에 추가됩니다.
번역 및 전사 세션은 다른 스트리밍 구조를 사용합니다. 클라이언트가 오디오를 계속 스트리밍하면 원본 오디오가 도착하는 대로 번역된 오디오, 전사 텍스트의 증분 업데이트 또는 전사 이벤트를 받습니다. 이러한 세션은 일반적인 Response 수명 주기를 따르지 않으므로 비용을 추산하고 모니터링할 때는 Response별 토큰 사용량 대신 오디오 길이 기준 요금을 사용하세요.
Response별 비용
Realtime API에서는 Response가 생성될 때 비용이 발생하며 입력 및 출력 토큰 수에 따라 요금이 부과됩니다. 입력 전사 비용은 예외이며 아래에서 별도로 설명합니다. 현재 네트워크 대역폭이나 연결에는 요금이 부과되지 않습니다. Response는 수동으로 생성할 수 있으며, 음성 활동 감지(VAD)를 켜면 자동으로도 생성됩니다. VAD는 음성이 없는 오디오 입력을 걸러내므로 클라이언트가 이를 대화 입력에 수동으로 추가하지 않는 한 입력 토큰으로 집계되지 않습니다.
Response를 생성할 때마다 대화 전체가 모델에 전달됩니다. 한 턴의 출력은 서버의 Conversation에 Item으로 추가되어 이후 턴의 입력에 포함됩니다. 따라서 세션 후반의 턴일수록 비용이 커집니다.
텍스트 토큰 비용은 토큰화 도구로 추산할 수 있습니다. 오디오 토큰은 사용자 메시지에서 오디오 100ms당 1개, 어시스턴트 메시지에서 오디오 50ms당 1개로 계산됩니다. 토큰 수에는 메시지 내용 외에 특수 토큰도 포함되므로 실제 집계에는 약간의 차이가 생길 수 있습니다. 예를 들어 내용이 텍스트 토큰 10개인 사용자 메시지가 토큰 12개로 집계될 수 있습니다.
예시
여러 턴에 걸친 Realtime API 세션에서 토큰 비용이 어떻게 발생하는지 간단한 예시로 살펴보겠습니다.
첫 번째 턴에는 토큰 100개 분량의 지침과 오디오 토큰 20개로 구성된 사용자 메시지를 추가해 총 120개의 입력 토큰을 사용합니다. 예를 들어 VAD가 사용자의 발화를 감지해 사용자 메시지를 추가할 수 있습니다. Response를 생성하면 오디오 토큰 20개와 텍스트 토큰 10개로 구성된 어시스턴트 출력 메시지가 생성됩니다.
이어서 사용자 오디오 메시지를 하나 더 추가해 두 번째 턴을 시작합니다. 두 번째 턴에서는 토큰이 어떻게 집계될까요? 이 시점의 Conversation에는 초기 지침, 첫 번째 사용자 메시지, 첫 번째 턴의 어시스턴트 출력 메시지, 두 번째 사용자 메시지(오디오 토큰 25개)가 포함됩니다. 이 턴에서는 입력으로 텍스트 토큰 110개와 오디오 토큰 64개를 사용하며, 새로 생성되는 어시스턴트 메시지의 출력 토큰이 추가됩니다.
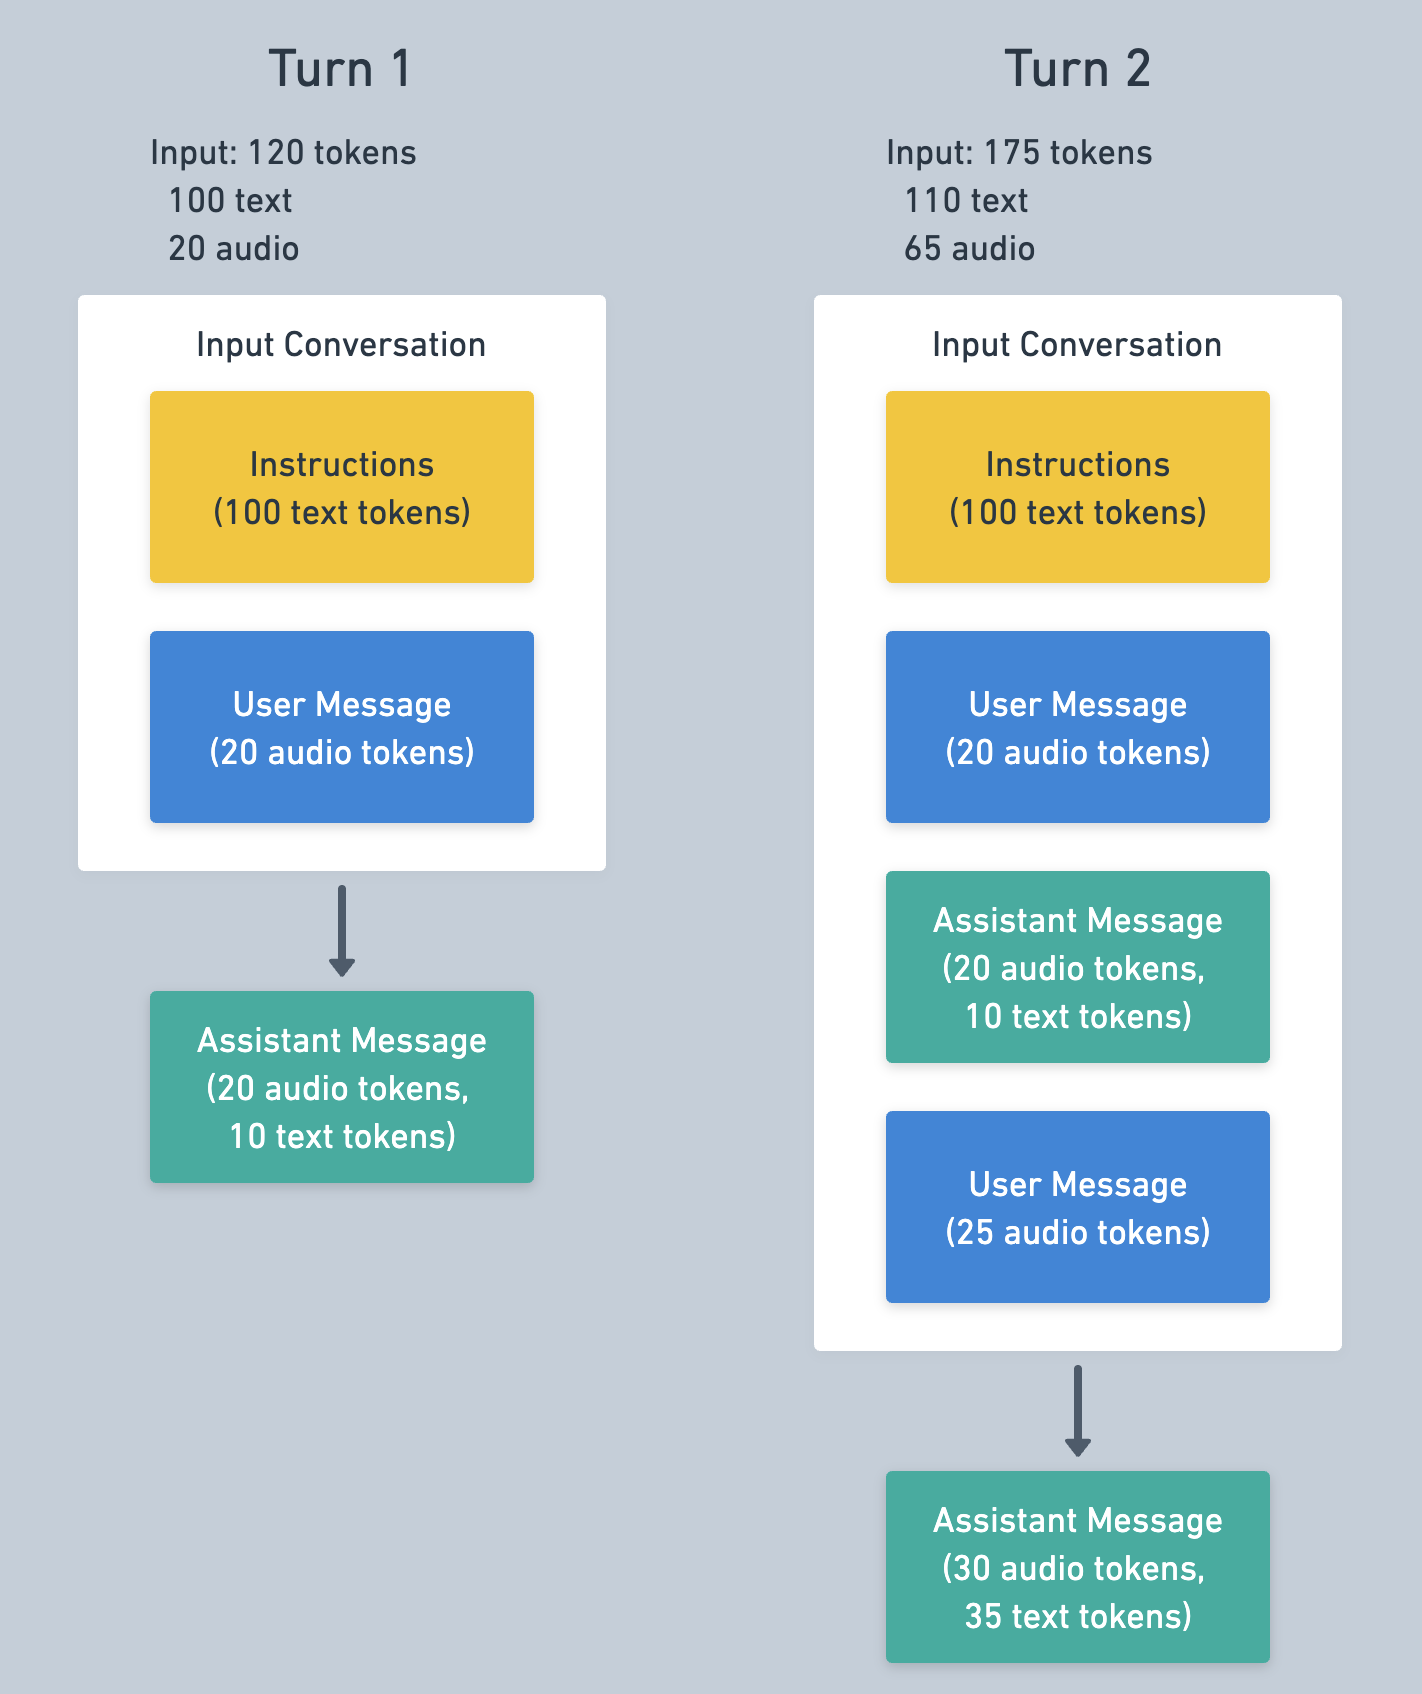
두 번째 턴에서는 첫 번째 턴의 메시지가 캐시되어 입력 비용이 줄어들 가능성이 높습니다. 캐싱에 대한 자세한 내용은 아래를 참고하세요.
Response에 사용된 토큰은 다음과 같은 response.done 이벤트에서 확인할 수 있습니다.
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}입력 전사 비용
입력 전사를 활성화하면 Realtime API에서 전사 요금을 별도로 청구합니다. 입력 전사에는 음성-음성 변환 모델과 다른 모델 및 요금표가 적용됩니다. gpt-transcribe를 사용해 커밋된 턴을 전사하세요. 전사는 입력 오디오 버퍼에 오디오를 기록하고 버퍼를 커밋한 후 시작됩니다.
입력 전사 사용량은 conversation.item.input_audio_transcription.completed 이벤트에서 확인하세요. 사용량 필드는 전사 모델에 따라 다릅니다. gpt-transcribe에는 오디오 길이 기준 요금이 적용되며, 토큰 사용량 기준으로 과금되는 모델은 토큰 수를 반환합니다. 예를 들어 오디오 길이 기준 사용량은 다음과 같은 형식입니다.
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}캐싱
Realtime API는 프롬프트 캐싱을 지원합니다. 캐싱은 자동으로 적용되며 여러 턴에 걸친 세션의 입력 토큰 비용을 크게 줄일 수 있습니다. Response의 입력 토큰이 이전 Response의 토큰과 일치하면 캐싱이 적용될 수 있지만, 항상 적용된다고 보장되지는 않습니다.
캐시 적중률을 높이는 가장 좋은 방법은 세션 기록을 변경하지 않는 것입니다. 대화 내용을 삭제하거나 수정하면 변경 지점 앞까지만 입력이 일치하므로 캐시를 활용할 수 있는 범위가 줄어듭니다. 지침과 도구 정의는 대화 앞부분에 있으므로 세션 도중에 변경하면 이후 턴의 캐시 적중률이 낮아집니다.
대화 잘라내기
대화의 토큰 수가 모델의 입력 토큰 한도를 초과하면 대화가 잘립니다. 즉, 가장 오래된 메시지부터 Response 입력에서 제외됩니다. 예를 들어 컨텍스트 크기가 32k이고 최대 출력 토큰 수가 4,096개인 모델은 대화를 잘라내기 전까지 컨텍스트에 최대 28,224개의 토큰을 포함할 수 있습니다.
클라이언트에서 토큰 윈도우를 모델의 최댓값보다 작게 설정하면 토큰 사용량과 비용을 제어할 수 있습니다. token_limits.post_instructions 설정으로 이 한도를 제어하려면 아래와 같이 잘라내기 유형을 retention_ratio로 지정하세요. 이 설정은 지침 토큰을 제외하고 Response에 사용할 수 있는 최대 입력 토큰 수를 제어합니다. post_instructions를 1,000으로 설정하면 입력 토큰 한도인 1,000개를 넘어서는 항목은 Response를 생성할 때 모델에 전달되지 않습니다.
대화를 잘라내면 대화 앞부분부터 캐시가 무효화됩니다. 매 턴마다 잘라내기가 발생하면 캐시 적중률이 매우 낮아집니다. 이를 완화하려면 클라이언트에서 필요한 것보다 더 많은 메시지를 한 번에 삭제하도록 설정하세요. 그러면 다시 잘라내야 할 때까지 더 많은 토큰을 추가할 수 있습니다. session.truncation.retention_ratio 설정으로 이 비율을 조정할 수 있습니다. 서버의 기본값은 1.0이며 한도를 맞추는 데 필요한 항목만 제거합니다. 값을 0.8로 설정하면 잘라내기 시 최대 토큰 수의 80%만 남기고 20%를 더 제거합니다.
특정 모델을 사용할 때 Realtime API의 세션당 비용을 줄이려면 다음 예시처럼 토큰 수 한도를 낮추고 retention_ratio를 1보다 작게 설정하는 것이 좋습니다. 비용은 낮아지지만 각 턴에서 모델이 기억할 수 있는 대화 내용도 줄어들 수 있습니다.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}아래와 같이 잘라내기를 완전히 비활성화할 수도 있습니다. 이 경우 Conversation이 너무 길어 Response를 생성할 수 없으면 오류가 반환됩니다. Conversation 크기를 직접 관리하려는 경우에 유용합니다.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}그 밖의 최적화 전략
미니 모델 사용하기
Realtime 음성-음성 변환 모델에는 일반 모델과 요금이 훨씬 저렴한 미니 모델이 있습니다. 미니 모델은 지침 준수와 함수 호출 성능이 일반 모델보다 떨어지는 경향이 있습니다. 먼저 더 큰 모델로 애플리케이션을 테스트하고 애플리케이션과 프롬프트를 개선한 다음, 미니 모델을 사용해 비용을 최적화해 보세요.
Conversation 편집하기
서버가 대화를 자동으로 잘라내지만 Conversation을 직접 편집해 비용을 관리할 수도 있습니다. 이 API는 클라이언트가 서버 측 Conversation을 완전히 제어할 수 있도록 설계되어 있어 원하는 대로 항목을 추가하거나 삭제할 수 있습니다.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}오래된 메시지를 삭제하면 입력 토큰 수와 비용을 줄일 수 있습니다. 이 과정에서 중요한 내용이 사라질 수 있으므로 오래된 메시지를 요약으로 대체하는 방법을 흔히 사용합니다. 위 예시처럼 conversation.item.delete 메시지로 Conversation에서 항목을 삭제하고 conversation.item.create 메시지로 항목을 추가할 수 있습니다.
비용 추산
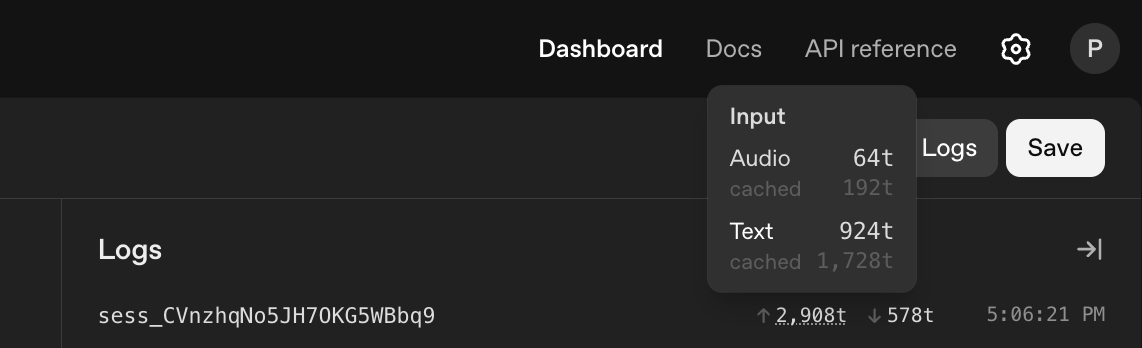
Realtime API의 토큰 사용량은 여러 요인에 따라 달라지므로 비용을 미리 추산하기 어려울 수 있습니다. Realtime Playground에서 실제로 사용할 프롬프트와 함수로 샘플 세션을 실행하고 토큰 사용량을 측정해 보세요. 세션의 토큰 사용량은 Realtime Playground의 Logs 탭에서 세션 ID 옆에 표시됩니다.