
GPT-5를 출시한 지금, GPT-5를 애플리케이션에 통합하는 가장 좋은 방법인 Responses API를 좀 더 자세히 소개하려 합니다. Responses를 추론 모델과 앞으로의 에이전트 개발에 맞춰 설계한 이유도 함께 살펴보겠습니다.
OpenAI는 새로운 세대의 API를 설계할 때마다 같은 질문에서 출발했습니다. 개발자가 모델과 소통하는 가장 간단하면서도 강력한 방법은 무엇일까?
API 설계의 기준은 언제나 모델 자체의 작동 방식이었습니다. 최초의 /v1/completions 엔드포인트는 단순했지만 한계가 있었습니다. 모델에 프롬프트를 주면 쓰다 만 내용을 이어 썼습니다. 개발자는 퓨샷 프롬프팅 같은 기법으로 모델이 JSON을 출력하거나 질문에 답하도록 유도할 수 있었지만, 당시 모델의 능력은 지금 우리가 익숙하게 쓰는 모델에 훨씬 못 미쳤습니다.
이후 RLHF와 ChatGPT가 등장하면서 사후 학습의 시대가 열렸습니다. 모델은 쓰다 만 글을 완성하는 데서 한 걸음 더 나아가 대화 상대처럼 응답하기 시작했습니다. 이 변화에 맞춰 /v1/chat/completions를 만들었습니다(주말 이틀 만에 만들었다는 일화로도 유명합니다). system, user, assistant 같은 역할을 도입해 개발자가 맞춤 지침과 컨텍스트를 갖춘 채팅 인터페이스를 빠르게 구축할 수 있는 토대를 마련했습니다.
모델은 계속 발전해 곧 보고 듣고 말할 수 있게 됐습니다. 2023년 말에 도입한 함수 호출은 개발자들에게 가장 사랑받는 기능 중 하나가 됐습니다. 비슷한 시기에 Assistants API도 베타로 출시했습니다. 코드 인터프리터와 파일 검색 같은 호스팅 도구를 갖춘 본격적인 에이전트 인터페이스를 만들려는 첫 시도였습니다. 일부 개발자에게는 좋은 반응을 얻었지만, Chat Completions에 비해 API 설계에 제약이 많고 도입하기 어려워 널리 쓰이지는 않았습니다.
2024년 말에는 두 API의 장점을 하나로 모아야 한다는 점이 분명해졌습니다. Chat Completions만큼 쉽게 시작할 수 있고 Assistants만큼 강력하면서도 멀티모달 모델과 추론 모델에 맞게 설계한 API가 필요했습니다. 그렇게 탄생한 것이 /v1/responses입니다.
/v1/responses에서 에이전트가 추론하고 행동하는 루프
Chat Completions는 한 턴씩 대화를 주고받는 간단한 채팅 인터페이스를 제공합니다. Responses는 추론과 행동을 반복하는 과정을 구조화한 루프를 제공합니다. 탐정에게 사건을 의뢰한다고 생각해 보세요. 의뢰인이 증거를 건네면 탐정은 사건을 조사하고, 필요하면 전문가(도구)에게 자문한 뒤 결과를 보고합니다. 탐정은 단계가 바뀌어도 자신의 수사 메모(추론 상태)를 보관하지만 의뢰인에게 그 메모를 건네지는 않습니다.
바로 이 지점에서 추론 모델의 강점이 드러납니다. Responses는 여러 턴에 걸쳐 모델의 추론 상태를 유지합니다. Chat Completions에서는 호출이 끝나면 추론 상태가 사라집니다. 탐정이 방을 나설 때마다 단서를 잊어버리는 셈입니다. 반면 Responses에서는 수첩을 계속 펼쳐 두듯 단계별 추론 과정이 다음 턴까지 이어집니다. 그 효과는 벤치마크 점수(TAUBench 5% 향상)뿐 아니라 캐시 활용률 향상과 지연 시간 단축에서도 나타납니다.
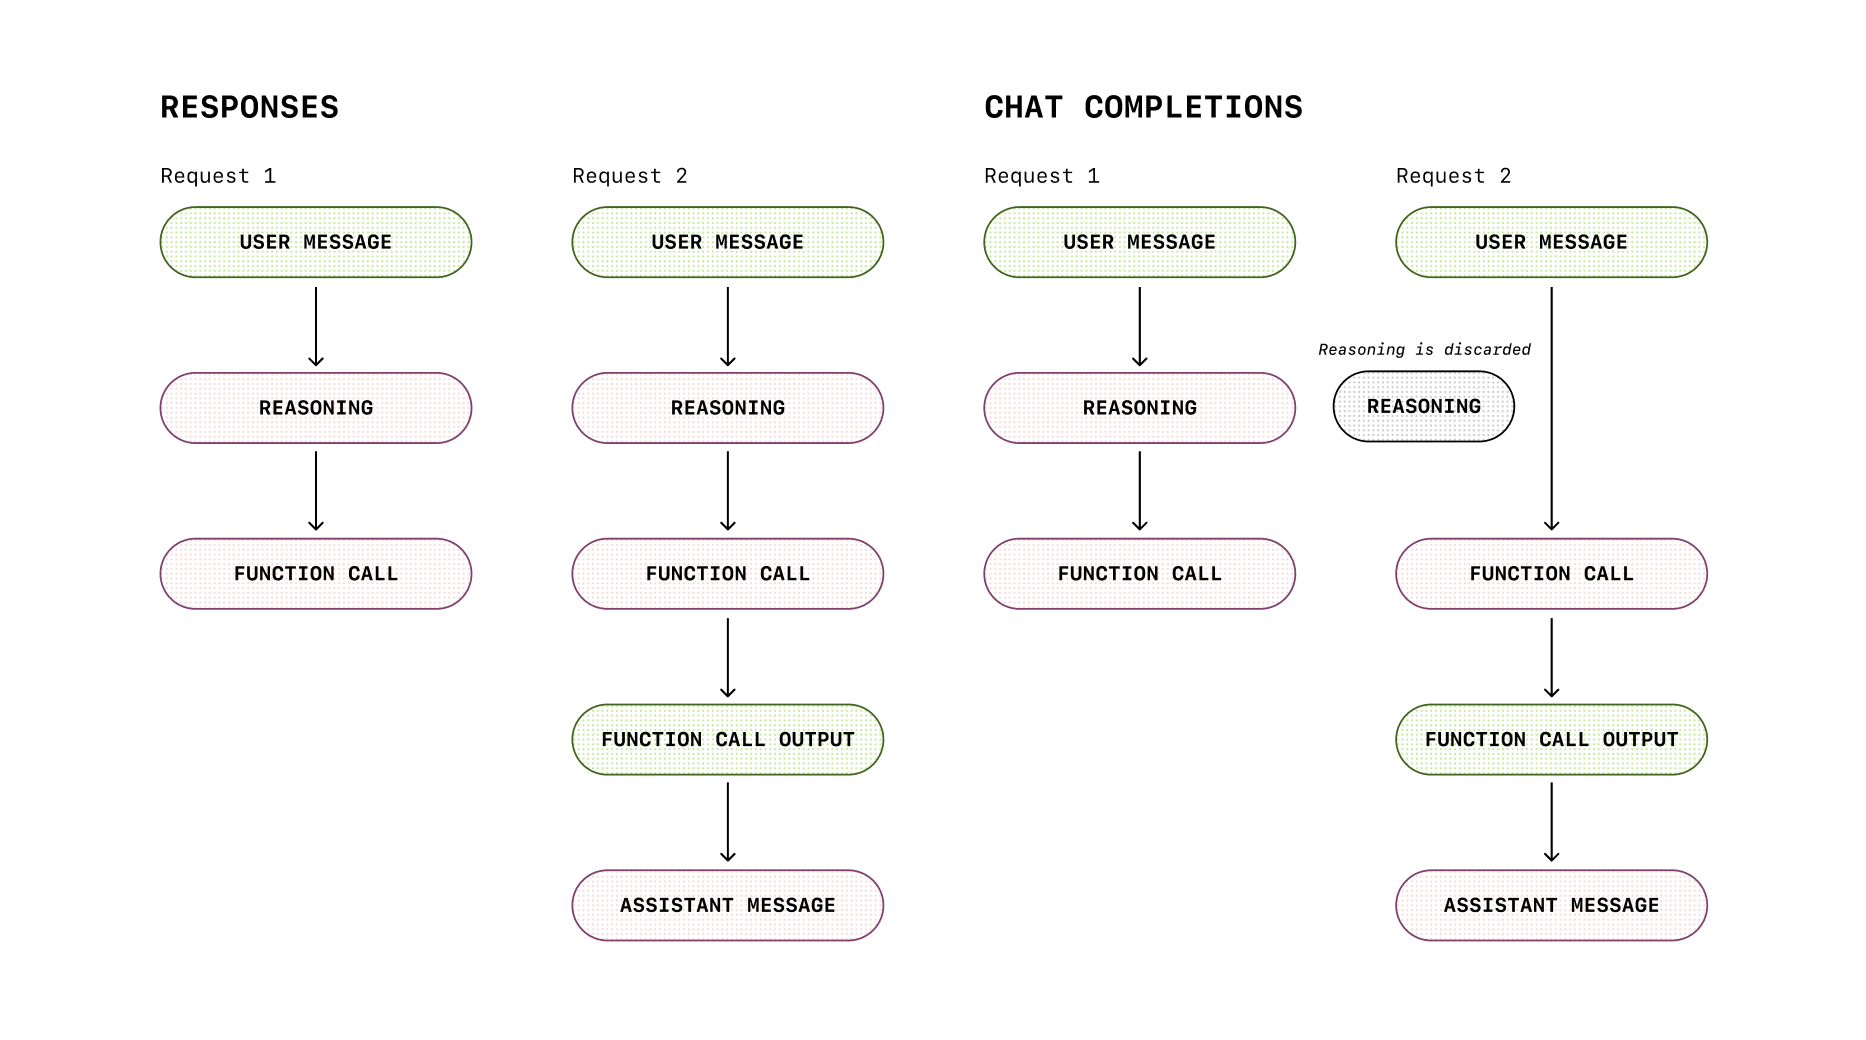
Responses는 여러 출력 항목을 반환할 수도 있습니다. 모델이 무슨 말을 했는지 확인하는 것은 물론, 어떤 행동을 했는지 살펴볼 수도 있습니다. 도구 호출, 구조화된 출력값, 중간 단계가 모두 기록으로 남습니다. 완성된 글과 그 글을 쓰면서 계산한 연습장을 함께 받아 보는 셈입니다. 이 기록은 디버깅이나 감사에 활용할 수 있고, UI에서 더 다양한 정보를 보여 줄 때도 유용합니다.
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},호스팅 도구로 더 많은 작업 맡기기
함수 호출을 도입한 초기에 한 가지 패턴이 눈에 띄었습니다. 개발자들은 모델로 API를 호출할 뿐 아니라 문서 저장소를 검색해 외부 데이터를 가져오고 있었습니다. 지금은 RAG라고 부르는 방식입니다. 하지만 막 개발을 시작한 입장에서 검색 파이프라인을 처음부터 구축하기란 어렵고 비용도 많이 듭니다. 그래서 Assistants에 처음으로 호스팅 도구인 file_search와 code_interpreter를 도입했습니다. 모델이 RAG를 활용하거나 코드를 작성해 사용자가 제시한 문제를 풀 수 있게 된 것입니다. Responses에서는 한 걸음 더 나아가 웹 검색, 이미지 생성, MCP를 추가했습니다. 코드 인터프리터나 MCP 같은 호스팅 도구는 서버 측에서 실행되므로 호출할 때마다 개발자의 백엔드를 거칠 필요가 없습니다. 그만큼 지연 시간과 왕복 호출 비용이 줄어듭니다.
추론을 안전하게 보존하는 방법
그렇다면 왜 이처럼 공을 들여 모델의 원본 추론 과정(CoT)을 감출까요? CoT를 그대로 공개해서 클라이언트가 다른 모델 출력처럼 다루도록 하는 편이 더 간단하지 않을까요? 간단히 말하면 원본 CoT 공개에는 여러 위험이 따릅니다. 환각이나 최종 응답에는 나오지 않을 유해 콘텐츠가 드러날 수 있고, OpenAI로서는 경쟁 측면의 위험도 생깁니다.
지난해 말 o1-preview를 출시할 당시 OpenAI 수석 과학자 Jakub Pachocki는 블로그에 이렇게 썼습니다.
우리는 비공개 추론 과정이 모델을 모니터링할 특별한 기회를 제공한다고 봅니다. 이 기록이 실제 추론을 충실히 반영하고 사람이 이해할 수 있다면, 모델의 ‘마음을 읽고’ 어떻게 생각하는지 파악할 수 있습니다. 예를 들어 앞으로는 추론 과정을 모니터링해 모델이 사용자를 조종하려는 징후를 포착하고 싶을 수도 있습니다. 다만 그러려면 모델이 자신의 생각을 있는 그대로 자유롭게 표현할 수 있어야 합니다. 따라서 추론 과정 자체가 정책이나 사용자 선호에 맞춰지도록 학습시킬 수는 없습니다. 또한 정렬되지 않은 추론 과정을 사용자에게 그대로 보여 주고 싶지도 않습니다.
Responses는 이를 두 가지 방식으로 해결합니다.
- 추론 상태를 암호화해 내부에 보관하고 클라이언트에는 공개하지 않습니다.
- 원본 CoT를 노출하지 않고도
previous_response_id나 추론 항목을 사용해 추론을 안전하게 이어 갈 수 있습니다.
개발에 /v1/responses가 가장 적합한 이유
Responses는 상태를 유지하고, 여러 모달리티를 지원하며, 효율적으로 작동하도록 설계했습니다.
- 에이전트의 도구 활용. Responses API에서는 파일 검색, 이미지 생성, 코드 인터프리터, MCP 같은 도구를 에이전트 워크플로우에 손쉽게 추가해 더 많은 작업을 수행할 수 있습니다.
- 기본으로 제공되는 상태 관리. 대화와 도구 상태를 자동으로 추적하므로 추론과 멀티턴 워크플로우를 훨씬 쉽게 다룰 수 있습니다. GPT-5를 Responses로 통합하면 이전 추론 상태를 활용하는 것만으로도 Chat Completions를 사용할 때보다 TAUBench 점수가 5% 높습니다.
- 설계 단계부터 지원하는 멀티모달. 텍스트, 이미지, 오디오, 함수 호출을 모두 동등하게 다룹니다. 텍스트 API에 다른 모달리티를 나중에 덧붙이는 대신, 집을 지을 때부터 방을 넉넉히 두듯 처음부터 여러 모달리티를 고려해 설계했습니다.
- 비용 절감과 성능 향상. 내부 벤치마크에서 캐시 활용률이 Chat Completions보다 40~80% 높았습니다. 그만큼 지연 시간이 짧아지고 비용도 줄어듭니다.
- 설계 개선. Chat Completions API와 Assistants API에서 얻은 교훈을 바탕으로 Responses API와 SDK 곳곳을 개선해 개발이 편해졌습니다.
- 어떤 일이 일어났는지 명시하는 스트리밍 이벤트를 제공합니다.
- 객체 내부의 타입 태그로 다형성을 구현합니다.
- SDK의
output_text헬퍼로 텍스트를 가져올 수 있습니다(더 이상choices.[0].message.content를 쓸 필요가 없습니다). - 멀티모달 및 추론 매개변수를 더 체계적으로 정리했습니다.
Chat Completions는 어떻게 되나요?
Chat Completions는 계속 제공됩니다. 지금 쓰는 방식에 잘 맞는다면 그대로 사용하세요. 추론이 다음 턴까지 이어지고, 여러 모달리티를 자연스럽게 주고받으며, 별도의 임시방편 없이 에이전트 루프를 구성하고 싶다면 Responses를 사용하세요.
앞으로의 전망
Chat Completions가 Completions를 대체했듯이, 앞으로는 개발자가 OpenAI 모델로 애플리케이션을 만들 때 Responses를 기본으로 사용하게 될 것으로 기대합니다. 간단한 작업은 간단하게 처리할 수 있고, 더 강력한 기능이 필요할 때는 그에 맞게 활용할 수 있습니다. 앞으로 어떤 패러다임이 등장하더라도 대응할 만큼 유연합니다.
앞으로 몇 년간 OpenAI는 이 API를 기반으로 개발을 이어 갈 것입니다.