
AI 오디오 기술 덕분에 사용자가 음성으로 앱과 상호작용하는 방식이 한층 다양해졌습니다. 올해 초에는 개발자가 이런 경험을 구현할 수 있도록 gpt-realtime을 비롯한 여러 오디오 모델과 새 API 기능을 출시했습니다.
지난주에는 안정적인 오디오 에이전트를 구축할 때 자주 겪는 문제를 줄이기 위해 새 오디오 모델 스냅샷을 출시했습니다. 음성 전사와 텍스트 음성 변환부터 음성-음성 변환을 기본 지원하는 실시간 에이전트까지, 프로덕션 음성 워크플로우 전반에서 안정성과 품질을 높였습니다.
이번에 출시한 스냅샷은 다음과 같습니다.
gpt-4o-mini-transcribe-2025-12-15는 전사 API 또는 Realtime API에서 음성을 텍스트로 변환합니다.gpt-4o-mini-tts-2025-12-15는 Speech API에서 텍스트를 음성으로 변환합니다.gpt-realtime-mini-2025-12-15는 Realtime API에서 실시간 음성-음성 변환을 기본 지원합니다.gpt-audio-mini-2025-12-15는 Chat Completions API에서 음성-음성 변환을 기본 지원합니다.
새 스냅샷의 공통 개선 사항은 다음과 같습니다.
오디오 입력
- 실제 환경에서 녹음한 오디오와 잡음이 섞인 오디오에서 단어 오류율이 낮아졌습니다.
- 무음 구간이나 배경 소음이 있는 구간에서 환각이 줄었습니다.
오디오 출력
- 출력 음성이 더 자연스럽고 안정적입니다. 맞춤형 음성을 사용할 때도 마찬가지입니다.
요금은 이전 모델 스냅샷과 동일합니다. 같은 비용으로 더 나은 성능을 얻으려면 새 스냅샷으로 전환하세요.
음성 에이전트, 고객 지원 시스템 또는 브랜드 고유의 목소리를 활용한 서비스를 개발하고 있다면 이번 업데이트로 프로덕션 환경에서 더 안정적으로 서비스를 운영할 수 있습니다. 각 모델에서 무엇이 달라졌고 실제 음성 워크플로우에서 어떤 효과가 있는지 살펴보겠습니다.
음성-음성 변환
도구 호출과 지시 이행 성능을 높인 새 Realtime mini 및 Audio mini 모델을 배포합니다. mini 모델과 대형 모델 간의 성능 격차가 줄어들어 일부 애플리케이션에서는 mini 모델로 전환해 비용을 절감할 수 있습니다.
gpt-realtime-mini-2025-12-15
gpt-realtime-mini 모델은 지연 시간이 짧은 멀티 모달 상호작용을 기본 지원하는 Realtime API용으로 설계했습니다. 오디오 입출력을 스트리밍하고 사용자가 모델의 말을 끊고 들어오는 상황도 처리할 수 있습니다. 이때 필요하면 음성 활동 감지 기능을 사용할 수 있습니다. 모델이 계속 말하는 동안 백그라운드에서 함수를 호출할 수도 있습니다.
새 Realtime mini 스냅샷은 지시를 더 잘 따르고 도구를 더 정확하게 호출해 실시간 에이전트에 한층 적합합니다. 내부 음성-음성 변환 평가에서 이전 스냅샷보다 지시 이행 정확도는 18.6%포인트, 도구 호출 정확도는 12.9%포인트 높아졌습니다. Big Bench Audio 벤치마크에서도 성능이 향상됐습니다.
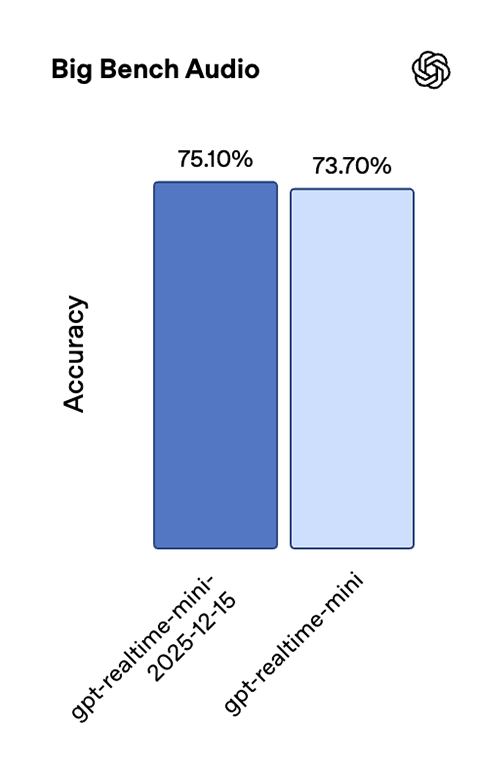
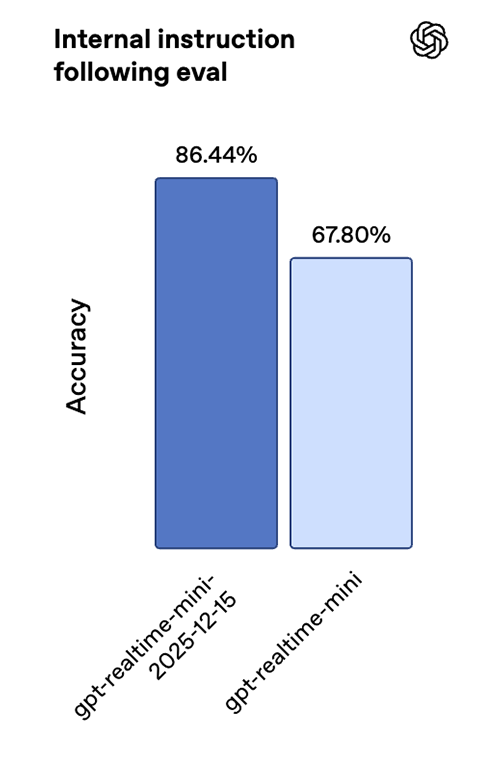
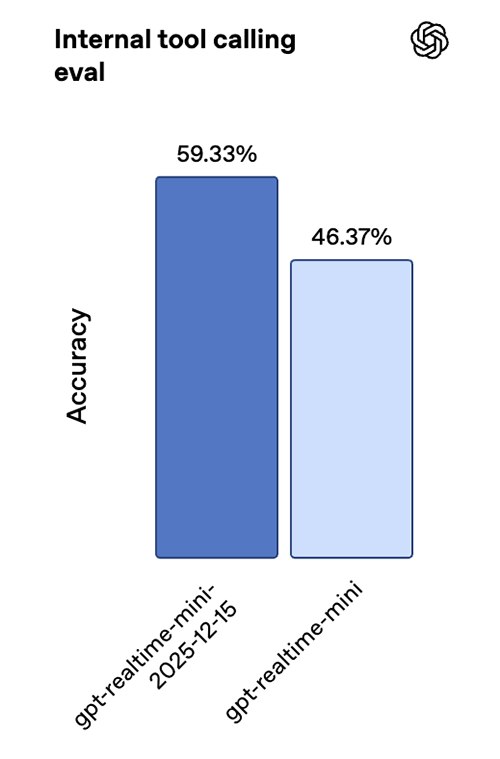
이러한 개선으로 지연 시간이 짧아야 하는 실시간 환경에서도 여러 단계에 걸친 상호작용이 더 안정적이고 함수 실행도 더 일관됩니다.
비용이 더 들더라도 에이전트의 정확도가 중요한 경우에는 여전히 gpt-realtime의 성능이 가장 뛰어납니다. 비용과 지연 시간이 가장 중요하다면 실제 사용 환경에서도 성능이 우수한 gpt-realtime-mini가 좋은 선택입니다.
예를 들어 Genspark는 두 언어 간 번역과 사용자 의도에 따른 지능형 라우팅 작업에서 이 모델의 성능을 집중적으로 테스트했습니다. 테스트 결과 음성 품질이 개선됐고 응답이 거의 즉각적이었으며, 대화가 빠르게 오가는 동안에도 사용자의 의도를 정확하게 파악했습니다.
gpt-audio-mini-2025-12-15
gpt-audio-mini 모델은 Chat Completions API와 함께 사용해 실시간 상호작용이 필요 없는 음성-음성 변환 기능을 구현할 수 있습니다.
두 스냅샷 모두 디코더를 개선해 목소리가 더 자연스럽게 들립니다. 맞춤형 음성을 사용할 때도 목소리를 더 일관되게 유지합니다.
텍스트 음성 변환
최신 텍스트 음성 변환 모델인 gpt-4o-mini-tts-2025-12-15는 이전 세대보다 정확도가 크게 향상돼 표준 음성 벤치마크 전반에서 단어 오류율이 상당히 낮아졌습니다. Common Voice와 FLEURS에서는 단어 오류율(WER)이 약 35% 낮아졌고, Multilingual LibriSpeech에서도 일관된 개선을 보였습니다.
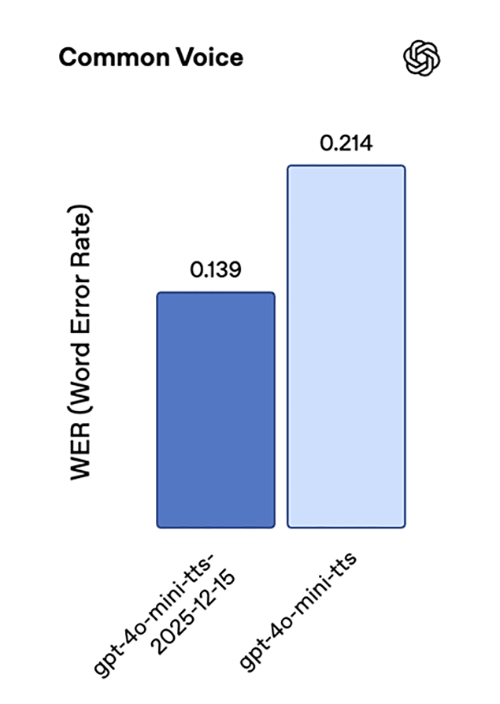
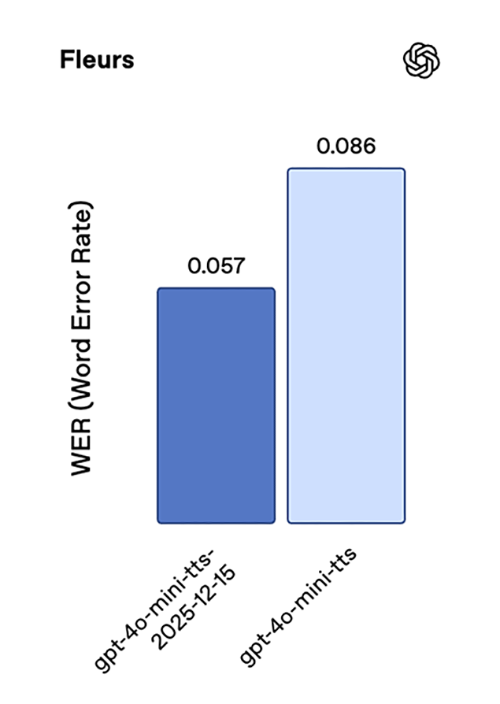
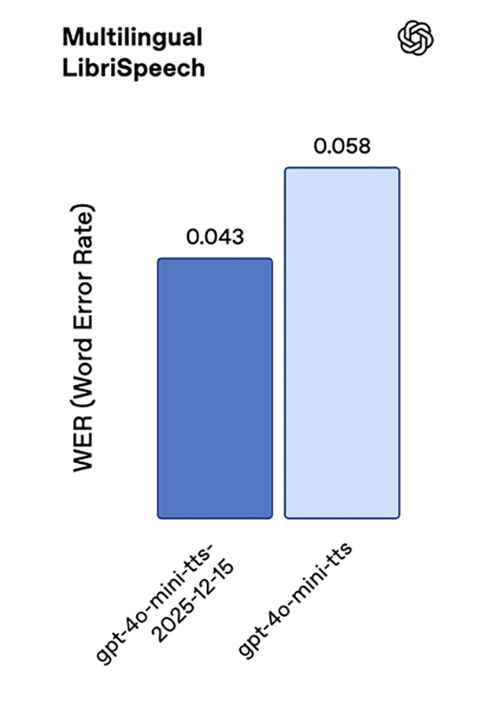
이 결과는 모델이 다양한 언어에서 더 정확하게 발음하고 더 안정적으로 작동한다는 점을 보여줍니다.
새 gpt-realtime-mini 스냅샷과 마찬가지로 이 모델도 목소리가 훨씬 자연스러워졌으며 맞춤형 음성을 사용할 때 성능이 향상됐습니다.
음성 텍스트 변환
최신 전사 모델인 gpt-4o-mini-transcribe-2025-12-15는 정확도와 안정성이 모두 크게 향상됐습니다. Common Voice와 FLEURS 같은 표준 자동 음성 인식(ASR) 벤치마크에서 언어 힌트를 제공하지 않고 평가했을 때 이전 모델보다 단어 오류율이 낮았습니다. 사용자가 짧게 말하거나 주변이 시끄러운 상황 등 실제 대화 환경에서 잘 작동하도록 모델을 최적화했습니다. 내부 소음 환경에서의 환각 평가에서는 실제 환경에서 녹음한 배경 소음과 발화 간격이 다양한 오디오를 재생했으며, 무음 구간도 포함했습니다. 그 결과 이 모델의 환각은 Whisper v2 대비 약 90%, 이전 GPT-4o-transcribe 모델 대비 약 70% 줄었습니다.
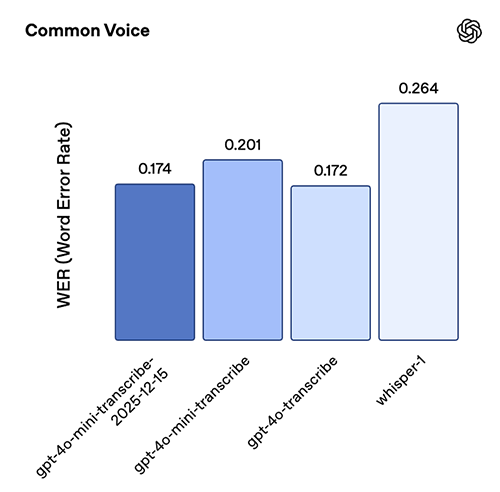
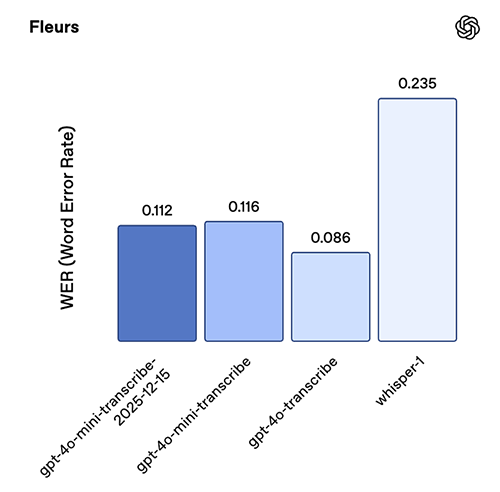
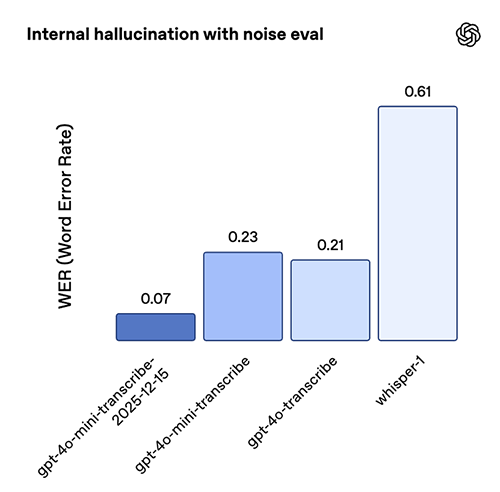
이 모델 스냅샷은 중국어(만다린), 힌디어, 벵골어, 일본어, 인도네시아어, 이탈리아어에서 특히 뛰어난 성능을 보입니다.
맞춤형 음성
맞춤형 음성 기능을 사용하면 브랜드 고유의 목소리로 고객과 소통할 수 있습니다. 고객 지원 에이전트나 브랜드 아바타를 만들 때 OpenAI의 맞춤형 음성 기술로 개성이 뚜렷하면서도 실제 사람처럼 들리는 목소리를 쉽게 구현할 수 있습니다.
새 음성-음성 변환 모델과 텍스트 음성 변환 모델은 맞춤형 음성의 음색을 더 자연스럽게 구현하고 원본 음성 샘플의 특성을 더 충실하게 재현합니다. 다양한 방언에서도 정확도가 높아졌습니다.
이 기술을 안전하게 사용할 수 있도록 맞춤형 음성 기능은 자격 요건을 충족하는 고객에게만 제공합니다. 자세한 내용은 담당 영업 책임자에게 연락하거나 영업팀에 문의하세요.
프로토타입에서 프로덕션으로
음성 앱에서 문제가 자주 발생하는 상황은 비슷합니다. 주로 대화가 길어지거나 무음 같은 예외 상황이 발생할 때, 또는 음성 에이전트가 도구를 정확히 사용해야 하는 플로우에서 문제가 생깁니다. 이번 업데이트에서는 이런 상황에 초점을 맞춰 오류율을 낮추고 환각을 줄였습니다. 도구 사용도 더 일관되고 지시를 따르는 정확도도 높아졌습니다. 출력 오디오도 더 안정적이어서 사용자가 더 자연스러운 음성을 들을 수 있습니다.
현재 음성 서비스를 출시하고 있다면 새 2025-12-15 스냅샷으로 전환한 뒤 주요 프로덕션 테스트 케이스를 다시 실행하는 것을 권장합니다.
초기 테스터들은 기존 지시를 그대로 두고 새 스냅샷으로 전환하는 것만으로도 눈에 띄는 개선을 확인했습니다. 각자의 사용 사례에서도 직접 테스트하고 필요에 따라 프롬프트를 조정해 보세요.