
Im September 2025 stellte OpenAI GPT-5-Codex vor, die erste Version von GPT-5, die für agentisches Programmieren optimiert war. Als wir im Dezember 2025 Version 5.2 veröffentlichten, begannen viele, autonomen Programmieragenten zuverlässige Arbeit zuzutrauen. Besonders deutlich war der Fortschritt darin, wie lange das Modell Anweisungen zuverlässig befolgen konnte.
Ich wollte herausfinden, wo diese Grenze lag. Also gab ich Codex ein leeres Repository, Vollzugriff und eine einzige Aufgabe: ein Designwerkzeug von Grund auf zu entwickeln. Für den Durchlauf wählte ich GPT-5.3-Codex und stellte den Reasoning-Aufwand auf „Sehr hoch“. Codex arbeitete rund 25 Stunden ohne Unterbrechung, verbrauchte dabei etwa 13 Millionen Token und erzeugte rund 30.000 Zeilen Code.
Das war ein Experiment. Ein Einsatz im Produktivbetrieb war nicht das Ziel. Codex bewältigte aber genau die Dinge gut, auf die es bei Aufgaben mit langem Zeithorizont ankommt: Es hielt sich an die Spezifikation, blieb bei der Aufgabe, überprüfte seine Arbeit und behob Fehler, sobald sie auftraten.

So sieht eine lange Codex-Sitzung aus
Ich bat Codex, eine Übersichtsseite mit den Sitzungsdaten zu erstellen:

Hier siehst du die Sitzungsstatistik und den Token-Verbrauch in der CLI:

Die Screenshots machen eine wesentliche Veränderung sichtbar: Beim agentischen Programmieren zählt neben der One-Shot-Leistung zunehmend der Zeithorizont, über den ein Agent arbeiten kann.
Entscheidend ist der längere Zeithorizont
„Die Modelle sind intelligenter geworden“ beschreibt nur einen Teil der Entwicklung. In der Praxis können Agenten länger einen schlüssigen Ansatz verfolgen, größere Arbeitspakete von Anfang bis Ende erledigen und nach Fehlern weiterarbeiten, ohne den Faden zu verlieren.
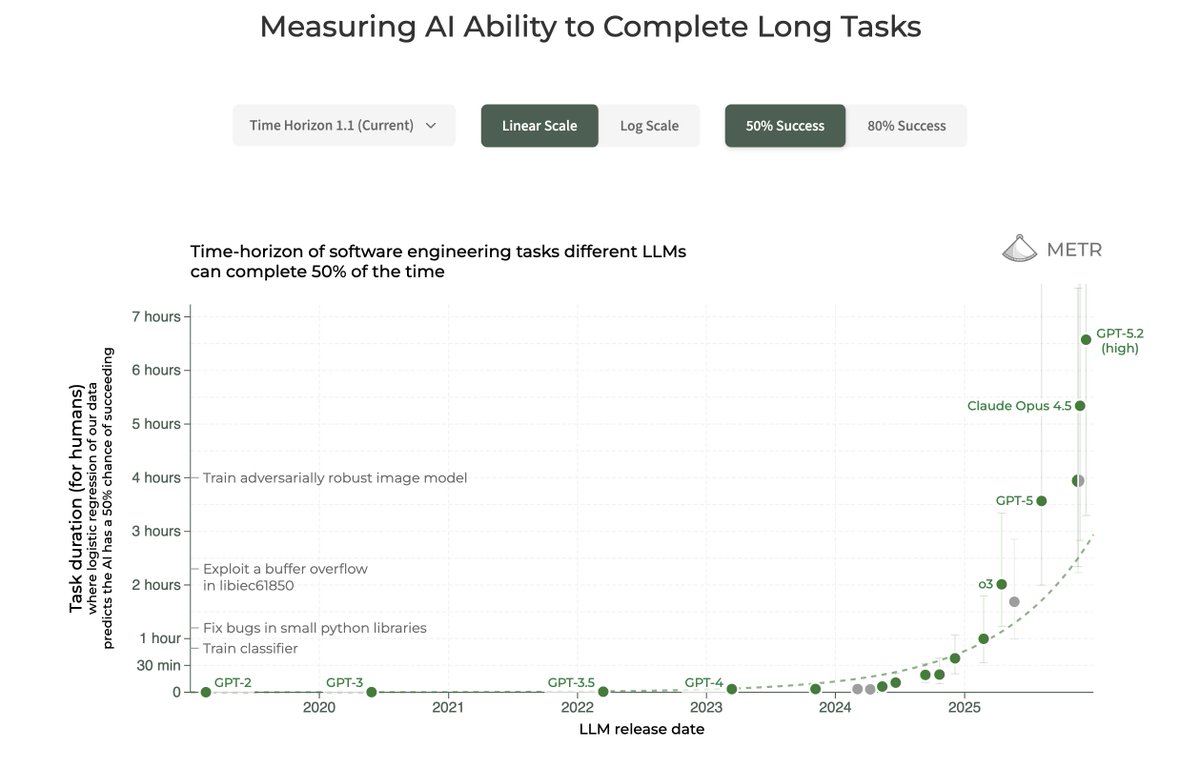
Die Benchmarks von METR zum Zeithorizont helfen, diese Entwicklung einzuordnen. METR misst, wie lange Softwareaufgaben dauern, die Frontier-Agenten mit einer Erfolgsquote von rund 50 % beziehungsweise 80 % abschließen können. Diese Aufgabendauer steigt rasch und verdoppelt sich ungefähr alle sieben Monate. Mehr dazu im Beitrag Wie METR misst, ob KI lange Aufgaben bewältigen kann.
In unserer Ankündigung zu GPT-5.3-Codex haben wir zwei weitere Fortschritte beschrieben, die sich bei der Arbeit mit Agenten bemerkbar machen:
- Das Modell führt Aufgaben mit mehreren Schritten besser aus (planen → umsetzen → prüfen → Fehler beheben).
- Du kannst den Kurs während der Ausführung leichter korrigieren, ohne von vorn anfangen zu müssen. Der bisherige Fortschritt bleibt erhalten.
Inspiriert haben mich auch die Berichte von Cursor über autonome Programmiersysteme, die über längere Zeit arbeiten. In einem Experiment ließ das Team einen Browser entwickeln: Wie Cursor einen Webbrowser entwickelte (Agenten skalieren).
Das Cursor-Team schrieb, OpenAI-Modelle seien „deutlich besser darin, über längere Zeit selbstständig zu arbeiten: Sie befolgen Anweisungen, bleiben konzentriert, verlieren das Ziel nicht aus den Augen und setzen Vorgaben präzise und vollständig um.“
Warum Codex bei langen Aufgaben den Faden behält
Für längere Aufgaben kommt es weniger auf einen einzigen umfangreichen Prompt an als auf den Arbeitszyklus, den das Modell als Agent durchläuft.
Bei Codex sieht dieser Zyklus ungefähr so aus:
- Vorgehen planen
- Code bearbeiten
- Werkzeuge ausführen (Tests, Build, Lint)
- Ergebnisse auswerten
- Fehler beheben
- Dokumentation und Status aktualisieren
- Zyklus wiederholen
Dieser Zyklus gibt dem Agenten drei Dinge:
- Konkrete Rückmeldungen aus der Ausführung (Fehler, Diffs, Logs)
- Einen außerhalb des Modells festgehaltenen Arbeitsstand (Repository, Dateien, Dokumentation, Worktrees, Ausgaben)
- Orientierung durch deine Rückmeldungen (du kannst anhand der Ergebnisse den Kurs korrigieren)
Das erklärt auch, warum sich Codex-Modelle in den Codex-Oberflächen besser nutzen lassen als in einem allgemeinen Chatfenster. Der Harness liefert strukturierten Kontext (Metadaten zum Repository, Dateibaum, Diffs, Befehlsausgaben) und sorgt dafür, dass der Agent nach festen Kriterien prüft, ob die Arbeit abgeschlossen ist.
In einem kürzlich veröffentlichten Artikel beschreiben wir den Arbeitszyklus des Codex-Agenten im Detail.
Außerdem haben wir die Codex App veröffentlicht, mit der sich dieser Arbeitszyklus im Alltag nutzen lässt:
- Parallele Threads in mehreren Projekten (während eine längere Aufgabe läuft, kannst du deiner täglichen Arbeit nachgehen)
- Skills (einheitliche Abläufe für Planung, Umsetzung, Tests und Berichte festlegen)
- Automatisierungen (Routineaufgaben im Hintergrund erledigen lassen)
- Git-Worktrees (Durchläufe voneinander trennen, Diffs überschaubar halten und unnötiges Hin und Her vermeiden)

Mein Setup für den Test
Für dieses „Experiment“ habe ich ein Designwerkzeug gewählt, weil sich Schwächen daran schnell zeigen. Die Benutzeroberfläche, das Datenmodell und die Bearbeitungsfunktionen müssen zusammenspielen, auch in den vielen Randfällen. Da hilft kein Bluff. Stimmt die Architektur nicht, treten schnell Fehler auf.
Ich gab GPT-5.3-Codex eine umfangreiche Spezifikation und stellte den Reasoning-Aufwand auf „Sehr hoch“. Das Modell arbeitete rund 25 Stunden ohne Unterbrechung, behielt den Faden und lieferte guten Code. Bei jedem erreichten Meilenstein führte es außerdem Tests, Lint-Prüfungen und eine Typprüfung durch.
Die zentrale Idee: ein dauerhaftes Projektgedächtnis
Am wichtigsten war das dauerhafte Projektgedächtnis. Ich hielt die Spezifikation, den Plan, die Vorgaben und den aktuellen Stand in Markdown-Dateien fest, die Codex jederzeit wieder lesen konnte. So blieb Codex auf Kurs, und die Kriterien dafür, wann die Arbeit als abgeschlossen galt, blieben über den gesamten Durchlauf dieselben.
Die folgenden Links führen zu den einzelnen Dateien im Repository:
Prompt.md (Spezifikation und erwartete Ergebnisse)
Zweck: Das Ziel von Anfang an festlegen, damit der Agent nicht „etwas Beeindruckendes entwickelt, das an der Aufgabe vorbeigeht“.
Die wichtigsten Abschnitte der Datei:
- Ziele und ausdrücklich ausgeschlossene Ziele
- Feste Vorgaben (Leistung, Determinismus, Nutzererlebnis, Plattform)
- Erwartete Ergebnisse (was am Ende vorliegen muss)
- „Abgeschlossen, wenn …“ (Prüfungen und Ablauf der Demo)
Im ersten Prompt wies ich Codex an, die Prompt-Datei als vollständige Projektspezifikation zu behandeln und daraus einen Plan mit Meilensteinen zu erstellen:

Plan.md (Meilensteine und Prüfungen)
Zweck: Eine offene Aufgabe in Etappen unterteilen, die der Agent einzeln abschließen und überprüfen kann.
Die wichtigsten Abschnitte der Datei:
- Meilensteine, die klein genug für einen Arbeitszyklus sind
- Abnahmekriterien und Prüfbefehle für jeden Meilenstein
- Regel für fehlgeschlagene Prüfungen: erst den Fehler beheben, dann weiterarbeiten
- Entscheidungsnotizen, damit der Agent nicht zwischen verschiedenen Ansätzen hin und her wechselt
- Vorgesehene Architektur der Codebasis

Die Codex App, die CLI und die IDE-Erweiterung haben seit Kurzem einen integrierten Planmodus. Damit kannst du eine größere Aufgabe vor der ersten Änderung in klare, überprüfbare Schritte aufteilen und dich mit Codex vorab auf das Vorgehen verständigen. Sind noch Punkte offen, fragt Codex nach. Du aktivierst den Planmodus mit dem Slash-Befehl /plan.
Implement.md (Arbeitsanweisungen zum Plan)
Zweck: Diese Datei ist die Arbeitsanleitung. Sie gibt Codex genau vor, wie es vorgehen soll: dem Plan folgen, Diffs auf die jeweilige Aufgabe beschränken, Prüfungen ausführen und die Dokumentation aktualisieren.
Die wichtigsten Abschnitte der Datei:
- Für jeden Meilenstein gilt der Plan in der Markdown-Datei
- Nach jedem Meilenstein die Prüfungen ausführen und Fehler sofort beheben
- Diffs auf die geplanten Änderungen beschränken, ohne die Aufgabe auszuweiten
- Die Markdown-Datei mit der Dokumentation laufend aktualisieren

Documentation.md (Arbeitsstand und Entscheidungen während der Umsetzung)
Zweck: Die Datei dient als gemeinsames Gedächtnis und als Protokoll. So kann ich auch nach mehreren Stunden Abwesenheit nachvollziehen, was in der Zwischenzeit passiert ist.
Die wichtigsten Abschnitte der Datei:
- Stand des aktuellen Meilensteins (was erledigt ist und was als Nächstes ansteht)
- Getroffene Entscheidungen und ihre Gründe
- Anleitung zum Ausführen und Vorführen (Befehle und kurze Smoke-Tests)
- Bekannte Probleme und offene Aufgaben

So sah die Überprüfung der Meilensteine während des Durchlaufs aus:

Überprüfung bei jedem Meilenstein
Codex schrieb den Code und prüfte, ob er funktionierte. Nach jedem Meilenstein führte es die vorgesehenen Prüfbefehle aus und behob Fehler, bevor es weiterarbeitete.
Hier siehst du Beispiele für die Befehle, die Codex zur Qualitätssicherung verwenden sollte:

Und hier ein Beispiel dafür, wie Codex Fehler nach einer fehlgeschlagenen Lint-Prüfung behob:

Was der Agent entwickelt hat
Das Ergebnis hatte Schwächen und war noch nicht für den Produktivbetrieb geeignet. Es war aber eine Anwendung, die ich ausprobieren und testen konnte. Für diesen Durchlauf reichte mir „Der Code lässt sich kompilieren“ als Maßstab nicht aus. Meine Frage war: „Hält sich Codex an die Anweisungen und funktioniert das Ergebnis tatsächlich?“
Diese Funktionen hat Codex umgesetzt:
- Bearbeitung auf der Zeichenfläche (Rahmen, Gruppen, Formen, Text, Bilder und Symbole, Schaltflächen, Diagramme)
- Zusammenarbeit in Echtzeit (Anwesenheit, Cursorpositionen, Auswahl und Änderungen werden zwischen Tabs synchronisiert)
- Einstellungen im Inspektor (Geometrie, Gestaltung, Text)
- Ebenenverwaltung (Ebenen suchen, umbenennen, sperren, ausblenden und neu anordnen)
- Hilfslinien, Ausrichten und Einrasten
- Zwischenstände im Verlauf speichern und wiederherstellen
- Verlauf auf einer Zeitleiste wiedergeben und an einem früheren Punkt einen neuen Branch anlegen
- Prototypmodus (Hotspots und Navigation durch den Ablauf)
- Kommentare (angeheftete Threads als erledigt markieren und wieder öffnen)
- Export (Speichern, Importieren und Exportieren sowie CLI-Export als JSON oder als React-Code mit Tailwind)
Was sich für Codex-Aufgaben mit langem Zeithorizont bewährt hat
Ein einzelner cleverer Prompt hätte für diesen Durchlauf nicht gereicht. Entscheidend war das Zusammenspiel mehrerer Elemente:
- Ein klares Ziel und feste Vorgaben in der Spezifikationsdatei
- Meilensteine mit Abnahmekriterien, die der Agent nach jeder Etappe prüft (
plans.md) - Eine Arbeitsanleitung für den Agenten (
implement.md) - Laufende Überprüfung durch Tests, Lint-Prüfungen, Typprüfung und Build
- Ein laufend aktualisiertes Protokoll (
documentation.md), mit dem ich den Arbeitsstand und den Verlauf jederzeit nachvollziehen konnte
In diese Richtung entwickelt sich das Programmieren über längere Zeiträume: Du kannst mehr Arbeit mit klaren Vorgaben delegieren und musst seltener eingreifen.
Probiere Codex mit einer eigenen längeren Aufgabe aus
Dieser 25-Stunden-Durchlauf mit Codex zeigt, wie sich die Softwareentwicklung verändert. Zu einzelnen Prompts und der engen Abstimmung beim Pair Programming kommt eine neue Form der Zusammenarbeit hinzu: Ein Agent kann über längere Zeit ein ganzes Arbeitspaket von Anfang bis Ende übernehmen. Du gibst an den Meilensteinen die Richtung vor, ohne jede Codezeile im Detail begleiten zu müssen.
Mit Codex wollen wir erreichen, dass der Agent besser im Team mitarbeitet und deinen konkreten Arbeitskontext stärker einbezieht. Klare Vorgaben sollen dafür sorgen, dass er zuverlässig arbeitet und Ergebnisse liefert, die sich gut überprüfen und veröffentlichen lassen. Schon heute sehen wir, dass Entwicklungsteams schneller vorankommen, wenn der Agent Routineaufgaben bei der Umsetzung und Überprüfung übernimmt. Den Menschen bleibt mehr Zeit für Design, Architektur, Produktentscheidungen und neuartige Probleme, für die es noch keine Vorlage gibt.
Diese Entwicklung wird auch Menschen zugutekommen, die nicht beruflich programmieren. Je besser Codex versteht, was sie erreichen wollen, und je mehr Sicherheit es ihnen mit Plänen, Prüfungen, Vorschauen und der Möglichkeit zum Zurücksetzen von Änderungen gibt, desto mehr Menschen werden eigene Anwendungen entwickeln und weiter verbessern können, ohne ständig in einer IDE zu arbeiten. Für die Codex-Oberflächen und -Modelle ist noch mehr geplant. Unser Ziel bleibt, dass sich der Agent weniger wie ein Werkzeug anfühlt, das du ständig beaufsichtigen musst, und mehr wie ein Teammitglied, auf das du dich auch bei längeren Aufgaben verlassen kannst.
Wenn du das selbst ausprobieren möchtest, findest du hier den Einstieg: