Den vollständigen Index der Dokumentation findest du in llms.txt. Die Markdown-Version einer Dokumentationsseite erhältst du, indem du
.md an die URL der Seite anhängst.
Erfahre, wie du den Gesprächszustand bei der Interaktion mit einem Modell verwaltest.
Responses
OpenAI bietet mehrere Möglichkeiten, den Gesprächszustand zu verwalten. So bleiben Informationen über mehrere Nachrichten oder Gesprächsrunden hinweg erhalten.
Wenn GPT-5.5 eine Zwischenmeldung als abschließende Antwort behandelt, prüfe,
ob deine Integration das Feld phase in der Nachricht des Assistenten korrekt beibehält.
Weitere Informationen findest du im Abschnitt Phase-Parameter.
Gesprächszustand manuell verwalten
Jede Anfrage zur Textgenerierung ist unabhängig und zustandslos. Du kannst dennoch Gespräche über mehrere Runden führen, indem du bei der Anfrage zusätzliche Nachrichten als Parameter übergibst. Ein Klopf-Klopf-Witz dient hier als Beispiel.
Mit abwechselnden Nachrichten der Rollen user und assistant übermittelst du dem Modell den bisherigen Gesprächsverlauf in einer einzigen Anfrage.
Um den Kontext zwischen generierten Antworten manuell weiterzugeben, verwende die Ausgabe der vorherigen Modellantwort als Eingabe und hänge sie an deine nächste Anfrage an.
Behalte bei zustandslosen Anfragen an Reasoning-Modelle jedes Element im Array output der Antwort bei. Die Responses API gibt Reasoning-Elemente standardmäßig verschlüsselt zurück. Wenn du die vollständige Ausgabe erneut übergibst, bleiben die Reasoning-Elemente und die Werte des Felds phase in den Nachrichten des Assistenten erhalten. Bei Modellen, die gespeichertes Reasoning unterstützen, kannst du mit reasoning.context: "all_turns" das verfügbare Reasoning aus früheren Gesprächsrunden in die nächste Generierung einbeziehen. Weitere Informationen findest du im Abschnitt Reasoning über mehrere Aufrufe hinweg beibehalten.
Wenn du Reasoning-Elemente erneut übergibst, behalte den Gesprächsverlauf bei, aus dem sie hervorgegangen sind. Im Leitfaden Das Präfix unverändert lassen erfährst du, wie sich Änderungen am Gesprächsverlauf auf das Reasoning auswirken.
Im folgenden Beispiel bitten wir das Modell, einen Witz zu erzählen, und fragen anschließend nach einem weiteren. Wenn du frühere Antworten an neue Anfragen anhängst, kann das Gespräch natürlich verlaufen, weil der Kontext früherer Interaktionen erhalten bleibt.
Gesprächszustand mit der Chat Completions API manuell verwalten.
Mit unseren APIs lässt sich der Gesprächszustand automatisch verwalten. So musst du die Eingaben nicht bei jeder Gesprächsrunde manuell übergeben.
Wir empfehlen dir, stattdessen die Responses API zu verwenden. Sie speichert den Zustand, sodass ein Parameter genügt, um den Kontext über Gespräche hinweg zu verwalten.
Wenn du den Endpunkt für Chat Completions verwendest, musst du den Zustand wie oben beschrieben manuell verwalten.
Conversations API verwenden
Die Conversations API speichert den Gesprächszustand zusammen mit der Responses API in einem langlebigen Objekt mit einer eigenen, dauerhaft gültigen ID. Sobald du ein Gesprächsobjekt erstellt hast, kannst du es in verschiedenen Sitzungen, auf unterschiedlichen Geräten oder in mehreren Jobs weiterverwenden.
Ein Gespräch speichert einzelne Elemente. Dazu können Nachrichten, Tool-Aufrufe, Tool-Ausgaben und weitere Daten gehören.
Bei einem Gespräch über mehrere Runden kannst du conversation bei jeder weiteren Anfrage übergeben. So bleibt der Zustand gespeichert und der Kontext steht für spätere Antworten zur Verfügung, ohne dass du mehrere Antwortelemente miteinander verketten musst.
Gesprächszustand mit der Conversations API und der Responses API verwalten
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Kontext aus der vorherigen Antwort übergeben
Du kannst den Gesprächszustand auch verwalten, indem du den Kontext mit dem Parameter previous_response_id an die nächste Antwort weitergibst. Damit verkettest du Antworten zu einem zusammenhängenden Gesprächsverlauf.
Antworten über mehrere Gesprächsrunden verketten, indem du die ID der vorherigen Antwort übergibst
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id im WebSocket-Modus
Im WebSocket-Modus der Responses API setzt du ein Gespräch mit previous_response_id nach denselben Regeln fort wie im HTTP-Modus. Dabei sendest du wiederholt response.create-Ereignisse über eine dauerhaft offene Socket-Verbindung.
Der Cache der jeweiligen Verbindung hält die jüngsten Antworten im Arbeitsspeicher, damit du das Gespräch mit geringer Latenz fortsetzen kannst. Wenn du stream_id verwendest, kann jeder Stream seine letzte Antwort vorhalten. Welche Antwort als Ausgangspunkt dient, bestimmt weiterhin previous_response_id. Du kannst also den Verlauf an einer Antwort aus einem anderen Stream forken und in einem neuen Stream fortsetzen, solange diese Antwort verfügbar ist. Lässt sich eine ID, die nicht im Cache liegt, nicht auflösen, starte eine neue Gesprächsrunde. Setze dabei previous_response_id auf null und übergib den vollständigen Eingabekontext.
Antwortobjekte werden standardmäßig 30 Tage lang gespeichert. Du kannst sie auf der
Protokollseite im Dashboard ansehen oder
über die API abrufen.
Um die Speicherung zu deaktivieren, setze store beim Erstellen einer Antwort auf false.
Für Gesprächsobjekte und ihre Elemente gilt die Aufbewahrungsfrist von 30 Tagen nicht. Wenn du eine Antwort einem Gespräch zuordnest, bleiben ihre Elemente ohne diese Frist gespeichert.
OpenAI verwendet Daten, die du über die API sendest, nur mit deiner ausdrücklichen Zustimmung zum Trainieren der Modelle von OpenAI. Mehr erfahren.
Auch wenn du previous_response_id verwendest, rechnet die API alle bisherigen Eingabetoken der verketteten Antworten als Eingabetoken ab.
Kontextfenster verwalten
Wenn du weißt, wie Kontextfenster funktionieren, kannst du Antworten zu Gesprächsverläufen verketten und den Zustand über mehrere Modellinteraktionen hinweg verwalten.
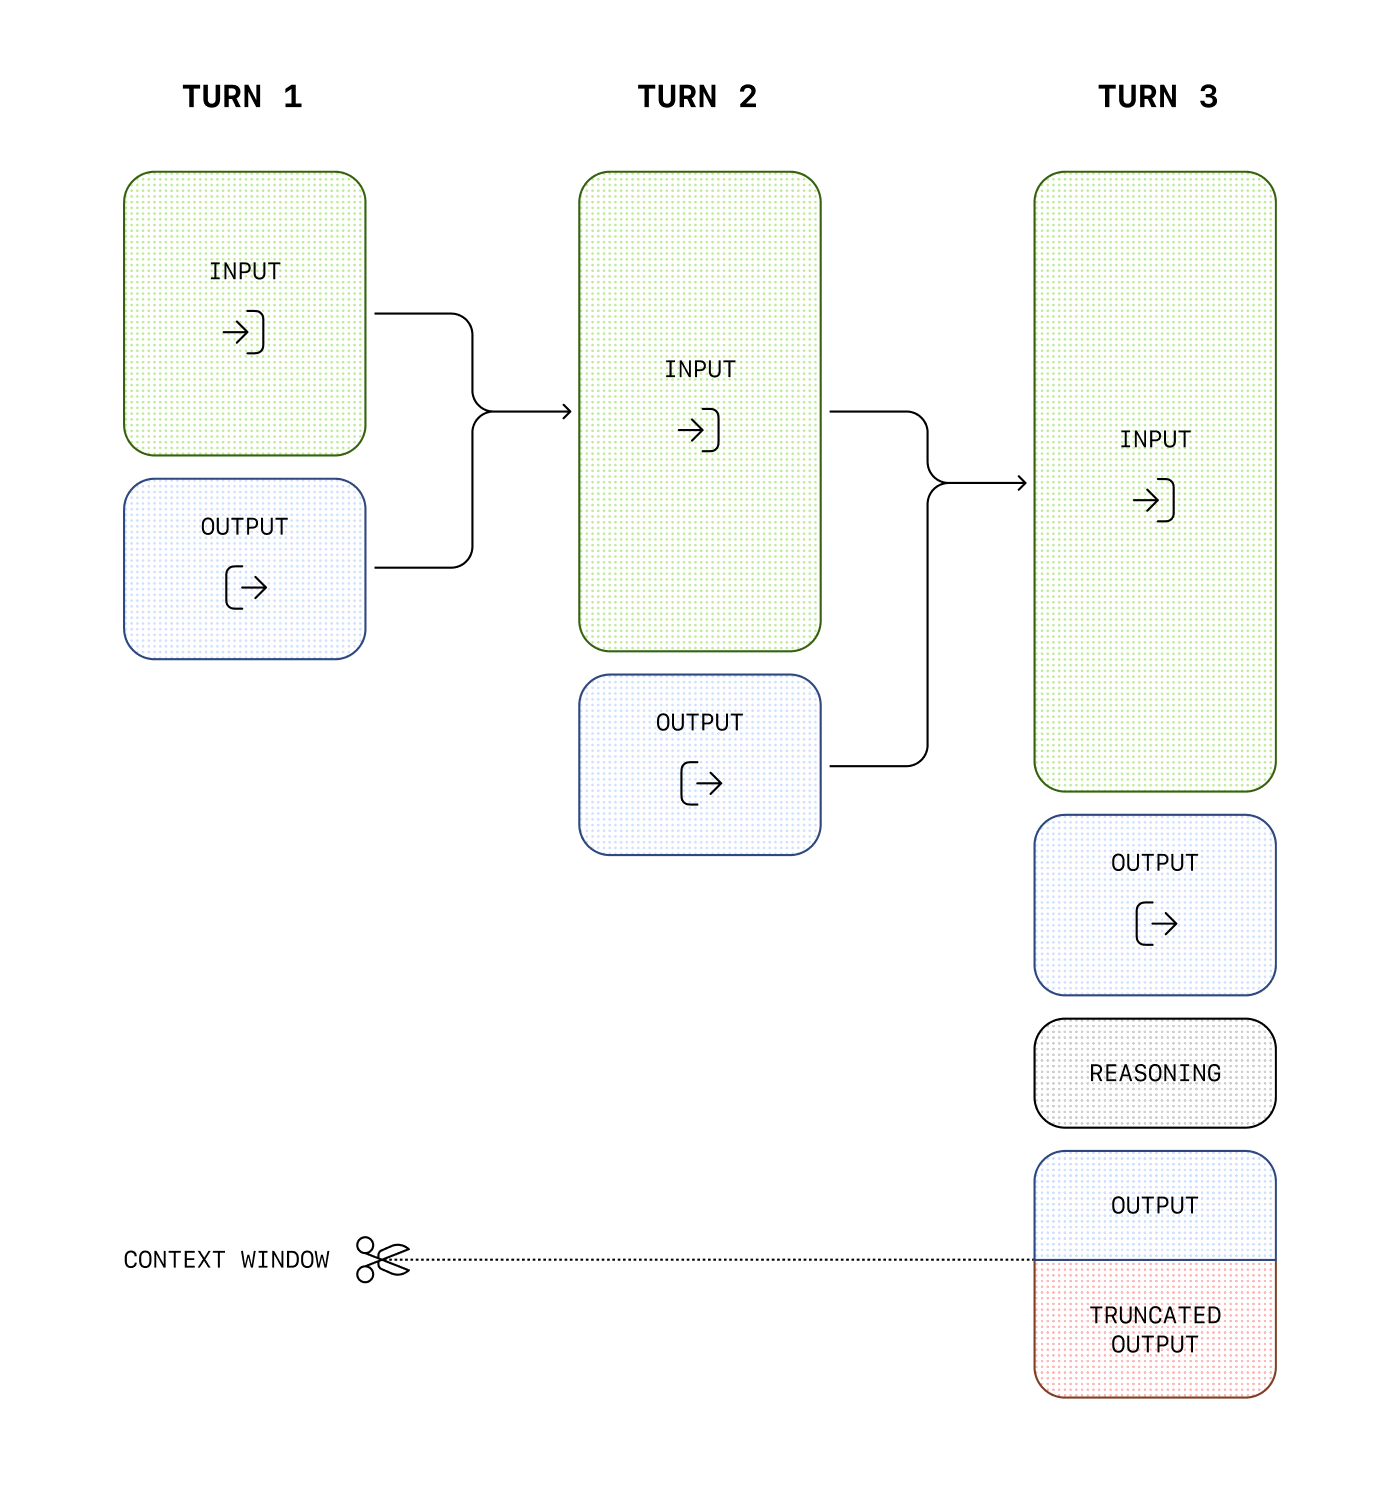
Das Kontextfenster gibt an, wie viele Token du in einer einzelnen Anfrage maximal verwenden kannst. Dazu zählen Eingabe-, Ausgabe- und Reasoning-Token. Wie groß das Kontextfenster deines Modells ist, erfährst du in den Modelldetails.
Kontext bei der Textgenerierung verwalten
Wenn deine Eingaben komplexer werden oder du mehr Gesprächsrunden einbeziehst, musst du sowohl die Obergrenze für Ausgabetoken als auch die Größe des Kontextfensters berücksichtigen. Der Umfang der Ein- und Ausgaben eines Modells wird in Token gemessen. Modelle zerlegen Eingaben in Token, um Inhalt und Absicht zu analysieren, und setzen Token zu zusammenhängenden Ausgaben zusammen. Jedes Modell kann bei einer Anfrage zur Textgenerierung nur eine begrenzte Anzahl von Token verarbeiten.
Ausgabetoken sind die Token, die ein Modell als Antwort auf einen Prompt generiert. Für jedes Modell gelten eigene Obergrenzen für Ausgabetoken. Beispielsweise kann gpt-4o-2024-08-06 maximal 16.384 Ausgabetoken generieren.
Das Kontextfenster gibt an, wie viele Token insgesamt für Ein- und Ausgabe zur Verfügung stehen. Bei einigen Modellen zählen auch Reasoning-Token dazu. Vergleiche die Kontextfenstergrößen unserer Modelle. Beispielsweise hat gpt-4o-2024-08-06 ein Kontextfenster von insgesamt 128.000 Token.
Ein umfangreicher Prompt kann das Kontextfenster des Modells überschreiten, etwa wenn du zusätzlichen Kontext, Daten oder Beispiele mitgibst. Dadurch kann die Ausgabe abgeschnitten werden.
Mit dem Tokenizer, der auf der Bibliothek tiktoken basiert, kannst du sehen, aus wie vielen Token eine bestimmte Zeichenfolge besteht.
Wenn du beispielsweise eine API-Anfrage an Chat Completions mit dem Modell o1 stellst, zählen folgende Token zum Kontextfenster:
Eingabetoken (Eingaben, die du im Array messages an Chat Completions übergibst)
Ausgabetoken (Token, die das Modell als Antwort auf deinen Prompt generiert)
Reasoning-Token (Token, mit denen das Modell seine Antwort plant)
Wenn du beispielsweise eine Anfrage an die Responses API mit einem Reasoning-fähigen Modell wie dem Modell o1 stellst, zählen folgende Token zum Kontextfenster:
Eingabetoken (Eingaben, die du im Array input an die Responses API übergibst)
Ausgabetoken (Token, die das Modell als Antwort auf deinen Prompt generiert)
Reasoning-Token (Token, mit denen das Modell seine Antwort plant)
Generiert das Modell mehr Token, als in das Kontextfenster passen, kann die API die Antwort abschneiden.
Mit dem Tokenizer kannst du abschätzen, wie viele Token deine Nachrichten benötigen.
Kontextverdichtung
Eine ausführliche Anleitung findest du jetzt im Leitfaden zur
Kontextverdichtung.
Wie du /responses mit context_management und compact_threshold verwendest, erfährst du im Abschnitt
Serverseitige Kontextverdichtung.
Weitere konkrete Beispiele und Anwendungsfälle findest du im OpenAI Cookbook. Diese Anleitungen zeigen dir, wie du die Fähigkeiten der Modelle mithilfe der APIs erweiterst: