
Jetzt, da GPT-5 verfügbar ist, möchten wir erklären, wie du das Modell am besten integrierst: über die Responses API. Dazu lohnt sich ein Blick darauf, warum wir Responses eigens für Reasoning-Modelle und künftige Anwendungen mit Agenten entwickelt haben.
Bei jeder Generation von OpenAI-APIs stand dieselbe Frage im Mittelpunkt: Wie kannst du bei der Entwicklung möglichst einfach mit Modellen kommunizieren und dabei ihre Möglichkeiten voll ausschöpfen?
Beim Entwurf unserer APIs haben wir uns immer daran orientiert, wie die Modelle selbst funktionieren. Unser erster Endpunkt /v1/completions war einfach, bot aber wenig Spielraum. Du hast dem Modell einen Prompt gegeben, und es hat deinen Gedanken zu Ende geführt. Mit Techniken wie Few-Shot-Prompting konnte man versuchen, das Modell dazu zu bringen, JSON auszugeben oder Fragen zu beantworten. Diese Modelle konnten allerdings deutlich weniger, als wir heute gewohnt sind.
Dann kamen RLHF und ChatGPT, und die Ära des Nachtrainings begann. Plötzlich konnten Modelle mehr als nur einen angefangenen Text fortsetzen. Sie antworteten, wie man es in einem Gespräch erwarten würde. Dafür entwickelten wir /v1/chat/completions (an einem einzigen Wochenende, wie inzwischen weithin bekannt ist). Rollen wie system, user und assistant gaben eine Struktur vor, mit der sich schnell Chatoberflächen mit eigenen Anweisungen und passendem Kontext entwickeln ließen.
Unsere Modelle wurden immer leistungsfähiger. Bald konnten sie sehen, hören und sprechen. Die Ende 2023 eingeführten Funktionsaufrufe entwickelten sich zu einer unserer beliebtesten Funktionen. Etwa zur gleichen Zeit veröffentlichten wir die Betaversion der Assistants API. Sie war unser erster Versuch, eine Schnittstelle zu entwickeln, über die Agenten mit gehosteten Tools wie Code Interpreter und der Dateisuche selbstständig arbeiten konnten. Bei einigen kam sie gut an. Im Vergleich zu Chat Completions ließ ihr API-Design aber weniger Spielraum und erschwerte den Einstieg. Deshalb fand sie nie breite Anwendung.
Ende 2024 war klar, dass wir diese Ansätze zusammenführen mussten. Wir brauchten eine Schnittstelle, die so zugänglich war wie Chat Completions, so leistungsfähig wie Assistants und zugleich auf multimodale Modelle und Reasoning-Modelle zugeschnitten. So entstand /v1/responses.
/v1/responses bildet die Schleife, in der ein Agent arbeitet
Mit Chat Completions hattest du eine einfache Chat-Schnittstelle für den rundenweisen Austausch mit dem Modell. Responses gibt dir eine strukturierte Schleife, in der das Modell Reasoning und Aktionen verbindet. Stell dir vor, du beauftragst eine Detektivin. Du gibst ihr Beweismaterial, sie ermittelt, zieht bei Bedarf Fachleute (Tools) hinzu und berichtet dir schließlich von ihren Ergebnissen. Ihre persönlichen Notizen (den Reasoning-Zustand) behält sie von einem Ermittlungsschritt zum nächsten. Sie gibt sie aber nie an dich weiter.
Hier spielen Reasoning-Modelle ihre Stärke aus: Responses erhält den Reasoning-Zustand des Modells über mehrere Gesprächsrunden hinweg. Bei Chat Completions geht das Reasoning zwischen Aufrufen verloren. Das ist, als würde die Detektivin jedes Mal alle Hinweise vergessen, sobald sie den Raum verlässt. Bei Responses bleibt das Notizbuch offen. Das Modell kann in der nächsten Runde an seine bisherigen Denkschritte anknüpfen. Das zeigt sich in Benchmarks (5 % besser bei TAUBench), in einer effizienteren Cache-Nutzung und in geringeren Latenzen.
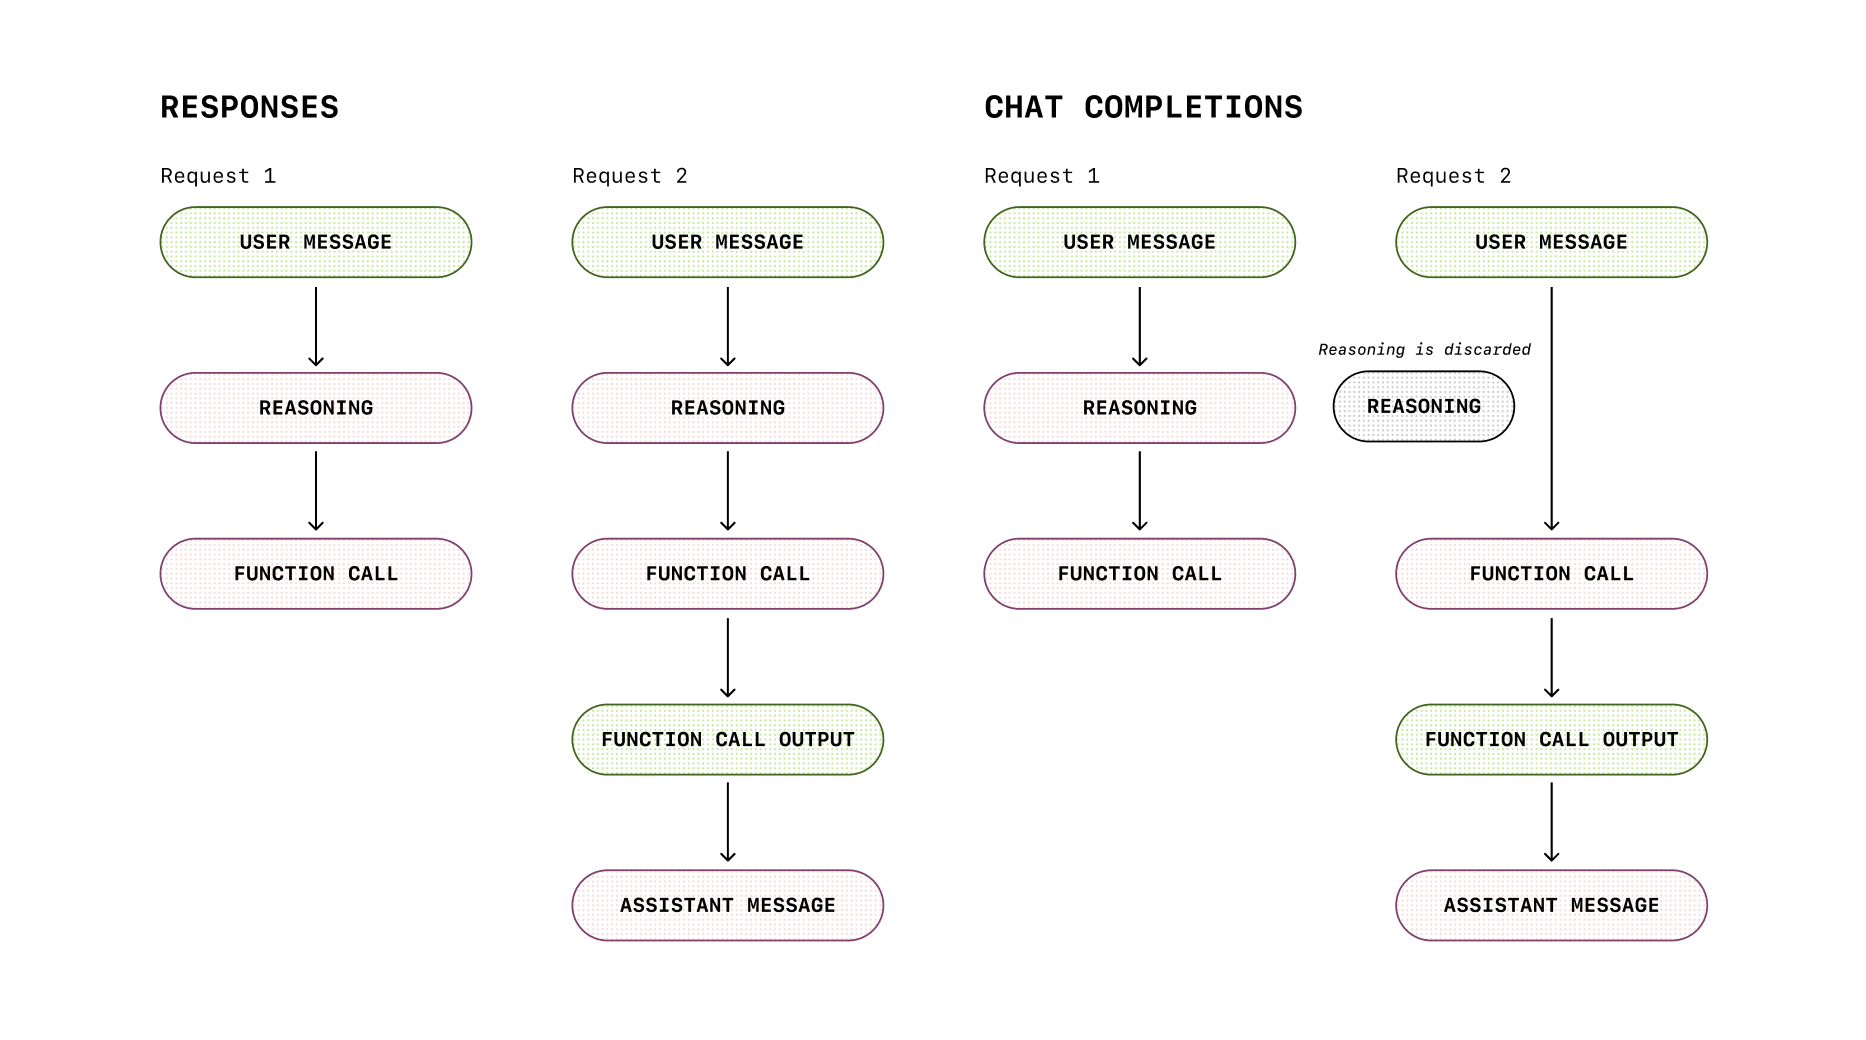
Responses kann außerdem mehrere Ausgabeelemente zurückgeben. Du siehst, was das Modell gesagt und was es getan hat. Anhand von Tool-Aufrufen, strukturierten Ausgaben und Zwischenschritten kannst du den Ablauf nachvollziehen. Das ist, als bekämst du neben der fertigen Ausarbeitung auch den Notizzettel mit den Nebenrechnungen. Das hilft beim Debuggen, bei Audits und bei der Entwicklung von Benutzeroberflächen, die mehr als das Endergebnis zeigen.
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},Welche Arbeit dir gehostete Tools abnehmen
Als wir Funktionsaufrufe einführten, fiel uns auf, wie häufig das Modell für zwei Aufgaben zum Einsatz kam. Es rief APIs auf und durchsuchte Dokumentbestände, um Informationen aus externen Quellen einzubeziehen. Diesen zweiten Ansatz kennen wir heute als RAG. Gerade am Anfang ist es aufwendig und teuer, selbst eine Pipeline für den Abruf solcher Informationen zu entwickeln. Mit Assistants führten wir unsere ersten gehosteten Tools ein: file_search und code_interpreter. Damit konnte das Modell RAG nutzen und Code schreiben, um die Aufgaben zu lösen, die du ihm gestellt hast. In Responses sind Websuche, Bildgenerierung und MCP hinzugekommen. Gehostete Tools wie Code Interpreter oder über MCP angebundene Tools werden serverseitig ausgeführt. Dadurch entfällt für jeden solchen Aufruf der Umweg über dein eigenes Backend. Das senkt die Latenz und die Kosten für die Kommunikation zwischen Client und Server.
Wie der Reasoning-Zustand sicher erhalten bleibt
Warum betreiben wir so viel Aufwand, um die unverarbeitete Gedankenkette (CoT) des Modells zu verbergen? Wäre es nicht einfacher, sie offenzulegen und es den Clients zu überlassen, sie wie andere Modellergebnisse zu behandeln? Die kurze Antwort: Wer die unverarbeitete Gedankenkette offenlegt, macht unter Umständen auch Halluzinationen oder schädliche Inhalte sichtbar, die in der endgültigen Antwort gar nicht vorkämen. Für OpenAI entstehen außerdem Wettbewerbsrisiken.
Als wir Ende letzten Jahres o1-preview veröffentlichten, schrieb unser Chief Scientist Jakub Pachocki in unserem Blog:
Wir glauben, dass eine verborgene Gedankenkette eine einzigartige Möglichkeit bietet, Modelle zu überwachen. Wenn sie den tatsächlichen Denkprozess des Modells getreu und verständlich wiedergibt, können wir gewissermaßen seine „Gedanken lesen“ und nachvollziehen, wie es zu einem Ergebnis kommt. Künftig könnten wir die Gedankenkette zum Beispiel auf Hinweise darauf untersuchen, dass das Modell versucht, die Person zu manipulieren, die es nutzt. Damit das funktioniert, muss das Modell seine Gedanken unverfälscht ausdrücken können. Wir können es deshalb nicht darauf trainieren, seine Gedankenkette an Richtlinien oder an den Vorlieben der Menschen auszurichten, die es nutzen. Eine Gedankenkette, die nicht an unseren Zielen ausgerichtet ist, möchten wir ihnen aber auch nicht unmittelbar zeigen.
Responses löst das auf zwei Arten:
- Die API bewahrt den Reasoning-Zustand intern auf. Er ist verschlüsselt und bleibt für den Client verborgen.
- Über
previous_response_idoder Reasoning-Elemente lässt sich das Reasoning sicher fortsetzen, ohne die unverarbeitete Gedankenkette offenzulegen.
Warum /v1/responses die beste Grundlage für deine Anwendungen ist
Wir haben Responses so entwickelt, dass die API den Zustand erhält, multimodale Inhalte verarbeitet und effizient arbeitet.
- Tools für Agenten: Mit der Responses API kannst du Tools wie Dateisuche, Bildgenerierung, Code Interpreter und MCP einfach in die Workflows deiner Agenten einbinden und ihnen damit mehr Möglichkeiten geben.
- Der Zustand bleibt standardmäßig erhalten. Die API erfasst Gespräche und den Zustand der Tools automatisch. Das vereinfacht Reasoning und Workflows über mehrere Gesprächsrunden erheblich. Wenn du GPT-5 über Responses integrierst, schneidet es bei TAUBench um 5 % besser ab als mit Chat Completions. Der Unterschied ergibt sich allein daraus, dass das Modell an sein bisheriges Reasoning anknüpfen kann.
- Von Grund auf multimodal. Text, Bilder, Audio und Funktionsaufrufe sind gleichberechtigt. Statt eine Text-API nachträglich um weitere Modalitäten zu ergänzen, haben wir sie von Anfang an eingeplant. Das ist wie bei einem Haus, für das man gleich genügend Schlafzimmer vorsieht.
- Geringere Kosten, bessere Leistung. Interne Benchmarks zeigen, dass Responses den Cache im Vergleich zu Chat Completions um 40–80 % besser nutzt. Das bedeutet kürzere Latenzzeiten und geringere Kosten.
- Besseres API-Design: Aus der Arbeit an der Chat Completions API und der Assistants API haben wir viel gelernt. In die Responses API und das SDK sind deshalb viele kleine Verbesserungen eingeflossen, die dir die Entwicklung erleichtern:
- Semantische Streaming-Ereignisse.
- Polymorphie mit Typkennzeichnung im Objekt selbst.
- Hilfsfunktionen für
output_textim SDK (der Zugriff überchoices.[0].message.contententfällt). - Übersichtlichere Gruppierung der Parameter für multimodale Inhalte und Reasoning.
Was wird aus Chat Completions?
Chat Completions bleibt verfügbar. Wenn es für dich gut funktioniert, nutze es weiter. Wenn du aber Reasoning über mehrere Aufrufe hinweg fortsetzen, ganz selbstverständlich mit verschiedenen Modalitäten arbeiten und Agenten ohne Behelfslösungen in einer Schleife agieren lassen möchtest, ist Responses der richtige nächste Schritt.
Ausblick
So wie Chat Completions seinerzeit Completions abgelöst hat, erwarten wir, dass Responses zur Standardschnittstelle für die Entwicklung mit OpenAI-Modellen wird. Für einfache Aufgaben ist die API unkompliziert. Für anspruchsvolle Anwendungen bietet sie die nötige Leistung, und sie ist flexibel genug für die Anforderungen, die der nächste grundlegende Wandel mit sich bringt.
Auf dieser API werden wir unsere Arbeit in den kommenden Jahren aufbauen.