Choisissez votre API pour comprendre comment elle mesure l’utilisation et découvrir comment maîtriser les coûts de votre application vocale.
Utilisation et coûts de GPT-Live
GPT-Live sépare la conversation vocale du backend qui assure le raisonnement et exécute les outils. Estimez les deux coûts séparément. Le coût de la session vocale dépend de sa durée, tandis que celui du backend dépend des modèles et des outils utilisés.
Coût des sessions vocales
GPT-Live facture les sessions vocales à la seconde, au tarif en vigueur pour le modèle. La durée de la session n’est pas arrondie à la minute supérieure.
La durée de la session active comprend les moments où l’utilisateur parle, où l’assistant parle, où tous deux gardent le silence et où le backend travaille.
Pour vos estimations, comptez toute la durée de la session active, du démarrage à la fermeture. Utilisez la durée indiquée par l’API plutôt que de chronométrer uniquement l’audio diffusé. Couper le microphone ne ferme pas la session. Une fois la conversation terminée, fermez la session et récupérez son relevé d’utilisation final.
Consultez les tarifs de l’API pour connaître les prix des modèles et des outils utilisés par le backend.
Frais d’initialisation WebRTC
Lorsqu’une requête POST /v1/live/sessions crée une session WebRTC, 15 secondes de session vocale sont facturées pendant l’initialisation. Une fois la session démarrée, ce montant est déduit des frais calculés sur sa durée. Pour estimer son coût, n’ajoutez pas 15 secondes à la durée de la session en cours.
Par exemple, les 90 secondes de la session décrite ci-dessous comprennent déjà les 15 secondes facturées à l’initialisation. La durée facturée est donc de 90 secondes et non de 105. Tenez compte des frais de création de session lorsque vous évaluez le coût des reconnexions ou des applications qui créent des sessions avant que l’utilisateur soit prêt à parler.
Coûts du backend
Les appels du backend sont facturés séparément de la session vocale, comme dans les applications sans interface vocale. Comptabilisez les tokens d’entrée et de sortie du modèle, les tokens d’entrée mis en cache si le modèle le permet, ainsi que les frais éventuels liés aux images ou aux outils. Si votre application fait appel à d’autres services, incluez également leur coût dans votre estimation.
Vous pouvez optimiser ces traitements indépendamment de l’interface vocale. Consultez le guide d’optimisation des coûts pour réduire le nombre de requêtes et la consommation de tokens. Pour les modèles du backend compatibles avec la mise en cache des prompts, placez les instructions réutilisables, les définitions d’outils et les autres contenus stables au début du prompt.
Les choix que vous faites pour le backend peuvent aussi modifier la durée de la conversation. Comparez les coûts totaux si une optimisation prolonge l’attente de l’utilisateur ou influe sur la capacité de l’assistant à mener la tâche à bien de façon fiable.
Estimation du coût d’une conversation
Pour une conversation comportant une seule session vocale :
Coût total = (secondes de session vocale facturables ÷ 60 × tarif vocal à la minute) + coûts du backend
Par exemple, avec un tarif vocal indicatif de 0,05 $ par minute, une session vocale de 90 secondes coûte 0,075 $. Si les frais liés au modèle et aux outils du backend s’élèvent à 0,02 $, la conversation coûte 0,095 $ :
| Poste | Calcul | Coût |
|---|---|---|
| Session vocale | 90 secondes ÷ 60 × 0,05 $ | 0,075 $ |
| Traitements du backend | Coût total du modèle et des outils | 0,02 $ |
| Total de la conversation | 0,075 $ + 0,02 $ | 0,095 $ |
Les tarifs et le coût du backend ci-dessus sont donnés à titre d’exemple. Utilisez le tarif vocal en vigueur, les données d’utilisation mesurées sur votre backend et les tarifs applicables aux modèles et aux outils. Si la tâche s’étend sur plusieurs sessions vocales, additionnez leurs durées et comptabilisez les traitements effectués par le backend entre les sessions.
Stratégies d’optimisation
Aidez l’utilisateur à terminer sa tâche en limitant les échanges et les temps d’attente inutiles. Conservez les confirmations et les vérifications nécessaires à la tâche.
Fournissez le contexte pertinent avant la session
Avant de démarrer la session vocale, rassemblez les informations que votre application est déjà autorisée à utiliser. Par exemple, un assistant chargé du suivi d’une commande peut disposer dès le départ de son numéro et de son statut actuel. L’utilisateur n’a alors besoin ni de répéter ces informations ni d’attendre une nouvelle recherche.
Gardez ce contexte à jour et limitez-le aux informations pertinentes pour la tâche. Donnez au modèle vocal les informations nécessaires à la conversation et conservez les dossiers détaillés et les workflows dans le backend. Consultez la configuration des sessions et le guide sur la délégation et les outils.
Réduisez le temps d’attente lié aux outils
Réduire l’attente peut améliorer l’expérience utilisateur et diminuer le coût des sessions vocales. Supposons par exemple que votre backend utilise gpt-5.6-luna en mode Rapide et exécute en parallèle les appels d’outils indépendants. Si ces optimisations permettent à l’utilisateur de terminer sa tâche et de fermer la session vocale une minute plus tôt, vous économisez 0,05 $ sur les frais de la session vocale. Le coût total diminue si le surcoût du backend est inférieur à cette économie.
Vous pouvez aussi lancer une recherche spéculative à partir de fragments de transcription avant de recevoir un événement de délégation. Lorsque vous mesurez les coûts du backend, comptabilisez aussi les traitements spéculatifs dont le résultat n’a pas servi.
Consultez la section Réduisez la latence du backend pour optimiser le modèle, les connexions, le streaming et les outils. À l’aide des évaluations d’agents vocaux, vérifiez le délai avant que l’utilisateur entende une réponse utile et mesurez le taux de réussite des tâches.
Fermez la session pendant les tâches de longue durée
L’interface vocale et le backend géré par votre application peuvent fonctionner indépendamment. Avec la délégation côté client, le processus de traitement du backend peut continuer à s’exécuter que la session vocale soit ouverte ou fermée. Enregistrez l’état de la tâche et le contexte de la conversation avant de fermer la session vocale.
Pour configurer le délai d’inactivité, définir ce qui déclenche le redémarrage et restaurer le contexte, consultez la section Fermez les sessions inactives et reprenez la conversation.
Dans le cas d’un agent ambiant, fermez la session vocale pendant que le backend exécute une tâche de longue durée, par exemple une tâche de programmation en mode objectif. Proposez un bouton Reprendre la conversation pour ouvrir une nouvelle session vocale au retour de l’utilisateur. Vous pouvez aussi utiliser un événement de fin de tâche émis par le backend pour démarrer une nouvelle session et avertir l’utilisateur que le résultat est prêt.
Pour reprendre la conversation, démarrez une nouvelle session en plaçant le contexte enregistré et le résultat vérifié de la tâche dans input. Par exemple, envoyez cet événement de démarrage sur une nouvelle connexion WebSocket :
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}Attendez l’événement session.started avant de transmettre l’audio en continu. La section Initialisez une session avec une conversation antérieure décrit le format d’historique pris en charge.
Si la session précédente a été enregistrée avec store: true, vous pouvez également forker cette session. Quelle que soit la méthode utilisée, conservez dans votre application l’état vérifié de la tâche exécutée par le backend.
Fermer la session permet d’économiser 0,05 $ par minute d’inactivité. Mettez cette économie en regard des frais de reconnexion et de l’interruption que subit l’utilisateur.
Choisissez le modèle adapté au backend
Commencez par sélectionner les modèles qui répondent aux exigences de précision et de fiabilité de la tâche. Comparez ensuite le coût total de la conversation en tenant compte de la durée de la session vocale, de l’utilisation du modèle, des appels d’outils et des nouvelles tentatives. Le guide de sélection des modèles explique comment arbitrer entre ces critères.
Un modèle de backend plus grand peut revenir moins cher au total s’il termine la tâche plus vite et que les économies sur la session vocale dépassent le surcoût des tokens. Un modèle moins cher peut revenir plus cher au total s’il prend plus de temps, répète des appels d’outils ou échoue.
Comparez le coût par tâche réussie, le taux de réussite et le temps nécessaire pour terminer la tâche. Incluez dans le total les tentatives infructueuses et les nouvelles tentatives pour éviter de favoriser une configuration moins chère simplement parce qu’elle accomplit moins de travail. Pour préparer votre comparaison, consultez l’exemple du Cookbook sur l’évaluation des agents vocaux.
Suivi de l’utilisation réelle
Pour chaque session, enregistrez séparément la durée de la session vocale et les données d’utilisation du backend. GPT-Live indique la durée cumulée de la session vocale en secondes :
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}Chaque mise à jour remplace le relevé de durée précédent. N’additionnez pas ces relevés. Après avoir envoyé session.close, continuez à recevoir les événements jusqu’à session.closed, puis enregistrez une seule fois la valeur finale de usage.seconds fournie par cet événement. Suivez la procédure de fermeture propre pour que votre application récupère les données d’utilisation finales avant de se déconnecter.
Pour la délégation via Responses, récupérez le champ usage de la réponse du backend dans les événements response.completed imbriqués dans response.event. Utilisez l’identifiant de chaque réponse du backend pour ne la compter qu’une fois. Conservez le détail des tokens d’entrée, de sortie et mis en cache afin d’appliquer les tarifs du modèle. Si votre application exécute des traitements indépendants sur le backend, recueillez aussi les données d’utilisation des requêtes correspondantes.
Comparez les coûts totaux estimés et réels sur un échantillon représentatif de conversations. Comptabilisez séparément les appels de modèle réservés aux évaluations et ceux de l’application. Examinez les coûts en tenant compte du taux de réussite des tâches.
Coûts de la Realtime API
Ce guide explique comment la Realtime API facture l’utilisation et comment optimiser les coûts. Les sessions d’agents vocaux cumulent des tokens d’entrée et de sortie pour le texte, l’audio et les images. Les sessions de traduction et de transcription en streaming sont facturées selon la durée de l’audio. Les tarifs varient selon le modèle. Consultez la page du modèle pour connaître ses tarifs, par exemple celle de gpt-realtime-2, de gpt-realtime-translate, de gpt-realtime-whisper ou de gpt-realtime.
Une session conversationnelle de la Realtime API se compose de plusieurs tours de conversation. À chaque tour, l’utilisateur fournit une entrée qui déclenche une Response dans laquelle le modèle produit sa sortie. Le serveur tient à jour une Conversation, une liste d’Items qui constituent l’entrée du tour suivant. Lorsqu’une Response est renvoyée, sa sortie est automatiquement ajoutée à la Conversation.
Les sessions de traduction et de transcription utilisent une autre architecture de streaming. Le client transmet l’audio en continu et reçoit l’audio traduit, les fragments successifs de transcription ou les événements de transcription à mesure que l’audio source arrive. Ces sessions ne suivent pas le cycle de vie habituel d’une Response. Pour estimer et suivre leur coût, utilisez les tarifs à la durée plutôt que le nombre de tokens par Response.
Coût par Response
La Realtime API comptabilise les frais à la création d’une Response, selon le nombre de tokens d’entrée et de sortie (sauf pour les frais de transcription de l’entrée, décrits plus bas). La bande passante réseau et les connexions sont actuellement gratuites. Vous pouvez créer une Response manuellement ou laisser l’API la créer automatiquement si la détection de l’activité vocale (VAD) est activée. La VAD filtre les passages sans parole. Ils ne comptent donc pas comme tokens d’entrée, sauf si le client les ajoute manuellement à la conversation.
Pour chaque Response, la conversation entière est envoyée au modèle. La sortie d’un tour est ajoutée sous forme d’Items à la Conversation côté serveur et fait partie de l’entrée des tours suivants. Les tours coûtent donc plus cher à mesure que la session avance.
Nos outils de tokenisation permettent d’estimer le coût des tokens de texte. Dans les messages de l’utilisateur, comptez un token audio pour 100 ms d’audio. Dans ceux de l’assistant, comptez un token audio pour 50 ms. Le décompte inclut des tokens spéciaux en plus du contenu du message, ce qui explique de légers écarts. Par exemple, un message utilisateur dont le contenu représente 10 tokens de texte peut compter pour 12 tokens.
Exemple
Prenons une session de la Realtime API comportant plusieurs tours pour illustrer le coût des tokens.
Au premier tour, nous ajoutons 100 tokens d’instructions et un message utilisateur de 20 tokens audio (par exemple, ajouté par la VAD lorsque l’utilisateur parle), soit 120 tokens d’entrée. La création d’une Response génère un message de l’assistant en sortie contenant 20 tokens audio et 10 tokens de texte.
Nous lançons ensuite un deuxième tour avec un nouveau message audio de l’utilisateur. Quels tokens seront comptabilisés pour ce deuxième tour ? La Conversation contient alors les instructions initiales, le premier message utilisateur, le message produit par l’assistant au premier tour et le deuxième message utilisateur (25 tokens audio). Ce tour compte 110 tokens de texte et 64 tokens audio en entrée, auxquels s’ajoutent les tokens de sortie du nouveau message de l’assistant.
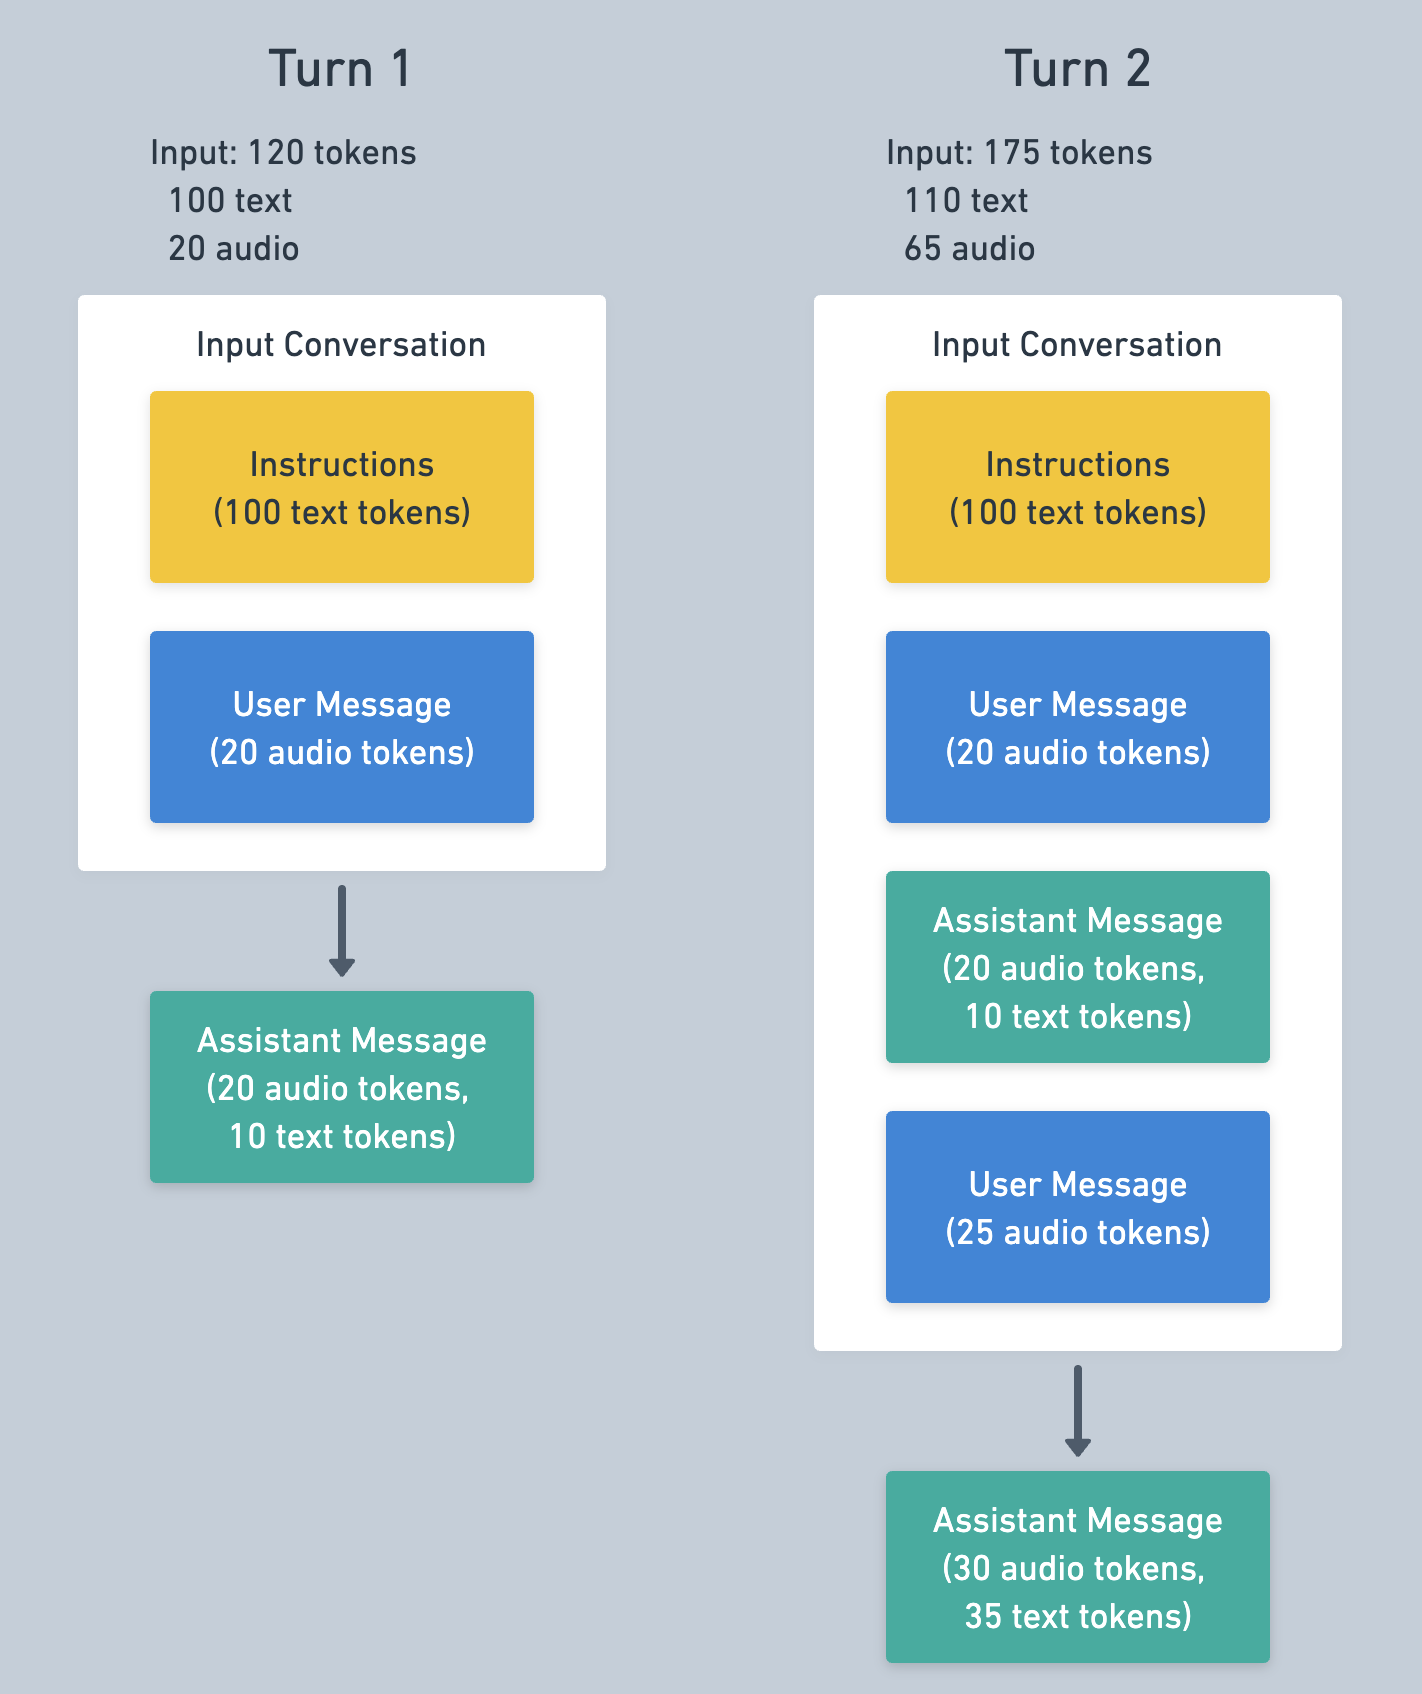
Les messages du premier tour seront probablement en cache au deuxième tour, ce qui réduit le coût de l’entrée. La section sur la mise en cache ci-dessous donne plus de détails.
L’événement response.done indique le nombre de tokens utilisés pour une Response, comme dans l’exemple suivant.
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}Coût de la transcription en entrée
Si vous activez la transcription en entrée, la Realtime API la facture séparément. Cette transcription utilise un modèle et une grille tarifaire différents de ceux du modèle parole à parole. Utilisez gpt-transcribe pour la transcription d’un tour validé. Elle commence une fois que l’audio a été écrit dans le tampon d’entrée audio et que le contenu du tampon a été validé.
Récupérez les données d’utilisation de la transcription en entrée dans l’événement conversation.item.input_audio_transcription.completed. Les champs dépendent du modèle de transcription : gpt-transcribe est facturé à la durée de l’audio, tandis que les modèles facturés au token renvoient des nombres de tokens. Voici un exemple de relevé à la durée :
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}Mise en cache
La Realtime API prend en charge la mise en cache des prompts. Cette optimisation s’applique automatiquement et peut réduire considérablement le coût des tokens d’entrée lors des sessions à plusieurs tours. Lorsque les tokens d’entrée d’une Response correspondent à ceux d’une Response précédente, l’API tente de les réutiliser depuis le cache, sans garantie.
Pour maximiser la proportion de tokens servis depuis le cache, évitez de modifier l’historique de la session. Supprimer ou modifier du contenu réduit la partie de l’entrée qui correspond encore à la version précédente : seul le préfixe qui précède la modification reste réutilisable. Les instructions et les définitions d’outils figurent au début de la conversation. Les modifier en cours de session réduit donc la proportion de tokens servis depuis le cache aux tours suivants.
Troncature
Lorsque la conversation dépasse la limite de tokens d’entrée du modèle, le serveur la tronque en retirant des messages de l’entrée de la Response, en commençant par les plus anciens. Un modèle doté d’une fenêtre de contexte de 32 k tokens et d’un maximum de 4 096 tokens de sortie peut inclure jusqu’à 28 224 tokens dans le contexte avant la troncature.
Pour maîtriser la consommation de tokens et les coûts, les clients peuvent définir une fenêtre de tokens inférieure au maximum du modèle. Le paramètre token_limits.post_instructions règle cette limite si vous configurez la troncature avec le type retention_ratio, comme dans l’exemple ci-dessous. Il fixe le nombre maximal de tokens d’entrée d’une Response, hors tokens d’instructions. Si vous réglez post_instructions sur 1 000, les éléments qui dépassent la limite de 1 000 tokens d’entrée ne sont pas envoyés au modèle pour générer la Response.
La troncature invalide le cache près du début de la conversation. Si elle intervient à chaque tour, très peu de tokens seront servis depuis le cache. Pour espacer les troncatures, les clients peuvent libérer davantage de place en supprimant plus de messages que le strict nécessaire. Le paramètre session.truncation.retention_ratio permet de régler ce comportement. Par défaut, le serveur utilise la valeur 1.0 et ne retire que les éléments nécessaires. Avec une valeur de 0.8, la troncature conserve 80 % du maximum et libère 20 % d’espace supplémentaire.
Pour réduire le coût par session de la Realtime API avec un modèle donné, nous recommandons d’abaisser la limite de tokens et de définir un retention_ratio inférieur à 1, comme dans l’exemple suivant. Cette économie peut réduire la quantité d’informations dont le modèle dispose à chaque tour.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}Vous pouvez aussi désactiver complètement la troncature, comme ci-dessous. Le serveur renvoie alors une erreur si la Conversation est trop longue pour créer une Response. Cette option peut vous convenir si vous souhaitez gérer manuellement la taille de la Conversation.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}Autres stratégies d’optimisation
Utilisation d’un modèle mini
Les modèles Realtime parole à parole existent en version « standard » et en version mini, nettement moins chère. Le compromis porte généralement sur la capacité du modèle à suivre les instructions et à effectuer des appels de fonction, deux tâches pour lesquelles la version mini est moins performante. Nous recommandons de tester d’abord votre application avec le modèle le plus grand, d’affiner l’application et le prompt, puis d’essayer de réduire les coûts avec le modèle mini.
Modification de la Conversation
La troncature s’effectue automatiquement sur le serveur, mais vous pouvez aussi maîtriser les coûts en modifiant la Conversation manuellement. L’API donne au client le contrôle complet de la Conversation côté serveur : il peut y ajouter des éléments ou en supprimer à tout moment.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}Supprimer les anciens messages réduit le nombre de tokens d’entrée et leur coût. Pour éviter de perdre des informations importantes, une pratique courante consiste à remplacer ces messages par un résumé. Utilisez un message conversation.item.delete pour supprimer un élément de la Conversation, comme dans l’exemple ci-dessus, et un message conversation.item.create pour en ajouter un.
Estimation des coûts
La façon dont la Realtime API comptabilise les tokens peut rendre les coûts difficiles à prévoir. Dans le Realtime Playground, testez les prompts et les fonctions que vous comptez utiliser, puis mesurez la consommation de tokens sur une session représentative. Vous trouverez le nombre de tokens utilisés dans l’onglet Logs du Realtime Playground, à côté de l’identifiant de la session.