
En septiembre de 2025, OpenAI presentó GPT-5-Codex, la primera versión de GPT-5 optimizada para la codificación con agentes. En diciembre de 2025 lanzamos la versión 5.2. Fue entonces cuando la gente empezó a confiar en los agentes autónomos de programación. En particular, vimos que el modelo podía seguir instrucciones de forma confiable durante mucho más tiempo.
Quería poner a prueba ese límite. Así que le di a Codex un repositorio vacío, acceso completo y una sola tarea: crear una herramienta de diseño desde cero. Luego lo dejé trabajar con GPT-5.3-Codex y la opción de razonamiento “Muy alta”. Codex trabajó unas 25 horas sin interrupciones, consumió alrededor de 13 millones de tokens y generó unas 30 000 líneas de código.
Fue un experimento, no un despliegue en producción. Aun así, Codex respondió bien en los aspectos que importan en las tareas de larga duración: siguió las especificaciones, se mantuvo enfocado, ejecutó verificaciones y corrigió los fallos sobre la marcha.

Así es una sesión de larga duración con Codex
Le pedí a Codex que generara una página con el resumen de los datos de la sesión:

Aquí se ven las estadísticas de la sesión en la CLI y el consumo de tokens:

Estas capturas muestran qué está cambiando en la codificación con agentes: cada vez importa más el horizonte temporal, además de lo que el agente puede resolver en un solo intento.
Lo que cambia es el horizonte temporal
El cambio va más allá de decir que “los modelos son más inteligentes”. En la práctica, los agentes pueden mantener la coherencia durante más tiempo, completar tareas más grandes de principio a fin y recuperarse de los errores sin perder el hilo.
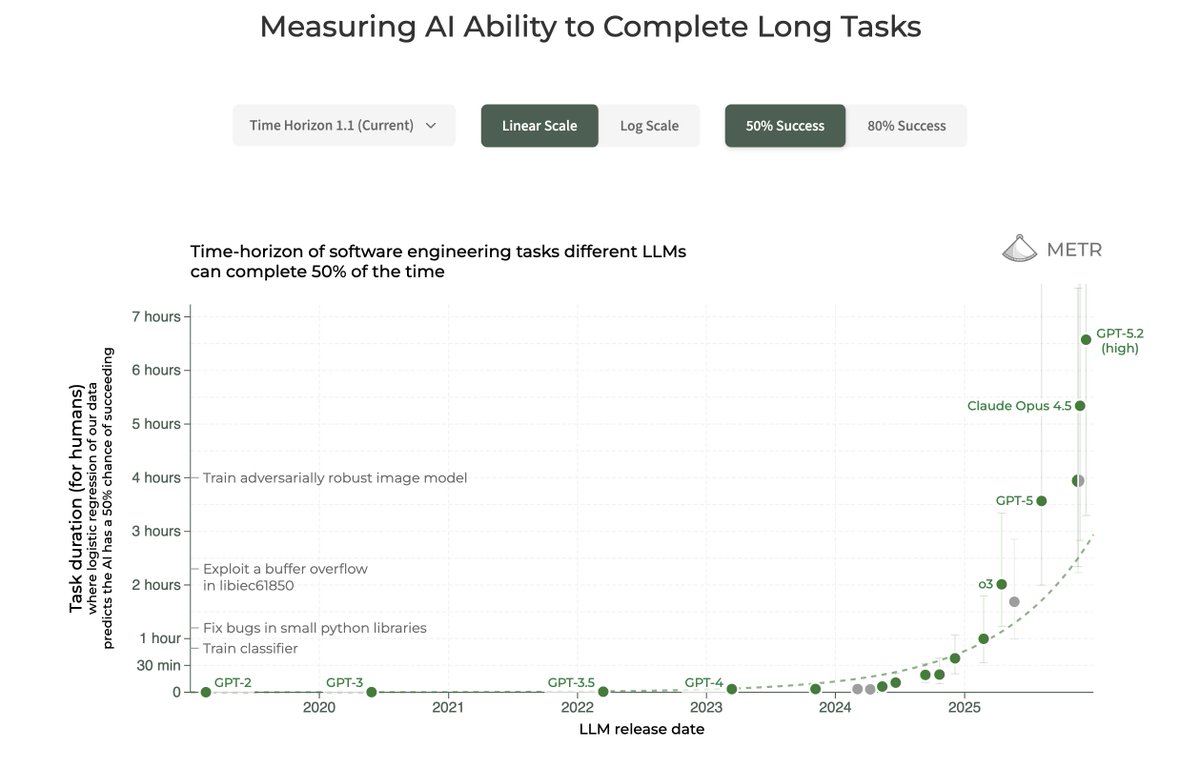
Las evaluaciones del horizonte temporal que realiza METR ayudan a entender esta tendencia. La duración de las tareas de software que los agentes de vanguardia pueden completar con una confiabilidad de alrededor del 50 % y del 80 % ha aumentado rápidamente: se duplica aproximadamente cada siete meses. Consulta Cómo medir la capacidad de la IA para completar tareas de larga duración (METR).
En nuestro reciente anuncio del lanzamiento de GPT-5.3-Codex, destacamos dos avances concretos para el trabajo con agentes:
- El modelo ejecuta mejor las tareas de varios pasos (planificar → implementar → validar → corregir).
- Es más fácil guiarlo sobre la marcha sin reiniciar toda la ejecución (puedes corregir el rumbo sin perder lo que ya avanzó).
También me inspiró lo que publicó Cursor sobre los sistemas autónomos de programación que trabajan durante períodos prolongados, incluido su experimento de crear un navegador: Cómo creó Cursor un navegador web (agentes a gran escala).
El equipo de Cursor escribió que los modelos de OpenAI son “mucho mejores para trabajar de forma autónoma durante períodos prolongados: siguen las instrucciones, mantienen la concentración, evitan desviarse e implementan lo que se les pide con precisión y por completo”.
Por qué Codex puede mantener la coherencia en tareas largas
En los trabajos de larga duración, el ciclo en el que opera el agente importa más que un único prompt enorme.
En Codex, el ciclo sigue, a grandes rasgos, estos pasos:
- Planificar
- Editar el código
- Ejecutar herramientas (pruebas, compilación y análisis estático)
- Observar los resultados
- Corregir los fallos
- Actualizar la documentación y el estado del proyecto
- Repetir
Este ciclo importa porque le permite al agente:
- Recibir información concreta sobre los resultados (errores, diferencias en el código, registros)
- Consultar el estado del trabajo fuera del modelo (repositorio, archivos, documentación, worktrees y resultados)
- Recibir indicaciones a lo largo de la ejecución (puedes corregir el rumbo según los resultados)
Por eso también se nota que los modelos de Codex funcionan mejor en las interfaces de Codex que en una ventana de chat genérica. El arnés de ejecución proporciona contexto estructurado (metadatos del repositorio, árbol de archivos, diferencias en el código y resultados de los comandos) y exige comprobar de manera sistemática que se cumplan los criterios para dar la tarea por terminada.
Hace poco publicamos un artículo con más detalles sobre el ciclo del agente de Codex.
También lanzamos Codex App, que te permite usar ese ciclo en tu trabajo diario:
- Hilos en paralelo en distintos proyectos (las tareas largas no interrumpen tu trabajo diario)
- Habilidades (estandariza la planificación, la implementación, las pruebas y la elaboración de informes)
- Automatizaciones (ejecuta tareas rutinarias en segundo plano)
- Worktrees de Git (aísla las ejecuciones, facilita la revisión de los cambios y evita tener que rehacer trabajo)

Cómo preparé la prueba
Elegí una herramienta de diseño para este “experimento” porque es una prueba exigente: combina una interfaz de usuario, un modelo de datos, operaciones de edición y muchos casos límite. No hay forma de disimular los problemas. Si la arquitectura está mal planteada, la herramienta falla enseguida.
Le di a GPT-5.3-Codex una especificación detallada y elegí la opción de razonamiento “Muy alta”. Trabajó unas 25 horas sin interrupciones, mantuvo la coherencia y entregó código de calidad. Además, por cada hito que completó, el modelo ejecutó verificaciones (pruebas, análisis estático y comprobación de tipos).
La idea central: una memoria persistente del proyecto
La técnica más importante fue darle al proyecto una memoria persistente. Escribí la especificación, el plan, las restricciones y el estado del proyecto en archivos Markdown que Codex podía volver a consultar. Así evité que se desviara y mantuve claros y estables los criterios para dar el trabajo por “terminado”.
Estos son los archivos que utilicé, con sus respectivos enlaces al repositorio:
Prompt.md (especificación y entregables)
Propósito: fijar el objetivo para evitar que el agente “cree algo impresionante que no sea lo que se le pidió”.
Secciones principales del archivo:
- Objetivos y aspectos fuera del alcance
- Restricciones obligatorias (rendimiento, determinismo, experiencia de usuario y plataforma)
- Entregables (lo que debe existir al terminar)
- “Se da por terminado cuando…” (verificaciones y secuencia de la demostración)
El prompt inicial le indicaba a Codex que tomara el archivo del prompt como especificación completa del proyecto y generara un plan por hitos:

Plan.md (hitos y validaciones)
Propósito: dividir un trabajo abierto en una serie de etapas que el agente pueda completar y verificar.
Secciones principales del archivo:
- Hitos lo bastante pequeños como para completarlos en un solo ciclo
- Criterios de aceptación y comandos de validación para cada hito
- Regla para detenerse y corregir: si la validación falla, corrige el problema antes de continuar
- Registro de decisiones para evitar ir y venir entre opciones
- Arquitectura prevista para la base de código

Hace poco incorporamos el Modo plan como función nativa de Codex App, la CLI y la extensión para IDE. Te permite dividir una tarea grande en una secuencia clara de pasos que puedes revisar antes de hacer cambios, para acordar el enfoque desde el principio. Si Codex necesita alguna aclaración, te hará más preguntas. Para activar el modo, usa el comando slash /plan.
Implement.md (instrucciones de ejecución que remiten al plan)
Propósito: servir de guía de ejecución. Le indica a Codex exactamente cómo trabajar: seguir el plan, limitar los cambios al alcance previsto, ejecutar las validaciones y actualizar la documentación.
Secciones principales del archivo:
- Usar el archivo Markdown del plan como referencia definitiva, hito por hito
- Ejecutar la validación después de cada hito (corregir los fallos de inmediato)
- Limitar los cambios a lo previsto (sin ampliar el alcance)
- Mantener actualizado el archivo Markdown de documentación

Documentation.md (estado y decisiones a medida que se completaban las entregas)
Propósito: servir de memoria compartida y registro de auditoría. Gracias a este archivo, puedo ausentarme durante horas y entender lo que ocurrió al regresar.
Secciones principales del archivo:
- Estado del hito actual (qué se completó y qué sigue)
- Decisiones tomadas y sus motivos
- Cómo ejecutar el proyecto y hacer una demostración (comandos y pruebas básicas rápidas)
- Problemas conocidos y asuntos pendientes

Así se verificó cada hito en la práctica durante la ejecución:

Verificación en cada hito
Codex hizo más que escribir código y esperar que funcionara. Al completar cada hito, ejecutó comandos de verificación y corrigió los fallos antes de continuar.
Estos son algunos de los comandos que le pedí que usara para comprobar la calidad:

Y este es un ejemplo de cómo Codex corrigió problemas cuando falló el análisis estático:

Qué creó el agente
El resultado tenía sus defectos y aún no estaba listo para producción, pero era una herramienta real que se podía probar. Para esta ejecución, el criterio iba más allá de “el código compila”. La pregunta era “¿cumple las instrucciones y funciona de verdad?”.
Funciones principales que implementó:
- Edición en el canvas (marcos, grupos, formas, texto, imágenes, íconos, botones y gráficas)
- Colaboración en tiempo real (sincronización de presencia, cursores, selecciones y ediciones entre pestañas)
- Controles del inspector (geometría, estilos y texto)
- Gestión de capas (buscar, renombrar, bloquear, ocultar y reordenar)
- Guías, alineación y ajuste automático de posición
- Instantáneas del historial y restauración
- Línea de tiempo para reproducir los cambios y crear una rama desde un punto anterior
- Modo de prototipo (zonas interactivas y navegación por el flujo)
- Comentarios (hilos anclados que se pueden marcar como resueltos y volver a abrir)
- Exportación (guardar, importar y exportar, además de exportar desde la CLI a JSON y a React con Tailwind)
Lecciones para las tareas de larga duración con Codex
El éxito de la ejecución fue más allá de un solo prompt ingenioso. Funcionó gracias a la combinación de estos elementos:
- Un objetivo y restricciones claros (archivo de especificación)
- Hitos con puntos de control y criterios de aceptación (
plans.md) - Una guía que indica cómo debe trabajar el agente (
implement.md) - Verificación continua (pruebas, análisis estático, comprobación de tipos y compilación)
- Un registro de estado y auditoría actualizado (
documentation.md) que permitía revisar la ejecución en cualquier momento
Hacia eso se orientan las tareas de programación de larga duración: menos supervisión constante y más delegación con límites claros.
Prueba Codex en una tarea propia de larga duración
Esta ejecución de 25 horas con Codex anticipa cómo será el desarrollo de software. Estamos pasando de los prompts aislados y los intercambios frecuentes de la programación en pareja a trabajar con agentes que pueden encargarse de una parte concreta del trabajo de principio a fin. Tú los orientas en cada hito sin tener que supervisar cada línea de código.
Con Codex buscamos que el agente colabore mejor contigo, se integre más estrechamente con el contexto real de tu trabajo y cuente con controles que te permitan confiar en los resultados, revisarlos y entregarlos con facilidad. Ya vemos que los desarrolladores avanzan más rápido cuando el agente se encarga de la implementación y la verificación rutinarias. Así pueden dedicar más tiempo a lo que más importa: el diseño, la arquitectura, las decisiones de producto y los problemas nuevos para los que no hay una solución predefinida.
Y esto va más allá de los desarrolladores. A medida que Codex entienda mejor lo que quieres hacer y ofrezca más recursos para hacerlo de forma segura (planes, validaciones, vistas previas y opciones para revertir cambios), más personas que no se dedican al desarrollo podrán crear y perfeccionar sus proyectos sin pasar todo el día en un IDE. Habrá más novedades en las interfaces y los modelos de Codex, pero el objetivo sigue siendo el mismo: que el agente se parezca cada vez menos a una herramienta que exige atención constante y cada vez más a un compañero de equipo en quien puedas confiar para tareas de larga duración.
Si quieres probarlo, empieza por aquí: