
Maintenant que GPT-5 est disponible, nous souhaitons expliquer pourquoi l’API Responses est le meilleur moyen de l’intégrer, et comment nous l’avons conçue pour les modèles de raisonnement et les applications à venir qui s’appuieront sur des agents.
À chaque génération d’API OpenAI, nous sommes partis de la même question. Comment donner aux développeurs le moyen le plus simple et le plus puissant de dialoguer avec les modèles ?
Nous avons toujours conçu nos API en fonction du fonctionnement des modèles. Notre tout premier point de terminaison, /v1/completions, était simple, mais offrait peu de possibilités. Vous donniez un prompt au modèle, qui se contentait de poursuivre votre texte. Avec des techniques comme les prompts few-shot, les développeurs pouvaient essayer d’amener le modèle à produire du JSON ou à répondre à des questions. Mais les capacités de ces modèles étaient bien en deçà de celles auxquelles nous sommes habitués aujourd’hui.
Puis sont arrivés le RLFH, ChatGPT et l’ère du post-entraînement. Les modèles ne se contentaient plus de terminer vos phrases : ils vous répondaient comme le ferait un interlocuteur. Pour suivre cette évolution, nous avons créé /v1/chat/completions (en un seul week-end, comme on le raconte souvent). Des rôles comme system, user et assistant donnaient aux développeurs un cadre pour créer rapidement des interfaces de discussion avec leurs propres instructions et éléments de contexte.
Nos modèles ont continué de progresser. Bientôt, ils ont su voir, entendre et parler. L’appel de fonction, introduit fin 2023, s’est révélé être l’une de nos fonctionnalités les plus appréciées. À la même époque, nous avons lancé l’API Assistants en version bêta. C’était notre première tentative de créer une interface entièrement conçue pour les agents, avec des outils hébergés comme l’interpréteur de code et la recherche de fichiers. Certains développeurs l’ont appréciée, mais son adoption est restée limitée. Sa conception imposait davantage de contraintes que celle de Chat Completions et la rendait plus difficile à prendre en main.
Fin 2024, il était devenu évident qu’il fallait réunir les atouts de ces API. Il nous fallait une API aussi accessible que Chat Completions, aussi puissante qu’Assistants et conçue dès le départ pour les modèles multimodaux et les modèles de raisonnement. C’est ainsi qu’est né /v1/responses.
/v1/responses fonctionne comme une boucle agentique
Chat Completions proposait une interface de discussion simple où les échanges se déroulaient à tour de rôle. Avec Responses, le modèle dispose d’une boucle structurée qui lui permet de raisonner et d’agir. Imaginez que vous fassiez appel à un détective. Vous lui fournissez des éléments de preuve, il mène l’enquête, consulte au besoin des experts (les outils), puis vous rend compte de ses conclusions. D’une étape à l’autre, le détective garde ses notes personnelles (l’état du raisonnement), sans jamais les remettre à son client.
C’est là que les modèles de raisonnement donnent toute leur mesure. Responses conserve l’état du raisonnement du modèle d’un échange à l’autre. Avec Chat Completions, le raisonnement est perdu entre deux appels, comme si le détective oubliait les indices chaque fois qu’il quittait la pièce. Avec Responses, le carnet reste ouvert : à l’échange suivant, le modèle peut s’appuyer sur chacune des étapes de son raisonnement. Le gain se mesure dans les tests de référence (+5 % sur TAUBench), mais aussi par une meilleure utilisation du cache et une latence réduite.
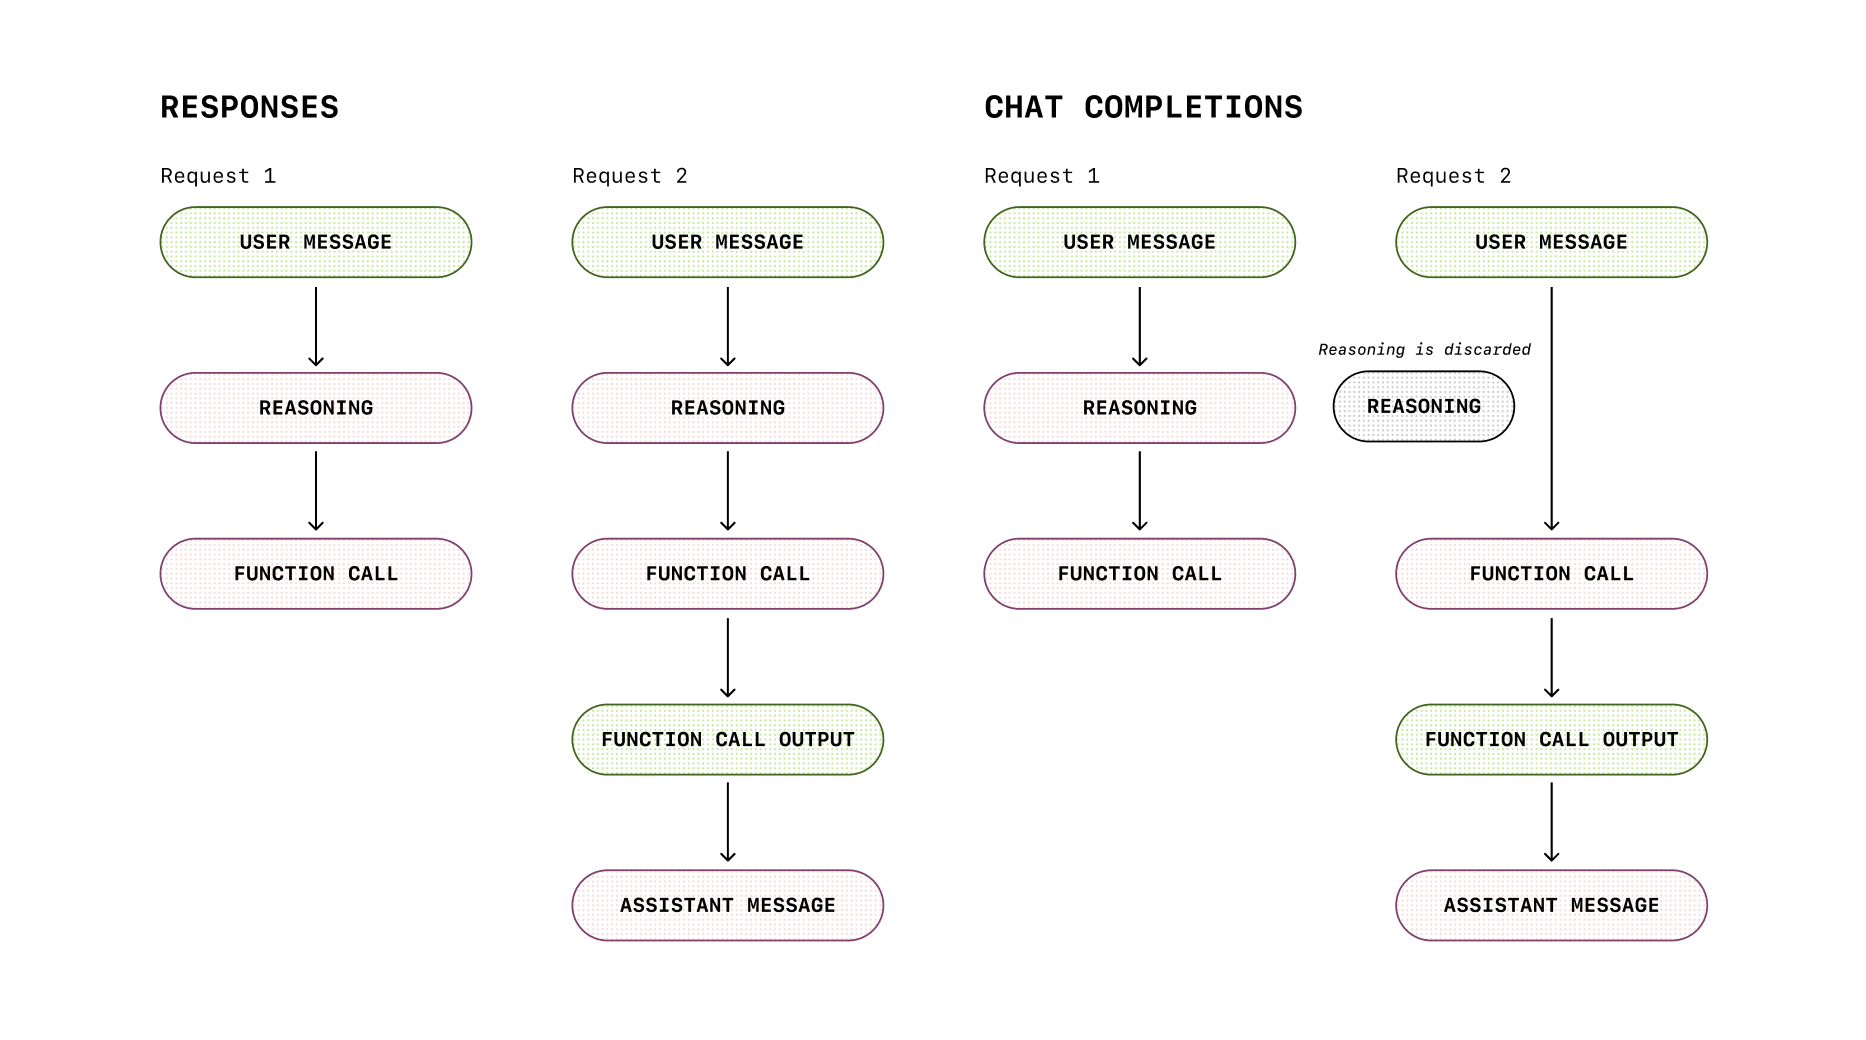
Responses peut aussi renvoyer plusieurs éléments en sortie. Vous voyez à la fois ce que le modèle a dit et ce qu’il a fait. Les appels d’outils, les sorties structurées et les étapes intermédiaires vous donnent une trace de son travail. C’est comme recevoir une copie au propre accompagnée du brouillon où figurent les calculs. Ces éléments facilitent le débogage, les audits et la création d’interfaces plus riches.
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},Des outils hébergés pour travailler à un niveau d’abstraction supérieur
Dès les débuts de l’appel de fonction, nous avons observé un usage récurrent. Les développeurs utilisaient le modèle pour appeler des API, mais aussi pour interroger des bases documentaires afin d’enrichir ses réponses avec des données externes. Cette dernière technique est aujourd’hui connue sous le nom de RAG. Or, quand on débute, construire de toutes pièces un pipeline de recherche documentaire est une entreprise complexe et coûteuse. Avec Assistants, nous avons lancé nos premiers outils hébergés, file_search et code_interpreter. Ils permettaient au modèle d’utiliser le RAG et d’écrire du code pour résoudre les problèmes que vous lui soumettiez. Avec Responses, nous sommes allés plus loin en ajoutant la recherche web, la génération d’images et MCP. Les outils hébergés comme l’interpréteur de code ou les outils MCP s’exécutent côté serveur. Chaque appel n’a donc plus à transiter par votre propre backend, ce qui réduit la latence et le coût des allers-retours.
Conserver le raisonnement en toute sécurité
Pourquoi prendre tant de précautions pour masquer le raisonnement détaillé (« chain-of-thought », ou CoT) du modèle sous sa forme brute ? Ne serait-il pas plus simple de le rendre accessible et de laisser les applications clientes le traiter comme les autres sorties du modèle ? En bref, exposer le raisonnement brut présente plusieurs risques. Il peut contenir des hallucinations ou des contenus préjudiciables qui ne figureraient pas dans la réponse finale. Pour OpenAI, cela présente aussi des risques sur le plan concurrentiel.
Lorsque nous avons lancé o1-preview à la fin de l’année dernière, notre directeur scientifique, Jakub Pachocki, écrivait sur notre blog :
Nous pensons que le raisonnement détaillé, lorsqu’il reste masqué, offre une occasion unique de surveiller les modèles. À condition qu’il soit fidèle et intelligible, ce raisonnement nous permet de « lire dans les pensées » du modèle et de comprendre sa démarche. À l’avenir, nous pourrions par exemple chercher à y déceler des signes de manipulation de l’utilisateur. Mais pour que cela fonctionne, le modèle doit pouvoir exprimer ses pensées sans les altérer. Nous ne pouvons donc pas l’entraîner à conformer son raisonnement détaillé à des règles ou aux préférences des utilisateurs. Nous ne souhaitons pas non plus exposer directement les utilisateurs à un raisonnement détaillé non aligné.
Responses répond à ces enjeux de deux façons :
- L’API conserve le raisonnement en interne, sous forme chiffrée et sans le rendre visible au client.
- Elle permet de poursuivre le raisonnement en toute sécurité grâce à
previous_response_idou aux éléments de raisonnement, sans exposer le CoT brut.
Pourquoi choisir /v1/responses pour développer vos applications
Nous avons conçu Responses pour conserver l’état des échanges, prendre en charge plusieurs modalités et utiliser efficacement les ressources.
- Utilisation d’outils par les agents. Avec l’API Responses, vous pouvez facilement enrichir vos workflows agentiques grâce à la recherche de fichiers, à la génération d’images, à l’Interpréteur de code et à MCP.
- Conservation de l’état par défaut. L’API assure automatiquement le suivi des conversations et de l’état des outils. Cela simplifie considérablement le raisonnement et les workflows qui s’étendent sur plusieurs échanges. Sur TAUBench, GPT-5 obtient un score supérieur de 5 % avec Responses par rapport à Chat Completions, grâce à la seule conservation du raisonnement.
- Prise en charge native de plusieurs modalités. Le texte, les images, l’audio et les appels de fonction sont tous pris en charge au même titre. Plutôt que de greffer des modalités sur une API de texte, nous avons prévu suffisamment de pièces dès la conception de la maison.
- Des coûts réduits et de meilleures performances. D’après nos tests de référence internes, l’utilisation du cache est de 40 à 80 % plus efficace qu’avec Chat Completions. Cela réduit la latence et les coûts.
- Une conception améliorée. Les enseignements tirés des API Chat Completions et Assistants nous ont permis d’apporter à l’API Responses et au SDK plusieurs améliorations qui facilitent le travail au quotidien, notamment :
- Des événements de streaming qui indiquent la nature de chaque mise à jour.
- Des éléments polymorphes dont le type est indiqué par un champ interne.
- Des utilitaires
output_textdans le SDK (plus besoin dechoices.[0].message.content). - Une meilleure organisation des paramètres liés aux modalités et au raisonnement.
Et Chat Completions ?
Chat Completions reste disponible. Si cette API vous convient, continuez à l’utiliser. Si vous souhaitez que le raisonnement persiste d’un échange à l’autre, que les interactions multimodales s’intègrent naturellement et que la boucle agentique fonctionne sans bricolage, choisissez Responses.
Et pour la suite ?
Tout comme Chat Completions a remplacé Completions, nous nous attendons à ce que Responses devienne le choix par défaut des développeurs qui utilisent les modèles d’OpenAI. L’API reste simple pour les usages courants, offre la puissance nécessaire aux applications plus exigeantes et conserve assez de souplesse pour s’adapter aux évolutions à venir.
C’est sur cette API que nous nous appuierons dans les années à venir.