
Les capacités audio de l’IA ouvrent de nouvelles possibilités d’interaction avec les utilisateurs. Plus tôt cette année, nous avons lancé plusieurs modèles audio, dont gpt-realtime, ainsi que de nouvelles fonctionnalités d’API pour permettre aux développeurs de créer ces expériences.
La semaine dernière, nous avons publié de nouvelles versions de nos modèles audio pour répondre à des difficultés courantes dans le développement d’agents vocaux fiables. Elles améliorent la fiabilité et la qualité des workflows vocaux en production, de la transcription et de la synthèse vocale aux agents qui fonctionnent nativement en parole à parole en temps réel.
Ces mises à jour comprennent :
gpt-4o-mini-transcribe-2025-12-15pour la transcription de la parole en texte avec l’API de transcription ou la Realtime APIgpt-4o-mini-tts-2025-12-15pour la synthèse vocale avec l’API Speechgpt-realtime-mini-2025-12-15pour les interactions natives en parole à parole en temps réel avec la Realtime APIgpt-audio-mini-2025-12-15pour les interactions natives en parole à parole avec l’API Chat Completions
Ces nouvelles versions apportent plusieurs améliorations communes :
En entrée audio :
- Des taux d’erreur sur les mots plus faibles pour les enregistrements en conditions réelles et les enregistrements bruités
- Moins d’hallucinations pendant les silences ou en présence de bruit de fond
En sortie audio :
- Une voix plus naturelle et plus stable, y compris avec les voix personnalisées
Les tarifs sont identiques à ceux des versions précédentes. Nous vous recommandons donc de passer à ces nouvelles versions pour bénéficier de meilleures performances au même prix.
Si vous développez des agents vocaux, des systèmes d’assistance client ou des expériences vocales propres à une marque, ces mises à jour vous aideront à fiabiliser vos déploiements en production. Voyons ce qui change et comment ces améliorations se traduisent dans les usages réels.
Parole à parole
Nous déployons de nouveaux modèles Realtime mini et Audio mini, optimisés pour mieux suivre les instructions et appeler les outils avec plus de précision. Les capacités de ces modèles mini se rapprochent de celles des modèles de grande taille. Certaines applications peuvent ainsi réduire leurs coûts en passant au modèle mini.
gpt-realtime-mini-2025-12-15
Le modèle gpt-realtime-mini est conçu pour la Realtime API, notre API dédiée aux interactions multimodales natives à faible latence. Il prend en charge le streaming audio en entrée et en sortie, la gestion des interruptions (avec détection facultative de l’activité vocale) et l’appel de fonction en arrière-plan pendant que le modèle continue de parler.
La nouvelle version de Realtime mini convient mieux aux agents en temps réel grâce à de nets progrès dans le suivi des instructions et les appels d’outils. Dans nos évaluations internes en parole à parole, la précision du suivi des instructions a progressé de 18,6 points de pourcentage et celle des appels d’outils de 12,9 points de pourcentage par rapport à la version précédente. Les résultats au test Big Bench Audio se sont également améliorés.
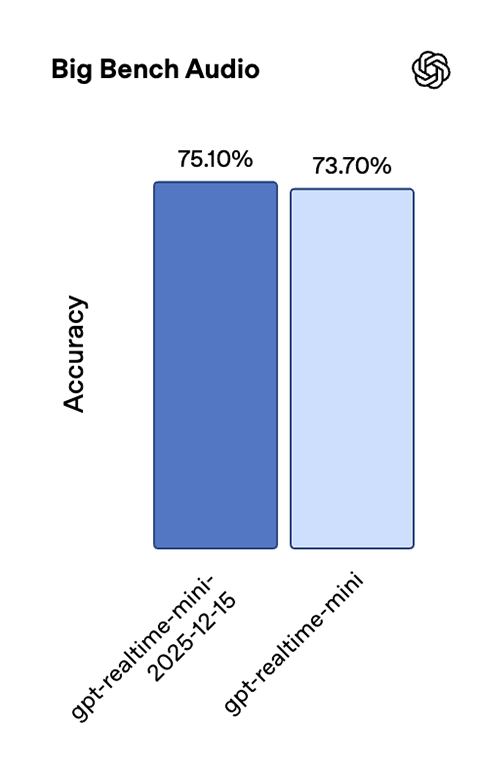
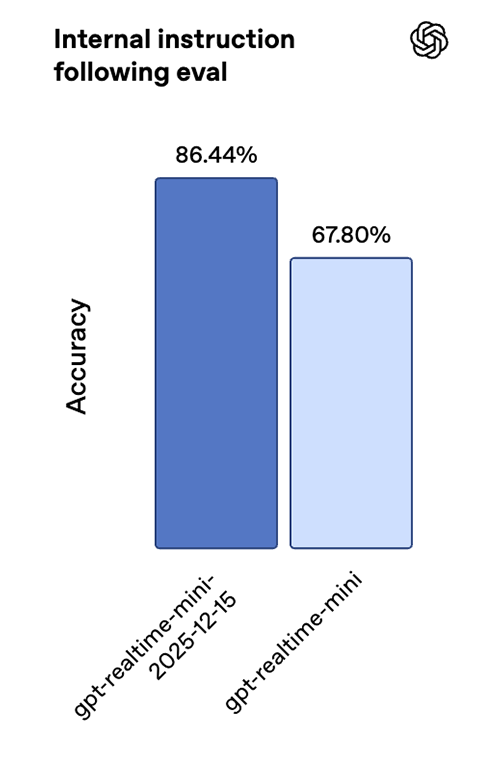
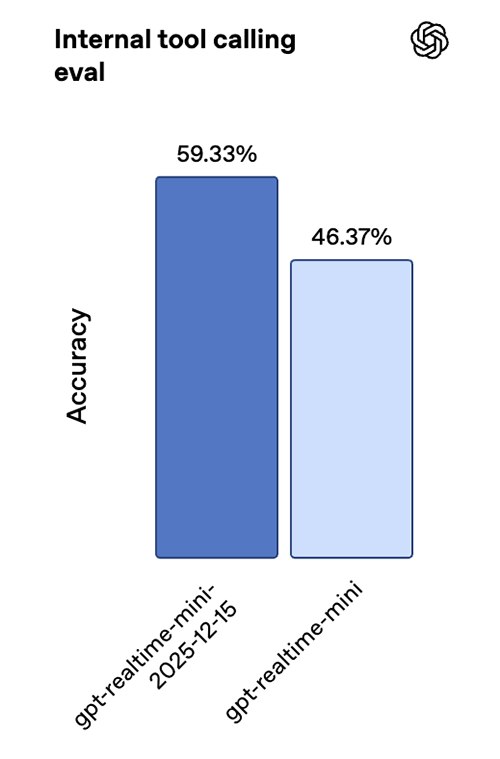
Grâce à ces progrès, les interactions en plusieurs étapes sont plus fiables et les fonctions s’exécutent de manière plus régulière lors d’échanges en direct à faible latence.
Pour les usages où la précision de l’agent justifie un coût plus élevé, gpt-realtime reste notre modèle le plus performant. Lorsque le coût et la latence sont prioritaires, gpt-realtime-mini est un excellent choix et donne de bons résultats en conditions réelles.
Par exemple, Genspark a mis le modèle à l’épreuve sur deux tâches : la traduction bilingue et le routage intelligent des demandes selon l’intention de l’utilisateur. En plus d’une meilleure qualité vocale, l’équipe a constaté que le modèle répondait presque instantanément et continuait de reconnaître précisément les intentions, même lorsque les échanges s’enchaînaient rapidement.
gpt-audio-mini-2025-12-15
Le modèle gpt-audio-mini peut s’utiliser avec l’API Chat Completions pour les applications en parole à parole qui ne nécessitent pas d’interaction en temps réel.
Les deux nouvelles versions intègrent également un décodeur amélioré qui produit des voix plus naturelles. Lorsqu’elles utilisent des voix personnalisées, ces versions préservent mieux les caractéristiques de la voix au fil des échanges.
Synthèse vocale
Notre dernier modèle de synthèse vocale, gpt-4o-mini-tts-2025-12-15, gagne nettement en précision. Sur les tests de référence, son taux d’erreur sur les mots est bien inférieur à celui de la génération précédente. Sur Common Voice et FLEURS, ce taux (WER) baisse d’environ 35 %. Nous observons également des gains réguliers sur Multilingual LibriSpeech.
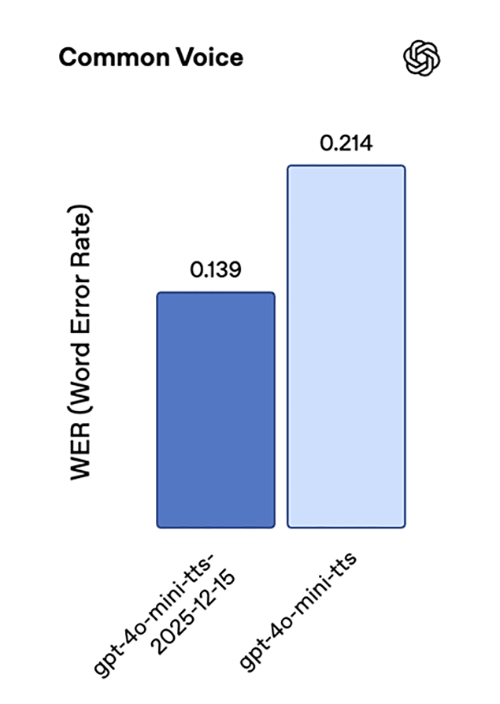
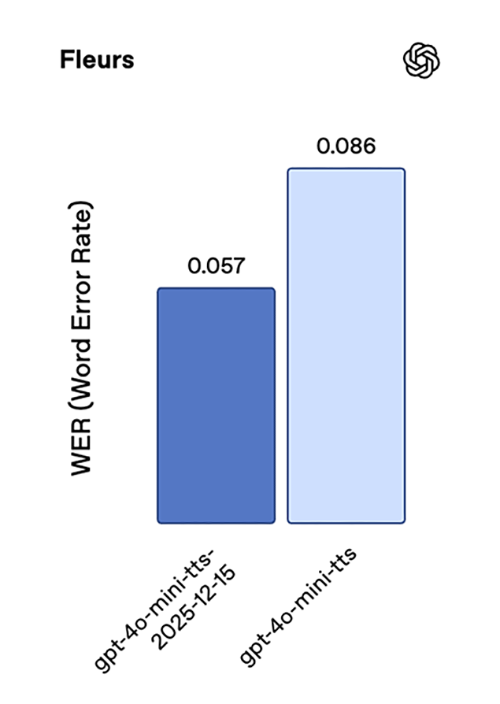
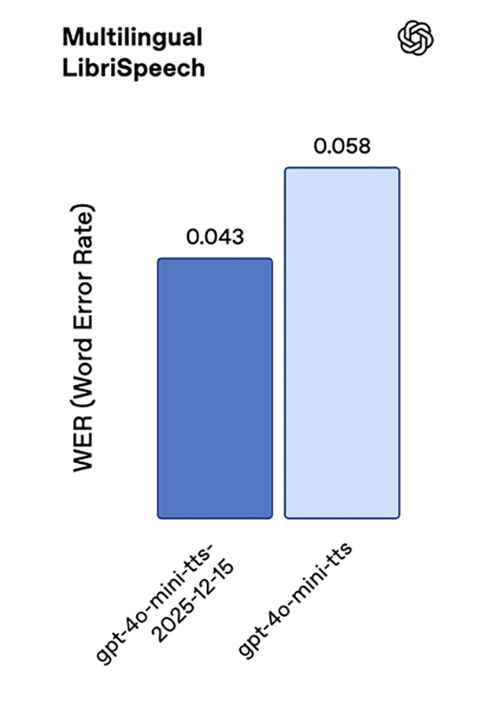
Ces résultats témoignent d’une prononciation plus précise et plus robuste dans de nombreuses langues.
Comme la nouvelle version de gpt-realtime-mini, ce modèle produit une voix beaucoup plus naturelle et donne de meilleurs résultats avec les voix personnalisées.
Transcription de la parole en texte
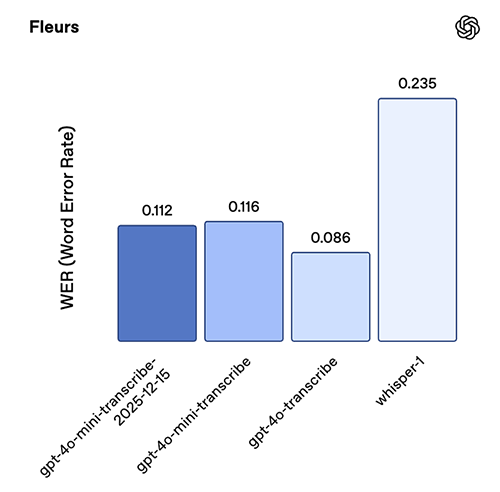
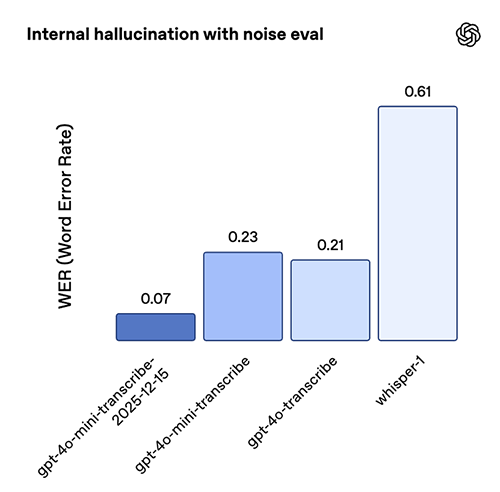
Notre dernier modèle de transcription, gpt-4o-mini-transcribe-2025-12-15, gagne nettement en précision et en fiabilité. Sur des tests de référence en reconnaissance automatique de la parole comme Common Voice et FLEURS, il affiche des taux d’erreur sur les mots inférieurs à ceux des modèles précédents, sans indication préalable de la langue. Nous l’avons optimisé pour les conversations en conditions réelles, par exemple lorsque l’utilisateur ne prononce que quelques mots ou que le bruit ambiant est important. Lors d’une évaluation interne des hallucinations en présence de bruit, nous lui avons fait écouter des extraits de bruit ambiant enregistrés en conditions réelles ainsi que des séquences audio alternant prises de parole de durées variables et silences. Le modèle a produit environ 90 % d’hallucinations de moins que Whisper v2 et environ 70 % de moins que les précédents modèles GPT-4o-transcribe.
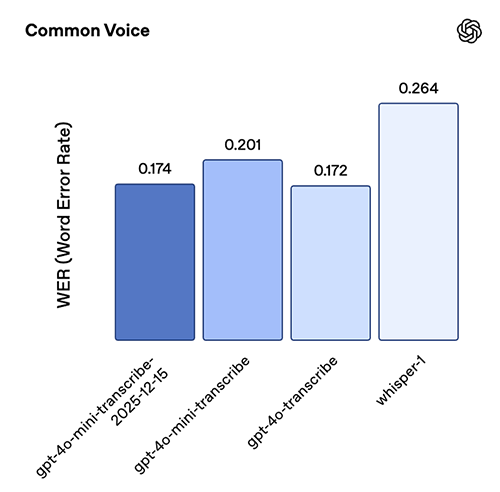
Cette version du modèle est particulièrement performante en chinois (mandarin), en hindi, en bengali, en japonais, en indonésien et en italien.
Voix personnalisées
Les voix personnalisées permettent aux organisations de s’adresser à leurs clients avec une voix propre à leur marque. Que vous développiez un agent d’assistance client ou un avatar de marque, la technologie de personnalisation vocale d’OpenAI vous permet de créer facilement des voix distinctives et réalistes.
Avec ces nouveaux modèles de parole à parole et de synthèse vocale, les voix personnalisées ont des intonations plus naturelles, reproduisent plus fidèlement l’échantillon d’origine et restituent plus précisément les différents dialectes.
Pour garantir une utilisation sûre de cette technologie, seuls les clients éligibles ont accès aux voix personnalisées. Pour en savoir plus, contactez votre responsable de compte ou prenez contact avec notre équipe commerciale.
Du prototype à la production
Les applications vocales rencontrent souvent des difficultés dans les mêmes situations : les longues conversations, les cas limites comme les silences et les workflows qui exigent que l’agent vocal utilise les outils avec précision. Ces mises à jour ciblent ces difficultés : les taux d’erreur diminuent, les hallucinations sont moins fréquentes, l’utilisation des outils est plus régulière et le modèle suit mieux les instructions. Nous avons également amélioré la stabilité de l’audio en sortie pour rendre les interactions vocales plus naturelles.
Si vous déployez déjà des applications vocales, nous vous recommandons de passer aux nouvelles versions 2025-12-15 et de relancer vos principaux scénarios de test en production.
Les premiers testeurs ont confirmé des améliorations sensibles en passant simplement aux nouvelles versions, sans modifier leurs instructions. Nous vous recommandons toutefois de faire des essais sur vos propres cas d’usage et d’ajuster vos prompts si nécessaire.